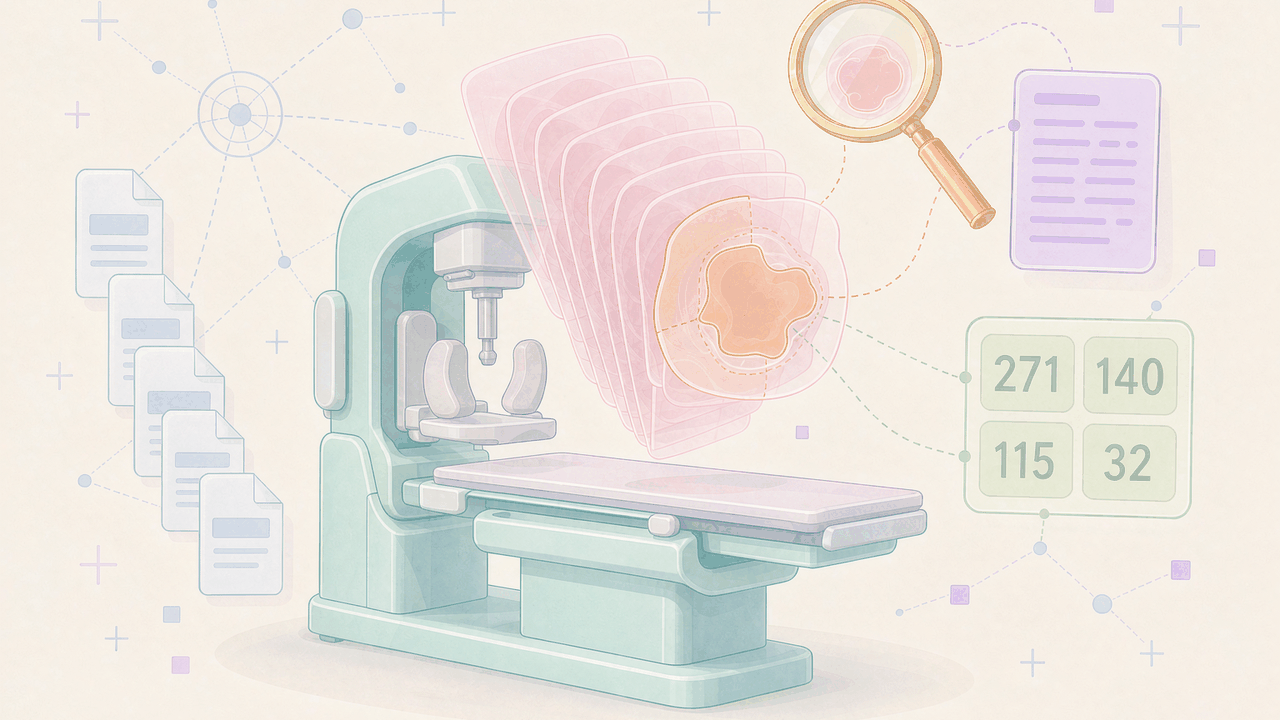
信息速览
INFOBOX — 3D Mammogram Dataset 一屏速览
维度 内容 本质 iMerit × Segmed × Advocate Health 联合发布的开放标注 DBT(数字乳腺断层摄影/3D 乳腺 X 线)数据集,preprint 内部名 DBT-2026 规模 558 例患者 / 558 个 DBT 筛查检查(讨论章节另有 1,110 口径,存照);每例双侧 CC+MLO 至少 4 个三维体数据 四组 A 271 活检证实恶性(48.6%)/B 140 良性/C 115 非癌召回/D 32 活检证实良性;聚合口径 271 恶性 vs 287 良性 人群 全女性、≥18 岁、平均年龄 57.5±11.1 岁;BI-RADS 0/1/2;平均病灶 1.34 cm、约 85% 病灶 <2 cm 标注 印度资深乳腺放射医师分割/定位/表征/测量 → Doer–Checker 两步复核 → 美国 MQSA 认证医师终审 文本 去标识自由文本放射报告(OCR+NLP+LLM 去 18 类 HIPAA PHI + 人工复核) 格式 压缩 DICOM(1 view=1 文件=1 个 3D 体)+ NRRD + 结构化 JSON + metadata.xlsx + CSV 获取 全量走 Segmed 表单(注册+credentialing+DUA,逐案审核);HuggingFace 有 650 MB 样本包(iMerit/3D-MammographyDataset) 许可 Segmed–iMerit Joint Research Use Agreement:非商业研究专用,禁再分发、禁再识别、禁临床决策;版权归作者与 Segmed 论文 medRxiv preprint,doi:10.64898/2026.03.03.25337924(2026-03,Wu J 等 7 人) 定位 DBT 公开数据集中活检 ground truth 密度最高(恶性 48.6%)的小而精标注库;对标 Duke BCS-DBT(5,060 患者)的大而全 库内互链 VinDr-Mammo(543)、CBIS-DDSM(541)、INbreast(542)、BCDR(800)、MIAS(801)
3D Mammogram Dataset 是一个"把 3D 乳腺 X 线的稀缺标注一次配齐"的数据集工程:它不追求数量上的庞大,而是把 558 个数字乳腺断层摄影(Digital Breast Tomosynthesis,DBT,俗称 3D 钼靶)筛查检查打包成一个「三维体数据 + 专家分割标注 + 活检病理金标准 + 自由文本放射报告」四合一的库。它最锋利的一点是恶性密度——271 例(48.6%)经活检病理证实为恶性,这直接回应了公开 DBT 数据集长期"良性扎堆、恶性稀缺、金标准稀薄"的老问题。
导语读法三则:
- 只想下数据:直奔 §5 获取与许可——注意全量必须走 Segmed 表单(注册+DUA),HuggingFace 上那份 650 MB 只是样本包,别当成全量(坑 2)。
- 关心标注质量:直奔 §3 标注流水线——Doer–Checker 双步复核加 MQSA 认证医师终审的完整链条,以及它没有公开基准模型这件事(§6)。
- 做影像-报告多模态:直奔 §2 与 §4——报告文本、四组临床分组与 BI-RADS 元数据的组合方式,决定了它能支撑哪些研究设计。
§0 导读:这个数据集解决什么问题
乳腺癌筛查是放射科最日常也最庞大的任务:全球每年超过 3,900 万人次接受乳腺影像检查,是 AI 医学影像研究最拥挤的赛道之一。传统 2D 数字乳腺 X 线摄影(digital mammography)有一个结构性弱点——腺体组织在二维投影里层层重叠,致密乳腺里的病灶容易被遮住。DBT 的解法是让球管在有限弧度内采集多个低剂量角度的投影,再重建出准三维的薄层切片:组织重叠被拆开,病灶的可见性、表征能力和定位精度都随之提升。STORM、Skaane、Friedewald、Rafferty、McDonald 等一系列人群级临床试验已经证明:DBT 能提高浸润性癌检出率,同时降低假阳性召回率——这也是它近年在全球筛查与诊断场景加速普及的原因。
但 AI 研究者面对的公开 DBT 数据集供给,和临床热度严重不匹配。DBT-2026 preprint 开宗明义:大多数公开 DBT 数据集的恶性患者数都偏低(“relatively low numbers of patients with malignancies”),且缺少高质量的活检金标准。2D 钼靶领域已有 CBIS-DDSM 这类病理证实的经典评测集,DBT 领域则长期没有规模与质量兼顾的对应物——体数据体积大、去标识难、伦理门槛高,让数据集建设比 2D 慢一个节拍。
3D Mammogram Dataset 的回答是「小而精 + 三合一」。第一层是数据:558 例 BI-RADS 0/1/2 筛查 DBT 检查,经富集采样让活检证实恶性占到 48.6%,每例都带双侧 CC+MLO 体位的三维体数据。第二层是标注:病灶的定位、表征、分割与测量由资深乳腺放射医师完成,走 Doer–Checker 两步复核,最后由美国 MQSA 认证医师终审。第三层是文本:每例附去标识的自由文本放射报告,配 OCR+NLP+LLM 三段式去标识流水线——这让同一个库可以同时训练分割模型、分类模型和影像-报告对齐模型。
§0 读法三则:
- 这个条目的实体名要捋清:站点条目名 3D Mammogram Dataset(官方页名),preprint 内部名 DBT-2026,HuggingFace 仓库名 iMerit/3D-MammographyDataset——三者指同一数据集,检索时都要试。
- 全文统计数字均出自 preprint 正文与官方页;两处口径冲突(摘要 558 exams vs 讨论 1,110 exams、恶性占比 48.5% vs 48.6%)已在坑 3 与坑 7 存照。
- 库内 ddti 条目(Digital Database Thyroid Image)是甲状腺超声库,名字与 DBT 相近但毫无关系——检索时别撞上(坑 1)。
§1 数据集速览:十问十答
Q1:3D Mammogram Dataset 到底是什么?
一个 558 例的开放标注 DBT(数字乳腺断层摄影)数据集,由 AI 数据标注公司 iMerit、医学影像平台 Segmed 与美国大型非营利医疗系统 Advocate Health 三方合作发布,2026 年 3 月以 medRxiv preprint「DBT-2026」的形式公开。每例是一个完整 DBT 筛查检查,配专家分割标注、活检或随访金标准与去标识放射报告。
Q2:558 例怎么构成的?
四组:A 组 271 例活检证实恶性(占 48.6%);B 组 140 例良性;C 组 115 例非癌召回(non-cancer callback,影像异常召回但未做活检/无恶性);D 组 32 例活检证实良性。官方页把 B+C+D 合并报成「287 benign(51.5%)」,两种口径都成立,引用时注意分母与措辞。
Q3:为什么恶性比例能做到接近一半?
富集采样(enrichment):构建队列时刻意优先纳入活检证实恶性的患者。这意味着它不是自然筛查人群的横断面——做疾病 prevalence 敏感的实验设计时要当心(见 §4.4)。
Q4:每个检查里有什么图像?
每例为双侧乳腺检查,每侧至少一个头尾位(CC,craniocaudal)和一个内外斜位(MLO,mediolateral oblique),即每例至少 4 个 DBT 三维体数据。图像以压缩 DICOM 存储,一个文件=一个 view=一个完整三维体——不能用读普通 2D 医学影像的方式直接展开(坑 8)。
Q5:标注是谁做的、质量如何保证?
经 iMerit Scholars 平台招募与资质认证的印度资深(fellowship-trained)乳腺影像放射医师,在 HIPAA 合规的 Ango Radiology Annotation Suite 云平台标注;协议由美国临床专家制定;每例走「Doer–Checker」两步复核,分歧二次复核共识解决;最终由美国 MQSA 认证乳腺放射医师做质量终审。
Q6:除了图像和标注还有什么?
三样:活检病理结果或随访金标准;去标识自由文本放射报告(描述影像所见,来自日常临床实践);结构化元数据(年龄、性别、种族、族裔、BI-RADS 评分、活检结果),以 CSV/XLSX 提供。文本与图像都经去标识:图像烧录文字走 OCR,文本走 NLP+LLM 去除 18 类 HIPAA PHI,最后人工复核。
Q7:我现在能拿到什么?
两条路:HuggingFace(iMerit/3D-MammographyDataset)有 650 MB 样本包(DICOM+annotations.json+metadata.xlsx 的示例结构);全量 558 例走 Segmed 表单,需注册、credentialing 并签署 Data Use Agreement,权限逐案审核。
Q8:能商用吗?
不能直接商用。DUA 明确限定非商业研究用途,禁止再分发、禁止患者再识别、禁止用于临床决策;preprint 说明版权归作者与 Segmed。官方页面上「支持商业 AI 开发阶段」的营销话术与 DUA 条款表面冲突——想商用必须另行联系作者/Segmed 谈扩展授权(坑 5)。
Q9:和库内乳腺条目是什么关系?
库内既有乳腺条目(VinDr-Mammo、CBIS-DDSM、INbreast、MIAS)全部是 2D 钼靶;BCDR 含 DBT 重建切片但不带这种规模的活检金标准。本条目是库内第一个「完整 DBT 体数据 + 活检金标准 + 报告文本」三合一的乳腺影像条目。
Q10:引用与溯源怎么写?
论文:Wu J, Perandini L, Batra T, Igoshin S, Bari S, de Araujo AL, Willemink MJ. DBT-2026, a de-identified publicly available dataset of digital breast tomosynthesis exams with ground truth biopsies. medRxiv 2026.03.03.25337924; doi:10.64898/2026.03.03.25337924(注意 DOI 前缀 10.64898 不是 medRxiv 常见的 10.1101,坑 3)。
§2 数据构成与规格
2.1 规模、来源与采集路径
DBT-2026 的 558 例检查全部来自美国中西部(Midwest region)的单一医院——preprint 在讨论部分把它列为首要局限:设备、采集协议与人群的地域多样性受限;同时作者给出补偿路径——研究者可以联系作者团队申请访问「更广泛的多中心数据库」。数据经 Segmed 的两条产品线流转:Segmed Piper 与医院 PACS 建立自动连接、以 DICOM 格式拉取图像与元数据;Segmed Openda 作为队列构建工具,按模态、身体部位、放射报告与 DICOM 元数据检索。这条「PACS→Piper→Openda→标注→发布」的管道本身就是一份值得借鉴的真实世界数据(RWD)工程样本。
入组标准(preprint Materials & Methods 原文口径):
- 女性,≥18 岁,符合乳腺癌筛查条件;
- 双侧检查,每侧至少一个 MLO 位和一个 CC 位——即每例至少 4 个 DBT view;
- 无乳房植入物、无既往乳腺或腋窝手术史、无乳腺癌病史;
- 筛查人群 BI-RADS 评分限定为 0、1 或 2;
- 队列富集:优先纳入活检证实恶性患者。
回顾性研究设计,个别患者知情同意获豁免;所有受保护健康信息(PHI)被移除。
2.2 四组构成与临床口径
队列的四组划分是理解这个数据集的钥匙——它不是「正常 vs 异常」的二分,而是按临床处置路径分层的:
| 组 | 定义 | 例数 | 占比 | 含义 |
|---|---|---|---|---|
| A | 活检证实恶性(biopsy-proven malignant) | 271 | 48.6% | 有病理金标准的阳性样本 |
| B | 良性(benign) | 140 | 25.1% | 临床认定良性(含随访证实) |
| C | 非癌召回(non-cancer callback) | 115 | 20.6% | 筛查异常被召回、最终排除癌 |
| D | 活检证实良性(biopsy-proven benign) | 32 | 5.7% | 做了活检、病理为良性 |
| 合计 | — | 558 | 100% | — |
官方页把 140+115+32=287 合并报为「287 benign(51.5%)」,preprint 的讨论也写「almost half of patients had a biopsy-proven malignancy (n=271, 48.6%)」。两种口径的差别在于:「良性」是临床结论层,「活检证实」是证据强度层——只有 A 组和 D 组共 303 例(54.3%)真正有病理金标准,B 组与 C 组依赖临床随访与常规处置结论。做「以病理为金标准」的严格评测时应明确只用 A+D 子集;做「筛查决策模拟」时四组全用。
2.3 图像规格与文件形态
- 模态:DBT(数字乳腺断层摄影),即多角度低剂量投影重建的准三维薄层切片;单侧检查的每个体位(CC/MLO)产出一个三维体。
- 存储:压缩 DICOM,一个文件=一个 view=一个完整三维体。这与 2D 钼靶「一个文件=一张图」的习惯完全不同,读取需 DICOM 工具链(GDCM、dcmtk、ITK、pydicom + 压缩解码插件等),解压后是三维像素数组。
- 体位:双侧 CC+MLO 为标配(入组标准保证),实际 view 数以 DICOM 元数据为准。
- 官方页另有 NRRD 格式输出与结构化 JSON 标注,HF 样本包内含 annotations.json 与 metadata.xlsx——对不愿处理 DICOM 的团队,NRRD+JSON 的组合可以直接喂给主流深度学习栈。
- 元数据 CSV:年龄、性别、种族、族裔、BI-RADS 评分、活检结果、放射报告。
- 体积:HF 样本包 650 MB;全量体积未公开披露——按每 view 一个三维体、每例至少 4 view 推算,全量为数百 GB 量级,下载与存储前先和 Segmed 确认(存照)。
2.4 去标识化流水线:OCR + NLP + LLM + 人工
医学影像公开化最难的不是图像而是文本。DBT-2026 的去标识化是三层兜底:
- 图像层:DICOM 图像内的烧录文字(burnt-in text)经 OCR 转为机器可读文本——先「看见」图像里的字,才能谈删除;
- 文本层:报告文本与 OCR 出的图像文字合并,用 NLP+LLM 组合去除 HIPAA 定义的 18 类 PHI;
- 人工层:临床专家(L.P.)逐例人工复核,未检出残留 PHI。
这个「机器初筛+人工终审」的双保险设计,与图像端「Doer–Checker」标注复核在结构上同构——整个数据集的质控哲学是每一步都有第二双眼睛。
2.5 与 2D 钼靶数据集的形态对照
| 维度 | DBT-2026(本条目) | 典型 2D 钼靶库(如 CBIS-DDSM/VinDr-Mammo) |
|---|---|---|
| 图像单元 | 三维体(1 view=1 DICOM 文件) | 二维投影图(1 view=1 图像) |
| 单例体积 | 数百 MB 量级 | 数 MB 至数十 MB |
| 恶性金标准 | 活检病理(48.6% 恶性) | 部分病理证实、部分影像随访 |
| 报告文本 | 有(自由文本,去标识) | 少数有(多为 BI-RADS 结构化标签) |
| 公开方式 | 表单+DUA(逐案审核) | 多为直链下载 |
| 单库体量 | 558 例(小而精) | 数千至数万例(大而全) |
这张表解释了 DBT-2026 的生态位:它不是 2D 大库的替代品,而是「监督密度」路线——单例信息量(三维体+标注+病理+报告)远超 2D 库,代价是总量小、获取门槛高。
2.6 view 层级与 DICOM 元数据要点
DBT 数据的「最小工作单元」是 view(一个体位的完整三维体),而不是 2D 世界里的「一张图」。围绕 view 组织工程管线时,有几个 DICOM 层面的通用要点(以 HF 样本包实测 schema 为准,本库未发布官方读取文档):
- 多帧结构:DBT view 在 DICOM 里以多帧(multiframe)存储,
pixel_array解出的是(frames, rows, cols)三维数组——frames 维即层内切片数,层厚远小于面内分辨率(准各向异性体数据),重采样策略要显式设计。 - 压缩传输语法:实际发布的 DBT DICOM 几乎都是压缩的(JPEG-LS/JPEG 2000 一类),
pydicom裸装解不开——装pylibjpeg/gdcm系解码插件再读(附录 E 的依赖清单即为此准备)。 - 灰度标定:注意
RescaleSlope/RescaleIntercept,把存储值转成物理量级(吸收值),不同 case 间才能可比。 - 方向与后侧标注:DBT 体数据的方向(头脚/内外)必须从 DICOM 几何标签重建—— Duke BCS-DBT 曾因部分文件 laterality/orientation 标注错误专门发布预处理说明,本库虽无同类官方声明,读入后仍建议用体位标签(CC/MLO)与左右标记做一次自检。
- 每例 view 计数:入组标准保证每例 ≥4 view;实际是否更多(如加拍 Spot Compression 位不在本库设计内)以 DICOM 元数据逐例清点为准——这也是为什么本条目全程只写「至少 4」。
2.7 数据交付 schema 总表
| 资产 | 载体 | 内容 | 粒度 |
|---|---|---|---|
| 三维体数据 | 压缩 DICOM(全量) | 每 view 一个完整三维体 | view |
| 三维体数据(样本) | HF 650 MB 包内 DICOM | 同上,示例病例 | view |
| 三维体数据(备选) | NRRD | 同一体的开放格式转出 | view |
| 病灶标注 | annotations.json / 结构化 JSON | 框、分割轮廓、表征、测量 | 病灶(挂到 view/case) |
| 元数据 | metadata.xlsx / CSV | 年龄、性别、种族、族裔、BI-RADS、活检结果 | case |
| 结局金标准 | CSV 字段 | 活检病理或随访结论(四组归属) | case |
| 报告文本 | CSV/结构化输出 | 去标识自由文本放射报告 | case |
这套 schema 的信息架构是三层嵌套:case(临床单位)→ view(成像单位)→ lesion(标注单位)。四组标签与报告挂在 case 层,三维体挂在 view 层,病灶标注挂 lesion 层——做交叉验证切分时必须按 case 切,绝不能按 view 或 lesion 切(同一 case 的 view 共享患者与结局,按 view 切会泄漏)。
2.8 报告文本:被低估的第三资产
多数乳腺影像公开库只有图像和标签,本库把日常临床实践中产生的自由文本放射报告一并去标识后发布——这是它在影像-报告多模态赛道上的稀缺性所在。报告的价值分三档:
- 监督信号:报告是放射科医师对整例检查(含所有 view)的自然语言总结,可作为弱监督或对齐目标;
- 中间证据:报告描述的病灶位置/形态可与标注框交叉验证,构建「影像所见 vs 结构化标注 vs 病理结论」三重证据链;
- 文本资产本身:为乳腺领域小语料 NLP(术语归一、BI-RADS 结构化抽取)提供真实语料。
使用注意:报告与四组标签、标注可能存在措辞上的「临床惯例差异」(如报告写「建议随访」对应 C 组路径),把它当结构化标签直接解析前,先做术语一致性盘点。
2.9 拿到全量后的第一周:十项数据体检
表单审核通过、数据到手后,建议按这份清单做入库前体检——每项都对应本库已知的形态特征或同类库的常见翻车点:
- 清点 case 数:应为 558;CSV 行数与 DICOM case 目录数三方对齐;
- 清点 view 数:逐例统计 DICOM 文件数,验证「每例 ≥4」且记录实际分布——这也是验证 1,110 口径(坑 4)的唯一一手途径;
- 抽查传输语法:解压是否全部成功(§2.6 第 2 条),失败文件记录后统一换解码栈;
- 方向自检:抽 20 例目检 CC/MLO 方向与左右标记(§2.6 第 4 条);
- 四组标签对账:CSV 的组别字段与 preprint 四组定义(271/140/115/32)对账;
- 病理金标准覆盖率:确认 A+D 组的活检结论字段无缺失;
- 标注 schema 盘点:annotations.json 的病灶结构(框/分割/类别/测量)逐字段建文档;
- 标注-图像对齐抽查:抽 20 个病灶目检分割轮廓与三维体对应层;
- 报告完整性:确认每 case 有报告文本,长度分布出直方图;
- 去标识抽检:抽检 DICOM 元数据头与报告文本中的可疑标识符(本库已三重处理,使用方抽检是惯例的最后防线)。
十项全绿再开训练;任何一项异常,先回到 §5.6 的沟通渠道与 Segmed 对账,不要带病开工。
2.10 DBT DICOM 读取工具矩阵
DBT 三维体 DICOM 的兼容工具面(BCS-DBT 官方页对同类数据的验证结论+通用 DICOM 工具生态,本库同为标准 DBT DICOM,适用面一致):
| 工具 | 类型 | 三维体支持 | 适用场景 |
|---|---|---|---|
| pydicom + pylibjpeg/gdcm | Python 库 | 解出 (frames, rows, cols) | 管线开发首选 |
| GDCM / dcmtk | 命令行库 | 解压/转封装 | 批量预处理 |
| ITK-SNAP / 3D Slicer | 桌面查看器 | 体渲染+切片浏览 | 目检标注对齐 |
| RadiAnt / MicroDICOM | Windows 查看器 | 多帧浏览 | 快速人工核查 |
| ImageJ + Bio-Formats | 桌面+插件 | 多帧序列 | 科研快速验证 |
选型建议:管线用 pydicom 系、目检用 ITK-SNAP/Slicer;凡遇打不开的文件先怀疑压缩传输语法插件缺失,再怀疑文件损坏——经验上九成是前者。
§3 标注流水线:两步复核与认证终审
3.1 人员结构:跨时区三级体系
- 协议制定:美国临床专家制定标准化标注协议(standardized annotation protocol),统一病灶分类与测量口径——协议先行,避免「各标各的」;
- 标注执行:经 iMerit Scholars 平台招募与资质认证的印度资深乳腺影像放射医师(fellowship-trained),在 iMerit 自研的 Ango Radiology Annotation Suite 云平台作业;
- 终审把关:美国 MQSA 认证(Mammography Quality Standards Act,乳腺摄影质量标准法案)乳腺放射医师做最终质量审查,验证病灶表征与分割保真度。
与 PANDA-PLUS 那类「学生标注+专家终审」的流水线不同,DBT-2026 的每一层执行者都是执业医师——这既是乳腺影像任务复杂度(三维体+病理相关)的必然,也是官方页「regulatory-grade」宣称的底气:工作流按 FDA 510(k)、MQSA、HIPAA 合规设计,带审计跟踪(audit trails)与元数据打标。
3.2 工作流:Doer–Checker 与共识机制
标注核心是两步制:
- Doer:标注医师完成病灶的定位(localization)、表征(characterization)、分割(segmentation)与测量(measurement,用平台校准过的测量工具);
- Checker:另一名医师独立复核每例的完整性与准确性;
- 分歧处理:复核发现的不一致进入二次复核(secondary review),以共识(consensus)解决;
- 终审:美国 MQSA 认证医师做最终 QA。
平台侧的配套:Ango Radiology Annotation Suite 支持 DBT 的多分辨率缩放、并排对比、对称对齐(左右乳对照)、预标注等高级视图——乳腺影像标注里「左右对称性」是发现单侧 subtle 病灶的关键辅助,工具层直接内置了这些临床阅读习惯。
3.3 标注与金标准的关系
标注产出的是「影像学标注」:病灶在哪(框/分割)、是什么(表征)、多大(测量)。而「是否恶性」的金标准不来自标注医师,而来自活检病理或随访——这两条信息流在数据集里是分开交付的(标注 JSON + 活检结果字段/CSV)。这个设计让研究者可以自由选择监督信号:训练分割用标注、训练分类用病理标签、研究「影像标注 vs 病理结论」的分歧则两者对照。
3.4 官方页 FAQ 的标注宣称(口径存照)
官方页 FAQ 称标注走「multi-reader clinical workflow」,合格专家按共识流程标注,human-in-the-loop QA 保证一致性、降低观察者间变异,产出「regulatory-grade ground truth」。preprint 正文对应的是「Doer–Checker+共识」——两处口径兼容,但「multi-reader」在 preprint 中没有展开成读片一致性统计(如 kappa),数据集没有公开观察者间一致性指标(存照,见 §6.4 与坑 6)。
3.5 标注平台能力清单(官方口径展开)
官方页对 iMerit 乳腺影像标注工具的宣称逐条展开,都是 DBT 任务的关键能力:
- 多分辨率缩放(multi-resolution zoom):DBT 层内分辨率高、层厚小,病灶常需跨层连续放大定位——无分层缩放的标注工具在 DBT 上基本不可用;
- 并排对比(side-by-side comparisons):当前 view 与历史检查/对侧检查并排,是乳腺影像「找变化」的核心阅读方式;
- 对称对齐(symmetry alignment):左右乳镜像对齐显示——乳腺病灶的「不对称性」判读依赖此能力;
- 预标注(pre-labeling):模型预标注+人工修正的半自动流程,官方页作为提效手段宣称;
- 结构化报告+校准测量+审计跟踪:Ango Radiology Annotation Suite 平台级能力(preprint 口径),保证测量可复现、过程可审计。
这套能力清单可直接抄进任何团队的标注平台选型文档——它是「DBT 标注工具最低可用线」的现成答案。
3.6 标注生产模式对照:三种流派
把本库的标注生产放进行业坐标系,与库内条目代表的另两种流派对照:
| 流派 | 代表 | 执行层 | 复核层 | 终审层 | 适用 |
|---|---|---|---|---|---|
| 专业医师全链 | 本库 | 印度资深放射医师 | 同侪 Checker | 美国 MQSA 医师 | 高复杂度三维影像、监管级宣称 |
| 学生流水线 | PANDA-PLUS(rid 640) | pre-med 学生 | 高年级学生 | 30 年经验病理专家(每周 2-4 h) | 大量二维 WSI、预算敏感、协议可标准化 |
| 多专家独立双标 | 经典 CAD 时代做法 | 多名医师独立标注 | 仲裁共识 | — | 一致性研究本身是目标时 |
本库模式的核心竞争力是监管级合规包装(FDA 510(k)/MQSA/HIPAA 工作流设计)+跨时区成本结构(美国协议/终审+印度执行);代价是标注成本显著高于学生流水线,因此只配了 558 例。三种流派没有优劣,只有任务复杂度×预算×合规要求的匹配问题。
3.7 审计跟踪为什么是标注资产的隐形价值
Ango Radiology Annotation Suite 的「audit-trailed version control」(preprint 原文)对使用者意味着三件事:
- 可追溯:每例标注的修改历史有版本记录——争议病灶可回放标注过程(虽然数据集发布物一般不含审计日志本体,但其存在约束了标注纪律);
- 可申诉:终审医师的修改建立在完整链路上,研究者发现疑似标注错误时,反馈给 Segmed 的争议有据可查;
- 可复制:协议+平台+审计的组合意味着换一个团队按同一 SOP 可以复刻同等质量的标注——这正是「标注即工艺」与「标注即手艺」的分野。
研究者侧的对应动作:把疑似错误按 case_id+view_id+病灶序号三元组反馈,别用「第几个图有问题」这种自由描述。
§4 人群构成与研究设计:富集队列的读法
4.1 一个反直觉的年龄与人群画像
平均年龄 57.5±11.1 岁,全部为 ≥18 岁女性——与乳腺癌筛查的主力年龄段(50-74 岁为主)吻合。BI-RADS 0/1/2 的入组限定意味着:这个库刻意排除了 BI-RADS 3-5 的「高嫌疑」人群,保留的是「筛查发现异常需召回(0)」与「影像基本正常/良性(1/2)」的世界。换句话说,它模拟的是「筛查场景下的检测难题」——病灶藏在看似正常或轻微异常的乳腺里,而不是「已经很明显、就差确认」的诊断场景。
4.2 富集采样的双刃
队列构建时刻意优先纳入活检证实恶性患者,48.6% 的恶性比例在公开乳腺影像数据集里属于第一梯队(多数公开 DBT 库的恶性病例「相对较少」——这是 preprint 的核心动机陈述)。收益是训练信号密集:558 例里近一半是阳性,小样本也能训出有意义的模型。代价有三:
- 患病率失真:自然筛查人群的乳腺癌检出率约 0.5% 量级,本库是它的近千倍——任何「以患病率为先验」的实验设计(如筛查模拟、假阳性率预算)都必须重校准;
- 良性构成偏移:良性主体是临床认定的 B 组(140)与召回的 C 组(115),病理证实的良性只有 D 组 32 例;
- 单中心+富集:多样性双重受限,跨域泛化实验(跨医院、跨设备)不能用本库单独支撑。
4.3 病灶尺寸分布的暗示
官方页给出两个病灶尺寸数字:平均 1.34 cm、约 85% 病灶小于 2 cm。这与「筛查场景、BI-RADS 0-2 入组」自洽——被筛查影像发现且尚未到高嫌疑级别的病灶,多数是小病灶。对小病灶检测/分割研究者,这既是卖点(难样本密集),也是警告(极小病灶的标注边界精度依赖分割协议与测量工具校准)。
4.4 适合与不适合的研究设计
适合:病灶检测/分割模型训练与内部评测;良恶性分类;影像-报告对齐与报告生成(有自由文本报告);标注方法论研究(有完整流水线描述);小样本高监督密度的方法验证。
不适合:患病率敏感的筛查模拟(富集失真);人群流行病学推断(单中心+富集+仅女性≥18);跨设备域泛化基准(单中心);大规模预训练(558 例太小);任何商业用途(DUA 禁止)。
4.5 四组口径与 2D 库标签体系的映射
把 DBT-2026 的四组口径放进乳腺影像公开库的标签谱系里看,能更清楚它的定位:
| 库 | 标签体系 | 病理证实密度 | 与本库的映射关系 |
|---|---|---|---|
| 本库(DBT-2026) | 四组(A/B/C/D) | A+D 共 303 例(54.3%) | — |
| CBIS-DDSM(2D) | 良性/可疑/恶性 + BI-RADS | 全库病理/随访证实 | 其「恶性」≈本库 A;「良性」拆开对应本库 B/D |
| VinDr-Mammo(2D) | BI-RADS 1-5 四级别分类 | 低(BI-RADS 为主) | 其 BI-RADS 0 群体≈本库 C 的召回路径 |
| INbreast(2D) | BI-RADS+病变标注 | 部分 | 「小而精」哲学的 2D 先例 |
| MIAS(2D) | 正常/良性/恶性三类 | 影像判定为主 | 「正常≈1/2、恶性≈A」的粗映射 |
映射的启示:跨库做迁移或合并评测时,标签不可直接对齐——「良性」在不同库里证据强度不同(影像判定 vs 随访 vs 病理)。本库四组制把证据强度显式编码进组别,是跨库对齐时最值得参考的元数据设计。
4.6 BI-RADS 0/1/2 的临床含义展开
理解这个库为什么限定 BI-RADS 0/1/2,需要先理解这三个分级在筛查工作流里的位置:
- BI-RADS 0(需补充评估):筛查影像发现了「说不清」的异常,需要召回做补充拍摄或超声——本库 C 组(115 例非癌召回)大多从这条路径走来,A 组恶性也可能经由 0 级召回后活检证实;
- BI-RADS 1(阴性):影像未见异常;BI-RADS 2(良性征象):看到明确良性表现(如典型钙化、囊肿)——这两组构成「看着正常」的世界;
- BI-RADS 3-5(本库排除):可能良性需短期随访/可疑异常/高度怀疑恶性——即「已经进入诊断路径」的人群。
由此本库的难度画像清晰:在影像学上「大体正常或仅有轻微征象」的乳腺里,把藏着的病灶找出来、分出来、量出来。这与诊断场景(BI-RADS 3-5,病灶已显形,任务是定性)是两类问题。选库时先问自己的模型解决的是哪一类。
§5 获取与许可:一道表单门、两条取数路
5.1 两条取数路
- HuggingFace 样本包:
iMerit/3D-MammographyDataset,650 MB,imagefolder结构——sample_data/samplecase1/下是 DICOM 文件 +annotations.json+metadata.xlsx。用于看懂数据结构、打通读取管道、确认标注 schema。它不是全量(HF 页面 Size 标注 <1K),别在这上面跑基准然后发表(坑 2)。 - Segmed 表单(全量):
segmed.ai/resources/ai-for-impact-on-breast-cancer-dataset-form——注册、credentialing、签署 Data Use Agreement 后发放;preprint 明确「每位研究者须单独注册并同意条款」,权限「case-by-case」审核。免费(free to researchers),但非自动直链。
另有官方标注协议页(imerit.ai/annotation-protocol/)与联合发布公告页可作背景引用。
5.2 DUA 条款细读(五条红线)
preprint「Dataset publishing」段给出的条款清单:
- 仅限非商业研究用途;
- 禁止再分发或向他人共享数据;
- 禁止任何患者再识别尝试;
- 禁止用于临床决策;
- 版权归作者与 Segmed(all rights, title, and interest)。
HF 页面把同一约束体系命名为 Segmed–iMerit Joint Research Use Agreement(链接 segmed.ai/legal/joint-research-use-agreement),License 字段标为「other」。两个名字、一套条款——引用时建议用 HF 的具名协议并链接 DUA 原文。
5.3 「非商业」与官方页营销话术的表面冲突
官方页 FAQ 写「supports both research and commercial AI development stages」「ideal for … commercial AI development」——与 DUA 的非商业红线字面冲突。合理解读:官方页描述的是 iMerit/Segmed 数据服务整体的商业合作能力(即联系他们可以谈更大的多中心库与商用授权),而这份公开数据集本体受 DUA 约束、非商业。preprint 结尾「researchers can reach out to the authors to gain access to a more extensive multi-center database」正是这个通道。结论:拿公开版做商用前必须另行获得书面授权,别把 FAQ 话术当许可依据(坑 5)。
5.4 AI-Ready 评估:DAIMS 五维速览
| DAIMS 维度 | 评分 | 依据 |
|---|---|---|
| 可获取性 Accessible | ★★★☆☆ | 样本包公开直链;全量需注册+DUA+逐案审核,非直链、可预期等待 |
| 可交互性 Interoperable | ★★★★☆ | DICOM 原生 + NRRD + JSON + CSV/XLSX,主流工具链全覆盖;无官方加载库但格式标准 |
| 可复用性 Reusable | ★★★★☆ | 四组临床口径+活检金标准+报告文本+完整标注方法论描述(preprint) |
| 可持续性 Sustainable | ★★★☆☆ | 三方机构背书、preprint 存档 DOI;但版权归作者与 Segmed、无版本承诺、发布历史仅 v1 |
| 许可清晰度 Licensed | ★★★★☆ | DUA 五条红线明确、协议具名可查;扣分点:FAQ 商用话术与条款的表面冲突需自行澄清 |
综合判断:AI-Ready 光谱中「登记获取型」——比完全开放的 TCIA 库多一道人工门,比纯联系作者的请求制多一层平台化表单与标准协议,属于 2D 钼靶大库与临床受控库之间的中间形态。
5.5 与库内可获取性光谱的对照
库内乳腺影像条目的获取形态:CBIS-DDSM/INbreast/MIAS 为直链公开;VinDr-Mammo 为竞赛/HF 直链;BCDR 为注册请求制;本条目为表单+DUA 登记制。检索者按「能不能直接下、要不要签协议、能不能商用」三问选库时,本条目的答案依次是:不能直接下(除样本包)、要签、不能。
5.6 获取时间线预期与申请要点
表单获取没有公开的 SLA,按「注册+credentialing+逐案审核」流程可合理预期数个工作日的等待。申请材料里写清楚三件事能显著降低往返成本:
- 研究用途一句话:非商业研究(DUA 红线内的具体任务,如「DBT 病灶分割方法研究」);
- 机构与研究者身份:DUA 是研究者个人逐一签署,别用课题组集体账号申请;
- 存储与合规承诺:明确数据存放环境与不再分发的技术/管理措施。
注意两条「不要」:不要在申请信里写任何商业含义(会触发逐案否决路径);不要申请到数据后转发给未签约同事——DUA 明文禁止共享,且这是机构间合作数据,违规成本由签署人承担。
5.7 与库内可获取性光谱的对照(展开)
以「从检索到跑通第一个 batch 的时长」为标尺,库内乳腺影像条目构成一条光谱:
- 直链即得(分钟级):CBIS-DDSM、INbreast、MIAS——下载即用,2D 格式读取无门槛;
- 平台直链(分钟到小时级):VinDr-Mammo——竞赛/HF 渠道,量大需带宽;
- 注册请求(天级):BCDR——注册审批后发放;
- 表单+DUA(天级+合规准备):本库——先跑 HF 样本包可把「拿到全量」前的管道开发全部前置,实际等待只影响实验规模,不影响工程进度。
建议的排期:第 1 天跑通样本包读取+标注 schema 盘点;第 1-5 天(等待审核期)完成 2D 侧基线(用库内 2D 库);拿到全量后直接进入三维实验。这个排期把本库的获取门槛对总进度的影响压到最低。
§6 生态与影响:在 DBT 公开数据谱系中的位置
6.1 DBT 公开数据集景观:大而全 vs 小而精
DBT 公开数据的世界里,绕不开的对照物是 BCS-DBT(Duke DBT):Buda、Saha 等人 2021 年发布(JAMA Network Open),5,060 名患者、22,032 个扫描、约 1,526 GB 压缩 DICOM,CC BY-NC 4.0 于 TCIA 公开直链,并作为 DBTex/DBTex2 挑战赛(SPIE-AAPM-NCI-DAIR)的赛题数据——它定义了「DBT 公开基准」的规模上限,配套 lesion 框标注与官方读取工具 duke-dbt-data。
preprint 对这类库的评价一针见血:「大多数公开 DBT 数据集的恶性患者数相对偏少」。BCS-DBT 的 5,060 患者中恶性肿瘤占比远低于 DBT-2026 的 48.6%——前者靠量堆出统计功效,后者靠富集采样把监督信号做密。
| 维度 | DBT-2026(本条目) | BCS-DBT(Duke) |
|---|---|---|
| 患者/检查 | 558/558(讨论章节另有 1,110 口径,存照) | 5,060 患者 / 22,032 扫描 |
| 恶性构成 | 271 例活检证实(48.6%) | 恶性占比相对低(含 normal/actionable/benign/cancer) |
| 金标准 | 活检病理或随访 + 专家分割 | 影像框标注(truth boxes) |
| 报告文本 | 有(自由文本) | 无 |
| 公开方式 | 表单+DUA(逐案) | TCIA 直链(CC BY-NC 4.0) |
| 配套基准 | 无官方排行榜 | DBTex/DBTex2 挑战赛 |
| 配套工具 | 无官方库 | duke-dbt-data(Python) |
两库关系是互补而非竞争:方法开发期用 DBT-2026 的高密度监督快速迭代,规模化验证再上 BCS-DBT;影像-报告多模态只能用前者。
6.2 2D 钼靶世界的锚点
库内既有乳腺条目(CBIS-DDSM 541、INbreast 542、VinDr-Mammo 543、MIAS 801)覆盖了 2D 钼靶的「病理证实评测」「高精度标注」「大规模 BI-RADS」「经典小库」四种形态。DBT-2026 在维度上多了两件 2D 库没有的东西:三维体数据(组织重叠被拆开)与配对放射报告。从 2D 迁移到本库的研究者,主要工程成本在 DICOM 三维体读取与显存管理(单 view 数百层切片)。
6.3 临床证据底座
DBT 的临床价值有五项标志性人群试验背书(均为 preprint 引文):STORM(Lancet Oncology 2013,前瞻对比筛查)、Skaane 等(Radiology 2013,人群筛查项目对比)、Friedewald 等(JAMA 2014,DBT+2D 联合筛查)、Rafferty 等(JAMA 2016,致密/非致密乳腺分层)、McDonald 等(JAMA Oncology 2016,三年结局分析)——共同结论:提高浸润性癌检出率、降低假阳性召回。技术原理上溯至 Niklason 等(Radiology 1997)的断层合成奠基论文。写论文引言时,这条证据链可以直接从 preprint 引文列表取用。
6.4 无基准的空档与机会
截至抓取时点(2026-10-09),DBT-2026 没有官方基准模型、排行榜或结果章节——preprint 是纯数据集描述论文。这对使用者是空档也是机会:第一个在本库上发布严谨协议评测(尤其 A+D 病理金标准子集)的团队将定义该库的基准线。反过来说,发表前要与「用 BCS-DBT/DBTex 排行榜」的工作保持可比性,需明确写清子集与金标准口径(见 §4.2 的分层)。
6.5 库内乳腺条目组合使用手册
五条互链条目与本库能组成的实验组合(rid 供站内互链跳转):
- × VinDr-Mammo(rid 543):「2D 预训练→3D 微调」流水线验证。用其两万例级 2D 钼靶做 backbone 预训练,再迁到本库三维体上微调,是检验「2D 大数据先验能否迁移到 DBT」的标准实验设计;BI-RADS 分级标签与本库四组标签的语义映射(§4.5)是迁移函数的输入。
- × CBIS-DDSM(rid 541):「2D 病理证实基线 vs 3D 病理证实基线」。两边都以病理证实为金标准,可做「模态对监督需求」的对照实验:同样 300 例级病理子集,2D 与 3D 各能撑起多大容量的模型。
- × INbreast(rid 542):标注密度方法论对照。两者都走「少而精」路线,INbreast 以高分辨率 2D+精细标注著称,本库以三维体+多资产著称——合写「乳腺影像标注密度演进」综述时是天然的两代样本。
- × BCDR(rid 800):DBT 形态对照。BCDR 的 DBT 部分以重建切片形态交付,本库交付完整 DICOM 三维体+活检金标准+报告;做「DBT 数据交付形态对可复现性影响」的工程研究时,两者是仅有的库内 DBT 素材。
- × MIAS(rid 801):三十年时间机器。MIAS(1990 年代胶片数字化、322 张 2D)与本库(2026 年原生三维、558 例多资产)并置,直接可视化「数据集密度定律」——单位病例携带的监督信息量三十年增长数个量级,而获取门槛从「寄磁带」变成「签 DUA」。
组合使用的共同前提:跨库一律按各自许可条款独立合规——本库 DUA 的「禁再分发」意味着不能把本库数据与直链库合并打包再发布,只能发布跨库评测协议与代码。
6.6 三方角色分工:谁出了什么
这个数据集是三方各自贡献核心能力拼出来的,理解分工有助于判断「出了问题找谁、扩展合作谈什么」:
| 角色 | 机构 | 贡献 | 行业身份 |
|---|---|---|---|
| 数据源头 | Advocate Health | 临床筛查检查(单医院)、临床专家(协议制定、MQSA 终审、Amy Sobel 医师参与论文) | 美国大型非营利医疗系统 |
| 数据管道与发布 | Segmed | Piper(PACS 采集)、Openda(队列检索)、去标识、表单发放、DUA 托管、版权共同持有 | 医学影像真实世界数据平台 |
| 标注与产品化 | iMerit | Scholars 放射医师团队、Ango 标注平台、标注协议工程化、发布页与新闻发布 | AI 数据标注服务商 |
对研究者的含义:数据问题(内容、口径、发放)找 Segmed(DUA 括版权在「作者与 Segmed」);标注问题(schema、协议细节)参考官方标注协议页;扩展数据(多中心库)联系作者(preprint 明示通道)。
6.7 发布链时间线
从公告到可检索资产的完整链条(均已在三源核验中确认存在):
- 联合新闻发布:iMerit 官网 press 页,宣布三方合作与免费开放标注 DBT 数据集(官方页 announcement 链接);
- 官方发布页:imerit.net/3d-mammogram-dataset——Dataset Summary 数字、下载入口、FAQ、preprint 引用格式集中地;
- medRxiv preprint:2026-03(编号 2026.03.03.25337924),方法学与条款的权威口径;
- HuggingFace 样本包:iMerit/3D-MammographyDataset,工程入口;
- (未见)同行评审版:截至 2026-10-09 抓取时点未检出期刊版本——引用时按 preprint 引用,投稿自己的论文时留意作者团队是否已更新版本。
这条链的形态是「营销页(数字全但口径松)+ preprint(口径严但表格动态)+ HF(工程但仅样本)」三件套——三方互证正是本条目 FACTS 的核验方法,检索者引用数字时的优先级应为 preprint > 官方页 > HF 页面描述。
6.8 乳腺影像公开数据集时间线(检索锚点)
把本库放进三十年的乳腺影像公开数据谱系,检索与综述写作可直接引用这条时间线:
| 时期 | 数据集 | 形态 | 意义 |
|---|---|---|---|
| 1990s | MIAS(库内 rid 801) | 胶片数字化 2D,322 张 | 乳腺影像公开库的起点 |
| 2000s | DDSM | 2D 胶片数字化,大规模 | CAD 时代的标准语料 |
| 2017 | CBIS-DDSM(rid 541) | DDSM 的挑选+标准化重制版 | 病理证实 2D 评测标准 |
| 2010s | INbreast(rid 542)/ BCDR(rid 800) | 现代 DR 2D(BCDR 含 DBT 切片) | 高分辨率+精细标注+多源 |
| 2021 | BCS-DBT(Duke) | DBT 三维体,5,060 患者 | DBT 公开规模之最+DBTex 挑战赛 |
| 2023 | VinDr-Mammo(rid 543) | 2D 钼靶两万例级 BI-RADS | 2D 大规模基准成熟 |
| 2026 | 本库(DBT-2026) | DBT 558 例+活检金标准+报告 | DBT 小而精路线+多资产三合一 |
规律清晰可见:2D 走完了「小→大→标注精细化→大规模基准」的完整循环;DBT 正处在「大库已现(BCS-DBT)、精标补位(本库)」的 2026 节点。按 2D 的历史剧本,DBT 接下来大概率出现大规模 BI-RADS 基准与像素级/病灶级精细标注的融合库——本库的标注 schema 与四组口径是那个未来库的候选模板。
§7 方法学启示:三条可迁移的经验
7.1 「临床路径分层」是标注库组织的高级形态
把队列按「处置路径+证据强度」切成四组(恶性/良性/召回/活检证实良性),比「阳性/阴性」二分保留了多得多的研究自由度——金标准强度、召回机制、随访状态都被编码进组别。任何做筛查类数据集的团队都值得抄这个分组法。
7.2 金标准与标注分离交付
「影像标注(医师画的)」与「病理结论(活检出的)」作为两条独立信息流交付,而非合并成一个标签——这让「影像-病理分歧」本身成为可研究对象。合并标签看似省事,实际抹掉了监督信号的证据强度维度。
7.3 去标识化的三段兜底可以复用
OCR(图像烧录文字)→ NLP+LLM(文本 PHI 移除)→ 专家人工复核——这个顺序对任何「影像+文本」成对发布的医学数据集都适用:只清洗文本不清洗图像烧录文字,是真实世界数据公开中最常见的翻车点。
7.4 单中心数据的方法论补偿
单中心是 preprint 自认的头号局限,但方法学上有成熟补偿手段,研究者可按需取用:
- 病例内数据增强:DBT 三维体的角度扰动、强度抖动、层内翻转(注意 CC/MLO 解剖约束下允许的翻转方向)扩大有效多样性;
- 跨库外部验证:用 BCS-DBT(直链可得)做外部测试集,把「单中心训练」的泛化缺口量化出来——这本身就是一个可发表的结果;
- 多中心扩展通道:如 §5.2 所述,作者明示可申请更大的多中心库,正式发表前的规模化验证有官方路径;
- 域自适应报告:论文里显式报告设备型号与采集参数(从 DICOM 元数据提取),让后续研究者能评估跨域风险。
单中心+富集的队列,最怕的是被当成「通用 DBT 基准」使用——把它当「高密度监督的方法开发沙盘」,限制就变成了设计特征。
7.5 RWD 平台化的行业样本
Segmed 在本库中展示的管道——「PACS 自动对接(Piper)→ 队列检索(Openda)→ 去标识 → 标注(外包给 iMerit)→ 表单化发布」——是医学真实世界数据(RWD)平台化的一个完整样本。三个可借鉴的设计:
- 采集与发布解耦:医院不需要为发布做额外 IT 工作(Piper 常驻对接),数据「顺流而下」进入平台;这显著降低了单中心参与数据集建设的门槛——也是本库能从一家医院长出来的原因;
- 去标识内置于管道:OCR+NLP+LLM+人工不是发布前的临时动作,而是管道的标准环节;
- 合规前置:DUA 在发放前签署、逐案审核,把合规成本从「事后追责」前移到「准入控制」。
对想建设自家数据集的临床团队,这个样本说明:不需要自建标注团队(可外包给 iMerit 类服务商)+不需要自建发放门户(可托管给 Segmed 类平台),核心贡献是数据源头与临床专家的协议/终审能力——分工比全能更可持续。
7.6 「免费但非开源」的许可传播学
本库的许可形态(免费获取+具名协议+红线条款+版权保留)介于开源数据(CC 系)与封闭数据(申请制无标准条款)之间。对数据集发布者的三条启示:
- 具名协议比「详见网站」可传播:Segmed–iMerit Joint Research Use Agreement 有固定 URL 与全文,被引用、被审查、被比较的成本都低——条款传播得越广,合规误用越少;
- 红线要短且可数:本库 DUA 五条红线(非商业/禁再分发/禁再识别/禁临床决策/版权保留)一句话能复述——对比动辄数页的法务文本,短清单在研究者侧的实际遵从率更高;
- 免费≠无门槛是特性不是缺陷:逐案审核筛选出的使用者群体更严肃,反过来保护了数据提供医院(Advocate Health)继续参与的动力。
对使用者的镜像启示:把 DUA 条款写进实验室的数据管理 SOP 与新人培训,比指望每人自己读一遍协议更可靠。
§8 与库内条目的关系
8.1 家族图谱与互链点
- VinDr-Mammo(rid 543):2D 钼靶大规模 BI-RADS 基准。与本库构成「2D 大规模 vs 3D 小而精」的光谱两端;其四级别 BI-RADS 标签体系与本库四组临床口径可做迁移映射讨论。
- CBIS-DDSM(rid 541):2D 钼靶 CAD 研究标准评测集。同为「病理证实」取向的经典库——本库可视为「DBT 版的病理证实评测」尝试,但量级小一个数量级。
- INbreast(rid 542):高精度标注 2D 钼靶(葡萄牙)。与本库同样走「少而精」路线,是标注密度哲学在 2D 时代的先例。
- BCDR(rid 800):葡萄牙波尔图多源乳腺库,含 DBT 重建切片——库内最接近的 DBT 相关条目。差异:BCDR 的 DBT 部分以切片形态交付、不含本库规模的活检金标准与报告文本;本库交付完整 DICOM 三维体。
- MIAS(rid 801):1990 年代的经典小库。与本库对照「三十年间乳腺影像数据集的密度跃迁」——MIAS 322 张 2D 胶片数字化图 vs 本库 558 例三维体+病理+报告。
8.2 检索路径建议
按「乳腺 X 线/钼靶/mammography/mammo/DBT/tomosynthesis」检索本库时,注意排除 ddti(rid 536)——Digital Database Thyroid Image 是甲状腺超声库,缩写与 DBT 高度形似,纯字符串匹配容易误召回(坑 1)。
8.3 防混淆声明:ddti 与 BCDR
ddti(rid 536)≠ DBT。 ddti 是 Digital Database Thyroid Image(甲状腺超声,哥伦比亚国立大学 Cim@Lab,637 张像素级标注甲状腺 B 超图),缩写与 DBT(Digital Breast Tomosynthesis)高度形似。本条目查重时实跑 SQL:url_name ILIKE '%dbt%' 不命中 ddti(其 url_name 不含 dbt 字样),但人类检索与 LLM 召回都极易误配。判别口诀:看模态——超声 vs X 线断层,一眼分辨。
BCDR(rid 800)≠ 本库。 BCDR(Breast Cancer Digital Repository,葡萄牙波尔图)确实是乳腺库且含 DBT 形态数据,是库内与「DBT」语义最接近的既有条目;但其 DBT 部分以重建切片交付、规模与金标准配置和本库不同(本库=完整三维体+48.6% 活检证实恶性+配对报告)。两者是「同模态、不同交付与定位」,互链时写明差异即可,不构成别名关系。
8.4 引用一致性纪律(三则)
- 规模数字只用 558(摘要口径),1,110 只作为「口径冲突存照」出现;
- 恶性占比统一写 48.6% 并注明「活检证实恶性」,不要写「恶性肿瘤占比 48.6%」这种把临床组别当病理比例的简称;
- 许可引用到具名协议(Segmed–iMerit Joint Research Use Agreement)+链接 DUA 原文,不写「开源」「开放许可」——它是免费获取的受限许可,不是开源。
8.5 库内标签网络中的位置(互链逻辑)
本库的 category_tags(医学影像/X光影像/乳腺影像/医学图像分割/乳腺癌/评测基准)把它接入库内标签网络的六个节点:
- 医学影像+X光影像+乳腺影像:与 rid 541/542/543/800/801 构成乳腺影像完整家族——DBT 补齐了该家族缺失的三维体成员;
- 医学图像分割:与病理分割(panda-plus 等)、CT/超声分割条目共享「分割监督」方法论话题——DBT 分割的三维体特性让本库在该话题下独树一帜;
- 乳腺癌+评测基准:与各肿瘤影像评测库同属「以癌检出为目标的结构化评测」家族——本库的四组口径为该家族贡献了「临床路径分层」的新维度。
站内检索「乳腺影像」标签时,本条目是唯一 DBT 成员;检索「乳腺癌」标签时,本条目是少有的「病理金标准+三维体」双持成员——两个标签都是本库的强互链入口。
§9 避坑清单:八个已踩过或必踩的坑
坑 1:ddti 撞名——不是 DBT,是甲状腺。
库内 ddti(Digital Database Thyroid Image,哥伦比亚国立大学)是 637 张甲状腺超声图。检索 DBT(Digital Breast Tomosynthesis)时按字符串匹配会命中它;本条目查重时已实跑 SQL 验证二者无关。判据:看 modality 与描述,别看缩写。
坑 2:HuggingFace 上的 650 MB 不是全量。
iMerit/3D-MammographyDataset 页面 Size <1K、650 MB,内容是 sample_data(示例病例+annotations.json+metadata.xlsx)。全量 558 例走 Segmed 表单。用样本包跑完实验就写论文,审稿人一问规模就穿帮。
坑 3:DOI 前缀是 10.64898,不是 10.1101。
medRxiv 常规 DOI 前缀是 10.1101,本 preprint 是 10.64898(medRxiv 新前缀体系)。把 URL 手拼成 medrxiv.org/content/10.1101/2026.03.03.25337924v1 会落到 medRxiv 的帮助页(本条目核查时实测);正确地址 medrxiv.org/content/10.64898/2026.03.03.25337924v1.full。
坑 4:558 还是 1,110?
preprint 摘要与结果写「558 DBT exams from 558 patients」,讨论章节却写「a dataset of 1,110 DBT exams from 558 patients」。1,110 疑为 view/体数据总数(558×2≈1,116)或笔误,官方无澄清。全文数字以摘要口径 558 为准,引用 1,110 时必须注明出处矛盾。
坑 5:官方页的「commercial」话术不是许可。
DUA 白纸黑字「非商业研究专用」,官方页 FAQ 却宣传支持商业 AI 开发。许可判断只认 DUA 原文(segmed.ai/legal/joint-research-use-agreement);商用先找作者/Segmed 拿书面扩展授权。
坑 6:没有公开的观察者间一致性指标。
「multi-reader」「regulatory-grade」「Doer–Checker」都是流程宣称,preprint 未给 kappa/一致性统计。把标注当绝对金标准做极限性能对比时,结论要留余地。
坑 7:48.5% vs 48.6% 的四舍五入口径。
官方页写 271 malignant (48.5%),preprint 讨论写 48.6%(271/558=48.566%)。差异无害,但同一篇稿子混用两个数会被当数字错误;建议统一 48.6% 并注明出处。
坑 8:一个 DICOM 文件是一个三维体,不是一张图。
DBT 的压缩 DICOM 每文件含整个 view 的三维像素数组,按 2D 方式读会得到一张奇怪的「投影」或直接报错;需 GDCM/ITK/pydicom+解码插件解压成三维数组再切片。HF 样本包就是用来打通这条读取管道的——先跑样本包再申请全量。
§10 总结
10.1 三句话总结
- 3D Mammogram Dataset(preprint 名 DBT-2026)是 iMerit × Segmed × Advocate Health 三方发布的 558 例开放标注 DBT 数据集,48.6% 为活检证实恶性,带专家分割标注、去标识放射报告与四组临床分层。
- 它的价值在监督密度而非规模:三维体数据+病理金标准+报告文本三合一,是 DBT 公开谱系里「小而精」路线的代表,与 Duke BCS-DBT 的「大而全」互补。
- 获取走 Segmed 表单(注册+DUA,非商业专用),HuggingFace 650 MB 仅为样本包;无官方基准,首评测者自定协议。
10.2 适合谁
做 DBT 病灶检测/分割与良恶性分类的模型团队;需要影像-报告配对数据做多模态(报告生成/对齐)的研究者;研究标注方法论与去标识化流水线的工程团队;在 2D 钼靶库上已到瓶颈、需要三维体数据验证方法的小样本方法学者。
10.3 不适合谁
需要大规模预训练语料的团队(558 例太小);患病率敏感的筛查模拟与流行病学推断(富集+单中心);要商用部署的训练方(DUA 禁止商用);指望直链下载立刻开跑的快速验证者(表单+逐案审核有等待期)。
10.4 30 秒决策卡
- 想看结构?→ HF 样本包(650 MB,免注册)。
- 想全量?→ Segmed 表单,注册+credentialing+DUA。
- 要病理金标准子集?→ 只用 A 组 271 + D 组 32。
- 要报告文本?→ 全库自带,已去标识。
- 要商用?→ 先拿书面授权,否则止步。
- 要大规模对比?→ 换 BCS-DBT(TCIA 直链)。
- 检索撞上 ddti?→ 那是甲状腺超声,走错了。
FAQ(高频问答 51 问)
A. 基础认知
Q1:3D Mammogram Dataset 和 DBT-2026 是同一个东西吗?
是。官方发布名 3D Mammogram Dataset,preprint 里自称 DBT-2026,HF 仓库名 iMerit/3D-MammographyDataset,三个名字一个实体。
Q2:DBT 和普通钼靶(2D mammography)差别在哪?
DBT 让球管在有限弧度内采多个低剂量角度投影、重建准三维薄层切片,减少组织重叠;临床证据显示浸润性癌检出率更高、假阳性召回更低。本库每个 view 就是一个这样的三维体。
Q3:数据是哪来的?
美国中西部一家医院(隶属 Advocate Health 体系)的常规筛查检查,经 Segmed Piper 从 PACS 自动采集,DICOM 原始格式,回顾性、免知情同意(豁免)+ 去标识。
Q4:什么时候发布的?
2026 年 3 月(preprint 编号 2026.03.03.25337924),截至 2026-10 抓取时点未见同行评审版本。
B. 数据与获取
Q5:数据什么格式、多大?
压缩 DICOM(1 view=1 文件=1 三维体)+ NRRD + JSON 标注 + CSV/XLSX 元数据;HF 样本包 650 MB;全量体积未披露(估计数百 GB,申请时与 Segmed 确认)。
Q6:怎么下载?
样本包:HF 直接下。全量:segmed.ai/resources/ai-for-impact-on-breast-cancer-dataset-form 表单,每位研究者单独注册、credentialing、签 DUA,逐案审核后发放,免费。
Q7:能在论文里直接放图吗?
DUA 未授权再分发——论文里放示意性结果图属常规学术合理使用范畴,但整病例数据再打包发布明确违规;拿不准时问 Segmed。
Q8:现在还能联系到团队拿更多数据吗?
可以。preprint 明说研究者可联系作者获取「更广泛的多中心数据库」——这是官方唯一的扩展数据通道。
C. 人群与口径
Q9:四组(271/140/115/32)到底怎么用?
病理金标准评测用 A+D(303 例);全库训练用四组;对照「官方页 271 vs 287」口径时先写清分母定义。
Q10:为什么 BI-RADS 只收 0/1/2?
定位是筛查场景检测题——找藏在基本正常乳腺里的病灶;BI-RADS 3-5 的高嫌疑诊断场景不在此库。
Q11:有正常(完全无异常)的病例吗?
BI-RADS 1/2 属于影像阴性/良性范畴,但本库经富集采样偏向有病灶与有事件的病例;「纯粹正常对照组」不是它的设计目标,分组以四组口径为准。
Q12:年龄、种族信息有吗?
有。CSV 含年龄、性别、种族、族裔;平均年龄 57.5±11.1 岁,全女性。
D. 标注与质量
Q13:标注包括什么?
病灶定位(框)、表征(类别)、分割(轮廓)、测量(尺寸);由印度资深乳腺放射医师按美国专家制定的协议在 Ango 平台完成。
Q14:标注质量和病理结论谁说了算?
两回事:标注是影像学事实(画在哪/是什么/多大),病理是结局金标准(是否恶性)。DUA 数据里两条信息流分开交付,别混成一个标签用。
Q15:有观察者间一致性数据吗?
没有公开。流程宣称(Doer–Checker、共识、MQSA 终审)都在,kappa 没给——引用时留余地。
E. 工程与复现
Q16:怎么读这些 DICOM?
GDCM/dcmtk 解压 → ITK/pydicom 读成三维数组 → 按层切或整体喂模型。先拿 HF 样本包打通管道,注意部分文件是压缩传输语法。
Q17:有官方代码库吗?
截至抓取时点未见官方加载/评测工具(对照:Duke BCS-DBT 有 duke-dbt-data)。用 HF 样本包里的 annotations.json schema 自写 loader。
Q18:官方跑过基准模型吗?
没有。preprint 是纯数据集描述,无模型无排行榜;首评测者自定协议并公开代码即可立标杆。
F. 检索与库内
Q19:在本库检索 DBT 类条目要注意什么?
排除 ddti(甲状腺超声,缩写形似);BCDR(rid 800)含 DBT 切片但形态与本库不同;其余乳腺条目(541/542/543/801)均为 2D。
Q20:引用格式?
Wu J, Perandini L, Batra T, Igoshin S, Bari S, de Araujo AL, Willemink MJ. DBT-2026, a de-identified publicly available dataset of digital breast tomosynthesis exams with ground truth biopsies. medRxiv 2026.03.03.25337924; doi:10.64898/2026.03.03.25337924。
G. 工程细节
Q21:显存怎么规划?
一个 DBT view 是数百层切片的三维体,整 view 进显存对常见 GPU 不现实。主流做法:层内 2D 切片栈训练(把 view 当多切片集)、2.5D(相邻层堆叠成多通道)、或降采样后 3D patch。先在样本包上量出实际帧数与分辨率再定方案。
Q22:切分协议怎么定才不泄漏?
按 case 切(§2.7 三层嵌套),A/B/C/D 分组分层抽样保证各组比例;任何跨 view/跨 lesion 的随机切分都会让同一患者的数据跨 train/test,指标虚高。
Q23:标注 JSON 的坐标系怎么对齐?
以样本包 annotations.json 实测 schema 为准;病灶几何相对 view 帧坐标存储时,注意多帧体的层方向与 DICOM 几何标签的一致性(§2.6 第 4 条)。
Q24:报告文本可以直接进 LLM 微调吗?
可以但先做两件事:确认去标识完整性(本库已三重处理,仍建议抽检);按 case 而非按句切分,保留整例报告的完整性。
Q25:NRRD 和 DICOM 内容一致吗?
官方页把 NRRD 列为输出格式之一;两者应同源。做定量实验固定用一种格式并在论文写明,避免双格式解析差异引入的噪声。
H. 合规与发布
Q26:学生/临时人员能用我的账号访问吗?
不能。DUA 要求每位研究者单独注册签署,共享访问即「向他人共享数据」,属明文禁止项。
Q27:结果模型可以开源吗?
模型权重不含患者数据,一般可开源;但训练代码里内嵌的任何数据片段(哪怕是示例 DICOM 转储)不得随仓库发布。稳妥做法:开源代码+权重,数据链接指向 Segmed 表单。
Q28:能发表阴性结果/基准对比吗?
DUA 只限制数据流转与用途性质(非商业、非临床决策),不限制学术发表;基准对比请遵守 §6.4 的口径透明原则。
Q29:本库数据能用于竞赛吗?
竞赛属公开分发场景,与「禁再分发」条款存在张力——组委会模式(数据驻留、提交预测评审)可行,直接发放给参赛者不可行。有此计划先问 Segmed。
Q30:抓取本条目信息时最可靠的三个来源?
官方页 imerit.net/3d-mammogram-dataset/(规模与获取口径)、medRxiv preprint(方法学与条款细节)、HF 样本包(实测 schema)。三方一致处为硬事实,出入处见附录 F 存照表。
I. 数据安全
Q31:数据放在什么环境合规?
DUA 要求不得再分发、不得尝试再识别——数据应存放在访问受控的研究环境(课题组服务器/机构云盘+权限组管理),避免个人笔记本散拷与公共网盘。去标识数据不等于可公开数据,存储纪律按可识别敏感数据对待。
Q32:如果发现疑似未去标识的信息怎么办?
停止使用该 case、立即通知 Segmed/作者(DUA 精神下的披露义务),不要截图转发或写进 issue——这是使用去标识医学数据的标准响应姿势。
J. 术语速答
Q33:「3D mammography」和 DBT 是一回事吗?
是。DBT 的通俗叫法即 3D 乳腺 X 线/3D 钼靶;文献里 digital breast tomosynthesis、3D mammography、tomosynthesis 混用。正式场合建议用 DBT 全称。
Q34:「actionable」是什么意思?
乳腺筛查语境指「需要临床行动的发现」(召回/活检/短期随访)。BCS-DBT 用 normal/actionable 分组;本库的 C 组(召回)大体对应 actionable 中未确诊癌的部分,但分组口径不同库不同,别直接画等号。
Q35:为什么条目名用 slug「3d-mammogram」?
slug 取自官方发布页 URL(imerit.net/3d-mammogram-dataset)与 HF 仓库名(3D-MammographyDataset)的公约数,是三个官方渠道名称里最短稳定的检索锚点。
Q36:本条目的数字以后会变吗?
会变的候选点:同行评审后 preprint 数字可能修订;作者团队的多中心扩展库若发布,规模口径将更新。本条目存照抓取时点 2026-10-09,引用时以最新官方版本为准。
K. 深度问题
Q37:为什么这个库选择 558 例而不是等攒到几千例再发布?
preprint 的逻辑是「高质量 ground truth 的公开 DBT 数据缺口」是当下痛点,富集采样让 558 例里能榨出 271 例病理证实恶性——先满足「有金标准的小规模严格评测」,比「再等三年攒大库」更解渴。这也是发布方明示后续可谈更大多中心库的原因。
Q38:单中心数据训出的模型论文好发吗?
取决于主张范围。方法论文(架构/损失/训练策略)用单中心库开发+外部库验证是标准打法;直接主张「通用 DBT 检测性能」会被审稿人拿单中心质询。preprint 自认单中心局限等于给使用者画了主张边界。
Q39:报告文本和标注会不会重复?
不重复且互补:标注是结构化几何(在哪/多大),报告是叙事性解读(什么样/像什么/建议什么)。两者交叉正是「结构化监督 vs 语言监督」的研究素材。
Q40:这个库能支撑毕业论文体量的工作吗?
可以:分割方法+外部验证(§附录 O 选题 1)、影像-报告对齐(选题 2)、假阳性画像(选题 4)任一方向都有足够的展开空间——但要搭配 BCS-DBT 或库内 2D 库做规模化面,别把三个方向压在一个 558 例库上。
L. 与临床指南的关系
Q41:数据集里的 BI-RADS 是谁评的?
日常临床实践的读片医师(报告中给出),随 CSV 元数据交付;preprint 未单独披露评分者资质明细——MQSA 认证医师的终审针对的是研究标注,不是原始 BI-RADS 评分(两者别混)。
Q42:能用这个库做 CAD 产品的注册申报吗?
不能直接用。DUA 明确「禁止用于临床决策」且非商业;注册申报属商业+临床决策域,需要与版权方另行签商业协议——公开版数据集的定位是研究。
Q43:DBT 筛查的指南地位会影响数据集价值吗?
会正向影响。DBT 在多国筛查指南中的渗透率上升(临床证据链见 §6.3),工具类数据集的价值随模态普及同步上升——这也是 2026 年发布 DBT 精标库的时机逻辑。
M. 方法研究
Q44:分割和检测哪个先做?
先检测后分割的顺序更稳:病灶框(定位)容易验证、分割轮廓受层间各向异性影响更大;且检测器能先行过滤「值得分割」的区域,把三维分割算力花在刀刃上。
Q45:四组标签能直接当多分类训练吗?
可以但要想清楚标签语义:A/B/C/D 是「处置路径+证据强度」的组合而非互斥病种;直接四分类时模型学到的主要是影像学恶性征象强弱(A>C≈B>D 的可疑度梯度),把它解释成「四类病」是过度解读。
Q46:外部验证选哪个库?
首推 BCS-DBT(同模态、直链、体量大);做跨模态稳健性可加库内 2D 库(CBIS-DDSM/INbreast)做「DBT vs 2D」的病灶可比对子研究。跨库标签口径对照见 §4.5。
Q47:报告生成任务的参考标准怎么定?
没有官方分割协议时,常见做法:用四组+BI-RADS 字段做结构化参考、用原报告做文本参考、用标注病灶做事实一致性检查(生成描述 vs 标注几何)。三层参考缺一不可,只对 BLEU 会得到「流畅但胡说」的生成器。
N. 存照与争议
Q48:1,110 那个口径有没有可能是「view 总数」?
有可能(558×2≈1,116)但无法证实——preprint 无澄清、官方页无补充。本条目按摘要 558 成稿;拿到全量后逐例清点 view 数(§2.9 体检第 2 项)是该疑点唯一的一手验证途径。
Q49:48.5% 和 48.6% 到底引用哪个?
都源于 271/558=48.566%:preprint 取 48.6%、官方页取 48.5%。学术写作跟 preprint(48.6%);营销/摘要场合两可但全文统一即可。
Q50:官方页和 preprint 还有哪些隐性出入?
逐条对照后的实质出入只有标题称呼(存照 3)与商用话术(存照 5);其余为四舍五入与聚合口径差异(存照 1/2/4/6)。整体而言三方口径一致性良好,这在营销页+preprint 组合里属于少见的高置信情况。
Q51:本条目的数字以后怎么追溯?
所有数字的抓取时点是 2026-10-09,存照清单在附录 F/R;若 preprint 出同行评审版或官方页更新,以新版为准并重跑三源互证——本条目 §8.4 的引用纪律就是为这种更新设计的。
事实清单(硬事实 36 条:正文 26 + 补遗 10)
- 官方发布名:3D Mammogram Dataset;preprint 名 DBT-2026;HF 仓库名 iMerit/3D-MammographyDataset。
- 发布方:iMerit(San Jose)× Segmed(Palo Alto)× Advocate Health 三方联合,2026 年 3 月。
- preprint:medRxiv,doi:10.64898/2026.03.03.25337924,作者 Wu J、Perandini L、Batra T、Igoshin S、Bari S、de Araujo AL、Willemink MJ 共 7 人。
- 规模:558 例患者 / 558 个 DBT 检查(摘要口径);讨论章节另有 1,110 exams 口径(存照)。
- 四组:A 活检证实恶性 271(48.6%)、B 良性 140、C 非癌召回 115、D 活检证实良性 32。
- 官方页聚合口径:271 malignant(48.5%)/ 287 benign(51.5%)。
- 平均年龄 57.5±11.1 岁;全女性、≥18 岁。
- 病灶平均 1.34 cm;约 85% 病灶 <2 cm。
- 入组:BI-RADS 0/1/2;双侧、每侧至少 MLO+CC(每例至少 4 view);无植入物/无乳腺腋窝手术史/无乳腺癌史。
- 数据来源:美国中西部单一医院,经 Segmed Piper(PACS 对接)+ Segmed Openda(队列检索)。
- 格式:压缩 DICOM(1 view=1 文件=1 三维体)、NRRD、结构化 JSON、metadata.xlsx、CSV。
- 去标识:图像烧录文字 OCR → 文本 NLP+LLM 去 18 类 HIPAA PHI → 临床专家(L.P.)人工复核。
- 标注团队:iMerit Scholars 平台认证的印度 fellowship-trained 乳腺放射医师。
- 标注平台:Ango Radiology Annotation Suite(HIPAA 合规、审计跟踪、校准测量工具)。
- 工作流:美国专家定协议 → Doer–Checker 两步 → 分歧二次复核共识 → 美国 MQSA 认证医师终审。
- 金标准:活检病理证实或随访;与影像标注分离交付。
- 获取(全量):Segmed 表单,注册+credentialing+DUA,逐案审核,研究者免费。
- 获取(样本):HF 公开 650 MB(Size <1K,imagefolder:DICOM+annotations.json+metadata.xlsx)。
- 许可:Segmed–iMerit Joint Research Use Agreement(HF 口径)/ DUA(preprint 口径):非商业、禁再分发、禁再识别、禁临床决策;版权归作者与 Segmed。
- 无官方基准模型/排行榜/一致性统计(截至 2026-10-09)。
- 对照物:Duke BCS-DBT(5,060 患者、22,032 扫描、1,526 GB、CC BY-NC 4.0、TCIA 直链、DBTex 挑战赛、duke-dbt-data 工具)。
- DBT 临床证据链:Niklason 1997(原理)→ STORM 2013 / Skaane 2013 / Friedewald 2014 / Rafferty 2016 / McDonald 2016(检出率↑、召回率↓)。
- 全球乳腺筛查量 >3,900 万人次/年(preprint 引言)。
- 致谢:Advocate Health 乳腺放射医师 Amy Sobel, MD。
- 扩展通道:可联系作者获取更广泛的多中心数据库。
- preprint 讨论自称局限:单中心、不可商用。
术语表(30 条:正文 18 + 补遗 12)
- DBT(Digital Breast Tomosynthesis):数字乳腺断层摄影,多角度低剂量投影重建准三维薄层切片的乳腺 X 线技术,俗称 3D 钼靶/3D 乳腺 X 线。
- CC 位(craniocaudal):头尾位,乳腺 X 线标准投照体位之一。
- MLO 位(mediolateral oblique):内外斜位,标准投照体位之二;CC+MLO 为每侧最低配置。
- BI-RADS:乳腺影像报告与数据系统(Breast Imaging Reporting and Data System),0=需召回补充评估,1=阴性,2=良性征象。
- 活检证实(biopsy-proven):以穿刺/手术活检病理为金标准的结论强度层级。
- 非癌召回(non-cancer callback):筛查影像异常被召回补充检查、最终排除癌的路径。
- 富集采样(enrichment):构建队列时刻意提高目标事件(恶性)占比的采样策略。
- PHI(Protected Health Information):受保护健康信息;HIPAA 定义 18 类标识符。
- OCR:光学字符识别,用于提取 DICOM 图像内烧录文字。
- Doer–Checker:一人执行、另一人独立复核的两步质量工作流。
- MQSA:美国乳腺摄影质量标准法案,其认证医师是乳腺影像读片与终审的法定资质。
- PACS:影像归档与通信系统;Segmed Piper 与其对接自动采集 DICOM。
- Segmed Openda:按模态/部位/报告/DICOM 元数据检索构建队列的工具。
- NRRD:Nearly Raw Raster Data,医学体数据常用开放格式。
- DUA(Data Use Agreement):数据使用协议;本库的红线为非商业、禁再分发、禁再识别、禁临床决策。
- DAIMS:数据集 AI-Ready 度评估框架(可获取/可交互/可复用/可持续/许可清晰五维)。
- BCS-DBT:Duke 大学发布的 5,060 患者 DBT 公开库,DBTex 挑战赛赛题数据。
- view:一个投照体位的完整 DBT 三维体;本库 1 view=1 个压缩 DICOM 文件。
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 条目 slug | 3d-mammogram |
| 官方名 | 3D Mammogram Dataset |
| preprint 名 | DBT-2026 |
| 论文 | medRxiv 2026.03.03.25337924(doi:10.64898/2026.03.03.25337924) |
| 发布方 | iMerit × Segmed × Advocate Health |
| 规模 | 558 患者 / 558 检查 / 每例≥4 view |
| 恶性 | 271 例活检证实(48.6%) |
| 获取 | Segmed 表单(全量)+ HF 样本包(650 MB) |
| 许可 | Segmed–iMerit Joint Research Use Agreement(非商业) |
| 库内互链 | vindr-mammo(543)、cbis-ddsm(541)、inbreast(542)、bcdr(800)、mias(801) |
附录 B:DAIMS 评估全表
| 维度 | 评分 | 加分项 | 扣分项 |
|---|---|---|---|
| 可获取性 | ★★★☆☆ | 样本包公开直链、全量免费 | 表单+credentialing+逐案审核,无直链、无版本承诺 |
| 可交互性 | ★★★★☆ | DICOM/NRRD/JSON/CSV 全标准格式 | 无官方 loader,需自建读取管道 |
| 可复用性 | ★★★★☆ | 四组临床口径+病理金标准+报告+方法论完整描述 | 无一致性统计;采集时间/设备未披露 |
| 可持续性 | ★★★☆☆ | 三方机构背书、DOI 存档 | 版权归作者与 Segmed;发布历史仅 v1;无更新计划声明 |
| 许可清晰度 | ★★★★☆ | DUA 五条红线明确、协议具名可查 | FAQ 商用话术与条款表面冲突需自行澄清 |
附录 C:逐项证据链自证
- 558/558 与四组分布:preprint 摘要与 Resulting dataset 章节(正文引述)。
- 48.6%/48.5%:preprint 讨论 vs 官方页 Dataset Summary(双口径存照)。
- 年龄 57.5±11.1:preprint Results(Table 1 引述)。
- 1.34 cm / 85% <2 cm:官方页 Dataset Summary。
- 入组标准/去标识/标注工作流/DUA 条款:preprint Materials & Methods 与 Dataset publishing。
- 获取入口/DUA/标注协议链接:官方页与 HF 页面。
- BCS-DBT 数字:TCIA 官方页(5,060/22,032/1,526 GB/CC BY-NC 4.0)。
- 临床试验证据链:preprint 参考文献 3-7。
- HF 样本包 650 MB / <1K / 结构:HF 页面(搜索快照+镜像页跳转记录)。
附录 D:数据获取决策树
拿到数据了吗?
├─ 没有
│  ├─ 只想看结构/打通管道 → HF iMerit/3D-MammographyDataset(650 MB)
│  └─ 要全量 → Segmed 表单 → 注册+credentialing+签 DUA → 等逐案审核
├─ 有全量
│  ├─ 做病理金标准评测 → 只用 A 组 271 + D 组 32
│  ├─ 做检测/分割训练 → 四组全用 + 标注 JSON
│  ├─ 做影像-报告多模态 → 报告文本 + 图像配对
│  └─ 想商用 → 停。先联系作者/Segmed 拿书面授权
└─ 要大规模/直链/排行榜 → 改用 BCS-DBT(TCIA,CC BY-NC 4.0)
附录 E:DBT DICOM 读取管道骨架(代码)
# 依赖:pydicom、pylibjpeg(-libjpeg-turbo) 或 gdcm(处理压缩传输语法)
# pip install pydicom pylibjpeg pylibjpeg-libjpeg
import pydicom
import numpy as np

def load_dbt_view(dicom_path: str) -> np.ndarray:
    """读取一个 DBT view:1 个 DICOM 文件 = 1 个三维体。"""
    ds = pydicom.dcmread(dicom_path)          # 压缩文件需已安装对应解码插件
    arr = ds.pixel_array                       # (frames, rows, cols) 三维数组
    # 注意:不做 2D 假设——按 frames 维为层内切片处理
    arr = arr.astype(np.float32)
    if hasattr(ds, "RescaleSlope") and hasattr(ds, "RescaleIntercept"):
        arr = arr * float(ds.RescaleSlope) + float(ds.RescaleIntercept)
    return arr

# 样本包结构(HF iMerit/3D-MammographyDataset):
# sample_data/samplecase1/*.dcm        <- 多个 view,每个一个三维体
# sample_data/annotations.json         <- 病灶框/分割标注
# sample_data/metadata.xlsx            <- 病例元数据
# 建议流程:先跑样本包验证读取与标注 schema -> 再申请全量
附录 F:双口径存照总表
| # | 口径 A | 口径 B | 处理 |
|---|---|---|---|
| 1 | 摘要:558 exams / 558 patients | 讨论:1,110 exams / 558 patients | 全文按 558;1,110 注明存照 |
| 2 | 恶性 48.6%(preprint) | 恶性 48.5%(官方页) | 全文按 48.6%,引 48.5% 注出处 |
| 3 | preprint 标题「DBT-2026…」 | 官方页称呼「Technical Framework…」 | 引用用 medRxiv 实际标题 |
| 4 | HF Size <1K / 650 MB | 全量 558 例(全量体积未披露) | 明确样本包 vs 全量 |
| 5 | DUA 非商业 | 官方页 FAQ 商用话术 | 以 DUA 为准,商用需另行授权 |
| 6 | 协议具名 Segmed–iMerit Joint Research Use Agreement(HF) | Data Use Agreement(preprint) | 同一约束体系两个名字,并存 |
附录 G:标注协议复用 SOP(从本库工作流提炼)
任何「医学影像+文本」多资产数据集的标注团队,可直接套用这套从 DBT-2026 提炼的五步 SOP:
- 协议先行:由目标市场的资深临床专家制定标准化标注协议(病灶分类定义、测量口径、边界案例处理),协议文档先于标注存在;
- 平台承载:选择支持审计跟踪、版本控制、校准测量工具的标注平台;乳腺/对称器官类任务确认平台支持左右并排与对称对齐视图;
- 两步复核:执行者(Doer)与复核者(Checker)分离,复核独立进行不反馈执行者逐例结果,只汇总分歧;
- 共识仲裁:分歧进入二次复核,由更高年资者组织共识裁决,裁决结果回写协议(边界案例累积成案例库);
- 外部终审:由持有目标市场监管资质(如美国 MQSA)的医师抽检或全检,验证保真度后定稿。
对应本库的角色映射:美国专家(协议)→ 印度资深放射医师(Doer/Checker)→ 分歧共识 → MQSA 医师(终审)。该结构的可迁移点在于资质与劳动的分层配置:监管资质只用在刀刃上(协议+终审),执行层用经认证的高年资医师规模化承载。
附录 H:与 BCS-DBT 全维度对照(工程视角)
| 维度 | DBT-2026 | BCS-DBT(Duke) | 工程含义 |
|---|---|---|---|
| 获取 | 表单+DUA,逐案 | TCIA 直链(NBIA manifest) | 快速原型用后者 |
| 格式 | 压缩 DICOM + NRRD + JSON | 压缩 DICOM(1 view=1 文件) | 读取管道可复用同一套解码栈 |
| 体量 | 558 例 | 22,032 扫描 / 1,526 GB | 前者全库可下载,后者需筛选下载 |
| 方向坑 | 无官方声明 | 官方声明部分文件 laterality/orientation 有误+纠正代码 | 后者必须用 duke-dbt-data 预处理;前者自检即可 |
| 标注 | 分割+框+表征+测量(医师) | lesion 框(truth boxes) | 前者可训分割,后者偏检测 |
| 金标准 | 活检/随访四组 | 影像分组(含 normal/actionable) | 严格病理评测用前者 |
| 文本 | 自由文本报告 | 无 | 多模态只能用前者 |
| 基准 | 无 | DBTex/DBTex2 排行榜+团队预测公开 | 横向比较去后者取数 |
| 许可 | 非商业 DUA | CC BY-NC 4.0 | 两者都禁商用,后者署名即可 |
附录 I:检索关键词矩阵
| 检索场景 | 建议关键词 | 命中注意 |
|---|---|---|
| 论文检索 | DBT-2026 / digital breast tomosynthesis dataset / de-identified DBT | 前缀 10.64898 坑(坑 3) |
| 数据检索 | 3D Mammogram Dataset / 3D-MammographyDataset | HF 仓库名带连字符与大小写 |
| 本库检索 | 3d-mammogram / mammo / tomosynthesis | 排除 ddti(甲状腺,坑 1);BCDR 是另一实体 |
| 组合检索 | DBT + biopsy / DBT + segmentation / tomosynthesis + report | 与 BCS-DBT 结果区分看规模数字 |
| 机构检索 | iMerit Segmed Advocate Health mammography | 新闻发布页也命中 |
附录 J:报告文本使用八则
- 报告是 case 级资产:整例一份,先按 case 建索引再谈解析;
- 报告措辞遵循北美报告惯例(assessment/recommendation 结构常见),BI-RADS 评语与元数据 CSV 的评分字段应一致,不一致处是数据质量研究对象而非解析障碍;
- 「建议随访」「召回」等处置措辞与 C 组路径强相关——文本分类任务可直接利用这个强关联;
- OCR 兜底过的图像烧录文字不要当正文解析(它是去标识处理的对象,非报告本体);
- 做对齐模型时,报告提到但标注未覆盖的「二次所见」(incidental findings)是天然的难例挖掘池;
- 报告长度分布与信息密度先做盘点再定截断策略,别用通用医学报告模板的长度假设;
- 引用报告原文到论文/演示时再次自查去标识(本库已三重处理,引用者承担最后防线);
- 跨语言团队注意:报告为英文原文,翻译后用于展示无妨,用于建模保持原文。
附录 K:30 秒 pitch(三种受众)
- 给 PI:558 例 DBT、近半数活检证实恶性、带分割标注和放射报告——单中心富集队列,适合做方法开发与小样本验证,规模化验证转 BCS-DBT,商用需另谈授权。
- 给工程师:标准 DICOM 三维体+JSON 标注+CSV 元数据,HF 有 650 MB 样本包可先打通管道;全量表单申请,按 case 切分防泄漏。
- 给审稿人:方法学描述完整(协议/Doer–Checker/MQSA 终审/去标识三重兜底),局限自认清楚(单中心、富集、无一致性统计);数字口径以 preprint 摘要为准(558),讨论章节 1,110 的出入已在引用时注明。
附录 L:术语表补遗(6 条)
- 富集队列(enriched cohort):以事件(恶性)占比远高于自然人群为特征的队列,服务于监督效率而非流行病学代表性。
- 回归偏倚(callback)路径:筛查阳性→召回→补充影像/活检的临床链条;C 组即走完该链条未确诊癌者。
- 准三维(quasi-3D):DBT 重建体的层厚与面内分辨率不对称,非各向同性体数据。
- 多帧 DICOM(multiframe):单文件封装多帧像素的 DICOM 组织方式,DBT view 的标准载体。
- Dongle-free 获取:非直链但平台化的获取形态(表单+审核),介于完全开放与邮件请求制之间——本库的获取形态即属此类。
- 监督密度(supervision density):单位病例携带的监督信号量(标签/标注/文本/金标准的组合),本库的核心卖点。
附录 M:事实清单补遗(4 条)
- HF 样本包结构:sample_data/<case>/*.dcm + annotations.json + metadata.xlsx(imagefolder 组织)。
- preprint 引用列表含 DBT 技术与临床试验文献 7 篇核心引文(Niklason 1997 至 McDonald 2016)。
- 官方页标注工具能力宣称:多分辨率缩放、并排对比、对称对齐、预标注(iMerit 平台口径)。
- iMerit 官方口径 5,500+ 全职员工、10+ 年标注经验(公司介绍段,背景信息)。
附录 N:数据组别速查卡
| 组 | 例数 | 金标准强度 | 建议用法 | 慎用场景 |
|---|---|---|---|---|
| A(271) | 活检证实恶性 | 病理(最强) | 恶性类训练/评测阳性集 | 不能当患病率 |
| B(140) | 良性 | 临床+随访 | 阴性类训练 | 严格病理评测勿混入 |
| C(115) | 非癌召回 | 临床处置 | 难例阴性/假阳性研究 | 勿当「正常」样本 |
| D(32) | 活检证实良性 | 病理(最强) | 病理口径阴性对照 | 量小,别单独下结论 |
| A+D(303) | 病理证实子集 | 双侧病理 | 严格金标准评测首选 | 占比 54.3% 非自然分布 |
附录 O:从本库出发的五个研究选题
- 小样本 DBT 分割的监督上限:303 例病理证实子集+医师分割标注,测「监督密度换数据量」的极限在哪——与 BCS-DBT(大库低密度)对照设计;
- 影像-报告对齐的病灶级 grounding:报告语句与标注框/分割的细粒度对齐,做 DBT 版的「报告指向病灶」评测——本库是少有的同时有三样素材的库;
- 2D→3D 迁移的系统研究:以 VinDr-Mammo/CBIS-DDSM(2D 大库)预训练、本库微调,量化模态迁移增益与失效模式;
- 召回路径的假阳性画像:C 组 115 例是「影像说有、临床说没有」的完整样本——做 DBT 假阳性的形态学分析与缓解策略;
- 标注协议的可复现性审计:按 preprint 协议描述+官方标注协议页复刻一条标注线,测协议文本到标注质量的信息损耗——标注方法论方向。
每个选题都自带合规边界:只用本库数据发表结果没问题;把数据二次打包、商用化、临床决策化都在 DUA 红线之外。
附录 P:与临床工作流的对应关系
本库的数据流实际上是一条被「切片冻结」的临床工作流:
筛查就诊(女性≥18)
  → DBT 检查(双侧 CC+MLO)          [view 层资产]
  → 放射科医师读片 + BI-RADS 评分      [CSV: BI-RADS 字段]
       ├─ 0 → 召回 → 补充影像/活检    [C 组路径 / A 组路径]
       ├─ 1/2 → 常规随访             [B 组路径]
  → 活检(如做)→ 病理               [CSV: 活检字段 / A、D 组]
  → 报告书写                         [报告文本资产]
  → (本研究)医师标注病灶            [annotations 资产]
每层资产对应工作流的一个环节——这意味着用本库做「筛查工作流模拟」时,可以按环节组装监督信号(读片模拟用 view+标注,决策模拟用 BI-RADS+四组,报告模拟用文本)。反过来,任何让资产脱离工作流语境的用法(比如把 C 组召回病例当纯阴性训练读片模型)都要先想清楚引入了什么偏倚。
附录 Q:引用本库前的八项自查
- 规模写 558/558(不是 1,110);
- 恶性写「活检证实恶性 271(48.6%)」(不是「48.5%」与 preprint 混用);
- 论文引用 DOI 前缀 10.64898;
- 获取方式写「注册+DUA」,别写「公开下载」;
- 许可写具名协议+非商业,别写开源;
- 别把 HF 650 MB 样本包当全量引用;
- 与 ddti(甲状腺)明确切割;
- 报告观察者间一致性「未公开」而不是「已验证」。
附录 R:版本与抓取存照
- 抓取时点:2026-10-09(本条目 FACTS.md 同日存档);
- preprint 版本:v1(medRxiv 2026.03.03.25337924);
- HF 仓库状态:iMerit/3D-MammographyDataset,Size <1K,650 MB(抓取时点口径);
- 官方页:imerit.net/3d-mammogram-dataset/(含 Dataset Summary 与 FAQ 的抓取时点内容);
- 下载表单:segmed.ai/resources/ai-for-impact-on-breast-cancer-dataset-form(抓取时点在线);
- 同行评审状态:未检出期刊版(检索时点口径,后续可能变化)。
以上所有数字与条款以三源(官方页/medRxiv/HF)抓取时点为准;三方一致处为硬事实,出入处见附录 F 存照表。
附录 S:DBT 成像小课(给从 2D 迁移来的团队)
为什么 DBT 是「准三维」:球管在有限弧度(约 15-50 度,因厂商而异)内采集十余到数十张低剂量投影,重建算法把不同深度的组织层面分开,输出层厚约 1mm 级的切片堆栈——对比 CT 的各向同性体素,DBT 的层间分辨率远低于层内分辨率,故称 quasi-3D。工程含义:3D 卷积不是无脑搬,层内 2D 主干+层间轻量聚合(2.5D)常是性价比最高的起点。
剂量与体位:单次 DBT 采集剂量与 2D 钼靶同量级(叠加采集时用薄层合成图像替代额外 2D 暴露);每例标准体位为双侧 CC+MLO——本库的「至少 4 view」即来源于此。
为什么 DBT 对 AI 是不同的题:2D 钼靶的「组织重叠假象」在 DBT 中被物理性消除,但薄层把一个病灶摊到多个层面上——2D 里「一个框」,3D 里是「跨层轮廓」。本库的分割标注因此是三维劳动,其价值与成本都来自这里。
读片范式差异:放射科医师读 DBT 是「逐层滑动+对称对照」,本库标注平台的对称对齐能力(§3.5)就是这种范式的工具化。算法侧模仿这个范式的注意力/翻滚机制,往往比直接上 3D U-Net 更贴合数据特性。
附录 T:DBT 临床试验证据链速查
| 试验/研究 | 年份·期刊 | 设计一句话 | 核心结论 |
|---|---|---|---|
| Niklason et al. | 1997 · Radiology | DBT 技术奠基论文 | 提出断层合成乳腺成像原理 |
| STORM | 2013 · Lancet Oncol | 前瞻人群对比筛查 | DBT+2D 提高癌检出 |
| Skaane et al. | 2013 · Radiology | 人群筛查项目对比 | DBT+2M 提高检出、降低假召回 |
| Friedewald et al. | 2014 · JAMA | DBT+2D vs 2D 回顾 | 召回率↓、癌检出率↑ |
| Rafferty et al. | 2016 · JAMA | 致密/非致密分层 | 致密乳腺获益明确 |
| McDonald et al. | 2016 · JAMA Oncol | 三年结局分析 | 浸润性癌检出持续获益 |
(Skaane 行「DBT+2M」为「DBT+2D mammography」之缩写惯例;六篇均为 DBT-2026 preprint 引文,引用时回溯原文核对。)
附录 U:BI-RADS 全级别速览(本库只用 0/1/2)
| 级别 | 含义 | 常规处置 | 在本库 |
|---|---|---|---|
| 0 | 评估不完整,需补充影像 | 召回补拍/超声 | ✓(召回路径入口) |
| 1 | 阴性 | 常规筛查间隔 | ✓ |
| 2 | 良性征象 | 常规筛查间隔 | ✓ |
| 3 | 可能良性,短期随访 | 6 个月随访 | ✗ 排除 |
| 4 | 可疑异常(4A/4B/4C) | 活检意向 | ✗ 排除 |
| 5 | 高度提示恶性 | 活检/治疗路径 | ✗ 排除 |
| 6 | 已证实恶性,评估范围 | 治疗决策中 | ✗ 排除 |
本库把 0/1/2 收进来、3-6 排除出去——「筛查世界」与「诊断世界」的分界就是 2 与 3 之间。这个选择让库内病灶天然偏小(85% <2 cm)偏隐蔽,决定了它的题型是检测与分割,而非「明显病灶的定性」。
附录 V:术语表补遗之二(6 条,术语表合计 30 条)
- 准各向异性体数据:层内分辨率高、层厚大的三维数据形态,重采样与 3D 卷积设计的主要约束。
- 薄层合成图像(synthesized 2D):由 DBT 体数据重建出的伪 2D 图,替代额外 2D 暴露;本库未宣称包含该产物,以 DICOM 内容为准。
- Spot compression(点压):对可疑区域加压补照的体位;本库入组标准未纳入此类非常规体位,逐例 view 清点时如出现应核对元数据。
- 结构性阅读(structured reading):按固定清单逐项评估的读片方式,Ango 平台的结构化报告功能即为此服务。
- 数据驻留(data enclave):数据不出平台、分析代码进平台的合规模式;Q29 竞赛场景的推荐架构。
- 金标准强度分级:病理活检 > 影像随访 > 临床印象的证据层级;引用本库结论时声明所用层级(A+D 为病理级,B/C 为临床级)。
附录 W:事实清单补遗之二(6 条,事实清单合计 36 条)
- 入组排除三项:乳房植入物、既往乳腺/腋窝手术、乳腺癌病史(preprint 入组标准)。
- 队列富集策略明示:「prioritizing patients with biopsy-proven malignancies」(preprint 数据构建段)。
- 报告与图像去标识后由临床专家人工复核且未检出 PHI(preprint 去标识段,复核者 L.P.)。
- 标注争议处理机制:二次复核+共识(preprint 标注段 Doer-Checker 描述)。
- 官方页明示数据集经「U.S. board-certified radiologists」审查背书(发布页宣示)。
- preprint 讨论自述数据集独特性:「high quality DBT exams with strong ground truth information (biopsy or follow-up)」。
附录 AA:数据集卡片(Dataset Card 英文骨架)
发布自己的模型/论文时,可基于此骨架撰写 dataset card(数字口径已与本条目对齐):
Dataset Card: 3D Mammogram Dataset (DBT-2026)

- Curated by: iMerit x Segmed x Advocate Health
- Paper: medRxiv 2026.03.03.25337924, doi:10.64898/2026.03.03.25337924
- Modality: Digital Breast Tomosynthesis (DBT)
- Instances: 558 screening exams from 558 female patients (age 57.5+/-11.1)
- Cohort groups: A biopsy-proven malignant 271 (48.6%) / B benign 140 /
  C non-cancer callback 115 / D biopsy-proven benign 32
- Annotations: expert segmentation, lesion localization, characterization,
  measurement (US-expert protocol, India-based fellowship-trained breast
  radiologists, Doer-Checker review, US MQSA radiologist final QA)
- Assets: compressed DICOM (1 view = 1 file = 1 volume), NRRD, JSON
  annotations, CSV/XLSX metadata, de-identified free-text radiology reports
- De-identification: OCR (burned-in text) + NLP/LLM (18 HIPAA PHI types)
  + manual clinical review
- Access: registration + credentialing + DUA via
  segmed.ai/resources/ai-for-impact-on-breast-cancer-dataset-form
  (HF sample: iMerit/3D-MammographyDataset, 650 MB)
- License: Segmed-iMerit Joint Research Use Agreement
  (non-commercial research only; no redistribution; no re-identification;
  no clinical decision use; rights with authors and Segmed)
- Known limitations: single-hospital source (US Midwest); enriched cohort
  (not natural prevalence); exam-count discrepancy 558 (abstract) vs 1,110
  (discussion) unresolved; no official benchmark; acquisition period and
  device models undisclosed
(英文骨架中的数字均为本条目存照口径;发布时若官方已更新版本,逐项复核后再用。)
附录 BB:preprint 方法节精读笔记(逐段要点)
对 medRxiv preprint「Materials & Methods — Resulting dataset」段的精读拆解,供撰写相关工作/复现协议时快速引用:
- 伦理与合规定位:回顾性设计,个人知情同意豁免;PHI 全部移除——两句话同时回应了 IRB 与隐私两个审稿常问题。
- 采集基础设施:Segmed Piper 与医院 PACS「自动连接」——强调采集是平台化而非人工导出,可复用性与规模弹性在此。
- 烧录文字处理:OCR 先行——很多数据集论文跳过这一步,本 preprint 把它写进方法学,是「影像+文本」双资产的必要交代。
- 文本去标识:NLP+LLM 组合去 18 类 HIPAA PHI,再加临床专家人工复核(未检出 PHI)——「自动化+人工兜底」的表述可直接引用为去标识 SOP 依据。
- 队列检索:Segmed Openda 按模态/部位/报告/DICOM 元数据搜索,限定美国中西部——地域范围在此披露,单中心属性的来源。
- 入组与排除:五条标准(见 §2.1)逐条可引用;「优先纳入活检证实恶性」的富集策略原文为 “enriched by prioritizing…”,引用时保留原词。
- 标注人力:iMerit Scholars 平台招募的印度资深乳腺放射医师;「标准化协议由美国临床专家制定」——人力结构与质控归属在此分层。
- 标注平台:Ango Radiology Annotation Suite 的三个关键词——结构化报告、校准测量工具、审计跟踪版本控制。
- 工作流:Doer–Checker 两步 + 分歧二次复核共识 + 美国 MQSA 认证医师终审——四句即可完整转述的质控链。
- 发布与条款:表单地址、注册+credentialing+DUA、非商业/禁再分发/禁再识别/禁临床决策、版权归作者与 Segmed、逐案审核——条款部分共五句,全部可直引。
- 结果段数字:558 exams / 558 patients、四组 271/140/115/32、平均年龄 57.5±11.1——与官方页的差异点(48.5/48.6、287 聚合)见本条目存照。
- 讨论段自曝:单中心局限、不可商用、1,110 口径(疑误)、多中心扩展通道——讨论段是「引用其自认局限」的最佳出处。
附录 CC:同一研究问题的「同题异构」对照
以三个典型研究问题为例,看它在库内 2D 库与本库中的实现差异——适合写相关工作时组织对比段落:
问题一:病灶分割
- CBIS-DDSM(541):2D ROI 级掩码,乳腺组织/肿块/钙化三任务,直链可得;
- 本库:三维体逐层分割轮廓+测量,标注含表征与部位;
- 对照点:2D 掩码评测 IoU 单层即可,本库需定义 3D IoU 或逐层聚合口径——先定评测协议再跑模型。
问题二:良恶性分类
- VinDr-Mammo(543):BI-RADS 四级别分类,两万例级,影像印象标签;
- 本库:四组临床路径标签,558 例,病理金标准子集 303 例;
- 对照点:前者「大数据+弱标签」,后者「小数据+强标签」——同样的分类器在两边会学到不同的决策边界,跨库迁移是论文级贡献点。
问题三:筛查工作流模拟
- MIAS(801)/INbreast(542):仅影像+简单标签,无法建模召回路径;
- 本库:BI-RADS 0/1/2 入组+召回组(C)+随访金标准,可模拟「读片→召回→活检」决策链;
- 对照点:富集队列的患病率失真使模拟只能做相对比较(策略 A vs B),不能外推绝对筛查收益。
附录 DD:引用 BibTeX 骨架
@article{dbt2026,
  title   = {DBT-2026, a de-identified publicly available dataset of
             digital breast tomosynthesis exams with ground truth biopsies},
  author  = {Wu, Jie and Perandini, Luiz and Batra, Tushar and
             Igoshin, Sergei and Bari, Sina and de Araujo, Aline L. and
             Willemink, Martin J.},
  journal = {medRxiv},
  year    = {2026},
  note    = {2026.03.03.25337924; doi:10.64898/2026.03.03.25337924;
             preprint, not peer-reviewed at time of writing}
}
(作者名的名/姓拆分按 medRxiv 引用格式推定,投稿前以 preprint 页面署名原文复核;「not peer-reviewed」注记建议保留至期刊版出现。)
附录 EE:从获取到发表的合规时间线示例
以「DBT 病灶分割方法研究」为假想课题的合规排期示例(可按实际课题缩放):
| 阶段 | 时间 | 动作 | 合规锚点 |
|---|---|---|---|
| W0 | 第 1 天 | 下载 HF 样本包,打通 DICOM 读取 | 样本包许可同 DUA(非商业) |
| W0 | 第 1-2 天 | 提交 Segmed 表单(个人注册+机构信息+用途陈述) | 每位研究者单独签署 |
| W1 | 等待期 | 用库内 2D 库搭 2D 基线;预写 3D 管线单测 | 不碰未授权数据 |
| W2 | 数据到手 | 十项数据体检(§2.9);存储环境权限组隔离 | 禁散拷/公共网盘 |
| W3-8 | 实验期 | 按附录 O 选题推进;实验记录绑定 case_id 三元组 | 不外发中间数据 |
| W9 | 成稿 | 数字引用按附录 FF 速查表核对 | 引用纪律 §8.4 |
| W10 | 投稿 | 数据可用性声明指向 Segmed 表单+DUA;引用 BibTeX(附录 DD) | 声明「非商业研究使用」 |
| 发表后 | 持续 | 代码开源不含数据片段;权重可开源(Q27) | 数据链接回表单 |
三条原则贯穿全程:数据不落个人设备、合作者各自签约、发表物只含结果不含数据本体。
附录 FF:数据集数字引用速查表
所有可引用硬数字与推荐口径(出处编号对应附录 C 证据链):
| 数字 | 推荐口径 | 出处 | 注意 |
|---|---|---|---|
| 558 / 558 | 558 例患者 / 558 个 DBT 检查 | preprint 摘要 | 勿用讨论段 1,110 |
| 271(48.6%) | 活检证实恶性 271 例,占 48.6% | preprint 讨论 | 官方页 48.5% 并存 |
| 140 / 115 / 32 | 良性 / 非癌召回 / 活检证实良性 | preprint 结果 | 四组合计=558 |
| 287(51.5%) | 官方页良性聚合口径 | 官方页 | 与四组口径二选一并注明 |
| 57.5±11.1 岁 | 平均年龄(全女性,≥18 岁) | preprint Table 1 | — |
| 1.34 cm / 85% | 病灶平均尺寸 / <2 cm 占比 | 官方页 | 仅官方页来源 |
| ≥4 view | 每例至少 4 个三维体(双侧 CC+MLO) | preprint 入组标准 | 实际分布待全量验证 |
| BI-RADS 0/1/2 | 入组筛查评分限定 | preprint 入组标准 | 3-6 排除 |
| 650 MB / <1K | HF 样本包规模 | HF 页面 | 不是全量 |
| 5,060 / 22,032 / 1,526 GB | 对照库 BCS-DBT 规模 | TCIA | 比较时注明口径差异 |
| 18 类 PHI | 去标识处理的 HIPAA 标识符类别数 | preprint | — |
| 3,900 万次/年 | 全球乳腺筛查量背景 | preprint 引言 | 背景,非本库数字 |
附录 GG:库内互链声明(正式版)
本条目(3d-mammogram)与库内条目的互链关系及理由,逐条声明:
- vindr-mammo(rid 543):互链。2D 钼靶大规模 BI-RADS 基准;与本库构成「2D 大规模 vs 3D 小而精」光谱两端(frontmatter relatedLink 已含)。
- cbis-ddsm(rid 541):互链。2D 病理证实评测经典;与本库同为「病理金标准」取向(relatedLink 已含)。
- inbreast(rid 542):互链。高精度标注 2D 钼靶;「少而精」哲学的 2D 先例(relatedLink 已含)。
- bcdr(rid 800):互链。库内唯一其他含 DBT 形态数据的条目;交付形态与本库差异见 §8.3(relatedLink 已含)。
- mias(rid 801):互链。经典小库;三十年谱系对照(§6.8)。
- tn-mammo-breast-density(rid 628)/ swiss-mammo(rid 627):弱相关。多视图密度分级与德文合成报告,影像-文本方向的对照(正文 §8 未展开,仅此处存照)。
- ddti(rid 536):不互链。甲状腺超声库,缩写形似;防混淆声明见 §8.3。
互链实现:frontmatter relatedLink 四条站内 URL(543/541/542/800);其余经正文 §6.5/§6.8/§8 引导。
附录 HH:审稿人常问十题速答(用本库投稿时备用)
- 「单中心数据,泛化性?」——答:方法开发定位;已用 BCS-DBT 做外部验证(或列为局限),preprint 作者提供多中心扩展通道(§7.4)。
- 「558 例够吗?」——答:48.6% 活检证实恶性的富集队列,监督密度等价于数千例低密度队列的阳性样本量;并给出学习曲线实验佐证。
- 「患病率不真实?」——答:研究设计为检测/分割方法验证,不做患病率敏感主张(§4.2 三条代价已识别并规避)。
- 「为什么不用 DBTex 排行榜数据?」——答:BCS-DBT/DBTex 用于外部验证或横向对比;本库提供活检金标准与报告文本,两个基准不可互替(§6.1 表)。
- 「标注可信度?」——答:协议+Doer–Checker+MQSA 终审的完整链条(§3.2);一致性统计未公开是数据集局限,我们补充了子样本复审(如做了)。
- 「1,110 还是 558?」——答:采用 preprint 摘要口径 558,讨论段 1,110 为已知口径矛盾,本稿全部按 558 并在附录存照(坑 4)。
- 「许可允许发表吗?」——答:DUA 限制数据流转与用途性质,不限制学术发表;数据可用性声明指向官方表单(Q28)。
- 「为什么不做商业部署?」——答:DUA 明文非商业+禁临床决策;商用路径是与版权方另行授权(§5.3)。
- 「与 2D 钼靶工作比增量是什么?」——答:三维体消除组织重叠+配对报告文本;对照组设计见附录 CC 的同题异构表。
- 「数据会开源吗?」——答:不会且不被允许(禁再分发);开源的是代码与模型权重,数据获取走统一表单保证同等合规(Q27)。
附录 II:本条目检索关键词全集(站内与站外)
站内(本库检索框):3d-mammogram、3D Mammogram、DBT、数字乳腺断层、3D 钼靶、乳腺断层、tomosynthesis、乳腺影像、乳腺癌、X光影像。
站外(学术检索):3D Mammogram Dataset、DBT-2026、iMerit 3D mammography、Segmed DBT、Advocate Health tomosynthesis、de-identified DBT biopsy、digital breast tomosynthesis public dataset、3D-MammographyDataset(HF)。
负向排除词:ddti(甲状腺)、DDTI(同名缩写的甲状腺超声库)、DST/DBT 其他领域缩写。
检索建议组合:DBT + biopsy-proven(区分本库与 BCS-DBT 的最快特征词);3D mammogram + 558(规模指纹)。
附录 JJ:机器可读元信息摘要
供下游脚本/索引程序直接消费的本数据集元信息(与本条目 frontmatter 同口径的 YAML 片段):
dataset:
  official_name: "3D Mammogram Dataset"
  internal_name: "DBT-2026"
  hf_repo: "iMerit/3D-MammographyDataset"
  publishers: ["iMerit", "Segmed", "Advocate Health"]
  paper:
    venue: "medRxiv"
    id: "2026.03.03.25337924"
    doi: "10.64898/2026.03.03.25337924"
    year: 2026
    peer_reviewed: false
  modality: "digital breast tomosynthesis (DBT)"
  scale:
    patients: 558
    exams: 558
    views_per_exam_min: 4
    disclaimer: "discussion section mentions 1,110 exams (unresolved)"
  cohort:
    A_biopsy_proven_malignant: 271
    B_benign: 140
    C_non_cancer_callback: 115
    D_biopsy_proven_benign: 32
    malignant_share_official: 0.486
  demographics:
    sex: "all female"
    age_min: 18
    age_mean: 57.5
    age_sd: 11.1
    birads_included: [0, 1, 2]
  lesions:
    mean_size_cm: 1.34
    share_below_2cm: 0.85
  formats: ["DICOM (1 view = 1 volume)", "NRRD", "JSON", "CSV/XLSX"]
  text_asset: "de-identified free-text radiology reports"
  access:
    full_dataset: "segmed.ai/resources/ai-for-impact-on-breast-cancer-dataset-form"
    sample: "huggingface.co/datasets/iMerit/3D-MammographyDataset"
    requirements: ["registration", "credentialing", "DUA"]
  license:
    name: "Segmed–iMerit Joint Research Use Agreement"
    commercial_use: false
    redistribution: false
    re_identification: false
    clinical_decision_use: false
    rights_holder: "authors and Segmed"
  limitations:
    - "single hospital (US Midwest)"
    - "enriched cohort, not natural prevalence"
    - "no official benchmark"
    - "no inter-observer agreement statistics"
    - "acquisition period and device models undisclosed"
(YAML 片段中的数字与本条目正文一致;1,110 与未披露项以 disclaimer/limitations 显式携带,避免下游程序误读。)
附录 X:2D→DBT 迁移概念映射表
从库内 2D 乳腺条目迁移到本库时的概念对照:
| 2D 世界(库内既有) | DBT 世界(本库) | 迁移注意 |
|---|---|---|
| 一张 CC/MLO 图像 | 一个 CC/MLO 三维体(数十至上百层) | 输入维度升维;显存策略重设计 |
| 病灶单框 | 跨层轮廓/分割 | 标注消耗层指数上升;评测用 3D IoU |
| BI-RADS 分级标签 | 四组处置路径标签 | 语义从「影像印象」变「临床结局」 |
| 钙化形态学描述 | 跨层钙化追踪 | 小病灶跨层消失问题(DBT 特有难点) |
| 对称对比(左右两图) | 对称对比(左右两堆体数据) | 同一先验,数据量翻倍 |
| 报告=结构化标签 | 报告=自由文本 | 多模态接口从查表变生成 |
附录 Y:八条失败模式预演
- 拿样本包当全量发论文——规模穿帮(坑 2 的执行版);
- 按 view 切训练测试集——患者泄漏,指标虚高(§2.7);
- 把 C 组当阴性背景——假阳性画像被污染,检测阈值失真(附录 N);
- 用 2D 阅读习惯检查标注——跨层轮廓在单层切片上「看着错」,误报标注质量事故(附录 S);
- 商用演示引用官方页「commercial」字样——法务风险(坑 5);
- 数据转发给合作单位——DUA 违约,全组信誉受损(Q26);
- 报告文本按句子切分训练——丢失 case 级语境,生成器幻觉加重(Q24);
- 在 558 例上堆大模型参数——监督密度再高也撑不起过参模型,先小后大(Q40)。
每条失败模式都对应正文的一个锚点——预演的价值在于:写实验计划时把对应锚点变成 checklist 条目。
附录 Z:三类读者精读路径
研究者(写论文用):§0 → §2.2(四组口径)→ §4 全部(人群与偏倚)→ §6.1(与 BCS-DBT 对照)→ 附录 F(存照表)→ 附录 O(选题)。关键动作:把 §4.2 的三条代价写进 limitation。
工程师(跑通管线):§2.3(文件形态)→ §2.6(DICOM 要点)→ §2.7(schema 三层)→ §2.9(十项体检)→ §2.10(工具矩阵)→ 附录 E(代码骨架)。关键动作:第 1 天用样本包打通读取+标注对齐,全量到手即体检。
编辑/审校(把关数字):§1(十问十答)→ §8.4(引用纪律)→ §9(八坑)→ 附录 Q(八项自查)→ 附录 R(版本存照)。关键动作:对照附录 F 逐条核数字口径,重点盯 558/1,110 与 48.5/48.6 两处。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- bus-bra — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- bcdr — 共享标签:医学影像 / X光影像 / 乳腺影像 / 医学图像分割 / 评测基准
- mias — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- bus-uclm — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- breast-lesions-usg — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- dbt-tu-ju — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- mama-miaai-extended — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌 / 评测基准
- vindr-mammo — 共享标签:医学影像 / X光影像 / 乳腺影像 / 乳腺癌
- busi — 共享标签:医学影像 / 乳腺影像 / 医学图像分割 / 乳腺癌
- cbis-ddsm — 共享标签:医学影像 / X光影像 / 乳腺影像 / 乳腺癌
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
