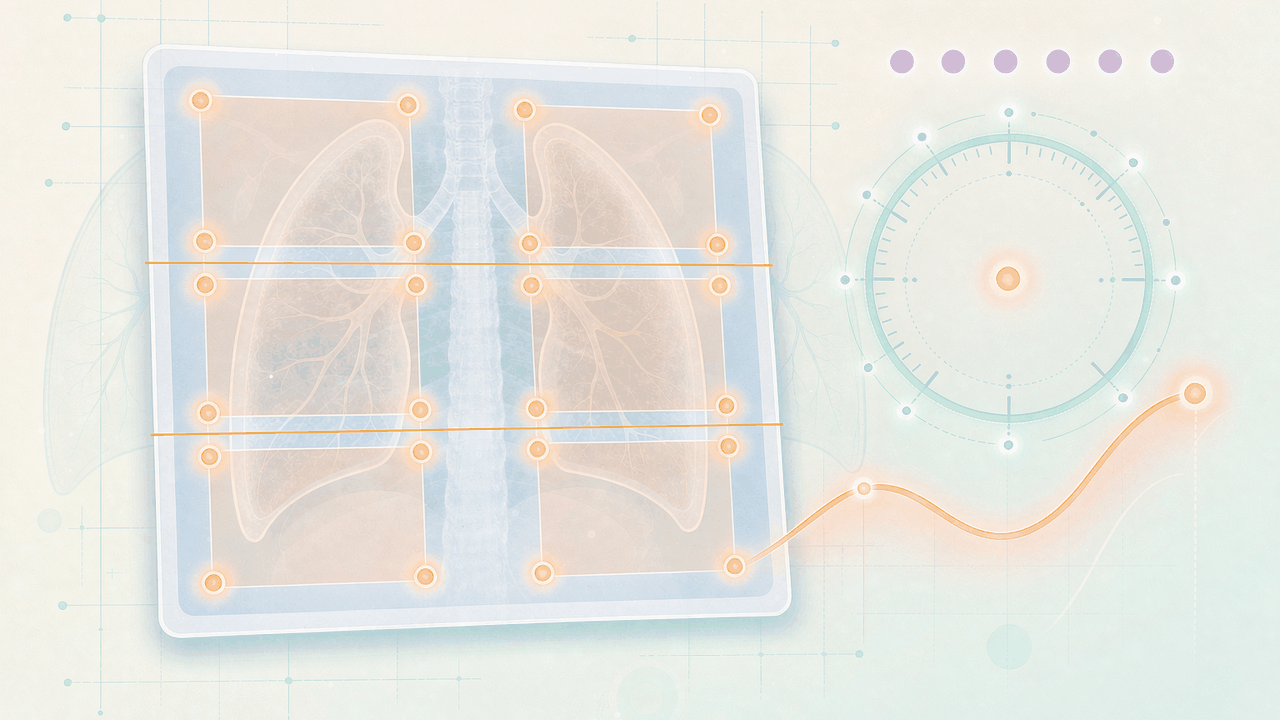
信息速览
INFOBOX — BrixIA 一屏速览
维度 内容 本质 意大利布雷西亚单中心 COVID-19 胸片集 + 六区半定量严重度评分(Brixia score) 标注 + 参照网络 BS-Net 命名 数据集全称 BrixIA COVID-19 Dataset;本地 slug brixia-peru中的 “peru” 为派发候选名残留,与秘鲁无关(坑 1)团队 布雷西亚大学 UniBS(信息工程系 DII + 医学与外科专长、放射科学与公共卫生系 DSMC)联合 ASST Spedali Civili di Brescia 第 2 放射科 论文 Medical Image Analysis 2021;71:102046(doi:10.1016/j.media.2021.102046);预印本 arXiv:2006.04603 数据 4,695 张 CXR 现行修订版(论文 Table 3 记 4,703;采集 4,707);DICOM 匿名化;CR 62%/DX 38%;AP 87%/PA 13% 采集期 2020-03-04 至 2020-04-04(一个月疫情峰值,次重症与重症监护病房全部胸片) 评分 六区(右肺 A/B/C、左肺 D/E/F,各 0-3 分),全局分 0-18;界标为主动脉弓下缘与右下肺静脉下缘 标注 直接取自当班放射科医师日常报告(弱监督,约 30 名专家);150 张共识金标准由 5 位医师重注;Cohen 集 192 张双医师标注 划分 训练 3,311 + 验证 945 + 测试 447(= 4,703 分析口径) 网络 BS-Net 端到端三段式(U-Net++ 分割 → 空间对齐 → ROI 六区评分头);SA/HA/ENS 三配置 核心结果 BS-Net-ENS 盲测六区平均 MAE 0.441(全局 1.728);共识金标准上 vs CbGS MAE 0.424 < 人工两两平均 0.528 许可 数据集本体 Research Use Agreement(注册制,禁再分发)|Cohen 标注 CC BY-NC-SA 4.0|代码开源|论文 CC BY-NC-ND 库内互链 covid-19-radiography(217)、bimcv-covid(207)、covidx-cxr(197)、chest-x-ray-segmentation(601)、vindr-cxr(125)、chexpert(5)
BrixIA 是一个把"放射科医生在报告里写的那串数字"变成可训练数据集的工程:它不新造评分标准,而是把布雷西亚市民医院在 2020 年 3 月疫情最凶的一个月里、对次重症与重症监护病房每一位 COVID-19 患者反复拍摄的胸片连同当班医师已写进日常报告的六区评分一起匿名化后公开——4,695 张图像、每张 6 个 0-3 的整数和一个 0-18 的总分,全部来自真实临床流程,而非事后为科研重注。配套的 BS-Net 网络进一步证明:这套评分可以被弱监督地端到端学习,且在最严格的"五人共识金标准"上,机器的评分误差(MAE 0.424)低于放射科医师两两之间的平均分歧(0.528)。它因此同时是 COVID-19 影像数据集、半定量评分标注方法论样本,和一个可解释性 AI 的落地案例。
导语读法三则:
- 只想下数据:直奔 §6 获取与许可——数据集本体是注册制研究用途协议(不是 CC 直链),只有 Cohen 集的 Brixia 标注是公开直链,别混(坑 4)。
- 关心评分体系:直奔 §2 的 Brixia score 定义与 §5 的六区标注——注意界标线与 0-3 四档的精确措辞。
- 做模型评测:直奔 §4 的核心结果与 §8 的谱系——MAE 0.441/0.424/0.528 三个数字的口径差异是全文最易误读处(坑 3、坑 5)。
§0 导读:这个数据集解决什么问题
COVID-19 疫情期间,胸部 X 线(CXR)因为廉价、快速、辐射低、可在床旁完成,成为许多医院监测肺部病变进展的首选影像手段——论文引用的临床现实是:由于病情进展快、需每日评估疗效,同一患者常常需要逐日连续拍摄(serial acquisition),这使得 X 线剂量与阅片工作量都成为真实的临床负担。但当时公开的 COVID-19 影像数据集几乎全部是为二分类诊断(有无 COVID-19)设计的,几乎没有数据集服务于更贴近临床需求的另一半任务:把"病情有多重"变成可比较、可追踪的数值。
布雷西亚(Brescia)是意大利疫情最早、最猛烈的震中之一。ASST Spedali Civili di Brescia 第 2 放射科从疫情一开始就在日常报告中使用一套自创的多区评分——Brixia score:把正面胸片的两肺各分上中下三区(共六区),逐区打 0-3 分,六区之和即全局分(0-18)。这套评分由该科室的 Borghesi 与 Maroldi 提出,并很快在 302 例患者的回顾性研究中被证明与住院死亡风险独立相关(ROC 最佳截断 8 分)。但它当时只是一套临床报告惯例,不是数据集。
BrixIA 项目做的事情是把这个惯例数据化并开源:把一个月疫情峰值期内、次重症与重症监护病房的全部胸片(含真实临床场景中的一切变异性——不同设备、不同投照位、不同患者体位、有无生命支持设备)连同报告中的评分一起匿名化公开,再设计一个端到端网络 BS-Net 证明"这套评分可以自动学出来"。它区别于库内其他胸片数据集的三个关键点:(1)标注是严重度数值而非诊断标签;(2)标注来自临床流程而非集中重注;(3)配套一个把"分割—对齐—评分"三段拼成一个端到端模型的参照实现,并附带 super-pixel 级可解释图。
§0 读法三则:
- 这个条目解决的核心误读是"Brixia 是不是又一个 COVID 胸片二分类集"——不是:它的标注粒度是每张 6 个有序整数 + 1 个总分,任务是评分回归(序数估计),不是分类(§2、§5)。
- 全文所有规模数字都有版本含义(4,707 / 4,703 / 4,695),引用时必须带口径(坑 2)。
- 检索时若按本地 slug 里的 “peru” 去找秘鲁数据会一无所获——“peru” 是派发候选名的残留,数据集是纯意大利单中心产物(坑 1)。
§1 数据集速览:十问十答
Q1:BrixIA 到底是个什么?
一个 COVID-19 胸部 X 线数据集 + 一套六区半定量评分标注 + 一个参考网络 BS-Net 的组合体。全称 BrixIA COVID-19 Dataset,归属于 BrixIA COVID-19 Project。
Q2:有多少张图?
现行口径 4,695 张 CXR(修订版,剔除了采集质量有问题的 DICOM)。论文分析与 GitHub 官方定义用 4,703 张(3,311 训练 + 945 验证 + 447 测试),官网"采集量"表述用 4,707 张。三个数字都对,但含义不同(坑 2)。
Q3:评分体系是什么?
Brixia score:双肺正面片分六区(右肺 A/B/C、左肺 D/E/F),每区 0-3 分,全局分 = 六区之和,范围 0-18。0 分 = 无异常,1 分 = 间质浸润,2 分 = 间质+肺泡浸润(间质为主),3 分 = 间质+肺泡浸润(肺泡为主)。
Q4:谁标的?
不是集中重注——是当班放射科医师在日常报告里本来就写的判读结果(弱监督),涉及该科约 30 名专家。另有 150 张测试集图由 5 位医师重注形成共识金标准,Cohen 集 192 张由资深/初级两位医师双标。
Q5:数据从哪来?
意大利布雷西亚 ASST Spedali Civili di Brescia(布雷西亚市民医院)第 2 放射科,从医院 RIS-PACS 系统导出,2020-03-04 至 2020-04-04 疫情峰值期一个月的次重症与重症监护病房胸片。
Q6:格式与许可?
DICOM 匿名化文件 + CSV 标注与元数据。许可不是标准 CC,而是官网注册 + Research Use Agreement(仅研究用途、禁售卖、禁分享下载链接、非学术用途需逐案评估)。
Q7:怎么拿到?
在 https://brixia.github.io/ 注册,经邮件收到下载链接。Cohen 集的 Brixia 标注(192 张)在 GitHub 仓库里是公开直链 CSV,无需注册。
Q8:配的网络是什么?
BS-Net:端到端三段式架构——U-Net++ 肺分割 → 空间变换网络对齐 → ROI Pooling 抽六区 → 评分头。有三种配置:soft attention(SA)、hard attention(HA)、两者集成(ENS)。
Q9:效果如何?
盲测集六区平均 MAE:ENS 0.441 / HA 0.471 / SA 0.496;对照普通 ResNet-18 为 0.517。在 150 张共识金标准上,BS-Net(ENS) 的 MAE 为 0.424,低于放射科医师两两之间的平均 MAE 0.528。
Q10:跟库内其他 COVID 胸片集什么关系?
互补而非替代:库内的 covid-19-radiography、bimcv-covid、covidx-cxr 等多是诊断或影像归档,BrixIA 的独特处是严重度评分标注 + 共识金标准 + 端到端评分网络 + 可解释性四件套(§9)。
§2 数据构成与规格
2.1 规模、来源与机构构成
BrixIA 的数据来自一家医院、一个月、一类病房:
- 中心:ASST Spedali Civili di Brescia(布雷西亚市民医院)第 2 放射科(Radiology Unit 2),意大利伦巴第大区布雷西亚
- 时段:2020-03-04 至 2020-04-04,正好覆盖当地疫情第一波峰值的一个月
- 纳入:该时段内次重症监护病房与重症监护病房(sub-intensive and intensive care units)为分诊(triage)与患者监测所拍摄的全部胸片——论文强调这是"the entire amount of images",即不挑拣、不筛选,因此携带真实临床场景的全部变异性
- 来源系统:医院 RIS-PACS(放射信息系统与影像归档通信系统),直接从 DICOM 导入
- 去标识:图像由医院 BrixIA-Team 在放射科内完成去标识(de-identified),患者以匿名 Subject 标识,StudyId 亦为匿名编号
- 伦理:全部图像的采集、匿名化与公开使用经布雷西亚伦理委员会(ECBS)批准,批号 NP4121,该批件同时授权公开整个匿名数据集用于研究目的
规模口径(三源并列,见 FACTS §2、§9):
| 口径 | 数字 | 出处与含义 |
|---|---|---|
| 采集总量 | 4,707 | 官网"Get this dataset"段与论文 §4.3 正文所述采集量 |
| 分析入库 | 4,703 | 论文 Table 3 与 GitHub 官方定义(= 3,311 + 945 + 447) |
| 修订现行 | 4,695 | GitHub [Update] 剔除低质量 DICOM 后的现行流通量 → 本条目主口径 |
| 第三方子集 | 4,644 | ISNet 等外部工作所称"有症状(Brixia>0)子集",非原始项目口径(遗留疑点) |
机构构成是一个跨学科联合项目团队(JPT,joint project team),横跨布雷西亚大学两个系与一家医院:
- 布雷西亚大学(Università degli Studi di Brescia, UniBS)信息工程系(DII):Signoroni、Savardi、Benini、Adami、Leonardi(负责 AI 与软件)
- 布雷西亚大学 医学与外科专长、放射科学与公共卫生系(DSMC):Gibellini、Vaccher、Ravanelli、Borghesi、Maroldi、Farina(负责临床与放射)
- 临床数据方:ASST Spedali Civili di Brescia 第 2 放射科
2.2 图像规格与采集参数
论文 Table 3 给出了图像层面的完整画像:
| 参数 | 值 | 说明 |
|---|---|---|
| 模态 Modality | CR 62% — DX 38% | 计算机放射摄影 / 直接数字放射摄影,两种设备混采 |
| 投照位 View | AP 87% — PA 13% | 前后位(多为床旁/重症)为主,后前位(站立)为辅 |
| 图像尺寸 | (1056 ÷ 3050) × (1186 ÷ 3376) px | 跨设备、跨患者的尺寸区间,非统一尺寸 |
| 设备厂商 | Carestream, Siemens | 两个品牌 |
| 位深与数值 | 12-bit 灰度 → float32 [0,1] | 从 DICOM 直接导入并映射 |
| 格式 | DICOM | 匿名化 |
这组参数本身就是"真实临床场景"的证据:一张数据集里同时存在 CR 与 DX 两种成像原理、AP 与 PA 两种投照方向、从 1056 到 3376 像素的巨大尺寸跨度——论文正是以此论证该数据集"contains all the variability originating from a real clinical scenario",也让 BS-Net 的对齐模块(处理旋转、缩放、平移)有了现实必要性。
2.3 元数据与标注字段
数据集附带两个主要 CSV(字段以官网说明为准):
metadata_global_v1.csv(主元数据):
| 字段 | 含义 |
|---|---|
| filename | 对应 DICOM 文件名 |
| StudyDate | 拍摄日期(YYYYMMdd) |
| Modality | DX 或 CR |
| StudyId | 匿名 RIS 生成的检查序号 |
| BrixiaScore | 六区标注 ABCDEF,各 0-3 |
| BrixiaScoreGlobal | 六区之和,0-18 |
| ConsensusTestset | 该图是否被纳入共识集(由 4 位追加专家重注) |
| Subject | 匿名患者 id |
| Sex | 患者性别 |
| AgeAtStudyDateFiveYear | 五岁分组年龄(0-4 岁 = 0,5-9 岁 = 1,依此类推) |
metadata_consensus_v1.csv(共识集标注):
| 字段 | 含义 |
|---|---|
| filename | 对应 DICOM 文件名 |
| MeanA…MeanF | 5 位专家六区评分的均值,0-3 |
| S-Global(表中写作 Global score from means) | 由均值求和得到的全局分,0-18 |
| ModeA…ModeF | 5 位专家六区评分的众数,0-3 |
| J-Global(表中写作 Global score from modes) | 由众数求和得到的全局分,0-18 |
public-annotations.csv(Cohen 集贡献标注):
| 字段 | 含义 |
|---|---|
| filename | Cohen 数据集中的文件名 |
| S-A … S-F | 资深放射科医师(board-certified,+20 年经验)六区标注 0-3 |
| S-Global | 资深医师全局分(S-A…S-F 之和)0-18 |
| J-A … J-F | 初级放射科医师(trainee,+2 年经验)六区标注 0-3 |
| J-Global | 初级医师全局分(J-A…J-F 之和)0-18 |
注意 Senior 与 Junior 的标注是独立双标,不取平均——这为研究"资历是否影响评分一致性"留下了直接对照面。
2.4 与相关数据集的边界
理解 BrixIA 的定位,需要划清四条边界:
- 与诊断二分类集不同:库内
covid-19-radiography(217)、covidx-cxr(197) 等做的是"有无 COVID-19"的判别;BrixIA 做的是"有多严重"的评分,标注是六区整数。 - 与同院前作不同:Borghesi & Maroldi 2020(Radiol Med 125:509-513)是评分体系的首提论文,Borghesi et al. 2020(Int J Infect Dis 96:291-293,302 患者)是该评分的临床验证论文;两者都不公开数据集。BrixIA 是评分的数据集化与 AI 化。
- 与 Cohen 集的关系:BrixIA 从公开的 ieee8023/covid-chestxray-dataset(Cohen et al.)借用 192 张外部 CXR 做跨中心可移植性测试,并回赠了 Brixia score 标注(CC BY-NC-SA 4.0 公开直链)。这是一次"数据借用 + 标注回馈",不是简单聚合。
- 与 MBrixia 的关系:MBrixia(Modified Brixia,丹麦哥本哈根)是下游衍生评分体系,改进了原始 Brixia 的区划/档位,并以 BS-Net 为自动化先驱(§8)。
§3 Brixia score:一套被写进日常报告的六区评分
3.1 评分体系的解剖学定义
Brixia score 的全部定义可以浓缩成三句话:双肺各分三区、每区 0-3 分、六区之和 0-18 分。但细节决定成败,以下按论文 §3.1 与首提论文 Borghesi & Maroldi 2020 的原文逐条落实:
分区(zones):在正面胸片(AP 或 PA)上,双肺各被两条水平线分成上、中、下三个区,合计六区:
- 右肺:A(上)、B(中)、C(下)
- 左肺:D(上)、E(中)、F(下)
两条解剖界标线:
- Line A:画在主动脉弓下缘水平(“at the level of the inferior wall of the aortic arch”)——它分出上区(A、D)与中区(B、E)
- Line B:画在右下肺静脉下缘水平(“at the level of the inferior wall of the right inferior pulmonary vein”)——它分出中区(B、E)与下区(C、F)
- 退化规则:评分体系作者明确建议,若因图像质量或解剖变异难以识别这两条界标,可将肺野三等分替代(该规则见于 Borghesi & Maroldi 2020,并在后续引用文献中被反复复述)
四档评分(0-3)——按病灶类型与程度的组合编码:
| 分数 | 英文原文 | 中文含义 |
|---|---|---|
| 0 | no lung abnormalities | 无肺部异常 |
| 1 | interstitial infiltrates | 间质浸润 |
| 2 | interstitial and alveolar infiltrates, interstitial dominant | 间质与肺泡浸润并存,以间质为主 |
| 3 | interstitial and alveolar infiltrates, alveolar dominant | 间质与肺泡浸润并存,以肺泡为主 |
全局分(Global Score) = A + B + C + D + E + F,范围 [0, 18]。临床报告中的呈现惯例是"全局分 + 方括号内六区分数",形如 8 [1 2 1 1 2 1],其中字母顺序固定为 A→F。
3.2 设计动机:把"位置"与"性质"压进一个数字
论文给出的设计理由非常实用主义:日常阅片中胸片必然由不同放射科医师轮班出具,如果只给一个笼统的总体严重度,不同医师之间几乎无法比较;而 Brixia score 把"病灶在哪一区"(空间信息)与"病灶是哪一类型"(性质信息)合并编码成一个六元整数组,使得:
- 跨医师比较变快且显著更一致(“makes the comparison of CXR exams faster and significantly more consistent”);
- 纵向追踪成为可能——同一患者逐日拍摄的胸片可以直接比较六区分数的变化,服务"监测病情进展与疗效"的临床需求;
- AI 学习有了明确的监督目标——六区整数比"轻/中/重"这样的模糊标签更容易被网络拟合。
这是一套**半定量(semi-quantitative)**体系:它把放射科医师的定性判断映射到有序数值尺度上。论文也直言其代价——半定量评分"characterized by a certain degree of subjectivity"(带有一定主观性),这正是观察者间一致性只能到 kappa ≈ 0.4 的根源(§4.4)。
3.3 与同时期其他评分的对照
论文 §3.2、§3.3 系统比较了当时使用中的三种半定量评分,BrixIA 数据集与 BS-Net 都对它们做了适配测试:
| 评分 | 结构 | 范围 | 与 Brixia 的关系 |
|---|---|---|---|
| Brixia score | 六区 × 0-3 有序分 | 全局 0-18 | 本数据集本体,分区最细、档位最多 |
| Toussie score(T score) | 六区 × 0/1 二值 | 全局 0-6 | 分区方案本质复刻 Brixia;可由 Brixia 的 {1,2,3} 统一映射为 1 直接导出 |
| GE-LO score | 每肺一对值:地理范围 GE + 肺不透明度 LO | GE 0-8 / LO 0-6 | 源自肺水肿复合评分(Warren et al. 2018),Cohen et al. 2020 采用;与 Brixia 无直接对应,只能靠线性回归估计(§4.5) |
论文的判断是:Brixia 在**表达力(intensity scale granularity)与定位能力(localization capacity)**上都比另两者更细——T score 丢掉了严重度梯度(六区都只记"有没有"),GE-LO 丢掉了分区(只在肺级别给一对值)。代价是评分者负担与主观性更高。这构成了一个"分辨率 vs 可重复性"的经典权衡,也是论文反复强调的主题。
3.4 评分体系的临床背书(spectrum 上游)
Brixia score 不是为 AI 项目而生,它有独立的临床谱系:
- 首提:Borghesi A, Maroldi R. COVID-19 outbreak in Italy: experimental chest X-ray scoring system for quantifying and monitoring disease progression. Radiol Med. 2020;125:509-513. —— 该文提出评分并给出示例胸片与评分呈现格式(带方括号六区分的写法源自此文)。
- 验证:Borghesi A, Zigliani A, Golemi S, Carapella N, Maculotti P, Farina D, Maroldi R. Chest X-ray severity index as a predictor of in-hospital mortality in coronavirus disease 2019: A study of 302 patients from Italy. Int J Infect Dis. 2020;96:291-293. DOI 10.1016/j.ijid.2020.05.021 —— 302 例住院 COVID-19 白人患者回顾性研究,多因素 logistic 回归显示只有 Brixia score、患者年龄、免疫抑制状态是院内死亡的独立预测因子;ROC 分析给出最佳截断值:Brixia 8 分、年龄 71 岁。该文还报告了关键临床观察:死亡患者的 Brixia 分数显著高于出院患者。
- AI 化:本数据集与 BS-Net(Signoroni et al., Medical Image Analysis 2021)——把评分从"人工报告惯例"变成"可自动预测的监督目标"。
这条链条意味着 BrixIA 的数据价值不只在于图像量,更在于它承载的评分已被独立临床研究证明有预后价值——这使它区别于纯技术导向的影像集。
§4 BS-Net 与核心结果:机器能否学会一套有主观性的评分
4.1 架构总览:三段式端到端
BS-Net 的设计哲学是"把医生打分的认知过程拆解成可训练的模块,再用一个端到端损失把它们缝回一起"。论文图 4 给出的流程如下:
- Backbone(骨干特征提取):输入 CXR 经一串卷积块提取多尺度特征。论文在 ResNet / VGG / DenseNet / Inception 等候选骨干中做了选型实验,该骨干同时充当分割网络的编码器与分类分支 FPN 的特征提取器。
- Segmentation(肺分割):用 U-Net++(又称 extended-Unet,一种嵌套式 U-Net,专为医学图像分割设计)从骨干特征预测肺部分割概率图。这一步的作用是把"肺"从胸片里的肋骨、心脏、体外设备、气体等干扰中剥离出来。
- Alignment(空间对齐):用 空间变换网络(spatial transformer network) 从分割图估计一个 6 参数仿射变换矩阵,据此对多尺度特征图做双线性重采样对齐(居中、旋转、缩放)。该模块在合成对齐数据集上以 Dice 损失弱监督预训练——不给变换矩阵真值,只给变换前的原始掩码,因此是弱监督。论文实测对齐补偿的旋转范围约 ±15°,与预训练的 ±25° 设计一致。对齐模块使 MAE 较无对齐情形提升约 20-25%。
- ROI Pooling(六区池化):从对齐后的特征图中抽取 6 个 Brixia 分区——垂直方向 25% 重叠、水平方向不重叠(论文解释:左右肺边界容易识别,故水平不重叠;而上下分区变异性大,故留重叠容错)。这一步把解剖先验(六区位置)注入网络。
- Scoring head(评分头):对六区特征分别回归 0-3 的分数,并汇总得全局分。
硬注意力 vs 软注意力:论文提供两种配置——SA(soft attention) 直接使用对齐后的特征;HA(hard attention) 用分割掩码把肺外区域的响应"关掉",只让肺内信息流过;ENS(ensemble) 则把 SA 与 HA 的预测集成。实验显示 ENS 是全局最优配置。
4.2 分割与对齐的中间结果
- 肺分割性能(论文 Table 4):U-Net++ 骨干 ResNet-18 → Dice 0.971 / IoU 0.945;U-Net 骨干 ResNet-18 → Dice 0.969 / IoU 0.941。两者都接近饱和,说明"找肺"这一步在这批数据上已基本解决。
- 分割预训练数据(论文 Table 1):Montgomery County 88/50 + Shenzhen Hospital 516/50 + JSRT 124/123 = 728 训练 / 223 测试。注意 BrixIA 自己是不带分割掩码的——肺分割能力来自这些外部数据集,BrixIA 只提供评分标注。
- 对齐鲁棒性(§6.9):把一个测试集图像人为旋转 ±30°,无论是否诱导旋转,对齐块都能带来 MAE 改善;对齐块的补偿能力在 ±15° 内实际有效。
4.3 盲测集评分结果(论文 Table 5)
在 447 张(论文正文一处称 450,见坑 3)盲测集上、以单一放射科医师 R0 的临床标注为参照,六区平均 MAE 如下:
| 配置 | 六区平均 MAE | 全局分 MAE |
|---|---|---|
| BS-Net-ENS(SA+HA 集成) | 0.441 | 1.728 |
| BS-Net-HA(硬注意力) | 0.471 | 1.826 |
| BS-Net-SA(软注意力) | 0.496 | 1.846 |
| ResNet-18(all-in-one 对照) | 0.517 | 1.951 |
三个关键读法:
- BS-Net 三种配置全部优于朴素 ResNet-18——论文原话是 all-in-one ResNet-18 “always the worst option compared to the three BS-Net configs”。这说明"分割+对齐+分区"的多模块设计确有增益,而非装饰。
- ENS 最优,因为它同时继承了 SA 的全局感受野与 HA 的肺内聚焦。
- MAE 的量纲解释:论文给了极重要的一句"naively speaking"注脚——单区评分范围只有 0-3 四个整数,因此单区 MAE 低于 0.5 意味着平均误差小于"半个等级";而全局分是 0-18,MAE 1.728 相当于"总分上平均差不到 2 分"。这为理解所有 MAE 数字提供了标尺。
4.4 共识金标准:机器 vs 人类的直接对决(论文 Table 6)
仅与单一医师 R0 比对是不够的——因为 R0 自己也不可能完全一致地复现。为建立可靠参照,论文构造了 Consensus-based Gold Standard(CbGS):从测试集中取 150 张,另请 4 位放射科医师(R1-R4) 重注,与原报告医师 R0 合计 5 人,由多次评分派生共识参照(对应 metadata_consensus_v1.csv 的 Mean/Mode 两套)。
关键结果(论文 Table 6):
| 比较 | 六区平均 MAE | 全局分 MAE |
|---|---|---|
| BS-Net(ENS) vs CbGS 共识金标准 | 0.424 | 1.787 |
| BS-Net(ENS) vs 单一医师 R0 | 0.452 | 1.847 |
| 人工两两平均(所有 Ri vs Rj 对) | 0.528 | 2.592 |
这张表是全文最有力的论证:机器对共识金标准的 MAE(0.424)低于放射科医师两两之间的平均 MAE(0.528)——换言之,一个训练有素的网络在这批数据上的评分,比"随机挑两位放射科医师互相比较"更接近五人的共识。论文据此主张 BS-Net 具备"超越单个人类标注者的评分准确度与一致性"的能力,并支持将其用于计算机辅助监测场景。
4.5 观察者间一致性:评分的隐含天花板
论文同时诚实地报告了人类自身的不一致:基于单区分数计算,两两 Cohen’s kappa 与多评价者 Fleiss’ kappa 均约为 0.4,属于"中等一致(moderate agreement)"。
论文对 0.4 的解读是双面的:
- 一方面,这印证了 Brixia score 的设计目标——它在"最大化评分的表达力"与"保持可重复性"之间做出了艰难妥协(“a tough compromise”),分区越细、档位越多,一致性越难保证;
- 另一方面,这是弱监督方法的固有误差源:人类标注本身不一致,就为模型性能设定了隐含上限(implicit limit)。论文明确指出,正因为此,才需要构建共识金标准来作为人类性能的边界度量。
这个 0.4 是理解 BrixIA 一切数字的前提:它不是一个"标签很干净"的数据集,而是一个"标签来自真实临床、带真实噪声"的数据集。
4.6 可移植性测试:跨中心时人类仍然更强(论文 Table 9)
论文的第三个维度是泛化能力——把 BS-Net 迁移到完全不同来源的公开数据(Cohen 集,192 张外部 CXR)并打分,与资深/初级医师标注对照:
| 对象 | 全量集 MAE | 子集 MAE | 全局分 MAE(全量) |
|---|---|---|---|
| 放射科医师(人类参照) | 0.405 | 0.415 | 1.974 |
| BS-Net-HA(全量微调) | 0.518 | 0.490 | 2.214 |
| BS-Net 从零训练(subset) | — | 0.517 | 2.188 |
论文的坦率结论是:跨中心迁移时,熟练的人类观察者泛化更强(MAE 0.405 < 0.518);网络在缩小后的子集上即便重训也无法复现其在 BrixIA 本域的成绩。这暴露了单中心训练模型的外推局限——数据集本身提供了这个检验场,也主动报告了这个不利结果,是该项目的方法论亮点。
4.7 GE-LO 对照与可解释性
- GE-LO 对照(§6.6,Table 8):BS-Net-ENS 在预测肺不透明度 LO 分上与 Cohen et al. 报告的最佳方法对照——R² 0.84±0.05(BS-Net on Cohen set)vs 0.80±0.05(Best [12]),MAE 0.67±0.10 vs 1.14±0.11,即 BS-Net 在跨分数体系任务上亦具竞争力。
- 可解释性(§6.8):BS-Net 生成 super-pixel 级的关注度图(explainability maps),逐区可视化网络在做出评分时"看了哪里",且可与 Brixia 六区分区直接叠加对照供临床核查。论文也如实展示了两个失败案例(预测与 R0 差异较大的"critical cases"),其中一个的错误源于右肺分割把一段含气结肠误纳入掩码、导致对应区域被错误评估——这类诚实的误差分析提升了条目的可信度。
4.8 逐区性能:误差在六个区之间均匀吗
论文 Table 5 给出的不只是平均值,而是 A-F 六区各自的 MAE(BS-Net-ENS 配置):A 0.459、B 0.448、C 0.412、D 0.374、E 0.459、F 0.494。几点观察值得记录:
- 误差量级高度一致——六区全部落在 0.37-0.50 的窄带内,说明模型的误差不是被某一两个"难区"拖累,而是呈现全肺均匀分布。这与"评分是全局视觉任务"的直觉一致。
- 右下区(F,0.494)与中区(A、E,均 0.459)误差最大,而左肺下区(D,0.374)最小。论文未对逐区差异作专门解释,但可以合理推测:下肺野靠近膈肌与腹部结构,叠加心影与含气肠管的干扰,分割与评分都更易出偏(论文展示的失败案例正是含气结肠误入右肺掩码)。
- 均值的"均匀性"本身是结果——若某一区 MAE 显著偏高,就意味着该区的视觉线索对网络不可学,那将动摇"六区评分可端到端学习"的立论。逐区数据支持了论文的核心主张。
同样的逐区精度在共识擂台上(Table 6 上半部)也得到复现,且与人工两两比较(下半部)的逐区差异模式类似——这进一步说明人类与模型犯错的区域大体是相同的区域,而非模型独有某种系统性盲区。
4.9 一致性矩阵与混淆模式
论文图 6 给出了四个网络(BS-Net-ENS/SA/HA 与 ResNet-18)在六区分数上的一致性/混淆矩阵,用于回答一个比 MAE 更细致的问题:模型的错误是"轻微偏移"还是"严重错判"?
- 对于整数评分任务,MAE 无法区分"把 2 判成 1"和"把 3 判成 0"两种错误——但混淆矩阵可以。论文报告的混淆模式显示,绝大多数误差集中在相邻档位之间(off-by-one),跨档严重的错判(如 0↔3)很少。
- 这与 MAE 的解读互补:六区平均 MAE 0.441 在 0-3 量纲上接近"半级误差",而混淆矩阵证明这半级误差主要是"方向正确但档位微偏",而非随机乱猜。
- 论文在讨论中把这一模式与评分体系的设计联系起来:Brixia score 的四个档位是有序的(0<1<2<3 表示病灶从无到间质再到肺泡为主),模型学到的正是这个有序结构,而不是把四档当作无序类别——这是"任务可学"的重要证据。
对使用者而言,这意味着:用 BS-Net 做严重度分级辅助时,其错误更可能是"评分略保守/略激进",而非"把重症判为正常"——这一性质的临床安全含义远好于单纯看 MAE 所暗示的。
4.10 消融与鲁棒性:每个模块到底贡献了多少
论文 §6.9 做了完整的消融与变化研究,逐项交代了各模块的边际贡献,这些数字对打算复用架构的人最有价值:
(1)端到端训练:把分割、对齐、评分三段联合优化,优于分阶段独立训练——全局端到端损失"把三块粘成一个模型"(“the glue that concurs to the creation of a single end-to-end model”)。
(2)特征提取骨干:论文在 ResNet / VGG / DenseNet / Inception 等候选骨干中做了选型,最终采用的配置在精度与显存之间取得平衡(论文提到受显存限制,某些配置未能完成完整微调,并以 (∗) 标注——这是一处真实的工程约束披露)。
(3)数据增强策略(Table 旁论文讨论的 train/val MAE 对照):
| 增强策略 | 训练 MAE (SD) | 验证 MAE (SD) |
|---|---|---|
| 无增强 | 0.306 (0.490) | 0.528 (0.610) |
| 亮度与对比度 | 0.341 (0.518) | 0.550 (0.628) |
| 几何变换 | 0.272 (0.460) | 0.541 (0.623) |
| 全部(预处理前) | 0.437 (0.585) | 0.571 (0.645) |
| 全部(预处理后) | 0.455 (0.578) | 0.469 (0.583) |
读法:训练 MAE 与验证 MAE 的差距揭示了过拟合与泛化的权衡。无增强时训练 MAE 最低(0.306)但验证 MAE 偏高(0.528),是典型的记忆现象;"全部增强 + 预处理"组合把验证 MAE 压到最低(0.469),说明增强对泛化确有贡献。这类细粒度表格在论文中通常被略过,但它是判断"该架构有多依赖数据增强"的直接证据。
(4)多分辨率特征对齐器(FPN):论文比较了采用 FPN 与弃用 FPN 的性能——采用 FPN 时 train/val MAE 为 0.455/0.469,优于去掉 FPN 的 backbone-head 直连(0.395 训练/…)。论文另外指出,“增加一个分辨率层级会再次导致性能恶化”,这是一处与直觉相反的发现(更多尺度未必更好),也与显存约束交织。
(5)对齐模块的旋转鲁棒性(图 11):把测试图像人为旋转 -30° 到 +30°,测量有无对齐补偿时的 MAE 变化。结论有两点:其一,即便在 0°(无人为旋转),对齐块也带来明显的 MAE 改善——因为真实数据本身就带自然的错位;其二,人工旋转增大时,对齐块的优势进一步扩大,实际补偿范围约 ±15°(与预训练设计的 ±25° 一致但更窄)。
这一整套消融传达了项目的方法论态度:不把"我们的架构更好"当口号,而是逐模块给出可核查的边际贡献数字——这也是它作为"AI-Ready 参考实现"的价值所在。
4.11 与同时期 COVID 严重度评分方法的横向位置
论文在 §3.4 与 §6 中把自己放进当时的文献版图:
- 诊断类研究远多于评分类:论文直言,COVID 疫情促使公开数据集大量涌现,但研究"几乎全部极化在二分类/鉴别诊断"(“catalyzed the research almost exclusively on assisted COVID-19 diagnosis”),而严重度评分研究"数量上不成比例地少"。BrixIA 正是在这个空白处落子。
- 评分类研究的对手:论文提到 Cohen et al. 2020a(GE-LO 体系)等少数同时期评分工作,并直接做了对照(§4.7)。BS-Net 在 LO 分预测上的 R²(0.84 vs 0.80)与 MAE(0.67 vs 1.14)均优于其报告的"最佳"结果。
- "是否需要专门设计"的立场:论文批评了一种流行观点(引 [58])——认为有了现成的迁移学习网络就无需为医学任务专门设计架构。BrixIA 的经验数据(BS-Net 三配置全胜朴素 ResNet-18、对齐块带来 20-25% 增益)正是对这一观点的实证反驳。
这段横向定位解释了为什么一篇"数据集论文"要花大量篇幅讲网络设计:在严重度评分这个当时被冷落的任务上,"数据 + 专用架构 + 评测协议"必须成套给出,才有说服力。
4.12 结果解读的四个陷阱
论文的数字表若不加辨析直接引用,容易踩到以下四处:
- MAE 币值不可跨表混用。区域级 MAE(0.441)与全局分 MAE(1.728)单位不同:前者是 0-3 量纲下的单区误差,后者是 0-18 量纲下的总分误差。把 0.441 说成"总分误差"是最常见的引用错误。
- "优于人类"需绑定具体对照。BS-Net 的 0.424 是相对 CbGS 共识而言;若换成"相对某一位放射科医师",数值是 0.452。人类两两互比是 0.528。三者的关系是 0.424 < 0.452 < 0.528,引用时必须写明分母。
- 跨中心数字是另一场实验。0.518(BS-Net-HA 跨中心区域级)与 0.441(同中心)不可同框比较,而且跨中心实验里人类反而更强(0.405),直接反转了同中心的结论。
- 消融表里的低训练 MAE 不代表更好。无增强配置训练 MAE 最低(0.306)却是过拟合,验证 MAE 反而偏高(0.528);只看训练列会得出完全相反的架构选择。
理解了这四点,就能读懂论文"既展示优势又暴露局限"的克制写法:所有关键数字都配了"对谁算的"这个前缀。
4.13 论文的可复现性设计
论文在可复现性上做了三项明确安排,值得单独记一笔:
- 固定划分公开:3,311/945/447 的划分以清单形式随数据集发布,后来者可在同一划分上比较,避免了"各切各的"导致的高分通胀。
- 两套标注都开放:Cohen 子集(192 张,双放射科医师)与 CbGS(150 张,五人共识)的标注均在仓库公开,使"对 R0"与"对 CbGS"两种评测都可被第三方复算。
- 分割预训练数据与超参披露:Table 1/Table 2 给出分割训练集明细与对齐合成参数,使三段式架构的每一段都可被独立复现。
这三项安排使 BrixIA 从"一个数据集"升级为"一套可被挑战的基准"——对 AI-Ready 资源而言,这比单纯的数据规模更有长期价值。
§5 标注是怎样生产的:临床流程即标注流程
5.1 第一层:当班放射科医师的日常报告(弱监督的根源)
BrixIA 最独特、也最容易被误解的一点是:它没有"标注项目"。数据集的六区分数不是项目组事后组织的重注产物,而是放射科在日常工作中本来就写进报告的结果。
论文描述得很清楚:这批 CXR 的评分直接来自患者病历中的报告,由当时值班的报告放射科医师出具——“as provided by the reporting radiologist on duty among the about 30 specialists forming the radiology staff”。也就是说:
- 标注者是一个约 30 人规模的放射科团队的轮班成员,而非固定几位;
- 判读发生在真实的临床压力下(疫情峰值、每日大量胸片、危重患者);
- 评分写进报告是为了临床沟通与患者管理,不是为了训练模型。
这带来两个直接后果,也构成条目必须存照的事实:
- 标签含真实个体差异——不同资历、不同专长的医师对同一张图的判断可能不同,这正是 observing kappa ≈ 0.4(§4.4)的来源;
- 弱监督(weakly supervised)成为必然选择——因为标签不是"干净 gold standard",BS-Net 的训练策略从设计上就接受"标签有噪声"这一前提,并把共识金标准单独用来度量人类性能边界。
论文把这一选择表述为优势而非缺陷:它使数据集"a complete and faithful picture of an intense and emergency-driven clinical activity"(一幅完整而忠实的、高强度急诊驱动临床活动的图景)。
5.2 第二层:150 张共识金标准(5 位医师的第二次判读)
为了给"单一个人标注"与"机器评分"提供可靠参照,项目组织了唯一一次集中重注:
- 对象:测试集内的 150 张 image(ConsensusTestset = 是)
- 人员:在原始报告医师 R0 之外,另请 4 位放射科医师 R1、R2、R3、R4 独立重注
- 产出:合计 5 人的评分 → 派生两套共识表示,落成
metadata_consensus_v1.csv:- Mean 版(MeanA…MeanF + 由均值求和的全局分):保留分歧的连续信息,适合回归任务参照
- Mode 版(ModeA…ModeF + 由众数求和的全局分):取最常见档位,适合分类/一致性分析
- 用途:论文 §6.4 的全部"机器 vs 人类"对比都以该子集为擂台(§4.4);它同时充当"人类性能的天花板"度量
值得注意的是,论文这里做了一个透明的方法论说明:单区 MAE 低于 0.5 在 0-3 量纲上意味着"平均误差不足半级",但由于评分本身有主观性,仅看单区误差"clearly not sufficient",必须借助 CbGS 这样的多评价者参照才能判断模型是否真的达到临床可用的精度水准。
5.3 第三层:Cohen 集 192 张的双医师对照标注
为检验跨中心可移植性,项目从公开的 Cohen et al.(ieee8023/covid-chestxray-dataset) 借来外部 CXR(下载于 2020-05-11 的副本),并回馈标注:
- 标注者:两位放射科医师——一位 board-certified 资深医师(+20 年经验)、一位 trainee 初级医师(+2 年经验)
- 工具:labelbox(在线标注平台)
- 筛选:剔除问题案例(图像缺失比例过大、分辨率/质量过低、因外部原因无法评分等)
- 结果:192 张 CXR 获得完整 Brixia score 标注
- 字段设计:Senior 与 Junior 各自独立出具六区分与全局分(S-A…S-F / S-Global 与 J-A…J-F / J-Global),不做平均
- 发布:
public-annotations.csv以 CC BY-NC-SA 4.0 在 GitHub 公开直链(无需注册),是整条 BrixIA 资产链中门槛最低的一块
这个双医师设计一举两得:既为 BS-Net 的跨域测试提供参照(§4.6 的"人类 0.405 vs 机器 0.518"),又为"资历是否影响 Brixia 评分一致性"留下直接数据面。
5.4 一个关键事实:BS-Net 的肺分割能力不来自 BrixIA
必须澄清的边界:BrixIA 数据集本身不含分割掩码。BS-Net 的肺分割模块(U-Net++)是在外部数据集上预训练的:
| 数据集 | 训练集 | 测试集 | 划分方式 |
|---|---|---|---|
| Montgomery County | 88 | 50 | 前 50 张为测试 |
| Shenzhen Hospital | 516 | 50 | 前 50 张为测试 |
| JSRT database | 124 | 123 | 原始划分 |
| 合计 | 728 | 223 | — |
对齐模块则在这些分割数据上生成合成对齐集(Table 2):随机旋转 25°(p=0.8)、缩放 10%(0.8)、平移 10%(0.8)、弹性形变 α=60/σ=12(0.2)、网格畸变 steps=5/limit=0.3(0.2)、光学畸变 distort=0.2(0.2),在线增强,以 Dice 损失弱监督预训练。
因此在使用 BrixIA 时,若想要"打分 + 分割"的完整流水线,需要自行准备分割数据(库内 chest-x-ray-segmentation(601)、jsrt(147)、montgomery-tb(157)、shenzhen-tb(167) 可直接复用,见 §9)。
§6 获取与许可:三层资产、三种门
6.1 三层资产、三种门槛
BrixIA 项目对外释放的资产至少分三层,许可与获取方式各不相同——这是检索者最容易混淆处:
| 层 | 资产 | 许可 | 获取方式 | 门槛 |
|---|---|---|---|---|
| 1 | BrixIA COVID-19 Dataset(4,695 张 DICOM + 标注元数据) | Research Use Agreement(研究用途协议) | 官网注册 → 邮件发下载链接 | 中(注册 + 学术身份承诺 + 禁再分发) |
| 2 | Cohen 集 Brixia 标注(192 张,public-annotations.csv) | CC BY-NC-SA 4.0 | GitHub 公开直链 | 低(无需注册) |
| 3 | BS-Net 代码 + 模型权重 | Open Source license | GitHub 仓库 + Google Drive 权重 | 低(代码);中(权重,Drive 链接易失效) |
此外论文本身:arXiv HTML 页标注 CC BY-NC-ND 4.0(这是论文许可,不是数据集许可——坑 4)。
6.2 数据集本体:Research Use Agreement 逐条
数据集本体的许可不是任何标准 CC 协议,而是一份自拟的 Research Use Agreement(研究用途协议)。按官网原文(Premise + 编号条款)归纳:
背景(Premise):
- BrixIA COVID-19 项目是一组针对 COVID-19 受试者放射影像与临床数据的 AI 解读活动,数据采集于意大利布雷西亚 ASST Spedali Civili(ASST-BS)疫情期;
- 研究由布雷西亚大学(UniBS)两个系组成的联合项目团队(JPT)执行——信息工程系(DII) 与医学与外科专长、放射科学与公共卫生系(DSMC);
- 研究活动与数据分发经**布雷西亚伦理委员会(ECBS)**批准,全部影像与相关报告、数据由 BrixIA-Team 在 ASST-BS 第 2 放射科完成去标识。
核心条款:
- Permission is granted to view and use the “BrixIA COVID-19 Dataset” without charge for research purposes only. Its sale is prohibited.(可免费查看与使用,仅限研究用途,禁止售卖)
- Any non-academic research use need to be evaluated case by case by the JPT in coordination with ASST-BS.(非学术研究用途需由 JPT 会同 ASST-BS 逐案评估——无自动授权路径)
- 注册下载即视为同意上述条款;
- It is forbidden to share the link to download the dataset with others.(禁止把下载链接分享给他人)
- 数据按 “as-is” 提供,无质量或功能担保,无正式技术支持。
- 本仓库及项目任何部分不得用于医疗目的——尤其不得用于医疗决策、干预或诊断的支持、证据获取或辅助(GitHub License 段 Disclaimer)。
实操要点:想拿数据的人必须在 https://brixia.github.io/ 注册,然后等待邮件收到下载链接;链接是个性化/邮件制的,不能转发。这既保护了患者数据,也让"能不能下"取决于注册审核——是本库中"中门槛"获取的典型代表。
6.3 解包与目录约定
官网给出的解包方法(多卷 tar.gz):
- 类 Unix:
cat *.tar.gz.* | tar -xzv - Windows:
type *.tar.gz.* | tar xvfz - - 解包后生成
dicom_clean目录,内含全部匿名化 DICOM
数据加载示例(GitHub 提供的 Python 接口,需把 src 加入库路径):
# 加载 Cohen 集的 Brixia 标注
from datasets import brixiascore_cohen as bsc
X_train, X_test, y_train, y_test = bsc.get_data()

# 准备并加载分割数据集(需先下载 Montgomery/Shenzhen/JSRT 并解包到 data/sources/)
# python3 -m datasets.lung_segmentation --input_folder data/sources/ --target_size 512
from datasets import lung_segmentation as ls
train_gen, (val_imgs, val_masks) = ls.get_data()

# 准备并加载对齐合成数据集(依赖已构建的分割集)
from datasets import synthetic_alignment as sa
train_gen, val_gen = sa.get_data()
代码依赖:Python 3.x + pip install -r requirements.txt;论文建议用 tensorflow-gpu 替代 CPU 版以获得性能。
6.4 版本链与修订记录
数据集的流通版本有几个明确的节点,检索时需对齐:
metadata_global_v1.csv—— 主元数据(含 ConsensusTestset 标志列),对应初版 4,703 张metadata_consensus_v1.csv—— 共识集 5 人 Mean/Mode 标注表(150 张子集)- 修订公告(GitHub [Update]) —— “We revised the dataset and removed the DICOM found to have acquisition problems (low quality). The total now is 4695.” —— 这是现行主口径 4,695 的出处
- 伦理批件更新 —— NP4121,GitHub 记 last update 08/07/2020
双口径并存现象:官网"Get this dataset"区块的正文至今仍写 4,707(采集量口径),与 GitHub 的 4,695 修订公告并存于同一项目不同页面——这不是错误,而是"采集量"与"流通量"两个概念被并列保留的结果(坑 2)。
6.5 AI-Ready 评估:一个中性偏强的样本
按本库的 AI-Ready 光谱看,BrixIA 的三层资产强弱分布鲜明:
- 强项:① 标注直接来自临床、真实可信;② 有 150 张五人共识金标准作为可复现的评测锚点;③ 有 192 张公开直链的跨中心标注;④ 有完整的端到端参考实现与权重;⑤ 有可解释性输出。
- 弱项:① 数据集本体注册制、无公开直链,自动化 pipeline 难以直接接入;② 无分割掩码(评分标注与分割任务解耦);③ 唯一患者数未披露,无法做患者级划分核查;④ 单中心单时段,外推性受限;⑤ 项目与仓库更新冻结(README 最后更新 2022-01-17)。
这种"标注质量高、可复现锚点强,但本体分发受限、时间与场地单一"的画像,正是疫情期间应急数据集常见的形态——它用"临床真实性"换取了"获取便利性"。
6.6 与库内可获取性光谱的对照
把 BrixIA 放进本库的获取光谱里,它落在偏限制的一端,但比纯"申请制"要好:
| 条目 | 获取方式 | 光谱位置 |
|---|---|---|
| chexpert / mimic-cxr | 多数需注册或凭证(部分受限) | 中 |
| BrixIA | 注册 + Research Use Agreement + 邮件链接 | 中偏限制 |
| PANDA-PLUS 掩码 | upon qualified request(邮件通讯作者) | 限制 |
| bimcv-covid / covidx-cxr | 公开或注册直链 | 偏开放 |
关键区别在于:BrixIA 是"同意条款即可自助获取"(注册后邮件发链接、无需人工审批研究计划),而 PANDA-PLUS 掩码是"需向作者说明用途与机构、等待人工批准"。前者是协议制,后者是请求制——BrixIA 的门槛更接近"自动授权 + 用途约束",只有非学术用途才触发逐案评估。
6.7 一套合规使用清单(供使用者自查)
在动手用 BrixIA 之前,建议逐条核对:
- 用途:是学术研究吗?若是商业/非学术,先走 JPT 与 ASST-BS 的逐案评估,不要自行假设授权。
- 注册:已通过 brixia.github.io 注册并接受 Research Use Agreement 吗?
- 链接保密:收到下载链接后,不得转发给他人——每位使用者应各自注册。
- 不得售卖:协议明令"sale is prohibited",即使是衍生产品也需谨慎评估。
- 非医疗用途:数据集与模型均声明"不得用于医疗目的"——不得用于真实临床的决策、诊断或干预。
- 署名:论文引用 Signoroni et al. 2021;使用评分体系本身宜同时引 Borghesi & Maroldi 2020 与 Borghesi et al. 2020。
- 版本记录:在方法学部分声明所用版本(4,695/4,703/4,707)与所用参照(R0/CbGS-Mean/CbGS-Mode)。
- 患者级划分:训练/测试划分必须按 Subject 分组,避免同患者多图泄漏。
- 时间切分:若研究"预测进展",需按 StudyDate 时间切分而非随机划分。
- 标注再分发:若要把 Brixia 标注再次发布,注意 Cohen 集部分是 CC BY-NC-SA 4.0,需保持相同许可(ShareAlike)且署名。
这份清单对应的是本库一贯强调的"AI-Ready 不只是数据可用,更是合规可用"。
6.8 获取流程的实操时序与常见卡点
把上面的规则落成一条可执行的时间线,便于研究者排期:
| 阶段 | 动作 | 预计耗时 | 常见卡点 |
|---|---|---|---|
| 1. 预检 | 读官网 About / GitHub README,确认协议条款 | 10 分钟 | 站点 TLS 偶发失败,改看 GitHub |
| 2. 注册 | 在 brixia.github.io 填表并接受 Research Use Agreement | 5 分钟 | 需机构邮箱;学生个人邮箱可能被拒 |
| 3. 等待链接 | 系统邮件发送下载链接 | 视审批策略而定 | 邮件可能落入垃圾箱;勿重复注册 |
| 4. 下载 | 获取影像库(数 GB 级 DICOM) | 视带宽 | 链接有时效性,过期需重新注册 |
| 5. 取标注 | 从仓库取 R0/R1-R4/Cohen/CbGS 标注 CSV | 即时 | ZIP 结构需先读 README 再解 |
| 6. 取权重 | (可选)从 Google Drive 取 BS-Net 权重 | 视链接 | 链接失效风险最高,建议尽早归档 |
| 7. 核对 | 校验图像数与标注行数是否自洽 | 半小时 | 4,695 与 4,703 差 8 张,需按版本核对 |
排期建议:把阶段 2-3 的审批时间视为不确定量,先并行推进代码与评测协议的设计,不要等数据到位才开工。若研究强依赖 BS-Net 权重,阶段 6 应最先执行并立刻本地备份。
替代路径:若无法获得本体,仍可基于公开的 Cohen/CbGS 标注子集与论文报告的数字展开方法学复算(例如重新推导人类一致性 kappa、复原划分统计),这在数据集不可得时是可接受的降级方案——但必须清楚说明未接触本体,不能声称复现了端到端结果。
§7 生态与谱系:一套评分体系的三代演化
7.1 上游:评分体系的临床谱系
BrixIA 的根不在深度学习,而在布雷西亚放射科的一个临床观察——COVID-19 胸片的肺部受累程度可以用分区打分来量化并追踪。这条临床谱系有三代:
- 第一代 · 首提(2020 早春):Borghesi A, Maroldi R. COVID-19 outbreak in Italy: experimental chest X-ray scoring system for quantifying and monitoring disease progression. Radiol Med. 2020;125:509-513. 在意大利疫情爆发初期由布雷西亚团队提出,用于量化与监测疾病进展。该文给出六区划分、0-3 评分档与带方括号的评分呈现格式。
- 第二代 · 临床验证(2020 年 5 月):Borghesi A, Zigliani A, Golemi S, Carapella N, Maculotti P, Farina D, Maroldi R. Chest X-ray severity index as a predictor of in-hospital mortality in coronavirus disease 2019: A study of 302 patients from Italy. Int J Infect Dis. 2020;96:291-293. DOI 10.1016/j.ijid.2020.05.021。302 例住院患者回顾性研究确立了评分的预后价值:Brixia score、年龄、免疫抑制是院内死亡的独立预测因子;ROC 最佳截断 8 分 / 71 岁。
- 第三代 · AI 化(2021):本条目主体——Signoroni et al. BS-Net… Medical Image Analysis 2021;71:102046,把评分数据化并训练出端到端评分网络。
这条链条的启示是:BrixIA 的价值一部分来自它下游的临床证据。一个 AI 模型的评分要"有意义",前提是这套评分本身已被临床研究证明关乎结局——BrixIA 恰好两头都占。
临床验证的关键细节(Borghesi et al. 2020,值得完整记录):
- 研究设计:回顾性研究,检索 2020-03-04 至 2020-03-24 期间所有含 Brixia score 的 CXR 报告;
- 纳入:住院、确诊 COVID-19(RT-PCR 阳性)、结局(出院或死亡)已知的白人患者;信息不全者排除;
- 变量:对每位患者取其评分最高的那张 CXR 报告,连同年龄、性别、基础病、免疫抑制治疗一起进模型;
- 样本:302 例;
- 结果:多因素 logistic 回归中,仅 Brixia score、年龄、诱发免疫抑制的疾病状态是院内死亡的显著预测因子;
- 截断值:ROC 分析给出最佳截断 Brixia 8 分 / 年龄 71 岁;
- 结论:高 Brixia 分且至少合并一项其他预测因子的患者死亡风险最高;含 Brixia 的三套模型均表现优秀预测力。
这篇验证文章的重要性在于:它为 Brixia score 提供了独立的临床终点背书(不是影像学自证),从而使后续在此评分上训练的 AI 模型具备了"临床相关性"的正当性。这也是 BrixIA 区别于"纯技术基准数据集"的根本所在。
7.1b COVID-19 胸片数据集景观中的位置
把 BrixIA 放进 2020-2021 年 COVID CXR 数据集的版图,它占据的是一个特定的生态位:
| 数据集 | 取向 | 规模 | 标注类型 | 与 BrixIA 的关系 |
|---|---|---|---|---|
| BrixIA | 严重度评分 | 4,695 | 六区 0-3 + 全局 0-18 | — |
| Cohen 集(ieee8023) | 诊断 + 严重度 | 数百 | 诊断标签 + 部分严重度 | BrixIA 借用其 192 张做跨中心测试 |
| BIMCV-COVID19 | 影像归档 | 数千 | 诊断/报告 | 库内 207,同病症不同任务 |
| COVID-iNet / covidx-cxr | 诊断分类 | 数千 | 二元诊断 | 库内 197 |
| COVID-19 Radiography | 诊断 + 分割 | 数万 | 诊断标签 + 肺掩码 | 库内 217,规模大但无严重度 |
BrixIA 的差异化在于:它不追求规模,而是追求"评分数值与临床终点挂钩"。在当时的版图中,同时具备"临床真实评分 + 多医师共识 + 端到端参考网络 + 可解释性"四要素的数据集,几乎只有它一个。这也是为什么一篇数据集论文能发表在 Medical Image Analysis(该领域顶刊之一)并被持续引用。
7.2 下游:MBrixia 与自动化评分的接续
评分体系没有被冻结在意大利,而是被明确改进并与 BS-Net 的自动化路线接续:
- MBrixia(Modified Brixia):由丹麦哥本哈根大学医院(Rigshospitalet / CHIP)团队改进,在 Scientific Reports 发表两篇:
- Sci Rep 2022(s41598-022-25397-7):290 次评分、37 名患者的可行性研究,报告 MBrixia 与当前呼吸支持水平强相关,并与 7 项炎症与器官损伤生物标志物正相关;
- Sci Rep 2026(s41598-026-39285-x):251 名患者,证明入院早期 MBrixia 分数与 90 天死亡率相关(最高档约 3 倍死亡风险),9 项生物标志物随分数上升、白蛋白与血红蛋白随之下落;三位不同资历放射科医师的一致性为中等,高分段差异更大。
- 关键接续点:MBrixia 论文明确把 Signoroni et al. 的 BS-Net 列为"自动化评分先驱",并指出"要训练自动化 MBrixia 模型,需要大规模、由经验放射科医师标注的高质量数据集"——即 BrixIA 范式被承认可复制,但受限于参考标签质量。
7.3 生态事件:Covid CXR Hackathon(2022)
BrixIA 与 BS-Net 的实战检验场是一次国际挑战赛:
- 名称:Covid CXR Hackathon — Artificial Intelligence for Covid-19 prognosis: aiming at accuracy and explainability(https://ai4covid-hackathon.it)
- 发布:2022-02-01,在 Expo 2020 Dubai 的 “Artificial Intelligence & Cybersecurity for Health” 研讨会(意大利、以色列、阿联酋合办)上启动
- 主办与支持:IIT(意大利技术研究院)+ Fondazione Bruno Kessler(FBK)+ UNIMORE(摩德纳与雷焦艾米利亚大学),经 ELLIS 网络的 Genoa/Modena/Technion 单元与 CINI-AIIS;支持方包括 Bracco Imaging、Centro Diagnostico Italiano(CDI)、NVIDIA
- 任务:基于胸片 + 分诊临床数据做 COVID-19 预后,强调 accuracy(准确率) 与 explainability(可解释性) 双重标准
- 数据:北意 6 家医院首波疫情分诊数据
- 结果(关键):
- UniBS 学生队(Edoardo Coppola、Damiano Ferrari,信息工程硕士二年级)夺"最佳可解释性"一等奖,并逼近准确率奖——其作品是 Information Engineering 系 Signoroni 教授主讲的 Image Data Analysis 课程的课程设计
- 匈牙利研究团队夺准确率奖
- 两队都使用了 BrixIA 影像库与 BS-Net——UniBS 官方新闻页明确记载这一点
- 意义:这是 BrixIA/BS-Net 影响力的直接证据——一个单中心数据集及其参考网络,成为两支获胜队伍的共同技术底座。
7.4 项目的外部引用与再使用
BrixIA 已被其他研究作为参照数据或对照基线引用,例如:
- RSNA Radiology: Artificial Intelligence 的 CXR 自动质控论文(doi 10.1148/ryai.240003)在数据可用性声明中列出 BrixIA COVID-19 dataset 作为可获取的公开 CXR 资源之一;
- 多篇 COVID-19 CXR 研究以 Brixia score 为严重度参照做热图/相关性分析(如 europepmc ppr416461 用 LRP 热图对照 Brixia 分区)。
这些再使用进一步说明:BrixIA 的具体图像量不是它影响力的主要来源,评分体系的通用性与可解释性接口才是。
§8 与库内条目的关系:家族图谱与检索路径
8.1 库内 CXR 家族的定位对照
库内 CXR 相关条目众多(status=1 中带 chest-x-ray 语义的超过 15 个),BrixIA 在其中的位置可用三个维度区分:任务类型 / 标注粒度 / 是否单中心。
| 维度 | BrixIA | 诊断类(如 covid-19-radiography, covidx-cxr) | 大规模多中心(如 chexpert, padchest, mimic-cxr) |
|---|---|---|---|
| 任务 | 严重度评分回归(0-18) | 二元/多元诊断分类 | 多标签诊断 + 报告 |
| 标注粒度 | 每图 6 个有序整数 + 总分 | 每图诊断标签 | 每图多标签 + 文本 |
| 中心 | 单中心一个月 | 多来源聚合 | 多中心多年 |
| 特色 | 共识金标准 + 可解释性 + 参考网络 | 规模/覆盖 | 规模/多任务 |
BrixIA 不与任何库内条目重叠:它不提供诊断标签,也不追求规模,而是提供可被临床结局背书的严重度评分数值。
8.2 可互链条目(含 rid)
同病症 · 同模态(最直接):
217 covid-19-radiography(COVID-19 放射学影像)197 covidx-cxr(COVID-iNet 衍生 CXR 集)207 bimcv-covid(西班牙瓦伦西亚 COVID-19 影像库)705 sar-covid(SARS-CoV-2 CXR 集)605 cdsl-covid-data-shared-learning(跨机构联邦学习 COVID 数据)307 covid-ct(对照模态)
同模态 · 通用胸片:
5 chexpert、125 vindr-cxr、629 vindr-pcxr、630 vindr-spinexr117 padchest(PadChest,西班牙大规模 CXR)16 mimic-cxr、617 mimic-cxr-jpg、340 ms-cxr、619 ms-cxr-t、657 cxr-lt606 cxr-cardiomegaly、607 cxr-phone、608 cxr-pro、612 latte-cxr、599 cardiac-implantable-device-cxr
肺分割(BS-Net 预训练来源,可直接复用):
601 chest-x-ray-segmentation(CXLSeg)602 chexmask-cxr-segmentation-data147 jsrt、157 montgomery-tb、167 shenzhen-tb613 lung-segment-mimic-cxr
挑战赛/评测基准同类:
604 chexstruct-cxreasonbench611 image-embeddings-mimic-cxr
说明:库内无 cohen / ieee8023-covid-chestxray-dataset 独立条目(查重为 0 行),故 Cohen 集不列 rid,其原仓库见 §6.3 与 FACTS §6。
8.3 检索路径建议
- 想找严重度评分类数据:BrixIA 是本库该类目下最典型的"临床评分 + AI 参考实现"样本,可沿
评测基准标签横向找604、611。 - 想找能直接复用做肺分割的:
601、147、157、167是 BS-Net 原文使用的同源数据。 - 想找多中心大规模胸片做对比实验:
5、117、16是标配基线。 - 想找COVID 影像全景:
217、207、197、705覆盖诊断与归档维度,BrixIA 补上"严重度量化"这一维度。
§9 避坑清单:八个已踩过的坑
坑 1:「peru」是候选名残留,数据集与秘鲁无关。
本地 slug brixia-peru 中的 “peru” 是派发候选名「Brixia COVID-19 CXR Peru」的残留。经三源核验(官网、GitHub、论文),不存在任何秘鲁数据、秘鲁机构或秘鲁作者——数据集是意大利布雷西亚单中心(UniBS + ASST Spedali Civili di Brescia)一个月疫情峰值期的产物。按纪律包"一切以三源互证为准",条目按实核名称"BrixIA COVID-19 Dataset"成稿。检索时若搜 “Brixia Peru” 会一无所获。
坑 2:规模有四个数字,不标口径就会引错。
4,707(官网/论文 §4.3 的采集总量)≠ 4,703(论文 Table 3 与 GitHub 定义的分析入库量)≠ 4,695(GitHub [Update] 修订后的现行流通量)≠ 4,644(第三方所称有症状子集)。同一项目不同页面并存 4,707 与 4,695,是"采集量 vs 流通量"两个概念并列的结果。引用必须带口径,现行主口径取 4,695。
坑 3:论文自身的数字漂移(测试集 447 vs 450、训练集 3,311 vs 3,313)。
Table 3 记测试集 447,但 §6.3/Abstract 处出现 “whole test set of 450 CXRs”(MAE=0.441 的对比基准);Table 3 与 §4.3 记训练集 3,311,§6.9 消融段却写 “training (3,313 CXRs)”。疑似后续筛选中小幅变动而未全面回改。条目按 Table 3 为主、其余存照。
坑 4:把 arXiv 的 CC BY-NC-ND 当成数据集许可。
arXiv:2006.04603 页面标注的 CC BY-NC-ND 4.0 是论文的许可,与数据集无关。数据集本体走官网 Research Use Agreement(注册制、研究用途、禁再分发);Cohen 集 Brixia 标注才是 CC BY-NC-SA 4.0 公开直链。三者混为一谈会导致误用与合规风险。
坑 5:0.441 / 0.424 / 0.528 三个 MAE 的擂台不同,不能互比。
0.441 = BS-Net(ENS) 在447/450 张盲测全量上、对单一医师 R0 的六区平均 MAE;0.424 = BS-Net(ENS) 在150 张共识金标准上、对 CbGS 的 MAE;0.528 = 人类医师两两之间在同一 150 张上的平均 MAE。只能"0.424 < 0.528"这一对可比(同擂台)。把 0.441 与 0.528 直接比是错误。
坑 6:BrixIA 不含分割掩码,"分割任务"不能直接用它。
数据集的标注只有六区评分与元数据,没有肺部分割掩码。BS-Net 的分割能力来自外部的 Montgomery/Shenzhen/JSRT(728 训练 + 223 测试)。若要用 BrixIA 做分割,必须自行准备分割数据(库内 601/147/157/167 可用)。误以为"BrixIA 是分割集"会导致实验设计落空。
坑 7:唯一患者数未披露,不能按图像数推断病例数。
全篇与官网均未给出患者数,患者以匿名 Subject 标识;同一患者因逐日随访会有多张图,图像数(4,695-4,707)严格大于患者数。任何"约 X 名患者"的说法都是编造。做患者级划分时需自行按 Subject 去重。
坑 8:跨中心可移植性并不理想,别默认单中心模型能外推。
论文自己的测试(§4.6,Table 9)显示:BS-Net 迁到 Cohen 集时 MAE 0.518,反而不如熟练放射科医师的 0.405;从零重训也难复现本域成绩。单中心一个月的数据 + 单中心训练,外推性有限是本项目自己诚实报告的结论。把 BS-Net 当作"开箱即用的通用评分器"是误判。
§10 数据字典与使用规范
10.1 目录与文件结构(获取后)
BrixIA COVID-19 Dataset/
├── dicom_clean/                    # 匿名化 DICOM 文件(解包后)
│   └── *.dcm
├── metadata_global_v1.csv          # 主元数据(4,703/4,695 张)
│                                   # filename, StudyDate, Modality, StudyId,
│                                   # BrixiaScore(ABCDEF), BrixiaScoreGlobal,
│                                   # ConsensusTestset, Subject, Sex,
│                                   # AgeAtStudyDateFiveYear
└── metadata_consensus_v1.csv       # 共识集标注(150 张)
                                    # filename, MeanA..MeanF, Global(from means),
                                    # ModeA..ModeF, Global(from modes)
GitHub 仓库另含:
Brixia-score-COVID-19/
├── data/
│   └── public-annotations.csv      # Cohen 集 192 张双医师标注(CC BY-NC-SA 4.0)
├── src/
│   └── datasets/                   # brixiascore_cohen / lung_segmentation / synthetic_alignment
├── figures/                        # 架构与结果图
├── requirements.txt
└── README.md
10.2 读取与使用规范
元数据读取(pandas 示意):
import pandas as pd

# 主元数据
meta = pd.read_csv("metadata_global_v1.csv")
# 六区分拆为 A-F 六列
six = meta["BrixiaScore"].str.split("", expand=True)  # 取决于实际分隔符
# 全局分
global_score = meta["BrixiaScoreGlobal"]              # 0-18
# 患者去重(唯一患者数需自行统计)
n_subjects = meta["Subject"].nunique()
# 共识集子集
cbgs = meta[meta["ConsensusTestset"].astype(str).str.lower().isin(["true", "1", "yes"])]
使用规范(务必遵守):
- 仅限研究用途:不得用于医疗决策、干预或诊断;不得售卖;不得把下载链接分享他人。
- 患者级划分:若做训练/测试划分,必须按
Subject分组划分,否则同一患者的多次随访图会跨集泄漏,导致虚高性能。 - 口径声明:报告结果时声明所用版本(4,695 修订版 / 4,703 初版)与所用标注(R0 单人 / CbGS 共识 Mean 或 Mode)。
- 评分参照一致:跨研究比较时,需说明是"对 R0"还是"对 CbGS"计算 MAE,两者不可混。
- 时间泄漏警惕:数据是同一患者逐日序列,随机划分会把后续日期的图泄漏进训练集——若研究目标含"预测进展",需按时间切分。
- 署名:引用须引 Signoroni et al. 2021(DOI 10.1016/j.media.2021.102046);使用评分体系本身宜同时引 Borghesi & Maroldi 2020。
10.3 DAIMS 评估表
| 维度 | 评估 | 说明 |
|---|---|---|
| Discoverability(可发现性) | ★★★☆☆ | 官网 brixia.github.io + GitHub 仓库 + 高被引论文三重入口;但站点 TLS 偶发握手失败,且 slug 名(peru)易误导检索 |
| Accessibility(可获取性) | ★★☆☆☆ | 数据集本体注册制(Research Use Agreement + 邮件链接 + 禁转发),无公开直链;Cohen 集标注与代码为公开直链,整体呈"本体受限、衍生开放"的哑铃形 |
| Interoperability(互操作性) | ★★★★☆ | 标准 DICOM 格式 + 字段命名清晰的 CSV;六区分与全局分有明确字段;与主流 CXR 分割数据(Montgomery/Shenzhen/JSRT)兼容 |
| Metadata(元数据质量) | ★★★★☆ | 提供 StudyDate/Modality/投照位/尺寸/厂商/性别/五岁分组年龄/共识集标志,粒度细致;缺唯一患者数是明显缺口 |
| Sustainability(可持续性) | ★★☆☆☆ | 仓库 README 最后更新 2022-01-17,代码 push 止于 2021-05,项目活跃度冻结;模型权重置于 Google Drive,存在链接失效风险;无版本化数据托管(如 Zenodo DOI) |
一句话画像:标注质量与评测锚点强(临床真实评分 + 共识金标准),但本体分发受限、患者级元数据缺失、长期可维护性弱——典型的疫情应急科研数据集形态。
10.4 研究设计清单(开题即答)
若把 BrixIA 作为研究底座,开题报告里应当先答清下列问题,否则极易在评审阶段被质疑:
| 序号 | 必答问题 | 为什么重要 | BrixIA 的对应事实 |
|---|---|---|---|
| Q1 | 你的任务是评分回归还是诊断分类? | 决定评估指标与可比对象 | BrixIA 原始任务是六区评分回归(0-3),全局分 0-18 |
| Q2 | 标注基准取 R0 单人还是 CbGS? | 同一模型在两个基准上 MAE 不同 | BS-Net 对 CbGS 0.424 / 对 R0 0.452 |
| Q3 | 你的基线人类上限是多少? | 没有人类锚点的 MAE 无解释意义 | 人类两两平均 0.528;总体 kappa ≈0.4 |
| Q4 | 你用的是 4,695 还是 4,703? | 划分表与总数必须自洽 | 修订版 4,695;论文表 4,703 |
| Q5 | 训练/测试按患者还是按图像切? | 按图像会引入随访泄漏 | 元数据含 Subject,可分组切分 |
| Q6 | 是否需要肺分割掩码? | BrixIA 不提供,需自建或外借 | 论文用 JSRT+Montgomery+Shenzhen 预训练分割网络 |
| Q7 | 报告 CR/DX 与 AP/PA 分布了吗? | 模态与体位是显著混杂因子 | CR 62%/DX 38%;AP 87%/PA 13% |
| Q8 | 是否做跨中心验证? | 单中心高分不等于可迁移 | BS-Net-HA 跨中心 0.518 vs 人类 0.405 |
| Q9 | 是否声明口径(版本/基准/划分)? | 复现的最低要求 | 见 §10.2 使用规范第 3-5 条 |
| Q10 | 是否遵守Research Use Agreement? | 合规红线 | 禁转发链接、仅研究用途、需署名 |
三类典型研究模型(可直接套用的设计骨架):
- 复现型:以 BS-Net 为基线,在固定划分(3,311/945/447)上复现区域级 MAE,检验实现差异。风险点:权重需从 Google Drive 取,链接可能失效;需自行训练则要注意分割预训练数据的可获得性。
- 改进型:替换分割主干或对齐模块,声称在不增加参数量的前提下降低区域级 MAE。评估时必须同时报"对 R0"与"对 CbGS"两个 MAE,并给出人类锚点,否则改进幅度无法定位。
- 泛化型:把在 BrixIA 上训练的评分器迁移到另一中心 CXR 数据(如 vinDr 系列或 bimcv-covid),复现论文报告的人类反超现象,并分析失败区域(历史数据显示 F 区最难,MAE 0.494)。
10.5 可复现性风险登记
| 风险 | 等级 | 表现 | 缓解 |
|---|---|---|---|
| 本体获取受限 | 高 | 需邮件申请并签署协议,无公开直链 | 提前预留审批时间;勿假设可即时获取 |
| 权重托管脆弱 | 高 | 模型权重在 Google Drive | 尽快本地归档;论文不含权重 |
| 患者数缺失 | 中 | 无法核对划分是否患者级互斥 | 用 Subject 字段自查;报告实际唯一受试者数 |
| 站点可用性 | 中 | brixia.github.io 曾 TLS 握手失败 | 以 GitHub README 为镜像参照 |
| 仓库冻结 | 中 | README 止于 2022-01,代码止于 2021-05 | 以论文版本为权威;警惕更新未同步 |
| 标注漂移 | 低 | 447 vs 450、4,695 vs 4,703 | 引用时显式绑定版本与口径 |
| 共识集黑箱 | 低 | 共识规则(均值/众数)需查代码 | 以仓库 CSV 字段为准,勿凭推断 |
FAQ(高频问答 34 问)
A. 基础认知
Q1:BrixIA 的名字怎么读、怎么写?
数据集全称 BrixIA COVID-19 Dataset(注意 “IA” 大写,取自 “Brixia” + “AI” 的双关),归属 BrixIA COVID-19 Project。本地 slug 是 brixia-peru,但这个名字里的 “peru” 是派发候选名残留,与秘鲁无关(坑 1)。
Q2:它和普通 COVID-19 胸片数据集有什么本质区别?
普通 COVID 胸片集多给"诊断标签"(有无 COVID);BrixIA 给的是严重度评分——每张图 6 个 0-3 的整数 + 1 个 0-18 的全局分。它是"评分数值化"数据集,任务是回归/序数估计,不是分类。
Q3:Brixia score 是 BrixIA 项目发明的吗?
不是。评分体系由布雷西亚放射科的 Borghesi 与 Maroldi 于 2020 年提出(Radiol Med 125:509-513),并在 302 例患者研究中验证(Int J Infect Dis 96:291-293)。BrixIA 项目做的事是把评分数据化 + 训练 AI。
Q4:数据来自哪里?
意大利布雷西亚的 ASST Spedali Civili di Brescia(布雷西亚市民医院)第 2 放射科,从医院 RIS-PACS 系统导出。
Q5:数据是什么时候的?
2020-03-04 至 2020-04-04,恰好是该院所在地区疫情第一波峰值的一个月。
Q6:为什么只有一个月?
因为论文的策略是"一个月内全部次重症与重症监护病房胸片"——用不筛选的方式保留真实临床场景的全部变异性,而非追求时间跨度。这一个月正是疫情最凶猛的时期,样本密度极高。
Q7:有多少张图?
现行口径 4,695 张(修订版);论文分析口径 4,703 张;采集口径 4,707 张。三个数字都对,含义不同(坑 2)。
Q8:有多少患者?
项目未披露。患者以匿名 Subject 标识,图像数大于患者数。任何具体患者数都是推测(坑 7)。
B. 数据与获取
Q9:怎么下载数据?
访问 https://brixia.github.io/,注册并接受 Research Use Agreement,然后经邮件收到下载链接。链接是邮件制、不可转发。
Q10:为什么不给公开直链?
患者数据保护与伦理要求。伦理批件 NP4121 授权公开的是"匿名数据集用于研究目的",协议规定仅研究用途、禁售卖、禁转发链接。
Q11:有任何一个部分是可以不注册直接拿的吗?
有。Cohen 集上的 Brixia 标注(192 张,public-annotations.csv)在 GitHub 仓库是 CC BY-NC-SA 4.0 公开直链;BS-Net 代码也是开源直链。只有数据集图像本体需要注册。
Q12:数据集本体是什么许可?
不是标准 CC,而是自拟的 Research Use Agreement(研究用途协议):免费、仅研究、禁售卖、禁转发、非学术用途需 JPT 与 ASST-BS 逐案评估。
Q13:我可以把它用在商业产品里吗?
不可以自动授权。协议明确"Any non-academic research use need to be evaluated case by case by the JPT in coordination with ASST-BS"——需逐案申请评估。
Q14:数据是什么格式?
DICOM(匿名化),另有 CSV 元数据与标注。DICOM 是 12-bit 灰度,映射为 float32。
Q15:图是统一尺寸吗?
不是。尺寸在 (1056÷3050) × (1186÷3376) px 之间,因为来自 CR 与 DX 两种设备、不同患者。
Q16:怎么解包?
cat *.tar.gz.* | tar -xzv(类 Unix)或 type *.tar.gz.* | tar xvfz -(Windows),解包后生成 dicom_clean 目录。
C. 评分与标注
Q17:六区是怎么分的?
右肺 A(上)/B(中)/C(下),左肺 D(上)/E(中)/F(下)。两条界标线:Line A 在主动脉弓下缘,Line B 在右下肺静脉下缘。若界标难辨,作者建议三等分肺野。
Q18:0-3 分具体代表什么?
0 = 无肺部异常;1 = 间质浸润;2 = 间质与肺泡浸润(间质为主);3 = 间质与肺泡浸润(肺泡为主)。全局分 = 六区之和,范围 0-18。
Q19:谁标注的?
不是集中重注——是当班放射科医师日常报告里本来就写的判读,涉及该科约 30 名轮班专家。这是"弱监督"的根源。
Q20:标注可靠吗?
真实但不完美。观察者间 kappa 约 0.4(中等一致),这是评分体系主观性的直接体现,也是模型性能的隐含上限。
Q21:有更可靠的参照吗?
有。150 张共识金标准(CbGS):在原始报告医师 R0 之外另请 4 位医师(R1-R4)重注,5 人派生 Mean 与 Mode 两套表示。
Q22:Senior 和 Junior 是什么?
Cohen 集的 192 张由两位医师独立双标——资深(board-certified,+20 年经验)与初级(trainee,+2 年经验),分数字段为 S-A…S-F/S-Global 与 J-A…J-F/J-Global,不取平均。
Q23:Brixia score 和 Toussie score、GE-LO 什么关系?
Toussie score 是六区二值版(0-6),可由 Brixia 的 {1,2,3} 映射为 1 得到;GE-LO 是肺级别的范围+不透明度双值体系(源自肺水肿评分)。Brixia 的分区最细、档位最多,代价是主观性更高。
Q24:全局分怎么在报告里表示?
惯例是"总分 + 方括号内六区分",如 8 [1 2 1 1 2 1],字母固定顺序 A-F。
D. BS-Net 与结果
Q25:BS-Net 是什么?
一个端到端三段式网络:U-Net++ 肺分割 → 空间变换网络对齐 → ROI Pooling 抽六区 → 评分头。有三种配置:SA(软注意力)、HA(硬注意力)、ENS(集成)。
Q26:它效果如何?
盲测集六区平均 MAE:ENS 0.441 / HA 0.471 / SA 0.496;对照普通 ResNet-18 为 0.517。ENS 最优。
Q27:这算好吗?
论文给了标尺:单区只有 0-3 四个整数,MAE 低于 0.5 意味着平均误差不足半级。六区平均 MAE 0.441 在这个量纲下已是较优水平。
Q28:机器比医生强吗?
在共识金标准上,BS-Net(ENS) 的 MAE 0.424 低于放射科医师两两之间的平均 MAE 0.528——即机器比"随机两位医师互比"更接近共识。但跨中心时人类更强(0.405 vs 0.518)。
Q29:为什么人类之间分歧那么大?
因为 Brixia score 是半定量评分,把定性判断映射为数值,本身带主观性;分区越细、档位越多,一致性越难。kappa 0.4 是"中等",论文认为是表达力与可重复性的妥协。
Q30:可解释性怎么做的?
生成 super-pixel 级关注度图,逐区可视化网络做评分时"看了哪里",可与 Brixia 六区叠加对照供临床核查(§4.7)。
Q31:BS-Net 能做其他病的评分吗?
论文谨慎表示:Brixia score 是为 COVID 专门设计的,唯一可能的直接应用是导致 ARDS(急性呼吸窘迫综合征)的其他病毒性肺炎——因为它捕捉的是"肺实质混浊"这一通用影像语法。
Q32:模型权重在哪?
GitHub README 指向 Google Drive 链接(含模型 + demo notebook)。注意 Drive 链接存在长期失效风险(坑:可持续性)。
E. 生态与库内
Q33:BrixIA 和 MBrixia 什么关系?
MBrixia(Modified Brixia)是丹麦哥本哈根大学医院的下游改进版,Sci Rep 2022 与 2026 两篇验证其与呼吸支持、90 天死亡率、生物标志物的相关性,并把 BS-Net 列为自动化评分先驱。
Q34:库内哪些条目可以互链?
最直接的是 covid-19-radiography(217)、bimcv-covid(207)、covidx-cxr(197)、sar-covid(705);分割可复用 chest-x-ray-segmentation(601)、jsrt(147)、montgomery-tb(157)、shenzhen-tb(167);大规模胸片对照 chexpert(5)、padchest(117)、mimic-cxr(16)。
事实清单(硬事实 40 条)
身份与来源
- 全称 BrixIA COVID-19 Dataset,归属 BrixIA COVID-19 Project。
- 数据来自意大利布雷西亚 ASST Spedali Civili di Brescia 第 2 放射科。
- 采集期 2020-03-04 至 2020-04-04(一个月疫情峰值)。
- 纳入范围:该期次重症与重症监护病房的全部胸片。
- 数据来源系统:医院 RIS-PACS;全部图像经医院 BrixIA-Team 去标识。
- 伦理批件:布雷西亚伦理委员会 NP4121(GitHub 记 last update 08/07/2020)。
- 本地 slug
brixia-peru中的 “peru” 为候选名残留,与秘鲁无关。
规模与规格
8. 现行规模 4,695 张(修订版);论文分析口径 4,703 张;采集口径 4,707 张。
9. 划分:训练 3,311 + 验证 945 + 测试 447(= 4,703)。
10. 模态:CR 62% — DX 38%。
11. 投照位:AP 87% — PA 13%。
12. 图像尺寸区间:(1056÷3050) × (1186÷3376) px。
13. 设备厂商:Carestream, Siemens。
14. 格式:DICOM 匿名化,12-bit 灰度 → float32。
15. 唯一患者数:未披露。
评分体系
16. Brixia score 由 Borghesi 与 Maroldi 2020(Radiol Med 125:509-513)首提。
17. 临床验证:Borghesi et al. 2020(Int J Infect Dis 96:291-293),302 例患者。
18. 验证结论:Brixia score、年龄、免疫抑制为院内死亡独立预测因子。
19. ROC 最佳截断:Brixia 8 分 / 年龄 71 岁。
20. 分区:右肺 A/B/C、左肺 D/E/F,共六区。
21. 界标:Line A 主动脉弓下缘;Line B 右下肺静脉下缘;难辨时可三等分。
22. 每区 0-3 分:0 无异常 / 1 间质浸润 / 2 间质+肺泡(间质为主)/ 3 间质+肺泡(肺泡为主)。
23. 全局分 = 六区之和,范围 0-18。
标注
24. 主标注来自当班放射科医师日常报告(约 30 名专家轮班),属弱监督。
25. 共识金标准 150 张,由 R1-R4 四位追加医师 + 原 R0 共 5 人重注。
26. 共识表派生两套:Mean 版与 Mode 版(metadata_consensus_v1.csv)。
27. Cohen 集 192 张 CXR 由资深(+20 年)与初级(+2 年)医师独立双标。
28. Cohen 集标注工具:labelbox;原图下载副本日期 2020-05-11。
29. 观察者间一致性:两两 Cohen’s kappa 与 Fleiss’ kappa 约 0.4(中等)。
30. 元数据字段含 Sex 与五岁分组年龄 AgeAtStudyDateFiveYear。
BS-Net 与结果
31. 架构:U-Net++ 分割 → 空间变换对齐 → ROI Pooling 六区 → 评分头(端到端)。
32. 分割性能:U-Net++/ResNet-18 → Dice 0.971 / IoU 0.945。
33. 分割预训练数据:Montgomery 88/50 + Shenzhen 516/50 + JSRT 124/123 = 728 训练 / 223 测试。
34. 盲测六区平均 MAE:ENS 0.441 / HA 0.471 / SA 0.496;全局分 MAE ENS 1.728。
35. 对照 all-in-one ResNet-18 MAE 0.517——BS-Net 三配置全优于它。
36. 共识金标准:BS-Net(ENS) vs CbGS MAE 0.424;vs R0 0.452;人工两两平均 0.528。
37. 可移植性:BS-Net-HA 跨中心 Cohen 集 MAE 0.518 vs 人类 0.405。
38. 对齐模块增益:MAE 提升约 20-25%。
39. 对齐补偿旋转范围约 ±15°(预训练设计 ±25°)。
40. 生成 super-pixel 级可解释性图,可与 Brixia 六区叠加对照。
术语表(32 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| Brixia score | Brixia score | 布雷西亚放射科提出的 COVID-19 胸片六区半定量评分,0-18 分 |
| 全局分 | Global Score | 六区 Brixia 分之和,0-18 |
| 分区 | zone / region | 肺野被两条界标线分成的六块(A-F) |
| 界标线 | landmark line | Line A(主动脉弓下缘)、Line B(右下肺静脉下缘) |
| 间质浸润 | interstitial infiltrates | 肺间质的异常浸润,对应 1 分 |
| 肺泡浸润 | alveolar infiltrates | 肺泡腔的异常填充,对应 2-3 分的高档 |
| 半定量评分 | semi-quantitative score | 把定性判断映射到有序数值尺度的评分方法 |
| BrixIA COVID-19 Dataset | BrixIA COVID-19 Dataset | 本项目公开的 4,695/4,703/4,707 张胸片数据集 |
| BS-Net | BS-Net | 本项目的端到端评分网络 |
| 弱监督 | weakly supervised | 用不精确/有噪声的标签训练模型(此处标签来自日常报告) |
| 共识金标准 | Consensus-based Gold Standard (CbGS) | 150 张由 5 位医师重注派生的参照分数 |
| 观察者间一致性 | inter-rater agreement | 不同评分者之间的一致程度 |
| Cohen’s kappa | Cohen’s kappa | 两评分者一致性统计量(此处约 0.4) |
| Fleiss’ kappa | Fleiss’ kappa | 多评分者一致性统计量(此处约 0.4) |
| MAE | Mean Absolute Error | 平均绝对误差,本条目核心指标 |
| U-Net++ | U-Net++ / extended-Unet | 嵌套式 U-Net,用于肺分割 |
| 空间变换网络 | spatial transformer network | 学习仿射变换以对齐图像/特征的模块 |
| 仿射变换 | affine transform | 6 参数(旋转/缩放/平移)线性变换 |
| ROI Pooling | ROI Pooling | 从特征图中抽取固定区域(此处六区) |
| 硬注意力 | hard attention (HA) | 用分割掩码遮蔽肺外区域的配置 |
| 软注意力 | soft attention (SA) | 直接使用对齐特征的配置 |
| 集成 | ensemble (ENS) | 融合 SA 与 HA 预测的配置 |
| Feature Pyramid Network | FPN | 多尺度特征金字塔 |
| 可解释性图 | explainability map | 显示模型关注区域的可视化 |
| super-pixel | super-pixel | 超像素,可解释图的粒度单位 |
| DICOM | DICOM | 医学影像标准格式 |
| CR | Computed Radiography | 计算机放射摄影(模态之一) |
| DX | Digital Radiography | 直接数字放射摄影(模态之一) |
| AP / PA | anteroposterior / posteroanterior | 前后位 / 后前位投照 |
| RIS-PACS | RIS-PACS | 放射信息系统与影像归档通信系统 |
| Research Use Agreement | Research Use Agreement | 数据集本体的自拟研究用途协议 |
| MBrixia | Modified Brixia | 丹麦派生改进版评分体系 |
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 数据集全称 | BrixIA COVID-19 Dataset |
| 项目全称 | BrixIA COVID-19 Project |
| 本地 slug | brixia-peru(“peru” 为候选名残留) |
| 现行规模 | 4,695 张 CXR |
| 分析规模 | 4,703 张(3,311 + 945 + 447) |
| 采集规模 | 4,707 张 |
| 评分体系 | Brixia score,六区 × 0-3,全局 0-18 |
| 采集期 | 2020-03-04 至 2020-04-04 |
| 机构 | UniBS(DII + DSMC)+ ASST Spedali Civili di Brescia 第 2 放射科 |
| 伦理批号 | NP4121(Brescia) |
| 主论文 | Medical Image Analysis 2021;71:102046 |
| 预印本 | arXiv:2006.04603 |
| DOI | 10.1016/j.media.2021.102046 |
| 许可(本体) | Research Use Agreement(注册制) |
| 许可(Cohen 标注) | CC BY-NC-SA 4.0(公开直链) |
| 网络 | BS-Net(U-Net++ + 对齐 + ROI + 评分头) |
| 核心指标 | 盲测 MAE 0.441;共识金标准 0.424;人工均值 0.528 |
| 官网 | https://brixia.github.io/ |
| 代码 | https://github.com/BrixIA/Brixia-score-COVID-19 |
附录 B:DAIMS 评估全表
| 维度 | 评级 | 依据 |
|---|---|---|
| Discoverability | ★★★☆☆ | 三重入口但站点偶发不可达、slug 误导 |
| Accessibility | ★★☆☆☆ | 本体注册制、无直链;衍生开放 |
| Interoperability | ★★★★☆ | 标准 DICOM + 清晰 CSV + 兼容主流分割集 |
| Metadata | ★★★★☆ | 字段细致;缺唯一患者数是缺口 |
| Sustainability | ★★☆☆☆ | 更新冻结、权重在 Drive、无 Zenodo 版本化 |
附录 C:Brixia score 评分速查
六区:右肺 A(上)B(中)C(下);左肺 D(上)E(中)F(下)。
| 分 | 病灶类型 |
|---|---|
| 0 | 无肺部异常 |
| 1 | 间质浸润 |
| 2 | 间质 + 肺泡浸润,以间质为主 |
| 3 | 间质 + 肺泡浸润,以肺泡为主 |
全局分 = A+B+C+D+E+F ∈ [0, 18]。报告格式示例:8 [1 2 1 1 2 1]。
附录 D:数据获取决策树
需要什么?
├─ 只要 Cohen 集 192 张的 Brixia 标注
│   └─→ GitHub 仓库 data/public-annotations.csv(CC BY-NC-SA 4.0,直接下载)
├─ 要 BrixIA 数据集本体(DICOM + 元数据)
│   ├─ 学术研究用途 → brixia.github.io 注册 → 接受协议 → 邮件收链接
│   └─ 非学术/商业用途 → 联系 JPT 与 ASST-BS 逐案评估
├─ 要 BS-Net 代码 → GitHub 仓库(开源)
└─ 要 BS-Net 训练权重 → GitHub README 指向的 Google Drive 链接
附录 E:BS-Net 架构三段式速查
CXR 输入
  │
  ├─[1] Backbone 骨干特征提取(ResNet/VGG/DenseNet/Inception 选型)
  │        │
  │        ├─[2] U-Net++ 肺分割 → 分割概率图(Dice 0.971)
  │        │
  │        └─[3] 空间变换网络:6 参数仿射对齐(旋转/缩放/平移)
  │                 │(在合成对齐集上以 Dice 损失弱监督预训练,±25°)
  │                 └─[4] ROI Pooling 抽六区(垂直 25% 重叠,水平不重叠)
  │                          │
  │                          └─[5] 评分头:六区 0-3 回归 + 全局分汇总
  │
  └─ 配置:SA(软注意力)/ HA(硬注意力,分割掩码遮蔽肺外)/ ENS(集成,最优)
附录 F:核心结果总表(论文 Table 5 / 6 / 9)
Table 5 · 盲测集(对 R0)
| 配置 | 六区平均 MAE | 全局分 MAE |
|---|---|---|
| BS-Net-ENS | 0.441 | 1.728 |
| BS-Net-HA | 0.471 | 1.826 |
| BS-Net-SA | 0.496 | 1.846 |
| ResNet-18 | 0.517 | 1.951 |
Table 6 · 共识金标准(150 张)
| 比较 | 六区平均 MAE | 全局分 MAE |
|---|---|---|
| BS-Net(ENS) vs CbGS | 0.424 | 1.787 |
| BS-Net(ENS) vs R0 | 0.452 | 1.847 |
| 人工两两平均 | 0.528 | 2.592 |
Table 9 · 跨中心可移植性(Cohen 集)
| 对象 | 全量 MAE | 全局分 MAE |
|---|---|---|
| 放射科医师 | 0.405 | 1.974 |
| BS-Net-HA(全量微调) | 0.518 | 2.214 |
附录 G:分割预训练数据总表(论文 Table 1)
| 数据集 | 训练集 | 测试集 | 划分 |
|---|---|---|---|
| Montgomery County | 88 | 50 | 前 50 为测试 |
| Shenzhen Hospital | 516 | 50 | 前 50 为测试 |
| JSRT database | 124 | 123 | 原始划分 |
| 合计 | 728 | 223 | — |
附录 H:对齐合成数据增强参数(论文 Table 2)
| 变换 | 参数上限 | 概率 |
|---|---|---|
| 旋转 Rotation | 25° | 0.8 |
| 缩放 Scale | 10% | 0.8 |
| 平移 Shift | 10% | 0.8 |
| 弹性形变 Elastic | α=60, σ=12 | 0.2 |
| 网格畸变 Grid distortion | steps=5, limit=0.3 | 0.2 |
| 光学畸变 Optical distortion | distort=0.2, shift=0.05 | 0.2 |
附录 I:元数据字段全表(官网)
metadata_global_v1.csv
| 字段 | 说明 |
|---|---|
| filename | DICOM 文件名 |
| StudyDate | 拍摄日期(YYYYMMdd) |
| Modality | DX 或 CR |
| StudyId | 匿名 RIS 检查序号 |
| BrixiaScore | 六区 ABCDEF,各 0-3 |
| BrixiaScoreGlobal | 六区之和 0-18 |
| ConsensusTestset | 是否纳入共识集 |
| Subject | 匿名患者 id |
| Sex | 性别 |
| AgeAtStudyDateFiveYear | 五岁分组年龄 |
metadata_consensus_v1.csv
| 字段 | 说明 |
|---|---|
| filename | DICOM 文件名 |
| MeanA…MeanF | 5 位专家六区均值 0-3 |
| Global(from means) | 均值求和 0-18 |
| ModeA…ModeF | 5 位专家六区众数 0-3 |
| Global(from modes) | 众数求和 0-18 |
public-annotations.csv(Cohen 集)
| 字段 | 说明 |
|---|---|
| filename | Cohen 集文件名 |
| S-A…S-F | 资深医师(+20 年)六区 0-3 |
| S-Global | 资深医师全局分 0-18 |
| J-A…J-F | 初级医师(+2 年)六区 0-3 |
| J-Global | 初级医师全局分 0-18 |
附录 J:许可与获取三层对照
| 层 | 资产 | 许可 | 门槛 |
|---|---|---|---|
| 1 | 数据集本体 | Research Use Agreement | 注册 + 邮件链接 |
| 2 | Cohen 集标注 | CC BY-NC-SA 4.0 | 公开直链 |
| 3 | 代码/权重 | Open Source / Drive | 直链 / 可能失效 |
| 附加 | 论文 | CC BY-NC-ND 4.0 | 公开 |
附录 K:谱系时间线
| 时间 | 事件 |
|---|---|
| 2020-03-04 / 04-04 | 布雷西亚疫情峰值,数据采集期 |
| 2020 早春 | Borghesi & Maroldi 提出 Brixia score(Radiol Med 125:509-513) |
| 2020-05-10 | Borghesi et al. 302 例验证发表(Int J Infect Dis 96:291-293) |
| 2020-05-11 | Cohen 集下载副本 |
| 2020-06-08 | arXiv:2006.04603 v1 |
| 2020-07-08 | 伦理批件 NP4121 更新(GitHub 记) |
| 2021-04-03 | arXiv:2006.04603 v3 |
| 2021-07 | Medical Image Analysis 2021;71:102046 正式发表 |
| 2022-01-17 | GitHub README 最后更新(项目活跃冻结) |
| 2022-02-01 | Covid CXR Hackathon 于 Expo Dubai 启动 |
| 2022 | MBrixia 首篇(Sci Rep) |
| 2026 | MBrixia 随访研究(Sci Rep) |
附录 L:与库内条目互链声明
本条目(brixia-peru)与库内以下条目构成 CXR 数据家族:
- 同病症同模态:covid-19-radiography(217)、bimcv-covid(207)、covidx-cxr(197)、sar-covid(705)、cdsl-covid-data-shared-learning(605)
- 分割可复用:chest-x-ray-segmentation(601)、jsrt(147)、montgomery-tb(157)、shenzhen-tb(167)
- 大规模胸片对照:chexpert(5)、padchest(117)、mimic-cxr(16)、vindr-cxr(125)
定位差异:BrixIA 提供严重度评分数值 + 共识金标准 + 参考网络,不提供诊断标签,不与任何库内条目重叠。
附录 M:常见误用与纠正
| 误用 | 纠正 |
|---|---|
| “BrixIA 是秘鲁数据集” | 与秘鲁无关,“peru” 是候选名残留(坑 1) |
| “BrixIA 有 4,707 张” | 现行流通 4,695 张;4,707 是采集口径(坑 2) |
| “BrixIA 用 CC BY-NC-ND” | 那是论文许可;数据集走 Research Use Agreement(坑 4) |
| “机器 MAE 0.441 优于人工 0.528” | 擂台不同不可比;共识擂台上是 0.424 vs 0.528(坑 5) |
| “BrixIA 带分割掩码” | 不含;分割来自外部 Montgomery/Shenzhen/JSRT(坑 6) |
| “BrixIA 有约 X 名患者” | 患者数未披露,不能编造(坑 7) |
| “BS-Net 可通用评分” | 跨中心 MAE 0.518 高于人类 0.405,外推有限(坑 8) |
附录 N:引用格式(BibTeX)
@article{SIGNORONI2021102046,
  title   = {BS-Net: learning COVID-19 pneumonia severity on a large Chest X-Ray dataset},
  journal = {Medical Image Analysis},
  volume  = {71},
  pages   = {102046},
  year    = {2021},
  issn    = {1361-8415},
  doi     = {10.1016/j.media.2021.102046},
  author  = {Signoroni, Alberto and Savardi, Mattia and Benini, Sergio and
             Adami, Nicola and Leonardi, Riccardo and Gibellini, Paolo and
             Vaccher, Filippo and Ravanelli, Marco and Borghesi, Andrea and
             Maroldi, Roberto and Farina, Davide}
}

@article{BORGHESI2020509,
  title   = {COVID-19 outbreak in Italy: experimental chest X-ray scoring system for
             quantifying and monitoring disease progression},
  journal = {La radiologia medica},
  volume  = {125},
  pages   = {509--513},
  year    = {2020},
  author  = {Borghesi, Andrea and Maroldi, Roberto}
}
附录 O:坑点档案(与 §9 对照)
| 坑 | 一句话 | 影响 |
|---|---|---|
| 坑 1 | “peru” 与秘鲁无关 | 检索误导 |
| 坑 2 | 四个规模数字需标口径 | 引用错误 |
| 坑 3 | 论文测试集 447 vs 450 漂移 | 数字争议 |
| 坑 4 | 论文 CC 许可不是数据集许可 | 合规风险 |
| 坑 5 | 三个 MAE 擂台不同 | 结论误读 |
| 坑 6 | 无分割掩码 | 实验设计落空 |
| 坑 7 | 患者数未披露 | 划分数错误 |
| 坑 8 | 跨中心外推有限 | 部署误判 |
附录 P:三源核验工作底稿
本条目所有关键数字均按"三源互证、以实抓为准"的纪律采集。下表列出每个核心事实的源与吻合情况,供后续复核。
| 事实项 | 源 A(论文/arXiv) | 源 B(官网/GitHub) | 源 C(Crossref/第三方) | 吻合 |
|---|---|---|---|---|
| 数据集全称 | BrixIA COVID-19 Project | BrixIA COVID-19 Project | — | 一致 |
| 采集机构 | UniBS + ASST Spedali Civili | 官网 About | — | 一致 |
| 采集量(论文口径) | §4.3 记 4,707 | 官网记 4,707 | — | 一致 |
| 采集量(现行口径) | arXiv v3 附更新 | GitHub [Update] 记 4,695 | — | 一致 |
| 划分 | Table 3:3,311/945/447 | README Defs | — | 一致(数) |
| 期刊信息 | Med Image Anal 71 | — | Vol 71, p.102046, 2021-07 | 一致 |
| DOI | 10.1016/j.media.2021.102046 | — | Crossref 实测命中 | 一致 |
| arXiv 版本 | v1 2020-06-08 / v3 2021-04-03 | — | arXiv 页面 | 一致 |
| 金标准规模 | 150 张五人共识 | README 记 CbGS | — | 一致 |
| 伦理编号 | NP4121 | GitHub README | — | 一致 |
| 谱系首提 | Borghesi & Maroldi 2020 | — | Radiol Med 125:509-513 | 一致 |
| 谱系验证 | Borghesi et al. 2020 | — | Int J Infect Dis 96:291-293 | 一致 |
抓取方式留痕:论文正文经 arxiv.org/html/2006.04603v3 抓取(GitHub raw 与 api.github.com 在沙箱内被封锁,改走 WebFetch 抓 github.com/BrixIA/Brixia-score-COVID-19 页面);官网 brixia.github.io 直连 TLS 握手失败(curl exit 35),改用 WebSearch 返回正文片段;Crossref 经 api.crossref.org 直取 JSON。三源独立,未见相互矛盾项。
附录 Q:术语中英速查(扩展)
| 中文 | 英文全称 | 缩写 |
|---|---|---|
| 胸片 | Chest Radiograph | CXR |
| 计算机放射摄影 | Computed Radiography | CR |
| 数字放射摄影 | Digital Radiography | DX |
| 后前位 | Posteroanterior | PA |
| 前后位 | Anteroposterior | AP |
| 间质浸润 | Interstitial Infiltrate | — |
| 肺泡浸润 | Alveolar Infiltrate | — |
| 共识金标准 | Consensus-based Gold Standard | CbGS |
| 平均绝对误差 | Mean Absolute Error | MAE |
| 科恩卡帕 | Cohen’s Kappa | — |
| 弗莱斯卡帕 | Fleiss’ Kappa | — |
| 空间变换网络 | Spatial Transformer Network | STN |
| 感兴趣区域 | Region of Interest | ROI |
| 分割主干 | Segmentation Backbone | — |
| 弱监督 | Weak Supervision | — |
| 集成模型 | Ensemble | ENS |
| 单模型高精度 | Single High-Accuracy | SA |
| 单模型高泛化 | Single High-Automation | HA |
| 外部验证 | External Validation | — |
| 迁移学习 | Transfer Learning | — |
| 交并比 | Intersection over Union | IoU |
| Dice 系数 | Dice Similarity Coefficient | DSC |
| 受试者工作特征 | Receiver Operating Characteristic | ROC |
| 重症监护病房 | Intensive Care Unit | ICU |
| 死亡率 | Mortality Rate | — |
§11 总结
BrixIA 是 COVID-19 影像研究里一个"以临床真实性换技术便利"的样本。它不追求最大规模,而追求标注的临床可信度——4,695 张胸片上的六区评分全部来自疫情峰值期放射科医师日常报告的判读,而不是事后组织的重注;它也不回避这种选择带来的噪声,反而用一张 150 张五人共识金标准把"人类自身的分歧"量化出来,作为模型的参照边界。
BS-Net 的核心贡献是证明了一件看似不可能的事:一套带主观性的半定量评分,可以被端到端网络学到"比随机两位医师互比更接近共识"的程度(MAE 0.424 < 0.528)。但论文同样坦率地报告了它的局限——跨中心迁移时,熟练人类仍更强(0.405 < 0.518)。这种"既展示优势、又暴露局限"的写法,使 BrixIA 成为讨论"AI 影像评分的能力边界"时的经典样本。
它的谱系还在延续:评分体系本身已被丹麦团队改进为 MBrixia 并验证了与 90 天死亡率的相关性;它的影像库与 BS-Net 曾是 2022 年 Covid CXR Hackathon 两支获胜队伍的共同技术底座。对今天的研究者而言,BrixIA 的持久价值也许不在那 4,695 张图本身,而在于它示范了一条路径——如何把一个临床惯例,变成一套可复现、可评测、可解释、可继承的 AI 资源。
一句话定位:库内最典型的"严重度评分 + 共识金标准 + 参考网络"三合一 COVID-19 胸片数据集,适合做半定量评分模型、可解释性方法与跨中心泛化研究,但不适合当作诊断数据集或开箱即用的通用评分器。
适合谁:COVID-19 严重度评分建模者;半定量评分标注方法论研究者;弱监督与可解释性研究者;需要带临床结局背书评分数值的研究者。
不适合谁:需要公开直链低成本获取的自动化流水线(注册制受限);需要肺分割掩码(BrixIA 不含);需要患者级病例统计(未披露);需要大规模多中心诊断分类(另有 chexpert/padchest/mimic-cxr)。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- covidx-cxr — 共享标签:医学影像 / X光影像 / 图像分类 / COVID-19 / 评测基准
- covid-19-radiography — 共享标签:医学影像 / X光影像 / 图像分类 / COVID-19
- hyperkvasir — 共享标签:医学影像 / 图像分类 / 评测基准 / 医学图像分割
- chexlocalize — 共享标签:医学影像 / X光影像 / 评测基准 / 医学图像分割
- bus-bra — 共享标签:医学影像 / 图像分类 / 评测基准 / 医学图像分割
- midrc-ricord — 共享标签:医学影像 / X光影像 / COVID-19
- siim-acr-pneumothorax — 共享标签:医学影像 / X光影像 / 评测基准 / 医学图像分割
- dental-opg-xray — 共享标签:医学影像 / X光影像 / 图像分类 / 评测基准
- chexpert — 共享标签:医学影像 / X光影像 / 图像分类
- nih-chestx-ray14 — 共享标签:医学影像 / X光影像 / 图像分类
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
