NeuroVoz:卡斯蒂利亚西班牙语帕金森语音语料库数据
本数据集为神经系统疾病领域的音频公开数据集,来源:google_dataset。
基本信息
资源简介
NeuroVoz:卡斯蒂利亚西班牙语帕金森语音语料库数据
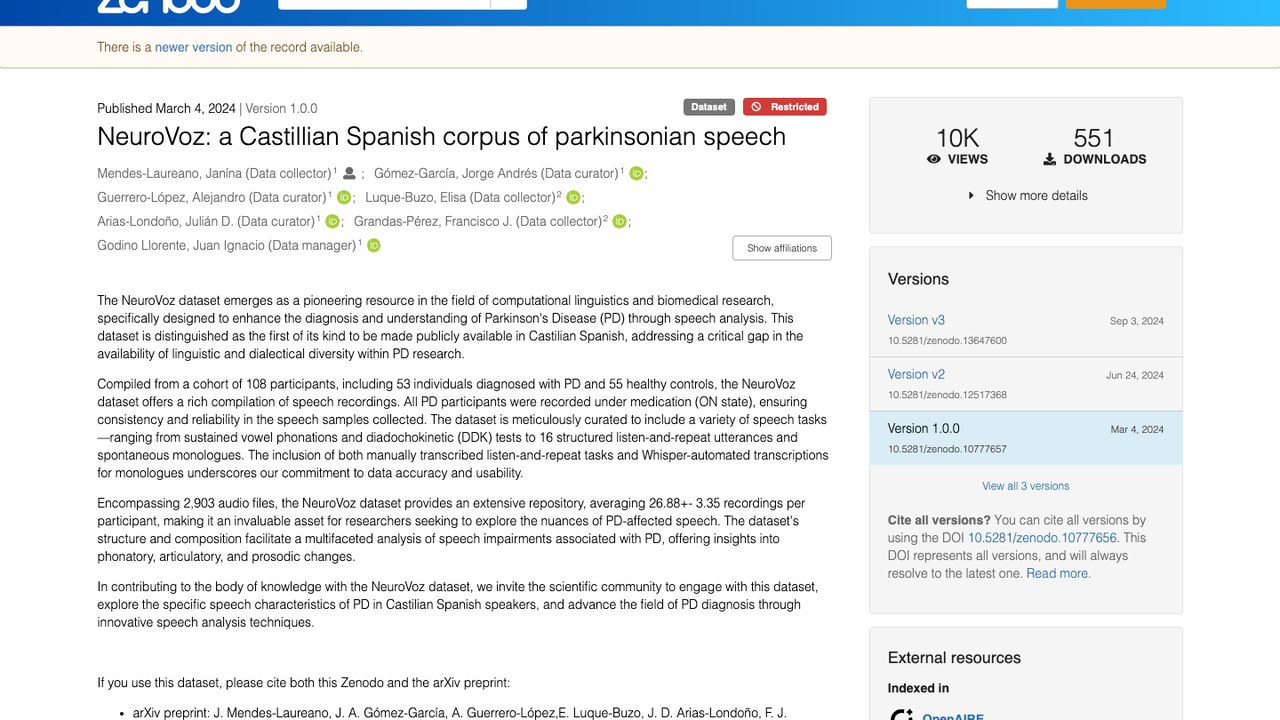
NeuroVoz: a Castillian Spanish corpus of parkinsonian speech
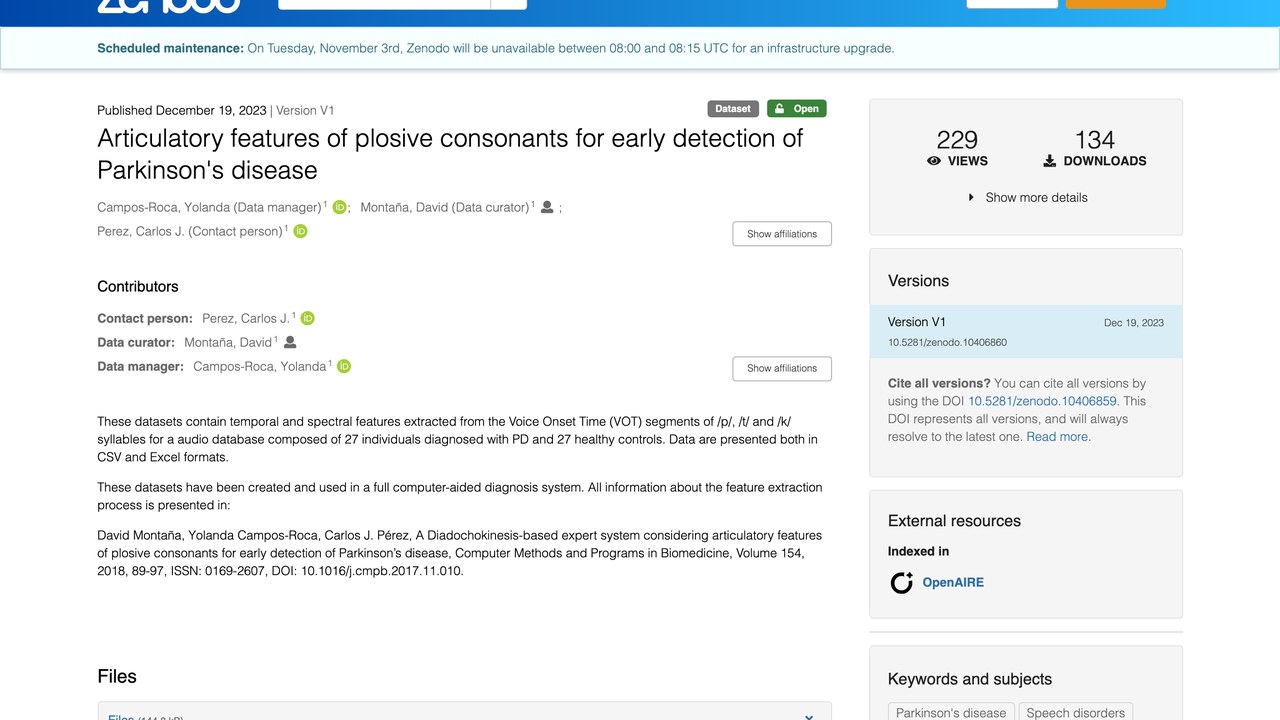
NeuroVoz 是首个公开的卡斯蒂利亚西班牙语帕金森病语音语料库,共纳入 108 名参与者,其中 53 名帕金森病患者(均在用药状态下录制)和 55 名健康对照。数据包含持续元音发声、重复音节运动等多种语音任务录音,可用于帕金森病的语音分析与辅助诊断研究,并弥补该领域在语言和方言多样性上的不足(来源 Zenodo,cc-by-nc-nd-4.0 许可)。
【数据集背景】
项目资助方:Ministry of Economy and Competitiveness of Spain。源站首次发布:2024-03-04。
【数据内容】
源站描述(机器翻译,仅供参考):NeuroVoz 数据集是计算语言学和生物医学研究领域的开创性资源,专门旨在通过语音分析增强对帕金森病(PD)的诊断和理解。该数据集是首个以卡斯蒂利亚西班牙语公开提供的此类数据集,填补了帕金森病研究中语言和方言多样性方面的关键空白。NeuroVoz 数据集由 108 名参与者组成的队列编制而成,其中包括 53 名被诊断患有帕金森病的个体和 55 名健康对照者,提供了丰富的语音录音汇编。所有帕金森病参与者均在用药状态下(ON 状态)录制,确保了所收集语音样本的一致性和可靠性。该数据集经过精心整理,包含多种语音任务——从持续元音发声和重复音节运动
【数据结构与技术规格】
数据集 DOI:10.5281/zenodo.10777657。
【主题与分类】
主题标签:Parkinson's disease、Parkinson、speech、castillian、spanish、neurovoz、Castillian Spanish、speech corpus。本站分类:神经系统疾病/帕金森病。
【获取与许可】
源站页面:https://zenodo.org/records/10777657
使用许可:cc-by-nc-nd-4.0。
【使用注意】
· 源站最后修改于 2024-07-17,引用时请注意版本时效。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取(Zenodo 公开直链)
源站:https://zenodo.org/records/10777657
(注册/登录后按页面指引下载)
数据说明
NeuroVoz数据集作为计算语言学和生物医学研究领域的开创性资源,专门旨在通过语音分析增强对帕金森病(PD)的诊断和理解。该数据集是首个以卡斯蒂利亚西班牙语公开提供的此类数据集,填补了PD研究中语言和方言多样性可用性的关键空白。NeuroVoz数据集由108名参与者组成的队列编制而成,其中包括53名被诊断患有PD的个体和55名健康对照者,提供了丰富的语音录音汇编。所有PD参与者均在用药状态下(ON状态)录制,确保了所收集语音样本的一致性和可靠性。该数据集经过精心策划,包含多种语音任务——从持续元音发声和构音障碍(DDK)测试到16个结构化的听复述话语和自发独白。包含手动转录的听复述任务和独白的Whisper自动转录,彰显了我们对数据准确性和可用性的承诺。
NeuroVoz数据集包含2,903个音频文件,构成了一个庞大的资源库,每位参与者平均有26.88±3.35份录音,这对于希望探索帕金森病(PD)影响下言语细微差异的研究人员来说,是一笔宝贵的财富。该数据集的结构与组成促进了对PD相关言语障碍的多维度分析,为发声、构音及韵律变化提供了深刻见解。通过NeuroVoz数据集为知识体系做出贡献,我们诚邀科学界利用此数据集,探索卡斯蒂利亚西班牙语使用者中PD的特定言语特征,并通过创新的言语分析技术推动PD诊断领域的发展。若您使用此数据集,请同时引用本Zenodo存储库及arXiv预印本:arXiv预印本:J. Mendes-Laureano, J. A. Gómez-García, A. Guerrero-López, E. Luque-Buzo, J. D. Arias-Londoño, F. J. Grandas-Pérez, 和 J. I. Godino-Llorente,“Neurovoz:一个卡斯蒂利亚西班牙语
许可
cc-by-nc-nd-4.0
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。