自闭症谱系障碍儿童与典型发育对照粪便微生物16S rRNA基因高通量测序数据集
该数据集由延安大学延安医学院基础医学院及延安大学附属医院儿科研究团队构建,纳入51名自闭症谱系障碍(ASD)儿童和51名年龄、性别匹配的典型发育(TD)对照
基本信息
资源简介
自闭症谱系障碍儿童与典型发育对照粪便微生物16S rRNA基因高通量测序数据集
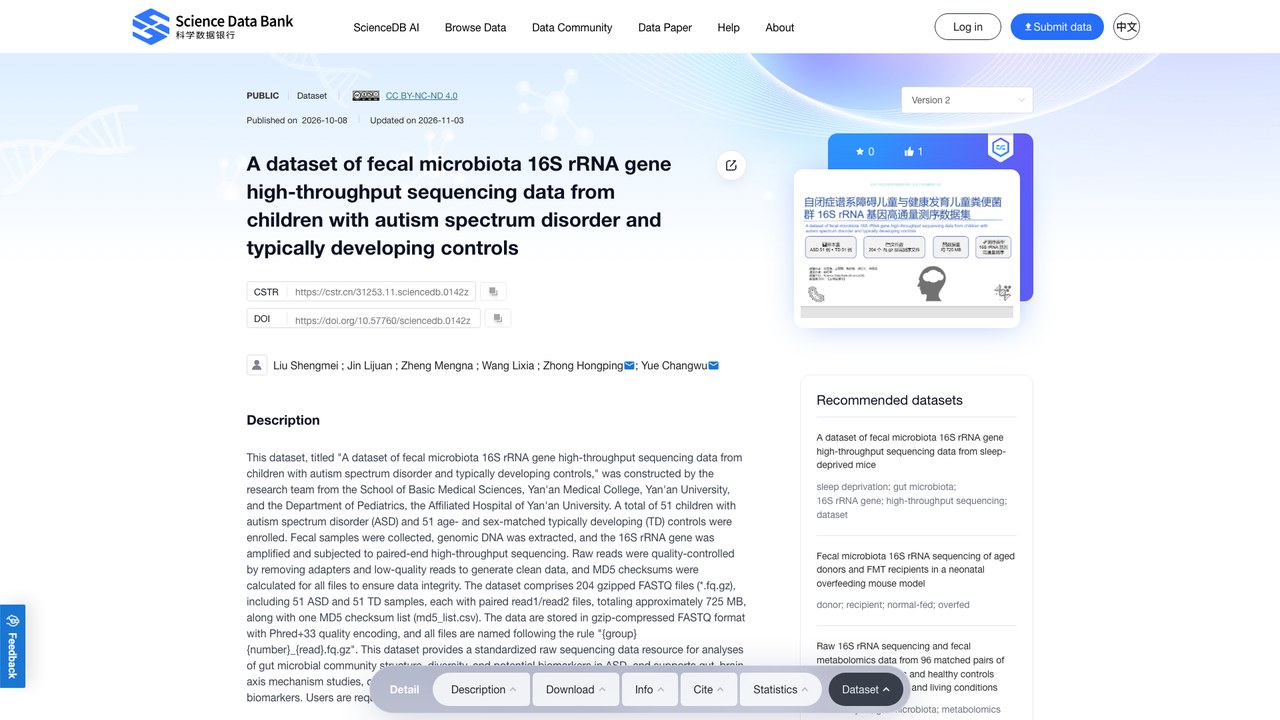
A dataset of fecal microbiota 16S rRNA gene high-throughput sequencing data from children with autism spectrum disorder and typically developing controls
该数据集由延安大学延安医学院基础医学院及延安大学附属医院儿科研究团队构建,纳入51名自闭症谱系障碍(ASD)儿童和51名年龄、性别匹配的典型发育(TD)对照。采集粪便样本,提取基因组DNA,扩增16S rRNA基因并进行双端高通量测序。原始reads经去除接头和低质量reads的质量控制生成clean data,所有文件计算MD5校验和以确保数据完整性。数据集包含204个gzip压缩的FASTQ文件(*.fq.gz),可用于研究ASD儿童与TD对照肠道微生物群组成差异及相关分析(来源 DOI 解析,Creative Commons Attribution Non Commercial No Derivatives 4.0 Inter。
【数据集背景】
源站首次发布:2026。
【数据内容】
源站描述(机器翻译,仅供参考):该数据集题为“自闭症谱系障碍儿童与典型发育对照粪便微生物16S rRNA基因高通量测序数据集”,由延安大学延安医学院基础医学院和延安大学附属医院儿科的研究团队构建。共纳入51名自闭症谱系障碍(ASD)儿童和51名年龄、性别匹配的典型发育(TD)对照。采集粪便样本,提取基因组DNA,扩增16S rRNA基因并进行双端高通量测序。原始reads经去除接头和低质量reads的质量控制以生成clean data,并计算所有文件的MD5校验和以确保数据完整性。该数据集包含204个gzip压缩的FASTQ文件(*.fq.gz),i
【主题与分类】
主题标签:Biology、autism spectrum disorder、gut microbiota、16S rRNA gene、high-throughput sequencing、dataset。本站分类:神经系统疾病。
【获取与许可】
源站页面:https://www.scidb.cn/detail?dataSetId=d6363e85a55444d7ab0328513b52b8bf
使用许可:Creative Commons Attribution Non Commercial No Derivatives 4.0 International。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://doi.org/10.57760/sciencedb.0142z
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
本数据集题为“孤独症谱系障碍儿童与典型发育对照儿童粪便微生物群16S rRNA基因高通量测序数据集”,由延安大学延安医学院基础医学院研究团队与延安大学附属医院儿科共同构建。共纳入51名孤独症谱系障碍(ASD)儿童和51名年龄、性别匹配的典型发育(TD)对照儿童。采集粪便样本,提取基因组DNA,对16S rRNA基因进行扩增并开展双端高通量测序。原始reads经去除接头和低质量reads的质量控制后生成clean data,并对所有文件计算MD5校验和以确保数据完整性。本数据集包含204个gzip压缩的FASTQ文件(*.fq.gz),包括51份ASD样本和51份TD样本,每份样本均含配对的read1/read2文件,总计约725 MB,另附一份MD5校验和列表(md5_list.csv)。
数据以gzip压缩的FASTQ格式存储,采用Phred+33质量编码,所有文件均按照“{group}{number}_{read}.fq.gz”的规则命名。该数据集为分析ASD中肠道微生物群落结构、多样性及潜在生物标志物提供了标准化的原始测序数据资源,并支持肠-脑轴机制研究、跨研究整合分析以及早期辅助诊断生物标志物的筛选。用户需同时引用本数据论文及数据集DOI。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。