PARERE 试验
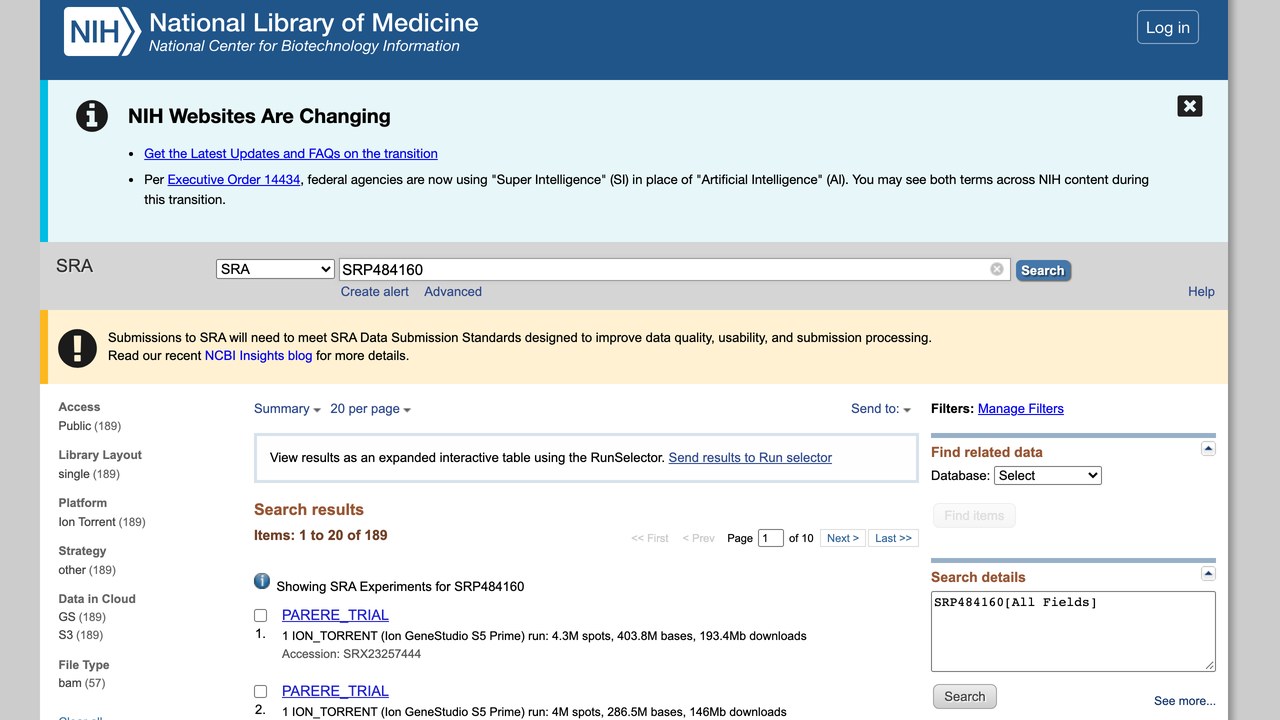
PARERE试验:RAS/BRAF野生型转移性结直肠癌抗EGFR再治疗,基于液体活检ctDNA分析,含相关测序数据。
基本信息
资源简介
PARERE 试验
【一句话概览】
PARERE(NCT04787341)是一项随机II期试验,研究对既往抗EGFR治疗获益、经液体活检ctDNA分析排除RAS/BRAF突变的RAS/BRAF野生型转移性结直肠癌患者,再次使用抗EGFR单克隆抗体的策略。相关标签为PRJNA1064885、University of Pisa(来源 NCBI)。
【数据集背景】
本数据集源站标题为《PARERE TRIAL》。源站首次发布:2024-01-17。
【数据内容】
源站原始描述:Retreatment with anti-EGFR monoclonal antibodies is a promising strategy in patients with RAS/BRAF wild-type (wt) metastatic colorectal cancer (mCRC) who achieved benefit from previous anti-EGFR exposure, upon exclusion of mutations in RAS/BRAF genes according to circulating tumour DNA (ctDNA) analysis by means of liquid biopsy (LB). This treatment approach is now being investigated in the randomized phase II trial PARERE (NCT04787341)
中文译文(机器翻译,仅供快速理解,请以原文为准):对于既往接受抗EGFR治疗获得获益、且通过液体活检(LB)进行循环肿瘤DNA(ctDNA)分析排除RAS/BRAF基因突变的RAS/BRAF野生型(wt)转移性结直肠癌(mCRC)患者,再次使用抗EGFR单克隆抗体治疗是一种有前景的策略。目前,该治疗方法正在随机II期试验PARERE(NCT04787341)中接受研究。
【主题与分类】
主题标签:PRJNA1064885、University of Pisa。
【适用方向】
组学数据适用于生物标志物发现与分子分型相关建模研究。
【获取与许可】
源站页面:https://www.ncbi.nlm.nih.gov/sra/SRP484160
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://www.ncbi.nlm.nih.gov/sra/SRP484160
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据加载示例(表格/文本类)
import pandas as pd, glob, os

files = (glob.glob(os.path.join(path, "**", "*.csv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tsv"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.xlsx"), recursive=True))
print("数据文件:", files)
df = pd.read_csv(files[0])
print(df.shape); print(df.columns.tolist()); print(df.head(3))
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。