NGP 细胞的 Bulk RNA seq 数据集
该数据集为 NGP 神经母细胞瘤细胞的 Bulk RNA 测序数据,用于在 nutlin-3 处理条件下对细胞转录反应进行分子表征
基本信息
资源简介
NGP 细胞的 Bulk RNA seq 数据集
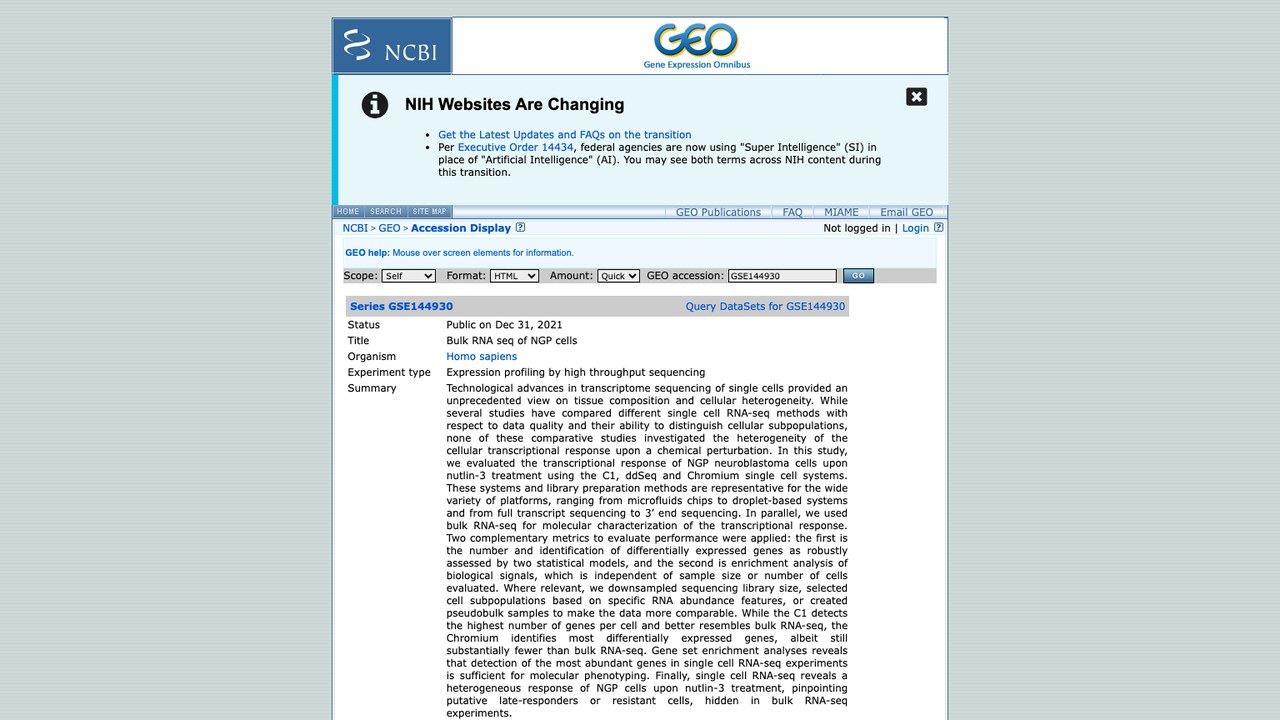
Bulk RNA seq of NGP cells
该数据集为 NGP 神经母细胞瘤细胞的 Bulk RNA 测序数据,用于在 nutlin-3 处理条件下对细胞转录反应进行分子表征。研究背景是比较 C1、ddSeq 和 Chromium 等单细胞 RNA 测序系统在化学扰动下转录异质性检测能力,而 Bulk RNA-seq 作为平行实验提供整体转录组信息。数据来源于 NCBI GEO,包含 1 个文件 GSE144930_series_matrix.txt.gz,可用于基因表达分析、转录反应研究及与单细胞测序结果的比较(来源 NCBI)。
【数据集背景】
源站首次发布:Feb 07 202。
【数据内容】
源站描述(机器翻译,仅供参考):单细胞转录组测序的技术进步为组织组成和细胞异质性提供了前所未有的视角。虽然已有若干研究比较了不同单细胞 RNA-seq 方法在数据质量及区分细胞亚群能力方面的差异,但这些比较研究均未考察化学扰动下细胞转录反应的异质性。在本研究中,我们使用 C1、ddSeq 和 Chromium 单细胞系统评估了 NGP 神经母细胞瘤细胞在 nutlin-3 处理后的转录反应。这些系统及文库制备方法代表了从微流控芯片到基于液滴的系统、从全长转录本测序到 3' 端测序的广泛平台类型。同时,我们使用 bulk RNA-seq 对转录进行分子表征。
【数据结构与技术规格】
文件数 1 个,合计 0 B。
【主题与分类】
主题标签:GPL18573、9606。本站分类:肿瘤。
【获取与许可】
源站页面:https://ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE144930
【使用注意】
· 源站最后修改于 Dec 31 202,引用时请注意版本时效。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE144930
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
单细胞转录组测序技术的进步为组织组成和细胞异质性提供了前所未有的视角。尽管已有若干研究比较了不同单细胞RNA-seq方法在数据质量及区分细胞亚群能力方面的差异,但这些比较研究均未探讨化学扰动下细胞转录反应的异质性。本研究利用C1、ddSeq和Chromium单细胞系统,评估了NGP神经母细胞瘤细胞在nutlin-3处理后的转录反应。这些系统及文库制备方法代表了从微流控芯片到基于液滴的系统、从全长转录本测序到3‘端测序等多种平台的广泛类型。同时,我们采用bulk RNA-seq对转录反应进行了分子特征分析。
采用了两项互补的指标来评估性能:第一项是通过两种统计模型稳健评估的差异表达基因的数量和鉴定,第二项是生物学信号的富集分析,这一分析不受样本大小或评估细胞数量的影响。在相关情况下,我们对测序文库大小进行了降采样,根据特定的RNA丰度特征选择了细胞亚群,或创建了伪批量样本来使数据更具可比性。尽管C1平台能检测到每个细胞中最多的基因数量,且更接近于批量RNA-seq的结果,但Chromium平台能识别出最多的差异表达基因,尽管这一数量仍远少于批量RNA-seq。基因集富集分析显示,在单细胞RNA-seq实验中,检测最丰富的基因足以进行分子表型分析。最后,单细胞RNA-seq揭示了NGP细胞在nutlin-3处理后呈现出异质性反应,指出了潜在的迟反应者或耐药细胞,这些在批量RNA-seq实验中是隐藏未见的。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。