上皮性卵巢癌表观基因组与转录组分析数据集
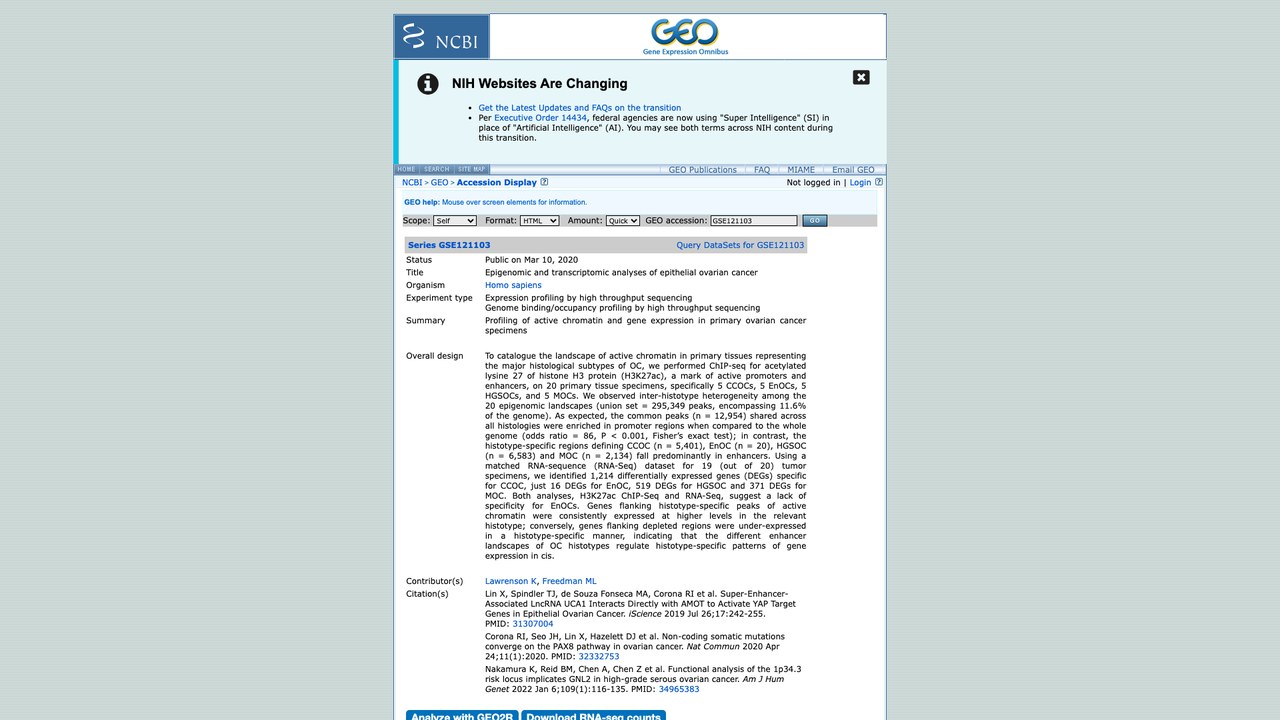
该数据集来自 NCBI,标题为上皮性卵巢癌的表观基因组与转录组分析,包含对原发性卵巢癌标本中活跃染色质与基因表达的分析。数据以高通量测序进行表达谱检测,涉及平台 GPL18573 与物种 9606,文件数量为 1,样例文件为 GSE121103_series_matrix.txt.gz
基本信息
资源简介
上皮性卵巢癌表观基因组与转录组分析数据集
GSE121103 是一个以上皮性卵巢癌为研究对象的公开数据集,英文全称为 Epigenomic and transcriptomic analyses of epithelial ovarian cancer,由 NCBI 收录,来源站点为 ncbi.nlm.nih.gov。该数据集围绕原发性卵巢癌标本中活跃染色质与基因表达开展分析,采用高通量测序进行表达谱检测,涉及平台 GPL18573 与物种 9606(人类)。数据集共包含 1 个文件,样例文件为 GSE121103_series_matrix.txt.gz,作者为 Kate,Lawrenson,发布时间为 Oct 10 201。整体来看,该数据集将表观基因组与转录组两个层面的检测结合在一起,为研究上皮性卵巢癌中染色质活跃状态与基因表达之间的关系提供了可获取的公开数据资源。
【数据集背景】
上皮性卵巢癌是卵巢癌中常见的组织学类型,对其表观遗传调控与转录输出之间关系的研究有助于理解肿瘤发生发展中的分子机制。该数据集正是以原发性卵巢癌标本为材料,同时开展表观基因组与转录组层面的分析,标题即明确指向“上皮性卵巢癌的表观基因组与转录组分析”。数据集由 Kate,Lawrenson 提交,经 NCBI 平台对外发布,发布时间为 Oct 10 201。其主题标签包含 Expression profiling by high throughput sequencing、GPL18573 与 9606,说明该数据属于基于高通量测序的表达谱研究,检测平台为 GPL18573,物种为人类。
【数据内容】
数据集的核心内容是针对原发性卵巢癌标本中活跃染色质与基因表达所进行的分析。源站描述指出,该数据集用于对原发性卵巢癌标本中的活跃染色质和基因表达进行 profiling。数据以高通量测序方式产生表达谱信息,主题标签中的 Expression profiling by high throughput sequencing 即对应这一检测方式。数据集文件数量为 1,样例文件名为 GSE121103_series_matrix.txt.gz,从文件名看属于系列矩阵文件,并以 GZIP 压缩形式提供。除该文件外,未提供其他文件样例信息。
【采集与来源】
该数据集来源于 NCBI,来源站地址为 ncbi.nlm.nih.gov,源站标题与数据集英文名一致,均为 Epigenomic and transcriptomic analyses of epithelial ovarian cancer。数据作者为 Kate,Lawrenson,发布时间为 Oct 10 201。样本材料为原发性卵巢癌标本,检测围绕活跃染色质与基因表达展开。涉及物种为 9606,即人类;涉及检测平台为 GPL18573。本站将其归类为“肿瘤 / 其他”。
【适用场景】
该数据集适用于上皮性卵巢癌相关的研究场景,尤其是需要同时考察活跃染色质状态与基因表达谱的分析工作。由于数据以高通量测序表达谱的形式提供,可用于表达层面的比较与探索;结合其表观基因组分析背景,也可用于讨论染色质活跃区域与基因表达之间的对应关系。对于关注原发性卵巢癌标本分子特征的研究者,该数据集可作为公开数据来源之一。具体分析设计需依据数据实际内容确定,源站未提供更细化的适用场景说明。
【使用方法】
使用该数据集时,首先下载数据文件 GSE121103_series_matrix.txt.gz。该文件为 GZIP 压缩包格式,读取前需按对应格式解压或直接以支持 GZIP 的工具打开。建议先在小样本上核对字段与编码,确认数据组织方式与编码无误后,再批量接入后续分析流程。由于数据集仅包含 1 个文件,接入时应以该系列矩阵文件为主要数据入口。源站未提供额外的使用步骤或分析参数说明。
【质量与限制】
该数据集文件数量为 1,样例文件为 GSE121103_series_matrix.txt.gz,源站未提供关于数据质量评分、缺失值情况、样本量或批次信息的具体说明。数据涉及平台 GPL18573 与物种 9606,使用时应确认平台与物种信息与分析目标一致。由于仅提供一个系列矩阵文件,原始测序数据或其他中间文件的情况源站未提供。发布时间的记录为 Oct 10 201,年份信息不完整,源站未提供更明确的日期说明。
【引用与许可】
该数据集的作者为 Kate,Lawrenson,来源站为 ncbi.nlm.nih.gov,源站标题为 Epigenomic and transcriptomic analyses of epithelial ovarian cancer。引用时应依据源站提供的作者与标题信息进行标注。关于该数据集的具体许可条款、使用限制与授权方式,源站未提供。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE121103
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
Profiling of active chromatin and gene expression in primary ovarian cancer specimens
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。