膀胱癌DNA甲基化与表达谱研究 [基因表达]
该数据集来自 omicsdi.org,聚焦膀胱癌的 DNA 甲基化与基因表达谱研究,包含 24 对匹配的微阵列 DNA 甲基化与基因表达谱数据
基本信息
资源简介
膀胱癌DNA甲基化与表达谱研究 [基因表达]
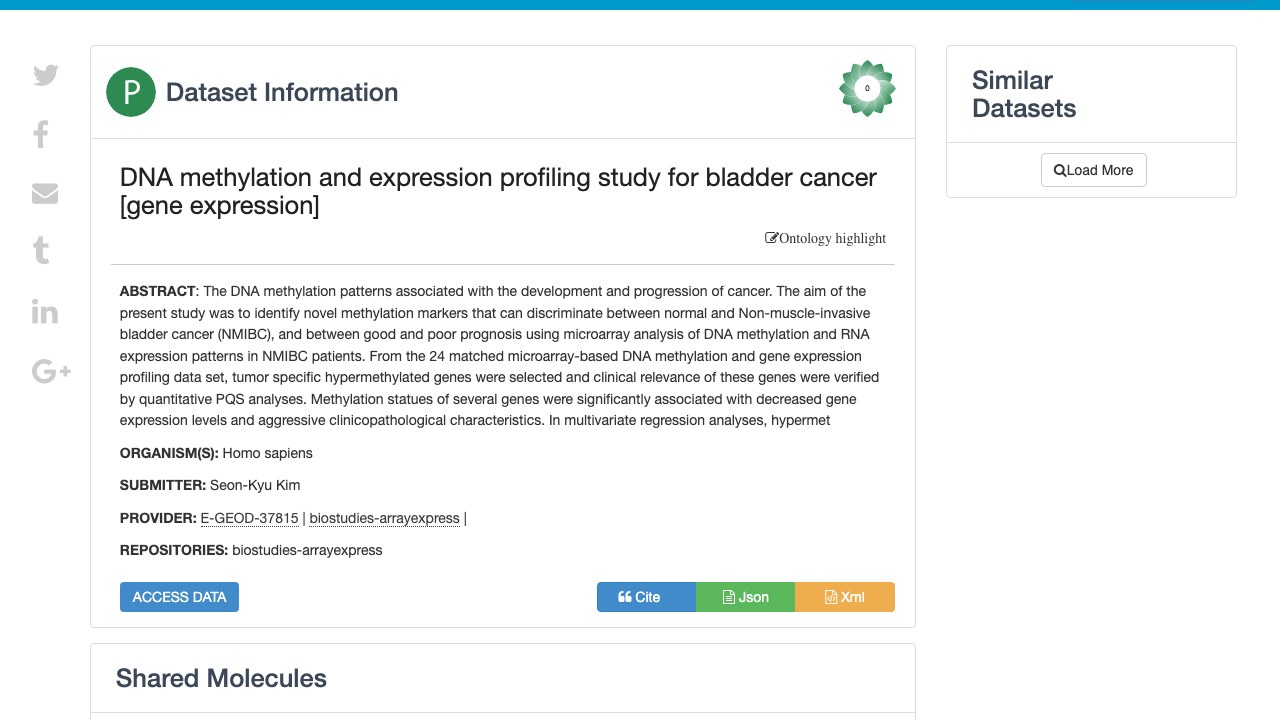
该数据集来自 omicsdi.org,聚焦膀胱癌的 DNA 甲基化与基因表达谱研究,包含 24 对匹配的微阵列 DNA 甲基化与基因表达谱数据。研究旨在识别能区分正常组织与非肌层浸润性膀胱癌(NMIBC)、以及区分预后良好与不良的新型甲基化标志物,并通过定量 PQS 分析验证候选基因的临床相关性。数据可用于筛选肿瘤特异性高甲基化基因、分析甲基化状态与基因表达下调及侵袭性临床病理特征的关系,并支持复发与进展的预测建模(来源 omicsdi.org)。
【数据内容】
源站描述(机器翻译,仅供参考):与癌症发生和进展相关的 DNA 甲基化模式。本研究的目的是通过对 NMIBC 患者 DNA 甲基化和 RNA 表达模式的微阵列分析,识别能够区分正常组织与非肌层浸润性膀胱癌(NMIBC)、以及区分预后良好与不良的新型甲基化标志物。从 24 对匹配的基于微阵列的 DNA 甲基化和基因表达谱数据集中,筛选出肿瘤特异性高甲基化基因,并通过定量 PQS 分析验证这些基因的临床相关性。若干基因的甲基化状态与基因表达水平降低及侵袭性临床病理特征显著相关。在多变量回归分析中,这些基因的高甲基化是复发和进展的独立预测因子。对于 integ
【主题与分类】
主题标签:Transcriptomics。本站分类:肿瘤。
【获取与许可】
源站页面:https://omicsdi.org/dataset/biostudies-arrayexpress/E-GEOD-37815
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://omicsdi.org/dataset/biostudies-arrayexpress/E-GEOD-37815
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
与癌症发生和发展相关的DNA甲基化模式。本研究旨在通过对非肌层浸润性膀胱癌(NMIBC)患者DNA甲基化和RNA表达模式的微阵列分析,识别能够区分正常组织与NMIBC、以及区分预后良好与预后不良的新型甲基化标志物。从24对匹配的基于微阵列的DNA甲基化和基因表达谱数据集中,筛选出肿瘤特异性高甲基化基因,并通过定量PQS分析验证这些基因的临床相关性。若干基因的甲基化状态与基因表达水平降低及侵袭性临床病理特征显著相关。在多因素回归分析中,这些基因的高甲基化是复发和进展的独立预测因子。为了整合分析整体甲基化状态与基因表达水平,我们使用了全基因组人类-6 v2.0表达珠芯片(Illumina公司,美国加利福尼亚州圣迭戈)。基因表达分析按照制造商提供的方案进行。
按照制造商的操作方案,使用500纳克总RNA进行标记杂交。根据制造商的说明,使用Illumina Bead Array Reader共聚焦扫描仪(BeadStation 500GXDW;Illumina Inc.,San Diego,CA)对芯片进行扫描。初始微阵列基因表达数据是通过Bead Studio软件(版本3.1.3,Illumina Inc.,San Diego,CA)的基因表达分析模块获得的。为了导出基于唯一基因的基因表达数据,我们使用了Illumina BeadStudio软件的Sample Gene Profile选项。因此,从Human-6 beadChip ver. 2上的全部48701个探针中,共有5553个具有重复基因的探针数据聚合成唯一基因。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。