SCEMENT 大规模单细胞 RNA 测序数据整合评估数据集
其内容涵盖拟南芥根系、人类主动脉瓣、PBMC Covid 图谱以及公共 10x 数据集,均经过预处理,用于细胞与基因层面的质量控制
基本信息
资源简介
SCEMENT 大规模单细胞 RNA 测序数据整合评估数据集
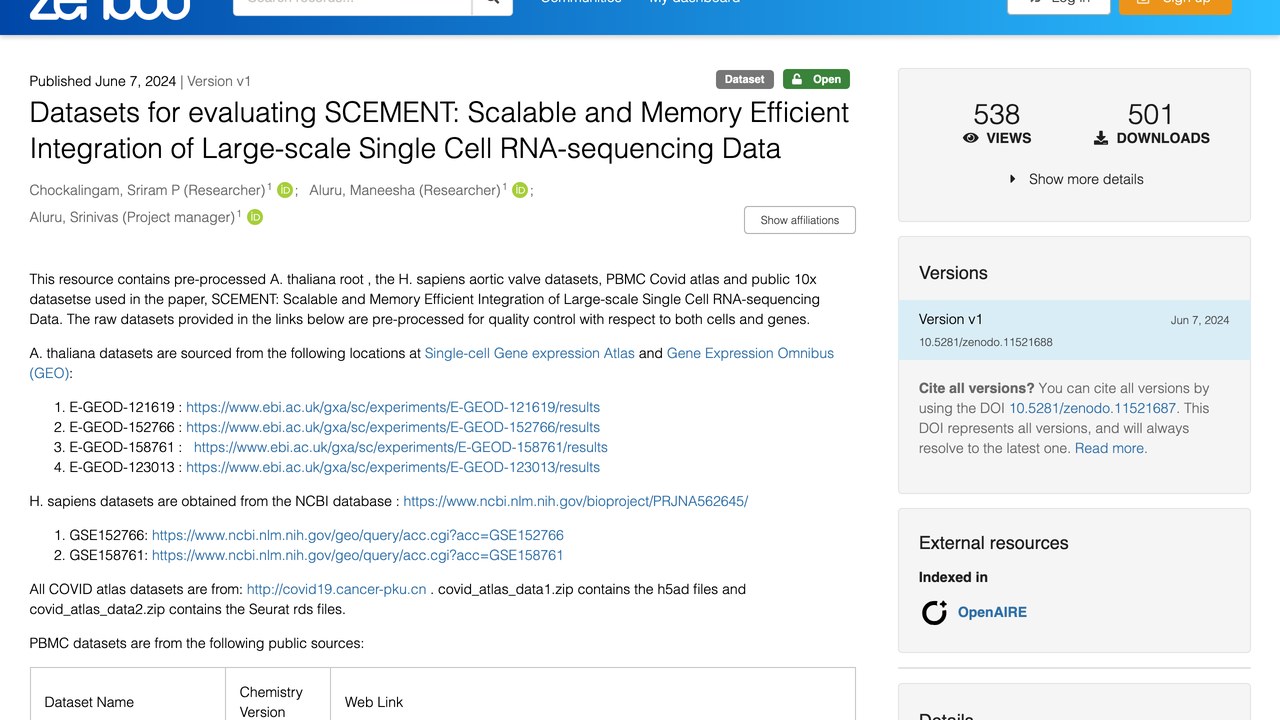
该数据集为面向单细胞 RNA 测序数据整合方法 SCEMENT 的评测资源,英文全称为 Datasets for evaluating SCEMENT: Scalable and Memory Efficient Integration of Large-scale Single Cell RNA-sequencing Data。其内容涵盖拟南芥根系、人类主动脉瓣、PBMC Covid 图谱以及公共 10x 数据集,均经过预处理,用于细胞与基因层面的质量控制。该资源由 Chockalingam, Sriram P、Aluru, Maneesha 与 Aluru, Srinivas 共同贡献,发布于 Zenodo,时间标注为 2024 年,采用 Creative Commons Attribution 4.0 International 许可。本站将其归入肿瘤 / 其他分类,来源站为 doi.org。整体而言,该数据集旨在为大规模单细胞转录组数据整合方法的性能评估提供标准化输入。
【数据集背景】
SCEMENT 是一种面向大规模单细胞 RNA 测序数据的整合方法,其名称强调可扩展性与内存效率。为验证该方法在不同物种、不同组织及不同数据规模下的表现,需要一套经过统一预处理的单细胞数据集作为评测基础。该资源正是为此目的而构建,汇集了多个公开来源的单细胞转录组数据,并针对细胞和基因两个维度完成了质量控制。源站描述指出,这些数据用于论文 SCEMENT: Scalable and Memory Efficient Integration of Large-scale Single Cell RNA-sequencing Data 的评测工作。
【数据内容】
该资源包含四类主要数据:拟南芥(A. thaliana)根系数据集、人类(H. sapiens)主动脉瓣数据集、PBMC Covid 图谱以及公共 10x 数据集。所有数据均以预处理后的形式提供,预处理过程涉及细胞与基因层面的质量控制。拟南芥数据来源于单细胞基因表达图谱(Single-cell Gene expression Atlas)和基因表达综合数据库(GEO),具体包括 E-GEOD-121619、E-GEOD-152766、E-GEOD-158761 和 E-GEOD-123013 四个条目。人类数据集则获取自 NCBI 数据库。源站描述中未完整列出所有下载链接,但已明确上述来源与预处理状态。
【采集与来源】
拟南芥数据集的原始来源为 Single-cell Gene expression Atlas 与 Gene Expression Omnibus(GEO),对应条目编号为 E-GEOD-121619、E-GEOD-152766、E-GEOD-158761 和 E-GEOD-123013,每个条目均附有 EBI 单细胞实验页面的链接。人类数据集来自 NCBI 数据库。PBMC Covid 图谱与公共 10x 数据集的具体来源在源站描述中未逐一展开。整体资源由 Zenodo 机构发布,发布时间为 2024 年,作者为 Chockalingam, Sriram P、Aluru, Maneesha 与 Aluru, Srinivas。
【适用场景】
该数据集适用于评估大规模单细胞 RNA 测序数据整合方法的性能,尤其是关注可扩展性与内存效率的场景。具体而言,可用于测试整合算法在跨物种(如拟南芥与人类)、跨组织(如根系与主动脉瓣)以及不同疾病背景(如 Covid 相关 PBMC 图谱)下的表现。公共 10x 数据集则提供了常见平台的数据输入,便于方法在不同数据规模与批次效应下的比较。由于数据已经过细胞与基因层面的质量控制,使用者可直接将其作为整合流程的输入,减少额外预处理带来的差异。
【使用方法】
源站未提供具体的使用步骤或代码示例。使用者需依据自身研究目的,从对应来源获取预处理后的数据文件,并按照 SCEMENT 方法或其它整合工具的要求进行输入。拟南芥数据可通过 EBI 单细胞实验页面获取,人类数据可通过 NCBI 数据库获取。由于许可为 Creative Commons Attribution 4.0 International,使用时应遵循署名要求。源站未提供关于数据格式、文件结构或运行环境的进一步说明。
【质量与限制】
该资源中的原始数据集已针对细胞和基因进行质量控制预处理,这一步骤有助于减少低质量细胞与低表达基因对整合结果的影响。然而,源站未提供关于预处理具体参数、阈值或评估指标的详细信息。此外,源站描述中未完整列出所有数据集的下载链接,部分来源信息可能不完整。该数据集主要面向方法评测,不必然适用于临床诊断或直接生物学结论推导。使用者应结合自身分析目标评估数据适用性。
【引用与许可】
该数据集采用 Creative Commons Attribution 4.0 International 许可,允许在署名条件下共享与改编。作者为 Chockalingam, Sriram P、Aluru, Maneesha 与 Aluru, Srinivas,机构为 Zenodo,发布时间为 2024 年。引用时应注明数据集英文全称及上述作者信息。源站未提供具体的引用格式或 DOI 编号,建议使用者参考来源站 doi.org 上的原始记录获取完整引用信息。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://doi.org/10.5281/zenodo.11521687
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据集大小约 21.67 GB。
数据说明
本资源包含经过预处理的拟南芥根、人类主动脉瓣数据集、PBMC Covid图谱以及论文《SCEMENT:大规模单细胞RNA测序数据的可扩展和内存高效整合》中使用的公共10x数据集。下方链接提供的原始数据集已针对细胞和基因进行了质量控制预处理。拟南芥数据集来源于单细胞基因表达图谱和基因表达综合数据库(GEO)的以下位置:E-GEOD-121619:https://www.ebi.ac.uk/gxa/sc/experiments/E-GEOD-121619/results E-GEOD-152766:https://www.ebi.ac.uk/gxa/sc/experiments/E-GEOD-152766/results E-GEOD-158761:https://www.ebi.ac.uk/gxa/sc/experiments/E-GEOD-158761/results E-GEOD-123013:https://www.ebi.ac.uk/gxa/sc/experiments/E-GEOD-123013/results 人类数据集来自NCBI数据库:https://www.ncbi.nlm.nih.gov/bioproject/PRJNA562645/ GSE152766:https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE152766 GSE158761:https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE158761 所有COVID图谱数据集均来自:http://covid19.cancer-pku.cn 。
covid_atlas_data1.zip 包含 h5ad 文件,covid_atlas_data2.zip 包含 Seurat rds 文件。PBMC 数据集来自以下公开来源:数据集名称 化学版本 网页链接 10k Human PBMCs, 3’ v3.1, Chromium X v3.1 https://www.10xgenomics.com/datasets/10k-human-pbmcs-3-ht-v3-1-chromium-x-3-1-high 20k Human PBMCs, 3’ HT v3.1, Chromium X v3.1 https://www.10xgenomics.com/datasets/20-k-human-pbm-cs-3-ht-v-3-1-chromium-x-3-1-high-6-1-0 10k Human PBMCs, 3’ v3.1, Chromium Controller v3.1 https://www.10xgenomics.com/datasets/10k-human-pbmcs-3-v3-1-chromium-controller-3-1-high Healthy PBMC Chromium Connect (channel 1) v3.1 https://www.10xgenomics.com/datasets/peripheral-blood-mononuclear-cells-pbm-cs-from-a-healthy-donor-chromium-connect-channel-1-3-1-standard-3-1-0 Healthy PBMC Chromium Connect (channel 5) v3.1 https://www.10xg
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。