平衡标签皮肤癌图像数据集
数据划分为训练集 16800 例和测试集 4192 例,文件为 parquet 格式,共 2 个文件。图像与标签字段可直接用于皮肤癌相关图像分类任务的模型训练与评估,适合作为医学影像分类研究的数据来源(来源 Hugging Face)
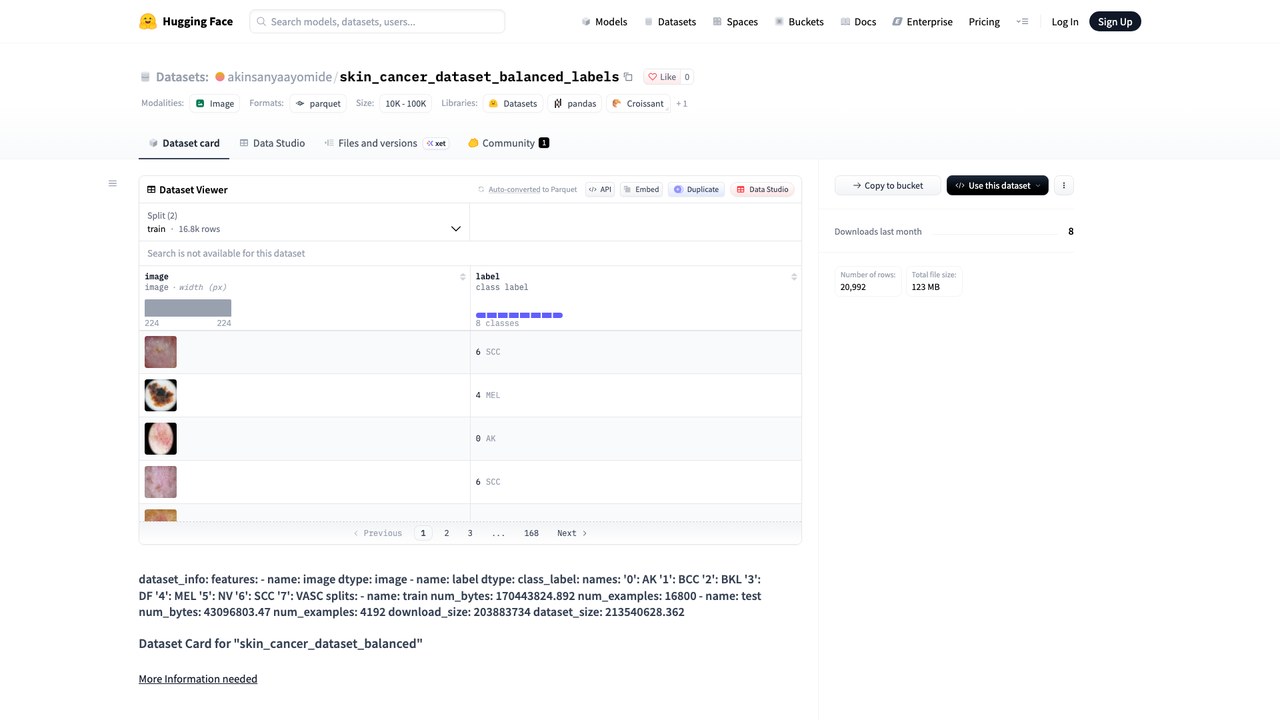
基本信息
资源简介
平衡标签皮肤癌图像数据集
该数据集名为 akinsanyaayomide/skin_cancer_dataset_balanced_labels,来源于 Hugging Face,本站归类为肿瘤 / 其他。数据以图像与类别标签成对组织,划分为训练集 16800 例和测试集 4192 例,文件为 Parquet 格式,共 2 个文件,合计约 122.78 MB。标签涵盖 8 个皮肤病变类别,图像字段与标签字段可直接用于皮肤癌相关图像分类任务的模型训练与评估,适合作为医学影像分类研究的数据来源。数据集于 2024-09-24 发布,主题标签涉及图像模态、Parquet 格式以及 10K 至 100K 的规模区间。
【数据集背景】
该数据集来自 huggingface.co,英文名称为 akinsanyaayomide/skin_cancer_dataset_balanced_labels,本站分类为肿瘤 / 其他。源站描述中仅给出了数据集的基本结构与划分信息,并附有“More Information needed”的说明,未提供更详细的数据集背景介绍。数据集发布时间为 2024-09-24,主题标签包括规模区间 10K<n<100K、格式 parquet、模态 image,以及 datasets、pandas、mlcroissant、polars 等库标签和 region:us。
【数据内容】
数据集包含图像和标签两个字段。标签为类别标签,共 8 类,名称分别为 AK、BCC、BKL、DF、MEL、NV、SCC、VASC。数据划分为训练集和测试集:训练集 16800 例,占用 170443824.892 字节;测试集 4192 例,占用 43096803.47 字节。下载大小为 203883734 字节,数据集大小为 213540628.362 字节。文件数量为 2,文件样例包括 balanced_skin_cancer_dataset_test.parquet 和 balanced_skin_cancer_dataset_train_2.parquet,合计约 122.78 MB。
【采集与来源】
数据集来源于 huggingface.co,源站描述中未提供图像采集方式、采集设备、采集地点、时间跨度、患者人群或标注流程等信息。源站描述仅包含数据集结构、划分和大小等元数据,并注明“More Information needed”。因此,关于采集与来源的更多细节,源站未提供。
【适用场景】
该数据集包含图像与标签字段,可直接用于皮肤癌相关图像分类任务的模型训练与评估,适合作为医学影像分类研究的数据来源。其 8 类标签覆盖 AK、BCC、BKL、DF、MEL、NV、SCC、VASC,训练集与测试集划分明确,可用于分类模型的训练、验证与测试。主题标签中的 modality:image 与 format:parquet 表明其适用于图像模态的机器学习流程。关于具体临床诊断、分割、检测等更细化的应用场景,源站未提供。
【使用方法】
使用时可下载数据文件,共 2 个:balanced_skin_cancer_dataset_test.parquet、balanced_skin_cancer_dataset_train_2.parquet,合计 122.78 MB。按文件格式读取,Parquet 为列式存储。建议先在小样本上核对字段与编码,确认无误后再批量接入。主题标签中列出了 datasets、pandas、mlcroissant、polars 等库,可结合这些工具进行读取与处理。关于更具体的加载代码、预处理步骤或训练配置,源站未提供。
【质量与限制】
源站描述中未提供数据质量评估、标注一致性、类别平衡性验证、图像分辨率、去重或隐私处理等信息。数据集名称中包含 balanced_labels,但源站描述未给出具体的平衡性说明或统计验证。源站描述中标注“More Information needed”,表明数据集卡片信息不完整。因此,关于质量与限制的更多内容,源站未提供。
【引用与许可】
源站描述中未提供引用格式、论文出处、作者信息或许可条款。因此,关于引用与许可的具体内容,源站未提供。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取与加载(Hugging Face datasets)
# 前置依赖: pip install datasets
from datasets import load_dataset

ds = load_dataset("akinsanyaayomide/skin_cancer_dataset_balanced_labels")
print(ds)  # 查看 splits 与字段结构
# 国内网络可先设镜像: import os; os.environ["HF_ENDPOINT"]="https://hf-mirror.com"
git lfs install && git clone https://hf-mirror.com/datasets/akinsanyaayomide/skin_cancer_dataset_balanced_labels
数据集大小约 220.9 MB。
仓库文件结构
.gitattributesREADME.mdbalanced_skin_cancer_dataset_test.parquetbalanced_skin_cancer_dataset_train_2.parquet
数据说明
dataset_info: features: - name: image dtype: image - name: label dtype: class_label: names: ‘0’: AK ‘1’: BCC ‘2’: BKL ‘3’: DF ‘4’: MEL ‘5’: NV ‘6’: SCC ‘7’: VASC splits: - name: train num_bytes: 170443824.892 num_examples: 16800 - name: test num_bytes: 43096803.47 num_examples: 4192 download_size: 203883734 dataset_size: 213540628.362… See the full description on the dataset page: https://huggingface.co/datasets/akinsanyaayomide/skin_cancer_dataset_balanced_labels.
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
完整数据卡:huggingface.co/datasets/akinsanyaayomide/skin_cancer_dataset_balanced_labels
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。