ORCHID 口腔鳞状细胞癌分类数据集
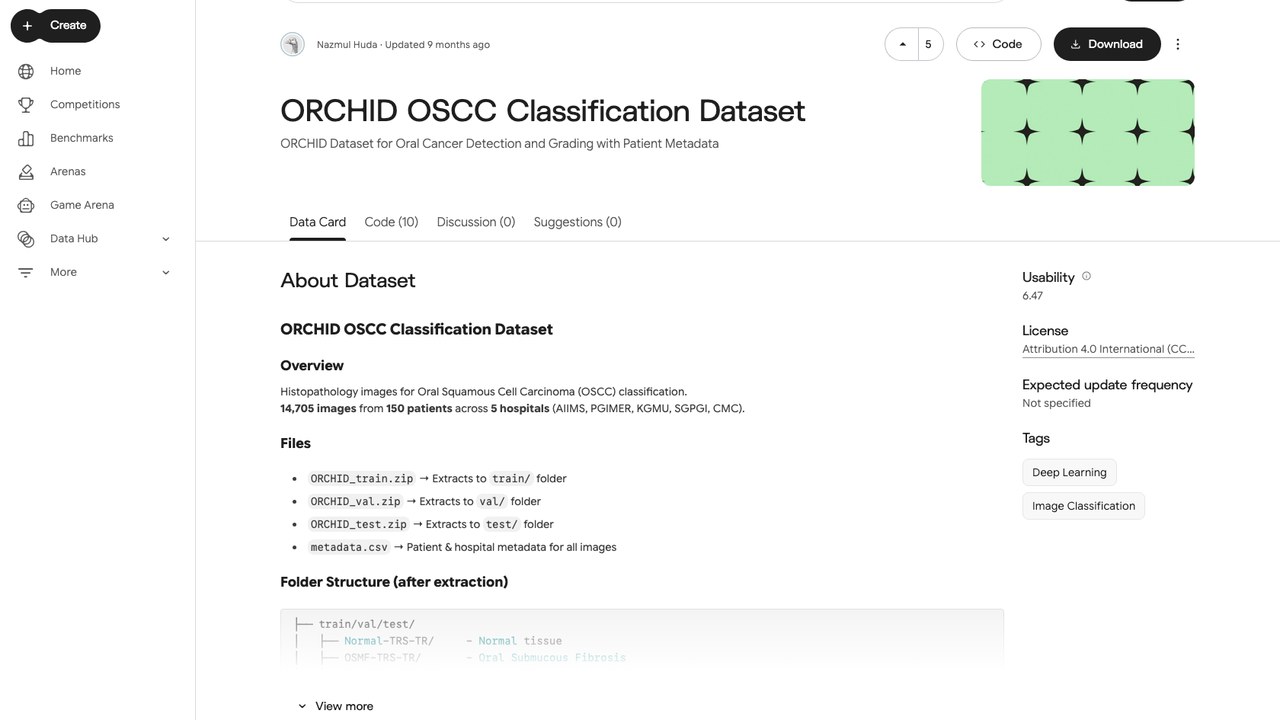
该数据集为口腔鳞状细胞癌(OSCC)组织病理图像分类数据集,包含来自 5 家医院(AIIMS、PGIMER、KGMU、SGPGI、CMC)150 名患者的 14,705 张图像
基本信息
资源简介
ORCHID 口腔鳞状细胞癌分类数据集
ORCHID OSCC Classification Dataset 是一个面向口腔鳞状细胞癌(OSCC)组织病理图像分类的公开数据集,发布于 kaggle.com,由 Nazmul Huda 上传,版本为 v1,发布时间为 2026-01-27。数据集共包含 14,705 张组织病理图像,来自 150 名患者,覆盖 AIIMS、PGIMER、KGMU、SGPGI、CMC 五家医院。数据按训练、验证、测试三个子集组织,并提供患者与医院层面的元数据文件,主题标签为深度学习与图像分类,适用于口腔癌病理图像的自动分类研究。
【数据集背景】
口腔鳞状细胞癌是口腔癌中最常见的病理类型,其组织病理学分级对诊断与治疗决策具有重要意义。该数据集以组织病理图像为对象,构建面向 OSCC 分类的标注数据资源,覆盖正常组织、口腔黏膜下纤维化以及不同分化程度的 OSCC,为深度学习模型在口腔癌病理图像上的训练与评估提供数据基础。数据集在 kaggle.com 发布,归类于肿瘤 / 口腔癌方向。
【数据内容】
数据集共包含 14,705 张组织病理图像,来源于 150 名患者。图像按类别组织为五个文件夹:Normal-TRS-TR 对应正常组织,OSMF-TRS-TR 对应口腔黏膜下纤维化,WD-OSCC-TRS-TR 对应高分化 OSCC,MD-OSCC-TRS-TR 对应中分化 OSCC,PD-OSCC-TRS-TR 对应低分化 OSCC。数据划分为 train、val、test 三个子集,分别由 ORCHID_train.zip、ORCHID_val.zip、ORCHID_test.zip 三个压缩包提供,解压后对应 train/、val/、test/ 目录。此外还提供 metadata.csv,记录所有图像对应的患者与医院元数据,其列包括 image_path(图像相对路径)等字段。文件样例为 PNG 格式图像,例如 ORCHID_test/test/mdoscc/o-3-00-01/ 目录下的 o-3-00-01-009.png、o-3-00-01-013.png、o-3-00-01-023.png、o-3-00-01-025.png、o-3-00-01-042.png 等。本站记录的文件数量为 20 个,合计约 108.07 MB。
【采集与来源】
数据来自五家医院,分别为 AIIMS、PGIMER、KGMU、SGPGI、CMC,共涉及 150 名患者。源站通过 metadata.csv 提供患者与医院层面的元数据,用于追溯每张图像所属的患者与来源医院。数据集的发布者为 Nazmul Huda,发布平台为 kaggle.com。关于图像的采集设备、扫描参数、染色流程与伦理审批等信息,源站未提供。
【适用场景】
该数据集面向组织病理图像分类任务,主题标签为深度学习与图像分类。典型用途包括:训练与评估卷积神经网络或其它深度学习模型,对正常组织、口腔黏膜下纤维化及不同分化程度的 OSCC 进行多类别分类;利用 train/val/test 划分开展模型选择与性能评估;结合 metadata.csv 中的患者与医院信息,研究跨患者、跨医院的数据分布差异对模型泛化能力的影响。由于数据涉及多家医院,也可用于考察多中心数据下的模型稳健性。
【使用方法】
使用时可分别下载 ORCHID_train.zip、ORCHID_val.zip、ORCHID_test.zip 与 metadata.csv,解压后得到 train/、val/、test/ 三个目录及元数据文件。三个目录下均按 Normal-TRS-TR、OSMF-TRS-TR、WD-OSCC-TRS-TR、MD-OSCC-TRS-TR、PD-OSCC-TRS-TR 五类组织图像。图像为 PNG 格式,可按文件路径读取。建议先在小样本上核对目录结构、类别标签与 metadata.csv 中的字段及编码,确认无误后再批量接入训练流程。metadata.csv 中的 image_path 字段给出图像的相对路径,可用于将图像与患者、医院信息关联。
【质量与限制】
数据集提供了明确的类别划分、train/val/test 划分以及患者与医院元数据,便于复现实验与开展多中心研究。但源站未提供图像分辨率、染色批次、标注一致性、类别样本量分布等具体质量指标,也未说明数据划分是否按患者分层以避免同一患者图像跨子集泄漏。本站记录的文件数量为 20 个、合计约 108.07 MB,与源站描述的 14,705 张图像规模不一致,实际可用数据范围需以源站提供的压缩包为准。此外,源站未提供伦理审批与数据脱敏说明。
【引用与许可】
该数据集采用 Attribution 4.0 International(CC BY 4.0)许可,使用时需按要求署名。数据集的发布者为 Nazmul Huda,发布平台为 kaggle.com,版本为 v1,发布时间为 2026-01-27。关于具体的引用格式与推荐参考文献,源站未提供。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
需登录公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
暂未开放有偿下载
公开数据集受托下载与技术交付服务。
提供高速下载与技术交付服务(收技术服务费,非数据销售)
暂未开放当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://kaggle.com/datasets/nazmulxdxd/orchid-oscc-classification
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据集大小约 57.19 GB。
数据说明
Nazmul Huda (2026). ORCHID OSCC Classification Dataset [Dataset]. https://www.kaggle.com/datasets/nazmulxdxd/orchid-oscc-classification
数据缺失?
依托陕西、四川两大基地,我们与超过十家三甲医院建立直接合作关系,覆盖合规授权、采集治理、专业标注、数据交付的全流程,为AI医疗团队提供即拿即用的高质量临床数据。
⚡️ 需要数据支持或标注服务?立即联系我们获取专业方案。