基于机器学习的双语自由文本病理报告乳腺癌受体状态提取数据集
数据集面向肿瘤/乳腺癌领域,涉及生物标志物信息从病理报告中的自动化提取,主题涵盖自然语言处理与临床决策支持。可用于评估标注一致性、辅助构建或验证基于机器学习的乳腺癌受体状态信息抽取方法(来源 figshare,CC BY + CC0 许可)
基本信息
资源简介
基于机器学习的双语自由文本病理报告乳腺癌受体状态提取数据集
Additional file 3: of Automated extraction of Biomarker information from pathology reports
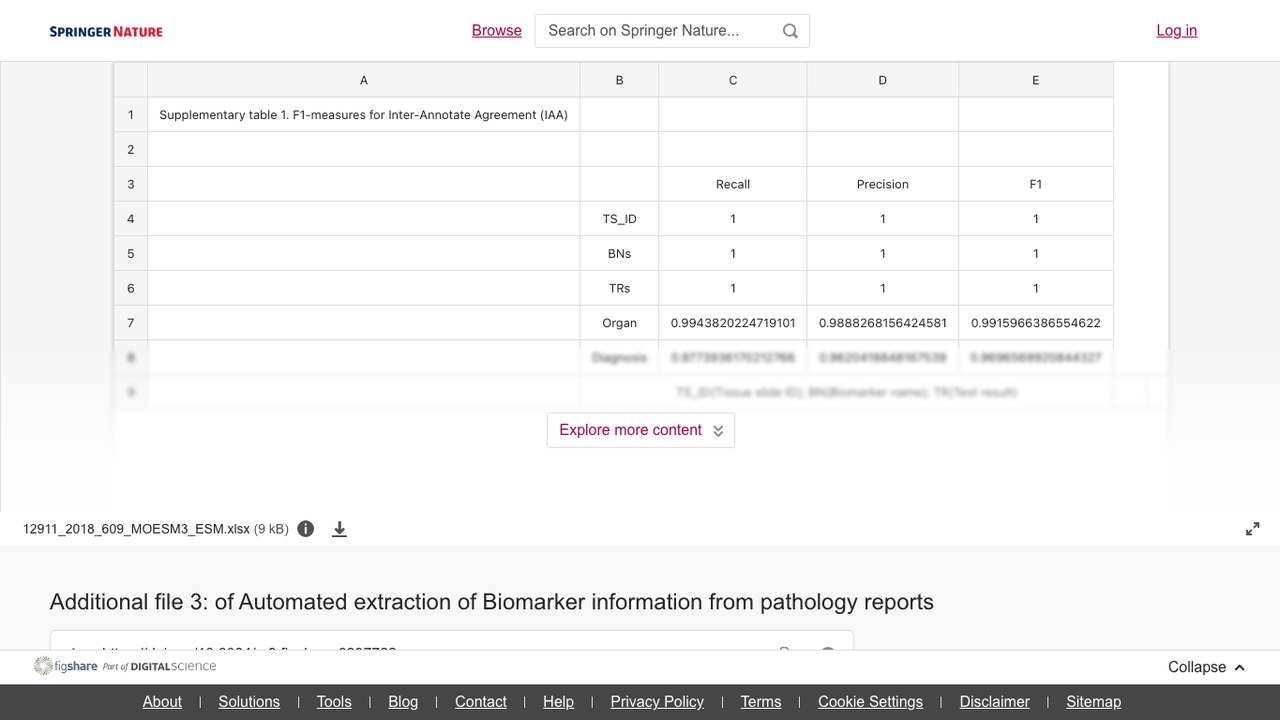
该数据集来自 springernature.figshare.com,为配套论文《Automated extraction of Biomarker information from pathology reports》的补充文件,包含 1 个 XLSX 文件,内容为金标准集的标注者间一致性(IAA)表。数据集面向肿瘤/乳腺癌领域,涉及生物标志物信息从病理报告中的自动化提取,主题涵盖自然语言处理与临床决策支持。可用于评估标注一致性、辅助构建或验证基于机器学习的乳腺癌受体状态信息抽取方法(来源 figshare,CC BY + CC0 许可)。
【数据集背景】
配套论文《Automated extraction of Biomarker information from pathology reports》发表于 BMC Medical Informatics and Decision Making(2018),DOI:10.1186/s12911-018-0609-7。项目资助方:Ministry of Health and Welfare。源站首次发布:2018-05-21。
【数据内容】
源站描述(机器翻译,仅供参考):表S1. 金标准集的注释者间一致性(IAA)。(XLSX 8 kb)
【数据结构与技术规格】
文件数 1 个,合计 9.21 KB。数据集 DOI:10.6084/m9.figshare.6297722.v1。
【主题与分类】
源站学科分类:Space Science、Medicine、Cell Biology、Pharmacology、Biotechnology、Chemical Sciences not elsewhere classified。主题标签:Biomarkers、Pathology reports、Natural language processing、Clinical decision-making。本站分类:肿瘤/乳腺癌。
【适用方向】
源站学科分类标注为 Space Science、Medicine、Cell Biology、Pharmacology、Biotechnology、Chemical Sciences not elsewhere classified。
【获取与许可】
源站页面:https://springernature.figshare.com/articles/dataset/Additional_file_3_of_Automated_extraction_of_Biomarker_information_from_pathology_reports/6297722
使用许可:CC BY + CC0(https://creativecommons.org/licenses/by/4.0/)。
规范引用:Lee, Jeongeun; Song, Hyun-Je; Yoon, Eunsil; Park, Seong-Bae; Park, Sung-Hye; Seo, Jeong-Wook; et al. (2018). Additional file 3: of Automated extraction of Biomarker information from pathology reports. figshare. Dataset
【使用注意】
· 源站最后修改于 2023-05-31,引用时请注意版本时效。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取(Figshare)
- 源站标题:Additional file 3: of Automated extraction of Biomarker information from pathology reports
- DOI:10.6084/m9.figshare.6297722.v1
- 发布日期:2018-05-21
- 文件数:1 个
- 文件总体积:9.21 KB
- 源站页面:https://springernature.figshare.com/articles/dataset/Additional_file_3_of_Automated_extraction_of_Biomarker_information_from_pathology_reports/6297722
命令行下载
curl -L -o "12911_2018_609_MOESM3_ESM.xlsx" "https://ndownloader.figshare.com/files/11525768"
文件清单
12911_2018_609_MOESM3_ESM.xlsx(9.21 KB)
文件总体积 9.21 KB(源站 API 实测)。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
数据说明
Table S1. Inter-Annotator Agreement (IAA) for gold standard set. (XLSX 8 kb)
许可
CC BY + CC0
引用
学术使用请引用 DOI 10.6084/m9.figshare.6297722.v1(source: https://springernature.figshare.com/articles/dataset/Additional_file_3_of_Automated_extraction_of_Biomarker_information_from_pathology_reports/6297722)。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。