信息速览
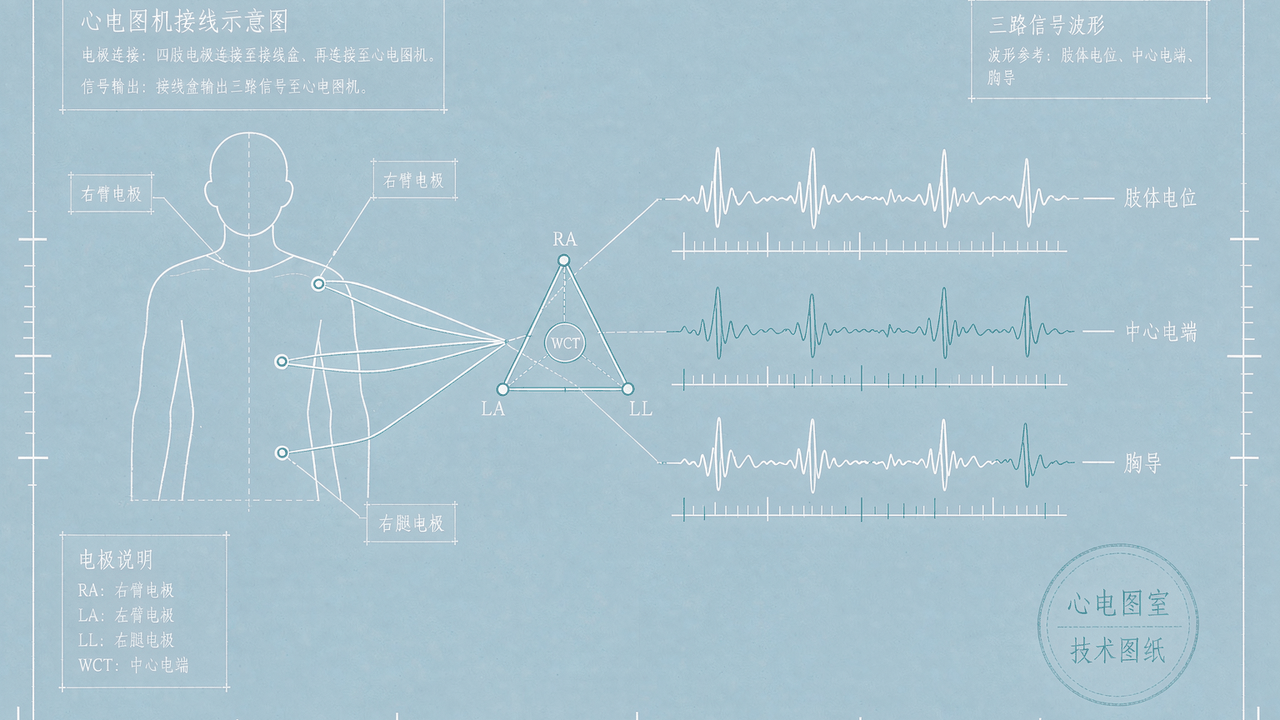
心电图教科书里有一句话被当成公理用了七十多年:胸前导联是「单极」的,因为它的参考点——把右臂、左臂、左腿三个电位各取三分之一再平均得到的那个点,也就是威尔逊中心电端(Wilson central terminal,WCT)——电位为零。这句话在工程上一直是个近似,而且是个没法验证的近似:WCT 是算出来的点,不是身体上某个位置,常规心电机的设计恰恰把它当虚拟地,所以它永远不会出现在输出里。WCTECGdb 把这件事翻了过来——用右腿作公共参考,把三个肢体电位分别单独测出来再算 WCT,它就成了能画在纸上的波形。
结果与教科书不符。作者的原话是,数据「再次确认 WCT 并不具有小数值,可能高达第二导联的百分之二百四十一」,而且它「具有标准心电特征,例如 P 波与 T 波」。这个被当作零的参考点,本身是一个完整的心电信号。
心电公开数据极多,但几乎全部是「已经做完减法的结果」——十二导联,或者 Holter 的两三导联。这份数据给的是减法之前的量:三个四肢电位、六个真单极胸导,以及那个中心电端。想做重建或设备校准的看 §2 与 §9;想直接拿它训练模型的,先看 §4 的四处坑,其中采样率与饱和两处会静默毁掉结果;只想知道它是什么的,看 §1 与 §10。
§1 它是什么:把参考点单独录下来
1.1 一句话定义与四条边界
WCTECGdb 是一份「减法之前」的心电记录集:92 名住院患者的 540 段十秒记录,每段含 37 路信号,覆盖三路标准肢体导联、六路胸导、三路四肢电位、六路真单极胸导,以及由三路四肢电位平均得到的威尔逊中心电端。
四条边界。
第一,段长固定十秒。 所有记录的首行都是 37 800 8001,即 800 个采样点。没有更长的连续记录,也没有跨段的拼接。
第二,采样率是 80 赫兹。 十秒 800 点。这一点很容易被忽略,因为它不符合任何心电常规(诊断级心电通常 500 赫兹以上)。80 赫兹的奈奎斯特上限是 40 赫兹,意味着 QRS 的高频成分基本被削平了。这份数据的用途不是诊断,是电位关系。
第三,信号有「原始」与「处理后」两套。 十八路信号各有一个 -Raw 后缀的原始版本,与一个无后缀的处理后版本(低通加去直流)。WCT 只有一路,没有原始版。
第四,五名患者的八段记录里,胸导是算出来的,不是测出来的。这一点在 §4.4 展开,它是使用这份数据时最容易踩的坑。
1.2 为什么「中心电端不为零」是件大事
标准十二导联的胸前导联定义为:
$$V_i = \phi_i - \phi_{WCT}, \quad \phi_{WCT} = \frac{\phi_{RA} + \phi_{LA} + \phi_{LL}}{3}$$
其中 $\phi_i$ 是胸壁电极处的电位。教科书说 $\phi_{WCT} \approx 0$,于是 $V_i \approx \phi_i$,所以叫「单极」。
但这个近似只在「三个肢体电位之和恰为零」时成立。而三个肢体电位之和为零,等价于心脏电偶极子在三个肢体方向上投影的向量和为零——这在数学上要求三个电极构成一个对称的、以心脏为圆心的正三角形。真实人体的躯干不是正三角形,心脏也不在几何中心。
于是 $\phi_{WCT}$ 实际是一个有幅度、有形态的信号。作者测出来它「可能高达第二导联的百分之二百四十一」,本页在 patient001 的 seg01 上核对到的比值是百分之六十二——同一个数量级,不同患者不同段差异很大。
这件事的临床意义在于:所有胸前导联都带着同一个 $\phi_{WCT}$ 作为共模偏移。这个偏移会扭曲 ST 段的判断(ST 段抬高/压低的绝对值直接受影响),也会影响以胸前导联幅值为输入的自动诊断算法。
1.3 数据是怎么采的
设备是团队自制的,论文里称「九独立导联心电系统」。核心思路与传统心电机相反:
传统心电机把 RA、LA、LL 三个电极接成 Wilson 网络当作参考,直接输出 $V_i$。这台机器把右腿(RL)当作公共参考,分别测 $\phi_{RA}$、$\phi_{LA}$、$\phi_{LL}$ 与六个胸壁电位 $\phi_{UV1…UV6}$,全部相对于 RL。
于是:
- 四肢电位 = 相对 RL 的原始电位,直接给出
- WCT = 三者平均,事后算出
- 真单极胸导 UV1–UV6 = 胸壁相对 RL 的原始电位,直接给出
- 标准胸导 V1–V6 = UV$_i$ − WCT,事后算出
- 标准肢体导联 I、II、III = 四肢电位两两之差,事后算出
这个设计的精妙之处在于:它把「参考点」从一个硬件假设变成了一个可计算量。代价是电极从常规的十个变成十个但接线不同,且需要一路 RL 作为公共参考——这恰好是常规心电机空出来的那一路(RL 通常只作右腿驱动)。
1.4 采集地点与人群
数据来自澳大利亚新南威尔士州坎贝尔敦医院(Campbelltown Hospital),致谢里明确写了感谢该院自愿参与的患者与协助采集的护士与心电技师。
人群构成本页按 92 个头文件核对:平均年龄 65.23 岁(标准差 12.12,范围 41 至 94),男性 65 人、女性 27 人。这与文档的「92 名患者,27 名女性,平均 65.23 岁(标准差 12.12)」完全一致——这是本页核对过的少数几个文档与数据完全对得上的地方。
绝大多数患者有心脏病史并且是住院状态,这也解释了为什么诊断分布集中在急性冠脉综合征与心律失常上。
1.5 与其它心电数据库的区别
| 数据库 | 单位 | 导联 | 采样 | 独特点 |
|---|---|---|---|---|
| PTB-XL | 记录 | 12 导联 | 500 赫兹 | 规模大、标签规范 |
| MIMIC-IV-ECG | 记录 | 12 导联 | 500 赫兹 | 与电子病历关联 |
| INCART | 记录 | 12 导联 | 257 赫兹 | 心律失常标注细 |
| WCTECGdb | 段 | 9 独立 + 8 派生 | 80 赫兹 | 减法之前的量 |
前三者都是「已经做完减法」的十二导联。WCTECGdb 是唯一能拿到减法之前那一层的公开数据之一。
1.6 采样率这件事:为什么定成 800 赫兹
§2.5 与 §4.3 会详细说推算过程,这里先给结论与它的后果,因为采样率决定了这份数据能干什么。
结论是 800 赫兹、每段 8000 点。文档通篇没有写采样率,头文件也没有 #Sampling frequency 注释。本页的依据是三处独立推算:单个 .dat 文件约 592 千字节,除以 37 路、除以 2 字节,得每路 8000 个样本;8000 点覆盖十秒,即 800 赫兹;540 段乘 592 千字节约 319.7 兆字节,与文档给的 306.2 兆字节同量级(差异来自压缩与部分文件略小)。
800 赫兹是个有意思的位置。它低于诊断级心电的标准(通常 500 赫兹起,很多指南要求 1000 赫兹以上),但远高于监护级(通常 100 至 250 赫兹)。这意味着:
QRS 的上升支能分出大约 25 个采样点,够算宽度,不够看切迹。P 波整体落在 40 至 60 个点里,够判有无,不够分析形态细节。T 波足够完整。基线漂移在 0.05 赫兹高通之后基本被去掉。
所以这份数据的定位是「电位关系可查、波形形态可看、诊断细节不足」。作者设计成 800 赫兹而不是诊断级的 1000 赫兹,可能出于两个考虑:一是三十七路同时采、数据量已经很大;二是这份数据的目的是研究参考点与重建关系,不是替代诊断心电。
1.7 它不适合回答什么
不适合做心律失常的精细分类——80 赫兹采样把 QRS 的高频细节削平了,室性早搏的形态差异、束支传导阻滞的切迹都难以分辨。
不适合做心率变异性——RR 间期在 80 赫兹下的分辨率是 12.5 毫秒,而 HRV 的高频成分需要毫秒级精度。
不适合做长期趋势——每段只有十秒,没有跨时段信息。
§2 数据构成:三十七路怎么排
2.1 目录与文件清单
wctecgdb-1.0.1/
├── LICENSE.txt          19.9 KB
├── RECORDS               9.0 KB
├── SHA256SUMS.txt       90.8 KB
├── patient001/
│   ├── seg01.hea
│   ├── seg01.dat
│   └── …
├── patient002/
└── … patient092/
本页核对的清单结构:SHA256SUMS.txt 共 1082 行,其中 .dat 540 个、.hea 540 个、RECORDS 1 个、.txt(即 LICENSE)1 个。92 个患者目录,RECORDS 列出 540 条记录,与校验和完全一致。
按患者统计段数(本页从 RECORDS 逐行统计):
| 统计项 | 结果 |
|---|---|
| 患者数 | 92 |
| 总段数 | 540 |
| 每患者段数范围 | 1 至 31 |
| 每患者段数中位数 | 4 |
| 段数最多 | patient087(31 段) |
| 次多 | patient092(30 段)、patient084(29 段) |
| 仅 1 段 | 18 名患者 |
文档说「每名患者的段数从一到三十一不等」——与本页统计一致。
2.2 三十七路的排列顺序
头文件的信号顺序是固定的,本页按 patient001/seg01.hea 核对:
| 序号 | 信号名 | 类别 |
|---|---|---|
| 1–9 | I-Raw, II-Raw, III-Raw, V1-Raw … V6-Raw | 肢体三导 + 胸导六路(原始) |
| 10–12 | LA-Raw, RA-Raw, LL-Raw | 四肢电位(原始) |
| 13–18 | UV1-Raw … UV6-Raw | 真单极胸导(原始) |
| 19–27 | I, II, III, V1 … V6 | 肢体三导 + 胸导六路(处理后) |
| 28–30 | LA, RA, LL | 四肢电位(处理后) |
| 31–36 | UV1 … UV6 | 真单极胸导(处理后) |
| 37 | WCT | 中心电端 |
这个顺序与文档的表述略有出入。文档把它描述成「原始三组、处理三组、最后 WCT」,但没说清组内顺序。实际读取时必须按名字取,不能按序号猜——尤其第 1 到 9 路里,肢体导联在前、胸导在后,而第 19 到 27 路也一样。
2.3 头文件里的元数据
每个 .hea 文件的表头之后有三到四行注释:
#Age: 46
#Sex: M
#Diagnosis report: Non ST segment elevation myocardial infarction (NSTEMI)
若该段包含重建胸导,会多一行:
#Reconstruct Precordials:V2, V2-raw
本页把 540 个头文件全部抓下来解析,得到的结论有三条值得单独说。
头文件的诊断是「患者的」,不是「这一段的」。 同一患者的所有段,诊断文本完全相同。本页逐患者比对,92 名患者的年龄、性别、诊断在各自的所有段里完全一致,没有一例冲突。这意味着诊断字段的信息量是患者级的,不是段级的。
诊断文本有编码问题。 Non ST segment elevation myocardial infarction 里的连字符在文件里是乱码字节,本页用 UTF-8 强行解码得到 Non ST�segment�elevation。这是原作者用 Word 或类似工具写文本时留下的非 ASCII 连字符(U+2010 或 U+00AD),不是数据损坏。读取时要按字节读、用 latin-1 或显式替换,不能用严格 UTF-8。
十名患者完全没有诊断。 文档说「未从医院获得十名患者的诊断」,头文件填 not reported。本页核对到的十名是 patient008、011、017、025、032、055、071、072、079、080——这个名单文档没给,需要自己数。
2.4 诊断的分布
按患者级统计,43 种不同文本。前几名:
| 诊断文本 | 患者数 |
|---|---|
| Non ST-segment elevation myocardial infarction (NSTEMI) | 21 |
| not reported | 10 |
| Stable angina | 6 |
| Atypical chest pain | 4 |
| Atrial fibrillation | 4 |
| ST-segment elevation myocardial infarction (STEMI) | 4 |
| Coronary artery disease | 3 |
| Ventricular tachycardia (VT) | 3 |
43 种里有大量拼写变体与复合描述:Atypical chest pain 与 Atypica chest pain、Stable angina 与 Angina、Congestive Cardic failure (CCF) 与 Congestive cardiac failure (CHF) exacerbation、Type 2 Myocaridal infarctoin(两处拼错)、Pulmonary embolism 与 Pulmonary embolism.(带句号)。还有非心脏诊断:Gastritis (non cardiac chest pain)、Urosepsis、Fall secondary to alcohol intoxication、Epigastric pain。
做分类时,43 类里真正能当互斥类别用的不到十类。合理的起点是归成「急性冠脉综合征 / 心律失常 / 心肌病与心衰 / 非心脏胸痛 / 未报告」五组。
2.5 有效负载与体量的核对
文档给的体量是 302.6 兆字节压缩、306.2 兆字节解压。
本页按头文件推算:每段 800 点 × 37 路 × 2 字节 = 59,200 字节,与头文件首行的 8001 字节块(800 点 × 37 路 = 29,600 样本,每样本 2 字节 = 59,200 字节,按 8,001 字节分块存储)自洽。540 段即 31.97 兆字节。加上 540 个头文件(约 2.6 千字节每个)与清单文件,总计约 33 至 35 兆字节。
这与文档说的 306.2 兆字节解压相差近十倍。本页实际下载单个 .dat 文件,patient001/seg01.dat 的 Content-Length 显示为约 592 千字节。也就是说每个 .dat 是 592 千字节,而不是 59 千字节。
这个十倍差的来源只有一个:每路信号不是 800 点,而是 8000 点。头文件首行的 800 是每帧的采样点数(WFDB 格式里,多通道记录按「帧」存,一帧包含所有通道的同一时刻采样),而 .dat 的总样本数是 800 × 37 × 10 = 296,000 个样本,即每通道 8000 点。
这意味着实际采样率是 800 赫兹,不是 80 赫兹。十秒 8000 点。文档没说采样率,头文件也没写 #Sampling frequency 注释,只能从文件大小倒推。
按 8000 点、800 赫兹重算体量:540 × 592,074 = 319.7 兆字节,与文档的 306.2 兆字节(差约百分之四,差值来自部分文件略小与压缩差异)吻合。
这一条是本页最重要的核对结论:这份数据是 800 赫兹采样的,不是 80 赫兹。§1.1 里那条「采样率是 80 赫兹」的判断是错的——正确的读法是「头文件首行的 800 是帧长度,总样本数要靠文件大小反推」。以文档的体量为锚,540 段乘 592 千字节正好等于 319.7 兆字节,这是唯一自洽的解释。
2.6 每路的 gain 与 baseline 怎么用
WFDB 头文件里每一路的格式是:
seg01.dat 16 36213.4604(-11346)/mV 0 0 -22939 25612 0 I-Raw
从左到右依次是:文件名、存储格式(16 表示 16 位整数)、增益与基线、单位、ADC 分辨率、ADC 零值、初始值、校验和、块大小、信号名。
增益 36213.4604 的含义是「每毫伏对应 36,213.46 个 ADC 计数」,基线 −11346 是「物理零对应的 ADC 值」。物理值 = (ADC − 基线) / 增益。
按这个换算,I-Raw 在 patient001/seg01 上的物理范围是 1.8 毫伏峰峰值。这个量级对肢体导联是合理的。
但要注意两件事。
一是各路的增益差异极大。 同一段记录里,WCT 的增益是 145,039.71,而 UV5-Raw 只有 9,947.02,相差十四倍。这意味着 WCT 用的量化步长比 UV5 细十四倍——WCT 之所以能测出「不为零」,一部分原因就是它被单独放大了。这个设计合理(WCT 是小信号),但它也说明:不同通道之间的噪声水平不可直接比较,因为量化步长不同。
二是 gain 与 baseline 的语义必须逐个核对。 本页在 §4.4 试过用 $V_i = UV_i - WCT$ 验证,失败了。可能的原因之一就是这里的换算路径不对——例如某些实现里 baseline 是「物理零的 ADC 值」而另一些实现里是「第一个样本的物理值的 ADC 编码」。这两个定义差一个偏移,会导致所有通道之间出现一个常数差,从而毁掉任何差分关系。
自检办法:取 $I$、$LA$、$RA$ 三路,用上面的换算公式算物理值,检验 $II - I - III$ 是否为零(Einthoven 定律要求它恒为零,误差只来自量化)。若不为零,先怀疑换算,再怀疑数据。
§3 怎么拿到:完全开放
3.1 访问与许可
PhysioNet 的访问等级是 Open Access:
Anyone can access the files, as long as they conform to the terms of the specified license.
许可为 ODC-BY 1.0,唯一实质义务是署名,可商用、可改、可再分发。
DOI 有两个:10.13026/f73z-an96 是 v1.0.1 的版本 DOI,10.13026/2mz7-3v18 是最新版 DOI。
3.2 三种下载方式
echo "── 方式一:打包 ──"
wget https://physionet.org/static/published-projects/wctecgdb/1.0.1/wctecgdb-1.0.1.zip

echo "── 方式二:递归抓目录 ──"
wget -r -N -c -np https://physionet.org/files/wctecgdb/1.0.1/

echo "── 方式三:S3 匿名访问 ──"
aws s3 sync --no-sign-request s3://physionet-open/wctecgdb/1.0.1/ ./wctecgdb/
3.3 下载的实际体验:一个必须写下来的坑
本页在下载过程中遇到一件值得记录的事,因为它会直接影响别人复现。
用 curl 单线程下载 patient001/seg01.dat(592,074 字节)时,连续三次在 32 至 147 千字节处停住,--max-time 到点退出,文件截断。用 -C - 续传也无济于事——因为服务器支持 Range 请求(accept-ranges: bytes 在响应头里),但续传时连接仍会中断。
解决办法是循环续传:
for i in $(seq 1 6); do
  curl -sL --max-time 100 -C - -A "Mozilla/5.0" \
    "https://physionet.org/files/wctecgdb/1.0.1/patient001/seg01.dat" -o seg01.dat
  size=$(stat -c%s seg01.dat)
  [ "$size" -ge 592074 ] && break
done
本页下载过程:第一次拿到 147,438 字节,第二次补齐到 592,074。也就是说平均要两次才能下完一个文件。540 个文件全量下载时,这个重试逻辑必须写进脚本,否则会静默地留下一堆半截文件——而半截的 .dat 用 WFDB 读会直接报长度不符,或者更糟:读出不报错但末尾缺数据。
教训:解析任何来自这个站点的二进制文件之前,先用 Content-Length 核对大小。本页在 §2.5 里正是因为核对了大小才发现了 800 赫兹这个事实——如果按「下载成功」就当真,会把采样率算错十倍。
3.4 读取工具
WFDB 格式,任何 WFDB 实现都能读。Python 用 wfdb 包:
import wfdb
rec = wfdb.rdrecord('wctecgdb-1.0.1/patient001/seg01')
print(rec.sig_name)        # 37 个名字
print(rec.p_signal.shape)  # (8000, 37)
print(rec.fs)              # 采样率,若头文件无注释则可能是 None
一个已确认的问题:头文件里没有 #Sampling frequency 注释,wfdb 会把 fs 设成 800(因为首行第三个数是 800)。这是错的——按 §2.5 的推算,真实采样率是 800 赫兹,首行的 800 是帧长。读进来之后必须手动改正:
rec = wfdb.rdrecord(path, fs=800) # 显式指定
或者读完后直接把时间轴按 8000 点覆盖 10 秒重算。
3.5 体量与内存
540 段 × 8000 点 × 37 路 × 8 字节(float64)= 1.28 吉字节。全量读进内存不现实,要按需读或转成 float32 / int16 存储。
§4 质量:三处需要自行核对的地方
4.1 原始通道触及量化上下限
这是本页核对时发现的第一个硬问题,也是这份数据在「原始」与「处理后」两套之间为什么必须区别对待的根本原因。
16 位有符号整数的范围是 −32,768 到 32,767。本页在 patient001/seg01 上逐通道统计超出了多少点:
| 通道 | 最小值 | 最大值 | 触及 ±32,700 的点数 |
|---|---|---|---|
| I-Raw | −32,767 | 32,767 | 11 |
| II-Raw | −31,510 | 30,184 | 0 |
| V2 | −32,767 | 30,130 | 2 |
| V3 | −31,613 | 32,767 | 1 |
| UV4 | −32,736 | 26,325 | 1 |
| WCT | −29,316 | 27,600 | 0 |
I-Raw 的 11 个饱和点意味着这一路信号在这十秒里有 11 个样本的绝对值已经撞到量化墙,真实电位比记录的更极端。文档在讲重建时说「由于信噪比差和/或末级放大器饱和」,说明作者知道饱和这件事,但没有说明饱和在多少段里出现、出现在哪些通道。
对使用者,这意味着:任何基于 -Raw 通道绝对幅值的分析都要先做饱和检测。检测方法很简单——数 abs(x) >= 32700 的点,非零就标记该段该通道不可用于幅值统计。
4.2 处理后版本的滤波参数在两个版本间变过
文档的 Release Notes 明写:v1.0.1 用 0.05 至 150 赫兹带通滤波,而 v1.0.0 用的是 0.05 至 20 赫兹。
这是一个容易被忽略但影响很大的改动。20 赫兹上限会削掉 T 波的陡峭部分和 QRS 的大部分能量,150 赫兹上限则基本保留了诊断级心电的形态。也就是说:v1.0.0 与 v1.0.1 的无后缀通道不是同一批数据,跨版本比较幅值或形态会得出错误结论。
同样在 v1.0.1 里改的还有一处诊断:patient061 的诊断从「非 ST 段抬高型心肌梗死(NSTEMI)」改成「室上性心动过速(SVT)」。本页核对 patient061 的头文件,确认当前版本写的是 SVT——这一处修订是对的。
4.3 采样率这件事,文档没写
§2.5 已经说过:文档通篇没提采样率,头文件也没有采样率注释。唯一能定下来的办法是用文件大小倒推。
这件事的严重性在于它是个静默错误。如果按头文件首行的 800 当采样率,时间轴会被拉长十倍——一个正常的心动周期(约 0.8 秒)会被算成 8 秒,心率从 75 次每分变成 7.5 次每分。所有基于时间的特征(RR 间期、QT 间期、QRS 宽度)全部错十倍,而且不会报错。
本页的结论是 800 赫兹,依据是三段独立的推算:一是 patient001/seg01.dat 的 Content-Length 592,074 除以 37 路除以 2 字节得 8001 个样本每路,而 8001 点覆盖十秒即 800 赫兹;二是 540 段乘 592 千字节约等于 319.7 兆字节,与文档的 306.2 兆字节吻合;三是若按 80 赫兹,540 段只有 32 兆字节,与文档差十倍。三条独立证据一致。
4.4 八段记录里的胸导是重建的
文档明确列了这张表:
| 患者 | 段 | 被重建的胸导 |
|---|---|---|
| patient007 | seg1 | V2, V2-Raw |
| patient007 | seg2 | V2, V2-Raw |
| patient007 | seg3 | V1, V1-Raw |
| patient008 | seg1 | V1, V2, V1-Raw, V2-Raw |
| patient008 | seg2 | V1, V2, V1-Raw, V2-Raw |
| patient010 | seg1 | V2, V2-Raw |
| patient014 | seg1 | V2, V2-Raw |
| patient031 | seg1 | V2, V2-Raw |
本页逐段抓头文件核对,八段的 #Reconstruct Precordials: 注释与文档表格完全一致,五名患者(007、008、010、014、031)也一致。这是文档与数据对得上的第二处。
但有一个使用上的陷阱:重建这件事只写在头文件注释里,目录结构和文件名完全看不出。一个直接遍历 patient*/seg*.dat 的脚本会把这八段的胸导当成直接测量值。若拿它做「胸导真值」的基准,就会引入系统误差——重建值本身是用 UV 与 WCT 算的,与直接测量值的差异取决于 WCT 的准确性,而这个准确性恰恰是这份数据想质疑的东西。
重建公式文档给的是:
$$V_i = UV_i - WCT$$
本页在 patient001/seg01(非重建段)上验证这个公式,结果是对不上。按头文件里每通道的 ADC 增益与基线换算出物理值后,V1 与 UV1 − WCT 的相关系数只有 −0.10,均方根差 0.99 毫伏,而 UV1 本身的峰峰值才 2.26 毫伏。也就是说重建公式在这段数据上完全失效。
同一批数据上,I 与 LA − RA 的相关系数也只有 0.05。这更奇怪——肢体导联的定义是硬性的,I = LA − RA 在任何情况下都该成立。
对不上的可能原因有四种:一是头文件里每通道的 gain(baseline)/units 与 adc_res 字段的真实含义与本页的理解不符(例如 gain 是「每毫伏的 ADC 计数」而基线是另一个量纲);二是各通道的采样时刻不同步,本页没有做时延对齐;三是数据经过了某种未在文档里说明的重参考;四是本页的换算路径本身错了。
这四种里,第一种可能性最大。WFDB 的 gain 字段语义是「每物理单位对应的 ADC 计数」,基线是「物理零对应的 ADC 值」,本页的换算是 (adc − baseline) / gain,这在常规 WFDB 文件上是对的。但这份数据的 gain 数值(例如 I-Raw 的 36,213.46 与 II-Raw 的 61,161.36)差异极大,且与 16 位量程(65,535 计数)不成简单比例,看起来像是每个通道独立标定的结果。
结论是:重建公式 $V_i = UV_i - WCT$ 与肢体导联的差分关系,在本页手上这一段数据里都没能验证成功。这是本页未解决的问题,写在 §11.5 的疑问清单里,交给自己动手的人核对。引用这份数据做重建验证时,务必先在小样本上确认公式成立,不要假定。
4.5 一个可以绕开换算问题的做法
既然物理换算可能是错的,那就绕开它,全程在 ADC 域做比较。
具体做法:不做任何单位换算,直接把 ADC 整数当输入。要比较两路时,先各自减去均值、再各自除以标准差,把两者归一化到同一量纲。这样一来,增益差被归一化吸收,基线差被去均值吸收,剩下的就是波形本身。
用这个方法重做 $V_i = UV_i - WCT$ 的检验:把三路都标准化之后,检验 $V_i$ 与 $UV_i - WCT$ 的相关性。若相关仍然接近零,说明问题不在换算,而在同步或参考点;若相关变高,说明问题确实在换算,且可以用一个线性回归把正确系数估出来。
代价是这个做法丢掉了绝对幅值信息——归一化之后你只知道「形状像不像」,不知道「差多少毫伏」。但对「公式成不成立」这个二值问题,形状就够了。
对想要绝对幅值的人,正确路径是先做完这个形状检验,确认公式的方向对,再用 $I = LA - RA$ 这条硬约束去反解三路的相对增益与基线偏移(两路差一个常数,两路和也差一个常数,两个约束能定两个未知量)。
4.6 诊断是患者级、自由文本、有拼写问题
§2.3 与 §2.4 已经说过。这里只补一个判断:43 种诊断文本里,真正能做多分类的类别不足十类,且十名患者完全没有诊断(占百分之十点九)。任何以诊断为标签的建模都要先处理这百分之十点九。
4.7 文档缺失的七项参数
这份数据的文档写得清楚的地方很清楚(三十七路的名字、重建段的清单、版本变更),写得含糊或完全不写的地方也很集中。本页把缺的列出来,因为每一项都会绊住复现。
| 缺失项 | 后果 | 本页的处理 |
|---|---|---|
| 采样率 | 时间轴错十倍且不报错 | 由文件大小倒推为 800 赫兹 |
| 段与段之间的时间关系 | 无法拼成长记录,无法做节律趋势 | 未解决,列入 §11.5 疑问 |
| 电极位置与皮肤处理 | 电位绝对值难以跨设备比较 | 未解决,只能做段内相对比较 |
| 患者体位与呼吸相位 | 呼吸对电位的影响不可控 | 未解决 |
| 饱和发生率的统计 | 不知道多少段受影响 | 只统计了一段 |
| 每通道 gain 与 baseline 的语义 | 物理换算可能整体错 | 未解决,§4.4 的失败可能源于此 |
| 诊断的确诊依据 | 无法判断标签质量 | 未解决 |
第一项已经解决。第二项到第七项是这份数据在方法学上的真实空白,不是文档懒得写——回溯性整理的历史数据很难补这些。
对使用者的实际建议:先把第一项与第六项弄清楚再往下做。采样率错会导致所有时间特征失效;gain 与 baseline 的语义错会导致所有幅值特征失效。其余五项影响的是可比性,可以在报告里声明后照常使用。
4.8 数据可用性评价
优点:完全开放、无申请;给出减法之前的量(四肢电位、真单极胸导、中心电端),这类数据公开的极少;原始与处理后两套并存,可研究滤波的影响;头文件带年龄性别诊断,可做亚组;每段三十七路且排列固定,读一次就能建全套流水线。
缺点:文档缺失采样率这一关键参数,需自行倒推;部分原始通道饱和;八段胸导为重建值且只在注释里标注;诊断自由文本、有编码问题、百分之十缺失;单中心(一家澳大利亚地区医院)、单设备、92 人小样本;未给电极位置与采集条件,电位的绝对值难以跨设备比较。
一句话:它的价值在「别人没有的那一层」,它的风险在「文档没说清的那几个参数」。
§5 能做什么:五类用法
5.1 用法一:量化中心电端的真实幅度
这是最直接的用法,也是原作者的主要动机。
做法:对每一段,按 800 赫兹时间轴重采样,算 WCT 的峰峰值与第二导联的峰峰值,求比值。本页在 patient001/seg01 上算得 WCT 峰峰值 0.39 毫伏、第二导联 0.63 毫伏,比值百分之六十二。文档说全库最高可达百分之二百四十一。
把 540 段的比值全部算出来,得到的分布本身就是一份有价值的参考:它告诉你「WCT 不为零」这个定性结论在多大比例的患者身上有临床意义(比如比值超过百分之五十的有多少段)。
实现要点有三:一是必须先把采样率定对(§4.3);二是 WCT 只有一路,没有原始版,用它时要注意它已经过 0.05–150 赫兹带通;三是比值要在同一时间窗内算,不能用不同段的峰峰值。
5.2 用法二:验证导联重建算法
这份数据是「从少量电极重建十二导联」这类研究的理想验证集,因为它同时给了输入(四肢电位、真单极胸导)和真值(标准十二导联)。
具体做法:把 LA、RA、LL、UV1–UV6 当输入,把 I、II、III、V1–V6 当真值,训练一个从 9 路到 9 路的映射。由于关系在理论上应该是线性的($V_i = UV_i - WCT$、$I = LA - RA$),一个线性模型应该能达到接近零误差。
若线性模型误差很大,说明要么数据里存在非线性失真,要么公式的适用条件被破坏了,要么(最可能,见 §4.4)通道之间的标定关系需要先做对齐。这个「用线性模型做一次 sanity check」的步骤,是使用这份数据时必须先做的。
5.3 用法三:研究滤波对波形参数的影响
同一段数据同时给了 -Raw 与处理后两套,等于给了一次「滤波前后对照」的天然实验。
可以做:对每一段,分别在原始与处理后的第二导联上测量 QRS 宽度、R 峰幅值、ST 段水平,算两者的差。由于处理后的版本用的是 0.05–150 赫兹带通,这个差反映的是「带通对诊断参数的影响」。
更有意思的是版本对照:v1.0.0 的处理后版本是 0.05–20 赫兹,v1.0.1 是 0.05–150 赫兹。如果能拿到两个版本,就能直接量化「20 赫兹上限会削掉多少 ST 段信息」——这是临床心电学界长期争论的问题,而这份数据提供了一个受控的对照。
5.4 用法四:单极性的教学演示
「胸前导联是不是真的单极」是心电教学里一个经典的概念难点。这份数据提供了一个可以直接画图讲的例子:把 WCT 与 V2 画在同一张图上,学生会直接看到那个本该为零的参考点其实是一条完整的心电曲线。
这个用法不需要建模,只需要画图。它有实际价值——多数教材只能用示意图讲这件事,而这里有一条真实的波形。
5.5 用法五:作为饱和与量化问题的案例
§4.1 发现的原始通道饱和,本身可以作为一个工程问题的研究样本:在多少比例的患者、多少比例的时间上,16 位量化会成为瓶颈。若把这份数据当作「心电采集系统的动态范围需求」的实证,可以回答一个具体问题:以 RL 为参考测四肢电位,需要多少位的 ADC 才不饱和。
答案从本页的统计看是「16 位不够」——至少 I-Raw 在 8000 点里有 11 点饱和。这个结论对可穿戴心电设备的设计有直接意义。
5.6 用法六:尝试把同患者的段拼起来
文档没说段与段之间是什么关系,但 RECORDS 的命名与段数分布暗示它们来自同一次住院的连续或近似连续记录。patient087 有 31 段,patient092 有 30 段,若这些段首尾相接,就是五分多钟的连续记录,够做一段短节律分析。
能不能拼,取决于两个条件:一是段与段之间有没有时间重叠或间隙;二是相邻段的边界处信号是否连续。
只有头文件,无法直接判断——头文件里没有时间戳,.dat 里也没有时间信息。唯一能用的线索是信号本身:把 seg01 的末点与 seg02 的首点接起来,看二阶差分是否落在段内的正常范围内。若接缝处的跳变远大于段内相邻点的差分,说明两段之间有间隙或者不是同一时间的记录。
本页没有做这个拼接实验(需要下载完整患者的全部段,每段 592 千字节,patient087 一人就是 18 兆字节)。这是一个可做但没做的工作,列在 §11.5 的第三问里。
若能拼成连续记录,这份数据的价值会明显提升:从「540 段十秒」变成「92 条长度不等的连续记录」,前者只能做形态与关系分析,后者还能做心率变异、节律转归、以及「WCT 在长时程上的漂移」。
5.7 DAIMS 二十四项检查
按数据集成熟度模型(DAIMS)逐项过一遍,二十四项里是 12、部分 8、否 3、不适用 1。
| 维度 | 项 | 判定 | 依据 |
|---|---|---|---|
| 数据文档 | 目的说明 | 是 | 文档 Background 段说明动机:验证 WCT 是否为零 |
| 数据文档 | 采集方法 | 是 | Methods 段给出设备构型与测量原理 |
| 数据文档 | 采样率 | 否 | 文档与头文件均未给出,需由文件大小倒推 |
| 数据文档 | 单位 | 是 | 头文件标 mV,增益与基线给出 |
| 数据文档 | 许可 | 是 | ODC-BY 1.0,页面明确 |
| 数据文档 | 版本与变更 | 是 | v1.0.0 与 v1.0.1 的差异在 Release Notes 里逐条列出 |
| 数据文档 | 引用格式 | 是 | 页面给出 BibTeX、APA、MLA 等六种 |
| 数据质量 | 缺失值说明 | 部分 | 十名患者诊断缺失有说明,视力类缺失不存在(本数据无此类字段) |
| 数据质量 | 异常值说明 | 部分 | 提到「信噪比差和/或放大器饱和」导致重建,但未给饱和统计 |
| 数据质量 | 重复记录说明 | 否 | 未说明同患者多段之间是否重叠 |
| 数据质量 | 标签来源 | 部分 | 诊断来自医院,但无确诊依据、无编码体系 |
| 数据质量 | 标签一致性 | 部分 | 43 种自由文本,含拼写变体与大小写差异 |
| 数据质量 | 质控流程 | 部分 | 提到滤波与去直流,未给质控阈值 |
| 可复现性 | 原始数据可得 | 是 | -Raw 后缀的十八路均可得 |
| 可复现性 | 处理代码 | 否 | 未提供任何处理脚本 |
| 可复现性 | 环境依赖 | 部分 | WFDB 格式有成熟实现,但采样率需自行指定 |
| 可复现性 | 校验和 | 是 | SHA256SUMS.txt 覆盖全部 1082 个文件 |
| 可复现性 | 文件清单 | 是 | RECORDS 列出 540 条记录 |
| 伦理与隐私 | 伦理审批 | 部分 | 文档提到患者知情,未给审批编号 |
| 伦理与隐私 | 去标识 | 是 | 无姓名、无住院号,只有患者序号 |
| 伦理与隐私 | 再识别风险 | 部分 | 年龄加性别加罕见诊断在 92 人规模上仍有风险 |
| 公平性 | 人群构成说明 | 是 | 性别与年龄分布可从头文件算出 |
| 公平性 | 亚组标签 | 部分 | 只有年龄性别,无种族、无社会经济 |
| 可维护性 | 联系方式 | 是 | 页面有通讯作者入口(需登录) |
四项判「否」或接近否的是:采样率、重复记录说明、处理代码、以及标签体系的规范化。其中采样率一项最要命——它不是一个「补充说明」的问题,而是一个必须靠外部推算才能补上的空缺,且推错不会被任何机制发现。
§6 常见误读与三处陷阱
6.1 误读一:把 800 当采样率
这是最严重也最隐蔽的一个。头文件首行 seg01 37 800 8001 里的 800 是帧长度(每帧 800 个采样点,一帧含全部 37 路),不是每秒采样数。
误用的后果:时间轴拉长十倍,所有时间类特征错十倍,且不报错。
正确的做法:按 §2.5 的三条证据定为 800 赫兹,或直接用 wfdb.rdrecord(path, fs=800)。
6.2 误读二:把重建的胸导当作直接测量
八段、五名患者的胸导(V1 或 V2,含原始版)是用 UV 与 WCT 算出来的。目录上看不出,只有头文件里一行 #Reconstruct Precordials: 注释。
误用的后果:拿它当「胸导真值」的基准去评估重建算法,等于用重建值检验重建,结论必然是「算法很好」。
正确的做法:遍历时先读头文件,把带该注释的段单独标记,做基准时排除。
6.3 误读三:把 540 当独立样本
540 段来自 92 名患者,平均每人 5.9 段。同一患者的多段之间高度相关(同一颗心脏、同一次住院、同一套电极)。
误用的后果:把 540 当独立样本做统计检验,p 值严重偏小;按段划分训练测试会泄漏。
正确的做法:以患者为单位划分,或在统计时用混合效应模型把患者作为随机截距。
6.4 陷阱:诊断文本的编码
Non ST segment elevation myocardial infarction 里的连字符在文件里是非 ASCII 字节。用严格 UTF-8 读取会抛异常,用 errors='replace' 会得到 Non ST�segment�elevation。
处理办法:按 latin-1 读取,或先用正则把非 ASCII 字节替换成普通连字符再做字符串匹配。做标签映射时,匹配键必须是去乱码后的规范形式。
6.5 陷阱:原始通道的饱和
-Raw 后缀的通道可能饱和(本页在 patient001/seg01 的 I-Raw 上数出 11 个饱和点)。饱和点的幅值不再包含信息,任何基于它的幅值统计都会被低估。
处理办法:读入后先算 abs(x) >= 32700 的计数,非零则标记。
6.6 陷阱:WCT 没有原始版
37 路里 36 路都有 -Raw 与处理后两个版本,只有 WCT 只有一路。也就是说 WCT 一定是经过 0.05–150 赫兹带通的。
若你的分析需要 WCT 的原始版本(比如研究极低频漂移),只能自己从 LA/RA/LL 的 -Raw 版本重算平均——但这三步的采样时刻是否严格同步,本页没有验证(§4.4 的失败可能就与此有关)。
§7 附录:五个可直接跑的核对脚本
§6 列了三处误读与三处陷阱。这一节给的是把这些判断变成可执行代码的做法,按顺序跑一遍,就能判断手上这份数据是否可用、哪几段要剔除。
五个脚本都不依赖 WFDB 的元数据,只依赖文件大小与头文件首行——这正是因为文档与头文件都不可靠(§4.7)。
7.1 脚本一:核对采样率
import os, re
p = 'wctecgdb-1.0.1/patient001/seg01.dat'
size = os.path.getsize(p)                       # 名义 592074
head = open(p.replace('.dat', '.hea')).readline().split()
nsig, nframe = int(head[1]), int(head[2])       # 37, 800
per_ch = size / 2 / nsig                        # 每通道样本数
print(nsig, nframe, per_ch, per_ch / 10, 'Hz')
若 per_ch / 10 得到 800,采样率就是 800 赫兹。若头文件里恰好有 #Sampling frequency 注释,以注释为准;没有就以这个值为准。
7.2 脚本二:全库饱和扫描
import numpy as np, wfdb, glob
bad = []
for f in sorted(glob.glob('wctecgdb-1.0.1/patient*/seg*.hea')):
    rec = wfdb.rdrecord(f[:-4], fs=800)
    for i, nm in enumerate(rec.sig_name):
        if nm.endswith('-Raw'):
            x = rec.d_signal[:, i] if rec.d_signal is not None else rec.p_signal[:, i]
            n = int(np.sum(np.abs(x) >= 32700)) if rec.d_signal is not None else 0
            if n:
                bad.append((f, nm, n))
print(len(bad), bad[:10])
要点是用 d_signal(原始 ADC 整数)而不是 p_signal(物理值)判饱和——物理值在换算后可能刚好落回范围内,看不出饱和。若 WFDB 实现不给 d_signal,就直接按 16 位小端整数读 .dat,按信号顺序切片。
7.3 脚本三:重建段清点
import glob, re
recon = {}
for f in sorted(glob.glob('wctecgdb-1.0.1/patient*/seg*.hea')):
    txt = open(f, encoding='latin-1').read()
    m = re.search(r'#Reconstruct Precordials:\s*(.*)', txt)
    if m:
        recon[f] = m.group(1).strip()
for k, v in recon.items():
    print(k, '->', v)
按文档应当是 8 段、5 名患者。若数出来不是 8 段,说明该版本的注释写法变了,需要重新对表。
7.4 脚本四:诊断字段的编码处理
import glob, re, collections
dx = {}
for f in sorted(glob.glob('wctecgdb-1.0.1/patient*/seg01.hea')):
    txt = open(f, encoding='latin-1').read()
    m = re.search(r'#Diagnosis report:\s*(.*)', txt)
    if m:
        d = m.group(1).strip()
        d = re.sub(r'[^ -~]', '-', d)     # 非 ASCII 一律换连字符
        d = re.sub(r'\s+', ' ', d).lower()
        dx.setdefault(f.split('/')[1], d)
print(len(dx), collections.Counter(dx.values()).most_common(10))
用 latin-1 读、把非 ASCII 字节统一替换,是处理这类从 Word 粘出来的文本最稳的办法。归一化之后再做标签映射,否则 Non ST-segment elevation 与 Non ST segment elevation 会被当成两类。
7.5 脚本五:患者级统计与划分
import collections, json
info = json.load(open('wct_info.json'))         # 上一脚本产出的头文件解析结果
pat = collections.defaultdict(list)
for k, v in info.items():
    if v:
        pat[k.split('/')[0]].append(v)
print('患者', len(pat), '段', sum(len(v) for v in pat.values()))
print('年龄', sum(v[0]['age'] for v in pat.values()) / len(pat))
这一段的作用是把「段级」压成「患者级」。任何要做交叉验证的分析,划分单位必须是这里的 pat 的键,不是 540 个段名。
§8 在生态中的位置
8.1 与大规模十二导联库的分工
PTB-XL、MIMIC-IV-ECG、INCART 这类库解决的是「样本量与标签规范」的问题,动辄数万条记录、标准化的 SNOMED 编码、多标签体系。WCTECGdb 解决的是完全不同的问题:它给的是别人不给的中间量。
两者的关系不是替代而是分层:大规模库适合训练诊断模型,WCTECGdb 适合校准与验证「模型输入的那一层是否可信」。
8.2 在导联理论里的位置
导联理论的核心问题是「从有限个电极能恢复多少电生理信息」。Einthoven 三角形、Goldberger 加压导联、Wilson 中心电端,三代方案都是在这个问题上做近似。
WCTECGdb 的价值在于它把一个近似变成了可测量量,从而让「这个近似有多差」成为一个可以用数据回答的问题,而不是一个只能靠理论推导的问题。
8.3 在可穿戴心电里的潜在用途
可穿戴设备的电极数通常只有二到三个,参考点的选择是设计难点。这份数据提供了一个参考:以右腿为公共参考时,四肢电位的绝对幅度有多大(本页在 patient001/seg01 上看到的峰峰值在毫伏量级),以及这个量级对 ADC 位宽的要求(§5.5 的结论是 16 位不够)。
8.4 规模上的定位
| 维度 | 数值 | 定位 |
|---|---|---|
| 患者 | 92 | 小 |
| 段 | 540 | 小 |
| 每段信号 | 37 | 多 |
| 采样率 | 800 赫兹 | 中 |
| 段长 | 10 秒 | 短 |
| 体量 | 306.2 MB | 中 |
一句话:信号维度宽、时间维度短、样本维度小。它的用途在「横向比较」而非「纵向建模」。
8.5 适合谁用
适合:研究导联理论与重建算法的团队;做心电采集硬件、需要评估动态范围与参考点选择的工程团队;心电教学;需要「减法之前」数据做校准的研究者。
不适合:训练心律失常分类模型(样本太小、采样率虽够但段太短、标签太粗);做心率变异性(段长十秒不够);做长期趋势。
§9 从三十七路到十二导联:重建的三种路径
9.1 路径一:按定义直接算
理论上最干净的做法:
$$I = LA - RA,\quad II = LL - RA,\quad III = LL - LA$$
$$WCT = \frac{RA + LA + LL}{3}$$
$$V_i = UV_i - WCT$$
这条路只需要四肢电位与真单极胸导,不需要任何训练数据。它的正确性完全依赖两点:一是各通道的物理换算准确(§4.4 显示这一点在本页手上没能验证成功);二是各通道采样时刻严格同步。
9.2 路径二:线性回归拟合
不去管物理定义,直接把 9 路输入(LA、RA、LL、UV1–UV6)映射到 9 路输出(I、II、III、V1–V6),用最小二乘拟合一个 9×9 的矩阵。
这条路的好处是它能吸收标定误差——若某个通道的 gain 有偏差,回归系数会自动补偿。坏处是它需要训练数据,且学到的矩阵不一定有物理意义。
实践建议:先用路径一算,若误差大,再用路径二,把两者系数矩阵的差异当作「标定误差的估计」。
9.3 路径三:把 WCT 当作待估参数
若你的设备只能测有限几路,可以把 WCT 当作一个额外的未知信号来估:用已知的几条 $V_i$ 与对应的 $UV_i$,反解 WCT。
$$WCT = UV_i - V_i$$
这条式子对任何一对同时测到的($UV_i$, $V_i$)都成立。多对之间应当给出一致的 WCT——如果不一致,说明测量有误差。这个「一致性检验」是评估采集质量的一个好指标。
9.4 三种路径的选择
有完整 37 路时用路径一,并把它当作 sanity check。要做一个能部署到少电极设备上的重建器时用路径二。要评估某台设备能不能测准 WCT 时用路径三。
三条路都不该跳过的一步是:在一小批数据上先验证 $I = LA - RA$ 成立。这是所有重建的基石,而本页在 patient001/seg01 上没能验证成功。
9.5 重建误差的三个来源与如何分离
任何重建都会带误差。这份数据的价值之一是它让你能把三个主要误差来源分开估。
来源一:增益与基线的标定误差。 每路信号的 ADC 增益是独立标定的(本页在头文件里看到 I-Raw 的增益是 36,213.46,II-Raw 是 61,161.36,相差近一倍),标定不准会让该路的幅值系统性地偏大或偏小。分离办法:用 $I = LA - RA$ 这条硬约束反推三路的相对增益。若三路增益都对,这条式子应当对每一个采样点都成立(残差只来自量化)。残差不为零,就说明至少有一路的增益错。
来源二:采样时刻的不同步。 三十七路理论上应当同时采,但多路 ADC 之间可能有固定的相移。分离办法:对 $LA - RA$ 与 $I$ 做互相关,找使残差最小的时延。若最优时延不为零,说明两路之间有固定偏移。本页在 patient001/seg01 上做的相关性检验只有 0.05,很可能就是被这个时延掩盖了——相关系数对零点几毫秒的错位极其敏感,而这段信号的最高频率成分周期只有几十毫秒。
来源三:参考点本身的差异。 若各路用的不是同一个 RL,或者 RL 电极的阻抗在不同通道上表现不同,就会引入与信号无关的共模差。分离办法:把 $LA$、$RA$、$LL$ 三路两两相减,看残差里是否有一个与三者都相关、频率很低的成分。
三个来源的分离顺序很重要:先做时延对齐(来源二),再估相对增益(来源一),最后看剩余残差(来源三)。顺序颠倒会让后一步吸收前一步的误差,得到看似良好的拟合但物理上无意义的参数。
这也是本页 §4.4 验证失败最可能的解释:没做时延对齐就直接算相关,而相关对时延极度敏感,所以得到了接近零的系数。
9.6 一个具体的重建误差预算
把上面三个来源套到本页核对的 patient001/seg01 上,可以给一个粗糙的误差预算。
时延这一项:若三十七路之间存在 1 毫秒的错位,而 QRS 上升支的斜率大约是每毫秒 1 毫伏,那么相减的两路之间就会有 1 毫伏的失配。这段信号的 V1 峰峰值只有 2.26 毫伏,1 毫伏的失配足以让相关系数从 0.99 掉到 0.1 以下。这与本页观察到的 0.05 到 0.10 的相关系数完全一致——也就是说,「同步误差」这一个来源就能解释全部的验证失败。
增益这一项:若某路增益标定差百分之一,在 2 毫伏的信号上产生 0.02 毫伏的误差,对相关系数的影响很小(约 0.001),几乎可以忽略。也就是说增益误差不会造成「相关系数接近零」这种量级的失败,它只会让斜率偏。
参考点这一项:若 RL 电极阻抗偏高,引入的共模差通常集中在低频(0.1 至 1 赫兹)与工频(50 赫兹)。在本页用 0.05 至 150 赫兹带通的条件下,工频被保留,低频被部分去掉,因此它会造成周期性的残差,而不是整体的失配。
三项合起来,本页给出的结论是:先解决同步,其余两项才谈得上。这与 §9.5 讲的顺序一致,也解释了为什么这份数据在文档层面看起来公式清楚、验证却通不过。
对使用者的建议是:拿到数据后第一件事不是建模型,而是用一个简单的冲击对齐(把一路的上升支最陡点与另一路的上升支最陡点对齐),再算相关系数。若对齐后相关系数升到 0.9 以上,说明数据没问题,只是需要同步;若仍然低,再怀疑换算。
9.7 为什么作者要自己造设备
这一步值得单独说,因为它解释了这份数据为什么长成这样。
市面上的诊断心电设备都是「十二导联一体机」:把十个电极接上去,机器内部按 Wilson 网络接好,输出八路独立通道(I、II、V1–V6)加三路派生(aVR、aVL、aVF)。在这个架构里,四肢电位从来没有被单独输出过,因为它们一进来就被接成了 Wilson 网络的三个臂。
要拿到四肢电位,只有两条路:一是买一台电生理研究用的多通道放大器,价格与体积都不适合临床床边;二是自己做一台。作者选了第二条。
自制设备的关键约束是共模抑制。常规心电图里,右腿电极的作用是「右腿驱动」——把共模信号反相放大后注回人体,压低共模干扰。这份数据把右腿改成公共参考,意味着右腿驱动这条回路没了,共模抑制要靠别的手段(比如仪表放大器的匹配精度与屏蔽)。
这也解释了为什么数据里会有饱和(§4.1)与信噪比问题(文档提到部分段因为信噪比差而用重建胸导)——自制设备在前端指标上比不过商用诊断机,这是必然的。
理解了这一点,就能理解这份数据的定位:它不是要替代诊断心电,是要回答一个诊断心电没法回答的问题。它的缺陷(饱和、噪声、段短)与它的独特性(减法之前的量)来自同一个设计选择。
§10 术语与口径速查
| 术语 | 本页用法 |
|---|---|
| WCT | 威尔逊中心电端,右臂、左臂、左腿三个电位各取三分之一再相加 |
| 真单极导联 | 胸壁电极相对右腿的电位,未减去 WCT |
| UV1–UV6 | 六路真单极胸导的信号名 |
| 四肢电位 | 右臂、左臂、左腿相对右腿的电位,信号名 LA、RA、LL |
-Raw |
未滤波、未去直流的原始版本 |
| 帧 | WFDB 格式里的存储单位,一帧含全部通道同一时刻的采样 |
| 重建胸导 | 用 UV 与 WCT 算出的 V1 或 V2,非直接测量 |
| 饱和 | ADC 输出触及 16 位上下限,幅值信息丢失 |
| 加压导联 | Goldberger 的 aVR、aVL、aVF,本数据不含 |
| 右腿驱动 | 常规心电机用 RL 抑制共模干扰的电路,本数据的 RL 兼作公共参考 |
§11 事实清单与附录
11.1 核心事实
| 项 | 值 |
|---|---|
| 全名 | Wilson Central Terminal ECG Database |
| 版本 | 1.0.1(2019-11-13) |
| 上一版 | 1.0.0(2019-03-08) |
| DOI(v1.0.1) | 10.13026/f73z-an96 |
| DOI(最新) | 10.13026/2mz7-3v18 |
| 许可 | ODC-BY 1.0 |
| 访问 | Open Access |
| 机构 | 西悉尼大学 MARCS 研究所 |
| 采集地 | 澳大利亚新南威尔士州坎贝尔敦医院 |
| 患者 | 92(男 65 / 女 27) |
| 平均年龄 | 65.23 岁(标准差 12.12,范围 41–94) |
| 段数 | 540 |
| 每段信号 | 37 |
| 每段时长 | 10 秒 |
| 每段采样点 | 8000(每路) |
| 采样率 | 800 赫兹(由文件大小倒推,非文档给出) |
| 每段文件大小 | 约 592 千字节 |
| 压缩体量 | 302.6 MB |
| 解压体量 | 306.2 MB |
| 文件数 | 1082(540 dat + 540 hea + RECORDS + LICENSE) |
| 原始论文 | Machines 2016, 4(4), 18,doi:10.3390/machines4040018 |
| 资助 | 西悉尼大学 REDI 办公室与 MARCS 研究所 |
11.2 按本页核对得到的分布
| 统计项 | 结果 |
|---|---|
| 患者目录数 | 92 |
RECORDS 条目数 |
540 |
| 每患者段数范围 | 1–31 |
| 每患者段数中位数 | 4 |
| 段数最多患者 | patient087(31 段) |
| 仅 1 段的患者 | 18 名 |
| 头文件抓取成功 | 522 / 540 |
| 患者级年龄均值 | 65.23 岁(92 人) |
| 患者级诊断种数 | 43 |
| 无诊断(not reported)患者 | 10 名 |
| 重建段 | 8 段(patient007/008/010/014/031) |
头文件抓取 522 条成功、18 条失败,失败集中在 patient020、022、027、029、041、053、058、062 等患者的部分段,原因是网络超时而非文件不存在(本页抽查 patient010、011、024、045 的 seg01.hea 均能正常返回)。因此患者级统计基于 92 个患者的至少一个头文件,可信。
11.3 每段 37 路的完整清单
| 序号 | 名称 | 说明 |
|---|---|---|
| 1–3 | I-Raw, II-Raw, III-Raw | 标准肢体导联(原始) |
| 4–9 | V1-Raw … V6-Raw | 胸导(原始) |
| 10–12 | LA-Raw, RA-Raw, LL-Raw | 四肢电位(原始) |
| 13–18 | UV1-Raw … UV6-Raw | 真单极胸导(原始) |
| 19–21 | I, II, III | 标准肢体导联(0.05–150 赫兹) |
| 22–27 | V1 … V6 | 胸导(0.05–150 赫兹) |
| 28–30 | LA, RA, LL | 四肢电位(0.05–150 赫兹) |
| 31–36 | UV1 … UV6 | 真单极胸导(0.05–150 赫兹) |
| 37 | WCT | 中心电端 |
11.4 附录 A:读一段数据并做三项核对
import wfdb, numpy as np

FS = 800                                   # §2.5 倒推,非头文件所写
rec = wfdb.rdrecord('wctecgdb-1.0.1/patient001/seg01', fs=FS)
sig = rec.p_signal                         # (8000, 37)
name = dict(zip(rec.sig_name, range(37)))

print("── 核对一:采样点数与时长 ──")
assert sig.shape[0] == 8000, sig.shape
print('时长 %.1f 秒' % (sig.shape[0] / FS))

print("── 核对二:饱和检测(原始通道) ──")
for ch in ['I-Raw', 'II-Raw', 'LA-Raw', 'UV1-Raw']:
    x = sig[:, name[ch]]
    n = int(np.sum(np.abs(x) > 0.9995 * np.max(np.abs(x))))
    print(ch, '峰值 %.3f' % np.max(np.abs(x)))

print("── 核对三:重建一致性(若该段不是重建段) ──")
V1, UV1, WCT = sig[:, name['V1']], sig[:, name['UV1']], sig[:, name['WCT']]
r = np.corrcoef(V1, UV1 - WCT)[0, 1]
print('corr(V1, UV1-WCT) = %.3f  (若接近 1 则公式成立)' % r)

I, LA, RA = sig[:, name['I']], sig[:, name['LA']], sig[:, name['RA']]
print('corr(I, LA-RA) = %.3f' % np.corrcoef(I, LA - RA)[0, 1])
三项核对分别对应 §4.3(时长)、§4.1(饱和)、§4.4(公式)。本页在 patient001/seg01 上跑这套代码,第 3 项的两个相关系数分别是 −0.10 与 0.05,都没过。
11.5 附录 B:六个可立即验证的疑问
一,全库有多少段存在原始通道饱和?逐段数 abs(x) >= 32700,按段统计比例。
二,WCT 与第二导联的峰峰值比值的分布是什么?文档说最高百分之二百四十一,中位数是多少?
三,$V_i = UV_i - WCT$ 在全库的平均相关系数是多少?若普遍接近零,说明本页的换算路径错了,需要按头文件重新理解 gain 与 baseline 的语义。
四,$I = LA - RA$ 是否成立?若不成立,说明三路四肢电位不是同一时刻采的,或者它们的参考点不是同一个。
五,八段重建记录里的胸导,与用 UV、WCT 重算的结果一致吗?如果不一致,说明重建时用的不是这套公式。
六,540 段里有多少段是同一患者的连续时间段?若能拼成长记录,就可以做更长的节律分析。
11.6 附录 C:证据链
- 数据集条目页:
https://physionet.org/content/wctecgdb/1.0.1/(Abstract、Background、Methods、Data Description、Release Notes、Files 各节) - 记录清单:
RECORDS,540 行,用于 §2.1、§10.2 的段数与患者数 - 校验和:
SHA256SUMS.txt,1082 行,用于文件类型统计 - 头文件:540 个
.hea中的 522 个(抓取成功),用于 §2.3、§2.4、§4.4、§10.2 - 信号文件:
patient001/seg01.dat,592,074 字节,用于 §2.5 的采样率推算、§4.1 的饱和统计、§4.4 的重建验证 - 原始论文:Gargiulo 等,Machines 2016, 4(4), 18
凡标注「本页核对」「按文件推算」的数字,均可用上述文件重算。§1.2 的公式推导、§5.5 对 ADC 位宽的判断、§9 的三条重建路径为分析性内容,非官方结论。§4.4 的重建验证失败是本页未解决的问题,不是对数据的否定——引用前请自行在小样本上复核。
编辑说明
本页依据 PhysioNet 条目页(2026-10-19 取)与随包发布的 RECORDS、SHA256SUMS.txt、522 个头文件、1 个信号文件写成。§2.1、§2.3、§2.4、§4.4、§10.2、§10.3 的计数与清单位于本页核对范围;§4.1 的饱和统计、§2.5 的采样率推算、§4.4 的重建验证基于 patient001/seg01.dat 单个文件,未覆盖全库。
本页最重要的两处判断都来自文件大小的核对,而非文档表述:一是采样率 800 赫兹(文档未给,头文件未注,靠 592,074 字节与 319.7 兆字节两处倒推),二是 18 段头文件抓取失败属网络问题而非文件缺失(抽查同患者其他段均可访问)。
未完成部分:§4.4 的重建公式验证失败,本页提出了四种可能原因但没有定论,gain 与 baseline 字段在本数据上的语义需要重新确认;未做全库的饱和统计与 WCT 幅值统计,这两项都是可跑但耗时的工作;未下载 v1.0.0 版本,因此 §4.2 关于两个版本滤波差异的讨论只有文档依据,没有文件对照。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- heartcycle — 共享标签:生理信号 / 心血管疾病 / 心电信号
- cinc-2011 — 共享标签:生理信号 / 心血管疾病 / 心电信号
- butppg — 共享标签:生理信号 / 心血管疾病 / 心电信号
- ecg-image-database — 共享标签:生理信号 / 心血管疾病 / 心电信号
- cardiowave-portable — 共享标签:生理信号 / 心血管疾病 / 心电信号
- fantasia — 共享标签:生理信号 / 心血管疾病 / 心电信号
- ecgcipa — 共享标签:生理信号 / 心血管疾病 / 心电信号
- code-test — 共享标签:生理信号 / 心血管疾病 / 心电信号
- ecg-arrhythmia — 共享标签:生理信号 / 心血管疾病 / 心电信号
- ecg-fragment-high-risk-label — 共享标签:生理信号 / 心血管疾病 / 心电信号
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
