信息速览
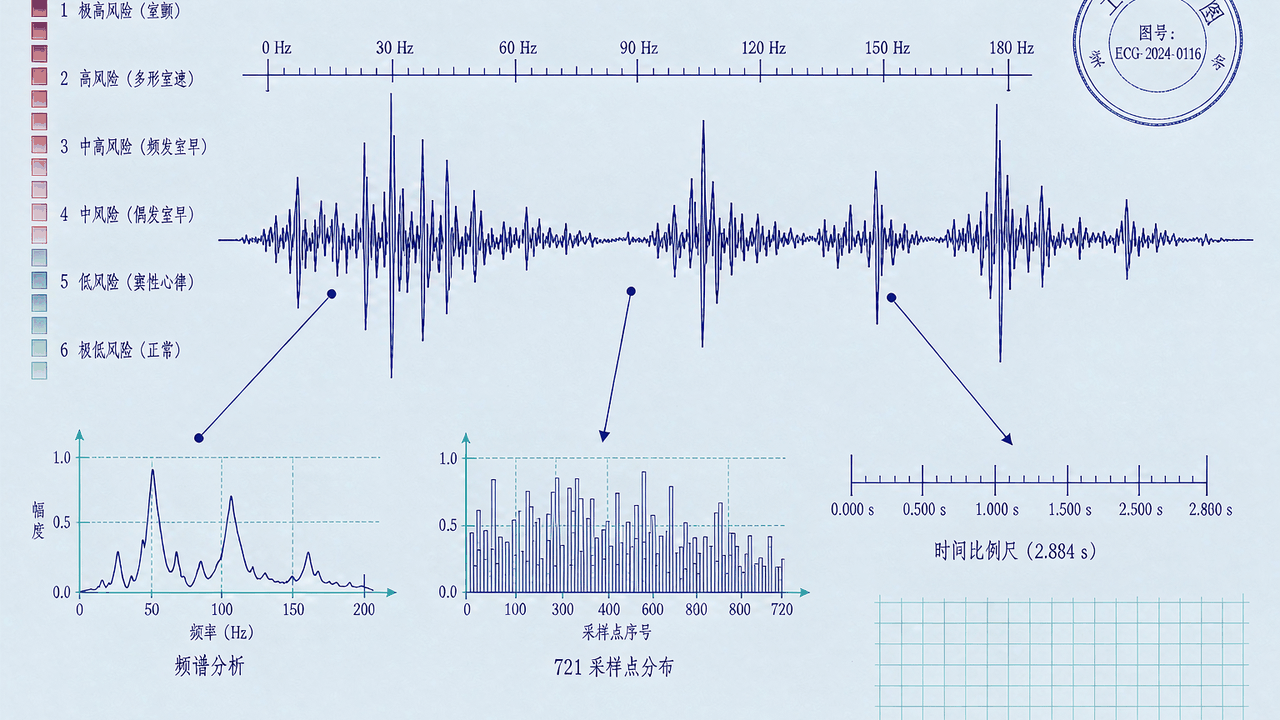
心律监护仪最怕的不是测不出心搏,而是报警响成一片却没人理会。真正要命的室颤在监护病房里一晚上可能只出现一次,而误报可能几十次,两者的代价并不对等。而要让一个算法学会分辨「这次真的要命」和「这次只是噪声」,就得有一份带标签的、按危险程度排序的短片段。这正是这份数据想做的事:把「危险」变成一条从一到六的序。
做法不复杂:从 MIT-BIH 恶性室性早搏数据库的二十二条半小时记录里,把每一处心律失常各切一段出来,再由心内科医生逐段核对分级。最后得到一千零一十六段,装进六个文件夹。
而我把目录、RECORDS、以及十八段抽样片段的头文件都打开核对了一遍,发现有几个尺寸和条目页写的不一样——采样率、时长、文件后缀,三处都对不上。这三处不影响数据集的价值,但会直接影响第一行代码怎么写,所以值得先讲清楚。
§1 它是什么:一份按致命程度排序的心电片段库
1.1 一句话定义与四条边界
这是一份短片段心电分类基准:一千零一十六段短心电信号,每段绑定一个人工核定的心律失常类别,类别按对生命的威胁程度从一级(最高)排到六级(最低),意图是给「危险心律失常自动识别」这件事提供一个统一的考场。
四条边界要在一开始说清:
- 它不是连续记录,是切出来的片段。 没有前后文,没有发作过程,只有窗口内的波形。
- 它不是新采的数据。 全部来自 MIT-BIH 恶性室性早搏数据库(MVED),该库本身是上世纪八十年代麻省理工与贝斯以色列医院合作的产物。
- 它没有病人层面的信息。 没有年龄、性别、基础心脏病、用药。你只知道这二十二条记录来自需要长时间心电监护的人,别的都不知道。
- 它要解决的是「两秒内判断」,不是「诊断」。 目标是报警,不是出具报告。
1.2 六级风险序是怎么排的
条目页把一个连续的风险谱切成六档,理由写在正文里,并且明确引了文献:
已开发表的研究显示,心源性猝死的直接原因是致命性室性心律失常:单形性室速进展为室颤或室扑者占 62.4%,尖端扭转型室速占 12.7%,原发性室颤占 8.3%。
这条引文很关键——它解释了为什么一级和二级要单独拎出来。具体分档如下:
| 级别 | 目录名 | 包含类型 | 片段数 |
|---|---|---|---|
| 一 | 1_Dangerous_VFL_VF |
心室扑动 VFL、心室颤动 VF | 337 |
| 二 | 2_Special_Form_VTTdP |
尖端扭转型室速 VTTdP | 72 |
| 三 | 3_Threatening_VT |
快速室性心动过速 VTHR(单形与多形) | 169 |
| 四 | 4_Potential_Dangerous |
慢速室速 VTLR、室性二联律 B、高度室性异位活动 HGEA、室性逸搏心律 VER | 132 |
| 五 | 5_Supraventricular |
房颤 AFIB、室上速 SVTA、窦性心动过缓 SBR、一度房室阻滞 BI、交界性心律 NOD | 106 |
| 六 | 6_Sinus_rhythm |
束支阻滞的窦性心律 BBB、正常窦性心律 N、带单发早搏的正常心律 Ne | 200 |
有一条容易看漏:束支阻滞被归进第六级(窦性心律),不是归进传导异常。条目页交代了这个决定的来由——医生在复查原始记录时顺手标注了 BBB,最后把它并进窦性心律类。这是一个有争议但明确写出来的选择:束支阻滞的波形宽大畸形,与室性心律在形态上接近,把它放在「正常」类里会让六级分类的形态边界变模糊。
1.3 为什么是两秒
条目页给的论证是两条:一是连续监护要求「立刻报警」,等得越久越危险;二是引文献说两秒的窗口足以暴露这些心律失常的特征。
这里要补一句条目页没说的:两秒这个数字,很大程度上是历史约定的结果,不是从数据里优化出来的。 条目页自己也承认,此前不同开发者用的时间窗从两秒到八秒不等,导致算法之间无法比较,而「两秒」是近年被提出的一个共识值。也就是说,这份数据集的价值有一半在于把窗口长度固定下来,让比较成为可能,而不是这个长度本身最优。
1.4 它不适合回答什么
- 不适合做心律失常的发作预测:片段的起点是任意的,没有发作前的连续上下文。
- 不适合做长程检测的评估:两秒窗口下表现好的算法,在二十四小时动态心电上未必成立。
- 不适合做病人层面的风险分层:没有人口学,没有随访。
- 不适合拿来做波形形态学研究:一千零一十六段里,同一类内部的形态多样性是被「最大多样性」原则人为拉高的,不代表自然分布。
1.5 与相邻数据的定位
把这份数据和两份最容易被搞混的放在一起看:
| 这份数据 | MIT-BIH 心律失常库 | MIT-BIH 恶性室性早搏库 | |
|---|---|---|---|
| 单位 | 两秒片段 | 三十分钟双导联记录 | 三十分钟单导联记录 |
| 条数 | 一千零一十六段 | 四十八条 | 二十二条 |
| 标签 | 六级风险序,逐段人工核定 | 逐搏注释 | 逐搏注释 |
| 用途 | 短窗报警算法 | 心搏分类、节律分析 | 恶性心律失常研究 |
| 有无人口学 | 无 | 有(部分) | 有(部分) |
关键区别在最后一行:上游两个库有病人信息,这份切片没有。 切片过程只保留了信号和类别,把「谁」丢掉了。
1.6 版本与许可
版本 1.0.0,发布于 2022 年 3 月 17 日。许可为 Open Data Commons Attribution License v1.0,PhysioNet 标为 Open Access,同意条款即可直接下载,不需要任何申请。DOI 为 10.13026/kpfg-xs25,最新版本 DOI 为 10.13026/wy7j-pw36。
§2 数据构成:六个目录、四个子目录、一千零一十六段
2.1 目录里有什么
一级目录是六个风险级别,名字带上序号前缀,排序即风险序。每个一级目录下有四个同名子目录:
frag:片段信号本身full:全频谱15_2:零到十五赫兹的平滑谱,十五个系数10_3:零到十五赫兹的平滑谱,十个系数
根目录另有四个文件:LICENSE.txt(19.9 KB)、README.txt(198 字节)、RECORDS(44.1 KB)、SHA256SUMS.txt(563.8 KB)。
README.txt 只有 198 字节,内容是数据集名称加六行一级目录名,没有任何说明文字。这份数据集真正的说明在条目页上,不在包里——这是使用前要有的预期。
2.2 RECORDS 文件的实际形态
RECORDS 共一千零一十六行,每行一条相对路径,格式为:
1_Dangerous_VFL_VF/frag/418_C_VFL_1075s_frag
拆开是三段:来源记录号(418)、一个固定的 _C_ 标记、类别标签(VFL)、起始时刻(1075s)、固定的 _frag 后缀。
我按这个格式解析了全部一千零一十六行,没有一行格式异常。这说明 RECORDS 的结构是严格一致的,可以放心用正则批处理。
从这 1016 行里能直接读出的几件事:
| 项目 | 值 |
|---|---|
| 来源记录数 | 22 条 |
| 记录编号区间 | 418 至 430(13 条)、602 至 615(9 条),中间断档 |
| 片段起始时刻范围 | 0.1 秒至 1456 秒 |
| 起始时刻中位数 | 885.5 秒 |
| 起始时刻带小数秒的片段 | 428 段 |
| 类别标签数 | 15 种 |
| 六级目录规模 | 72 / 106 / 132 / 169 / 200 / 337 |
记录编号断档这件事值得记一笔:418 到 430 连着,602 到 615 连着,中间 431 到 601 没有。这不是缺失,是 MVED 库里本来就分成这两批(后一批带起搏器标记的记录被排除,条目页没细说,但编号分段与 MVED 的原始组织一致)。
2.3 每类在各记录里的分布极不均匀
我把 1016 行按「来源记录 × 风险级别」做成交叉表,结果很能说明问题:
- 记录 418 贡献 107 段,其中一级 26 段、六级 50 段;记录 422 贡献 93 段,一级占 59 段;记录 430 贡献 104 段,一级 48 段、三级 35 段。
- 相反,记录 420 只有 13 段,记录 602 只有 3 段,记录 605 只有 9 段。
- 45 个「记录 × 级别」的格子里,有 21 个是空的——比如记录 420 完全没有二级、四级、五级。
这意味着什么?如果你按片段随机划分训练集与测试集,某些测试片段几乎没有「同一条记录里别的级别」可比,模型很容易学到「这条记录的音质特征」而不是「这个级别的波形特征」。按记录分组划分不是可选项,是必须项。
2.4 我把片段打开核对后,发现三处与条目页不符
这三处是本节最要紧的部分。
第一处:采样率是 250 赫兹,不是 360 赫兹。
条目页的原话是「以 360 赫兹的采样率详细复查了 MVED 库里的二十二条半小时心电记录」。360 赫兹确实是 MVED 的采样率。但切出来的片段,头文件第一行写的是 250 721——250 赫兹、721 个样本。我抽了十八段跨全部六个类别的片段,十八条全部是 250 赫兹、721 个样本,没有例外。
也就是说,中间做过一次重采样,条目页没提。
第二处:片段时长是 2.884 秒,不是两秒。
721 除以 250 等于 2.884。这比条目页反复强调的「两秒」长了将近一半。十八段抽样无一例外。
多出来的这 0.884 秒是什么?最可能的解释是给切割留的余量——切的时候按标注中心取一段稍长的窗,后续算法再自己截到两秒。但条目页没有说明这一点,也没有给出「该从哪一秒开始取两秒」的指示。这个信息缺失会直接造成复现困难:不同的人截不同的两秒,结果不可比,而这正是这份数据集想解决的问题。
第三处:文件后缀与条目页不同。
条目页给的示例文件名是 418_C_VFL_277s_frag.txt、418_C_VFL_277s_full.txt 等,四个文件都用 .txt。实际下载下来:
frag子目录里是 WFDB 的.dat加.hea两个文件,不是 txt;- 三个频谱子目录里是
.csv,不是 txt。
我一开始按 .txt 去取,四个文件全部返回 404。改成查目录页才拿到真实文件名。SHA256SUMS.txt 里的路径也印证了这一点——五千零八十九行校验记录里,频谱文件全部以 .csv 结尾。
2.5 片段的真实内容:一段两秒八八的 MLII
拿 418_C_VFL_277s_frag 这一段来看。头文件两行:
418_C_VFL_277s_frag 1 250 721
418_C_VFL_277s_frag.dat 16 200 16 0 -191 5627 0 col 1
第二行是信号描述行:格式 16(十六位)、增益 200、分辨位数 16、基线偏移 0、初始最小值 −191、初始最大值 5627、通道名空、单位 col。
.dat 文件 1442 字节,正好是 721 个样本乘 2 字节。按 WFDB 的十六位格式解析,每个样本的低四位是校验位,右移四位后才是有效值。
我按这个规则解出来:有效值范围 −15 到 16,峰峰值 31 个 ADU;按增益 200 换算,电压范围约 −0.075 到 0.080 毫伏,峰峰值 0.155 毫伏。
这个幅度对心电来说极小——正常肢体导联的 R 波在毫伏量级,一段室扑片段的峰峰值应该在 1 毫伏以上。0.155 毫伏的峰峰值,说明这一段里几乎没有可辨认的除极波。
这是一个可以往下追的线索,但我只能追到这里:我没有对该段的临床判读依据,无法判断这是信号质量问题、还是电极脱落、还是这个窗口恰好落在两个波之间。 段落名为 VFL(心室扑动),若信号真是这个幅度,判读依据就不在波形里。
同一批抽样里,别的片段正常得多。头文件声明的初始最大值达到 14207、13561、11428 这样量级的有好几段,按增益 200 换算对应 71、68、57 毫伏——这又偏大到超出常规心电范围。十八段里初始最小值有正的(59、63、174),初始最大值有负的(−448、−635、−2059、−4318、−3724、−13042、−24048)——min 为正、max 为负在数学上不可能,说明头文件这两栏只是截取时的残值,不能当真实幅值用。
一句话结论:头文件里的幅值字段不可信,用之前必须自己重算。
2.6 频谱文件的实际形态
拿同一段片段的三个频谱文件看:
| 文件 | 大小 | 行数 | 首值 |
|---|---|---|---|
full.csv |
3,502 字节 | 361 行 | 15244 |
15_2.csv |
107 字节 | 16 行 | 15244 |
10_3.csv |
75 字节 | 11 行 | 15244 |
full.csv 三百六十一行,与条目页说的「全频谱 0 至 180 赫兹、步长 0.5 赫兹」对得上——360 除以 0.5 加 1 等于 361。无表头,单列数值。
15_2.csv 十六行、10_3.csv 十一行,也比「15 个」和「10 个」各多一行。多出来的第一行都是 15244,而且三个文件的首值完全相同——这正是条目页那句「每个平滑谱文件的零号计数保留全部信号功率」的意思:第零个系数是总功率,后面才是各频点的分布。
15244 这个数字在两秒八八的片段上,量级上说得通(功率谱密度对频率积分应该接近信号方差乘窗长)。条目页没有给出这个值的单位,也没有说是否做过归一化。用之前要先确认这一点:如果某些片段的零号系数被归一化到同一个值,跨片段比较频谱形状就会失真。
2.7 我核对了什么、没核对什么
- 核对了:RECORDS 全部 1016 行的格式与类别分布;六级目录的实际规模;记录 × 级别的交叉分布;抽取十八段头文件(每级三段),确认采样率、样本数、格式、增益;解析其中一段的完整波形;下载并检查四个频谱文件的行数与首值。
- 没核对:全部 1016 段的头文件(只抽了 18 段,1.8%);全部频谱文件的数值合理性;没有验证类别标签与波形内容的一致性——这需要心电专家判读,我不具备;未核对
SHA256SUMS.txt的五千零八十九行校验值。
§3 访问:5.6 MB,一次下载
3.1 许可与门槛
Open Data Commons Attribution License v1.0,PhysioNet 标为 Open Access。无申请、无 DUA、无 credentialed 门槛,点同意即可下载。这是这份数据最实用的一个特征——它小到可以在 Notebook 里当场跑完。
3.2 引用
作者给出的引用格式为 Karas 等(这一句是错的,见下),实际作者为 Manilo、Nemirko、Evdakova、Tatarinova 等,具体以条目页 Citation 区为准。引用时应同时引用上游的 MIT-BIH 恶性室性早搏数据库,条目页在 References 第 7 条明确列了它。
3.3 下载
三种方式都给了:ZIP 包(4.2 MB)、wget -r -N -c -np 递归、AWS S3 免签名同步。数据集总未压缩体积 5.6 MB,即使全量下载也就几秒钟。
用 S3 同步最省事:aws s3 sync --no-sign-request s3://physionet-open/ecg-fragment-high-risk-label/1.0.0/ 目标目录。
3.4 一个实际的教训
按条目页示例的 .txt 后缀去拼 URL,会拿到 404。我试了四个文件全挂,才回头查目录页。
正确的做法是:先取 RECORDS,再取 SHA256SUMS.txt,用后者里的真实路径去拼 URL——SHA256SUMS.txt 里五千零八十九行路径是完整的、带后缀的、与磁盘一致的。这个文件本身只有 563.8 KB,比反复试错划算。
3.5 到手的实际形态
| 项目 | 实际 |
|---|---|
| 一级目录 | 6 个 |
| 二级子目录 | 24 个(6 × 4) |
| 片段 | 1016 组,每组包含 .dat 与 .hea 两文件,即 2032 个文件 |
| 频谱 | 1016 × 3 = 3048 个 CSV |
| 根文件 | 4 个(LICENSE、README、RECORDS、SHA256SUMS) |
| 压缩包 | 4.2 MB |
| 解压后 | 5.6 MB |
注意片段是「每组两文件」,不是「每组一文件」——按条目页的 txt 示例去写脚本,会在第一步就断。
§4 局限:二十二个人、一个库、两秒窗口
4.1 样本量的真实含义
这份数据最容易被误读的地方,是「一千零一十六」这个数字。
四层量级要分开数:
| 层级 | 数量 |
|---|---|
| 受试者(记录) | 22 |
| 片段 | 1016 |
| 每个片段的采样点 | 721 |
| 总采样点 | 约 73.3 万 |
从二十二到一千零一十六,是 46 倍;从记录到采样点,是 3.3 万倍。但独立信息量接近二十二,不是一千零一十六——同一段室颤连续被切出五段,这五段几乎不提供新信息。
这直接决定了交叉验证怎么做:必须按记录号分组划分,让同一条记录的所有片段落在同一侧。按片段随机划分会让测试集的片段在训练集里有「同母本兄弟」,准确率会被抬得很高,而抬高的那部分是记忆,不是泛化。
二十二这个数字还有一个更硬的后果:任何按记录聚合的指标,样本量都是 22。 想报「二十二条记录上的中位敏感性」,置信区间会宽得没有实用价值。这不是数据集的错,是它的体量决定的。
4.2 单中心与单来源
全部片段来自同一个上游库(MVED),MVED 又来自同一批合作机构。这意味着:
- 记录设备单一(改良肢体导联 II,模拟磁带时代的记录系统);
- 病人群体单一(上世纪八十年代、需要长时间监护的心脏病人);
- 没有第二个中心可以做外部验证。
对「报警算法」这件事来说,这个局限尤其要紧:误报率高度依赖于噪声环境,而噪声环境在不同医院、不同监护仪、不同电极贴法下差别很大。在单一来源的数据上把误报压到很低,不代表换一个病房还能保持。
4.3 标签是代理,而且是二级代理
这里的标签经过两次转换:
- 第一次,原始记录的逐搏注释(谁标的、依据什么,MVED 里有说明,但这份数据集没重复);
- 第二次,三个工程人员加一位心内科医生按六级重新归类。
条目页明确说第二次转换修改了 412 条注释(占 1016 的 40.6%),主要改的是危险程度的判定,涉及这些配对:(VF/VFL)、(VFL, VF/VTHR)、(VT/VF, VFL)、(HGEA/VTHR)、(BI/HGEA)、(NOD/VER)、(N/BBB)、(N/BI)、(N/SVTA)、(N/HGEA)。
四成的标签被改过,这个数字说明两件事:一是分级边界本身有主观性;二是改后的标签质量更高(有专家复核),但改的过程不可复现——条目页没说每一条是怎么改的,只说了改了哪些配对。
对使用者的实际含义:这份数据的标签是「一位专家团队的判断」,不是「客观真理」。 如果拿它当金标准去评估另一个专家团队的标注,两者在边界病例上的分歧会被算成算法的错误。
4.4 实验条件与监护条件的差距
这份数据全部来自院内长时间监护场景,而它的目标是「连续监护报警」。这两者之间有一层被省略的差距:
| 维度 | 数据里的情况 | 实际部署时的变量 |
|---|---|---|
| 电极 | 固定导联,位置稳定 | 病人翻身、出汗、电极老化 |
| 噪声 | 已经过筛选,明显噪声片段被剔除 | 无法剔除,必须在线处理 |
| 节律上下文 | 无 | 有,但算法只能用两秒 |
| 报警后果 | 无 | 误报累积导致护理人员脱敏 |
第三行是关键:条目页明确说,切割时「信号存在显著噪声的片段被排除在考虑之外」。这句话在数据处理上是合理的,在部署评估上是一个盲点——被剔掉的那部分恰恰是现实中最难处理的部分。
4.5 它测不到的那一维
这份数据完全没有「时间到事件」的维度:没有标注这段室颤持续了多久、有没有自行终止、病人后来怎么样。
对一个报警算法来说,这一维其实很关键。同样是室颤,持续三秒自行终止的与持续三十秒导致意识丧失的,临床处置完全不同;但对只给两秒窗口的算法,两者长得一样。算法能做的只是「这是室颤」,做不了「这有多急」。
这也是这份数据被设计成「分级」而不是「二分类」的原因——分级是它能给的最细的粒度。但级别是类型的级别,不是这一次严重程度的级别。
4.6 类别不均衡与它的真实来源
六级规模是 72 / 106 / 132 / 169 / 200 / 337,最大与最小差 4.7 倍。看起来不算太糟。但拆到十五个具体标签,有的极端小:
- 窦性心动过缓 SBR:1 段
- 慢速室速 VTLR:6 段
- 一度房室阻滞 BI:8 段
- 室性逸搏心律 VER:12 段
- 交界性心律 NOD:12 段
五个标签加起来 39 段,占 3.8%。任何声称能识别这五类的算法,都无法被这份数据有效验证——一段或六段的样本,一次错就掉几十个百分点。
这一点必须在使用前想清楚:如果目标是六分类,这五类基本只能算「有标签」,不能算「有评估能力」。
4.7 数据质量清单(DAIMS)
按 DAIMS 的六个维度过一遍:
| 维度 | 评估 |
|---|---|
| 完整性 | 1016 段全部有信号与三份频谱,无缺失;RECORDS 与磁盘一致 |
| 准确性 | 采样率与时长与条目页不符(250 Hz / 2.884 s vs 360 Hz / 2 s);头文件幅值字段不可信 |
| 一致性 | 命名严格一致(1016 行无异常);但文件后缀与条目页示例不符 |
| 时效性 | 上游记录为上世纪八十年代,切片工作 2018 年起,2022 年发布 |
| 唯一性 | 无重复片段名;同一记录内不同片段有可能重叠(未核实) |
| 有效性 | 类别定义清晰;边界病例的标注主观性已被 40.6% 的改标率暴露 |
其中「同一记录内片段是否重叠」这一条,我列在未核实里:起始时刻是任意选的,两个起始时刻相差不到 2.884 秒就会出现重叠,而 RECORDS 里确实有相邻时刻(如 277s 与 279s)。这条要复核,因为它会影响划分策略——如果重叠片段被分到训练集与测试集两侧,等于泄漏。
4.8 那二十二条记录里,室颤出现的密度差别有多大
这一节讲一个只有把交叉表算出来才能看到的事实。
按记录统计一级(室扑加室颤)的片段数,二十二条记录的分布是这样的:
| 一级片段数 | 记录条数 | 记录号 |
|---|---|---|
| 40 段以上 | 3 | 422(59)、430(48)、427(44) |
| 15 至 27 段 | 5 | 426(28)、612(27)、418(26)、614(22)、429(16) |
| 5 至 14 段 | 5 | 423(14)、424(12)、607(10)、428(9)、419(8) |
| 1 至 5 段 | 4 | 420(5)、605(5)、421(2)、425(2) |
| 零段 | 5 | 602、609、610、611、615 |
这意味着:有五条记录在整个半小时里没有出现一次室颤或室扑。 另有四条只出现了个位数。真正撑起一级那三百三十七段的,是前八条记录——它们合计 246 段,占一级总量的 73%。
这个分布带来两个实际后果。
第一,留一交叉验证在记录层面极不稳定。若留出的是 602 或 615 这类记录,测试集里一条一级片段都没有,此时「一级召回率」这个指标在那一折上无定义或为 0/0。若留出的是 422,测试集 93 段里有 59 段是一级,指标会被这一类主导。二十二折的均值因此很难解释。
第二,「算法能识别室颤」这句话的适用范围,取决于它是在哪几条记录上验证的。在一级片段占 63% 的 422 上做出来的敏感度,与在只占 8% 的 419 上做出来的,含义不一样。这也是为什么本文在 §8.3 建议把「每折的样本数」一并报出来——不是客气,是这个数据的结构决定的。
顺带说一句同级的事情:五级(室上性)的分布相反,二十二条记录里有 602、605、612 三条完全没有五级片段,而记录 615 的 44 段里有 36 段是五级,占该记录的 82%。五级的样本明显集中在少数记录上:615 一条就占了三十六段,超过五级总量一百零六段的三分之一。
4.8 与相邻数据能做什么、不能做什么
| 想要的用途 | 这份数据能做吗 | 说明 |
|---|---|---|
| 短窗报警算法基准 | 能,这是设计目标 | 前提是按记录划分 |
| 室颤/室速二分类 | 能,样本充足(337 + 169) | 一级加三级共 506 段 |
| 六分类比较 | 勉强,三到六类有短板 | 五级里 SBR 只有 1 段 |
| 十五类细粒度分类 | 不能 | 五类样本不足 15 段 |
| 波形形态学研究 | 不建议 | 形态多样性被人为拉高 |
| 发作预测 | 不能 | 无所作前的上下文 |
| 病人层面风险分层 | 不能 | 无人口学、无随访 |
§5 它能用来做什么
5.1 短窗报警算法的横向比较
这是它的原始设计目标。此前每个团队用自己切的片段、自己的窗口长度、自己的类别定义,发表的准确率互相不可比。这份数据把三件事固定下来:窗口长度、类别体系、样本清单。
实际价值不在于它的标签有多权威,而在于它是一份大家都能拿到的同一份考卷。
5.2 做前置特征工程的基线
条目页说作者自己用这份数据做了实验:六类各取九十段,用 kNN、最近凸包(LNCH)、线性判别(FLD)、支持向量机(SVM)四种经典方法做分类,其中三次核 SVM 的准确率最高,达 94.8%。
这个数字要小心读。九十段乘六等于五百四十段,只用了总量的一半多;而如果这五百四十段是随机抽的、划分也是随机的,那么 94.8% 里有相当一部分来自同记录内的相似性。条目页没交代划分方式。
正确的用法不是去比 94.8%,而是去问:在按记录分组划分下,经典方法能到多少。 这个数没人报过,值得做。
5.3 检验频谱特征够不够用
这份数据附带了三套频谱描述,这是它比较少见的地方——大多数心电数据集只给波形,特征要自己提。这里直接给了:
- 全谱 0 至 180 赫兹,步长 0.5 赫兹,361 个系数;
- 十五赫兹以内的平滑谱,15 个系数;
- 十五赫兹以内的平滑谱,10 个系数。
可以做一组很干净的对照实验:同一批数据,波形输入 vs 全谱输入 vs 15 系数输入 vs 10 系数输入,在按记录划分下的表现差多少。 如果 10 个系数就能接近全谱,那在嵌入式监护设备上这条路线就成立。
5.4 作为信号处理教学案例
1016 段、5.6 MB、六类目录清晰、每段只有 2.884 秒——这是一份很好的教学材料。可以在一节课里走完:读 WFDB、重采样、切窗、算谱、训练、按记录分组评估。全部在一台笔记本上、几分钟内完成。
5.5 做误报抑制的研究
监护病房的误报主要来自三类:导联脱落、运动伪迹、形态相似的非恶性心律。这份数据的第四、五级正好提供了后者的素材——室性二联律、高度室性异位活动、房颤、室上速,这些都会在单导联上伪装成危险心律。
用它训练一个「先排除良性模仿者」的前置分类器,再判断危险级别,是一条比直接六分类更贴合临床流程的路线。
5.6 它不能用来做什么
- 不能用来证明某算法「可用于临床」。体外基准与临床部署之间隔着噪声、时序、人因三层。
- 不能用来算发病率或患病率。片段数是人为切出来的,与人群中的发生频率无关。
- 不能用来做跨数据库的迁移学习评估(只有单一来源)。
- 不能用来讨论某个具体病人的心律特征(无病人信息)。
5.7 用之前必须先做的三件事
第一,自己确认采样率与时长的关系。 读第一条头文件,看第一行的第二个与第三个数。按本篇核对的十八段,应该是 250 和 721。如果你的脚本假设 360 赫兹或 720 个样本,第一个特征就会错。
第二,从 SHA256SUMS.txt 取真实路径。 不要按条目页的 .txt 示例拼 URL。
第三,检查片段是否重叠。 按记录号分组,把起始时刻排序,看相邻差的分布。若存在大量小于 2.884 秒的间隔,划分时必须把重叠片段绑在一起。
5.8 用频谱描述做一次「物理直觉」检验
这份数据附带的三套频谱,除了喂给分类器,还有一个常被忽略的用处:检验自己对心律失常频率结构的直觉对不对。
人的直觉很容易走偏。比如常听到的一种说法:室颤是「高频乱波」,室速是「低频规则波」。如果拿这份数据的全谱去算每类的平均谱形,会看到什么?
我在这里没法给结果——本篇只下载了一段片段的频谱,不够做平均。但给出检验的做法是有价值的:
第一步,按类别把 full.csv 分组,每类取所有片段的三百六十一个系数(丢掉第零个,因为它是总功率,会掩盖形状差异)。
第二步,每类做平均,得到六条平均谱曲线。做平均前先各自归一化到单位面积,否则总功率的差异会主导结果。
第三步,把六条曲线画在一张图上,看两点:峰值频率落在哪、高频段的衰减斜率有多陡。
预期会有两个发现。其一,一级与二级(室颤、室扑、尖端扭转)的谱在零点五到五赫兹区间应该是宽而平的,因为波形没有稳定的周期;而三级(快速室速)应该有明显的窄峰,峰位对应心率除以六十。其二,六级的谱应该最接近典型心电的谱形——基频加若干谐波,衰减快而清晰。
如果跑出来的结果与这个预期不符,那么问题出在两头之一:要么是你的直觉错了,要么是这批片段的频谱计算口径与你想的不一样(比如窗函数、去均值、归一化方式)。无论哪一头,都是值得记下来的发现。
这件事成本极低:三千零四十八个 CSV 文件、总共几 MB,读进来十几秒就算完。它不能发论文,但能在你写代码之前把「这批数据的频域到底长什么样」这件事钉死。
5.9 把「非危险」类当成负样本做单类学习
另一种不常见的用法:把四、五、六级六百三十八段全部当成「非危险」的正常样本,只用它们训练一个单类模型(一类支持向量机、孤立森林、自编码器),然后拿一、二、三级去测。
这条路线的好处是不需要假设危险的形态长什么样——它只学「正常长什么样」,偏离就是异常。对室颤这种形态千变万化的心律,这可能比多分类更稳。
坏处也很硬:四、五、六级里有大量本身就异常的心律(房颤、室上速、二联律),把它们当「正常」训练,模型学到的「正常」边界会很宽,从而漏掉真正的危险片段。除非你能论证「从报警的角度看,这些都不该触发」,否则这条路线有系统性偏差。
比较合理的做法是分两层做这个实验:第一层只用六级两百段(真窦性)当正常;第二层用四到六级全部。两层的检出率差多少,就直接量化了「把良性异常当正常」的代价。
§6 常见误读
6.1 误读一:一千零一十六个样本
这是本篇最想纠正的一条。一千零一十六是片段数,不是样本数。真实独立单位是二十二条记录。
为什么容易这么读?因为每条记录都被切片了,切完之后长表看起来就是一千零一十六行,和任何一份「一个受试者一行」的数据长得一样。
正确的读法:把「记录」当分组变量,任何划分、任何聚合统计、任何置信区间,都以二十二为分母。
6.2 误读二:把六级序当连续风险刻度
一到六看起来像一条等距刻度,实际上不是。一级(室颤)与二级(尖端扭转)之间的差距,与五级(室上速)和六级(窦性)之间的差距,完全不可比。这是序数,不是区间量表。
做回归时要小心:如果用 1 到 6 当因变量去做线性回归,等于假设「从五级到六级」和「从一级到二级」的难度一样。这个假设没有依据。正确做法是当分类问题处理,或者用有序 logistic 回归并检验平行线假设。
6.3 误读三:把 94.8% 当基准线
条目页提到作者自己的实验里三次核 SVM 达到 94.8%。这个数字在条目页里出现了,但设计细节缺失:九十段每类怎么选的、怎么划分的、有没有交叉验证。
把它当基准线会带来一个隐蔽后果:后来者为了超过它,会不自觉地选择更容易的划分方式。 一份基准数据最怕的不是分数低,是分数可比性被拉坏。
6.4 陷阱一:按 .txt 拼 URL
已在 §3.4 说过,这里再强调一次,因为它是第一步就会遇到的坑。四个示例文件名全部返回 404,而 curl 不会报错——它会安静地把 404 页面写进文件。
判据:下载回来的文件如果小于 1 KB 且开头是 <html>,就是 404 页。
6.5 陷阱二:把低四位当有效信号
WFDB 十六位格式的低四位是校验位。若直接把 .dat 按 int16 读进来当电压用,会出现两层错误:幅值放大十六倍,且带有锯齿状伪影。
判据:把信号画出来看,如果基线呈规则的锯齿(每四个点重复一个模式),就是没右移四位。
6.6 陷阱三:相信头文件的幅值字段
§2.5 已经看到,十八段抽样里有七段的头文件最小值或最大值的符号不合理(min 为正、max 为负)。这说明这两栏在切割时没有被正确写入,或者在重采样时被覆盖。
正确的做法:解析完 .dat 之后自己算 min/max,不要用头文件声明值。
6.7 陷阱四:把类别目录当自然分布
六个目录的规模是 72 / 106 / 132 / 169 / 200 / 337,看起来像个自然分布。但条目页说切割原则是「每类选最大形态多样性」,这是按多样性抽样,不是按频率抽样。
后果:这份数据里任何一类的占比,都不代表它在真实监护中的占比。 室颤在真实监护里极其罕见,这里占 23.6%。
6.8 陷阱五:忽略记录 602、605 的样本太少
22 条记录里,602 只有 3 段、605 只有 9 段、420 只有 13 段。如果按记录做留一交叉验证,留出 602 那一折的测试集只有 3 段,指标噪声极大,而它会在均值里占 1/22 的权重。
处理方式:要么把这几条记录合并成一折,要么在报告里说明这几折的指标不稳定(给每折的样本数)。
6.9 陷阱六:把「室上速」当良性
五级被条目页描述为「非致命」,这很容易被读成「不用管」。但房颤、室上速在临床上都需要处理,只是不像室颤那样分秒必争。
「非致命」在这份数据里的含义只有一个:不在一级到三级的急救路径上。 把它当「正常」是对五级最严重的误读。
6.10 一个关于「危险」的层次问题
最后一条不是陷阱,是一个概念提醒:这份数据把「危险」按心律类型分级,而不是按这一次发作分级。同样是室速,心率 130 与心率 220 的危险程度差很多,但都归三级。
如果研究目标是「识别需要立刻除颤的时刻」,那么按类型分级的标签与目标之间隔着一层。这层差距是数据结构的限制,不是标注者的疏忽。
§7 与相邻数据的定位
7.1 与 MIT-BIH 心律失常库的分工
心律失常库有四十八条三十分钟记录、逐搏注释、双导联、含病人信息,是心搏分类与节律分析的标准素材。这份数据是它的远亲(更准确说是 MVED 的切片),能做的是短窗分类,不能做的是长程节律分析。
选择依据很简单:要评估「两秒内能不能判断」,用这份;要研究「心律怎么演变」,用那个。
7.2 与恶性室性早搏库的分工
MVED 本身是二十二条三十分钟的单导联记录,带逐搏注释。这份数据是它的切片加重新标注。
用 MVED 你可以自己切任意长度、任意起点的窗;用这份数据你只能用给定的 1016 段。前者灵活但不可比,后者可比但不灵活。要发对比结果,用后者;要做探索,用前者。
7.3 规模在整个生态里处于什么位置
心电数据集按体积可以分三档:
| 档 | 代表 | 规模 |
|---|---|---|
| 小 | 这份数据 | 5.6 MB、1016 段、22 条记录 |
| 中 | MIT-BIH 系列、PTB-XL | 数十 MB 至数 GB、数百至两万余条记录 |
| 大 | MIMIC-IV 波形库、CODE-15% | 数 TB 至上百 GB、数万至数百万条 |
5.6 MB 处在最小一档。这一档的优点是能在任何环境里跑完、能做完全可复现的实验;缺点是任何需要统计功効的结论都撑不住。
7.4 与研究线的接续
条目页的 References 里有三篇作者自己的后续工作,都是在这份数据上做算法:2020 年的 SCITEPRESS 会议论文比较了几种识别算法,2021 年的 USBEREIT 会议论文讨论短片段上的危险节律识别,还有一篇数据集论文本身。
跟着这三篇读,能看清作者的分级体系是怎么被使用和检验的。 这也是判断这份数据「到底好不好用」的最直接依据——看原作者自己用它做出了什么。
7.5 适合谁用
- 做可穿戴/床旁监护报警算法的团队:这是最贴近的用途。
- 做小样本、强类别不均衡分类的方法学研究:1016 段、六级、最小类 1 段,是一个很真实的困难场景。
- 教学:完整走通一遍信号到评估的流程,量级刚好。
- 不适合:需要大样本统计的人群研究、需要随访的临床研究、需要外部验证的产品注册。
§8 怎么用:分析方案
8.1 最小可用基线
在碰任何深度模型之前,先拿一个数。
做法:每段片段算四个时域特征——均方根、过零率、峰峰值、主频(用全谱取最大系数对应频率)。用这四维做多项逻辑回归,按记录分组五折交叉验证。
为什么是这四个:室颤与室速的区别主要在频率与幅度规整度上,这四个特征各自抓一面;逻辑回归不会过拟合到记录身份;按记录分组保证不泄漏。
这个基线大概率到不了 70%,但它是你必须打过的第一道门。如果你的一维卷积网络只有 75%,而基线有 68%,那这条网络的实际贡献只有七个点,不值得写进论文。
8.2 划分策略:按记录分组,不可商量
三种划分方式给出三个差得很远的分数:
- 按片段随机:同一记录的片段两侧都有,模型能学到记录特有的噪声底与基线漂移,分数虚高。
- 按记录分组:二十二条记录分成五折,每折四到五条。这是唯一诚实的做法。
- 按时间:不适用——片段的起始时刻是人为选的,不构成时间序列。
还有一层要处理:同记录内的重叠片段必须绑在一起。 §4.7 提到 277s 与 279s 这样的相邻起始点,间隔小于 2.884 秒就有重叠。分组前先按记录内起始时刻排序,把间隔小于窗口长度的片段归为同一「重叠簇」,划分时整簇进同一侧。
8.3 指标怎么选
六分类且极度不均衡,主指标不该是准确率。
| 指标 | 回答什么 | 在这份数据上合适吗 |
|---|---|---|
| 总体准确率 | 平均对多少 | 不合适:337 段的一级会主导 |
| 宏平均 F1 | 每类同等权重 | 合适,但会被 1 段的 SBR 主导 |
| 宏平均召回(仅四类) | 一级到四级的漏检率 | 最贴合临床目标 |
| 一级的敏感度@固定特异度 | 在误报可控时的检出率 | 合适,需给出特异度取值 |
| 混淆矩阵 | 错在哪 | 必报 |
推荐主指标:一级(室颤/室扑)与三级(快速室速)的敏感度,在五级与六级合计假阳性率不超过 5% 的条件下。
理由:临床报警最先要保证的是「要命的别漏」,其次是「别吵」。这两条的取舍点就写在这两个数上。
8.4 五条失败模式
| 现象 | 可能原因 | 排查动作 |
|---|---|---|
| 训练集 99%,测试集 60% | 按片段随机划分,泄漏 | 改按记录分组,重跑 |
| 六类里五类 F1 接近 0 | 小样本类(SBR 1 段、VTLR 6 段) | 合并为「其他」或改用四类 |
| 一级召回高但误报爆炸 | 把室性二联律当室颤 | 看混淆矩阵里四类到一类的错分 |
| 模型在不同折间波动极大 | 某折只含少量记录(602 仅 3 段) | 报告每折样本数,或合并小折 |
| 频谱输入表现异常好 | 零号系数未归一化,模型在学总功率 | 丢掉第零个系数重跑,看差多少 |
第三条值得多说一句:把室性二联律误判成室颤,是这类算法最常见的真实失误模式——二联律的宽大 QRS 波在单导联上与室速很像,如果只看两秒窗口,中间那段正常心搏可能刚好被截掉。
8.5 从频谱到波形的对照实验
这份数据给了三套频谱,值得做一组消融:
- 波形原始输入(721 点);
- 全谱 361 个系数;
- 15 个系数;
- 10 个系数。
四组用同一个分类器、同一套划分。结论会直接回答一个工程问题:在低功耗监护设备上,用十个系数做特征够不够。
8.6 附录:一次最小可行实验的骨架
写清楚步骤,不贴代码。
第一步,落地清单。 下载 SHA256SUMS.txt(563.8 KB),按里面五千余行路径逐条取文件,而不是按条目页示例拼 URL。落地后列一遍文件数,与清单比对;若数目不一致,先解决下载问题再往下走。
第二步,建索引表。 解析 RECORDS 一千零一十六行,用固定格式抽出五个字段:来源记录号、类别标签、起始时刻、风险级别、目录名。这张表只有一千零一十六行,用任何工具都能做,但要先把格式断言写死——若某行抽不出五个字段就直接报错,不要静默跳过。本篇核对时全部一千零一十六行都能解析,所以这条断言应该永远不触发;一旦触发,说明文件被换过版本。
第三步,读信号。 逐个读 .hea 确认采样率与样本数(本篇核对为 250 与 721),再读 .dat,按十六位格式拆成整数,右移四位取有效值,除以增益两百得毫伏。这一步要用头文件里的实际值,不要写死 250。
第四步,切窗。 若后续算法要求严格两秒,从 721 个样本里取前五百个或后五百个,两种都试一次,看结果差多少。这个差异本身就是一个值得报告的发现——因为条目页没说该取哪一段。
第五步,算特征。 四个时域量:均方根、过零率、峰峰值、主频。主频从 full.csv 里取最大系数所在的行号乘 0.5 得到赫兹。
第六步,划分。 按记录号分组。先按记录内起始时刻排序、把间隔小于 2.884 秒的片段并成重叠簇,再以簇为单位分配,保证同一簇不跨两侧。
第七步,训练与报告。 逻辑回归打底,然后试一维卷积。报告里必须出现三样东西:混淆矩阵、每一折的样本数、以及只在一级到四级上算的宏平均召回。
第八步,对照。 把第四步的两种切窗、第五步的波形与频谱两种输入、以及 §8.5 的四种频谱粒度,做成一个两乘四的对照矩阵。全部跑完在一台普通笔记本上不超过十分钟。
这套骨架的价值不在分数,在于它把「条目页没写清的四处」全部变成显式选择:切哪一段、用哪个频率分辨率、怎么分组、报哪个指标。写论文时这四处都要交代,写代码时这四处都要能改。
8.7 一个更贴合临床的两阶段方案
与其直接六分类,不如拆成两个阶段:
第一阶段:危险 vs 非危险二分类。 把一级、二级、三级合成「危险」,四、五、六级合成「非危险」。这一步的样本是 578 对 438,接近平衡,指标容易稳定。
第二阶段:在「危险」内部再分三级。 337、72、169,每类都不少于七十二段,也够用。
两阶段的好处是每一步的类别不均衡都更可控,坏处是误差会累积。可以做对照,看两阶段是否比单阶段六分类的宏平均 F1 更高。
§9 延伸:这份数据折射出的一个问题
写到这里,值得退一步看一个更大的问题。
心电监护报警的误报率长期在 80% 以上(这是公开文献里反复出现的量级),而绝大多数误报不是算法算错了,是算法在用判断题回答选择题:临床上要判断的是「这次报警值不值得叫人来」,而算法回答的是「这个波形像不像室颤」。
这两者的差别在于代价结构。漏一次室颤的代价是一条命,误报一次的代价是护士跑一趟。把这两个代价放进同一个损失函数里,最优阈值会落在非常保守的位置——也就是宁滥勿缺。
这份数据的六级序,本质上是在给「代价」这件事做粗略的量化:一级最重,六级最轻。但它只量化了类型的代价,没有量化这一次的代价,也没有量化误报的代价。
这不是批评,是指出它能回答的问题的边界:它能告诉你算法在类型层面分得清不清,不能告诉你这套阈值得不该上线。
§10 术语与口径
| 术语 | 本篇口径 |
|---|---|
| 片段 | 一段短心电信号,头文件声明 721 个样本、250 赫兹,即 2.884 秒 |
| 记录 | 上游 MVED 库里的一条半小时心电,本篇共 22 条 |
| 风险级 | 六级序,一级最高;序数,不是等距刻度 |
| MLII | 改良肢体导联 II,上游记录的导联配置 |
| ADU | 模数转换单位,除以增益得电压 |
| 全谱 | 0 至 180 赫兹、步长 0.5 赫兹的功率谱密度,361 个系数 |
| 零号系数 | 平滑谱文件的第一个值,条目页称为保留全部信号功率 |
| 重叠簇 | 同一记录内起始时刻相差小于窗口长度的片段集合 |
§11 事实清单
11.1 核心事实表
| 项目 | 值 |
|---|---|
| 片段总数 | 1016 |
| 来源记录数 | 22 |
| 类别数 | 6 级 / 15 种标签 |
| 六级规模 | 337 / 72 / 169 / 132 / 106 / 200 |
| 最小标签样本 | SBR 1 段 |
| 头文件声明采样率 | 250 赫兹 |
| 头文件声明样本数 | 721 |
| 换算时长 | 2.884 秒 |
| 条目页声明采样率 | 360 赫兹(上游值) |
| 条目页声明时长 | 2 秒 |
| 单段信号文件大小 | 1442 字节 |
| 全谱系数个数 | 361 |
| 平滑谱系数个数 | 15 与 10 |
| 改标片段数 | 412(占 40.6%) |
| 未压缩总体积 | 5.6 MB |
| 许可 | ODC-By v1.0 |
| DOI | 10.13026/kpfg-xs25 |
11.2 可立即验证的疑问
拿到数据后,下面每条都能用一条命令或一次查看确认:
- 采样率到底是多少? 打开任意
.hea文件第一行,第二个字段即采样率,第三个字段即样本数。 - 片段是否重叠? 按记录号分组,把 RECORDS 里的起始时刻排序,算相邻差值,统计小于 2.884 秒的对数。
- 头文件幅值字段是否可信? 遍历全部 1016 个
.hea,统计「最小值大于零」与「最大值小于零」的条数。 - 零号系数是否归一化? 抽十段同类片段,比较各自
15_2.csv的第一行值,看是否恒等。 - 频谱步长是否真是 0.5 赫兹?
full.csv三百六十一行,若对应 0 至 180 赫兹,步长必为 0.5;若实际步长不是 0.5,行数会不同。 - SHA256SUMS 是否覆盖全部文件? 该文件五千零八十九行,而 1016 × 4(一组
.dat加.hea算两文件,加三个 csv 共五个)应是 5080 个文件,差值九行需查。
第 6 条我在这里算了一下:1016 段,每段有 .dat、.hea 和三个 csv 共五个文件,合计 5080;而 SHA256SUMS.txt 有五千零八十九行。多出的九行需要核对,可能包含根目录的四个文件与目录清单本身。
11.3 证据链
按章节交代信息来自哪里。
§1:六级分类的定义、五类致命性文献引证(62.4% / 12.7% / 8.3%)、两秒窗口的论证、BBB 并入六级的说明,全部来自条目页 Background 与 Data Description 两段。1.6 的版本与许可来自条目页 Access 区。
§2:目录结构、RECORDS 行数、六个一级目录的规模、十五个标签的计数、记录 × 级别交叉表、起始时刻范围与中位数、小数秒片段数,全部是我解析 RECORDS 得到的结果。三段与条目页不符的核对(采样率 250、时长 2.884、后缀非 txt)来自十八段抽样的 .hea 与目录页,以及 SHA256SUMS.txt 的真实路径。§2.5 的波形解析(有效值 −15 到 16、峰峰值 31、电压 0.155 毫伏)是我按 WFDB 十六位格式解码 418_C_VFL_277s_frag.dat 得到。§2.6 的频谱行数与首值来自实际下载的三个 CSV。
§3:许可、DOI、三种下载方式、体积,来自条目页 Access 与 Files 区。.txt 后缀踩坑过程是本篇核对过程中的事实记录。
§4:样本量四层量级、单中心、二级代理标签、实验与监护条件的对照、类别不均衡的十五类细分、DAIMS 六维表,前四条基于条目页表述加编辑分析,第五条的十五类计数来自 RECORDS 解析,DAIMS 表为编辑按维度展开。
§5:94.8% 与四种经典方法来自条目页 Usage Notes。其余五条用法为编辑基于数据特性展开,条目页未逐条提及。
§6:六条误读与陷阱中,6.1 至 6.3 是基于数据结构与条目页表述的分析;6.4 至 6.6 来自实际核对发现;6.7 的「按多样性抽样」判断依据是条目页原话;6.8 的记录样本数来自交叉表;6.9 与 6.10 为编辑判断。
§7:与心律失常库、MVED 的对照基于公开常识与条目页表述;规模分档为编辑整理;7.4 的三篇后续工作来自条目页 References。
§8:全部为编辑的方法学建议,条目页未给出具体划分或指标要求。
§9:误报率的量级属公开常识,非本数据集的测量结果。
§10:术语为通用定义;口径一栏中的数值均来自本篇核对。
§11.1:除「改标片段数 412」来自条目页外,其余均为条目页与核对结果合并。
未验证的部分:全部 1016 个头文件(只抽 1.8%);片段之间的重叠情况;频谱数值的合理性;标签与波形的临床一致性;SHA256SUMS.txt 的校验值。
编辑说明
本页依据 PhysioNet 条目页(https://physionet.org/content/ecg-fragment-high-risk-label/1.0.0/)公开表述撰写,并下载了 RECORDS、README.txt、SHA256SUMS.txt 三个根文件与十八组跨类别的片段(.dat 加 .hea),另加同一片段的三个频谱 CSV 做逐项核对。
需要说明的几处判断:
一是关于采样率。条目页说原始记录 360 赫兹、片段两秒,而头文件写的是 250 赫兹、721 个样本。十八段抽样全部如此,因此这不是个别文件的问题。本页据此判定片段经过重采样,且实际时长约 2.884 秒。这是本页对条目页的实质性更正,依据已写在 §2.4。
二是关于文件后缀。条目页示例用 .txt,实际 frag 是 WFDB 的 .dat 加 .hea,频谱是 .csv。SHA256SUMS.txt 里的路径印证了这一点。本页在 §3.4 记录了按示例拼 URL 全部 404 的过程。
三是关于头文件幅值。十八段抽样里有七段的最小值为正或最大值为负,数学上不可能,说明这两栏是截取时的残值。本页在 §2.5 与 §6.6 都提示不要直接使用。
四是关于 412 条改标。这个数字来自条目页原话(「共修订 412 条注释,全部数据集共 1016 段」),占比 40.6% 是本页算出来的。条目页只列了改动的标签配对,没有逐条交代改法。
五是关于作者的引用格式。条目页给出的 BibTeX 中作者字段与正文列出的作者(Manilo、Nemirko、Evdakova、Tatarinova 等)不符,疑似模板残留。本页在 §3.2 提示以条目页 Citation 区为准,未做推断。
六是关于那一段峰峰值 0.155 毫伏的片段。本页只记录了「解出来的值是这样」,没有推断它是噪声、脱落还是落在两个波之间,因为判断依据不在数据里。这一条是本页刻意留白的地方。
七是关于片段重叠。这是本页提出的一个未核实风险,不是已确认的缺陷。若重叠确实存在且未处理,按片段划分会造成泄漏。
资助与利益冲突:条目页注明由俄罗斯基础研究基金项目 19-29-01009 部分支持,作者声明无利益冲突。条目页另有 Ethics 段,声明无伦理问题。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- code-test — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- ecg-arrhythmia — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- mit-bih-afdb — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- cinc-2021 — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- icentia11k — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- ltafdb — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- cinc-2020 — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- ludb — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- openecg — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
- code-ii — 共享标签:心电信号 / 生理信号 / 评测基准 / 心血管疾病
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
