信息速览
帕金森病的震颤研究里,「开关」不是比喻。患者颅内埋着电极,程控仪一按,刺激起来,手就静下来;一关,几十秒内抖回来。同一时刻,左旋多巴的血药浓度又是另一个开关。两个开关各有两档,交叉出四种状态,而这四种状态下的手,是同一个人的同一只手。
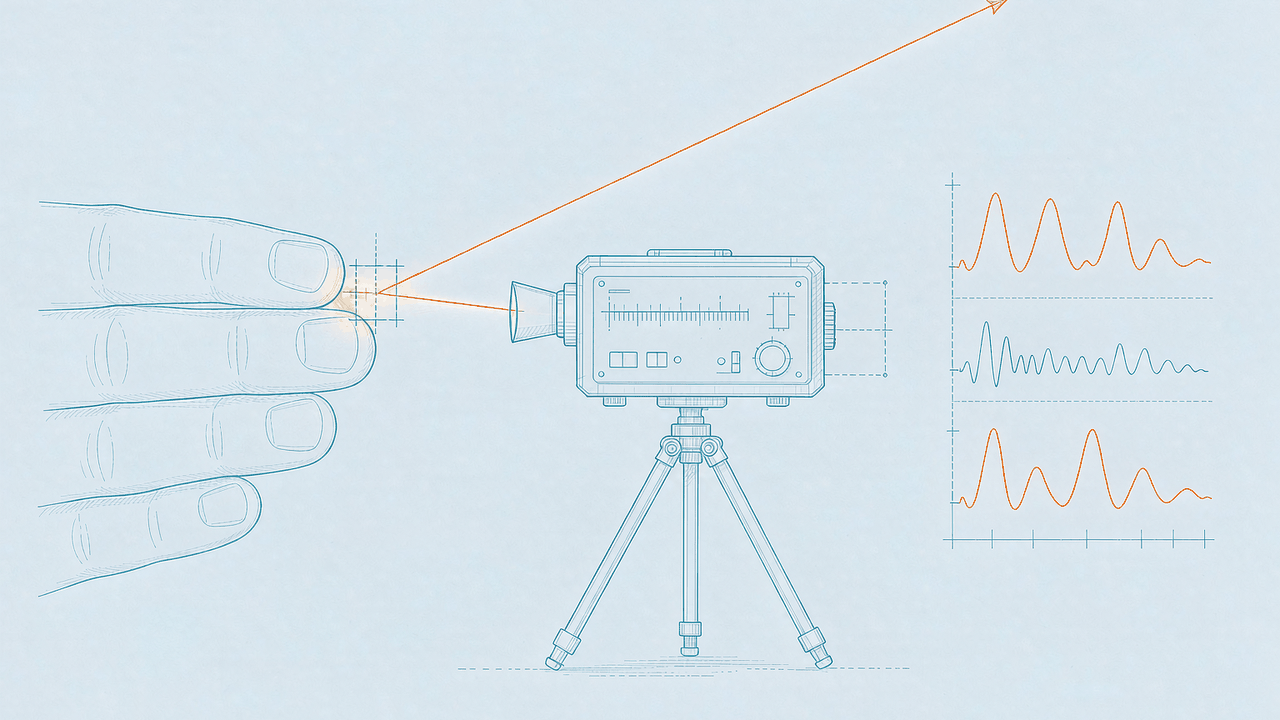
2001 年 8 月,PhysioNet 上线了一份把这件事录下来的数据。十六例患者,三个刺激靶点,四种开关组合,外加关刺激后每十五分钟一次的衰减序列,一共一百零一条记录。测量方式很朴素:指尖贴一张反光纸,一台低强度激光测速仪对着它,输出电压与手指速度成正比。
它记录的不是「有没有震颤」,而是一段连续的速度曲线,一百赫兹,每条约一分钟。这决定了它能回答什么、不能回答什么,也决定了它和站内那些用按键、用步态、用腕表去间接推断帕金森病的资源,根本不是同一类东西。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 全名 | Effect of Deep Brain Stimulation on Parkinsonian Tremor |
| 内部库名 | DBSPDTREMOR(README 首行) |
| 发布方 | PhysioNet(MIT 计算生理学实验室维护) |
| 创建者 | Anne Beuter、Michele S. Titcombe、Leon Glass |
| 创建机构 | 蒙彼利埃第一大学体育科学学院;麦吉尔大学非线性动力学中心 |
| 首次发布 | 2001 年 8 月 27 日,版本 1.0.0,仅此一版 |
| 受试者 | 16 例帕金森病,全部已植入脑深部电刺激器 |
| 有记录的受试者 | 15 例(编号 v3 无任何记录) |
| 分组 | 高幅震颤 8 例(1–8)、低幅震颤 8 例(9–16) |
| 靶点 | 丘脑中腹中间核 3 例、苍白球内侧部 7 例、丘脑底核 6 例 |
| 记录数 | 101 条 |
| 单条时长 | 约 60 秒(34 至 121 秒,按点数换算) |
| 采集设备 | 低强度激光测速仪 + 指尖反光纸 |
| 采样参数 | 100 Hz,单通道,量程五档 |
| 条件维度 | 刺激开/关 × 用药开/关,另加停药后 15/30/45/60 分钟 |
| 目录结构 | 8 个条件类目 × 高幅/低幅 = 16 个子目录 |
| 体积 | 未压缩 3.5 MB |
| 许可 | ODC 署名 1.0,免注册下载 |
| DOI | 10.13026/C2D097 |
§1 它要解决的具体麻烦
1.1 震颤的幅度与频率必须分开量
临床上描述震颤,常用的是一句话:「右上肢静止性震颤,幅度中等,频率约每秒五到六次。」这句话里其实有两个独立的量。幅度回答「抖得厉害不厉害」,频率回答「抖得快不快」,二者在帕金森病里并不同步变化。刺激一开,幅度常常在几秒内塌下去,频率却可能只挪动零点几赫兹;药物起效时,幅度降得更慢,频率反而可能先升后降。
要看清这两条线各自怎么走,靠门诊里的一次目测不行,靠量表也不行。统一帕金森病评定量表把震颤拆成几个整数档,档与档之间是断的,而幅度在刺激开启后的头十秒里往往连续滑落好几个档。中间那一段,量表记不下来。
所以这类研究的核心需求只有一条:一条连续的、以物理单位计量的速度或位移曲线,而且必须在开关切换的前后各有足够长的采样。tremordb 就是为这条需求做的。它不去统一量表,也不去覆盖全天,只把一分钟的曲线在八种状态下各录一遍。
这里有一个常被忽略的取舍。一分钟够看主频与均方根幅值,不够看分钟以上的漂移;一百赫兹够覆盖四到六赫兹的震颤主频,不够看肌电那样的高频成分。这个取舍决定了全库的性格:它是一台记录开关瞬间的示波器,不是一台二十四小时监护仪。
| 观察对象 | 需要的采样条件 | 本库是否满足 |
|---|---|---|
| 震颤主频(四至六赫兹) | 采样率高于主频十倍以上 | 满足,一百赫兹 |
| 刺激开启后的幅度衰减曲线 | 切换前后各数十秒连续记录 | 部分满足,单条仅约六十秒 |
| 关刺激后的分钟级恢复 | 每十五分钟一次、持续一小时 | 满足,四档梯度 |
| 用药起效的时间过程 | 服药后连续数小时 | 不满足,只有「已起效」一个状态 |
| 日间波动 | 全天候记录 | 不满足,无重复会话设计 |
| 左右手对称性 | 同一次测试双手中指同时记录 | 不满足,每人只测一侧 |
1.2 三条常见的错误期待
第一条,期待它是「震颤数据库」的通用版。tremordb 这个名字看起来像「震颤数据库」的缩写,容易被理解成一个收纳各类震颤(特发性震颤、小脑性震颤、生理性震颤)的大池子。实际情况窄得多:库里只有帕金森病一种病,只有静止性震颤一种类型,只有食指一个部位,而且所有人都已经做过手术。文件名里的 r 表示 resting tremor,这个字母是固定的,没有第二个取值。
第二条,期待它是加速度计数据。惯性传感器在这类研究里太常见,以至于看到「震颤」「波形」「一百赫兹」三个词,很多人的第一反应是戴上腕表或指环采到的三轴加速度。这里不是。激光测速仪测的是速度,一维,单位是毫米每秒或米每秒。加速度与速度之间差一个微分,理论上可以互转,但微分会把高频噪声放大,而这份数据的量程档位在不同记录之间并不统一,微分前必须先逐条确认单位。
第三条,期待它有临床严重度。表里有年龄、性别、靶点、刺激参数、药量、确诊年份,唯独没有统一帕金森病评定量表的运动分,也没有 Hoehn 与 Yahr 分级。库里唯一接近严重度的是「高幅」与「低幅」这个二分:前八例因为震颤严重而接受手术,后八例因为僵硬或异动而接受手术。这是一个入组理由,不是一个测量值。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 看清刺激开关瞬间的幅度变化 | 四种开关组合各约六十秒的速度曲线 | 够,且是它唯一的设计目的 |
| 比较三个刺激靶点的抑制效果 | 丘脑 3 例、苍白球 7 例、底核 6 例 | 勉强,各组人数太少且未随机 |
| 关刺激后震颤如何逐级恢复 | 十五、三十、四十五、六十分钟四档 | 够,这是全库最稀缺的结构 |
| 研究震颤主频随状态的变化 | 一百赫兹采样,足以做四至六赫兹的谱估计 | 够,但单条只有一分钟 |
| 训练一个震颤检测或分型模型 | 十五人、一百零一条、条件标签齐全 | 不够,人少且同人多条 |
| 拿到以加速度为单位的信号 | 单位是速度 | 不够,需自行微分并承担噪声代价 |
| 做严重度与震颤的剂量反应 | 无量表分,只有高幅低幅二分 | 不够 |
| 研究上肢其他关节或姿势性震颤 | 只有食指指尖静止性震颤 | 不够 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 你在做震颤信号的谱估计或包络提取,缺一段干净的公开真值 | 一百赫兹、单通道、约六十秒,条件标注在文件名里 | 先用 §4.2 的案例跑通一个人的八条,再扩到全库 |
| 你在评估神经调控的即时效应,需要一份可复现的对照 | 开关四象限加停药梯度,同一批人 | 按人对齐而非按记录对齐,先做个体曲线 |
| 你在写震颤测量方法学的综述 | 有 DOI、有原始论文、有明确的器械与量程说明 | 按 §9.3 同时引数据与 2001 年论文 |
| 你需要一个教学用的短序列样本 | 文件小、语义清晰、一百零一条足够铺开讲 | 用 §5.3 的解析器先讲清文件名七段 |
| 你在做可穿戴设备的算法验证,手上有加速度计数据 | 只有速度,不能直接喂给同一套特征 | 先积分或微分对齐量纲,再谈可比性 |
| 你要找帕金森病的行为学代理指标 | 这份不是,nqmitcsxpd 那类才是 | 换库,先读 §6.1 的分工表 |
1.5 一句话判断
它是一份把「开关」写进文件名的数据:十四个字母的位置里藏着靶点、编号、刺激、停药分钟与用药,而曲线本身只负责回答「手当时抖得多快」。
1.6 不适合谁:四条边界
不适合把记录数当样本量的人。 一百零一条记录背后是十五个人,其中八个人各贡献了八条。任何按记录随机划分训练集与测试集的做法,都会让同一个人的不同状态同时出现在两边。这个泄漏不会报错,只会让指标虚高。
不适合需要统一量纲的幅值比较。 说明表里的速度单位同时出现毫米每秒与米每秒,量程档位从零点二伏到二伏不等。把不同档位的均方根直接放进同一张柱状图,会得到三四个数量级的假差异。跨记录比较前必须先把单位统一。
不适合当作震颤的自然史。 所有受试者都已手术,都处于长期刺激状态,都在实验室里坐着被测一分钟。这是一群被高度选择过的人在一段被高度规定的时间里的表现,不能外推成「帕金森病震颤的一般形态」。
不适合研究药物剂量反应。 用药只有两档:至少十二小时未服,或服下平时晨剂的一点五倍。没有血药浓度,没有起效时刻的连续采样,也没有中间剂量。它只能回答「开着和关着差多少」,不能回答「随剂量怎么变」。
§2 数据构成与规格
2.1 十六个目录与一百零一条记录
整个库不是平铺的。顶层先按条件分成八个类目,每个类目再按震颤幅度分成高幅与低幅两个子目录,于是有了十六个目录,名字都是五个字符以内的短串:renh、renl、refh、refl、ronh、ronl、rofh、rofl、r15ofh、r15ofl、r30ofh、r30ofl、r45ofh、r45ofl、r60ofh、r60ofl。前三个字母是条件,最后一个字母 h 或 l 是幅度组。
条件代码的读法固定:r 是静止性震颤,第二个字符 e 表示刺激有效(effective),o 表示无刺激(off),n 表示用药已服(on),f 表示停药(off)。所以 ren 是「刺激开、用药开」,rof 是「刺激关、用药关」,r30of 是「刺激关了三十五分钟、用药关」。
一百零一条记录按这八类分布如下。这里的数字取自官方页面的分类表,并与记录清单逐条核对过。
| 类目 | 含义 | 高幅组 | 低幅组 | 合计 |
|---|---|---|---|---|
ren |
刺激开、用药开 | 5 | 8 | 13 |
ref |
刺激开、用药关 | 5 | 8 | 13 |
ron |
刺激关、用药开 | 7 | 8 | 15 |
rof |
刺激关、用药关 | 6 | 8 | 14 |
r15of |
停刺激 15 分钟、用药关 | 3 | 8 | 11 |
r30of |
停刺激 30 分钟、用药关 | 4 | 8 | 12 |
r45of |
停刺激 45 分钟、用药关 | 3 | 8 | 11 |
r60of |
停刺激 60 分钟、用药关 | 4 | 8 | 12 |
| 合计 | — | 37 | 64 | 101 |
低幅组的八个人每人八条,一条不缺,所以低幅组的每一类都是八条,合计六十四。高幅组的八个人贡献三十七条,缺口集中在两个人身上:编号 v3 一条也没有,编号 g1 只有三条。这个不对称本身就是一条重要的结构信息——四象限的设计是完整的,落到具体的人身上并不完整。
| 受试者 | 靶点 | 组别 | 记录数 | 缺失的类目 |
|---|---|---|---|---|
| g1 | 苍白球内侧部 | 高幅 | 3 | 缺 rof 与四档停药梯度 |
| g2 | 苍白球内侧部 | 高幅 | 8 | 无 |
| v3 | 丘脑中腹中间核 | 高幅 | 0 | 全部缺失 |
| v4 | 丘脑中腹中间核 | 高幅 | 2 | 只有 ron 与 rof |
| v5 | 丘脑中腹中间核 | 高幅 | 2 | 只有 ron 与 rof |
| s6 | 丘脑底核 | 高幅 | 8 | 无 |
| s7 | 丘脑底核 | 高幅 | 6 | 缺 r15of 与 r45of |
| s8 | 丘脑底核 | 高幅 | 8 | 无 |
| g9 至 g13 | 苍白球内侧部 | 低幅 | 各 8 | 无 |
| s14 至 s16 | 丘脑底核 | 低幅 | 各 8 | 无 |
这张表解释了一件容易被忽略的事:丘脑组名义上有三个人,实际只有两份数据,而且是两份只有两条记录的数据。任何以靶点为自变量的比较,丘脑这一支的统计支撑都极薄。
2.2 字段与记录的完整字典
记录不存成表格,条件信息全部压在文件名里。文件名由七段拼成,段与段之间没有分隔符,只能按位置与字面解析。
| 段 | 取值 | 长度 | 含义 |
|---|---|---|---|
| 靶点字母 | g、v、s |
1 | 苍白球内侧部、丘脑中腹中间核、丘脑底核 |
| 受试者编号 | 1 至 16 | 1 至 2 | 与受试者表第一列一致 |
| 震颤类型 | r |
1 | 静止性震颤,全库唯一取值 |
| 刺激状态 | e、o |
1 | 有效刺激(高于一百赫兹)或无刺激 |
| 停刺激分钟 | 15、30、45、60 |
2,可缺 | 仅在刺激状态为 o 时可能出现的梯度标记 |
| 用药状态 | n、f |
1 | 已服晨剂一点五倍,或停药十二小时以上 |
| 侧别 | .let、.rit |
4 | 左食指或右食指,写作扩展名形式 |
第七段值得单独说。.let 与 .rit 看起来像文件格式扩展名,其实不是。库里所有波形都是同一种二进制存储,.let 只表示「测的是左手」,.rit 只表示「测的是右手」。把它们当格式标记去查 MIME 类型,会一无所获。
第二个字典是 file_description.txt。这张表逐条列出每个文件的四个技术参数,是全库唯一可靠的元数据来源。
| 列 | 取值示例 | 含义 |
|---|---|---|
| SUBJ | g1 |
受试者编号 |
| FILE | g1ren.let |
文件名,含侧别 |
| RANGE | 0.2、0.5、1.0、2.0 |
量程,单位伏 |
| VELOCITY | mm/s、m/s |
该条记录速度的单位 |
| LASER | 0-0.2、0-1 |
激光测速仪的速度档位,单位米每秒 |
| RATE | 100 |
采样率,赫兹 |
| SAMPLES | 6234 |
该条记录的点数 |
第三个字典是 subject_description.txt。它是一张转置的宽表,十九行,十六列,行是变量名,列是受试者。读取时需要先转置再解析,否则每一行都会被当成一个受试者。
| 行名 | 含义 | 备注 |
|---|---|---|
| SUBJECT | 受试者编号 | 与文件名首段一致 |
| AGE (YRS) | 测试时年龄 | 整数 |
| GENDER | 性别 | M 或 F |
| STIM TARGET | 刺激靶点 | GPi、Vim、STN |
| BI/UNI-LATERAL | 单侧或双侧刺激 | Bi 或 Uni |
| EFF FREQ (Hz) | 有效刺激频率 | 均高于一百赫兹 |
| INEFF FREQ (Hz) | 无效刺激频率 | 均低于一百赫兹 |
| INTENSITY (V) | 刺激强度 | 伏 |
| PULSE WIDTH (mu sec) | 脉宽 | 微秒 |
| MODE (CONT/CYCL) | 刺激模式 | 连续或周期 |
| STIM CONTACTS | 触点极性 | 四个符号,-、+、. 混排 |
| YEAR DIAGNOSED | 确诊年份 | 1974 至 1999 |
| YEAR DBS RIGHT | 右脑手术年份 | 部分为空 |
| YEAR DBS LEFT | 左脑手术年份 | 部分为空 |
| TOT DAILY MED (mg) | 每日总药量 | 晨、午、晚三剂之和 |
| 150% SINGLE DOSE (mg) | 测试前单次剂量 | 晨剂的一点五倍 |
触点那一行用的是四字符记号:- 表示负极,+ 表示正极,. 表示未启用,顺序按电极由近端到远端。例如 ---. 表示前三个触点接负极、第四个不参与。这是深部脑刺激程控记录的通行写法,不是这份数据自创的。
2.3 一条记录的完整解剖
以 §4.2 的案例所用的 g2 为例。这个人是苍白球内侧部刺激、高幅组、双侧植入,五十二岁男性,库里有他八条记录。先看文件名 g2r30of.rit 怎么读:g2 是二号苍白球受试者,r 是静止性震颤,30 是停刺激三十分钟,o 是刺激关,f 是用药关,.rit 是右食指。
再看它所在的目录 r30ofh:类目 r30of 加高幅标记 h。目录里有一份头文件 r30ofh.hea,全文只有六行有效内容:
r30ofh 4 100
g2r30of.rit format? gain? ...
s6r30of.let format? gain?
s7r30of.rit format? gain?
s8r30of.let format? gain?
这是 WFDB 多段记录的头文件骨架:第一行是记录名、段数、采样率,后面每行一个段。这份写着四个段,与目录里同属该类目的四个文件正好对上。格式与增益两个字段都写成了 format? 与 gain?,即占位符;抽查的两份头文件都是这个写法。
这份说明表的对应行是这样的:
g2 g2r30of.rit 2.0 m/s 0-1 100 9144
含义是:二号受试者,右食指,量程二点零伏,速度单位米每秒,激光档位零到一米每秒,采样率一百赫兹,九千一百四十四个点。九千一百四十四除以一百,得九十一点四四秒。
把这条记录与同一目录里的其他几条并排,能看出量程不是统一的。同一个类目里,有人用零点五伏档,有人用二点零伏档;速度单位因此也分成毫米每秒与米每秒两支。这不是采集错误,而是量程自适应:抖动小的人用高灵敏度档,抖得厉害的人必须换低灵敏度档以免削顶。代价是跨记录比较幅值之前,必须先从说明表里读回各自的单位。
#-- 同一目录内的四条记录,量程与单位并不一致
s6r30of.let  1.0   m/s    0-1     100  7200
g2r30of.rit  2.0   m/s    0-1     100  9144
s7r30of.rit  0.5   mm/s   0-0.2   100  6510
s8r30of.let  2.0   m/s    0-1     100  8616
2.4 八种条件与两档幅度
条件的设计有两条腿。第一条是四象限:刺激开或关,用药开或关,交叉出四种状态,对应 ren、ref、ron、rof 四个类目,共五十五条记录。第二条是衰减梯度:把刺激关掉,在第十五、三十、四十五、六十分钟各测一次,全程停药,对应四个 rXXof 类目,共四十六条记录。
用药这一档的细节值得写清。所谓「用药开」,是服下平时晨剂的一点五倍的分散型左旋多巴制剂,由神经科医师判定起效后才开始测试,官方给出的等待时间约四十分钟。所谓「用药关」,是至少十二小时未服任何药物。这两个状态之间没有中间档,也没有采血测浓度。所以「用药开」是一个二值标签,不是一条剂量曲线。
幅度分组则完全是另一种性质。它不是按测出来的幅值分,而是按入组理由分:前八例因为震颤严重而接受手术,后八例因为僵硬或异动而接受手术。官方页面把它写成「高幅震颤」与「低幅震颤」,字面上像是测量结果,实际上是手术指征的回顾性分类。这一点在解释组间差异时很关键——两组的差别不只在于抖得厉害不厉害,还在于他们为什么被推上手术台。
三个靶点在两组里的分布并不均衡。丘脑组三个人全在高幅组,而高幅组恰恰是记录最不全的一组。低幅组八个人全部是苍白球与底核,且全部八条齐全。这意味着想比较靶点效应,可用的数据其实集中在苍白球与底核之间,丘脑只提供了两份零散的样本。
| 靶点 | 高幅组 | 低幅组 | 合计人数 | 记录数 |
|---|---|---|---|---|
| 丘脑中腹中间核(Vim) | 3 | 0 | 3 | 4 |
| 苍白球内侧部(GPi) | 2 | 5 | 7 | 51 |
| 丘脑底核(STN) | 3 | 3 | 6 | 46 |
2.5 与同类资源的字段差异
把 tremordb 放到公开震颤资源的谱系里,它的位置很特别:维度最窄,条件最细。
| 资源类型 | 典型字段 | 采样粒度 | 与本库的差异 |
|---|---|---|---|
| 惯性传感器震颤库 | 三轴加速度、三轴角速度 | 五十至二百赫兹 | 本库只有一维速度 |
| 表面肌电震颤库 | 多通道肌电包络 | 五百赫兹以上 | 本库无肌肉电活动 |
| 光学动捕震颤库 | 指尖三维坐标 | 每秒上百帧 | 本库无空间轨迹 |
| 数字化平板震颤库 | 绘制螺旋的笔压与坐标 | 数十赫兹 | 本库无绘图任务 |
| 量表型震颤评估 | 统一量表分项 | 每次评估一个整数 | 本库有连续曲线无量表 |
| tremordb | 单通道指尖速度 | 一百赫兹,约六十秒 | 条件最细,维度最窄 |
窄有明确的好处:一维速度曲线没有任何模态对齐问题,谱估计、包络、均方根、样本熵都能直接算,不需要坐标系变换。坏处同样明确:它答不了「手在空间里怎么动」,只能答「指尖这一点的速度怎么变」。
与站内步态类的资源相比,差异在于测量对象而不是测量哲学。gaitndd 与 gaitdb 测的是行走节律,事件是「着地」,派生量是步幅时长;tremordb 测的是静止时的抖动,事件没有离散化,整条曲线就是原始观测。前者天生适合做间隔序列分析,后者天生适合做谱分析。
2.6 体积与够不够算
官方标注未压缩合计三点五兆。一百零一条记录,每条约六千至九千点,单通道,若按每点四字节计,总量正好落在二三兆的量级,加上两张说明表与十六份头文件,凑到三点五兆说得通。这个体积在任何机器上都不构成负担,全量下载与全量读入内存都是几秒钟的事。
够不够算,标准不是体积而是序列长度。单条六十秒、一百赫兹,即六千点。做四到六赫兹的谱估计,这个长度给出的频率分辨率约零点零一七赫兹,分辨「五点二赫兹」与「五点四赫兹」没有问题,看二次与三次谐波也够。做包络的分钟级趋势,六十秒只够一个点,谈不上趋势。做样本熵,六千点在可用区间内偏短,结论对嵌入维数与容限的选取敏感。做去趋势波动分析更勉强,可用的尺度区间只有一两个倍频程。
§3 它是谁的数据:一次程控实验的副产品
3.1 三个署名与两个机构
PhysioNet 的项目页没有给个人署名,通讯作者一栏需要登录才能查看。真正的署名在 README 里:Anne Beuter、Michele S. Titcombe、Leon Glass。前两位的联系地址分别落在蒙彼利埃第一大学体育科学学院与麦吉尔大学非线性动力学中心,第三位同在麦吉尔。
这个组合决定了数据的视角:把生理信号当成动力系统的一条轨道,而不是一组待分类的样本。关刺激后的分钟梯度正是这种视角的产物——要看的是系统从一个状态滑向另一个状态的过程,不是「有」与「无」两类。
值得注意的是,README 只署了三位创建者,而页面指定的引用论文有五位作者,多出的两位是临床侧的合作者。这种「数据署创建者、论文署全部作者」的分工在 2001 年很常见,但它带来一个实际的检索问题:按作者名去查这份数据,用三位创建者的名字能查到,用两位临床作者的名字查不到。
3.2 时间线:论文在前,库在后
数据不是先建库再写论文,而是先有实验与论文,再把材料整理上线。顺序反过来看,很多设计选择就说得通了。
| 年份 | 事件 | 与数据的关系 |
|---|---|---|
| 1974 至 1999 | 十六例受试者陆续确诊 | 受试者表里的确诊年份跨度 |
| 1993 至 2000 | 左右脑电极陆续植入 | 手术年份跨度,最早 1993 年 |
| 2001 | 论文发表于 Thalamus & Related Systems 第一卷第三期 | 页面指定的唯一引用 |
| 2001-08-27 | 数据以 1.0.0 版上线 | 记录清单文件的日期 |
| 2001-10 至 11 | 说明表、图片与目录整理完成 | 各文件时间戳集中在这两个月 |
| 2020-08-07 | 校验和文件重新生成 | 平台迁移留下的痕迹 |
最后一行说明平台做过一次维护:波形与说明表的时间戳停在 2001 年,校验和文件则是 2020 年重新生成的,内容未变,只补了逐文件哈希。
3.3 采集现场:指尖一张反光纸
设备链很短,四步走完。
五个量程档位对应五种精度,这个对应关系写在头文件的注释里:二点零伏档对应正负一点零毫米每秒,一点零伏档对应正负零点五,零点五伏档对应正负零点二五,零点二伏档对应正负零点一,零点一伏档对应正负零点零五。档位越低,能分辨的速度越小,但能承受的最大速度也越小。选档的依据是预估的震颤幅度,而预估只能靠观察,所以同一批记录里档位并不统一。
| 量程(伏) | 精度(毫米每秒) | 适用情形 | 在库中的表现 |
|---|---|---|---|
| 2.0 | ±1.0 | 大幅抖动,接近削顶 | 见于关刺激后幅度回升的条件 |
| 1.0 | ±0.5 | 中等幅度 | 少量出现 |
| 0.5 | ±0.25 | 小幅度 | 低幅组多用此档 |
| 0.2 | ±0.1 | 极小幅度,刺激已起效 | 见于刺激开条件 |
| 0.1 | ±0.05 | 接近静止时的残余抖动 | 极少,只在个别低幅记录里 |
这张表解释了一个乍看奇怪的现象:同一名受试者在刺激开与刺激关时,量程往往不同。g2 在刺激开的记录里用零点二伏档,在刺激关的记录里用二点零伏档,两者相差十倍。这不影响原始数据的使用,但会让「把八条记录的均方根画在一张图上」这种操作直接失效——除非先按档位把单位归一。
3.4 三层信息与它们的可信度
这份资源的信息分布在三个层次上,可信度并不相同。
| 层次 | 内容 | 可信度 | 风险 |
|---|---|---|---|
| 官方页面 | 分组人数、条件类目、文件名规则、器械描述 | 高,逐条可查 | 与 README 在靶点例数与记录条数上不一致 |
| README | 库名、创建者、机构、引用格式、纳入排除标准 | 高,是第一手文档 | 靶点例数与记录条数与页面不一致 |
| 文件本身 | 记录清单、受试者表、文件说明表、头文件 | 高,可逐字节核对 | 头文件字段是占位符,语义需靠说明表补 |
三层要分清:页面告诉你八个条件类目各有多少条,但不告诉你 v3 一条也没有;说明表告诉你每条记录的量程与单位,但不告诉你为什么选这个档;头文件告诉你有几个段、采样率多少,但不告诉你数据怎么解码。任何一条结论,最好同时落到两层以上。
§4 它最独特的东西:把开关写进文件名
4.1 条件不是元数据,是文件名
多数数据集把实验条件放进一张表里,一行一个样本,一列一个条件。tremordb 没有这张表。条件全部压在文件名的字符位置上,七个段拼成一个字符串,没有分隔符。
这个设计有它的道理。2001 年的存储习惯里,文件名就是最耐久的索引:目录可以变,说明文件可以丢,文件名跟着数据走。把条件编进文件名,等于让每条记录自带标签,拷贝到任何地方都不会失去上下文。
代价也很实在。文件名不是结构化字段,任何筛选都得先写解析器;解析器写错一个字符,条件就整体错位。更麻烦的是同一条记录的条件分散在文件名与目录名两处:目录名给出类目与幅度组,文件名给出靶点、编号、停药分钟与用药。两处必须同时读,只读一处会丢掉一半信息。
这里有一条容易被忽略的边界:幅度组只存在于目录名,文件名里没有。如果把所有文件平铺到一个目录里,高幅与低幅的区分就永久丢失,只能回到受试者编号去查(一至八为高幅,九至十六为低幅)。侧别也类似,它躲在扩展名里,一旦被改名工具当成格式后缀剥掉,就只剩记录清单一条线索。
4.2 案例:g2 的八条记录与四次开关
g2 是低编号里的完整个案:苍白球内侧部刺激、双侧植入、高幅组、五十二岁男性、1985 年确诊、1996 年双侧手术。他在库里贡献了八条记录,正好覆盖四象限与四档停药梯度,是这个库里少数能把「开关全貌」看全的人。
| 记录 | 条件 | 侧别 | 量程 | 点数 | 时长(秒) |
|---|---|---|---|---|---|
g2ren.rit |
刺激开、用药开 | 右 | 0.2 | 7680 | 76.8 |
g2ref.rit |
刺激开、用药关 | 右 | 0.2 | 6336 | 63.4 |
g2ron.rit |
刺激关、用药开 | 右 | 0.5 | 7134 | 71.3 |
g2rof.rit |
刺激关、用药关 | 右 | 2.0 | 7176 | 71.8 |
g2r15of.rit |
停刺激 15 分钟 | 右 | 2.0 | 6150 | 61.5 |
g2r30of.rit |
停刺激 30 分钟 | 右 | 2.0 | 9144 | 91.4 |
g2r45of.rit |
停刺激 45 分钟 | 右 | 2.0 | 6354 | 63.5 |
g2r60of.rit |
停刺激 60 分钟 | 右 | 2.0 | 6162 | 61.6 |
八条记录里藏着两个信息。第一,量程从零点二伏跳到二点零伏,正好发生在刺激状态从 e 变 o 的一刻——刺激一停,抖动幅度上升一个量级,必须换档。第二,四档梯度的量程全部停在二点零伏,说明在关刺激后的整个小时内,幅度都没有回落到需要更高灵敏度的程度。
这条记录链的用法可以分三步。先用 g2ren 与 g2rof 这一对,比较两个开关同时开与同时关时的速度均方根,得到一个跨状态的幅度比。再用四条 rXXof 排出恢复曲线,看震颤在第几分钟回到什么水平。最后用 g2ref 与 g2ron 拆开两个开关各自的贡献——这两个条件一个只有刺激、一个只有药物,正好是单因素对照。
需要注意的是,这几种对比都建立在「同一分钟内幅度稳定」这个假设上。若震颤在这一分钟里本身就有起伏,单条记录不足以代表该状态的水平,需要重复测量。库里每个人每个条件只有一条,没有重复,所以这个假设无法在数据内部被检验。
4.3 三个靶点的可比与不可比
三个靶点在解剖上对应三条不同的环路,抑制震颤的机制至今没有定论。官方页面直接写了这句话:高频刺激压制震颤的机制未知。既然机制未知,靶点之间的比较就只能是现象层面的。
可比性的问题不在人数,而在混杂。丘脑组三人全在高幅组,苍白球与底核则两组都有人。年龄也不平衡:丘脑组三人分别是七十一、六十七、四十岁,跨度比另两组大。手术年份同样不齐,最早的 1993 年,最晚的 2000 年,病程长短差出七年。
| 混杂因素 | 丘脑组 | 苍白球组 | 底核组 |
|---|---|---|---|
| 年龄范围 | 40 至 71 岁 | 50 至 68 岁 | 37 至 64 岁 |
| 确诊年份范围 | 1989 至 1999 | 1975 至 1989 | 1974 至 1992 |
| 单侧与双侧 | 单侧 2、双侧 1 | 单侧 1、双侧 6 | 全部双侧 |
| 高幅与低幅 | 高幅 3、低幅 0 | 高幅 2、低幅 5 | 高幅 3、低幅 3 |
所以「哪个靶点抑制震颤更好」这个问题,这份数据答不了。它能答的是「在这批人身上,三个靶点的抑制现象长什么样」,而这两句话在论文里的分量完全不同。
4.4 这份数据真正被用来回答的问题
官方页面没有像某些资源那样列出待研究问题清单,但从设计与论文标题能推出它的原始议程:幅度与频率特征如何随刺激与药物改变。拆开看,它至少能支撑四问。刺激开启后主频是否移动,看同一个人的 ren 与 ron 两条即可。刺激与药物对幅度的贡献是否可加,要看四象限全套,而且只能对八条齐全的人做。关刺激后的恢复是线性还是阶跃,看四条梯度。谐波结构是否随状态改变,单条一百赫兹的谱就够看二次与三次谐波。
至于震颤是否具有确定性混沌特征,那是第五问,也是这份数据被引用最多、同时最勉强的一问。2001 年前后,非线性动力学在生理信号里正热,把震颤看成低维混沌系统的论文不少。一分钟、六千点的序列做关联维数或李雅普诺夫指数,处在够用与不够用的边界上,结论对嵌入参数很敏感。
常见的分析族与它们对应的数据切片,可以逐条对上。谱分析吃单条曲线,输出主频与谐波功率;包络分析吃单条曲线,输出幅度的慢变化;状态对比吃同一人的多条,输出幅度比或频率差;恢复曲线吃四条梯度,输出时间常数;组间对比吃跨人的同类条件,输出分布差异,但受样本量与量纲限制。
4.5 边界条件:什么情况下它不再适用
有四类问题,无论怎么处理这份数据都答不了。
需要空间信息的问题。 只有速度一个标量,没有位移方向,没有关节角度。想知道震颤是绕着哪个轴转的,必须换用动捕或惯性传感器。
需要长时间尺度的问题。 单条上限一百二十一秒,无重复会话。日内波动、药效 wear-off、疾病进展,全部超出结构能力。
需要剂量反应的问题。 用药只有两档,刺激强度虽有数值但没有系统变化。表里的强度、脉宽、频率是各人程控的既有设置,不是实验变量。
需要自然情境的问题。 全部在实验室坐位下测,手有支撑,任务是「保持静止」。日常生活中的震颤与睡眠中的震颤,这份数据一概不涉及。
§5 怎么拿到:从目录到一条速度曲线
5.1 目录结构与下载面
顶层十六个目录加七个文件,没有更深层级。三个入口各有用途:想看规格与许可去项目页;想一次拿全量走整包下载;想只要几条,就在文件树地址后接相对路径单取。四条路都不需要登录,也不需要在页面上点同意。云镜像另有一条,桶名公开只读,适合写进脚本做批量同步。
许可要求一致:免注册、可商用、需署名。没有申请流程,也没有数据使用协议需要签署。这一点对教学场景很友好——课堂上可以直接让学生拉全量。
5.2 批量下载与校验
整个库三点五兆,递归抓取几秒钟完成。
#-- 递归镜像整个目录,去掉 files/tremordb/1.0.0 三层前缀
mkdir -p data/tremordb
wget -q -r -N -c -np -nH --cut-dirs=3 \
  -P data/tremordb \
  https://physionet.org/files/tremordb/1.0.0/

#-- 校验完整性,只打印失败项
cd data/tremordb && sha256sum -c SHA256SUMS.txt | grep -v ': OK' || echo all-ok

#-- 确认目录数量与记录数量
find . -maxdepth 1 -type d | wc -l
wc -l < RECORDS
--cut-dirs=3 是为了把本地路径压平,否则文件会落在 data/tremordb/files/tremordb/1.0.0/ 这样的多层嵌套里,后续脚本的相对路径全要改。第二条命令只打印失败项,输出 all-ok 表示全部匹配。
5.3 解析文件名
文件名没有分隔符,只能按位置切。写解析器时最好一次把七段全部取出,并顺手做一致性校验。
import re
from pathlib import Path

#-- 靶点字母 1 位、编号 1 至 2 位、震颤类型 r、可选停药分钟 2 位、刺激 e/o、用药 n/f
PAT = re.compile(r"^(?P<target>[gvs])(?P<num>\d{1,2})r(?P<pause>\d{2})?(?P<dbs>[eo])(?P<med>[nf])$")

TARGET = {"g": "GPi", "v": "Vim", "s": "STN"}

def parse(name: str) -> dict:
    stem, _, side = name.partition(".")
    m = PAT.match(stem)
    if not m:
        raise ValueError(f"未识别的文件名: {name}")
    g = m.groupdict()
    pause = int(g["pause"]) if g["pause"] else 0
    return {
        "subject": g["target"] + g["num"],
        "target": TARGET[g["target"]],
        "group": "HAT" if 1 <= int(g["num"]) <= 8 else "LAT",
        "dbs_on": g["dbs"] == "e",
        "pause_min": pause,
        "med_on": g["med"] == "n",
        "side": "left" if side == "let" else "right",
    }

#-- 用记录清单跑一遍,确认一百零一条全部可解析
names = Path("data/tremordb/RECORDS").read_text().split()
rows = [parse(n) for n in names]
print(len(rows), len({r["subject"] for r in rows}))
最后一行同时打印两个数:记录数与去重后的人数。这两个数字不一样,是这份数据最容易被忽略的一点——一百零一条记录只对应十五个人。
5.4 读两张说明表
subject_description.txt 是转置的宽表,十九行十六列,读取后要先转置。表里用 # 开头的行是注释与分隔,需要先剔除。
import re
from pathlib import Path

def read_subjects(path: str) -> dict:
    #-- 只保留非注释行,按空白切分
    lines = [ln for ln in Path(path).read_text().splitlines()
             if ln.strip() and not ln.lstrip().startswith("#")]
    rows = [re.split(r"\s{2,}", ln.strip()) for ln in lines]
    keys = [r[0] for r in rows]
    cols = [c for c in rows[0][1:]]
    return {k: dict(zip(cols, r[1:])) for k, r in zip(keys, rows)}

subj = read_subjects("data/tremordb/subject_description.txt")
print(subj["AGE (YRS)"]["g2"], subj["STIM TARGET"]["g2"])
file_description.txt 则是逐行的定格式表,七列,用空白分隔。它的价值在于给出量程与单位,这是全库唯一说明幅值该怎么读的地方。
import re
from pathlib import Path

ROW = re.compile(r"^(\w+)\s+(\w+\.(?:let|rit))\s+(\d\.\d)\s+(mm/s|m/s)\s+(\S+)\s+(\d+)\s+(\d+)\s*$")

def read_files(path: str) -> list:
    out = []
    for ln in Path(path).read_text().splitlines():
        m = ROW.match(ln.strip())
        if m:
            out.append({
                "subject": m.group(1), "file": m.group(2),
                "range_v": float(m.group(3)), "unit": m.group(4),
                "laser": m.group(5), "rate": int(m.group(6)),
                "samples": int(m.group(7)),
            })
    return out

meta = read_files("data/tremordb/file_description.txt")
print(len(meta), meta[0])
两行打印出来的结果应当是一百零一条与一条完整的元数据。若数目偏少,多半是正则里的空白匹配太严——这份表的列之间的空格宽度逐行不同。
5.5 读波形与算谱
波形是单通道整数序列,没有可用的 WFDB 头。头文件里的格式与增益是占位符,通用读取器会直接报错。可行路径是按字节读入,用说明表里的点数反推每点的字节数,再与官方给的渲染结果对照确认字节序。
from pathlib import Path

def probe(path: str, n_samples: int) -> dict:
    #-- 只做探测:文件字节数除以点数,得到每点占几个字节
    raw = Path(path).read_bytes()
    return {
        "bytes": len(raw),
        "samples": n_samples,
        "bytes_per_sample": round(len(raw) / n_samples, 3),
        "duration_s": n_samples / 100.0,
    }

print(probe("data/tremordb/renh/g1ren.let", 6234))
这个探测不给出解码方式,只给出约束。字节数与点数的比值是判断存储宽度的第一手证据;拿到比值后仍需与官方页面上的波形图逐点比对,才能确定符号位与字节序。这一步不能省,因为一旦符号弄反,谱估计的功率不受影响,但包络与偏移量会全错。
拿到一维数组之后,谱估计就是常规操作。震颤主频在四到六赫兹,做谱时把搜索区间限定在这个范围,可以避开低频漂移与五十赫兹工频干扰。
import numpy as np

def dominant_freq(x, fs: float = 100.0, band=(3.0, 10.0)) -> tuple:
    x = np.asarray(x, dtype=float)
    x = x - x.mean()
    freqs = np.fft.rfftfreq(len(x), d=1.0 / fs)
    power = np.abs(np.fft.rfft(x)) ** 2
    sel = (freqs >= band[0]) & (freqs <= band[1])
    idx = np.argmax(power[sel])
    return float(freqs[sel][idx]), float(power[sel][idx])

def rms(x) -> float:
    x = np.asarray(x, dtype=float)
    return float(np.sqrt(np.mean((x - x.mean()) ** 2)))
两个函数一个给主频,一个给均方根幅值。它们合起来就是这份数据最常被提取的两个量:抖得多快,抖得多大。注意 rms 的单位跟着输入走,输入是毫米每秒就输出毫米每秒,输入是米每秒就输出米每秒,函数本身不负责归一。
5.6 三类常见读取错误
| 现象 | 原因 | 改法 |
|---|---|---|
| WFDB 读取器报错或读出空信号 | 头文件里格式与增益是占位符 | 不用通用读取器,按说明表自行解码 |
| 十条记录的幅值差三个数量级 | 量程档位不同,单位混了毫米每秒与米每秒 | 按说明表的单位列归一后再比较 |
| 解析后人数比记录数少很多 | 一百零一条对应十五人,属正常 | 按人去重后再统计人数 |
| 受试者表读成十六行一人一行 | 该表是转置的宽表 | 先转置再解析 |
| 目录名判断幅度组失败 | 幅度组只在目录名末字符 | 用 h 与 l 判定,或按编号一至八 |
| 文件名正则匹配失败 | 停药分钟是可选段,正则未设为可选 | 把第五段写成 \d{2}? |
第一项是这份库特有的坑。多数 PhysioNet 资源给出完整的 WFDB 头,读到 format? 这种占位符的机会不多,容易误以为是下载损坏。实际上文件是完整的,缺的是头文件里的解码声明。
import re

def group_of(name: str) -> str:
    #-- 幅度组只存在于目录名末字符,文件名里没有
    m = re.match(r"^r(?:\d{2})?o?[nf]?([hl])$", name)
    if m:
        return "HAT" if m.group(1) == "h" else "LAT"
    #-- 退化路径:用编号判定,一至八为高幅
    num = int(re.match(r"^[gvs](\d{1,2})", name).group(1))
    return "HAT" if num <= 8 else "LAT"

print(group_of("r30ofh"), group_of("renl"))
§6 与库内条目的关系
6.1 关系图谱
站内与帕金森病相关的词条已经有一族,其中最容易与本篇混淆的是 nqmitcsxpd。两者的区别不在疾病,而在测量层次。
| 维度 | tremordb | nqmitcsxpd |
|---|---|---|
| 测量对象 | 食指指尖的瞬时速度 | 键盘按键的按下与抬起时刻 |
| 信号形态 | 连续波形,一百赫兹 | 离散事件序列,只有时间戳 |
| 是否有波形 | 有,单通道速度曲线 | 没有,只有打字节奏 |
| 采集场景 | 实验室坐位,手有支撑 | 日常打字,自然情境 |
| 与疾病的关系 | 症状本身的直接测量,无量表分 | 运动迟缓的行为学代理,附 UPDRS-III |
| 可回答的问题 | 幅度与主频如何随刺激改变 | 击键间隔的分布是否异常 |
| 记录粒度 | 一条一分钟曲线 | 一段打字会话的间隔序列 |
一句话分工:tremordb 测的是「手在抖」,nqmitcsxpd 测的是「手在慢」。前者有波形可以拆频,后者只有时序可以算间隔。把两者放进同一个模型里当同质特征,是最常见的错误用法。
站内另有几个资源需要区分。步态三兄弟(gaitndd、gaitdb、gaitpdb)测的是行走,事件是着地,分析对象是间隔;daphnet-fog 测的是冻结步态,用的是下肢加速度;cops 与 parkinsons-disease-smartwatch 用的是腕部惯性传感器,场景是自由生活;ppmi 是纵向队列,规模与目的都完全不同。
| 词条 | 关系 | 一句话区隔 |
|---|---|---|
| nqmitcsxpd | 测量层次互补 | 那边只有击键时序,这边有速度波形 |
| gaitndd | 同一平台的老资源 | 那边测行走节律与相位,这边测静止抖动 |
| gaitdb | 同一平台的更早资源 | 那边十五人两列步幅,这边十六人一百零一条曲线 |
| gaitpdb | 同病不同部位 | 那边是足底压力,这边是食指速度 |
| daphnet-fog | 同病不同症状 | 那边面向冻结步态检测,这边面向震颤抑制 |
| cops | 同病不同设备 | 那边是双腕加速度加症状日记,这边是激光测速 |
| parkinsons-disease-smartwatch | 同病不同场景 | 那边是自由生活的腕表记录,这边是实验室一分钟 |
| ppmi | 队列与实验的分野 | 那边是纵向生物样本队列,这边是一次程控实验 |
| pc-gita | 模态互补 | 那边是语音,这边是运动 |
与 gaitndd 的关系值得多说一句,因为两者常被一起引用。共同点是同一个平台、同一个年代、同一类「小而干净的真实序列」定位,都带原始波形,都适合做方法学试验台。不同点在于信号的性质:步态是准周期的离散事件流,节律分析吃的是间隔序列;震颤是准周期的连续振荡,分析吃的是谱。两者都能算变异,但变异的含义不同——一个是步与步之间的长短差,一个是振幅的包络起伏。
| 维度 | tremordb | gaitndd |
|---|---|---|
| 平台与年代 | PhysioNet,2001 | PhysioNet,2000 |
| 受试者 | 16 例帕金森病,全部术后 | 64 例,三种病加对照 |
| 信号 | 单通道指尖速度 | 双通道足底压阻 |
| 采样率 | 100 Hz | 300 Hz |
| 单条时长 | 约 60 秒 | 300 秒 |
| 派生量 | 无,只发原始序列 | 有,十三列逐拍量 |
| 实验条件 | 八类开关组合 | 无,一次自选步速 |
| 主要分析 | 谱估计、包络、状态对比 | 变异性、长程相关、相位占比 |
6.2 检索路径
tremor 这个词在站内会命中一大片,而这份资源的英文全名里根本没有 tremor 这个词——它的正式名称是「深部脑刺激对帕金森震颤的影响」,检索时必须用 slug 或全名。按 slug 找是最稳的一条路;按病名找会先撞上步态与腕表那几族;按作者找则只能查到三位创建者,查不到论文里的两位临床作者。
实用区分法是看有没有波形:出现「单通道速度曲线、一百赫兹、激光」是 tremordb;出现「击键、间隔、无波形」是 nqmitcsxpd;出现「压阻、双足、十三列」是 gaitndd;出现「三轴加速度、冻结」是 daphnet-fog;出现「腕表、自由生活、症状日记」是 cops。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
看到「一百零一条记录、一百赫兹、八种条件」这三个数字,最容易形成两个误判。第一个是把一百零一当成样本量,于是以为这是一份中等规模的分类数据;第二个是把「一百赫兹连续波形」当成可以任意切窗的通用信号,于是以为能直接喂给以三十秒窗为单位的深度学习管线。
两个误判的根子相同:把「发布了什么」与「发布的东西能支撑什么」混为一谈。一百零一条记录背后是十五个人,其中八个人各贡献八条,同一个人在不同条件下的曲线高度相关,按记录划分必然泄漏。一百赫兹对应的是四到六赫兹的窄带振荡,不是肌电或语音那样的宽带信号,任何依赖高频细节的特征在这份数据上都没有信息。做完这两步校正,两个数字就各归其位。本节评分建立在这个校正之上。
7.1 DAIMS 五维评分
按 DAIMS 五维框架打分,每维二十分,满分一百。分数是相对同类公开运动障碍资源的水平,不是绝对结论。
| 维度 | 得分 | 依据 | 扣分点 |
|---|---|---|---|
| 可发现 | 13 | 有 DOI、有平台页、被非线性动力学文献引用 | 标题不含 tremor 与 database,按关键词检索命中率低 |
| 可获取 | 18 | 免注册、整包三点五兆、无申请流程 | 无可查询接口,无按条件筛选的 API |
| 可互操作 | 10 | 目录按 WFDB 习惯组织,文件名有明确语法 | 头文件字段是占位符,通用工具链读不出 |
| 可复用 | 13 | 许可宽松、条件标签明确、说明表逐条给出量程 | 无量表分、无标定文件、单位在同一库内不统一 |
| 可引用 | 17 | DOI 稳定、有指定论文 | 平台侧无独立数据论文,创建者与论文作者不完全重合 |
| 合计 | 71 | — | — |
七十一分里,扣得最重的是互操作与可发现两项。互操作的问题在头文件:一个没有格式声明的 WFDB 目录只是「长得像 WFDB」,实际必须自己写解码器。可发现的问题在命名:全名里没有 tremor 这个词,slug 又是缩写。
7.2 三处需要自己核对的地方
第一处是靶点例数。官方页面写丘脑底核六例,README 写八例。受试者表里带 s 前缀的编号是 s6、s7、s8、s14、s15、s16,正好六个。所以页面与表一致,README 的八是笔误。两个口径并存,官方未说明哪个权威,按可核对的一侧(表与文件名)走,另一个留作备注。
第二处是四象限的记录条数。页面写五十五条,README 写五十四条,而按类目表相加得十三加十三加十五加十四,正好五十五。记录清单里能对上的也是五十五。同样按可核对的一侧走。
第三处是速度单位。页面上的图注写作「米每秒」,说明表里同时出现毫米每秒与米每秒。这不是矛盾,而是两种量程的两种单位:零点二与零点五伏档记成毫米每秒,一点零与二点零伏档记成米每秒。但两者相差一千倍,混读会得到灾难性的错误。处理原则是逐条读说明表的单位列,不做任何默认假设。
三处都可以用同一条原则处理:不判对错,只按可核对的一侧走,另一侧留在备注里。
7.3 已知的、可枚举的偏差
偏差可以逐条列出,每一条都能在页面、说明表或文件里找到依据。
| 偏差 | 方向 | 依据 | 后果 |
|---|---|---|---|
| 全部术后 | 人群高度选择 | 受试者表无未手术者 | 不能代表未治疗的震颤 |
| 单侧记录 | 左右不可比 | 每人固定一侧 | 无法做对称性分析 |
| 无量表分 | 严重度缺失 | 表内无统一量表列 | 只能高低幅二分 |
| 高低幅按入组理由分 | 分组非测量 | 页面写明手术目的不同 | 组间差异含指征混杂 |
| 单条一分钟 | 时间尺度受限 | 点数除以采样率 | 无法看慢变化 |
| 无重复测量 | 信度未知 | 每人每条件一条 | 无法估计测量误差 |
| 量程不统一 | 幅值不可直比 | 说明表量程五档 | 跨记录比较需先归一 |
| 单位混用 | 数量级风险 | 说明表两列单位 | 误读会差一千倍 |
| 头文件占位 | 工具链不兼容 | format? 与 gain? |
需自写解码器 |
| 无血药浓度 | 剂量反应缺失 | 只有两档用药 | 无法建剂量模型 |
其中最容易被叠加使用的是第五条与第六条。一分钟的记录里,震颤本身可能正处于起伏中;而每个人每个条件只有一条,无法判断这一分钟是否代表该状态的平均水平。§4.2 的案例正好说明这一点:八条记录凑出一张完整的开关表,但这八条各自只有一分钟,任何「恢复曲线的时间常数」都是从四个点估出来的,误差无法从数据内部估计。
7.4 外部验证矩阵
判断一份数据能不能支撑结论,看它被外部怎么用过,比看它自己怎么写更有说服力。
| 验证维度 | 是否有外部证据 | 说明 |
|---|---|---|
| 原始论文内的自证 | 有 | 2001 年论文用同一批记录做幅频分析 |
| 后续非线性动力学研究引用 | 有 | 多篇震颤动力学论文以它为例 |
| 与惯性传感器对照 | 部分有 | 速度与加速度可通过微分互证,但需同批采集 |
| 与肌电同步 | 无 | 采集时无肌电通道 |
| 与量表同步 | 无 | 未记录同期评分 |
| 跨中心重复 | 无 | 单一批次,无第二中心 |
| 长期稳定性 | 无 | 单次实验,无随访 |
第一行值得展开。四象限与停药梯度的设计不是事后拼的,而是 2001 年论文的分析框架直接落成的数据形态:要分离刺激与药物的贡献,就必须有单因素条件;要看恢复过程,就必须有分钟梯度。数据的设计与论文的问题是一件事的两面,这既是优点(内部一致),也是限制(只服务那一组问题)。
7.5 它为何能持续:一个没人再复制的开关梯度
二十五年不更新、三点五兆、十六个人。按现代数据集的标准,它早该被更大的库取代。但它仍被取用,原因不在规模,而在它是少数几份把「刺激关掉之后每一刻钟测一次」这个设计执行完整的公开数据。
想再造一份,难的从来不是设备——一台激光测速仪与一块反光纸并不昂贵——难的是让一批已经手术的患者在停药十二小时、关掉刺激一小时的条件下,安静坐着被反复测量五次。这是临床上的麻烦,也是伦理上的门槛。稀缺的不是人数,是一个愿意被这样折腾一小时的队列。
§8 生态位与历史
8.1 历史沿革
PhysioNet 在 2000 年前后上线了一批小型生理信号合集,覆盖心电、呼吸、步态、震颤等节律,定位都是「小而干净的真实序列」,供方法学研究与教学使用。tremordb 是其中体量最小的一批之一,也是少数把实验条件写进文件名的。
| 阶段 | 时间 | 发生了什么 |
|---|---|---|
| 实验 | 1993 至 2001 | 十六例患者陆续手术并接受程控测试 |
| 论文 | 2001 | 结果发表于 Thalamus & Related Systems |
| 上线 | 2001-08-27 | 1.0.0 版发布,一百零一条记录 |
| 整理 | 2001-10 至 11 | 说明表、示意图与目录补齐 |
| 迁移 | 2020-08-07 | 校验和文件重新生成,内容未变 |
| 现状 | 至今 | 仅此一版,无后续更新 |
第四行说明这个库是分批整理完的:记录清单在八月上线,说明表到十月才补齐,示意图在十月下旬。也就是说,早期下载的人拿到的可能是一个没有说明表的版本。这解释了为什么有些二手描述里对量程与单位的记载互相矛盾。
8.2 与同期资源的分工
同期还有几类资源在解决相邻问题:心率变异性库做心搏间期,方法同源而生理系统不同;睡眠与呼吸节律库把尺度拉到数小时,事件定义换成呼吸与觉醒;步态库精于间隔序列,代价是需要行走场地;惯性传感器库把场景搬到自由生活,代价是姿态与佩戴位置带来的伪迹。tremordb 站在最窄的一端:一个人、一根手指、一分钟。时间尺度上,它比心率变异性库还短一个数量级;条件密度上,它比任何一类都细。
8.3 生态位:程控门诊的档案馆
在机器学习语境里,它排不上号;在神经调控的生理学语境里,它占一个规模无法替代的位置:一份把程控参数与即时反应对应起来的档案。
临床上一个常见的困惑是:同样的参数,为什么这个患者震颤立刻消失,那个患者只是减轻。回答它需要同一批人在不同参数下的即时反应,而这类数据几乎不出实验室,通常留在病历里。tremordb 给出的是一小片公开版:不是全部参数组合,而是「开」与「关」两个极端,外加关掉之后的一小时。
8.4 谁在用它,用来做什么
从公开文献看,使用者集中在三类:做非线性时间序列方法的工程与应用数学组、做运动控制与震颤机制的生物力学组、做神经调控疗效评估的临床研究组。三类用法的共同点是把它当试验台或对照,而不是训练素材。方法学组要全部一百零一条曲线,用来比较谱估计与复杂度指标在短序列上的稳定性;生物力学组要同一人的多条记录,分析幅频随状态的耦合;临床组只取四象限与梯度子集,描述刺激与药物的相对贡献。教学场景则往往只用一个人的八条,把实验设计与条件编码讲一遍。
§9 使用指引
9.1 三种角色的路径
| 角色 | 第一步 | 第二步 | 第三步 |
|---|---|---|---|
| 方法学研究者 | 读说明表确认量程与单位 | 用 §5.3 的解析器把一百零一条全部结构化 | 在按人分组的切分下跑你的估计量 |
| 生物力学研究者 | 先看一个人八条的量程跳变 | 用 §4.2 的案例检查单条曲线 | 组内先做个体曲线,再做组间描述 |
| 临床研究者 | 明确高低幅是入组理由 | 只在四象限内做配对比较 | 跨靶点结论必须写明混杂 |
三条路径的共同点是先看单条、再看多条。跳过第一步直接跑全量,容易在两处翻车:不读单位列会把毫米每秒与米每秒混算;不按人分组会把同一个人的八条当成八个独立样本。
9.2 一条最短的可用流程
从下载到一张按状态汇总的表,三步。
#-- 第一步:取全量并校验
mkdir -p data && cd data
wget -q -r -N -c -np -nH --cut-dirs=3 \
  -P tremordb https://physionet.org/files/tremordb/1.0.0/
cd tremordb && sha256sum -c SHA256SUMS.txt > /dev/null && echo ok
import glob
import os
import re
import pandas as pd

PAT = re.compile(r"^([gvs])(\d{1,2})r(\d{2})?([eo])([nf])$")

def parse(name):
    g = PAT.match(os.path.splitext(name)[0]).groups()
    return {
        "subject": g[0] + g[1],
        "group": "HAT" if int(g[1]) <= 8 else "LAT",
        "pause_min": int(g[2]) if g[2] else 0,
        "dbs_on": g[3] == "e",
        "med_on": g[4] == "n",
        "side": "left" if name.endswith(".let") else "right",
    }

rows = []
for path in sorted(glob.glob("data/tremordb/*/*.let") + glob.glob("data/tremordb/*/*.rit")):
    r = parse(os.path.basename(path))
    r["bytes"] = os.path.getsize(path)
    rows.append(r)

idx = pd.DataFrame(rows)
print(idx.groupby(["group", "dbs_on", "med_on"]).size())
打印出的表按组别、刺激状态、用药状态交叉计数。它的用途不是下结论,而是在建模之前先确认三件事:每组人数对不对、四象限的分布是否符合官方页面、有没有整类缺失。任何一项异常,先回到 §5.5 的检查流程,而不是继续往下算。
9.3 引用方式
| 对象 | 引用内容 |
|---|---|
| 数据 | Beuter A, Titcombe MS, Glass L. Effect of Deep Brain Stimulation on Parkinsonian Tremor (version 1.0.0). PhysioNet. 2001. doi:10.13026/C2D097 |
| 指定论文 | Beuter A, Titcombe MS, Richer F, Gross C, Guehl D. Effect of deep brain stimulation on amplitude and frequency characteristics of rest tremor in Parkinson’s disease. Thalamus & Related Systems. 2001;1(3):203–211 |
| 平台 | Goldberger A, Amaral LAN, Glass L, et al. PhysioBank, PhysioToolkit, and PhysioNet. Circulation. 2000;101(23):e215–e220 |
两件事容易漏。第一,只引平台不引论文,会让后来者找不到器械与条件的完整说明,因为页面上的描述是论文的压缩版。第二,许可是署名制,成果里必须致谢数据来源,不能只写「数据来自公开库」。
§10 AI 使用声明
| 项目 | 说明 |
|---|---|
| 写作方式 | 人工阅读官方页面、README 与三张说明表后撰写,AI 参与资料整理与文字组织 |
| 事实来源 | PhysioNet 项目页、README、RECORDS、subject_description.txt、file_description.txt、renh.hea 与 r30ofh.hea |
| 未做的事 | 未做分布统计,未训练任何模型,未计算组间显著性,未复现论文结果 |
| 数字口径 | 人数与分组以页面与受试者表为准,记录数与时序以 RECORDS 与说明表为准 |
| 口径冲突 | 丘脑底核例数、四象限记录条数、速度单位三处并列 |
| 未核实项 | 测试地点、单条曲线的临床评分、量程选档规则、波形解码细节 |
| 许可判断 | 按页面标注的 ODC 署名 1.0 表述,不代替法律意见 |
| 适用边界 | 仅描述数据资源,不构成临床诊断或程控建议 |
常见误读(避坑清单)
| 说法 | 实际 | 证据 |
|---|---|---|
| 这是一个收纳各类震颤的通用库 | 只有帕金森病静止性震颤,只有食指一个部位 | 页面数据描述段,震颤类型字母恒为 r |
| 十六个人就是十六份数据 | 十六人入组,十五人有记录,v3 一条也没有 | RECORDS 一百零一行,前缀无 v3 |
| 一百零一条记录等于一百零一个样本 | 一百零一条来自十五人,八人各贡献八条 | 记录清单按人归并 |
| 数据是加速度 | 是速度,单位毫米每秒或米每秒 | 页面器械描述与说明表单位列 |
| 幅值可以直接横向比较 | 量程五档、单位两种,相差可达一千倍 | 说明表 RANGE 与 VELOCITY 两列 |
| 它是标准 WFDB 记录,可以直接读 | 头文件格式与增益是占位符 | renh.hea 与 r30ofh.hea 原文 |
| 高幅低幅是测出来的严重度 | 是按手术指征的事后分组 | 页面分组描述 |
| 用药有两档就等于有剂量反应 | 只有停药与一点五倍晨剂两档,无血药浓度 | 页面条件说明 |
| 丘脑组有三人份数据 | 只有两份,且各两条记录 | RECORDS 中 v3 缺失,v4 与 v5 各两条 |
| 每个人左右手都测了 | 每人固定测一侧 | 文件名扩展名逐人唯一 |
| 每条都是标准六十秒 | 点数换算从三十四秒到一百二十一秒 | 说明表 SAMPLES 列除以一百 |
FAQ
Q1:tremordb 到底有多少名受试者?
官方页面写十六例,分高幅与低幅各八例。但记录清单里只有十五个人的前缀,编号 v3 没有任何记录。所以「入组十六人、有数据十五人」要分开表述。
Q2:它测的是加速度、速度还是位移?
速度。设备是低强度激光测速仪,激光打在食指指甲的反光纸上,输出电压与指尖速度成正比。单位在说明表里写作毫米每秒或米每秒,随量程档位而变。
Q3:为什么头文件读不出数据?
每个子目录一份头文件,里面格式与增益两个字段写成占位符,没有给出存储格式编号与标定系数。通用 WFDB 读取器读到这种头文件会失败。可用的元数据在说明表里。
Q4:同一个人的八条记录能当八个样本吗?
不能。八条记录来自同一只手、同一套电极、同一天,彼此高度相关。要按人分组做交叉验证,否则同一个人会同时出现在训练集与测试集。
Q5:能用来训练震颤检测或分型模型吗?
只能做有限的可行性试验。十五人、一百零一条,没有独立测试集,也没有第二个中心的数据做外部验证。真要试,用留一人交叉验证,并写明结论不外推。
Q6:幅值怎么比较才不出错?
先读说明表的单位列,把毫米每秒与米每秒统一,再看量程档位是否相同。两档之间的比例关系只能从量程推出,官方没有给逐条的标定曲线。
Q7:关刺激后的恢复曲线怎么用?
四条记录分别对应第十五、三十、四十五、六十分钟。它们都是停药状态,可与 rof 一起排成五点时序。但每个点只有一分钟、只有一条,时间常数只能粗估。
Q8:它和 nqmitcsxpd 有什么本质区别?
nqmitcsxpd 记录的是键盘按键的时序,没有波形,测的是运动迟缓的行为学代理;tremordb 记录的是指尖速度波形,测的是震颤本身。一个算间隔,一个做谱。
Q9:能用来研究特发性震颤吗?
不能。库里全部是帕金森病,且全部已植入脑深部电刺激器。特发性震颤的靶点、频率与药物反应都不同,这份数据没有对应样本。
Q10:为什么有些记录只有三十几秒?
点数在三千四百到一万二千一百之间,换算成时间是三十四到一百二十一秒。官方只说约六十秒。短的那些可能是采集提前终止,但页面未给原因。
Q11:引用时只引 PhysioNet 页面行不行?
不行。页面明确要求引用 2001 年那篇论文,器械与条件的完整说明在那篇里。规范做法是 DOI 与论文同时给出。
术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 静止性震颤 | rest tremor | 肢体在无支撑放松状态下出现的节律性抖动 |
| 姿势性震颤 | postural tremor | 维持某一姿势时出现的抖动,本库不涉及 |
| 脑深部电刺激 | deep brain stimulation | 植入电极对皮质下核团施加高频电脉冲 |
| 丘脑底核 | subthalamic nucleus | 常用刺激靶点,代号 s |
| 苍白球内侧部 | internal globus pallidus | 常用刺激靶点,代号 g |
| 丘脑中腹中间核 | ventro-intermediate nucleus | 常用刺激靶点,代号 v |
| 高幅震颤组 | high amplitude tremor | 以缓解震颤为主要手术目的的八例 |
| 低幅震颤组 | low amplitude tremor | 以缓解僵硬或异动为主要目的的八例 |
| 激光测速仪 | laser velocity transducer | 通过反射光频移测量表面速度的装置 |
| 量程 | range | 采集设备的电压档位,本库五档 |
| 精度 | precision | 该量程下可分辨的最小速度,与量程成反比 |
| 削顶 | clipping | 信号超出量程上限被截断,造成幅值失真 |
| 采样率 | sampling rate | 每秒采样次数,本库一百赫兹 |
| 主频 | dominant frequency | 谱图中功率最大的频率成分 |
| 谐波 | harmonic | 主频整数倍处的成分 |
| 均方根 | root mean square | 序列的幅度度量,单位与原始信号一致 |
| 包络 | envelope | 幅度随时间的慢变化曲线 |
| 四象限 | four-quadrant design | 刺激开/关与用药开/关交叉出的四种状态 |
| 停药梯度 | stimulation-off ladder | 关闭刺激后每十五分钟一次的复测序列 |
| 程控 | programming | 调整刺激参数的门诊操作 |
| 触点 | contact | 电极上的导电环,决定电流分布 |
| 脉宽 | pulse width | 每个电脉冲的持续时间,单位微秒 |
| 分散型左旋多巴 | dispersible levodopa | 可溶于水的左旋多巴制剂,起效较快 |
| 关期 | off state | 药物失效、症状重新出现的时段 |
| 记录清单 | RECORDS | 列出全部记录名的纯文本文件 |
| 校验和 | checksum | 用于验证文件完整性的哈希值 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 层级 |
|---|---|---|---|
| 受试者入组数 | 16 | 页面、受试者表 | 两处一致 |
| 有记录人数 | 15 | RECORDS 去重 | 文件本身 |
| 高幅组人数 | 8 | 页面、受试者表 | 一致 |
| 低幅组人数 | 8 | 页面、受试者表 | 一致 |
| 苍白球组人数 | 7 | 受试者表、文件名前缀 | 一致 |
| 丘脑组人数 | 3 | 受试者表、文件名前缀 | 一致 |
| 底核组人数 | 6 | 受试者表;README 写 8 | 两处不一致 |
| 记录总数 | 101 | RECORDS 行数、页面类目相加 | 一致 |
| 高幅组记录数 | 37 | 页面、RECORDS 统计 | 一致 |
| 低幅组记录数 | 64 | 页面、RECORDS 统计 | 一致 |
| 采样率 | 100 Hz | 头文件、说明表 | 一致 |
| 单条点数范围 | 3400 至 12108 | 说明表 | 文件本身 |
| 单条时长范围 | 34 至 121 秒 | 点数除以采样率 | 推算 |
| 量程档数 | 5 | 头文件注释、说明表 | 一致 |
| 目录数 | 16 | 文件树 | 文件本身 |
| 未压缩体积 | 3.5 MB | 页面 | 官方页面 |
| 许可 | ODC 署名 1.0 | 页面 | 官方页面 |
| DOI | 10.13026/C2D097 | 页面 | 官方页面 |
| 上线日期 | 2001-08-27 | 页面、RECORDS 时间戳 | 一致 |
| 版本 | 1.0.0 | 页面 | 官方页面 |
附录 B:数字的来源分层
| 层级 | 含义 | 本页涉及的项 |
|---|---|---|
| 官方页面 | PhysioNet 项目页直接给出 | 十六例、三靶点、八类条件、五十五条、体积、许可、DOI、日期 |
| README 与说明表 | 随数据发布的文档 | 库名、创建者、机构、靶点八例的说法、五十四条的说法、逐条量程与点数 |
| 文件本身 | 目录树、记录清单、头文件 | 十五人有记录、十六个目录、头文件占位符、每条的单位与点数 |
| 推算 | 由上述数据换算 | 单条时长(点数除以采样率)、量程与精度的对应 |
附录 C:完整参考文献
- Beuter A, Titcombe MS, Richer F, Gross C, Guehl D. Effect of deep brain stimulation on amplitude and frequency characteristics of rest tremor in Parkinson’s disease. Thalamus & Related Systems. 2001;1(3):203–211.
- Beuter A, Titcombe MS, Glass L. Effect of Deep Brain Stimulation on Parkinsonian Tremor (version 1.0.0). PhysioNet. 2001. doi:10.13026/C2D097.
- Goldberger A, Amaral LAN, Glass L, et al. PhysioBank, PhysioToolkit, and PhysioNet: components of a new research resource for complex physiologic signals. Circulation. 2000;101(23):e215–e220.
- Pollard T, Moody BE, Lehman L, et al. PhysioNet as a global platform for biomedical research. Nature Health. 2026;1(8):792–795. doi:10.1038/s44360-026-00096-z.
附录 D:任务代码
把这份数据用于「同一个人跨状态的主频与幅值对比」时,最短的一段流程如下。它只做三件事:解析条件、按人归并、把结果排成一张表。
import os
import re
import numpy as np
import pandas as pd

PAT = re.compile(r"^([gvs])(\d{1,2})r(\d{2})?([eo])([nf])$")

def parse(name):
    g = PAT.match(os.path.splitext(name)[0]).groups()
    return {"subject": g[0] + g[1],
            "pause_min": int(g[2]) if g[2] else 0,
            "dbs_on": g[3] == "e",
            "med_on": g[4] == "n"}

def load_series(path):
    #-- 按单字节读入再转有符号整数仅为占位,实际位宽须用字节数除以点数确认
    raw = np.frombuffer(open(path, "rb").read(), dtype=np.int8).astype(float)
    return raw

def spectrum_peak(x, fs=100.0, band=(3.0, 10.0)):
    x = x - x.mean()
    f = np.fft.rfftfreq(len(x), d=1.0 / fs)
    p = np.abs(np.fft.rfft(x)) ** 2
    sel = (f >= band[0]) & (f <= band[1])
    return float(f[sel][np.argmax(p[sel])])

rows = []
for d in sorted(os.listdir("data/tremordb")):
    sub = os.path.join("data/tremordb", d)
    if not os.path.isdir(sub):
        continue
    for fn in sorted(os.listdir(sub)):
        if not fn.endswith((".let", ".rit")):
            continue
        r = parse(fn)
        r["file"] = fn
        r["group"] = "HAT" if int(r["subject"][1:]) <= 8 else "LAT"
        rows.append(r)

idx = pd.DataFrame(rows)
print(idx[idx.subject == "g2"].sort_values("pause_min")[["file", "dbs_on", "med_on", "pause_min"]])
两个细节值得注意。第一,主频必须限定在四到十赫兹的窄带里找,否则低频漂移会抢走峰值。第二,同一个人的多条记录要放在一起看,跨人的汇总只能报告组内中位数,因为六到八人的组做显著性检验没有解释价值。
附录 E:如果只记五件事
第一,它是十六个人、十五份数据、一百零一条记录。记录数不是样本量。
第二,它测的是速度,不是加速度。单位在毫米每秒与米每秒之间跳,差一千倍。
第三,条件不在表里,在文件名里。七段字符,缺一段就错位。
第四,它的独特之处是关刺激后的四档分钟梯度,这是同类公开数据里少见的。
第五,它和 nqmitcsxpd 不是一回事:一个测手在抖,一个测手在慢。
编辑说明
核验时间 2026 年 10 月 28 日。核验方式为直接抓取 PhysioNet 项目页与 README,读取记录清单、受试者表、文件说明表与两份分组头文件,并按文件名逐条结构化为条件表;未做任何谱分析,未计算组间差异,未复现论文结论。官方页面与随数据文档在靶点例数(页面六例、README 八例)、四象限记录条数(页面五十五条、README 五十四条)、速度单位(图注米每秒、说明表两种单位并存)三处存在并列口径,文中均按原样呈现,未作裁定,只在能由受试者表与文件名核对的地方标注了可核对的一侧。数据版本为 1.0.0,自 2001 年起未更新;若平台改版导致目录结构变化,下载面与文件清单需重新核对。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- pc-gita — 共享标签:生理信号 / 神经科学 / 帕金森病
- nqmitcsxpd — 共享标签:生理信号 / 神经科学 / 帕金森病
- tappy — 共享标签:生理信号 / 神经科学 / 帕金森病
- emgdb — 共享标签:生理信号 / 神经科学
- sgamp — 共享标签:生理信号 / 神经科学
- phdsm — 共享标签:生理信号 / 神经科学
- cardioresp-response-orthostat — 共享标签:生理信号 / 神经科学
- earh — 共享标签:生理信号 / 神经科学
- earndb — 共享标签:生理信号 / 神经科学
- mouse-stroke-cylinder-rearing — 共享标签:生理信号 / 神经科学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
