信息速览
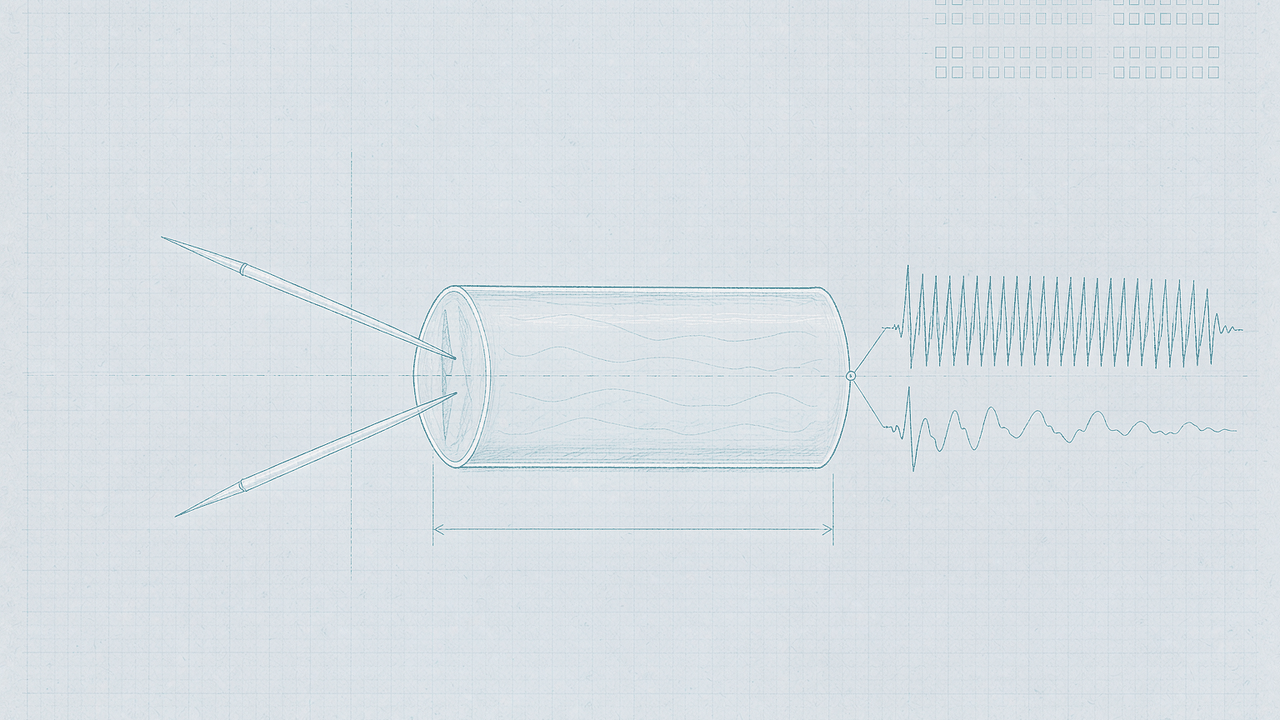
一根直径接近一毫米的神经纤维,被两根电极从侧面扎进去:一根往里面灌电流,一根在旁边读电压。六十多年前,正是这套装置把动作电位拆成了钠与钾两条电流通路,也把「神经元可以用方程写出来」变成了可检验的命题。SGAMP 是这套装置留下的原始痕迹之一,由 PhysioNet 在 2016 年 4 月 15 日以 1.0.0 版发布,DOI 10.13026/C25C73。
名字容易被读错。SGAMP 不是肌电缩写,展开是 Squid Giant Axon Membrane Potential,即枪乌贼巨轴突膜电位。它没有肌肉、没有运动单位、没有针极贴在人的皮肤上;研究对象是北美枪乌贼(Loligo pealei)的巨大轴突,一种被离体制备之后仍能存活数小时的单根神经纤维。整个库只有 8 条这样的纤维,共 170 次试验,每次试验给出膜电位与刺激电流两路信号。
体量小并不等于门槛低。它的采样率是 125 kHz,比多数临床生理信号高一个数量级;它的原始值没有被标定成常规物理单位,需要按官方给的增益自己换算;它的刺激分两类,一类是随机叠加电流,一类是单个脉冲,两类混在同一批记录里。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 官方全名 | Squid Giant Axon Membrane Potential |
| 缩写展开 | SGAMP = Squid Giant Axon Membrane Potential |
| 发布平台 | PhysioNet(MIT Laboratory for Computational Physiology) |
| 版本与日期 | 1.0.0,2016 年 4 月 15 日 |
| DOI | 10.13026/C25C73 |
| 原始实验作者 | Paydarfar D、Forger DB、Clay JR |
| 生物对象 | 北美枪乌贼 Loligo pealei 巨轴突,8 条 |
| 试验数 | 170 次(记录清单逐行列出) |
| 通道 | 2 路:膜电位 Vmembrane、刺激电流 Istim |
| 采样率 | 125 kHz |
| 单次时长 | 数秒量级,由头文件样本数决定 |
| 采集设备 | DATAQ Instruments,值转成 MIT(WFDB)格式 |
| 存储格式 | WFDB:.hea 文本头文件 + .dat 16 位整型 |
| 体积 | 未压缩约 901.7 MB |
| 访问与许可 | 开放访问,ODC-By 1.0,无需签署协议 |
| 配套文件 | Irms.txt、Recording-Info.ods、RECORDS、SHA256SUMS.txt |
§1 它要解决的具体麻烦
1.1 一段被噪声推来推去的起搏活动
主引用论文的题目已经把问题说完了:Noisy Inputs and the Induction of On–Off Switching Behavior in a Neuronal Pacemaker。神经元振荡器不总是老老实实地按固定频率放电,它可以在两种稳定状态之间跳:一种是安静,一种是节律性放电。当这两个状态离得很近时,理论上一点点噪声就足以让它来回翻。论文摘要的措辞是「small noisy stimulus currents induce a multitude of paths between two nearby stable states」,即微小的噪声刺激电流会在两个相邻稳定态之间引出大量路径。
这句话需要一次实验来兑现。作者用的是灌流的枪乌贼轴突标本,这在电生理里是最经典的离体制备:一根足够粗的轴突,可以把两根电极都塞进轴浆里,一根记录膜电位,一根注入电流,中间没有细胞膜的第二道阻隔。在这类标本上,噪声不是一个统计假设,而是一段可以逐点写进刺激电流波形里的、真实存在的随机信号。
SGAMP 就是这批实验的原始记录被整理公开的形态。它要解决的麻烦不是「缺一个数据集」,而是「这篇论文里那张关于噪声诱导翻转的图,别人能不能拿着原始波形重画一遍」。数据库的存在让这件事从「按描述复现」变成「按样本重算」。
1.2 三条常见的错误期待
第一条是把 SGAMP 当成肌电。四个字母确实长得像 sEMG 的重排,PhysioNet 上也有大量以 EMG 结尾的库。但它的对象是神经轴突,不是肌纤维,测的是跨膜电位,不是肌纤维外部的容积传导电位。两者在信号形态上也不像:表面肌电是许多运动单位电位的叠加,一条包络线;这里是一条纤维、一次一个动作电位,时间轴上是一串间隔清楚的大尖峰。
第二条是以为它体量大、能训练模型。170 次试验、8 条轴突,一位数乘以两位数,还不到两百份记录。任何按常规机器学习口径规划的团队,看到这个数字都会立刻明白它不是训练集。它的规模刚好够做参数标定、够做几次交叉验证、够做教学演示,但不够做统计学习。
第三条是以为开放下载就等于开箱即用。它是开放的,匿名就能拉整包,这一点比多数 PhysioNet 资源友好。可是打开文件之后,迎面而来的是两路以伏为单位、未标定、电流通道还带直流偏置的原始值。开箱之后仍要做的换算与校准,才是这份数据真正的入口成本。
三条期待指向同一个习惯:先看缩写,再看标题,不读展开。补上展开这一步,期待会自动回到正确位置。
1.3 它能给到的与给不到的
把需求拆成一行行来对,比读摘要快。
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 神经元双稳态与噪声诱导翻转的原始波形 | 170 次试验,刺激电流逐点保存 | 够,且是唯一一手材料 |
| 单根轴突的动作电位形态 | 125 kHz 膜电位,尖峰细节完整 | 够,采样密度远超需求 |
| 神经起搏器模型(如 HH 型方程)的标定 | 膜电位与注入电流成对 | 够,前提是先完成单位换算 |
| 刺激强度与翻转概率的关系 | 逐次试验的均方根电流表 | 部分够,强度不是分级设计 |
| 跨个体或跨物种的泛化 | 8 条轴突,同一物种 | 不够,样本量不足 |
| 肌肉或运动单位相关分析 | 无 | 不够,对象是神经不是肌肉 |
| 带标注的动作电位序列 | 无标注文件 | 不够,须自己检测 |
| 完整的实验元数据(温度、电极内液、标本来源批次) | 页面未给 | 不够,要读论文 |
| 现成的物理单位记录 | 页面称有,下载里没有 | 部分够,须自行换算 |
| 训练深度网络的大规模语料 | 170 份记录 | 不够,量级差两三个数量级 |
前四行是可以被直接满足的需求,中间三行是部分满足,最后三行是明确不满足。分界线不在难易,而在这份数据被设计出来要回答的问题是什么:它服务于机制,不服务于规模。
1.4 你的处境与它能帮到的事
下面这张表按处境组织,不按特性组织。左列是你眼下的状态,中间是它能帮上的部分,右列是接下来该做的一步。
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 正在复现一篇噪声诱导放电翻转的论文 | 提供原文那批试验的一手波形 | 先按 §5.3 的换算把两路单位摆正 |
| 想给自己的神经元模型找真实标定数据 | 膜电位与注入电流成对出现 | 用 §9.2 的最小流程跑通一条记录 |
| 要给研究生讲电流钳与电压记录的区别 | 两路信号并列存放,对照直观 | 下载整包 901.7 MB,不必挑记录 |
| 在做动作电位检测算法的小样本测试 | 125 kHz 采样,尖峰边界清楚 | 自己写检测,库不带标注 |
| 想找一个神经电生理的入门公开库 | 开放许可、匿名可取、总体积不到 1 GB | 从 a1t01 这样的小记录开始 |
| 需要大量样本训练分类器 | 170 次试验 | 换一个规模更大的电生理档案库 |
| 要给医疗器械做临床验证 | 离体标本,无人体数据 | 这一份不能作为临床证据 |
| 需要发表时可引用的规范出处 | DOI 与四篇论文齐备 | 按 §9.3 两段式引用 |
1.5 一句话判断
它不是一个数据集工程,而是一篇论文的实验附录:把一次关于噪声如何打开与关闭神经起搏器的实验,按原始样本的粒度摊开,代价是只有八条轴突,且所有物理单位都要自己换算。
1.6 不适合谁:四条边界
第一条是规模驱动的项目。需要上万条波形、需要做深度网络预训练、需要统计显著性检验的团队,170 次试验连一次像样的分层抽样都支撑不住。它和那些以千小时计的生理信号库不在同一个量级上,硬凑只会让结论全部依赖于少数几条轴突。
第二条是人体或临床方向的项目。这里没有受试者、没有伦理批件编号、没有年龄性别,因为它根本没有人的数据。任何以患者人群为卖点的研究,在这一份里找不到任何样本。
第三条是需要现成标注的项目。库里有记录,没有动作电位时间戳,没有「这一段是安静、那一段是放电」的分期标签。要拿它做监督学习,第一步就得自己把标注做出来,而这一步的可重复性完全取决于你的检测器。
第四条是需要即插即用的工程队。整包不到 1 GB 这件事很友好,但换算规则不统一、physical 目录缺失、单位标注与数值相差三个数量级,这三件事叠在一起,意味着从下载到第一条可信波形之间必须过一次人工核对。赶工期时选择它,容易在第一小时就卡住。
§2 数据构成与规格
2.1 一个目录、三种清单、两路信号
下载解开之后,根目录的结构简单到不需要导航:一个 raw 子目录装全部记录,其余四份是清单与说明。这种「一目录到底」的布局在 PhysioNet 上属于早期项目的典型做法,它没有按会话、按受试者分层,只靠文件名编码两个维度的身份。
| 路径 | 类型 | 内容 | 官方口径 |
|---|---|---|---|
raw/ |
目录 | 170 个 WFDB 记录,每个两文件 | 原始未标定值 |
Irms.txt |
文本 | 170 行,试验号与均方根电流 | 仅随机电流段有数值 |
Recording-Info.ods |
表格 | 逐次试验的说明 | 官方建议查阅 |
RECORDS |
文本 | 170 行记录名清单 | 与目录一一对应 |
SHA256SUMS.txt |
文本 | 全部文件的校验值 | 2019 年补入 |
RECORDS 这份清单值得单独说一句:它只有一列,每行是一个 raw/aXtY 形式的相对路径,共 170 行。PhysioNet 的 WFDB 工具链默认读这份文件来决定「有哪些记录」,因此清单与目录是否一致,直接决定 wfdb 能不能不指定文件名就批量遍历。
2.2 字段与记录的完整字典
头文件是全库信息密度最高的地方。以 a1t01 为例,三行文本把一份记录的全部结构讲完了。
a1t01 2 125000 1571801
a1t01.dat 16 63768.912(4471)/V 0 0 -21246 -10102 0 Vmembrane
a1t01.dat 16 87578.2264(-2619)/V 0 0 -2512 13970 0 Istim
三行的字段含义按 WFDB 规范是固定的,逐项拆开如下。
| 行 | 字段序 | 值(以 a1t01 为例) |
含义 |
|---|---|---|---|
| 第 1 行 | 1 | a1t01 |
记录名 |
| 第 1 行 | 2 | 2 |
信号通道数 |
| 第 1 行 | 3 | 125000 |
采样率,赫兹 |
| 第 1 行 | 4 | 1571801 |
每通道样本数 |
| 第 2 行 | 1 | a1t01.dat |
数据文件名 |
| 第 2 行 | 2 | 16 |
每样本位宽 |
| 第 2 行 | 3 | 63768.912 |
通道 1 的 ADC 增益(整型单位/伏) |
| 第 2 行 | 3 括号 | 4471 |
通道 1 的基线(零点偏移) |
| 第 2 行 | 4 | /V |
单位声明,伏 |
| 第 2 行 | 末位 | Vmembrane |
通道 1 名称,膜电位 |
| 第 3 行 | 3 | 87578.2264 |
通道 2 的 ADC 增益 |
| 第 3 行 | 3 括号 | -2619 |
通道 2 的基线 |
| 第 3 行 | 末位 | Istim |
通道 2 名称,刺激电流 |
两个增益数字的比值是一个有用的小事实:约 8.8 万除以约 6.4 万,接近 1.37。这意味着同样的 1 比特量化步长,落到电流通道上代表的物理量比落到电位通道上更细。用 16 位整型覆盖正负满量程,电位侧一格约 15.7 微伏,电流侧一格折算之后更小。对 125 kHz 的采样来说,这个量化精度不算瓶颈。
每通道样本数这一列则透露出时长。a1t01 是一百五十七万多个样本,除以十二万五千,约十二点六秒;而同一批里 a1t18 只有二十五万样本,约两秒。官方说「each record lasts in the order of several seconds」,这句话的跨度是真实的:从两秒到十余秒都在「数秒量级」里。
2.3 一条记录的完整解剖
一份记录在磁盘上永远是两个文件。.hea 是上面那三行文本,.dat 是二进制。按格式 16 的规定,样本按「帧」交错:第 1 个样本属于通道 1,第 2 个属于通道 2,第 3 个又回到通道 1,如此往复。因此 a1t01 的 .dat 体积除以 2 字节、再除以 2 通道,正好应还原出 1571801。
可以用一段最朴素的读取代码验证这件事,不依赖 wfdb 包。
#-- 不依赖 wfdb:手工解析格式 16 的交错二进制
import numpy as np

name = 'raw/a1t01'
head = open(name + '.hea', encoding='utf-8').read().splitlines()
rec, n_sig, fs, n_samp = head[0].split()
n_samp = int(n_samp)

#-- 每行通道注释里取出增益与基线
ch = []
for line in head[1:]:
    f = line.split()
    gain, base = f[2].split('(')
    ch.append((f[-1], float(gain), int(base.rstrip(')'))))

raw = np.fromfile(name + '.dat', dtype='<i2').reshape(-1, 2)[:n_samp]
for i, (nm, gain, base) in enumerate(ch):
    phys = (raw[:, i].astype(float) - base) / gain
    print(nm, '样本数', len(phys), '中位数 %.3f' % np.median(phys), '单位见头文件末字段')
print('声明采样率', fs, 'Hz;推断时长 %.2f s' % (n_samp / int(fs)))
跑通之后,这份记录的形状就完整了:一个两列、一百五十多万行、值域跨越正负几百的矩阵,采样间隔 8 微秒。把它画出来,上面那条会看到一串宽度极窄、幅度骤升的尖峰,下面那条是一条缓慢游走、局部还带毛刺的电流曲线。
| 观察项 | 通道 1 Vmembrane | 通道 2 Istim |
|---|---|---|
| 物理意义 | 跨膜电位差 | 注入的刺激电流 |
| 典型基线 | 负值,远离零 | 刺激关闭时应为零 |
| 快变量 | 动作电位的上升与下降支 | 脉冲边沿、噪声毛刺 |
| 慢变量 | 阈下电位的漂移 | 随机电流的包络 |
| 是否带直流偏置 | 无(膜电位本身可为负) | 有,官方明说须去偏置 |
| 是否需要换算 | 需,除 0.1 得伏 | 需,1 伏折 5 微安每平方厘米 |
2.4 八条轴突与一百七十次试验
RECORDS 清单的分布是全库唯一可以按文件名直接读出的结构信息。八条轴突的试验数并不平均:登记为 a6 的那一条贡献了五十二次,是整库的将近三分之一;a3 只有八次。
| 记录名段 | 试验编号范围 | 试验数 | 占全库比例 |
|---|---|---|---|
a1 |
t01 至 t22 | 22 | 约八分之一 |
a2 |
t01 至 t11 | 11 | 约十五分之一 |
a3 |
t01 至 t08 | 8 | 约二十一分之一 |
a4 |
t01 至 t23 | 23 | 约七分之一 |
a5 |
t01 至 t22 | 22 | 约八分之一 |
a6 |
t01 至 t52 | 52 | 约三分之一 |
a7 |
t01 至 t12 | 12 | 约十四分之一 |
a8 |
t01 至 t20 | 20 | 约八点五分之一 |
编号连续、无缺号,这一点对批量读取有用:只要知道某条轴突的最大编号,就能用一个 for 循环把它的全部试验扫完,不必先读 RECORDS。但也要注意,编号连续不代表试验条件连续,a6 为什么做了五十二次,页面没说,Recording-Info.ods 是唯一可能的解释来源。
2.5 刺激的两类:随机叠加电流与单个脉冲
官方把刺激分成两组,这是全库最重要的分类维度,因为它决定了指标的可用性。
| 组别 | 官方措辞 | Irms 表里的样子 |
可比较的量 |
|---|---|---|---|
| 随机叠加电流 | stochastically summated polysynaptic currents | 一列数值 | 均方根电流,单位微安每平方厘米 |
| 单个电流脉冲 | individual current pulses | 字面量 PULSE |
无均方根值 |
Irms.txt 只有 170 行,其中 7 行写的是 PULSE,其余 163 行是数值。这 163 个数值的跨度是从 0.0472 到 2.4498,单位按官方说明是微安每平方厘米。它们不是等间距的分级,也不构成一条被设计过的强度序列;更像是每次试验各按实验需要设定的结果,被事后汇总成一张表。
这一点对分析的直接影响是:想做「刺激强度—翻转概率」的曲线,不能指望这里有现成的分级设计。你得自己把它们按数值排序、分箱,并为每一档找够样本,而 163 次试验分到若干档里,每档的样本会很薄。
§3 它是谁的:一篇论文的原始记录
3.1 三位作者与一条研究线
页面列出的作者是 Paydarfar D、Forger DB、Clay JR。这三个人在噪声与神经兴奋这条线上合作了不止一次,PhysioNet 的参考文献栏把四篇都列了出来,时间跨度从 2006 年到 2015 年。
| 年份 | 论文 | 与 SGAMP 的关系 |
|---|---|---|
| 2006 | Noisy Inputs and the Induction of On–Off Switching Behavior in a Neuronal Pacemaker | 主引用,数据库即来自这批实验 |
| 2011 | Optimal Stimulus Shapes for Neuronal Excitation | 复用同一批轴突标本做最优刺激形状 |
| 2012 | Ionic Mechanism Underlying Optimal Stimuli for Neuronal Excitation | 解释最优刺激的离子机制 |
| 2015 | Characterizing Spiking in Noisy Type II Neurons | 用同一批数据检验六参数放电模型 |
四篇共用一个实验平台,这是理解 SGAMP 的关键:它不是一个持续采集的数据库项目,而是一组论文的实验底稿。2011 年那篇的摘要里写得很清楚,作者在枪乌贼巨轴突上证明「spike generation in a neuron can be highly discriminatory for stimulus shape」,即动作电位的触发对刺激形状高度敏感。2015 年那篇则把同一批轴突数据当成验证集,检验一个六参数模型能否预测峰间期分布与爆发模式。
3.2 为什么是枪乌贼巨轴突
选择这个标本不是情怀。巨轴突的直径在数百微米到接近一毫米之间,一根玻璃毛细管可以从侧面插进轴浆,同时充当电压记录电极与电流注入电极,而不会像在哺乳动物神经元上那样受制于细胞体积与膜片钳的几何约束。用电流钳方式控制注入电流、同时记录膜电位,在这种标本上几乎是唯一能做到干净的要求。
代价是它离人很远。它不参与任何肌肉运动之外的复杂行为,也没有突触网络。它的价值在于可以被写进方程:霍奇金与赫胥黎当年就是在这个标本上把膜电流拆成钠、钾与漏电流三项,那个模型至今仍是所有神经元模型的母本。
| 维度 | 巨轴突标本 | 哺乳动物离体神经元 | 人体表面肌电 |
|---|---|---|---|
| 记录方式 | 细胞内双电极 | 膜片钳 | 体表电极 |
| 能否控注入电流 | 能,电流钳 | 能,但几何受限 | 不能 |
| 单次记录时长 | 数秒至数十分钟 | 数分钟 | 数分钟至数小时 |
| 与人的距离 | 远,跨物种跨门 | 近,仍离体 | 直接来自人 |
3.3 它与 PhysioNet 其他资源的关系
PhysioNet 的主流内容是临床信号:心电图、脑电、重症监护波形。SGAMP 在这批资源里是一个异类,它既没有受试者编号,也没有临床结局,只有一个物种名和八条标本。它出现在平台上,很大程度上是因为 2016 年前后平台在扩展「基础电生理」这一块,而巨轴突是基础电生理的地基。
这也解释了它的规格为何朴素:没有分层目录、没有白皮书、没有版本迭代记录,1.0.0 一放就是十年。它是被收录的,不是被运营的。
3.4 放在时间线上
1960 年代,巨轴突上做出动作电位的离子学说。2006 年,这批作者用它证明噪声可以让起搏神经元在安静与放电之间来回翻。2011 到 2012 年,同一批标本被用来研究什么样的刺激形状最省电流。2015 年,原始数据被拿去检验一个简化的放电统计模型。2016 年 4 月,整批数据以 170 次试验的形式进入 PhysioNet。
这条线里没有一个节点是为「发布数据集」而存在的,发布是终点的一个副产品。理解了这一点,就不难理解为什么它的文档写得像论文附录,而不是像数据集卡片。
§4 实验设计:两路信号如何配成一对
4.1 一次试验的最小闭环
一次试验的物理闭环非常短:注入一段电流,同时读膜电位,两路信号在同一个采样时钟下被数字化。没有行为任务、没有刺激呈现、没有被试响应,全部变量都在电极两端。
| 环节 | 输入 | 输出 | 在本库里的体现 |
|---|---|---|---|
| 刺激生成 | 随机电流或矩形脉冲 | 模拟电流波形 | 通道 2,Istim |
| 膜响应 | 注入电流 | 跨膜电位变化 | 通道 1,Vmembrane |
| 数字化 | 两路模拟电压 | 16 位整型样本 | .dat 交错存放 |
| 汇总 | 逐次试验 | 说明表与均方根表 | Recording-Info.ods、Irms.txt |
这个闭环短到可以用一张表讲完,但它的短正是它的长处:任何一个分析结论都可以追溯到两路信号本身,不必引入看不见的中间环节。
4.2 采样率为什么定在 125 kHz
动作电位的上升支在巨轴突上只需几百微秒。要在时间轴上把这个上升支画清楚,采样间隔就得细到这个尺度的一个小分数。十二万五千赫兹对应 8 微秒一个点,上升支上能落下几十个采样点,重构出来的波形足够判断峰值时刻与斜率。
这个采样率带来的成本也很直接:一条十余秒的记录就是一百五十多万个样本乘两通道,单文件六兆字节上下。整包一百七十份,未压缩约 0.9 GB。对今天的存储毫无压力,但在 2016 年,这已经是一个「够大但还能整包下」的体量。
| 采样率 | 采样间隔 | 一秒样本数(双通道) | 一小时样本数 |
|---|---|---|---|
| 1 kHz | 1 毫秒 | 2 千 | 720 万 |
| 10 kHz | 100 微秒 | 2 万 | 7200 万 |
| 125 kHz(本库) | 8 微秒 | 25 万 | 9 亿 |
4.3 两类刺激的物理差别
随机叠加电流的用意是模拟突触输入的统计特性:许多小事件在时间上随机叠加,形成一段连续起伏的电流。单个脉冲的用意则是对照:给一个确定形状、确定幅度的方波,看膜怎么响应。
这两类在分析上的待遇完全不同。随机电流段有均方根值,可以拿来排序、分箱、画剂量—反应曲线;脉冲段没有均方根值,因为方波的均方根与幅度是一回事,官方索性在表里写 PULSE 而不填数。要做「随机与脉冲对比」的分析,得自己从波形里把脉冲段的幅度量出来。
4.4 案例:a1 的第一次试验如何贯穿全库
选一条记录做锚点,后面的讨论都能落到具体数字上。这里选 a1 的第一条试验,记录名 a1t01,理由是它是 RECORDS 的第一行、体积居中、两路信号都完整。
它的头文件在前面第 2.2 节已经摊开:两个通道、125 kHz、一百五十七万多个样本。按 §2.3 的解读,这段记录在十二秒上下。它的 Irms 值是 0.4347,属于随机电流组,处在 163 个数值里偏低的四分之一位置。
如 §4.4 的案例所设定,这条记录之所以适合当锚点,是因为它同时具备三个可验证的性质。第一,它足够长,长到能包含多次放电与若干段安静期,适合观察 on–off 翻转。第二,它的刺激强度不高,按论文的逻辑,低噪声正是双稳系统最容易来回翻的区间。第三,它在文件名上没有任何特殊标记,任何一个按字母序遍历的脚本都会第一个遇到它,因此它天然会出现在所有调试过程的日志里。
后面的第 5.3 节会用它演示单位换算,第 7.4 节会用它演示外部验证,第 9.2 节会用它跑通最小流程。同一条记录在不同章节里被反复引用,好处是每一步的中间结果都能对上前一步。
4.5 一条记录能被问出的问题
拿到 a1t01 之后,可以问的问题其实不多,但每一个都很扎实。
| 问题 | 依赖哪一路 | 能否从本库直接回答 |
|---|---|---|
| 这段时间里放了多少次电 | 通道 1 | 能,需自写检测器 |
| 放电间隔是否规则 | 通道 1 | 能,算峰间期 |
| 有没有从放电转入安静 | 通道 1 | 能,看峰间期中断 |
| 注入电流的强度是多少 | 通道 2 + Irms.txt |
能,先换算再核对 |
| 翻转时刻的电流处于什么相位 | 两路对齐 | 能,这正是论文的分析手法 |
| 温度是多少 | 无 | 不能,页面未给 |
最后一行是一个提醒:这份数据的可分析面被两路信号严格限定。凡是不能从电位与电流推出的量,它一律不给。
§5 怎么拿到,以及拿到之后怎么读
5.1 三条获取路径
开放许可的好处在这里体现得最直接:不需要注册,不需要签协议,三条路径任选。
#-- 路径一:整包 ZIP,约 901.7 MB
curl -O https://physionet.org/files/sgamp/1.0.0.zip

#-- 路径二:递归拉取,只补缺失文件,适合断点续传
wget -r -N -c -np https://physionet.org/files/sgamp/1.0.0/

#-- 路径三:匿名 S3 同步,不需要任何凭证
aws s3 sync --no-sign-request s3://physionet-open/sgamp/1.0.0/ ./sgamp
三条路径在官方页面上并列给出,取哪一条取决于你的网络环境。路径二的 -c 是关键:SGAMP 的单文件只有几兆,但一百七十个文件加起来的断点续传,比整包重拉省事得多。
5.2 先看清单再动手
下载完不要马上读信号,先对一遍账。
#-- 记录清单应有 170 行,且与目录里的 .hea 数一致
wc -l RECORDS
ls raw/*.hea | wc -l

#-- 按轴突分组点一遍,确认分布
cut -d/ -f2 RECORDS | cut -d't' -f1 | sort | uniq -c

#-- 抽一条看头文件是否完整
cat raw/a1t01.hea
这三条命令对应三个可能出问题的地方:清单缺行、目录多文件、头文件被截断。开放数据不会保证下载过程的完整性,SHA256SUMS.txt 才是最终裁判。
5.3 单位换算:本库最容易出错的一步
官方给的换算规则只有两条,但每一条都容易读漏。
#-- 按官方说明把 raw 目录的数值换成物理量
import numpy as np

def to_physical(name):
    head = open(name + '.hea', encoding='utf-8').read().splitlines()
    fields = []
    for line in head[1:]:
        f = line.split()
        gain, base = f[2].split('(')
        fields.append((float(gain), int(base.rstrip(')'))))
    sig = np.fromfile(name + '.dat', dtype='<i2').reshape(-1, 2)
    #-- 先用头文件增益与基线还原到伏
    volt = np.stack([(sig[:, i] - b) / g for i, (g, b) in enumerate(fields)], axis=1)
    vm = volt[:, 0] / 0.1            #-- 通道 1 除以 0.1 得膜电位,单位伏
    i_stim = volt[:, 1] * 5.0        #-- 通道 2 按 1 伏折 5 uA/cm2
    return vm, i_stim

vm, i_stim = to_physical('raw/a1t01')
print('膜电位中位数 %.3f V' % np.median(vm))
print('刺激电流中位数 %.4f uA/cm2' % np.median(i_stim))
第一条规则是通道 1 除以 0.1,官方措辞是「multiply the values by 0.1 to remove the instrumentation gain」,意思是原始记录被放大了十倍,乘 0.1 之后才是真实的伏。第二条规则是通道 2 按 1 伏折 5 微安每平方厘米,并且要去掉仪器带来的直流偏置。
这里有一个必须自己拿主意的细节:头文件已经把增益与基线写进去了,用 wfdb 读会得到以「伏」为单位的值,此时再乘 0.1 就会重复换算一遍。两条路径都对,但不能混用。要乘 0.1 的那条路径,是直接读原始整型、不套用头文件 ADC 增益的做法。
| 起点 | 第一步 | 第二步 | 结果单位 |
|---|---|---|---|
| 原始 16 位整型 | 减基线、除头文件增益 | 乘 0.1 | 伏(膜电位) |
| 原始 16 位整型 | 减基线、除头文件增益 | 乘 5、去偏置 | 微安每平方厘米 |
wfdb 物理值 |
直接使用 | 不再乘 0.1 | 伏 |
5.4 动作电位的检测
库不带标注,检测器得自己写。对这类信号,一条最简单的阈值法就够用,因为信噪比极高。
#-- 极简阈值检测:先估基线,再按基线加若干倍标准差设阈
import numpy as np

def detect_spikes(vm, fs=125000, k=6.0, refractory_s=0.002):
    base = np.median(vm)
    sd = 1.4826 * np.median(np.abs(vm - base))
    thr = base + k * sd
    above = np.flatnonzero(vm > thr)
    ref = int(refractory_s * fs)
    peaks, last = [], -10 ** 9
    for i in above:
        if i - last > ref:
            peaks.append(i)
            last = i
    return np.array(peaks)

vm, _ = to_physical('raw/a1t01')
peaks = detect_spikes(vm)
isi = np.diff(peaks) / 125000 * 1000
print('峰值数', len(peaks), '峰间期中位数 %.2f ms' % np.median(isi))
中位数稳健标准差这一步是必要的:膜电位的直方图有两个峰(安静基线在负处,动作电位在正处),直接算标准差会被大量尖峰拉大,阈值就会设得过高。用中位数与中位绝对偏差估计基线侧的离散度,阈值才落在两者的谷底附近。
5.5 把两路信号对齐
两路信号在同一个采样时钟下采集,通道索引天然对齐,这是格式 16 交错存放带来的好处:不需要任何时间戳配准。对齐的唯一用途是回答论文里的那个问题——放电翻转的那一刻,刺激电流处在什么相位。
#-- 找出放电中断的位置,并取出中断前后的电流均值作对照
import numpy as np

vm, ist = to_physical('raw/a1t01')
peaks = detect_spikes(vm)
isi = np.diff(peaks) / 125000
gap = np.argmax(isi)                       #-- 最长间期所在位置
t_gap = peaks[gap] / 125000
win = 125000 * 2                           #-- 前后各取两秒
before = ist[max(0, peaks[gap] - win):peaks[gap]].mean()
after = ist[peaks[gap]:peaks[gap] + win].mean()
print('最长间期 %.2f s,出现在 %.2f s' % (isi[gap], t_gap))
print('中断前电流均值 %.4f,中断后 %.4f' % (before, after))
按 §4.4 的案例给出的入手点,这段代码只回答一个描述性问题:最长的那次中断前后,注入电流的水平有没有差别。它不构成对论文结论的复现,因为真正的相位分析需要把随机电流与放电时刻做互相关,而这需要多次试验叠加。它构成的是一个入手点:先确认翻转在这条记录里真实存在,再谈统计。
5.6 三种常见的读法错误
第一种是把膜电位的绝对值当生理值。巨轴突的静息电位在经典文献里大致是负几十毫伏,而这里的中位数落在负几百。差出来的量级不是数据错了,而是「伏」与「毫伏」的差别:原始值以伏计,换算后仍是伏,要在心里乘一千才是熟悉的毫伏刻度。
第二种是把电流通道的基线当零。官方明说原始记录可能有直流偏置,刺激关闭时基线才应为零。如果你读到一段恒定的非零电流,先怀疑偏置,不要立刻解释成「持续注入」。
第三种是把所有记录当成同一实验条件。163 次随机电流试验的强度从 0.0472 到 2.4498,跨度超过五十倍;另有 7 次是脉冲。把它们混在一起做统计,等于把不同剂量与不同刺激类型当成同一种东西。
| 错误读法 | 症状 | 正确做法 |
|---|---|---|
| 直接读毫伏 | 膜电位负几百毫伏 | 按伏处理,必要时乘一千 |
| 假设电流零基线 | 未刺激段仍有恒定电流 | 先减偏置,对齐零基线 |
| 混合两类刺激 | 均值被脉冲拉偏 | 按 Irms.txt 的 PULSE 标记分列 |
| 套用头文件增益后又乘 0.1 | 幅值小十倍 | 两条换算路径选一条走到底 |
| 按文件名排序当时间序 | 同一轴突的试验顺序被打乱 | 按 t 后数字数值排序 |
§6 与库内条目的关系
6.1 关系图谱
SGAMP 与库内几类资源都有明确的错位关系,这些错位恰好可以用来定位它。
SpikeInterface 是一个分析框架,不含固定数据,因此和它只共享「尖峰」这个字眼;CHB-MIT 一类头皮脑电库是多个神经元的叠加电位,且带患者人群,与单根纤维的细胞内记录隔着两层。
真正值得逐项对比的是三类:同样记神经电信号的联邦档案,比如 DANDI Archive;以及表面肌电与高密度肌电库,比如 NinaPro、GRABMyo、HD-FW KIN、Hyser。下面按资源类别把它们摆开。
最重要的一行是第三、四行。表面肌电与高密度肌电做的是运动单位分解:从许多纤维叠加的表面电位里,用算法反推单个运动单位的放电时刻。SGAMP 不需要分解,因为它本身就是一根纤维的电记录。这两者在方法上并不相通——一个是从叠加里分离,一个是天生单一——但在教学上正好构成对照:分解算法的目标形态,就是 SGAMP 里那串干净的尖峰。
6.2 检索路径
在本站找与它相关的内容,三条路径各有用途。
同样记录单细胞电活动的库,走「神经科学」加「生理信号」两个标签交叉,会命中 DANDI Archive 一类联邦档案。从表面信号反推单纤维的方法,走「生理信号」加关键词「运动单位」,会命中高密度肌电各篇。可作对照的人体电生理波形,走「生理信号」下的心电与脑电词条。分析与可视化工具,直接搜 SpikeInterface 或 WFDB。
三条路径的共同点是:它们都不给你「另一份枪乌贼轴突数据」,因为别处没有。你能找到的只是邻居——上游的细胞外记录库、下游的肌电库、横向的工具链。
6.3 与 DANDI Archive 的三处错位
两者都含神经电生理,但错位得厉害。
第一处是记录位置。DANDI 里的主流是细胞外记录:电极在细胞外,记录的是附近多个神经元放电在电极上的叠加。SGAMP 是细胞内记录:电极在轴浆里,记录的是这单个细胞自己的跨膜电位。前者看不见突触后电位,后者看不见邻居。
第二处是实验完整度。DANDI 上的实验往往带行为、带多电极、带完整的元数据 schema;SGAMP 只有两路信号,元数据靠一份 ODS 表和论文。
第三处是版本与规模。DANDI 持续增长,以多 TB 计;SGAMP 停在 1.0.0,不到 1 GB。前者的价值在数量,后者的价值在单个样本的干净程度。
6.4 与高密度肌电的关系:一个是结果,一个是过程
这条关系值得单独讲,因为最容易被混淆。
高密度表面肌电的所谓「运动单位分解」,输出对象是运动单位动作电位:某个运动神经元支配的一批肌纤维同步放电,在表面电极上留下的时空图样。SGAMP 里记录的对象是这个图样的上游——一根神经纤维的膜电位本身。要做分解算法的验证,理想做法是拿到分解结果的真值;SGAMP 给的不是肌纤维,所以它不能当肌电分解的金标准。
但它能当方法论上的参照。分解算法的评估常常依赖仿真数据,而仿真里那套「尖峰 + 噪声」的生成模型,其生物学出处正是巨轴突这类标本上的记录。拿 SGAMP 里的真实尖峰去校准仿真器,比凭经验设参数更靠得住。
两者的差异可以压缩成五对:记录位置一个在轴浆内、一个在皮肤表面;单个来源的可见性一个是天生单一、一个要靠算法分离;时间分辨率一个 8 微秒、一个通常 0.5 至 1 毫秒;空间信息一个没有、一个有阵列;与肌肉的关系一个只驱动它、一个本身就是肌肉电活动。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
评估这份数据时,一个常见的误判是拿「规模」当质量指标:170 次试验太少,所以它质量低。这个误判在两处站不住。
第一处,它的规模与它要回答的问题匹配。噪声诱导双稳翻转是一个机制问题,机制问题需要的是可追溯的原始波形,不是统计功效。170 次试验足够让三次论文复用同一批数据,这本身就是它质量的一个旁证。
第二处,规模小带来的不是误差,而是适用范围窄。它不会让你得出错误结论,只会让你得不出某些结论。这两者在实际使用中的处理方式完全不同:前者要警惕,后者只要不去写。
因此本节的分维度评分不按样本量扣「技术先进性」,只按「作为机制研究底稿的可用性」给分。评分的对象是它作为一份数据集的完整性,不是它作为论文的贡献度。
拿 §4.4 的案例 a1t01 来量一遍,这种错位会看得更清楚。这条记录的两路信号完整、对齐、可直接换算,作为单条样本几乎没有缺口;但把它放进一个需要样本量的流程,第一个卡口是没有标注,第二个卡口是没有温度与电极参数,第三个卡口是 physical 目录的缺失。也就是说,单条记录的完整与整个库的可分析性,是两件事。
7.1 五维评分
评分用 DAIMS 五维框架,每维给出依据而不是结论。分数为编辑判断,供选型参考,不是官方数据。
| 维度 | 含义 | 分(5 制) | 依据 |
|---|---|---|---|
| D 数据完整度 | 记录是否自洽 | 3.5 | 两路信号成对齐全,但 physical 目录缺失 |
| A 获取可及性 | 拿到数据的成本 | 5.0 | 开放许可,匿名可取,总量不到 1 GB |
| I 信息深度 | 是否支持细粒度分析 | 4.5 | 125 kHz 采样,尖峰形态完整 |
| M 方法论成熟度 | 采集规程与文档 | 3.0 | 页面简略,电极与温度未列 |
| S 场景覆盖 | 条件与规模的广度 | 1.5 | 8 条轴突、单一物种、单一制备 |
五维里两项高分、一项中高、两项低分,形状与它的小体量一致:可及性与深度极强,广度极弱。选型时不要只看总分,要看卡在哪一维。卡在「快速拿到真实波形」,它几乎是首选;卡在「要有足够样本」,它一定不合适。
7.2 文档缺口清单
页面写得不多,缺口却很集中,五处。
第一处是电极形态。官方只说「single-unit neuronal recordings」,没有说用的是细胞内玻璃微电极还是双管电极,也没有给电极电阻与内液成分。做定量复现时,这决定你能不能在仿真里复刻同一套记录条件。
第二处是温度。巨轴突的离子通道动力学对温度极其敏感,温度每变化十度,时间常数会差两三倍。页面全文没有出现温度值,只写了「perfused」。
第三处是 physical 目录的去向。描述节以「physical directory contains the recordings converted into physical units by the PhysioNet team」的句式把它当既成事实介绍,但 1.0.0 版下载根目录下只有 raw,请求该路径返回 404。两个口径并列,差额是整批已换算记录,构成官方未说明。
第四处是单位标注与数值的关系。文件里通道单位写的是伏,数值量级也在伏;而多数电生理文献以毫伏交流。这不算错误,但会让第一次接触的人多花时间。
第五处是试验条件的逐条说明。Recording-Info.ods 是唯一的一手来源,页面对它的介绍只有一句「see the Recording-Info.ods spreadsheet for information about each trial」。不开这个文件,你只知道有 170 次试验,不知道每次用的什么刺激参数。
7.3 已知的、可枚举的偏差
偏一,物种。全部为北美枪乌贼。它的离子通道组合与哺乳动物不同,动作电位的时程也不同。用它标定出来的参数不能直接搬到人身上,只能作为机制参照。
偏二,制备。全部为离体灌流标本。离体意味着没有血流、没有体温调节、没有神经调制系统的输入。这条纤维在实验台上的行为,与它在活体动物体内的行为之间有距离。
偏三,个体数。8 条轴突,无法估计个体间变异。任何「平均值」都只是这 8 条的平均,不是物种的平均。
偏四,条件分布。163 次随机电流试验的强度并非均匀或分级设计,最高与最低相差五十倍以上;7 次脉冲试验是少数派。按强度分层时,各层的样本数完全由原始实验的取舍决定。
偏五,文档。关键采集参数(电极、温度、溶液)不在数据里,而在论文里,且几篇论文之间可能有差异,页面没有逐项汇总。
这五条里,前三条是对象层面的,第四条是设计层面的,第五条是文档层面的。对象层面的偏差意味着结论的作用域被限定在一个物种的一类制备上;设计层面的偏差意味着任何剂量—反应分析都要先做样本量核算;文档层面的偏差意味着复现成本被转移给了使用者。
| 偏差 | 类型 | 在分析里的表现 | 可控程度 |
|---|---|---|---|
| 跨物种 | 对象 | 参数不能直搬哺乳动物 | 不可控,只能标清作用域 |
| 离体制备 | 对象 | 无血流与调制输入 | 不可控 |
| 8 条轴突 | 对象 | 个体间变异无法估计 | 不可控 |
| 强度非分级 | 设计 | 分层后每档样本薄 | 可控,按 Irms 自行分组 |
| 文档缺参数 | 文档 | 复现要读论文 | 可控,读原文补齐 |
7.4 外部验证矩阵
一份数据是否被外部工作用过,是它生命力的证据。下表列出四种可核验的外部信号。
| 信号类型 | 可核验形式 | 本篇状态 | 含义 |
|---|---|---|---|
| 作者自用 | 2015 年那篇用它检验六参数模型 | 有 | 同一组人复用 |
| 平台浏览 | 页面侧栏的项目浏览数 | 页面给出但未逐版拆分 | 关注度有限 |
| 第三方复现 | 别的团队用它重算 | 未核实 | 需检索引用 |
| 教学用途 | 课程里的示例波形 | 未核实 | 常见于电流钳教学 |
第一条是最硬的证据。2015 年那篇的摘要明确写到,模型在「experimental data from squid giant axon with a noisy input current」上做了验证,而这批数据正是 SGAMP 的来源。同一批作者用同一批数据支撑了两篇不同主题的论文,说明这些记录的信息量没有被一次论文榨干。
7.5 它为何能持续:靠的是一次实验的复用价值
公开的神经元记录会越来越多,采样率会被超过,通道数会被超过。但有一样东西不容易被复制:一段关于双稳翻转的具体实验,已经在四处论文里被当作共同底座。它靠的是这批记录的复用价值活着,不是靠持续更新。
这也有助于理解它为什么十年只有一个版本。它不被运营,只被引用。只要还有人做噪声与神经兴奋的建模,a1t01 这类记录就会被重新下载一次。
§8 生态位与历史
8.1 一条从离子学说到噪声建模的线
巨轴突的故事可以拆成四段。
| 时期 | 主线 | 关键问题 | 与本库的关系 |
|---|---|---|---|
| 1950 至 1960 年代 | 离子学说 | 动作电位由哪些电流组成 | 提供标本与方法 |
| 1980 至 1990 年代 | 通道动力学 | 单个通道的随机开闭如何影响放电 | 提供噪声的物理来源 |
| 2000 年代 | 噪声诱导现象 | 随机输入能否切换放电状态 | 本库的直接来源 |
| 2010 年代 | 最优刺激 | 什么样的波形最省电流 | 复用同一批标本 |
| 2016 年 | 数据公开 | 如何让别人重算 | 本库上线 |
第三段是它真正的位置。在那之前的噪声研究多以仿真为主,因为要在真实神经元上逐点控制一段随机电流并不容易;巨轴突恰好是可以做到这一点的少数标本。
8.2 与 2011 年那篇的关系
2011 年的论文研究的是另一件事:最优刺激形状。摘要的说法是,作者在 Hodgkin-Huxley 模型与枪乌贼巨轴突实验上都证明,动作电位的触发对刺激形状高度敏感,且最优形状取决于神经元受到的输入。
这篇与 SGAMP 的关系不是「同一个数据集被两篇用」,而是「同一批标本被两个问题用」。标本是稀缺资源,一次成功的制备可以支撑多个实验问题,这就是为什么 8 条轴突能撑起 170 次试验。
8.3 开放许可这道门
PhysioNet 上的资源大多要注册,含人体数据的一律要签协议。SGAMP 是少数连注册都不用的,官方原文是「Anyone can access the files, as long as they conform to the terms of the specified license」。
| 层次 | 典型受限库 | SGAMP |
|---|---|---|
| 是否需注册 | 必须 | 不需要 |
| 是否需培训 | 视许可 | 不需要 |
| 是否需签协议 | 必须 | 不需要 |
| 能否匿名直连 | 不可 | 可以 |
| 能否商用 | 视协议 | 许可允许,须署名 |
| 义务 | 遵守协议 | 署名(ODC-By 的核心条款) |
开放的理由很实在:不含人的数据,而且原始实验早已发表。署名义务是唯一的约束,引用论文与数据集即可满足。
8.4 它在 PhysioNet 的位置
PhysioNet 以临床信号起家,基础电生理是少数派。SGAMP 在这个少数派里也不算显眼:它太老、太小、太不像数据集。但正是这类资源让平台覆盖了从单细胞到群体的整条链路。
| 平台内同类 | 对象层级 | 规模量级 | 访问方式 |
|---|---|---|---|
| 本库 | 单细胞(轴突) | 10 的 2 次方次试验 | 开放 |
| 细胞外记录档案 | 多细胞群体 | 10 的 4 至 6 次方 | 开放或受控 |
| 头皮脑电库 | 全脑叠加 | 10 的 2 至 3 人 | 视库 |
| 心电库 | 器官电活动 | 10 的 3 至 4 条记录 | 开放 |
§9 使用指引
9.1 三种角色的路径
不同角色进这份数据的入口不一样。
| 角色 | 第一件事 | 第二件事 | 不要做的事 |
|---|---|---|---|
| 学生或初学者 | 下整包,先读 a1t01 的头文件 |
用 §2.3 的脚本画一遍波形 | 一上来就批量处理 170 条 |
| 建模研究者 | 读 2006 与 2015 两篇的方法 | 用 Irms.txt 排出强度序 |
假设刺激强度是分级设计 |
| 教学者 | 选一条短记录(约两秒量级) | 同时画两路,讲电流钳 | 把「伏」直接当「毫伏」讲 |
9.2 一条最短的可用流程
从下载到第一条可信波形,最短五步。这里假定网络通畅、wfdb 已装。
#-- 第一步:只取一条记录试用,别先拉整包
mkdir -p sgamp && cd sgamp
curl -sO https://physionet.org/files/sgamp/1.0.0/raw/a1t01.hea
curl -sO https://physionet.org/files/sgamp/1.0.0/raw/a1t01.dat

#-- 第二步:确认头文件三行齐全,采样率与样本数都在
cat a1t01.hea
#-- 第三步:读进来,检查通道名与样本数
import wfdb
rec = wfdb.rdrecord('a1t01', physical=True)
print(rec.sig_name, rec.fs, rec.sig_len, rec.units)

#-- 第四步:按 §5.3 的规则换算,确认两路量级合理
vg = rec.p_signal[:, 0] / 0.1
ia = rec.p_signal[:, 1] * 5.0
print('膜电位中位数 %.3f V' % (vg.mean() if vg.size == 0 else __import__('numpy').median(vg)))
print('电流中位数 %.4f uA/cm2' % __import__('numpy').median(ia))

#-- 第五步:跑 §5.4 的检测器,看峰间期是否落在毫秒量级
第四步的打印是最关键的一次自检。如果膜电位中位数落在个位数量级,说明换算多做了一步;如果落在千位数量级,说明少做了一步。把这一行打印对了,后面的检测才有意义。
9.3 引用方式
两段式引用是 PhysioNet 的惯例:先引原始论文,再引平台论文。
Paydarfar, D., Forger, D. B., & Clay, J. C. (2006). Noisy inputs and the
induction of on-off switching behavior in a neuronal pacemaker.
Journal of Neurophysiology, 96(6), 3338-3348.
https://doi.org/10.1152/jn.00486.2006

Squid Giant Axon Membrane Potential (version 1.0.0). PhysioNet.
https://doi.org/10.13026/C25C73
| 引用对象 | 标识 | 用途 |
|---|---|---|
| 数据集 | 10.13026/C25C73 | 说明数据版本 |
| 主论文 | 10.1152/jn.00486.2006 | 说明实验设计与分析手法 |
| 2011 年论文 | 10.1371/journal.pcbi.1002089 | 说明同一批标本的另一用途 |
| 2012 年论文 | 10.1371/journal.pone.0045983 | 说明离子机制 |
| 2015 年论文 | 10.1016/j.jtbi.2014.09.041 | 说明统计模型的验证 |
| 平台 | 10.1038/s44360-026-00096-z | 说明平台来源 |
9.4 建模时最容易忽略的三件事
第一件是采样率与模型步长。125 kHz 对数值积分是灾难性的步长,通常要重采样到 10 kHz 量级再拟合,重采样之前先做低通,否则尖峰会被混叠。
第二件是电流的真实形状,§4.4 的案例里两路对齐的那一段就是提醒。随机叠加电流的频谱特性正是论文关心的变量之一,任何平滑或降采样都可能改变频谱,进而改变结论。要做频谱分析,就在原始 125 kHz 上做。
第三件是单次试验的长度不等。从两秒到十余秒混在一起,按固定窗长切分会把短记录切碎。先按头文件样本数分组,再决定窗长。
§10 AI 使用声明
| 项 | 说明 |
|---|---|
| 词条性质 | 数据集介绍,非实验协议或临床指南 |
| 资料来源 | PhysioNet 项目页与文件清单、Europe PMC 四篇论文摘要 |
| 数字口径 | 以官方页面与记录清单为准,冲突处并列 |
| 已核验 | 记录数、轴突分组、采样率、通道增益、Irms 取值范围 |
| 未核实 | 电极形态、温度、溶液成分、physical 目录去向 |
| 代码状态 | 结构示范,路径按本地下载位置调整 |
| 使用风险 | 单位换算易出错,须按 §5.3 自检 |
| 免责 | 选型与建模判断由使用者承担 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 「SGAMP 是单运动单位动作电位」 | 展开是枪乌贼巨轴突膜电位,对象是神经不是肌肉 | 官方标题与摘要首句 |
| 「它是肌电数据集」 | 无肌电、无运动单位、无收缩分级 | 摘要只提 membrane potential 与 stimulus current |
| 「下载要签协议」 | 开放访问,匿名可取 | 访问政策段原文 |
| 「页面里的 physical 目录能下」 | 1.0.0 根目录只有 raw |
请求该路径返回 404 |
| 「膜电位是负几百毫伏」 | 数值以伏计,换算后仍是伏 | 头文件单位字段为 V |
| 「每次试验都是随机电流」 | 7 次是单个脉冲,Irms 表记作 PULSE |
Irms.txt 逐行内容 |
| 「刺激强度是分级设计」 | 163 个数值相互独立,跨度五十倍 | Irms.txt 取值 |
| 「8 条轴突等于 8 名受试者」 | 是 8 条离体纤维,不是个体抽样 | 摘要 8 different axons |
| 「带动作电位标注」 | 库内无标注文件 | 文件清单仅四份非记录文件 |
| 「版本一直在更新」 | 十年只有 1.0.0 | 版本页仅一条 |
| 「采样率与常规电生理相当」 | 125 kHz,比常规高一个数量级以上 | 头文件与摘要 |
FAQ
Q1:SGAMP 到底是哪几个词?
Squid Giant Axon Membrane Potential,枪乌贼巨轴突膜电位。PhysioNet 页面标题即此全名,DOI 与版本页也用它。
Q2:它一共有多少条记录?
170 次试验,分布在 8 条轴突上,RECORDS 清单逐行列出。八条轴突的试验数从 8 次到 52 次不等。
Q3:采样率与单次时长是多少?
125 kHz,即 8 微秒一个点。单次时长从约两秒到十余秒,由头文件每通道样本数除以采样率得到。
Q4:为什么找不到 physical 目录?
1.0.0 版根目录只有 raw 与三份文本表格文件,请求该路径返回 404。官方描述节按存在该目录写换算规则,两个口径并列。
Q5:两路信号的单位到底是什么?
膜电位换算后以伏计,刺激电流以微安每平方厘米计。头文件单位字段写 V,与数值量级自洽;日常交流时若要换成毫伏,需自行乘一千。
Q6:能不能直接拿它训练神经网络?
不建议。170 次试验、8 条轴突、无标注,样本量比常规训练需求低两三个数量级。它更适合当机制模型的标定与验证素材。
Q7:为什么电流通道会有非零基线?
官方明说原始记录可能存在仪器直流偏置,这不代表真的注入了恒定电流。刺激关闭时基线才应为零,处理时应先对齐零点。
Q8:Irms.txt 里的 PULSE 是什么意思?
表示这次试验用的是单个电流脉冲,而非随机叠加电流,因此没有均方根值可填。170 行里有 7 行是这种。
Q9:它和运动单位分解有关系吗?
只有方法论上的参照关系。分解是从表面叠加电位里反推单个运动单位,SGAMP 记录的是单根神经纤维的膜电位,两者对象不同,不能互相替代。
Q10:要不要引论文?
要。电极、温度、溶液这些数据里没有的参数都在论文里,只引数据集会让复现者缺关键信息。
Q11:它适合做教学吗?
很适合。两路信号并列、尖峰清楚、总量不到 1 GB,是讲电流钳与膜电位对照的现成素材。
Q12:它会不会再更新?
可能性很低。1.0.0 发布于 2016 年,此后没有版本记录,页面定位是论文的实验附录而非持续运营的数据集。
术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 巨轴突 | giant axon | 枪乌贼用于快速逃逸反射的粗大神经纤维 |
| 膜电位 | membrane potential | 细胞膜内外两侧的电位差 |
| 刺激电流 | stimulus current | 由电极注入标本的电流 |
| 电流钳 | current clamp | 控制注入电流、观察膜电位变化的记录方式 |
| 细胞内记录 | intracellular recording | 电极穿透细胞膜、直接测膜内电位 |
| 动作电位 | action potential | 膜电位的一次快速全或无式翻转 |
| 峰间期 | inter-spike interval | 相邻两次放电之间的时间 |
| 双稳态 | bistability | 系统存在两个可稳定停留的状态 |
| 起搏神经元 | pacemaker neuron | 无需输入也能节律放电的神经元 |
| 噪声诱导翻转 | noise-induced switching | 随机输入使系统在两个状态间跳转 |
| 阈下电位 | subthreshold potential | 未达放电阈值时的膜电位变化 |
| 随机叠加电流 | stochastically summated current | 许多小电流事件在时间上随机叠加 |
| 均方根电流 | root mean square current | 电流波形平方均值的平方根 |
| 灌流 | perfusion | 用生理溶液持续流过标本以维持活性 |
| 离体标本 | in vitro preparation | 从生物体取出后维持的活组织 |
| 直流偏置 | DC offset | 记录链路引入的恒定偏移 |
| ADC 增益 | ADC gain | 每单位物理量对应的整型计数 |
| 基线 | baseline | 头文件中定义的零点计数 |
| 交错存放 | interleaved storage | 多通道样本按帧轮流写入 |
| 格式 16 | format 16 | WFDB 的 16 位整型存储格式 |
| 头文件 | header file | 声明记录结构的 .hea 文本 |
| 记录清单 | RECORDS | 列出全部记录名的文本文件 |
| 开放许可 | open license | 允许自由使用、要求署名的许可 |
| 署名义务 | attribution | 使用后须标明来源的许可条款 |
| 项目浏览数 | project views | 平台上该数据被查看的次数 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 轴突数 | 8 | 摘要 | 官方页面 |
| 试验数 | 170 | 摘要与 RECORDS |
官方页面 |
| 采样率 | 125 kHz | 数据描述节与头文件 | 官方页面 |
| 通道数 | 2 | 头文件 | 官方页面 |
| 通道名称 | Vmembrane、Istim | 头文件 | 官方页面 |
a1t01 样本数 |
1571801 | 头文件 | 官方页面 |
a1t01 增益 |
约 6.4 万、约 8.8 万 | 头文件 | 官方页面 |
| 体积 | 901.7 MB | 下载页 | 官方页面 |
| 版本与日期 | 1.0.0,2016-04-15 | 页面顶部 | 官方页面 |
| DOI | 10.13026/C25C73 | 页面侧栏 | 官方页面 |
| 许可 | ODC-By 1.0 | 页面侧栏 | 官方页面 |
Irms 行数 |
170(含 7 行 PULSE) | Irms.txt |
官方页面 |
Irms 取值范围 |
0.0472 至 2.4498 | Irms.txt |
官方页面 |
| 电流换算 | 1 V 折 5 uA/cm2 | 数据描述节 | 官方页面 |
| 物种 | Loligo pealei | 摘要 | 官方页面 |
physical 目录 |
不存在(404) | 文件目录 | 官方页面 |
| 电极形态 | 未给 | 全文未见 | 未核实 |
| 温度 | 未给 | 全文未见 | 未核实 |
附录 B:数字的来源分层
| 层级 | 定义 | 本篇中的例子 |
|---|---|---|
| 官方页面 | 页面正文、清单或头文件直接写明 | 8 条、170 次、125 kHz、901.7 MB、ODC-By |
| 论文摘要 | Europe PMC 收录的摘要 | 双稳翻转动机、最优刺激、六参数模型验证 |
| 推算 | 由官方数字直接计算 | 单次时长、样本数除采样率、增益比值 |
| 未核实 | 页面与摘要都没有 | 电极形态、温度、溶液成分 |
界限要划清。附录 A 每行都标了层级,标为推算的分量低于标为官方页面的行。
附录 C:完整参考文献
| 编号 | 文献 | 用途 |
|---|---|---|
| R1 | Paydarfar D, Forger DB, Clay JR. Noisy Inputs and the Induction of On–Off Switching Behavior in a Neuronal Pacemaker. J Neurophysiol, 2006, 96:3338-3348. doi:10.1152/jn.00486.2006 | 主引用,数据来源 |
| R2 | Forger DB, Paydarfar D, Clay JR. Optimal Stimulus Shapes for Neuronal Excitation. PLoS Comput Biol, 2011, 7(7):e1002089. doi:10.1371/journal.pcbi.1002089 | 同批标本的另一用途 |
| R3 | Clay JR, Forger DB, Paydarfar D. Ionic Mechanism Underlying Optimal Stimuli for Neuronal Excitation. PLoS One, 2012, 7(9):e45983. doi:10.1371/journal.pone.0045983 | 离子机制 |
| R4 | Boďová K, Paydarfar D, Forger DB. Characterizing Spiking in Noisy Type II Neurons. J Theor Biol, 2015, 365:40-54. doi:10.1016/j.jtbi.2014.09.041 | 统计模型验证 |
| R5 | Squid Giant Axon Membrane Potential (version 1.0.0). PhysioNet. doi:10.13026/C25C73 | 数据集本体 |
| R6 | Pollard T, et al. PhysioNet as a global platform for biomedical research. Nature Health, 2026. doi:10.1038/s44360-026-00096-z | 平台来源 |
附录 D:任务代码
给三种常见任务各一段最短代码,全部以本地已下载的记录为前提。
#-- 任务一:把同一轴突的全部试验按强度排序,检查剂量关系
import numpy as np

def irms_table(path='Irms.txt'):
    tab = {}
    for line in open(path, encoding='utf-8'):
        parts = line.split()
        if len(parts) == 2:
            tab[parts[0]] = None if parts[1] == 'PULSE' else float(parts[1])
    return tab

tab = irms_table()
rand = {k: v for k, v in tab.items() if v is not None}
print('随机电流试验', len(rand), '脉冲试验', len(tab) - len(rand))
order = sorted(rand, key=rand.get)
print('最低三档', [(k, round(rand[k], 4)) for k in order[:3]])
print('最高三档', [(k, round(rand[k], 4)) for k in order[-3:]])
#-- 任务二:跨试验比较峰间期,先确认记录短到能整条读进来
import numpy as np

def head_info(name):
    f = open(name + '.hea', encoding='utf-8').readline().split()
    return int(f[1]), int(f[2]), int(f[3])

for rec in ['a1t01', 'a1t18', 'a1t17']:
    n_sig, fs, n_samp = head_info('raw/' + rec)
    print(rec, '通道', n_sig, '采样率', fs, '时长 %.2f s' % (n_samp / fs))
#-- 任务三:把膜电位与刺激电流叠在一张图上,肉眼查翻转
import numpy as np
import matplotlib.pyplot as plt

vm, ist = to_physical('raw/a1t01')
t = np.arange(len(vm)) / 125000
fig, ax = plt.subplots(2, 1, sharex=True, figsize=(10, 5))
ax[0].plot(t, vm, lw=0.5)
ax[0].set_ylabel('Vmembrane')
ax[1].plot(t, ist, lw=0.5)
ax[1].set_ylabel('Istim')
ax[1].set_xlabel('time (s)')
plt.tight_layout()
plt.savefig('a1t01_overview.png', dpi=150)
三段都只是骨架。任务一的输出会提醒你一个重要事实:随机电流试验与脉冲试验的比例接近二十三比一,任何以「脉冲响应」为题的分析,样本都只有七次。任务二的输出说明为什么必须先读头文件:同样是「数秒」,两条记录的时长可以差六倍。任务三的图是最直观的一次质检,如果上面那条看不到成串的尖峰、下面那条看不到起伏,八成是单位换算做错了。
附录 E:如果只记五件事
| 序 | 一句话 |
|---|---|
| 一 | 全名是枪乌贼巨轴突膜电位,不是肌电,也不是运动单位动作电位 |
| 二 | 8 条轴突、170 次试验,每次两路信号,采样率 125 kHz |
| 三 | 开放许可,匿名可取,整包不到 1 GB,十年只有一个版本 |
| 四 | 原始值未标定,膜电位以伏计,电流须去偏置并乘 5 折成微安每平方厘米 |
| 五 | 页面称有 physical 目录,下载里没有,用之前先按 raw 自行换算 |
编辑说明
本篇的核验方式是抓取 PhysioNet 项目页、记录清单、Irms.txt 与若干头文件,并各查一次 Europe PMC 的论文摘要;未下载完整二进制,只做过一次区间读取以确认头文件与数据文件的对应关系,因此正文中不涉及任何由全量文件统计得出的分布数字。
三处未覆盖值得记录:一是电极形态与标本制备的温度、溶液,页面全文未见;二是 physical 目录的实际去向,1.0.0 下载中不存在该路径;三是八条轴突为什么试验数相差六倍有余,需读 Recording-Info.ods 与论文正文。三项均按未核实标注,未做推断填补。
数字口径上,记录数、试验数与分组三处互相印证,不存在冲突。physical 目录的存在与缺席构成一个官方内部不一致,正文按两口径并列处理,未判定对错。
标题与正文中出现的「一百七十次试验」为中文概数写法,与速览表及附录中的精确值对应。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- bci-competition-iv-2a — 共享标签:神经科学 / 生理信号 / 挑战赛数据集
- cinc-2023 — 共享标签:神经科学 / 生理信号 / 挑战赛数据集
- emgdb — 共享标签:神经科学 / 生理信号
- tremordb — 共享标签:神经科学 / 生理信号
- phdsm — 共享标签:神经科学 / 生理信号
- cardioresp-response-orthostat — 共享标签:神经科学 / 生理信号
- earh — 共享标签:神经科学 / 生理信号
- earndb — 共享标签:神经科学 / 生理信号
- mouse-stroke-cylinder-rearing — 共享标签:神经科学 / 生理信号
- music-motion-2015 — 共享标签:神经科学 / 生理信号
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
