信息速览
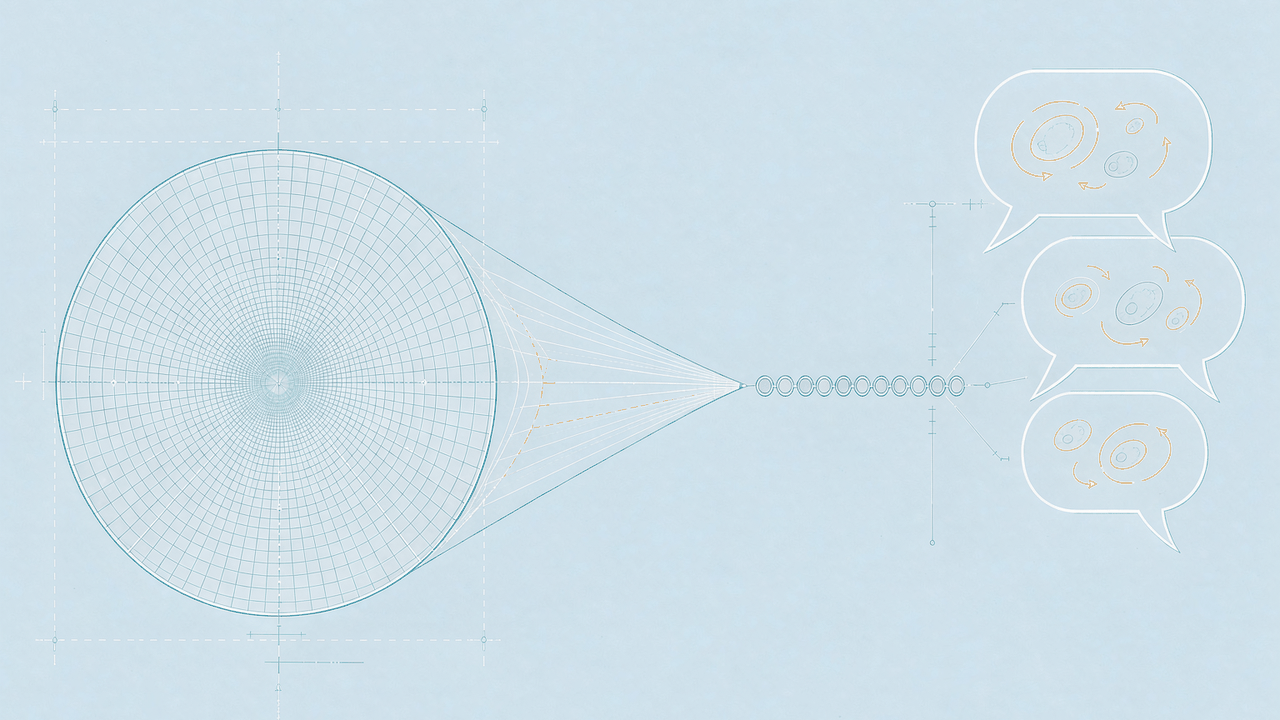
病理 AI 这两年的主线是「切片级表征」:把 gigapixel 的全切片图像压成一个向量,然后拿去做分类、分型、预后。这条路成熟、可复现、有大量公开基准。另一条路少有人走:把整张切片喂进语言模型,让它像病理医师一样被追问、被要求写报告。难点不在语言模型本身,而在于怎么在不丢掉诊断依据的前提下,把动辄十万乘十万像素的切片塞进上下文窗口。
SliceChat 就是这条路线上的一份公开答卷。它由复旦大学等机构联合完成,2024 年 11 月把数据托管到 Hugging Face 的 General-Medical-AI 组织下,2026 年论文发表在 Nature Cancer。仓库里放了三样东西:约 19 万条切片级指令记录、七个评测 CSV、以及 32 个癌种的 patch 特征包。训练用的原始切片不在仓库里,评测用的切片也不在。
对使用者来说,这份资源最有价值的地方不是模型分数,而是它把「切片怎么变成对话」这件事的中间产物全部摊开了——特征包长什么样、指令记录长什么样、评测题长什么样,都可以逐个文件看清楚。同时它也有一个明确、无法绕开的缺陷:官方仓库未声明许可。这一点会贯穿全文,并且直接影响「能不能商用」这个最现实的判断。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 本质 | 切片级病理多模态指令数据 + 跨队列评测基准(模型本体与原始切片都不在仓库内) |
| 团队 | 复旦大学与联合团队,作者二十余人,通讯方向为计算病理与多模态 |
| 论文 | Nature Cancer 2026,DOI 10.1038/s43018-026-01220-4 |
| 仓库 | Hugging Face General-Medical-AI/SlideChat,创建于 2024-11-07,最近更新 2026-09-05 |
| 训练规模 | 论文口径 274,233 条多模态指令样本 |
| 仓库训练文件 | 三档:描述指令 4,181 条、问答指令 175,734 条、答题式变体 10,386 条与 436 条 |
| 评测规模 | 论文口径:封闭式 8,836 题、开放式 129 题、报告 3,149 份 |
| 评测队列 | TCGA、BCNB、CPTAC、HistAI 四队列,跨 31 个癌种 |
| 封闭题结构 | 四选一为主,HistAI 为三选一;标准答案以字母 A/B/C/D 给出 |
| 开放题结构 | 给定一张切片,要求生成含七要素的病理报告 |
| 特征包 | TCGA 32 个癌种 + BCNB 一份,tar.gz 分片,带 sha256 |
| 记录格式 | 训练为 JSON 对话数组;基准为 CSV,四队列列名不统一 |
| 许可 | 未声明(无 License 段、无 license 标签)→ 默认按不可商用处理 |
| 原始像素 | 不提供,需回各自门户获取(TCGA/CPTAC 受控、BCNB/HistAI 各有条款) |
| 库内位置 | 病理条目已有五十余条,但「病理 VQA / 对话」这一档此前为空 |
§1 它要解决的具体麻烦
1.1 一句话结论:它解决的是「切片太大、语言模型太小」这个尺度错配
一张全切片图像在 40 倍下的像素规模通常在十万乘数万到二十万乘十万之间,即使按最激进的压缩,直接编码也会把显存和上下文全部吃光。切片级的语言模型必须回答两个问题:第一,把成千上万个 patch 压成有限的 token,靠什么压缩而不丢诊断依据;第二,压缩之后,模型凭什么学会回答「这张切片的核分裂像多不多」「这属于几级」「边界切干净没有」这类问题。SliceChat 的贡献是把这两个问题各自给出了一套可检查的工程答案,并把答案的数据侧产物公开出来。
尺度错配这件事,做切片级表征的人感受不深:他们的输出是一个向量,向量多大都无所谓。但一旦接上语言模型,压缩方式就直接决定了模型能看见什么。压得太狠,核分裂像这种「少数几个细胞决定结论」的证据会被平均掉;压得太松,上下文装不下,模型只能看切片的一小块,又退回到 patch 级。这是这条路线的核心矛盾,也是下面所有章节反复要回到的点。
1.2 三条常见的错误期待
第一条错误期待,是把它当作一个「能直接问病理问题的聊天机器人」。仓库里没有权重、没有推理服务、没有 API,只有指令数据和基准题。要得到对话能力,需要自己去拿模型、自己去准备特征,仓库只覆盖了这条链路的中间一段。
第二条错误期待,是把它当作「27 万张切片的数据库」。指令样本的计数单位是问答对,不是切片。同一张切片在第二阶段的问答集里会被反复提问,尤其是基础概念题,一张切片可以挂上几十个问题。按切片去估算可得的数据量,会高估一个数量级。
第三条错误期待,是把它当作「已经解决了病理幻觉的模型」。训练回答的来源是诊断报告改写,评测答案的来源是报告字段抽取,两者都以「这份报告写了什么」为准,而不是以「病理医师看着这张切片会怎么判」为准。报告里没写的,数据里就没有;报告里写错的,数据里也照单全收。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 训练一个能就切片对话的模型 | 两阶段指令数据 + 特征包 + 论文里的训练配方 | 基本够用,缺权重与预处理脚本 |
| 评测自家模型的切片级问答 | 四队列七文件的封闭题,带标准字母 | 够用,但只能对比它自己划的题 |
| 评测报告生成质量 | TCGA/CPTAC/HistAI 三套开放式报告参考 | 够用,但四队列里 BCNB 没有报告集 |
| 拿到原始切片像素 | 不提供,只有特征与文件名 | 不够,须自行回门户申请 |
| 商用授权 | 无 License 段 | 不够,须书面授权 |
| 复现论文训练流程 | 论文给了架构与阶段,仓库无代码 | 不够,须自行实现 |
| 做非肿瘤病理(炎症、感染、正常组织) | 四队列全部是肿瘤 | 不够,覆盖几乎为零 |
| 做患者级预后预测 | 切片级记录,无随访字段 | 不够,不属于这条线 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 手里有一批自建 WSI,想让模型会答切片级问题 | 提供可借鉴的指令构造方式与两阶段训练顺序 | 先按它的字段结构把自己的报告改写成指令,再考虑复用它的题 |
| 自研切片级 VLM,需要外部基准对比 | 四队列七文件的封闭题可以直接当外部测试集 | 先按病例号检查与你训练集的交集,避免数据泄漏 |
| 只想拿现成切片特征做 MIL 分类 | 32 个癌种的特征包省掉了编码器推理 | 核对特征维度与编码器版本,不要与别的编码器混用 |
| 评估病理助手的安全边界 | 题库中的通识题与切片题混杂,是观察幻觉的好样本 | 把问题分成「看图可答」与「纯记忆可答」两组分别统计 |
| 临床或产业要落地 | 无许可、无前瞻验证、无监管路径 | 把本文当作技术综述读,不要当作可用组件 |
| 教学演示 | 指令与题目都可读,适合讲「切片怎么进语言模型」 | 从 §2.3 的一条记录解剖讲起最直观 |
1.5 一句话判断
这是一份把「切片如何进入语言模型」全过程摊开的工程样本,不是一份可以直接接入的产品组件——它的数据侧价值远高于它的可用性,而许可缺失把「能不能用」这件事从技术问题变成了法律问题。
1.6 不适合谁:四条边界
第一种不适合的人,是想找一份开箱即用的病理对话数据集的人。这份资源需要使用者自己完成特征编码、切片 token 化、提示词模板对齐三件事,任何一步没对上,数据和模型就接不起来。
第二种不适合的人,是需要明确授权链路的企业或医院。仓库没有许可声明,法务无法出结论。即便作者随后补充了许可,训练集里 TCGA 与 CPTAC 的部分本身也受各自门户条款约束,链路是分层的,不是一句话能解决的。
第三种不适合的人,是做非肿瘤病理的人。四个评测队列没有一个覆盖炎症、感染、自身免疫或正常组织形态,这类场景下模型的「不知道」会以自信的错误答案呈现。
第四种不适合的人,是期待患者级结论的人。这份数据的所有字段都停在切片级,既没有随访,也没有治疗反应,任何把它推到预后或疗效判断的用法都超出了数据本身能支撑的范围。
§2 数据构成与规格
2.1 仓库里到底有什么:三档指令、七个 CSV、一份特征目录
打开仓库的文件树,按目录分是四类。第一类是训练指令,四个 JSON 文件。第二类是评测基准,七个 CSV。第三类是特征包,一个目录加一个压缩包。第四类是仓库自身的元文件,包括一张很短的数据集卡和一个 2.4 KB 的 .gitattributes。
数据集卡只有八百多字节,标题是 Introduction 与 Contents 两段,逐条列出每个文件做什么用。它没有写许可,没有写引用方式,没有写数据来源的许可链路,也没有写任何已知问题。这一点在下一节 §3 会展开,此处只记录事实:卡里能拿到的信息量,低于任何一份正式的数据说明。
| 类别 | 文件 | 体积 | 作用 |
|---|---|---|---|
| 训练指令 | SlideInstruct_train_stage1_caption.json |
6.0 MB | 第一阶段,切片描述生成 |
| 训练指令 | SlideInstruct_train_stage2_vqa.json |
163 MB | 第二阶段,切片视觉问答 |
| 训练指令 | SlideInstruction+.json |
1.9 MB | 答题式变体,十万条规模中的一部分 |
| 训练指令 | SlideInstruction++.json |
3.8 MB | 答题式变体,比上一个更细的问答 |
| 评测 | SlideBench-VQA-TCGA.csv |
894 KB | TCGA 封闭题 |
| 评测 | SlideBench-VQA-BCNB.csv |
1.9 MB | BCNB 封闭题 |
| 评测 | SlideBench-VQA-CPTAC.csv |
71 KB | CPTAC 封闭题 |
| 评测 | SlideBench-VQA-Histai.csv |
186 KB | HistAI 封闭题 |
| 评测 | SlideBench-Caption-TCGA.csv |
2.4 MB | TCGA 报告生成 |
| 评测 | SlideBench-Caption-CPTAC.csv |
30 KB | CPTAC 报告生成 |
| 评测 | SlideBench-Caption-Histai.csv |
1.8 MB | HistAI 报告生成 |
| 特征 | Feat/TCGA_patch_feat/ |
32 个癌种分片 | 按癌种打包的 patch 特征 |
| 特征 | Feat/BCNB_patch_feat.tar.gz |
单包 | BCNB patch 特征 |
这张表本身就是一份判断依据:训练侧 175 MB,评测侧 5 MB,特征侧是最大的一块。也就是说,这个仓库的重心在「特征」与「指令」,而不在「题」。评测集小到可以全部读完——事实是,四个队列的七张表加起来不足五千行,任何使用者在半小时内都能把它们逐行看完,这也是下面所有结构描述可以直接给出而不需要抽样的原因。
2.2 字段与记录的完整字典
四类文件的字段互不相同。训练指令用一套对话数组,四个 CSV 队列用三套不同的列名。把它们并列放,才能看清「同一个概念在不同队列里叫什么」。
| 文件组 | 字段 | 含义 | 备注 |
|---|---|---|---|
| 训练指令 | id |
记录序号 | 形如 train::0,只在文件内唯一 |
| 训练指令 | image |
单元素数组,存特征文件相对路径 | 形如 ./BRCA/TCGA-XXXX-01Z-00-DX1.csv |
| 训练指令 | conversations |
对话数组 | 首条 human,末条 gpt |
| 训练指令 | conversations[].from |
角色 | 只有 human 与 gpt 两种取值 |
| 训练指令 | conversations[].value |
文本 | 人类侧末尾带 <image> 占位符 |
| TCGA VQA | ID |
行号 | 从 0 起 |
| TCGA VQA | Slide |
切片标识 | TCGA 条码格式,含 -01Z-00-DX1 后缀 |
| TCGA VQA | Tumor |
癌种缩写 | 如 ACC、BRCA、LGG |
| TCGA VQA | Broad Category |
粗类 | 如 Microscopy、Diagnosis |
| TCGA VQA | Narrow Category |
细类 | 如 Staging、Grading |
| BCNB VQA | Task |
任务名 | 七类,如 Tumor、ER、PR、HER2 |
| HistAI VQA | Organ |
器官 | 与癌种不同,这里是解剖部位 |
| 全部 VQA | Question |
题干 | 多为「作为资深病理医师,请判断……」句式 |
| 全部 VQA | A / B / C / D |
选项 | BCNB 与 HistAI 常有空选项 |
| 全部 VQA | Answer |
标准答案 | 字母,个别文件另有 Output 列存模型输出 |
| Caption | Question |
报告生成指令 | 七要素模板,见 §2.3 |
| Caption | Answer |
参考报告全文 | 来自队列自带诊断报告 |
| HistAI Caption | case |
病例标识 | 与 Slide 冗余,Slide 为单元素列表字符串 |
字段表里最值得注意的两处不统一:一是 Tumor 在 TCGA 里是癌种缩写,在 HistAI 里换成了 Organ,在 Caption 文件里又各自不同;二是 BCNB 完全不用癌种与粗细类,而是用七个 Task 值把所有题平分。这意味着跨队列写统一的评测脚本时,不能按列名硬编码,必须显式维护一张映射表。
2.3 一条记录的完整解剖
先看训练侧。一条记录是一个完整回合,问题末尾的 <image> 是模型侧要替换成切片 token 的位置。这个占位符是理解整份数据的关键:数据里没有像素,只有「这里该放切片」的标记,真正的切片向量来自特征包或使用者自己的编码器。
[
  {
    "id": "train::0",
    "image": ["./COAD/TCGA-AM-5820-01Z-00-DX1.csv"],
    "conversations": [
      {"from": "human", "value": "What is the histologic grade of the colorectal adenocarcinoma?\n<image>"},
      {"from": "gpt", "value": "Grade 3 (poorly differentiated)."}
    ]
  },
  {
    "id": "train::1",
    "image": ["./ESCA/TCGA-IG-A3Y9-01Z-00-DX1.csv"],
    "conversations": [
      {"from": "human", "value": "What is the tissue source under the microscope?\n<image>"},
      {"from": "gpt", "value": "Esophageal epithelial tissue"}
    ]
  }
]
再看评测侧。封闭题的一条记录,本质是把报告里的一个字段变成一个四选一问题。下面这条来自 TCGA 的 ACC 切片,考的是 Fuhrman 核级,四个选项里的顺序是打乱的——注意 C 与 D 的次序是反的,这是刻意的,用来防止模型靠位置猜测。
ID,Slide,Tumor,Broad Category,Narrow Category,Question,A,B,C,D,Answer
2,TCGA-OR-A5J8-01Z-00-DX1,ACC,Diagnosis,Grading,"Based on the Fuhrman nuclear grading system, what is the grade of the neoplasm?",Grade 1,Grade 2,Grade 4,Grade 3,C
报告生成的一条记录则完全不同:题干是一段固定模板,要求七项内容;答案是一整段参考报告。模板七要素依次是组织病理诊断、肿瘤形态与生长方式、浸润范围与受累结构、脉管或神经侵犯、切缘状态、TNM 分期、其他非肿瘤性改变。
ID,Slide,Tumor,Question,Answer
0,TCGA-PA-A5YG-01Z-00-DX1,ACC,"Please generate a comprehensive and professional pathology report from Adrenal gland, including key elements such as: (1) the histopathological diagnosis, (2) tumor morphology and growth patterns, (3) extent of invasion and involved structures, (4) lymphovascular or perineural invasion, (5) status of surgical margins, (6) TNM staging if possible, (7) any additional pathological findings including non-neoplastic tissue alterations.","The pathological evaluation reveals the presence of low-grade adrenal cortical carcinoma in the left adrenal gland, characterized by sheet-like infiltration, necrosis, capsular vascular invasion, and nuclear atypia."
2.4 规模与构成分布
规模只能给三个口径,且三个口径互不相等。第一个是论文摘要里的多模态指令样本数,二十七万四千余条。第二个是仓库里三档训练文件的实际记录数,合计约十九万条。第三个是评测题数,封闭式八千八百余题,开放式一百二十九题,报告三千一百余份。三者之间的差额,论文没有逐项说明,此处只记录「存在两个口径」,不对差额构成下判断。
| 统计项 | 数值 | 口径 | 来源 |
|---|---|---|---|
| 多模态指令样本 | 二十七万四千余 | 论文摘要 | 论文 |
| 描述指令记录 | 4,181 | 仓库文件计数 | 仓库 |
| 问答指令记录 | 175,734 | 仓库文件计数 | 仓库 |
| 答题式变体 A | 10,386 | 仓库文件计数 | 仓库 |
| 答题式变体 B | 436 | 仓库文件计数 | 仓库 |
| 封闭式题 | 八千八百余 | 论文摘要 | 论文 |
| BCNB 封闭题 | 7,274 | 仓库文件计数 | 仓库 |
| TCGA 封闭题 | 3,176 | 仓库文件计数 | 仓库 |
| HistAI 封闭题 | 769 | 仓库文件计数 | 仓库 |
| CPTAC 封闭题 | 240 | 仓库文件计数 | 仓库 |
| 开放式题 | 129 | 论文摘要 | 论文 |
| TCGA 报告参考 | 1,547 | 仓库文件计数 | 仓库 |
| HistAI 报告参考 | 1,145 | 仓库文件计数 | 仓库 |
| CPTAC 报告参考 | 38 | 仓库文件计数 | 仓库 |
癌种覆盖上,训练集只用了十个 TCGA 癌种,且分布极不均衡:乳腺癌与低级别胶质瘤两项就占了一半以上,食管癌、肾癌、前列腺癌等常见癌种在训练集里完全没有出现。评测则铺开到三十一个癌种。这个「训练窄、评测宽」的设计是刻意的,用来检验泛化,但也意味着评测分数里有相当一部分来自模型的知识储备而非切片观察。
| 癌种缩写 | 病理含义 | 训练问答记录数 | 是否在评测中出现 |
|---|---|---|---|
| BRCA | 乳腺浸润性癌 | 37,564 | 是 |
| LGG | 低级别胶质瘤 | 30,074 | 是 |
| GBM | 胶质母细胞瘤 | 21,009 | 是 |
| LUAD | 肺腺癌 | 17,969 | 是 |
| LUSC | 肺鳞癌 | 16,438 | 是 |
| BLCA | 膀胱尿路上皮癌 | 15,294 | 是 |
| COAD | 结肠腺癌 | 14,418 | 是 |
| HNSC | 头颈鳞癌 | 13,615 | 是 |
| READ | 直肠腺癌 | 5,287 | 是 |
| SKCM | 皮肤黑色素瘤 | 4,066 | 是 |
| ACC/ESCA/KIRC/PRAD 等 | 肾上腺皮质癌、食管癌、肾透明细胞癌、前列腺癌 | 答题式变体中出现 | 是 |
BCNB 的题目结构是另一套逻辑:它不按癌种,按七个临床任务把题平分。七个任务覆盖肿瘤类型判断、雌激素受体、孕激素受体、HER2 状态、HER2 表达强度、分子分型、组织学分级。每类一千题上下,这种「一类任务一摞题」的结构,使它成为四队列里最适合做分任务横向对比的一份。
| 队列 | 切片粒度 | 题目/报告数 | 覆盖癌种或器官 | 是否含参考报告 |
|---|---|---|---|---|
| TCGA | 单切片 | 3,176 题 / 1,547 报告 | 泛癌,三十余种缩写 | 是 |
| BCNB | 单切片 | 7,274 题 | 仅乳腺癌 | 否 |
| CPTAC | 单切片 | 240 题 / 38 报告 | 肾、子宫内膜、黑色素瘤等 | 是 |
| HistAI | 单切片 | 769 题 / 1,145 报告 | 乳腺为主,兼含其他器官 | 是 |
2.5 与同类资源的字段差异
把这份资源放到病理数据集的谱系里看,它与「切片分类数据集」和「报告配对数据集」的差别都在字段层。分类数据集只需要一个标签列;报告配对数据集需要切片与长文本的一对一映射;而这里需要的是「切片 + 问题 + 答案」三元组,且问题要能区分「看图可答」与「不看图也能答」两类。
| 资源类型 | 主键 | 图像表示 | 文本表示 | 典型任务 |
|---|---|---|---|---|
| 切片分类集 | 切片 | WSI 或 patch | 单标签 | 分型、分级 |
| 报告配对集 | 病例 | WSI | 完整报告 | 报告生成、弱监督 |
| 本资源(训练侧) | 记录号 | patch 特征文件 | 一问一答 | 指令微调 |
| 本资源(评测侧) | 行号 | 切片标识 | 四选一或报告 | 评测 |
这个差异在工程上意味着:拿到切片分类集的经验几乎不能直接迁移。分类集可以随手切成训练/验证/测试三份,而这里的切分必须在病例号层做,否则同一张切片的不同提问会跨集泄漏。§2.1 已经指出评测表可以逐行读完,真正需要小心的是训练集与评测集之间的切片重叠,这件事只能由使用者自己做。
§3 它是什么:一条把切片压成十二枚 token 的流水线
3.1 三层编码器与一个语言主干
整条架构由三个编码部分接一个语言主干组成。第一个编码器处理 patch:把切片在选定倍率下切成许多小方块,逐块用病理基础模型编码成一个向量。第二个编码器处理切片整体:对 patch 特征做多级池化,抽出全局视角。第三个部分负责把这两类表示压到固定长度——这是整条流水线最关键的一步。
压缩方式用的是注意力式的池化:不再让模型直接看几千枚 patch,而是让一组可学习的小向量去「查询」这些 patch,每个查询向量汇总它最关心的那一片。查询向量的数量是固定的,论文中对应的设计使得每张切片最终只呈现给语言模型十几枚 token。切片里成千上万个 patch 的信息,被这十几枚 token 代表。
这个设计解释了数据集的形态:仓库里每个特征文件对应的不是一张图的像素,而是这张图切完之后所有 patch 的向量堆叠。文件名里的 .csv 后缀指的是特征表,不是题目表,初次接触时极易混淆。
| 组成 | 输入 | 输出 | 体积由什么决定 |
|---|---|---|---|
| patch 编码器 | 单个 patch 图像小块 | 一维特征向量 | 编码器宽度 |
| 切片编码器 | 全部 patch 特征 | 全局表示 | 池化层数 |
| 切片 token 层 | 全部 patch 特征 + 查询向量 | 固定数量 token | 查询向量个数 |
| 语言主干 | 切片 token + 问题文本 token | 答案文本 | 主干规模 |
3.2 为什么不能直接用 patch 级 VLM
patch 级视觉语言模型在病理上已经做得很成熟,但它们的输入是感兴趣区域,通常是几百到一千像素见方的一小块。这类模型回答「这块区域里是什么细胞」很在行,回答「这张切片边界有没有切干净」则无能为力——后者需要看整张切片的组织轮廓,而轮廓只在低倍下才完整。
更麻烦的是,切片诊断里有大量结论依赖「远看」而非「近看」。肿瘤的整体生长方式、坏死范围的分布、切缘与肿瘤的距离,这些信息在单个 patch 里根本不存在。因此,把 patch 级模型的输出做平均或投票,得不到切片级答案。这正是本文这条路线存在的理由,也是论文反复强调「gigapixel-scale」的原因。
3.3 三档训练文件的分工
三档文件不是简单的大小之分,而是三个不同的监督目标。描述文件教模型「看着切片把诊断写出来」,输出是连贯段落。问答文件教模型「回答具体问题」,输出多是短语或短句。两个答题式变体则把问题进一步结构化,答案更像考试的标准答案。
| 文件 | 监督目标 | 答案形态 | 适合的训练阶段 |
|---|---|---|---|
| 描述指令 | 切片级报告生成 | 三到六句连贯段落 | 第一阶段,对齐切片与语言 |
| 问答指令 | 视觉问答 | 短语、短句、单句解释 | 第二阶段,学问题类型 |
| 答题式变体 A | 结构化问答 | 极短答案,常见单个词 | 与问答混用 |
| 答题式变体 B | 更细粒度的结构化问答 | 短句 | 与问答混用 |
值得注意的是,问答文件里的问题分为两类,这个分法用肉眼就能看出来。一类指向切片本身,比如「这张切片的组织学分级是多少」,答案必须看图才能得出;另一类不指向切片,比如「激素替代治疗与浸润性导管癌风险的关系是什么」,答案是教科书通识,哪张切片挂上去都一样。这两类混在同一个文件里,是本资源最容易被误用的地方,§4.3 的案例会专门处理它。
3.4 数据集卡为什么这么短
数据集卡只有两段,这与仓库的体量很不匹配。一个合理的技术解释是:这份资源的主要发布渠道是论文,仓库只是论文的附件仓库;数据集卡在这个定位下只承担「告诉你要下哪几个文件」的索引功能。这个解释不改变事实,但影响使用者的预期——不能指望从卡里得到使用规范、字段定义或许可信息。
对照库内成熟条目,一份合格的数据集卡至少要交代四件事:数据来源与采集方式、标注流程与标注者资质、字段字典、许可与引用。这份卡四件都没有。因此本文的 §2.2 字段字典、§7.3 偏差清单,实际上是在替它补足这部分内容。
§4 它做得好的与做得不够的
4.1 做得好:把中间产物全部公开了
大多数切片级多模态工作只发论文和权重,数据的中间形态(切片怎么切、特征怎么存、指令长什么样)藏在代码里。这份资源把特征包直接托管,且按癌种切成可独立下载的分片,附带 sha256 校验文件。对想复现「特征 → token」这一段的人来说,这比权重有用得多。
分片的设计也值得记一笔:每个癌种一个或多个 .part-000x 文件,最后一个分片之后紧跟 .sha256。这种做法让使用者可以先下一两个小癌种试通流程,再决定要不要下全量。以乳腺与肾透明细胞癌这样的常见癌种为例,单癌种分片通常在一到数个 GB 之间,试通成本远低于下载整个仓库。
4.2 做得好:评测设计里有一个刻意的泛化测试
训练只看十个癌种,评测铺到三十一个。这个不对称是设计,不是疏漏。它把「模型是在看图还是在背知识」这个问题推到台面上:如果一个模型在训练没见过的癌种上分数掉得很厉害,那它的切片理解能力就可疑;如果分数几乎不掉,那它可能根本没在看图。这个设计思路对做评测的人有直接借鉴价值。
4.3 案例:TCGA-OR-A5J8-01Z-00-DX1 这张肾上腺皮质癌切片
用一张具体的切片把上面所有抽象说法落到地面。这张切片取自 TCGA 的肾上腺皮质癌队列,标识为 TCGA-OR-A5J8-01Z-00-DX1,它同时出现在 TCGA 的封闭题表与训练问答集里。围绕它可以看到三层事实。
第一层是题目的密度。在 TCGA 封闭题表中,这一张切片挂着多道题,覆盖组织构型、分期、核级、细胞形态等不同细类。这些题的标准答案全部以单个字母给出,选项有四个,且次序被打乱——同一张切片的分期题,正确答案落在第三个选项;核级题,正确答案也落在第三个选项,但选项文本本身的排列是 Grade 1、Grade 2、Grade 4、Grade 3,也就是说模型即便知道答案是三级,也必须数清它排在第三位。
第二层是答案的来源。题目文本里出现了「基于病理分期」「依据 Fuhrman 核级系统」这样的措辞,说明题目是从报告里已有的结论反向构造的:报告写了 pT2 pNX,题目就变成「最可能的分期是什么」,正确答案照抄 pT2 pNX。这条链路意味着,标准答案的可靠性上限就是原报告的可靠性,题目并未引入独立的病理复核。
第三层是训练集与评测集的重叠。同一张切片在训练问答集里出现时,问题与答案形态不同,但图像侧完全一致。这构成一个必须处理的风险:如果使用者原样使用官方划分,模型在这张切片上的表现不能算作泛化能力的证据。§4.3 的案例给出的处理办法是按病例号做交集检查,把重叠切片从评测中剔除,或者在报告中显式标注。
4.4 做得不够:封闭题与开放题的比例严重失衡
封闭题八千八百余,开放题一百二十九,比例接近七十比一。这个比例反映的是构造成本——封闭题可以从报告字段模板化批量生成,开放题必须有人写参考答案。但它也带来一个后果:模型在封闭题上的优势被充分测量,而在真正需要组织语言、需要临床推理的报告生成上,测量样本少到只能给出趋势,不能给出稳定结论。
| 题型 | 数量级 | 构造方式 | 评测稳定性 |
|---|---|---|---|
| 封闭题(四选一) | 八千八百余 | 报告字段 → 题干 + 干扰项 | 高,但可被格式捷径抬高 |
| 封闭题(三选一) | 含在上面,HistAI 为主 | 同上 | 中 |
| 开放题(报告生成) | 一百二十九 | 模板题干 + 真实报告 | 低,样本少 |
| 开放题(自由问答) | 论文另有一组 | 专家撰写问题 | 低,评分依赖专家 |
4.5 做得不够:干扰项的构造留下格式线索
四选一的干扰项从同一字段的其他取值里抽,这是标准做法。但当一个字段的取值域很窄、且选项文本长度差很大时,模型可能不看图也能靠措辞猜对。以分期题为例,选项「pT1 pNX」与「pT2 pN0」长度接近,靠长度猜不到;但以细胞形态题为例,正确选项是一整句描述,干扰项是另外三整句,此时正确项往往更长、更具体,形成了可被利用的线索。
这个问题在多份病理 VQA 基准里都存在,不是本资源独有。区别在于,本资源的题目是从报告反向生成的,报告的语言风格统一,干扰项又来自同一批报告的相邻段落,风格相似度更高,线索也就更隐蔽。使用者在报告分数时,应该同时报告一个「不看图、只看题的基线」,这个基线如果不明显低于看图模型,分数就不可信。
4.6 做得不够:没有给出去重与交付边界
Feat 目录下有 32 个 TCGA 癌种分片,但训练指令只用了其中十个。其余二十二个癌种的特征为什么要发布?论文没有说明。一种可能是供使用者做自己的泛化实验,另一种可能是仓库按 TCGA 全集批量打包、未做裁剪。两种解释都成立,仓库没有给出哪个是准的。使用者如果要做训练配方的精确复现,只能以指令文件里实际出现的癌种为准。
§5 怎么拿到:从仓库到可用的一次完整取数
5.1 访问路径与镜像
官方入口是 Hugging Face 的 General-Medical-AI/SlideChat,仓库未设门禁,任何人都可以直接读取文件列表与下载。在国内网络环境下,hf-mirror.com 提供同构镜像,路径与官方一致,把域名替换即可。huggingface_hub 库也支持通过环境变量切到镜像。
需要注意的是,镜像的 API 与官方 API 在字段上不完全等价:镜像的 /api/datasets/{repo} 返回体里 tags 字段通常只保留 size_categories、modality、region 三类,不含 license 与 arxiv 标签。这一点在判断许可时会误导人——看到镜像上没有 license 标签,不能推断官方就有。本文的许可结论是在官方仓库与镜像的 README 原文两侧都核对过的:两侧内容一致,都没有 License 段。
5.2 只读元数据,先不下载
第一步永远是不下载。下面的代码只取仓库元信息与文件树,用来确认文件是否还在、大小是否变化、有没有新增文件。这类检查的成本是几秒钟,而一次误下载的成本可能是几十 GB。
#-- 读取仓库元信息(官方入口),确认文件清单与最近更新时间
python3.11 - <<'PY'
import json, urllib.request

repo = "General-Medical-AI/SlideChat"
url = "https://huggingface.co/api/datasets/" + repo
req = urllib.request.Request(url, headers={"User-Agent": "dataset-audit/1.0"})
meta = json.load(urllib.request.urlopen(req, timeout=30))
print("lastModified:", meta.get("lastModified"))
print("tags:", meta.get("tags"))
lic = [t for t in meta.get("tags", []) if t.startswith("license:")]
print("license tags:", lic if lic else "NONE")
PY
输出的 license tags: NONE 就是许可缺失的机器可读证据。这一行比任何文字描述都直接:Hugging Face 的许可标签是可选的,作者不填,平台不会拦;但对下游来说,不填等于没有授权。
5.3 拉文件树,算出每个文件的体积
仓库的文件树 API 会返回每个文件的字节数和 sha 前缀,可以直接用来做体积核对与版本固定。下面这段会把训练与评测文件列成表,并标出哪些是 JSON、哪些是 CSV。
#-- 列出主目录文件,按体积排序(用 huggingface_hub 或纯 urllib 均可)
import json, urllib.request

def tree(repo, path=""):
    url = f"https://huggingface.co/api/datasets/{repo}/tree/main/{path}".rstrip("/")
    req = urllib.request.Request(url, headers={"User-Agent": "dataset-audit/1.0"})
    return json.load(urllib.request.urlopen(req, timeout=30))

repo = "General-Medical-AI/SlideChat"
rows = [(x["path"], x.get("size", 0)) for x in tree(repo) if x["type"] == "file"]
for path, size in sorted(rows, key=lambda r: -r[1]):
    print(f"{size/1048576:9.2f} MB  {path}")
这段输出里最大的文件是第二阶段的问答指令,其次是报告参考,再次是描述指令。看一眼排序就能判断「下载优先级」:如果只想理解数据结构,先下最小的 SlideInstruction+.json(不到 2 MB)就够了。
5.4 下载单个文件并解析出字段
确认结构之后,再按需下载。下载用 hf_hub_download,它带缓存、带断点续传、能指定 revision。下面这段下载最小的那个指令文件,并打印首条记录的完整结构。
#-- 只下最小的一个文件,先看清结构再决定要不要下大的
from huggingface_hub import hf_hub_download
import json

path = hf_hub_download(
    repo_id="General-Medical-AI/SlideChat",
    filename="SlideInstruction+.json",
    repo_type="dataset",
    revision="main",
)
data = json.load(open(path, encoding="utf-8"))
print("records:", len(data))
print("keys:", list(data[0].keys()))
print("first image:", data[0]["image"])
print("first turn:", data[0]["conversations"][0]["value"][:120])
得到 keys: ['id', 'image', 'conversations'] 之后,就可以完全确定数据的形态:没有额外元数据、没有难度标签、没有来源标注。这也印证了前面的判断——这份资源把「来源」压在文件名里,把「问什么」全放在文本里。
5.5 把评测 CSV 读成统一结构
四个队列的列名不统一,读的时候必须先做列名归一,再合并。下面的代码处理三件事:去掉 BOM、把 Organ 归一成 Tumor、把 HistAI 的三选一补一个空 D 列。
#-- 把四个队列读成同一张表,列名不同的一律映射到统一 schema
import csv, glob, os

base = os.path.expanduser("~/slidechat")
schema = {"ID": "row_id", "Slide": "slide", "Tumor": "tumor", "Organ": "tumor",
          "Task": "task", "Question": "question", "A": "A", "B": "B",
          "C": "C", "D": "D", "Answer": "answer"}
rows = []
for f in sorted(glob.glob(os.path.join(base, "SlideBench-VQA-*.csv"))):
    cohort = os.path.basename(f).split("-")[-1].replace(".csv", "")
    with open(f, encoding="utf-8-sig", newline="") as fh:
        for r in csv.DictReader(fh):
            item = {schema[k]: v for k, v in r.items() if k in schema}
            item.setdefault("D", "")
            item["cohort"] = cohort
            rows.append(item)
print(len(rows), "rows;", len({r["slide"] for r in rows}), "distinct slides")
§4.3 的案例中那张切片在评测表里挂了多道题,正是靠 Slide 列连接起来的。这里还会出现另一个细节:BCNB 的 Slide 列是纯数字编号,没有前缀,与其他三个队列的标识体系完全不同。跨队列去重时不能把 Slide 直接当主键,必须加上 cohort 组成复合键。
5.6 下载特征包并核对校验和
特征包比文本大得多,下载前应该先看分片,下完立刻校验。TCGA 每个癌种目录里最后一个分片之后都跟一个 .sha256 文件,用它校验拼接后的整体。
#-- 下一个小癌种的全部特征分片并校验(以 KIRC 为例,先看再定)
mkdir -p feat/KIRC && cd feat/KIRC
for p in 000 001 002 003 004 005 006; do
  curl -fL -o "KIRC.tar.gz.part-$p" \
    "https://huggingface.co/datasets/General-Medical-AI/SlideChat/resolve/main/Feat/TCGA_patch_feat/KIRC/KIRC.tar.gz.part-$p"
done
curl -fL -o "KIRC.tar.gz.sha256" \
  "https://huggingface.co/datasets/General-Medical-AI/SlideChat/resolve/main/Feat/TCGA_patch_feat/KIRC/KIRC.tar.gz.sha256"
cat KIRC.tar.gz.part-00* > KIRC.tar.gz
sha256sum -c KIRC.tar.gz.sha256
tar -tzf KIRC.tar.gz | head -5
分片数量因癌种而异,不一定是七个;脚本里写死七个只是演示,实际使用前应该先用 5.3 的文件树把该癌种目录列一遍。sha256sum -c 通过之后再解压,否则后面所有的特征对齐都建立在一个损坏的包上。
5.7 取数时最容易踩的四个技术坑
第一个坑是 image 字段是单元素数组而非字符串,data["image"] 取出来是列表,直接做字符串拼接会得到带上方括号与引号的怪字符串,路径就找不到。
第二个坑是特征文件的扩展名。文件名以 .csv 结尾,但列数成千上万,用 pandas 默认参数读会非常慢;应该直接按无表头读取,或者用 numpy.loadtxt 指定 dtype。
第三个坑是 <image> 占位符。它出现在人类问题的末尾,替换时不能只做字符串删除,要在原位置插入切片 token,否则问题与图像的对齐会整体错位一格。
第四个坑是 Answer 列里 HistAI 的写法。HistAI 的封闭题是三选一,D 列为空,用四选一的准确率公式会把这些行算错;BCNB 也有部分行的 D 列为空,但正确答案仍可能是 C,不能用「去掉空选项后重新编号」的简单办法处理。
§6 与库内条目的关系
6.1 关系图谱:它站在三组条目的交叉点上
把库内已有的病理条目按「图像粒度」排列,会看到一条清晰的序列:patch 级分类集、WSI 级分类集、WSI 与报告配对的生成集、以及现在这一份切片级对话集。前三种在库里都有大量条目,第四种此前为空。这个空位不是没人做,而是做的人少、发出来的更少。
第二组关系是测评类条目。库里的病理 QA 基准多围绕显微图像或感兴趣区域,题目形态是「看图回答」,答案由专家撰写。本文这份资源的题目来自报告字段抽取,形态不同,正好构成对照:一边考专家判断,一边考报告复述。
第三组关系是队列类条目。TCGA、CPTAC、BCNB、HistAI 四个队列在库里都有各自的条目或其上级条目。本文这份资源不是新队列,而是把四个已有队列的切片重新组织成题目。因此它与队列条目的关系是「派生」,不是「并列」——队列条目讲数据从哪来,本文讲这些数据被怎么改写成题目。
| 关系类型 | 库内对应 | 关系说明 |
|---|---|---|
| 空位填补 | 病理 VQA / 对话 | 库内此前无此类条目 |
| 下游派生 | TCGA、CPTAC、BCNB、HistAI | 题目由这些队列的切片与报告改写而来 |
| 同层对照 | 病理 QA 基准类条目 | 一个是专家出题,一个是报告抽题 |
| 上游依赖 | WSI 特征编码类条目 | 特征包依赖病理基础模型,编码器版本决定可用性 |
| 方法相关 | 切片级多示例学习条目 | 同属切片级建模,但一个是判别式,一个是生成式 |
6.2 检索路径
按用途找,有四条路。第一条,想理解「切片怎么变成 token」,从 §3.1 与 §2.3 的代码块入手,先看一条记录,再看一层架构。第二条,想找可以直接用的评测集,从 §2.2 的字段表与 §5.5 的归一代码入手,跳过训练部分。第三条,想评估许可风险,直接看 §3.4、§7.3 与常见误读表的第一条。第四条,想找同类资源横向对比,从 §6.1 的关系图谱出发,按「图像粒度」这个轴去找相邻条目。
按关键词找,最有区分度的三个词是「切片级」「指令」「报告改写」。前两个能把它与切片分类集区分开,第三个能把它与专家出题的病理 QA 基准区分开。检索时避开「病理 VQA」这个宽词,它会命中大量基于显微图像而非整张切片的条目。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
在往下读分数之前,需要先在校正一个默认假设。多数人读数据集百科时,默认「质量」指的是数据本身有多准确,于是会去找标注一致性、专家复核率、错误率这些指标。对这份资源,这个默认会带来系统性的误判:它的数据质量在很大程度上不由标注决定,而由上游报告的质量决定。
换句话说,问「这份数据准不准」是问错了对象。封闭题的标准答案照抄报告字段,开放式报告的参考文本就是原报告,训练答案由语言模型根据报告改写。整条链路的上游只有一个,就是各队列自带的病理报告。报告写得细,数据就细;报告漏了某项,数据里就没有这一项,题目还会因此少掉一批。所以本节的所有判断,都要换成「上游报告在什么条件下可信」这个问法来读。
第二个需要校正的点,是分数与能力的关系。论文报告的优势幅度(封闭题十九个百分点、报告生成的评估指标七点七个百分点)是在特定基线与特定题集上测出来的。这些数字说明方法有效,不能说明模型在临床上可用。把前者当成后者,是本节要防的主要误判。
7.1 五维评分
按 DAIMS 五维打分,评的是「作为一份可被 AI 直接使用的数据资源」的成熟度,不是模型的临床价值。
| 维度 | 分数 | 判断依据 |
|---|---|---|
| 可用性(Accessibility) | 4 / 5 | 仓库无门禁、文件树清晰、有校验和;扣分在无许可与无预处理脚本 |
| 可追溯性(Traceability) | 2 / 5 | 切片标识可追溯,但指令答案的来源到「报告」为止,无逐条引用 |
| 完备性(Completeness) | 3 / 5 | 四队列覆盖三十一个癌种,但训练只覆盖十个,非肿瘤为零 |
| 一致性(Consistency) | 3 / 5 | 记录结构统一,跨队列列名不统一,选项数量不一 |
| 可复现性(Reproducibility) | 2 / 5 | 数据可复现,训练流程与特征编码器版本未随仓库给全 |
7.2 分数的含义与不能推出来的事
可用性四分里,那失去的一分很重。无门禁下载与无许可授权是两件事,前者让人能拿到,后者让人能合法用。对个人研究者,这一分几乎不影响;对企业与医院,这一分足以让整套流程停在上线之前。
可追溯性两分是这份资源的结构性问题。切片标识精确到 TCGA 条码或 C3L 编号,这部分做得很好;但一条训练记录的答案来自哪份报告的哪一段,数据里没有任何字段指向。要核对某条答案,只能靠人工回到原报告里搜。对做审计的人来说,这意味着任何抽查都是 O(n) 的人工工作。
可复现性两分最容易被低估。数据能下、能读、能对,但论文里的特征编码器是哪一版、patch 尺寸多少、池化层几何如何配置,这些决定了特征包能不能被正确还原成 token。仓库不给这些参数,使用者只能按论文描述自行猜测,猜错则特征维度对不上。
7.3 已知的、可枚举的偏差
§4.3 的案例已经说明,题目与答案之间是一层报告改写而非独立复核;这条链路带来的问题,在癌种上表现最直接。训练集十个癌种中,乳腺、胶质瘤、肺、膀胱四类占了绝大多数,食管、肾、前列腺、肝在训练问答里不出现,只在答题式变体里零星出现。模型在评测中遇到这些癌种时,只能靠语言侧的知识,切片侧几乎无监督信号。
第二类偏差是任务偏差。BCNB 的七类任务全是乳腺癌的临床指标,这让评测在乳腺癌上的颗粒度极细;而其他癌种只有粗细类两级的少量题目,颗粒度极粗。跨癌种比较分数时,这个不对称会放大差异。
第三类偏差是语言偏差。全部题目与答案都是英文,措辞统一为「作为资深病理医师,请判断」这类模板句式。中文病理报告改写的指令是否可用,未做验证。
第四类偏差是风格偏差。开放式报告的参考文本来自不同机构,长度与详细程度差异极大:HistAI 的参考报告常见一句话式的要点罗列,TCGA 的参考报告是完整段落。模型在同一批题上学到的报告风格会随队列漂移。
第五类偏差是缺失偏差。BCNB 没有开放式报告集,HistAI 的封闭题只有三选一。四队列在题型上并不对称,任何「四队列平均」的汇总指标都会掩盖这一点。
| 偏差类型 | 表现 | 对结论的影响 |
|---|---|---|
| 癌种 | 训练十个、评测三十一个 | 未见癌种的分数偏低不能归因于切片理解 |
| 任务 | 乳腺癌任务极细,其他极粗 | 跨癌种比较被放大 |
| 语言 | 全英文模板句式 | 中文场景未验证 |
| 风格 | 报告长度与详略随队列漂移 | 报告生成指标受队列影响 |
| 缺失 | BCNB 无报告集、HistAI 无四选一 | 汇总均值失真 |
7.4 外部验证矩阵
把本文这份资源与三个可对照的对象放在一起:论文自身的内部评测、库内专家出题的病理 QA 基准、以及临床端的专家读片。三者回答的问题不同,不能互相替代。
| 验证对象 | 验证了什么 | 没验证什么 |
|---|---|---|
| 论文内部评测 | 在四队列固定题目上优于基线 | 题目本身是否有格式捷径 |
| 对照其他病理 QA 基准 | 题目形态与专家出题基准的差别 | 同一模型在两类题上的能力差距来源 |
| 专家评分 | 开放式回答在五个维度上的相对优劣 | 与真实诊断结论的一致性 |
| 前瞻性临床使用 | 无公开证据 | — |
| 跨机构外部验证 | 部分队列本身就是外部数据 | 未覆盖亚洲以外以外的更多机构 |
矩阵里最关键的一格是「前瞻性临床使用」——它是空的。这不是这份资源独有的问题,而是整个病理多模态对话方向的共同缺口。任何把它直接推到临床场景的叙述,都需要补上这一格才能成立。
7.5 它为何能持续:三条腿支撑的生存逻辑
这份资源能否继续被使用,取决于三个条件是否同时成立。第一个条件是上游队列的开放性。TCGA 与 CPTAC 的部分切片属于受控访问,BCNB 与 HistAI 各有自己的申请流程。只要这些队列继续开放,基于它们构造的题目就能被重新生成,这份资源的评测部分也就有再生能力。
第二个条件是特征编码器的可获取性。仓库里的特征包是某个病理基础模型的输出,只要那个模型继续可下载、版本不再大改,特征包就能被正确解读。反过来说,编码器一旦闭源或重构,这批特征就会变成只读的死数据。
第三个条件是切片级对话这个任务本身是否被承认。如果后续工作普遍转向「切片级检索加工具调用」而不是「切片进上下文」,这份指令数据的方法论价值就会下降,但它作为「第一批把整张切片接进语言模型的公开产物」的历史位置不会消失。
三条腿里,第一条最稳,第二条有风险,第三条取决于领域走向。这也是为什么本文把它定位为「工程样本」而非「基础设施」——基础设施需要三条腿同时稳固,样本只需要在其中一条上有不可替代的参考价值。
§8 生态位与历史
8.1 历史沿革:从 patch 级助手到切片级对话
2023 年前后,病理视觉语言模型的第一波工作是「区域级」的:给模型一块感兴趣区域,让它描述、诊断、回答。这类模型很快遇到了天花板——区域是人工框的,模型只在被框定的范围内有效,而真实诊断从来不是从一块区域开始的。
2024 年起,方向转向切片级。做法大体分两类:一类是把切片压成图(缩略图加局部放大),再按普通多模态方式处理;另一类是先把全部 patch 编码成特征,再在特征空间里做压缩与聚合。本文这份资源属于后一类,它把压缩这步做成可学习的注意力池化,并把这个中间产物公开发布。
2024 年 11 月仓库上线,2026 年论文见刊。这两年的时间差本身就是一条信息:数据早于论文发布,说明作者愿意让社区先看到中间产物;同时仓库在两年里只更新过元数据,内容未变,说明这批文件是一次性打包发布后就不再维护的类型。
8.2 与相邻方法的分工
同一条路线上还有其他公开工作,各自的分工不同。有的工作侧重用海量切片与配套描述训练切片编码器,产出的是表征模型而非对话模型;有的工作侧重把切片切成超长序列交给长上下文视觉主干,产出的是端到端可微但推理成本高的系统;本文这份资源侧重把压缩与指令两件事同时做成可复用的数据。
| 路线 | 压缩方式 | 主要产出 | 与本资源的关系 |
|---|---|---|---|
| 切片表征 | 多示例池化 | 切片向量 | 本文的特征包来自这条线 |
| 长上下文视觉 | 保留大量 patch 序列 | 端到端系统 | 压缩思路相反 |
| 缩略图 + 局部 | 人工或规则选图 | 轻量多模态 | 信息损失更早 |
| 本文路线 | 可学习查询池化 | 数据 + 模型 | 同时发布中间产物 |
这个分工表说明一件事:本文这份资源在方法上并非唯一解,它的独特性在于「同时公开了数据侧的三段产物」。
8.3 它填的空位:病理条目里缺的那一档
库内病理条目按用途大致能分出四档:分割与检测、分类与分型、配准与增强、报告配对与生成。第四档里已经有不少「WSI + 报告」的条目,但它们的用途是弱监督训练或报告生成评测,题目形态是「给定切片写报告」,而不是「给定切片回答问题」。
本资源落在第四档与第五档之间:它有报告生成,也有问答,且问答是有标准答案的选择题。这一档此前在库内是空的。填上这一档的意义,不在于又多了一条病理条目,而在于补上了「切片级交互」这个维度——前面的条目都是单向的,这条是双向的。
| 库内档次 | 典型任务 | 交互方式 | 本资源位置 |
|---|---|---|---|
| 分割与检测 | 细胞核、腺体 | 无 | — |
| 分类与分型 | 癌种、分级 | 无 | — |
| 配准与增强 | 多染色对齐 | 无 | — |
| 报告配对与生成 | 报告生成 | 单向 | 部分重合 |
| 切片级交互 | 问答、追问 | 双向 | 这一档 |
8.4 它在方法史上的位置
把时间轴拉长,这份资源属于「多模态模型从看图说话转向看整张图说话」这个转段的产物。它的技术贡献会被后续更高效的压缩方法超越,但它的数据组织方式——把切片特征、指令、题目三段一起发布,且每段都保持可读——很可能会成为后来者的参考格式。
对写方法综述的人来说,它提供了一个很好的坐标:在它之前,切片级多模态的公开数据基本只有「切片 + 报告」的配对;在它之后,「切片 + 问题 + 答案」的三元组开始出现,并且评测从「生成得像不像」扩展到「选得对不对」。这个坐标的价值独立于它的分数高低。
§9 使用指引
9.1 三种角色的路径
第一种角色是方法研究者,想复现或改进切片到 token 的压缩。路径是:先读 §3.1 的架构,再下 5.6 里的一个小癌种特征包,按论文描述实现池化层,用 5.4 下的小指令文件跑通一条样例,最后才考虑全量。这条路径的重点是把「特征维度对不上」这个错误尽早暴露。
第二种角色是评测者,只想找一个切片级问答基准。路径是:跳过训练文件,直接走 5.5 的归一代码,把四队列合成一张表,按癌种与任务分别统计。重点是先报告「不看图基线」,再报告模型分数,否则无法判断模型是不是在猜格式。
第三种角色是决策者,要判断这份资源能不能进入某个项目。路径是:只读 §3.4、§7.3、§7.4 与常见误读表,把「许可」「前瞻验证」「非肿瘤覆盖」三件事分别对到自己的项目要求上。三者中任何一项不满足,都应停止推进。
| 角色 | 第一步 | 关键风险 | 判断标准 |
|---|---|---|---|
| 方法研究者 | 下小癌种特征包 | 编码器版本不明 | 特征维度能否对上 |
| 评测者 | 归一四队列列名 | 训练评测重叠 | 不看图基线是否显著低 |
| 决策者 | 读许可与验证矩阵 | 无授权、无前瞻证据 | 三项硬要求是否全过 |
9.2 一条最短的可用流程
对只想「看到一条真实记录长什么样」的人,下面的流程不需要 GPU、不需要下载大文件,全程几十兆以内。它做四件事:拉一个指令文件的头部、拉一张评测表的头部、把两者对齐到同一个切片标识上、打印出这条切片在两边分别被问过什么。
#-- 最短流程:不下大文件,只看一条记录在训练侧与评测侧各长什么样
python3.11 - <<'PY'
import csv, io, json, urllib.request

base = "https://huggingface.co/datasets/General-Medical-AI/SlideChat/resolve/main/"
def head(path, nbytes):
    req = urllib.request.Request(base + path, headers={"Range": f"bytes=0-{nbytes}",
                                                       "User-Agent": "audit/1.0"})
    return urllib.request.urlopen(req, timeout=60).read().decode("utf-8", "ignore")

raw = head("SlideBench-VQA-TCGA.csv", 400000)
rows = list(csv.DictReader(io.StringIO(raw)))
first = rows[0]
print("slide:", first["Slide"])
print("question:", first["Question"][:90])
print("answer:", first["Answer"])
print("same slide questions:", sum(1 for r in rows if r["Slide"] == first["Slide"]))
PY
这里只取了评测侧。要再对上训练侧,把 first["Slide"] 的条码前缀拿去第二阶段问答文件里搜一次即可;由于该文件有一百多兆,建议用 huggingface_hub 的本地缓存方案而不是每次重下。这条流程的价值在于:它能在没有任何 GPU 的情况下,把「训练侧问什么」与「评测侧怎么判」两件事放到眼前对齐。
9.3 引用方式
引用这份资源时,应同时给出数据与论文两条。数据的引用信息在仓库里没有现成的 BibTeX,只能按仓库名与访问路径手写;论文的引用以 DOI 为准。由于仓库未声明许可,引用不等于获得授权,在论文的「数据可用性」段落里应写明「许可未声明」这一事实,而不是含糊地写成「公开可用」。
@misc{slidechat_dataset_2024,
  title  = {SlideChat: Dataset resources for whole-slide pathology image understanding},
  author = {{General-Medical-AI}},
  year   = {2024},
  note   = {Hugging Face dataset repository, no license declared},
  howpublished = {https://huggingface.co/datasets/General-Medical-AI/SlideChat}
}

@article{slidechat_nature_cancer_2026,
  title  = {SlideChat: a multimodal generative AI assistant for whole-slide computational pathology},
  journal = {Nature Cancer},
  year   = {2026},
  doi    = {10.1038/s43018-026-01220-4}
}
论文作者列表很长,二三十人量级,正式引用时应以期刊页面给出的完整作者列表为准,不要用本节示例里省略后的版本。
§10 AI 使用声明
| 项目 | 说明 |
|---|---|
| 本页作者 | 千方医数集编辑,人工撰写框架与判断 |
| AI 参与范围 | 中文行文润色、表格排版、代码片段初稿 |
| 事实来源 | 官方仓库文件树与数据集卡原文、Nature Cancer 论文摘要、仓库内文件内容 |
| 未使用 AI 生成的内容 | 所有数字均取自上述来源,未做外推 |
| 核查方式 | 文件计数与字段名由脚本逐个访问仓库文件得到 |
| 未能核查的内容 | 论文全文、训练超参、特征编码器具体版本 |
| 引用与再分发 | 本页引用仓库结构,未收录任何切片图像或患者文本 |
| 更新责任 | 许可状态变化时,本页结论需重新核对 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 「这是开源的,可以随便用」 | 仓库无 License 段、无 license 标签,默认保留所有权利 | 仓库 README 全文仅两段目录说明;API 的 tags 里没有 license 项 |
| 「27 万条就是 27 万张切片」 | 计数单位是问答对,同一张切片被反复提问 | 第二阶段文件 17 万余条记录,但癌种与切片高度重复出现 |
| 「里面有切片图片」 | 只有 patch 特征与文件名,无像素 | 文件树中无图像文件,image 字段指向特征表 |
| 「答案都是病理医师逐条标的」 | 封闭题答案从报告字段抽取,训练答案由语言模型改写 | 题目措辞含「基于病理分期」等报告用语 |
| 「问了切片就等于看了切片」 | 大量问题属通识题,不看图也能答 | 问答集中存在激素替代治疗这类与图像无关的问题 |
| 「四个队列都是独立测试集」 | TCGA 评测切片与训练集同源,可能重叠 | 训练问答与 TCGA 评测均取自 TCGA 同一队列 |
| 「报告生成分数可以直接比较」 | 参考报告风格随队列漂移,长度差异极大 | HistAI 多为要点式短句,TCGA 为完整段落 |
| 「它已经能用于临床辅助诊断」 | 无前瞻验证、无监管路径、无患者级信息 | 仓库无临床验证材料,论文未报告前瞻研究 |
| 「特征包可以随便换编码器重新解读」 | 特征维度与编码器强绑定,换编码器即失效 | 仓库未记录编码器版本与 patch 参数 |
| 「许可没写就是随便用」 | 无声明在著作权上是最保守解释的默认 | 缺少 License 段不构成授权,须书面许可 |
FAQ
Q1:这份数据能商用吗?
不能据此判断可以商用。仓库没有 License 段,也没有附加使用条款,按最保守的解读应视为保留所有权利。商用需要事先取得作者书面授权,且即便取得授权,训练集里来自 TCGA 与 CPTAC 的部分仍受各自门户条款约束。
Q2:它包含原始切片像素吗?
不包含。仓库提供的是 patch 级特征包与特征文件名,原始切片需要自行前往各队列门户申请。TCGA 与 CPTAC 的部分数据属于受控访问,需要提交申请并通过审核。
Q3:二十七万条指令对应多少张切片?
不是一一对应。指令条数是问答对的数量,同一张切片在第二阶段会被多次提问,尤其是通识类问题,一张切片可挂上数十条。按切片估算数据量会高估一个数量级。
Q4:为什么训练只用了十个癌种,评测却有三十一个?
这是刻意的泛化测试设计,用来区分模型是在看图还是在背知识。代价是未见癌种上的分数不能单独归因于切片理解能力,需要与语言侧基线对照。
Q5:四选一题的选项为什么顺序不规则?
选项次序被打乱,同一张切片的不同题,正确项可能落在不同位置。这是防位置猜测的常规做法,但也意味着模型必须把字母与文本对应起来,不能只输出位置。
Q6:能不能直接拿报告生成结果写病历?
不能。生成的是切片级描述性报告草稿,缺少临床信息、影像与实验室依据,也没有经过前瞻性验证。它只能用于研究与教学演示。
Q7:训练集和评测集会不会重叠?
存在可能性。训练问答的十个癌种与 TCGA 评测切片来自同一公开队列,官方未说明是否按病例号隔离。使用前应自行按病例号做交集检查。
Q8:HistAI 的题为什么只有三个选项?
HistAI 队列的原始设计是三选一,文件里 D 列为空。用四选一的准确率公式会把这类行算错,统计时必须按队列分别处理。
Q9:特征包为什么要分片?
单个癌种的特征文件可达数 GB,分片是为了支持断点续传与部分下载。每个癌种的最后一个分片之后跟一个 sha256 文件,用于校验拼接后的整体完整性。
Q10:它和库里已有的病理报告生成条目有什么区别?
已有条目多是「切片配报告」的单向生成,本资源增加了带标准答案的选择题,交互是双向的。两者的评测目标不同,不能混在一张表里比较。
Q11:中文病理场景能用吗?
未验证。全部指令与题目都是英文模板句式,中文报告改写的指令是否可用没有任何公开证据,直接套用需要自行构建中文指令并重新评测。
Q12:如果只想要评测集,需要下载多大?
七个 CSV 合计不足十兆,可以全部下载后逐行读完。真正的成本不在下载,而在理解四队列的列名差异与选项数量差异,这部分需要写归一代码。
术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 全切片图像 | whole-slide image | 病理玻片经扫描得到的分辨率极高、可分级缩放的图像 |
| 小图块 | patch | 从切片上按固定像素尺寸切出的小方块,是编码的基本单位 |
| 文本标记 | token | 语言模型处理的基本单位,切片侧被压成的向量组也称 token |
| 查询池化 | query pooling | 用一组可学习向量汇总 patch 特征的压缩方法 |
| 视觉问答 | visual question answering | 给定图像与问题输出答案的任务 |
| 指令微调 | instruction tuning | 用「指令-回答」样本训练模型遵循指令 |
| 封闭式题 | closed-ended question | 选项固定的选择题 |
| 开放式题 | open-ended question | 无固定选项、需生成文本的题 |
| 报告生成 | report generation | 由图像生成结构化或叙述性诊断报告 |
| 基准 | benchmark | 用于横向比较模型能力的固定题集 |
| 队列 | cohort | 按同一来源或同一标准收集的一组样本 |
| 受控访问 | controlled access | 需申请与审批才能获取的数据分发方式 |
| 数据泄漏 | data leakage | 训练数据与评测数据重叠导致分数虚高 |
| 干扰项 | distractor | 选择题中非正确的选项 |
| 泛化 | generalization | 在未见数据上保持性能的能力 |
| 弱监督 | weakly supervised | 只用粗粒度标签训练的监督方式 |
| 多示例学习 | multiple instance learning | 把一组小样本打包成一个标签进行训练的方法 |
| 校验和 | checksum | 用于验证文件完整性的哈希值 |
| 许可 | license | 授权他人使用、修改、再分发的法律文本 |
| 前瞻性验证 | prospective validation | 在真实使用场景中事先设计并执行的验证 |
| 检索增强 | retrieval augmentation | 先检索相关知识再生成答案的做法 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 多模态指令样本 | 二十七万四千余 | 论文摘要 | 论文 |
| 封闭式题 | 八千八百余 | 论文摘要 | 论文 |
| 开放式题 | 一百二十九 | 论文摘要 | 论文 |
| 报告数 | 三千一百余 | 论文摘要 | 论文 |
| 癌种数 | 三十一 | 论文摘要 | 论文 |
| 队列数 | 五 | 论文摘要 | 论文 |
| 封闭题优势幅度 | 十九点一个百分点 | 论文摘要 | 论文 |
| 报告生成指标优势 | 七点七个百分点 | 论文摘要 | 论文 |
| 描述指令记录 | 4,181 | 仓库文件 | 官方仓库 |
| 问答指令记录 | 175,734 | 仓库文件 | 官方仓库 |
| 答题式变体 A | 10,386 | 仓库文件 | 官方仓库 |
| 答题式变体 B | 436 | 仓库文件 | 官方仓库 |
| TCGA 封闭题 | 3,176 | 仓库文件 | 官方仓库 |
| BCNB 封闭题 | 7,274 | 仓库文件 | 官方仓库 |
| HistAI 封闭题 | 769 | 仓库文件 | 官方仓库 |
| CPTAC 封闭题 | 240 | 仓库文件 | 官方仓库 |
| TCGA 报告 | 1,547 | 仓库文件 | 官方仓库 |
| HistAI 报告 | 1,145 | 仓库文件 | 官方仓库 |
| CPTAC 报告 | 38 | 仓库文件 | 官方仓库 |
| 特征癌种目录 | 32 | 仓库文件树 | 官方仓库 |
| 训练用癌种 | 10 | 文件内容 | 官方仓库 |
| 许可 | 未声明 | 数据集卡 | 官方仓库 |
| 论文 DOI | 10.1038/s43018-026-01220-4 | 文献检索 | 论文 |
附录 B:数字的来源分层
| 层级 | 定义 | 本页对应的数字 |
|---|---|---|
| 第一层:官方页面 | 仓库数据集卡、文件树、API 返回值 | 全部文件计数、字段名、体积、许可状态 |
| 第二层:论文摘要 | Nature Cancer 摘要文本 | 指令样本数、题量、报告数、癌种数、优势幅度 |
| 第三层:未核实 | 论文全文、训练超参、编码器版本、患者数 | 论文正文细节未取、训练超参未取、编码器版本未取 |
三层的边界要守清楚。第一层的数字可以逐个文件复核,第二层的数字只能引用不能核到行,第三层的数字本文一律不给。遇到需要第三层才能回答的问题,正文里都用「未核实」或「官方未说明」标注,而不是用一个看起来合理的估算填上。
附录 C:完整参考文献
| 编号 | 文献 | 类型 | 可访问性 |
|---|---|---|---|
| 1 | Chen Y, Ma C, Li Q, 等. SlideChat: a multimodal generative AI assistant for whole-slide computational pathology. Nature Cancer, 2026. DOI 10.1038/s43018-026-01220-4 | 期刊论文 | 摘要公开 |
| 2 | General-Medical-AI. SlideChat 数据集仓库. Hugging Face, 创建于 2024-11-07. | 数据集 | 公开,未设门禁 |
| 3 | 仓库数据集卡 README(Introduction / Contents 两段) | 数据说明 | 公开 |
| 4 | Europe PMC 检索返回的 SlideChat 条目摘要 | 文献索引 | 公开 |
| 5 | 仓库文件 SlideBench-VQA-TCGA.csv 等七份基准文件 |
数据文件 | 公开 |
| 6 | 仓库文件 SlideInstruct_train_stage1_caption.json 等四份指令文件 |
数据文件 | 公开 |
附录 D:术语与文件对照速查
| 你听到的说法 | 对应文件 | 对应字段 |
|---|---|---|
| 「第一阶段数据」 | 描述指令 JSON | conversations 里的段落式回答 |
| 「第二阶段数据」 | 问答指令 JSON | conversations 里的短句回答 |
| 「测评题」 | 四份 VQA CSV | Question / A–D / Answer |
| 「报告题」 | 三份 Caption CSV | Question 模板与 Answer 全文 |
| 「切片特征」 | Feat 目录分片 |
无字段,纯数值矩阵 |
| 「切片编号」 | VQA/Caption CSV | Slide 列,跨队列格式不同 |
附录 E:如果只记五件事
第一,它解决的是尺度错配——把整张切片压成十几枚 token,再交给语言模型对话,这个压缩方式决定了模型能看见什么。
第二,二十七万条是问答对,不是切片;同一张切片会被反复提问,按切片估算会高估一个数量级。
第三,答案的上游是各队列自带的诊断报告,不是独立的病理复核,所以数据质量的上限就是报告质量的上限。
第四,训练用十个癌种、评测铺到三十一个,是刻意的泛化测试,也意味着未见癌种的分数不能单看。
第五,许可未声明,默认按不可商用处理;这一条不是技术细节,而是决定能否落地的第一道门。
编辑说明
本页的核验时间为 2026-10-26。核验方式为逐个访问官方仓库的文件树接口与数据集卡原文,读取文件头与全量计数,并用 Europe PMC 检索论文摘要。未取论文全文,未下载特征包的全部内容,未运行任何训练或推理。未覆盖的内容包括:论文正文里的表格与消融实验、特征编码器的具体版本与 patch 参数、训练超参、以及四个队列各自的许可链路细节。若官方后续补充 License 段,本页 §3.4、§7.3、常见误读首条与 FAQ 首条需同步改写。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- dalphin — 共享标签:医学影像 / 病理图像 / 医学问答与基准 / 视觉问答 / 肿瘤学
- deep-tumor-vqa — 共享标签:医学影像 / 医学问答与基准 / 视觉问答 / 肿瘤学
- ego-wear-bench — 共享标签:多模态 / 医学问答与基准 / 视觉问答
- panda — 共享标签:医学影像 / 病理图像 / 医学问答与基准 / 肿瘤学
- paip — 共享标签:医学影像 / 病理图像 / 医学问答与基准 / 肿瘤学
- herlev-pap — 共享标签:医学影像 / 病理图像 / 医学问答与基准 / 肿瘤学
- sipakmed — 共享标签:医学影像 / 病理图像 / 医学问答与基准 / 肿瘤学
- cmb-aml — 共享标签:医学影像 / 病理图像 / 多模态 / 肿瘤学
- patchgastricadc22 — 共享标签:医学影像 / 病理图像 / 多模态 / 肿瘤学
- multi-oscc-histopath — 共享标签:医学影像 / 病理图像 / 多模态 / 肿瘤学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
