信息速览
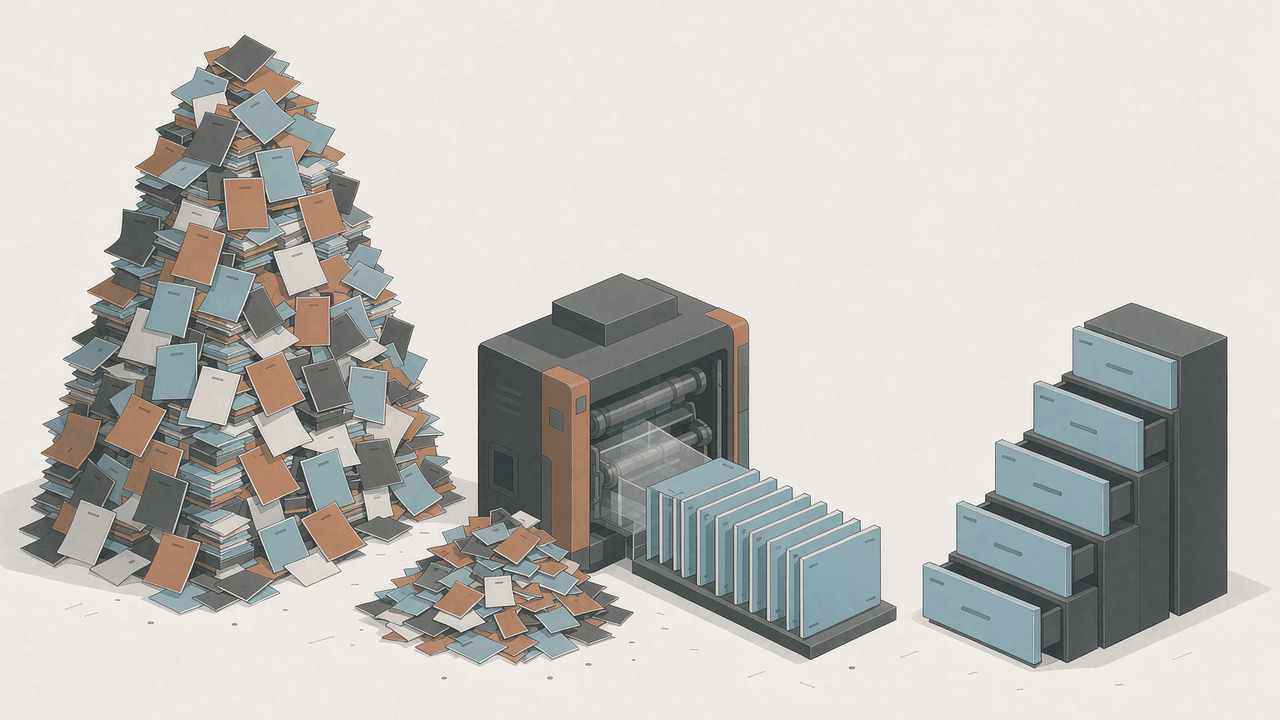
RefSeq 是 NCBI 维护的参考序列库,全称 NCBI Reference Sequence Database。它做的事情可以用一句话概括:从 GenBank 收下的海量提交里,为每个物种的每一种天然分子挑出一条代表序列,重新验证、重新注释,编上带下划线的登录号,再按双月节奏整体发布。Release 237 于 2026 年 8 月 31 日发布,含十八万四千七百五十二个物种、六亿四千五百五十万条登录号、6.7 万亿个核苷酸碱基与一千九百三十九亿个氨基酸残基。
它与 GenBank 的关系不是替代,而是分工。GenBank 是原始档案,作者交什么就存什么,NCBI 不改一个字;RefSeq 是建在这座档案上的选本,同一条序列在两边各有一个登录号,含义与责任都不同。理解这一点,才能理解它为什么既有高质量的人工策展记录,也有大量由流程自动生成的预测记录。
它的骨架是一套前缀体系。NC_ 指染色体,NG_ 指基因组区域,NM_ 指编码转录本,NP_ 指对应蛋白,XM_、XP_ 指流程预测的转录本与蛋白,WP_ 指跨物种去冗余的蛋白——十五种前缀,各自对应一种分子类型与一种生产路径。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 全称 | NCBI Reference Sequence Database |
| 维护方 | 美国国家生物技术信息中心(NCBI),隶属 NLM / NIH |
| 首次发布 | 2003 年 6 月 30 日,Release 1,2,005 个物种 |
| 当前版本 | Release 237,2026 年 8 月 31 日 |
| 物种数 | 184,752 个(按分类号计) |
| 登录号数 | 645,505,406 条 |
| 序列总量 | 6,703,188,511,506 个核苷酸碱基;193,908,692,498 个氨基酸残基 |
| 分子类型 | 基因组、RNA、蛋白、WGS 主记录四类 |
| 前缀体系 | NC_、AC_、NG_、NT_、NW_、NZ_、NM_、XM_、NR_、XR_、NP_、AP_、XP_、YP_、WP_ 十五种 |
| 状态码 | REVIEWED、VALIDATED、PROVISIONAL、PREDICTED、INFERRED、MODEL、UNKNOWN,另有 na |
| 目录结构 | 13 个分类节点加 1 个 complete 全量节点,同一记录至少出现两次 |
| 文件格式 | FASTA、GenBank 平文件、ASN.1 三类,gzip 压缩 |
| 发布节奏 | 全量版本约每两月一次,两次之间提供每日增量 |
| 上游 | INSDC 三库(GenBank、EMBL、DDBJ)的公开提交 |
| 下游 | 比对、注释、变异报告、临床检测、模型训练 |
| 不包含 | 原始读段、临床表型、未被选中的提交、非真核的转录本记录 |
| 许可 | 可自由下载;引用时需注明论文与版本号 |
§1 它要解决的具体麻烦
1.1 同一个基因,在档案里有几十条几乎一样的序列
一个常见的人类基因,在 GenBank 里可能有几十条甚至上百条提交:不同实验室、不同年代、不同测序策略,序列长度从几百碱基到全长不等,有的带载体残留,有的把内含子当外显子标了,有的 5′ 端少了一截。它们都是真实提交,都被永久保存,但没有任何一条可以被单独称为「这个基因的序列」。
这件事在比对、引物设计、变异命名、蛋白结构预测里都会立刻变成麻烦。想给一个位点写坐标,得先决定以哪条序列为准;换一条,坐标全变。想让一个模型学会「基因到蛋白」的映射,得先有一份不重复、不自相矛盾的对照表,而档案本身不提供这份表。
RefSeq 的切入点就在这里。它不增加新数据,只做减法与整编:为每个物种的每种天然分子挑一条代表,把该修的修掉,把该标的标上,给它一个稳定的编号。论文与发布说明里反复用同一个说法——生物意义上的非冗余,即每个物种或样本的每种天然分子只留一个例子。
代价同样明确:被舍弃的那些提交并不会消失,但它们从此不在 RefSeq 里,想找必须回 GenBank。选本必然有取舍,取舍标准掌握在策展方手里。
1.2 三条常见的错误期待
| 常见期待 | 实际情况 |
|---|---|
| 以为 RefSeq 是「最新最全的序列库」 | 它求的是代表性与一致性,不是覆盖度。收录与否取决于数据量与策展资源,很多有数据的物种并不在里面 |
| 以为库里的记录都经过人工审阅 | 蛋白记录里绝大多数是流程自动生成的 XP_,人工审阅的只占很小一部分 |
| 以为编号相同就是同一条序列 | 同一个基因的多条 NM_ 对应不同剪接异构体,坐标与序列都不同 |
1.3 它给得到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 一条基因的权威转录本与蛋白序列 | NM_ 与对应的 NP_,附版本号 | 够,这是它的主场 |
| 一个物种的全基因组与全部基因注释 | NC_ 染色体加 NG_、NM_、NR_、NP_ 一整套 | 够,但注释完整度随物种差别很大 |
| 跨物种可比的同源蛋白集合 | WP_ 非冗余蛋白,跨菌株与跨物种合并 | 够做聚类,不做直系同源的精细判定 |
| 变异报告的参考坐标 | NM_、NG_ 加版本号,临床报告的通用基准 | 够,但必须锁定版本 |
| 原始测序读段 | 不给,需回 SRA | 不够 |
| 临床表型与随访 | 不给,需回 ClinVar、dbGaP 等 | 不够 |
| 未收录物种的任意序列 | 不给,只能回 GenBank 取原始提交 | 不够 |
| 基因表达量 | 不给,表达数据在 GEO 与 SRA | 不够 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 要给一批变异写 HGVS 命名,缺统一坐标基准 | 提供 NM_、NG_ 与版本号,是临床命名的通行基准 | 固定 accession.version,记录在报告脚注里 |
| 要训练蛋白语言模型,需要一份不重复的蛋白集 | 提供按物种、按状态码可筛的蛋白 FASTA | 用状态码把 XP_ 与 NP_ 分开,按需决定是否纳入预测记录 |
| 要做宏基因组或比较基因组,需要参考基因组 | 提供 NC_、NZ_、NZ_ 支架级的完整与草稿基因组 | 记录组装号与注释名,避免跨版本比较 |
| 要设计 qPCR 引物或 CRISPR 靶点 | 提供经核对的转录本与基因组坐标 | 用 NG_ 或 NC_ 定位,避开多态位点 |
| 要做临床检测的位点报告 | 提供与 LRG、MANE 对接的稳定转录本 | 优先选 MANE Select 标记的那一条 |
| 想找某个物种的全部序列 | 可能根本没有该物种的 RefSeq | 回 GenBank 或该物种的专门数据库 |
1.5 一句话判断
如果需要一个稳定、可引用、跨物种口径一致的序列基准,RefSeq 是默认起点;如果需要的是「所有被提交过的序列」,它从来不是那个库,将来也不会是。
1.6 不适合谁:四条边界
第一,不适合把 RefSeq 当作序列全集的人。它是选本。同一物种同一分子只留一条代表,其余提交只存在于 GenBank。做变异发现、罕见的个体特异序列、宏基因组里的新物种,都需要回到原始档案。
第二,不适合把预测记录当作已证实结论的人。XM_、XR_、XP_ 由注释流程批量生成,随组装与算法版本整体更换。用它们做基因集统计,必须先声明是否包含预测记录,否则同一物种在不同版本下会得出不同基因数。
第三,不适合需要临床表型的人。RefSeq 是序列库,不含样本、疾病、随访。变异与表型的关联在 ClinVar,基因与疾病的关联在 OMIM 与 Gene,人群频率在 gnomAD 一类资源。
第四,不适合需要原始读段的人。它只给组装后的序列与注释,不给 FASTQ、BAM、覆盖度。想复核一个位点是否真实,必须回 SRA 取原始数据。
§2 数据构成与规格
2.1 四类分子,一张统计表
Release 237 的发布说明把体量拆成四行,这四行就是整个库的骨架。
| 分子类型 | 记录数 | 碱基或残基总数 |
|---|---|---|
| 基因组(Genomic) | 63,683,560 | 6,452,968,191,891 |
| RNA | 86,067,871 | 250,220,319,615 |
| 蛋白(Protein) | 495,290,394 | 193,908,692,498 |
| WGS 主记录(Wgs master) | 463,581 | 不适用 |
| 合计 | 六亿四千五百五十万 | — |
四行相加正好等于总数,说明统计口径没有重叠。基因组一类装的是染色体、支架、重叠群与质粒;RNA 一类装的是转录本,编码与非编码都在里面;蛋白一类是最大的一块,接近全库的四分之三;WGS 主记录不装序列,只标记一个全基因组鸟枪项目,用来把散落的支架归拢到一个项目号下。
有一个细节值得记住:分子类型不单独占一列。发布目录只有六列——分类号、物种名、登录号与版本、所在目录、状态码、长度——想知道一条记录是 DNA 还是蛋白,只能看前缀。这是设计上的取舍,前缀本身就是类型标签。
2.2 十五种前缀:整个库的语法
前缀是理解 RefSeq 最省力的入口。两到三个字母,加一个下划线,后面跟六位或九位数字;NZ_ 例外,它后面接的是它所依据的 INSDC 登录号,形如 NZ_AABC02000001。下划线是 RefSeq 的独有标记,INSDC 三库的登录号从不含下划线——这一条足以在一堆编号里瞬间分辨来源。
| 前缀 | 分子 | 指什么 | 生成方式 |
|---|---|---|---|
| NC_ | DNA | 完整染色体或连锁群,通常是参考组装 | 策展 |
| AC_ | DNA | 完整基因组分子,通常是备用组装 | 策展 |
| NG_ | DNA | 基因组区域,可含一个或多个位点,如 RefSeqGene、rRNA 簇、非转录假基因 | 策展 |
| NT_ | DNA | 重叠群(contig),克隆法或组装中间产物 | 计算 |
| NW_ | DNA | 支架(scaffold),多来自全基因组鸟枪 | 计算 |
| NZ_ | DNA | 以 INSDC 登录号为基础的染色体与支架,主要用于原核 | 计算 |
| NM_ | mRNA | 编码蛋白的转录本,NCBI 人员或模式生物数据库策展,即「已知」集 | 策展 |
| XM_ | mRNA | 注释流程预测的编码转录本,即「模型」集 | 计算 |
| NR_ | RNA | 非编码转录本,含 lncRNA、结构 RNA、转录假基因 | 策展 |
| XR_ | RNA | 注释流程预测的非编码转录本 | 计算 |
| NP_ | 蛋白 | 注释在 NM_ 上,或注释在没有转录本记录的基因组分子上 | 策展 |
| AP_ | 蛋白 | 注释在 AC_ 备用组装上 | 策展 |
| XP_ | 蛋白 | 注释在 XM_ 上,或注释在没有转录本记录的基因组分子上 | 计算 |
| YP_ | 蛋白 | 注释在没有转录本记录的基因组分子上,如部分线粒体、病毒、参考细菌基因组 | 计算 |
| WP_ | 蛋白 | 跨菌株、跨物种去冗余的非冗余蛋白,版本号恒为 .1 | 计算 |
读这张表要抓住三条线索。
第一条是分子层级:DNA 在上,RNA 居中,蛋白在下,一条 NM_ 对应一条 NP_,一条 XM_ 对应一条 XP_。这套对应关系是 RefSeq 被大量工具默认依赖的原因——给一个登录号,就能顺着前缀推出它的上下游。
第二条是策展与计算的分界。带 M 的(NM_、XM_)与带 R 的(NR_、XR_)成对出现,前者人工,后者流程;蛋白一侧同理,NP_ 与 XP_ 成对。这条分界线不是质量好坏的分界,而是责任归属的分界:XM_ 错了,是注释流程的版本问题;NM_ 错了,是策展判断的问题。
第三条是 NC_ 与 NG_ 的分工。NC_ 是整条染色体,动辄上亿碱基,坐标随组装版本变化;NG_ 是一段被单独拎出来的基因组区域,长度通常在几万碱基以内,专门为临床报告与复杂位点注释准备,坐标不随组装更新而漂移。做基因检测报告的人熟悉 NG_,做全基因组分析的人熟悉 NC_,两者不能互换。
前缀的位数也有规则:六位数字用完之后扩到九位,已有登录号保持不变。这条规则写在发布说明里,是为了让旧编号永远可解析。
2.3 一条记录的解剖
发布说明里给了一个真实样例,莱什曼原虫弗里德林株的 3 号染色体。把它逐行拆开,就是一条 RefSeq 记录的全部要素。
LOCUS       NC_004916             384502 bp    DNA     linear   CON 18-JUN-2017
DEFINITION  Leishmania major strain Friedlin complete genome, chromosome 3.
ACCESSION   NC_004916 AC125735
VERSION     NC_004916.2
DBLINK      BioProject: PRJNA15564
            BioSample: SAMEA3138173
            Assembly: GCF_000002725.2
KEYWORDS    RefSeq; complete genome.
SOURCE      Leishmania major strain Friedlin
  ORGANISM  Leishmania major strain Friedlin
            Eukaryota; Euglenozoa; Kinetoplastida; Trypanosomatidae;
            Leishmaniinae; Leishmania.
七行各有各的作用。LOCUS 行给长度、分子类型、拓扑结构与最后更新日期;DEFINITION 是人读的一句话描述;ACCESSION 行第一个编号是主编号,后面跟的是历史编号,记录被合并时旧号会退到次要位置;VERSION 是精确到版本的全名,也是引用时唯一应该写的那个;DBLINK 指向生物项目、生物样本与组装,是向上追溯到提交的入口;KEYWORDS 标出这是 RefSeq 记录且为完整基因组;SOURCE 与 ORGANISM 给出物种名与分类谱系。
值得注意的是 DBLINK 里那个 GCF_ 编号。GCF_ 是组装库的登录号,不是 RefSeq 序列登录号;组装号后面常跟一个 RS_ 年月标记,代表该组装上 RefSeq 注释的版本。把 GCF_ 当成序列号去检索,是新手最常见的错位之一。
记录本体之后是特征表,逐个列出基因、mRNA、CDS 的坐标与限定符,再往后是序列。平文件格式把这些放在一起,FASTA 只保留序列,ASN.1 保留全部结构。三种格式内容等价,用途不同:做比对用 FASTA,读注释用平文件,做程序化解析用 ASN.1。
2.4 七个状态码:每条记录都带着自己的履历
状态码写在记录的 COMMENT 段,也写在发布目录的第五列。它的作用是把「这条记录被审到什么程度」变成可查询的字段。
| 状态码 | 含义 | 是否算策展 |
|---|---|---|
| REVIEWED | 经 NCBI 人员或合作方审阅,可能补入了更多文献与特征 | 是 |
| VALIDATED | 经过初步审阅,确定为该位点的首选序列标准,尚未做最终审阅 | 是 |
| PROVISIONAL | 未逐条审阅,但被认为有充分支持、代表有效转录本与蛋白 | 否 |
| PREDICTED | 未逐条审阅,记录的某些方面属于预测 | 否 |
| INFERRED | 由基因组序列分析推断,尚无实验证据支持 | 否 |
| MODEL | 由 NCBI 基因组注释流程生成,两次注释之间不做个体修订 | 否 |
| UNKNOWN | 状态码尚未赋值,或该类型记录本不需要赋值 | 否 |
发布说明同时留了一句诚实的话:状态码并非对所有物种都一致提供,目录里出现 UNKNOWN 表示本该有码却没检出,出现 na 表示按项目计划本就不提供。这句话很重要——它意味着按状态码筛选时,未赋码的记录会被静默漏掉,除非显式把它们算进来。
从规模上看,两类记录的量级差得很远。以 complete 节点为例,Reviewed 状态的 RNA 记录约二十三万条、蛋白约三十万条;Model 状态的 RNA 记录约七千一百万条、蛋白约六千万条。换句话说,被人工看过的只是浮在最上面的一层,绝大多数的 XM_ 与 XP_ 是流程产物。这不是缺陷,是覆盖面与成本之间的必然选择,但任何按「RefSeq 基因集」做统计的工作都必须先声明自己用的是哪一层。
2.5 目录结构:故意的冗余
FTP 上的发布目录不是按物种分,而是按分类节点分,一共十三个:古菌、细菌、真菌、无脊椎动物、线粒体、其他、植物、质粒、质体、原生动物、哺乳类脊椎动物、其他脊椎动物、病毒。此外还有一个 complete 目录,装全量。
这套结构是故意冗余的。发布说明写得很直白:每条记录至少出现两次,一次在 complete,一次在某个分类节点;有的会出现三次,比如一条人线粒体序列同时出现在 complete、mitochondrion 与 vertebrate_mammalian。这样做是为了让不同用户只下自己需要的那一块,而不必先下全量再切。
代价是容易重复计数。把十三个节点的记录数直接相加,会得到远大于总数的结果。本文所有总量数字都取自 complete 节点与发布说明的头部,不取自节点求和。
每个节点的统计文件还会给出该节点的物种数、各类分子的记录数与长度,以及按状态码拆分的 RNA 与蛋白计数。这些数字是核对下载完整性的好工具:下完之后数一遍记录条数,与统计文件对不上,就是漏了文件。
2.6 文件命名与体积
文件名本身携带四个信息:目录、序号、分子与格式、压缩方式。形如 complete.1006.1.genomic.fna.gz,从左到右依次是节点名、序号、可选的分卷号、格式、压缩后缀。同序号的文件之间要小心:蛋白文件装的是本序号基因组或 RNA 文件里出现的蛋白,而 RNA 文件与同序号的基因组文件内容并不相干。不同序号之间更不一定相关,因此不能假设序号相邻的文件属于同一批物种。
格式一共三类六种:基因组的 FASTA 与 GenBank 平文件、RNA 的 FASTA 与平文件、蛋白的 FASTA 与平文件,此外还有 ASN.1 的二进制的 bna 文件。压缩一律 gzip。
体积上有两条硬约束写在说明里:核苷酸 FASTA 文件超过 1 GB 就分卷,未压缩的 ASN.1 文件不超过 2 GB。因此一个物种的完整数据往往散落在多个文件里,想按物种取全,要么扫遍目录,要么改用按组装组织的 genomes/refseq 路径。
2.7 发布节奏与增量
全量发布大约每两个月一次。Release 233 在 2026 年 1 月 26 日,234 在 3 月 16 日,235 在 5 月 11 日,236 在 7 月 6 日,237 在 8 月 31 日,间隔在六到八周之间。说明文档里写的计划是每逢单月发布,实际节奏略有漂移,以发布说明的日期为准更稳妥。
两次全量之间,每日增量放在 daily 目录。增量文件只含当天新增与改动的记录,适合做持续同步,不适合做首次建库。做首次建库必须从全量开始,再用增量追平,否则会缺掉历史上被改动过的版本。
版本号的意义在这里体现得最清楚:登录号不变,序列或注释变了就递增版本号,旧版本仍可访问。因此引用一条序列时,写 accession 只说明「哪条」,写 accession.version 才说明「哪一版」。临床报告、模型训练集、比对索引,三处都必须写到版本。
§3 它的身份:谁的库,对谁负责
3.1 三个名字,一套编号
这个库有三个常用称呼。全称 NCBI Reference Sequence Database 出现在正式文档与论文里;RefSeq 是所有人日常用的简称;在 E-utilities 与各类工具的参数里,它常以 refseq 这个库名出现,检索时用一个过滤器就能把 RefSeq 记录从 GenBank 记录里筛出来。
三个名字指向同一个东西,但语气不同。叫全称时,强调的是它作为 NCBI 官方产品的身份;叫 RefSeq 时,强调的是那套带下划线的编号体系;写成过滤条件时,强调的是它在 Entrez 里与 GenBank 共库检索、靠属性区分的存在方式。最后这一点常被忽略:RefSeq 记录与 GenBank 记录住在同一个核酸库与同一个蛋白库里,不是两套独立的检索系统。这也是为什么同一条序列可以有两个登录号,检索时必须靠过滤器或前缀来区分。
3.2 维护方与四条生产路径
维护方是 NCBI,隶属美国国家医学图书馆,后者隶属国立卫生研究院。发布说明里对责任的表述很直接:由 NCBI 负责生产与分发,记录通过合作与内部处理两条线产生,其中一部分由 NCBI 的专家生物学家策展。
具体到一条记录怎么来的,有四条路径,每条路径对应不同的质量与责任。
第一条是合作。外部权威团体提供序列、命名、注释与表型链接,RefSeq 直接采用。酵母的 SGD、拟南芥的 TAIR、果蝇的 FlyBase、线虫与蚊虫的 VectorBase、人类的 HGNC 与 OMIM、小鼠的 MGI、大鼠的 RGD、斑马鱼的 ZFIN,都是这条路径上的常客。病毒一侧另有一个病毒基因组顾问委员会。
第二条是提取。没有合作方时,NCBI 从 INSDC 提交里自动挑出最好的一条,校验格式、必要时修正,然后基本原样收进 RefSeq,并在记录上注明来源。这类记录的质量等于原始提交的质量。
第三条是重新注释。挑出的序列可能被 NCBI 人员修改过:补全 UTR、去掉载体与接头残留、修正明显的测序错误、把基因与序列的对应关系重新核对一遍。改动幅度从技术性修补到整条重注释不等。
第四条是流程生成。真核物种的转录本与蛋白由基因组注释流程批量产出,一次运行生成数万到数十万条 XM_、XR_、XP_。这条路径产量最大,也最不依赖人工。
四条路径并存,是 RefSeq 既能覆盖十八万个分类单元、又能对少数模式物种给出高质量记录的原因。代价是同在 RefSeq 名下,两条记录的实际可靠性可能差出很远。
3.3 与 GenBank 的分工边界
这是整个库最需要说清的一件事。发布说明里有一句比喻:RefSeq 像一篇综述,它是对大量他人产出的一手数据的综合与摘要;GenBank 是那些一手数据本身。
| 维度 | GenBank(及 INSDC 三库) | RefSeq |
|---|---|---|
| 定位 | 原始序列档案 | 参考序列选本 |
| 收录原则 | 作者提交什么就收什么 | 每个物种每种天然分子留一个代表 |
| 是否改动 | 从不改动提交内容 | 会修正、补注、重新注释 |
| 登录号形态 | 字母加数字,不含下划线 | 两字母前缀加下划线,或 NZ_ 接 INSDC 号 |
| 冗余度 | 高,同一分子可能几十条 | 低,但不为零 |
| 覆盖物种 | 所有有提交的物种 | 有足够数据且有策展路径的物种 |
| 责任主体 | 提交者 | NCBI 与合作伙伴 |
| 主要用途 | 存档、追溯、发现新序列 | 比对基准、注释参考、报告坐标 |
两条边界的实际含义可以这样记:想知道「世界上有人交过哪些序列」,去 GenBank;想知道「这个物种这个基因应该以哪条为准」,来 RefSeq。前者是证据,后者是判词。
也正因如此,RefSeq 不提供「全部序列」这件事不该被当作缺陷来批评。它如果什么都要,就退化成了第二个 GenBank。
3.4 与相邻资源的关系
RefSeq 不是一个孤岛,它的编号被大量相邻资源当作锚点。
RefSeqGene 是 NG_ 记录的一个专门子集,为临床报告里常见的基因固定一段基因组区间,使坐标不随组装版本漂移。LRG 是 EMBL-EBI 与 NCBI 联合的另一套方案,用 LRG_ 编号固定区间与最少转录本,2021 年起停止新增,官方推荐转向 MANE。两者解决的是同一个问题:让报告里的坐标活得比组装版本更久。
MANE 由 NCBI 与 EMBL-EBI 联合推进,把人类与小鼠的 RefSeq 转录本与 Ensembl 转录本一一配对,配对成功的那一条标为 MANE Select。它的意义在于终结「同一基因在 RefSeq 与 Ensembl 里各有一套编号、报告互相对不上」的历史。
GCF_ 与 GCA_ 属于组装库,不属于 RefSeq 序列库。GCF_ 开头的记录表示该组装由 RefSeq 提供,GCA_ 表示来自 GenBank 提交;两者后面常跟一个 RS_ 年月标记,代表 RefSeq 注释的版本。混用这三套编号,是跨库取数时最常见的错误来源。
§4 它的手艺:一条记录是怎么长成的
4.1 四道验证
发布说明列了验证的几种方式,拆开看是四道关。
第一道是格式。记录必须能被解析成合法的 ASN.1 结构,字段齐全,坐标不越界。这一关是纯技术性的,过不了就没有记录。
第二道是序列一致性。基因组序列上标注的 mRNA 特征,必须与该 mRNA 记录本身对得上;标注的编码区,必须真的能翻译出它所指的那条蛋白。这一关抓的是拼接错误与注释错位。
第三道是描述一致性。基因符号、基因名、蛋白名必须在 RefSeq 与 Gene 记录之间保持一致。这一关决定了跨库检索能不能对上号。
第四道是命名规范。有官方命名委员会时,优先采用委员会给的符号。发布说明同时提醒:基因符号既不要求跨物种唯一,也不要求种内唯一。这句话看起来是常识,实际是很多自动化流程出错的根源——按符号合并不同物种的基因,会把完全无关的基因并到一起。
4.2 版本号、合并与次级编号
RefSeq 的稳定性建立在两条规则上。其一是登录号不变,序列或注释更新时只递增版本号,旧版本仍可访问。其二是记录被合并时,旧登录号不会消失,而是退到 ACCESSION 行的次要位置,仍可检索到合并后的记录。
这两条规则合起来,给了下游一个可依赖的承诺:一个写进论文的 accession.version,五年后仍然指向同一条序列。但它不给另一个承诺——这条记录永远存在。记录会被替换、永久抑制或临时抑制,每次发布都附一份移除清单,逐条说明属于哪种情况。
4.3 案例:NM_000546 走过的那条路
用一个真实记录把流程串起来。人类 TP53 的第 1 号转录本 NM_000546,是临床报告里被引用得最多的序列之一。打开它的平文件,头几行是这样的:长度 2,512 bp,分子类型 mRNA,版本 6,关键词一栏写着 RefSeq 与 MANE Select。
COMMENT 段把来历写得很清楚:这是 REVIEWED 状态的记录,由 NCBI 人员策展,参考序列取自三条 GenBank 记录,编号分别是 DA453049.1、X02469.1 与 AK223026.1;2020 年 2 月 13 日,这一版本替换了 NM_000546.5。
这段话正好覆盖了四条生产路径的前三条:它来自 GenBank 提交,不是凭空写的;它由 NCBI 人员重新核对,并从三条来源中取长补短;它带 REVIEWED 状态,说明人工看过。编码区标在 143 至 1324 位,这一行坐标是所有以它为准的变异命名的起点。
版本更替那一句尤其值得看。登录号没变,版本从 5 到 6,旧版仍可取回。替换的原因可能是序列修正、注释调整或上游数据更新,记录本身只说「替换了」,不说为什么。这正是 §4.2 那条规则的实态:稳定的是编号,会变的是内容。
到临床一侧,这条记录承担第三个角色:变异命名的坐标基准。一份报告写 c.215C>G,前面必须挂上 NM_000546 与版本号,否则无法确定用的是哪一版序列。五年前发的报告今天还能复核,靠的就是这条版本链。
边界同样清楚。NM_000546 只代表第 1 号转录本,不代表 TP53 的全部异构体;它只给序列与注释,不给表达量、不给突变频率、不给临床意义。§7.3 会回到这一点,说明为什么把这一条当成「TP53 的全部」是一种误读。
4.4 冗余为什么被允许存在
RefSeq 自称非冗余,但发布说明里列了五类被明确允许的冗余。这份清单比任何宣传语都更能说明它的实际形态。
第一类是可变剪接。同一基因的不同剪接产物各有记录,如果剪接差异落在非翻译区,翻译出的蛋白可能完全相同,于是蛋白层面出现重复。
第二类是旁系同源。目标是给每个天然分子一条记录,所以近期基因复制产生的近乎相同的基因也各有一条。真核基因组里这类情况极多。
第三类是中间记录。为了支撑组装与注释,会额外提供 NT_ 重叠群与 NG_ 区域记录,它们与 NC_ 染色体内容重叠。
第四类是备用组装。不同人群、不同品系的基因组各有一套记录,比如小鼠的不同品系、人类主要组织相容性复合体区域。这类记录在序列与注释上都可能有差异。
第五类是原核菌株。不同菌株各有一套基因组记录,会带来冗余,但能保留菌株特异的蛋白。发布说明补了一句:菌株层面的蛋白补集是非冗余的。
所以准确的说法是「生物学意义上的非冗余」:每个物种每个天然分子留一个例子,而不是「库里没有重复序列」。这两句话差别很大,前者是设计目标,后者是错误期待。
4.5 移除:登录号也会死
每次发布都有一份移除清单,四列之外多一列移除类型,取值有四种:死蛋白、被其他登录号替换、永久抑制、临时抑制。
永久抑制通常意味着这条记录被判定为错误或不再需要,不会回来;临时抑制意味着它可能在未来某次发布中恢复。被替换的记录,旧号不一定退为次级编号——发布说明特意注明这一种情况下原登录号不作为次级编号保留。
对长期项目来说,这份清单是必须监控的输入。做临床 panel 的团队如果在某次版本升级后发现一批位点坐标对不上,原因往往就是背后的转录本被替换或抑制了,而这件事在记录本身里看不出来,只在移除清单里写着。
§5 取数:四条路径
5.1 四条路径的取舍
| 路径 | 适合什么 | 代价 |
|---|---|---|
| 网页检索(Nucleotide、Protein、Gene) | 查单条记录、看注释、核对版本 | 无法批量,不适合建库 |
| FTP 全量下载 | 建本地库、做比对索引、训练模型 | 体量大,需要自己切分与校验 |
| E-utilities 接口 | 按查询条件批量取、按登录号列表取 | 受请求频率限制,需要分批与重试 |
| Datasets 命令行工具 | 按物种或组装取基因组与注释 | 覆盖面以组装为单位,不覆盖全部记录类型 |
选哪条路,取决于你要的是「一条记录」还是「一个物种」还是「整个库」。这三件事在 RefSeq 里的组织方式完全不同:单条记录走 Entrez,物种走基因组或按目录扫描,整库走 FTP 全量。
5.2 FTP 上的三个入口
第一个入口是 release 目录,装全量与分类节点,适合建库。第二个是 daily 目录,装每日增量,适合追平。第三个是 genomes/refseq 目录,按组装组织,一个物种一个文件夹,里面是基因组 FASTA、GFF 注释、蛋白与 CDS 序列,适合做单物种分析。
三个入口的内容有重叠但不完全一致。release 以登录号为单位组织,genomes 以组装为单位组织,前者适合做序列检索,后者适合做基因组分析。同一份数据在两处出现时,格式与切分方式不同,做校验和对比时会发现差异,这不是错误。
5.3 用 E-utilities 取一条记录
按登录号取一条记录是最小的可用操作。下面这段可以直接跑,把 NM_000546 的 GenBank 平文件存到本地。
#-- 取一条 RefSeq 记录的平文件(含注释与序列)
curl -sS "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi?db=nuccore&id=NM_000546.6&rettype=gbwithparts&retmode=text" -o NM_000546.6.gb

#-- 只取 FASTA
curl -sS "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi?db=nuccore&id=NM_000546.6&rettype=fasta&retmode=text" -o NM_000546.6.fa

#-- 核对版本与长度,确认拿到的是想拿的那一版
grep -E "^LOCUS|^VERSION" NM_000546.6.gb
第三条命令不是可选项。接口对不带版本号的登录号会返回最新版,而最新版可能已经不是你论文里用的那一版。把版本号写进请求,再把返回的 VERSION 行与预期比对,是唯一可靠的确认方式。
5.4 批量取一个物种的蛋白集
按物种取全量蛋白,用查询式比逐个登录号更省事。下面这段按物种名与 RefSeq 过滤器取智人的 RefSeq 蛋白,只保留 NP_ 前缀,跳过预测记录。
#-- 第一步:先问一共有多少条,避免一次拉太多
esearch -db protein -query "Homo sapiens[Organism] AND refseq[filter] AND NP_[PACC]" | xtract -pattern ENTREZ_DIRECT -element Count

#-- 第二步:分批取 FASTA,每批 500 条,写入同一个文件
for start in 0 500 1000 1500; do
  esearch -db protein -query "Homo sapiens[Organism] AND refseq[filter] AND NP_[PACC]" \
    | efetch -start "$start" -stop "$((start+499))" -format fasta >> human_np.faa
done

#-- 第三步:数一遍条数与去重后的登录号数,两者应相等
grep -c "^>" human_np.faa
grep "^>" human_np.faa | cut -d" " -f1 | sort -u | wc -l
第二步的分批是必须的。一次性请求上千条会被限流,返回截断而不报错,最后得到一份看起来完整、实际少了一半的 FASTA。第三步的对账是防线:条数与去重后的登录号数不一致,说明混入了重复或截断。
5.5 版本固定与校验
无论走哪条路,落到本地之后有三件事必须做。
第一,把版本写进文件名与元数据表。文件名里带 accession.version,元数据表里存下载日期与发布号,两者缺一不可。
第二,记录文件校验和。FTP 上每个文件都配了 MD5,下完立刻比对,比事后发现序列被截断要省事得多。
第三,保存发布目录的切片。发布目录是六列的扁平表,把用到的那些行切出来存一份,日后核查「当时到底有哪些记录」时,这是唯一的一手凭据。整份目录很大,切片很小,成本可以忽略。
§6 与库内条目的关系
6.1 一图看清谁引用谁
RefSeq 在整条生信链路里的位置,用一句话说:上游接档案,下游被注释库、变异库与检测流程引用。
| 相邻资源 | 与 RefSeq 的关系 | 交界处用什么对接 |
|---|---|---|
| GenBank / EMBL / DDBJ | 上游档案,RefSeq 的原料来源 | INSDC 登录号,写在 DBBLINK 与 ACCESSION 行 |
| Ensembl | 平行的另一套参考注释,转录本编号为 ENST | 通过 MANE 配对,通过坐标与序列比对 |
| GENCODE | Ensembl 与 Havana 联合产出的注释集,供 ENCODE、GTEx 使用 | 通过转录本与基因标识映射,不直接引用 NM_ |
| LRG | 与 NCBI 联合的位点参考方案,用 LRG_ 号 | 每条 LRG 记录声明对应的 NG_ 与 NM_ |
| ClinVar | 变异与临床意义的库 | 用 NM_、NG_ 加版本号作为报告坐标 |
| SRA | 原始读段档案 | 通过 BioProject 与 BioSample 关联 |
| HGNC | 人类基因符号的命名方 | 符号进入 RefSeq 的基因字段 |
| InterPro | 蛋白家族与结构域分类 | 以 NP_、XP_ 序列为输入做扫描 |
| Sequence Ontology | 序列特征类型的术语体系 | 出现在 GFF 的 feature 列与平文件特征表 |
这张表要表达的不是「谁更权威」,而是「谁负责哪一段」。RefSeq 负责给出那条序列与它的坐标,不负责解释这条序列在疾病里的意义,也不负责给出它在组织里的表达量。
6.2 三条常用的检索路径
第一条是从基因到序列。在 Gene 库里搜符号,进入基因页,页面上按 RefSeq 分组列出该基因的全部 NM_、NR_、NP_,标出哪条是 MANE Select。这是最快的一条路,也是临床报告最常用的一条。
第二条是从序列到基因。手上只有一条登录号时,直接在 Nucleotide 或 Protein 里检索,记录的 GENE 字段与 DBLINK 会指回基因页。
第三条是从变异到转录本。ClinVar 里每条变异都挂着它所参照的 RefSeq 登录号与版本,顺着这条线可以回到序列、回到基因、回到组装坐标。做 panel 设计时,这条路径是标准做法。
6.3 与 GENCODE、Ensembl 的逐项区隔
这三个库经常被混为一谈,实际是三件不同的东西。
| 维度 | RefSeq | Ensembl | GENCODE |
|---|---|---|---|
| 产出方 | NCBI | EMBL-EBI 与 Wellcome Sanger | Ensembl 与 Havana 联合 |
| 核心产物 | 逐条序列记录,带登录号与版本 | 基因组数据库与查询接口 | 一套 GTF/GFF3 注释文件 |
| 转录本编号 | NM_、NR_、XM_、XR_ | ENST | ENST(沿用 Ensembl 体系) |
| 是否给序列 | 给,FASTA 与平文件 | 给,可从接口按坐标取 | 主要给注释,序列需配合基因组取 |
| 策展方式 | 人工策展加流程生成,逐条标状态码 | 自动注释为主,辅以人工 | Havana 人工注释加 Ensembl 自动注释 |
| 典型用户 | 临床报告、比对基准、跨物种比较 | 基因组浏览、跨物种比较 | 转录组定量、注释依赖型流程 |
| 覆盖物种 | 十八万余个分类单元,深浅不一 | 数百个物种,重点物种深 | 人类与小鼠 |
最容易出错的地方在转录本编号。同一个基因,RefSeq 给一条 NM_,Ensembl 给若干条 ENST,GENCODE 沿用 ENST;三者的外显子边界可能一致,也可能不一致。做跨库合并时,必须显式做一次映射,不能按基因符号直接对齐。§4.3 的案例说明了另一面:RefSeq 侧一条转录本的版本变化,会让挂在上面的全部变异坐标失效,而 ENST 侧的变化节奏完全不同,两边不会同步。
6.4 与 LRG、ClinVar 的分工
LRG 解决的是「参考序列随组装换代而漂移」这个问题,做法是给每个位点固定一段区间与最少转录本,编号 LRG_ 不带版本,永不改变。它与 RefSeq 的关系是互补而非替代:每条 LRG 记录都声明自己对应的 NG_ 与 NM_,临床实验室可以只认 LRG,也可以只认 NM_,但不能两边混用同一份报告。
ClinVar 是变异库,它的每条记录都引用具体的 RefSeq 登录号与版本。这意味着 RefSeq 的一次版本升级,会通过 ClinVar 传导到所有下游报告。理解这条链路,就能理解为什么临床流程普遍要求把版本号写死在报告模板里。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
讨论 RefSeq 的质量,先要放弃两个默认假设。
第一个假设是「参考序列即真相」。RefSeq 给的是判词,不是事实本身。它选出的是当时可用的最好一条,这条可能是一个罕见等位基因,可能缺一段 UTR,可能在一个多态位点上选了次要型的碱基。用它做坐标基准没问题,用它断言「这个物种的这条基因就是这样」就越界了。
第二个假设是「库里的记录同质」。同一个库名下,REVIEWED 的人工记录与 MODEL 的流程记录,可靠性不在一个量级;NM_ 与 XM_ 的差别不是命名习惯,是生产方式。任何质量评价,都必须先说明评价的是哪一层。把全库当成一个均质数据集来统计,得到的结论没有意义。
7.1 五维评分
| 维度 | 评价 | 依据 |
|---|---|---|
| 标识符稳定性 | 强 | 登录号不变、版本号递增、旧版可访问、合并后旧号退为次级 |
| 覆盖广度 | 强 | 十八万余个分类单元,从病毒到哺乳动物 |
| 注释一致性 | 较强 | 基因符号与 Gene 库强制对齐,命名优先采用官方委员会结果 |
| 策展深度 | 分层明显 | 人工记录占少数,模型记录占多数,两者不可混谈 |
| 可追溯性 | 中等 | 每条记录标状态码与来源,但缺少逐条处理日志 |
这五项里,前两项是它真正的长处,第四项是最容易被误读的地方,第五项是它的短板:能查到这条记录是谁策展的、依据哪些文献,但查不到它在哪一天被哪一版流程改过哪个碱基。
7.2 DAIMS 视角下的四条线
用数据档案管理的通用框架看,四条线的表现并不齐。
采集线:来源清楚,全部来自 INSDC 提交或合作方直供,每条记录带 DBLINK 与 COMMENT,可回溯到原始提交。这一条最强。
建模线:模型清晰,四类分子、十五种前缀、七个状态码,层级关系明确。缺点是分子类型不单独成列,只能从前缀推断,对自动化解析不够友好。
溯源线:记录级的溯源到状态码与协作者为止,流程级的溯源到发布说明与版本号为止。中间那一层——某条记录在某次重注释中改了什么——不公开。
治理线:发布节奏稳定,移除清单公开,版本归档完整,文档详尽。这一条也强。
7.3 已知的、可枚举的偏差
偏差不是笼统的「有偏」,可以逐条列出来。
第一,物种偏差。十八万个分类单元里,绝大多数只有少量记录,深度集中在大肠杆菌、酵母、果蝇、线虫、斑马鱼、小鼠、人类等模式物种。做跨物种统计时,非模式物种的缺失会系统性地偏向研究充分的类群。
第二,层级偏差。蛋白记录数量最大,但其中绝大多数是 XP_ 预测记录。按条数算「RefSeq 有多少蛋白」,会把预测记录一并计入覆盖度。
第三,参考偏差。每个物种选一条代表,意味着这一条携带的等位基因成为「标准」。在高度多态的位点上,这条标准可能不代表任何人群的主要型别。这是选本模式的固有代价,不是执行失误。
第四,版本偏差。同一物种在不同发布版本里的基因数会变,原因是注释流程换代与组装更新,不是生物学发现。做时间序列分析时,这种断崖会伪装成信号。
第五,完整性偏差。发布说明自己承认,很多物种的基因组、转录本与蛋白集合是不完整的,尤其是尚无完整组装的那些。引用时把它当作「完整基因组」会低估缺失。
7.4 外部验证矩阵
| 验证角度 | 外部证据 | 结论 |
|---|---|---|
| 临床报告的可复核性 | 全球临床遗传实验室普遍以 NM_、NG_ 加版本作为 HGVS 基准 | 事实上的行业标准 |
| 与 Ensembl 的一致性 | MANE 项目已完成人鼠两套注释的逐条配对 | 主体可比对,少量转录本无对应 |
| 跨库命名一致性 | 基因符号与 HGNC、MGI 等命名方强制对齐 | 符号层面冲突少 |
| 覆盖度 | 十八万余个分类单元,含大量仅有草稿基因组的物种 | 广度足够,深度不均 |
| 长期可用性 | 自 2003 年起连续发布,编号规则二十年未变 | 停更与规则突变的概率低 |
7.5 它为何能持续
一个公共参考库能活二十多年,靠的不是资金,是两件事:编号规则足够简单,简单到任何工具都能实现;发布节奏足够稳定,稳定到下游敢把它写进流程。
编号规则只有一条核心:两字母加下划线,版本号递增。这条规则简单到可以用一行正则识别,于是几乎所有生信工具都原生支持它。发布节奏是双月全量加每日增量,稳定到临床实验室敢把报告模板挂在上面。再加上 RefSeq 与 GenBank 共用检索系统、与 HGNC、MGI、FlyBase 等命名方强制对齐,它就从一个数据库变成了一个基础设施。
这种基础设施地位有一个副作用:它的错误会被放大。一条 NM_ 的注释错了,可能同时污染几百篇论文、几千份报告。这也是为什么它的策展流程里有那么多道验证,以及为什么每次版本升级都要附一份移除清单。
§8 生态位与历史
8.1 二十多年的版本线
| 时间 | 事件 |
|---|---|
| 2003 年 6 月 | Release 1 发布,覆盖 2,005 个分类单元 |
| 2014 年 | NCBI 停止分配菌株级分类号,菌株改由 BioSample 跟踪 |
| 2015 年 2 月 | 目录调整,撤销 microbial 节点,拆为 archaea 与 bacteria |
| 2016 年 | 论文系统总结分类学扩展与功能注释,前缀体系定型 |
| 2021 年 | LRG 停止新增,MANE 成为人鼠转录本的首选对照方案 |
| 2024 年 1 月 | 物种数达 145,371 |
| 2025 年 1 月 | 物种数达 162,138 |
| 2026 年 1 月 | 物种数达 174,157 |
| 2026 年 8 月 | Release 237,物种数达十八万四千七百五十二,记录数六亿四千五百五十万 |
从这条线能读出两段节奏。2003 年到 2015 年前后是打地基:把编号规则、状态码、验证流程定下来,覆盖以模式物种为主。2015 年之后是铺面:随着测序成本下降,物种数从几万涨到十八万,增量主要来自细菌、真菌与病毒的大量草稿基因组。2024 年初到 2026 年初,两年增加约两万九千个分类单元;2026 年前八个月又增加一万余个,速度仍在加快。
发布说明里还有一条值得注意的动向:RefSeq 正在考虑对大肠杆菌这类被反复测序的物种收紧收录标准。这句话的分量不小——它意味着未来物种数与记录数的增长可能不再同步,广度先于深度到达瓶颈。
8.2 三座体系的分工
把整个核酸数据生态分成三层,RefSeq 在中间。
底层是 INSDC 三库,负责存档,收一切提交,永不改动。中层是 RefSeq 与同类的选本,负责给每个物种每个分子一个代表。顶层是注释与知识库,把序列翻译成基因、变异、通路、疾病。
三层的责任边界很清楚:底层保证「不丢」,中层保证「不重」,顶层保证「能用」。混淆三层的职能,是外行判断这类资源时最常见的错误——要求 RefSeq 收全,等于要求中层干底层的活;要求 RefSeq 给疾病解释,等于要求中层干顶层的活。
8.3 在 AI 时代的再定位
近两年,RefSeq 以一种新的方式被大量使用:作为蛋白与核酸语言模型的语料与对照集。
这件事有它的道理。训练蛋白模型需要一份去冗余、有物种标签、有质量分层的序列集,RefSeq 恰好三样都有——WP_ 给了跨物种去冗余的蛋白,分类号给了物种标签,状态码给了质量分层。相比之下,直接从 GenBank 拉全量会引入大量重复与低质量序列,清洗成本高得多。
但也有一个新出现的误用风险:把 XP_ 与 NP_ 混在一起训练,然后报告「模型学会了蛋白结构」。这两类记录的可靠性差着量级,混在一起等于给模型喂了一批未经核实的翻译产物。稳妥的做法是按状态码过滤,并在方法里写清楚保留了哪几层。
另一个变化是检索方式。过去人们通过网页或 FTP 取数,现在越来越多通过批量接口与云端镜像取数。这对 RefSeq 是好事——它的编号规则简单,天生适合做程序化访问;但这也意味着版本管理责任更多地转移到了使用者一侧。
8.4 与策展型资源的互补
有人预期,随着长读长测序与单倍型组装普及,RefSeq 这种「每物种一条代表」的模式会被「每人一套组装」的图基因组取代。这个判断在可预见的范围内不成立,原因是两者的服务对象不同。
图基因组回答的是「这个人群里这段序列有多少种形态」,RefSeq 回答的是「报告里这个位点该写哪个坐标」。前者需要容纳全部变异,后者需要一个稳定的锚点。锚点可以换,但不能每次都换;这正是 NG_ 与 LRG 存在的理由。
更可能的演化是分工加深:图基因组承担变异发现与分型,RefSeq 承担报告与引用,两者通过 MANE 一类映射层对接。§4.3 的案例已经展示了这种分工的雏形——同一个基因,一条记录承担序列基准,另一套体系承担变异谱。
§9 使用指引
9.1 三种角色的路径
做临床检测与报告的人,路径最短也最讲究。第一步在 Gene 库找到目标基因,确认 MANE Select 标的是哪一条 NM_;第二步核对这条记录的版本,写进报告模板;第三步用 NG_ 或 NC_ 核对基因组坐标;第四步去 ClinVar 看该位点已有的解释。四步里任何一步跳过版本号,报告的可复核性就丢了。
做算法与模型的人,路径是批量化的。先按物种与状态码筛出要用的记录,再按分子类型分桶,然后用发布目录切出清单,最后从 FASTA 全量里按登录号抽取。关键在于两份清单要对得上:一份是你想用的,一份是你实际下到的。
做数据库与工具开发的人,路径最重。需要处理三件事:前缀到分子类型的映射表、状态码到质量等级的策略、以及版本升级时的差异合并。第三件最容易被低估——每次发布都有新增、改动与移除,改动里还分序列变化与仅注释变化,三者对下游的影响完全不同。
9.2 一条最短的可用流程
从零到一份可用的物种蛋白集,下面这条流程是 §5.4 的完整版,多了一步版本核对与一步去冗余。
#-- 第一步:锁定发布版本,把发布号写进工作目录名
RELEASE=237
mkdir -p "refseq_${RELEASE}" && cd "refseq_${RELEASE}"

#-- 第二步:取该版本的发布说明与统计,作为对账基线
curl -sS -O "https://ftp.ncbi.nlm.nih.gov/refseq/release/release-statistics/RefSeq-release${RELEASE}.08312026.stats.txt"

#-- 第三步:只下蛋白 FASTA,跳过基因组与 RNA
wget -q -r -np -nH --cut-dirs=3 -A "protein.faa.gz" \
  "https://ftp.ncbi.nlm.nih.gov/refseq/release/vertebrate_mammalian/"

#-- 第四步:解压并核对条数
zcat *.protein.faa.gz | grep -c "^>"
#-- 第五步:把 FASTA 头解析成表,按登录号前缀分桶
import gzip, re
from collections import Counter

pat = re.compile(r"^>(\w{2}_\d+)\.(\d+)\s+(.*)$")
rows, prefixes = [], Counter()
with gzip.open("vertebrate_mammalian.protein.faa.gz", "rt") as fh:
    for line in fh:
        m = pat.match(line)
        if m:
            acc, ver, desc = m.groups()
            prefixes[acc.split("_")[0] + "_"] += 1
            rows.append((acc, ver, desc))

print("记录数:", len(rows))
print("前缀分布:", prefixes.most_common())
这段流程里有两个容易被省略的动作。第一个是第二步,先下统计文件当基线,后面任何数量对不上都能立刻发现。第二个是第五步的前缀分桶,它一眼就能看出这份「蛋白集」里有多少是 NP_、多少是 XP_——这决定了后续能不能直接用于训练或统计。
9.3 引用方式
引用写到三层才算完整。
第一层是方法学论文:O’Leary 等 2016 年发表于《核酸研究》第 44 卷 D1 期、D733 至 D745 页的那篇,文献编号以 gkv1189 结尾。这篇论文系统描述了分类学扩展与功能注释,是引用 RefSeq 时的标准出处。
第二层是版本:写明发布号与发布日期,例如 Release 237、2026 年 8 月 31 日。只写「RefSeq」而不写版本,无法判断用的是哪一批记录。
第三层是具体记录:每一条用到的序列都要写 accession.version,而不是只写 accession。临床报告、论文补充材料、模型训练集的清单,三处都适用这条规则。
§10 AI 使用声明
| 项目 | 说明 |
|---|---|
| 本页 AI 参与程度 | 由 AI 助手依据官方发布说明、统计文件与 FTP 文档起草,数字逐项对照原始文件 |
| 数字来源层级 | 见附录 B;发布说明与统计文件为一级,论文为二级 |
| 未核实项 | 官方 About 网页在核验期间拒绝访问,正文对「策展流程」的描述改以发布说明第 1.3 节与第 3.6 节为依据 |
| 版本信息 | 以 Release 237(2026-08-31)为准,核验日期 2026-10-29 |
| 已知不一致 | 文档称全量发布计划安排在单月,实际发布间隔在六到八周之间浮动,正文以实际日期为准 |
| 记录状态 | 物种数、记录数、碱基与残基数均取自发布说明首部,四类分子计数取自同文件第 3.5 节,两者相加可对上 |
| 适用边界 | 描述的是数据集本身的结构、规模与边界,不含对具体研究结论的评价 |
| 更新机制 | 数据集双月更新,本页不承诺随版本同步刷新 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 「RefSeq 是 GenBank 的升级版,迟早取代它」 | 两者分工不同,GenBank 是原始档案,RefSeq 是选本,缺一不可 | 发布说明第 1.3.4 节明确两者并行,GenBank 是主档案 |
| 「RefSeq 收了世界上所有的序列」 | 只收每个物种每种分子的一个代表,且物种收录取决于数据量与策展资源 | 发布说明第 2.1 节:并未收录 GenBank 中所有有数据的物种 |
| 「库里的记录都经过人工审阅」 | 蛋白记录绝大多数是流程生成的 XP_,人工审阅的只占很小一部分 | 统计文件 complete 节点的状态码计数 |
| 「NM_ 和 XM_ 只是编号习惯不同」 | 前者人工策展,后者流程预测,质量与责任主体都不同 | 发布说明第 3.8 节与前缀表 |
| 「一个基因只有一条 RefSeq 转录本」 | 每个被证实的剪接异构体各有一条记录 | 发布说明第 2.3 节的冗余说明 |
| 「登录号不变,所以记录永远在」 | 记录可被替换、永久抑制或临时抑制,每次发布附移除清单 | 发布说明第 3.7 节列出四种移除类型 |
| 「下划线只是格式装饰」 | 下划线是 RefSeq 与 INSDC 登录号的唯一区分标记 | 发布说明第 3.8 节:INSDC 登录号从不含下划线 |
| 「GCF_ 是 RefSeq 的序列登录号」 | GCF_ 是组装库编号,不是序列编号 | 发布说明第 2.5 节示例中的 GCF_ 与 RS_ 命名 |
| 「把十三个分类节点的记录数加起来就是总量」 | 目录故意冗余,同一记录至少出现两次,相加会重复计数 | 发布说明第 3.1 节:每条记录至少提供两次 |
| 「原核生物也有 NM_ 转录本」 | 转录本记录只提供给真核物种 | 发布说明第 2.2 节 |
| 「RefSeq 含临床表型与随访」 | 不含,只有序列与注释 | 发布说明第 1.4 节列出的用途范围 |
| 「下载 daily 增量就能建库」 | 增量只含当天新增与改动,建库必须从全量开始 | 发布说明第 1.2 节与 FTP 目录说明 |
FAQ
Q1:RefSeq 和 GenBank 到底什么关系?
GenBank 是原始档案,作者提交什么就存什么,NCBI 不改动;RefSeq 是在其之上挑出每个物种每个分子的代表,重新验证与注释后给出的版本。两者并行,登录号体系不同,RefSeq 的登录号一定含下划线。
Q2:NM_ 和 XM_ 有什么区别,能不能混用?
NM_ 是经过策展的编码转录本,来自 NCBI 人员或模式生物数据库的人工核对;XM_ 是注释流程自动预测的转录本,未经逐条人工审阅。可以混用,但必须在方法或报告里声明保留了哪一层,否则同一物种的基因数会因筛选口径不同而变。
Q3:为什么同一个基因有好几条 NM_ 编号?
因为一个基因可以产生多个剪接异构体,RefSeq 为每个被证实的异构体单独给一条记录。做变异报告时必须指明用哪一条,否则坐标无法对齐。MANE Select 的作用就是给出一个默认选择。
Q4:RefSeq 的登录号会变吗?
登录号本身稳定,序列或注释改动时版本号递增,旧版本仍可访问。但记录可能被替换、永久抑制或临时抑制,每次发布都附移除清单,长期项目应固定到 accession.version。
Q5:十八万物种,是不是意味着覆盖了所有已知物种?
不是。这个数字是本次发布中出现过的分类号数量,收录与否取决于该物种的序列数据量与是否有策展路径。大量物种只有零星记录,很多有数据的物种根本不在库里。
Q6:RefSeq 里的基因组是完整基因组吗?
不全是。NC_ 通常代表完整染色体或完整分子,但大量物种只有 NZ_ 或 NW_ 级的草稿组装。发布说明自己承认,很多物种的基因组、转录本与蛋白集合并不完整。
Q7:能不能直接用 RefSeq 做差异表达或变异检测?
不能。它只有参考序列与注释,没有读段、没有表达量、没有人群频率。差异表达要用 GEO 与 SRA 的数据,变异检测要用 dbSNP、gnomAD、ClinVar 一类资源,RefSeq 在其中只承担参考坐标的角色。
Q8:RefSeq 与 Ensembl、GENCODE 该选哪个?
做临床报告与跨物种比较,选 RefSeq,因为编号稳定、状态码明确;做转录组定量与注释依赖型流程,选 GENCODE 或 Ensembl,因为注释更细、与定量工具衔接更好。两边需要对齐时,用 MANE 的配对结果,不要按基因符号硬拼。
术语表
| 术语 | 含义 |
|---|---|
| INSDC | 国际核酸序列数据库协作体,含 GenBank、EMBL、DDBJ 三库 |
| 登录号(accession) | 一条记录的稳定编号,不含版本 |
| 版本号(version) | 附在登录号后的小数,序列或注释改动时递增 |
| 前缀 | 登录号开头的两三个字母,标明分子类型与生产路径 |
| 非冗余 | 每个物种每种天然分子只保留一个代表,不等于库内无重复序列 |
| 策展 | 由人工核对序列、注释、命名与文献的过程 |
| 模型记录 | 由注释流程生成的预测记录,前缀为 XM_、XR_、XP_ |
| 已知记录 | 经人工策展的记录,前缀为 NM_、NR_、NP_ |
| RefSeqGene | NG_ 记录中为临床报告固定区间的子集 |
| MANE | NCBI 与 EMBL-EBI 联合的转录本配对方案,标出人鼠的首选转录本 |
| LRG | 位点参考基因组,用不帶版本的 LRG_ 编号固定区间,2021 年起停止新增 |
| 组装号 | GCF_ 或 GCA_ 开头的基因组组装编号,与序列登录号不同 |
| 平文件 | GenBank 格式的文本记录,含注释与序列 |
| ASN.1 | 一种结构化数据表示,RefSeq 的原始交换格式 |
| WGS | 全基因组鸟枪,指用随机打断测序再组装得到基因组的策略 |
| 重叠群(contig) | 组装得到的一段连续序列,对应 NT_ 前缀 |
| 支架(scaffold) | 由多个重叠群按配对信息连接成的更长片段,对应 NW_ 前缀 |
| 备用组装 | 同一物种不同个体或品系的替代组装,对应 AC_ 与部分 NC_ |
| 状态码 | 标注记录策展程度的字段,从 REVIEWED 到 MODEL 共七种 |
| 移除清单 | 每次发布附带的、上一版有而本版无的记录列表 |
| DAIMS | 数据档案与信息管理的一套评估框架,看采集、建模、溯源与治理四条线 |
| HGVS | 变异命名的国际规范,依赖转录本登录号与版本 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 当前发布号 | Release 237 | 发布说明首部 | 一级 |
| 发布日期 | 2026 年 8 月 31 日 | 发布说明首部 | 一级 |
| 物种数 | 184,752 | 发布说明首部 | 一级 |
| 登录号总数 | 645,505,406 | 发布说明首部 | 一级 |
| 核苷酸碱基数 | 6,703,188,511,506 | 发布说明首部 | 一级 |
| 氨基酸残基数 | 193,908,692,498 | 发布说明首部 | 一级 |
| 基因组记录数 | 63,683,560 | 发布说明第 3.5 节 | 一级 |
| RNA 记录数 | 86,067,871 | 发布说明第 3.5 节 | 一级 |
| 蛋白记录数 | 495,290,394 | 发布说明第 3.5 节 | 一级 |
| WGS 主记录数 | 463,581 | 发布说明第 3.5 节 | 一级 |
| 分类节点数 | 13 个,另加 complete | 发布说明第 3.1 节 | 一级 |
| 登录号前缀数 | 15 种 | FTP README 前缀表 | 一级 |
| 首次发布时间 | 2003 年 6 月 30 日 | 物种增长统计文件 | 一级 |
| 首次发布物种数 | 2,005 | 物种增长统计文件 | 一级 |
| 进入物种数的年份 | 2014 年停止菌株级分类号 | 发布说明第 2.1 节 | 一级 |
| 论文出处 | 核酸研究 44 卷 D1 期 D733 至 D745 | Crossref 元数据 | 二级 |
附录 B:数字的来源分层
一级:官方发布文件。 包括发布说明、统计文件、物种增长文件与 FTP README。本文的物种数、记录数、碱基与残基数、四类分子计数、目录结构、前缀表、状态码定义、移除类型,全部取自这一层。这几个文件是 RefSeq 每个版本对外发布的正式文档,其权威性不低于网页。
二级:论文。 O’Leary 等 2016 年的论文用于说明设计意图与历史背景,不用于描述当前规模。论文发表时的数字与今天相差一个数量级,混用会得出错误结论。
三级:未核实与推断。 官方 About 网页在核验期间无法访问,凡涉及策展流程的表述,本文改以发布说明的对应小节为依据,未引入网页内容。Released 节奏的「单月计划」与实际日期的偏差,按实际日期记录。
附录 C:完整参考文献
- O’Leary NA, Wright MW, Brister JR, Ciufo S, et al. Reference sequence (RefSeq) database at NCBI: current status, taxonomic expansion, and functional annotation. Nucleic Acids Research, 2016, 44(D1): D733–D745. doi:10.1093/nar/gkv1189.
- NCBI. RefSeq Release 237 Distribution Release Notes. 2026-08-31. https://ftp.ncbi.nlm.nih.gov/refseq/release/release-notes/RefSeq-release237.txt
- NCBI. RefSeq Release 237 Statistics. 2026-08-31. https://ftp.ncbi.nlm.nih.gov/refseq/release/release-statistics/RefSeq-release237.08312026.stats.txt
- NCBI. RefSeq Organism Growth Statistics. https://ftp.ncbi.nlm.nih.gov/refseq/release/release-statistics/RefSeq.taxid_growth.txt
- NCBI. README for ftp://ncbi.nlm.nih.gov/refseq/release/. 2024-01-16. https://ftp.ncbi.nlm.nih.gov/refseq/release/README
- NCBI. RefSeq 官方站点与 About 页. https://www.ncbi.nlm.nih.gov/refseq/ 与 https://www.ncbi.nlm.nih.gov/refseq/about/
- NCBI Handbook, Chapter 18: The Reference Sequence (RefSeq) Database. https://www.ncbi.nlm.nih.gov/books/NBK21091/
附录 D:取数代码
#-- 按发布目录筛出一个物种的全部登录号,并统计前缀与状态码
import csv, collections

CATALOG = "RefSeq-release237.catalog"   # 六列,制表符分隔
TARGET = "Homo sapiens"

stat = collections.Counter()
with open(CATALOG, encoding="utf-8") as fh:
    for row in csv.reader(fh, delimiter="\t"):
        if len(row) < 6 or row[1] != TARGET:
            continue
        acc, status = row[2], row[4]
        prefix = acc.split("_")[0] + "_"
        stat[(prefix, status)] += 1

for (prefix, status), n in sorted(stat.items(), key=lambda x: -x[1])[:12]:
    print(f"{prefix:4s} {status:12s} {n}")
#-- 用 E-utilities 按登录号清单取 FASTA,带重试与限速
while read -r acc; do
  curl -sS --retry 3 --retry-delay 2 \
    "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi?db=nuccore&id=${acc}&rettype=fasta&retmode=text" \
    >> selected.fa
  sleep 0.4      #-- 每秒不超过三次请求
done < accessions.txt

#-- 对账:请求条数与返回条数必须一致
wc -l < accessions.txt
grep -c "^>" selected.fa
附录 E:如果只记五件事
第一,它是 NCBI 的参考序列选本,不是原始档案;原始档案是 GenBank,两者并行,各司其职。
第二,Release 237 含十八万四千七百五十二个物种、六亿四千五百五十万条登录号,四类分子是基因组、RNA、蛋白与 WGS 主记录。
第三,十五种前缀是它的语法:NC_ 染色体、NG_ 基因组区域、NM_ 策展转录本、XM_ 预测转录本、NP_ 与 XP_ 对应蛋白、WP_ 跨物种去冗余蛋白。
第四,状态码标明每条记录的策展程度,人工记录少、模型记录多,按「RefSeq 基因集」做统计前必须先声明用的是哪一层。
第五,它不给读段、不给表型、不给未被选中的提交;记录还会被移除,长期项目必须固定到 accession.version。
编辑说明
核验时间为 2026 年 10 月 29 日。核验方式为直接读取 NCBI FTP 上的 Release 237 发布说明、发布统计、物种增长表与 README,并逐项核对四类分子计数与总数是否可对上;论文出处经 Crossref 元数据核对卷期页码与文献编号。
官方 About 网页与统计网页在核验期间返回访问拒绝,故正文中凡涉及流程、前缀与状态码的表述,一律改以发布说明第 1.3、2.1、2.3、3.1、3.5、3.6、3.7、3.8 节与 FTP README 的前缀表为依据,未引用无法读取的网页内容。这一点在 §10 与附录 B 中同样标注。
未覆盖的内容包括:各分类节点下的物种级明细分布、逐条记录的处理日志(官方不公开)、以及非人类物种的注释完整度评估(官方未逐物种给出)。发布节奏方面,文档写的单月计划与实际发布日期的偏差按实际日期记录,未做进一步解释。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- dbsnp — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- ensembl — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- biosamples — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- dgva — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- ddbj — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- clingen — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- giab — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- decipher — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- hgdp — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
- uhgg — 共享标签:基因组学与多组学 / 变异与注释 / 测序数据
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
