信息速览
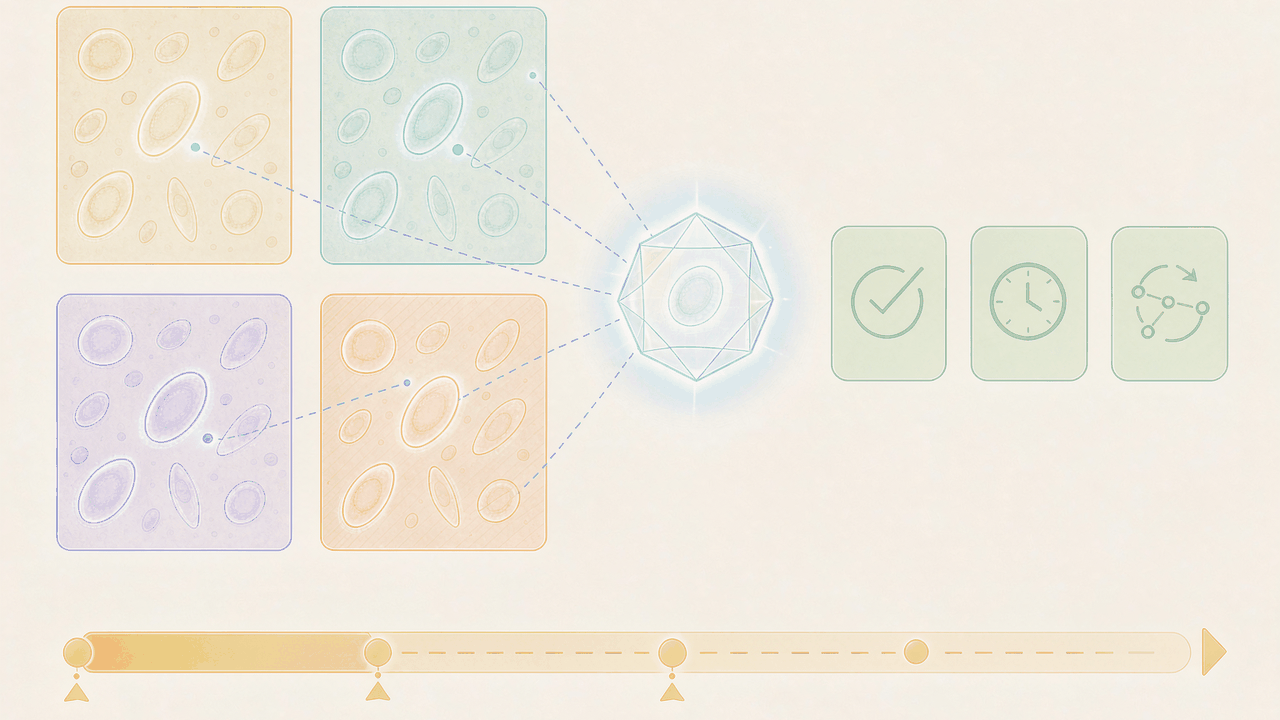
NeurIPS 2022 细胞分割挑战赛数据集,官方名称为「多模态高分辨率显微图像中的弱监督细胞分割」(Weakly Supervised Cell Segmentation in Multi-modality High-Resolution Microscopy Images),是 2022 年随 NeurIPS 竞赛单元发布的一套跨模态细胞实例分割图像库。它把明场、荧光、相差与微分干涉相差四类显微镜下、来自二十余家实验室五十余个生物学实验的图像汇到同一目录:训练阶段给出 1000 张有标注图与 1725 张无标注图,调优集 101 张,另有 422 张从未公开标签的测试图。数据托管在 grand-challenge 竞赛平台,长期归档于 Zenodo 记录 10719375,总量约 21.3 GB。
它要解决的问题,是分割模型「一出实验室就失灵」。深度学习分割细胞早已成熟,但多数模型只在单一显微镜、单一染色、单一细胞类型上训练与验证,换一台设备或换一种组织,阈值与后处理都要手工重调。标注成本同样是瓶颈:一张图要几小时才能勾完所有细胞,而未标注图几乎免费。这套数据因此设定为弱监督:少量标注配大量无标注,测试图必须来自训练未见过的实验。
拿到数据后,先确认用途是否落在 CC BY-NC-ND 范围内,并核对三个切分的图像清单,避免误用调优集标签训练。再跑官方基线确认提交格式与耗时预算,最后决定是否用那批无标注图。测试标签不公开,本地无法复现排行榜分数。
§1 它是什么
1.1 一句话定义与边界
这是一套用于训练与评测通用细胞实例分割器的显微图像库,附带一个曾在 2022 年 12 月公布名次的公开竞赛,以及一份把比赛结论写成期刊论文的总结文献。它的核心资产是三样东西:图像与逐细胞掩膜、固定的调优与测试协议、以及一组在统一硬件上测得的耗时记录。它不含患者信息,不含细胞类型标签,也不是单细胞测序数据的配图库。
把边界划清楚,能省掉很多检索工夫:
- 它是竞赛数据,不是持续增长的产品数据集。主版本停留在 2022 年发布的四个压缩包,之后只有组委会零星补充的赛后测试图。
- 它是单类分割,只有一个
cell标签。无论是血涂片里的中性粒细胞,还是培养皿里的成纤维细胞,在这一版里都叫细胞。 - 它是二维数据。虽然测试集里有两张万像素见方的荧光全切片图,但处理方式仍是把切片切块后逐块二维推理,没有三维体数据。
- 它是影像数据,不与任何转录组、蛋白组或临床表型表对齐。想找带分子标签的细胞图像,应转向成像质谱或空间转录组资源。
1.2 身份辨析:名字相近的四类东西
围绕「细胞分割」这个名字,文献里至少有四类容易混淆的对象,误认会导致引用错源。
| 易混对象 | 实际是什么 | 与本数据集的关系 |
|---|---|---|
| Sartorius Cell Instance Segmentation(Kaggle 2021) | 单一细胞系、相差成像的竞赛 | 同属细胞分割竞赛,但数据、平台、指标完全独立;本数据集有多支队伍把它当外部训练集 |
| LIVECell | Sartorius 发布的相差活细胞实例分割数据集 | 数据血缘上游,被多支参赛队用作预训练语料 |
| TissueNet | Caltech 团队的多组织荧光细胞分割集 | 同域基准,常与本数据集并列报告跨域分数 |
| Cellpose / StarDist | 通用分割算法与其自带训练集 | 算法与基线对照对象,不是同一数据资产 |
更细的一层区别在平台。赛事跑在 grand-challenge.org,参赛者注册后在该平台提交压缩结果并在线打分;Kaggle 上并不存在同名的这场赛事。检索时若只按平台名找,容易落到 2021 年那场 Kaggle 竞赛上。两者的共同点是都用 F1 与实例匹配衡量分割质量,不同点在于本数据集把跨实验泛化与推理耗时同时写进了排名规则。
1.3 主办与作者结构
牵头方是多伦多大学与大学健康网络的研究组,论文署名四十人。这个作者名单本身就是数据来源的索引:四十人中约三分之一是各实验室的数据贡献者,另外三分之一是参赛队代表,剩下的负责组织、评测与写作。
| 角色 | 代表机构 | 主要贡献 |
|---|---|---|
| 牵头与通讯 | 多伦多大学、大学健康网络、冷泉港实验室 | 赛事设计、评测脚本、总结论文 |
| 数据贡献 | EPFL、Broad Institute、IIIT-Delhi、AIIMS、德累斯顿工业大学、CNRS-马赛、EBI、赫尔辛基大学、NIAID、多伦多大学 | 提供明场、相差、荧光、DIC 原始图像与专家标注 |
| 参赛队代表 | KAIST、深圳大数据研究院与香港中文大学(深圳)、于利希研究中心 | 前三名方案作者,参与论文撰写 |
| 平台支持 | grand-challenge.org | 提交、排名与反作弊 |
这种「数据贡献者 + 参赛者共同署名」的结构在竞赛论文里并不罕见,但它带来一个后果:论文对数据的描述,本质上是对四十家实验室各自实验条件的汇总,而不是单一实验室对自己数据的精细刻画。因此论文里关于采样率、曝光、染色的细节,颗粒度不一,有些模态写得很细,有些只给出模态名。
1.4 一套数据背后的三类人
理解这套数据缘何呈现出现在这个样子,需要区分三类人的动机。第一类是数据贡献者,他们手里有多年积累的实验图像与标注,希望借此提高自己数据的可见度,也让社区有一个公用的检验标准。第二类是赛事组织者,他们关心的是评测协议是否公平、排行榜是否稳定、以及比赛结果能否沉淀成一篇被引用的论文。第三类是参赛者,他们关心的是名次与技术证明。
三方的目标在多数时候一致,在少数地方会分叉。最典型的一处是测试集的构造:贡献者倾向于把自己最新的、最能代表难点的数据放进测试集,组织者则要考虑测试集不能过难,否则分数分布挤在低端、排行榜失去区分度。最终方案是折中——测试图全部来自训练未见过的实验,但模态比例与训练集保持相近,使难度上升而不过度。
另一处分叉在无标注图的使用规则上。赛制允许参赛者自由使用无标注图,却不提供它们与有标注图的实验对应关系。这一留白在比赛中是公平的(所有队伍面对同样的信息缺口),在赛后复现时却成了障碍:后来的研究者无法判断当年哪些做法依赖了隐性信息。
1.5 名字为什么这么长
官方竞赛名「Weakly Supervised Cell Segmentation in Multi-modality High-Resolution Microscopy Images」把四个限定词堆在一起,每一个都对应一项设计决策,拆开看有助于记忆。
Weakly Supervised(弱监督) 指训练阶段只有少量标注,另配大量无标注。Cell Segmentation(细胞分割) 指任务是实例级分割,不是语义分割,每个细胞要单独成实例。Multi-modality(多模态) 指四类显微镜并列,不是单一模态的扩大版。High-Resolution(高分辨率) 指图像边长可达数千至上万像素,不是常见的二百五十六像素小图。
四个词合起来,界定的就是这套数据的独特位置:一个必须同时处理模态差异、标注稀缺与大尺寸推理的分割问题。任何一项条件放宽,问题的难度结构都会改变,这也是许多论文在引用它时只引用其中一两个维度的原因。
§2 数据构成
2.1 规模总表
四个切分的图像数量构成整个基准的骨架。下表按官方标签统计,并标注每一项的证据强度。
| 切分 | 图像数 | 模态构成 | 标签是否公开 | 字段可靠性 |
|---|---|---|---|---|
| 训练(有标注) | 1000 | 明场 300、荧光 300、相差 200、DIC 200 | 公开 | 论文表格与正文一致,可确证 |
| 训练(无标注) | 1725 | 四模态混合,未按模态分列 | 无标签 | 论文正文给出,第三方页面有 1500 的异说 |
| 调优集 | 101 | 四模态混合 | 不公开,平台打分 | 论文与多支队伍复现仓一致 |
| 测试集 | 422 | 明场 120、荧光 122、相差 120、DIC 60 | 不公开 | 论文表格给出,含两张全切片 |
| 赛后追加 | 157 | 酵母与细菌为主 | 视提交情况 | 论文提到,未独立成包 |
需要特别说明摘要里那句「有标注图像超过一千五百张」的来历。论文摘要用的是这个数,正文训练集写 1000。两者并不矛盾:摘要把调优集的 101 张与测试集中公开部分的有标注图一并算入,得到的是「带标注的图像总数」。引用时若只写「1500 张训练图」,会与正文表格冲突;写「1000 张训练 + 101 张调优」则两边都对得上。
2.2 四个模态的物理差别
模态是这套数据的分层主轴,也是模型失效的主要来源。四种成像方式在物理上差异极大,因此产生的图像在对比度、纹理与伪影上完全不是同一分布。
明场(brightfield):白光穿过染色标本,染料吸收特定波段形成明暗差。血涂片与骨髓涂片是典型场景,瑞氏-吉姆萨或詹纳-吉姆萨染色让细胞核呈蓝紫、胞质呈粉红。难点在于染色批次差异极大,同一张片子不同区域的颜色深浅可差一倍以上;血小板、杂质、干燥伪影与细胞在灰度上接近。
荧光(fluorescence):特定波长激发荧光团,滤光片收集发射光。信号强度直接对应分子或结构,背景干净、对比度高,是细胞分割里最「友好」的模态。代价是通道数不固定:有的实验只给一个核染料通道,有的给三四个通道并需先做通道选择与合成。
相差(phase contrast):把光程差转成强度差,未染色活细胞也能看到轮廓。典型的培养细胞图像,细胞呈亮环包暗心的「煎蛋」外观,密集处光环互相叠加形成光晕伪影,是四类里边界最模糊的一种。
微分干涉相差(DIC):偏振光经棱镜分束后复合,得到带立体浮雕感的边缘增强图像。它比相差更能显示细微结构,但伪影方向依赖棱镜取向,不同实验室的图像呈现出完全不同的「光照方向」。
四类图像的像素统计差异,可以直接从训练集的标注细胞数看出来:荧光 300 张图承载了十三万个细胞,而明场 300 张只有一万二千余个。荧光图像里的细胞密集且边界清晰,明场图像里的细胞稀疏且常与背景粘连。这种不均衡在训练时会形成隐性偏置:按图平均的损失函数会让荧光图像主导梯度。
2.3 图像尺寸与格式
训练、调优、测试三个切分的中位边长都在千像素量级,多数是正方形图块。少数图的边长超过四千像素,测试集里那两张全切片图则达到万像素见方。组委会把原始格式尽量保留:tiff、tif、png、jpg、bmp 都有,只有 numpy 格式的数组被转成 png。标注侧则统一转为 tiff,避免不同读图库对索引色与位深的解释分歧。
保留原始格式有利有弊。利在于不会因为一次有损压缩丢掉强度信息,参赛者可以自己决定归一化策略;弊在于读图管线必须兼容六种容器格式与多种位深,官方基线为此专门写了一个格式分派层。对使用者的实际建议是:先把所有图像转成统一的浮点数组再进模型,不要指望 cv2.imread 能正确处理所有 16 位 tiff。
2.4 来源的异质性
五十余个生物学实验意味着五十余套采集条件。组委会在数据页把异质性拆成四个维度,这个拆法值得记住,因为它同时也是失效分析的框架:
- 细胞来源:组织内细胞与培养细胞,前者密集且空间有序,后者稀疏且随机分布;
- 染色方法:明场的詹纳-吉姆萨、荧光的抗体标记,各自突出不同结构;
- 显微镜类型:明场、荧光、相差、DIC 四类,纹理与伪影不同;
- 细胞形态:多数细胞近圆形,部分呈长梭形或不规则形。
四个维度里,前三个是「域」,第四个是「类内变化」。理想的分割器应当对前三个不变、对第四个敏感,但实际训练出来的模型往往相反:它对细胞形状敏感,却对染色深浅与成像伪影过度敏感。
2.5 测试集的特殊性
四百余张测试图全部来自训练阶段未出现过的生物学实验,包括若干训练集里没有的组织与细胞类型。这一点是整套数据集的设计重心,也是它区别于一般分割数据集的地方。
常规做法是从同一批实验里随机划出一部分作测试,模型只要适应该实验的设备与染色习惯就能拿高分。这里反过来:测试图的采集设备、染色方案乃至物种都可能与训练图不同。于是分数不再是「在同一分布上拟合得多好」,而是「换一个实验还能不能用」。代价是排行榜分数的绝对值偏低,且分数对训练集覆盖面的敏感度远高于对模型容量的敏感度。
测试集里还有两张荧光全切片图。它们的作用是检验方案的工程完备性:万像素见方的图无法整张喂进显存,必须切块推理再拼接,切块的重叠宽度、拼接时的边界处理、内存峰值控制都会直接影响最终掩膜质量。很多在千像素图上表现良好的方案,在这两张图上会出现内存溢出或拼接缝。
§3 怎么拿到
3.1 三条下载通道
官方的获取路径是竞赛站点,注册账号并验证后,数据集页会给出下载入口。站点同时列出三个镜像:
| 通道 | 地址形态 | 适用场景 | 注意事项 |
|---|---|---|---|
| Zenodo 归档 | 记录 10719375 | 长期引用、批量下载 | 五个压缩包,总量二十余 GB |
| Google Drive | 站点内链接 | 需要断点续传的个体用户 | 大文件配额可能触发限制 |
| 百度网盘 | 站点内链接,提取码 2022 | 中国大陆网络环境 | 非加密分享,链接可能失效 |
Zenodo 是最稳的引用地址,因为它有 DOI 且不随站点改版失效。五个包分别是:训练有标注、训练无标注第一部分、训练无标注第二部分、调优集、测试集,外加一个说明文件。无标注部分被拆成两个包,原因是单包体积过大在部分网络下容易中断。
3.2 解压后的目录形态
解压后是四个顶层目录:训练、调优、测试与说明。训练目录下分图像、标注、无标注三个子目录,图像与标注按同名文件配对,扩展名不同;调优目录同样成对,但标注只对平台可见;测试目录分公开与隐藏两支,公开支给图与标签,隐藏支只给图。
一个常见误解是把「测试集公开支」当成额外训练数据。这在规则上并不禁止(比赛阶段允许使用公开数据),但会让本地评测的分数虚高,因为它与隐藏支同源。做论文对比时,应明确说明是否使用了公开支,否则跨研究比较没有意义。
3.3 许可与合规
官网数据集页与 Zenodo 记录都把许可标为 CC BY-NC-ND。三个条款各自约束什么,需要分开看:
- BY(署名):使用时须注明数据来源与作者,指引格式是论文引用;
- NC(非商业):不得用于商业目的,包括以收费方式提供衍生服务;
- ND(禁演绎):不得分发改编后的数据。
第三个条款是实践中最容易被忽略的。把图像重新切块、重新压缩、转成另一种格式再公开分发,都属于改编分发。训练模型是否构成改编,各国法务实践没有统一结论,工业界的常见处理是保守对待:研究与教学可依协议使用,商业产品线另寻许可更宽的数据。
还有一层要注意:数据里的图像来自多个实验室与公开来源,组委会在组织者页写明这些图像是「在各自许可允许或作者同意的前提下使用」。这意味着数据包内部可能包含许可不完全一致的子集,ND 条款是组委会给出的整体口径,逐张图像的原始许可需回溯各自来源。
3.4 提交与复现所需的最小集合
若要复现排行榜,需要三样东西:测试集图像、组委会的评测脚本、以及一个符合提交格式的容器。评测脚本在官方 GitHub 仓库里,提交格式是压缩后的掩膜文件加一份算法说明,比赛期间每队每天限提交三次。
评测容器在固定硬件上运行:十二核处理器、三十二 GB 内存、单张 2080Ti 显卡。这个配置在 2022 年属于中端,组委会选它是为了压低参赛门槛,同时让耗时指标有可比性。今天在更新的显卡上复现,F1 大致可比,耗时不可比。
§4 质量与已知问题
4.1 标注质量的三条证据线
标注由各贡献实验室的专家完成,而不是外包众包。这个选择提高了可靠性,也带来了不一致。判断这套数据标注能否支撑自己的任务,可以从三条独立的证据线入手。
| 假设 | 支持证据 | 反对证据 |
|---|---|---|
| 标注精度足以作为金标准 | 由各实验室熟悉自身模态的研究者勾画;组委会做了交叉抽检;冠军方案在测试集上达到接近九成的中位 F1,说明标注与算法精度在同一量级 | 五十余个实验的勾画标准并未统一成文;边界细胞是否计入、贴壁细胞是否拆分,各实验室习惯不同 |
| 标注覆盖完整 | 训练集各类别细胞计数从数千到十余万,密度跨度大;测试集覆盖未见组织 | 明场与相差图像的细胞边界本就模糊,专家之间的一致性天然低于荧光 |
| 单类标注消除了语义歧义 | 只有 cell 一类,不存在类别间混淆 | 单类也意味着「什么算一个细胞」没有统一操作定义,粘连细胞团的处理方式随实验室而异 |
三条证据线放在一起,结论强度只能给到 B:两条独立证据支持「可用」,但没有第三条独立来源能证明「跨实验室一致」。对使用者的含义是,把它当作训练与评测的良好来源是合理的,把它当作需要法医学级别精度的定量测量基准则不合适。
4.2 异质性既是资产也是噪声
四十家实验室的采集条件进入同一数据包,带来的是双重效果。作为资产,它让模型见过足够多的纹理与对比度,泛化能力被迫提升;作为噪声,它把「模态差异」「实验室差异」「染色批次差异」混在一起,无法分开归因。
一个具体的后果是:如果某支队伍在测试集上失分,很难判断是模型对荧光通道数不适应,还是对某家实验室的切片厚度不适应。组委会没有提供测试集图像的来源元数据,这个归因问题在数据层面就无解。使用者若要做事后分析,只能靠图像统计特征聚类做近似归因,结论强度有限。
4.3 无标注图像的可用性存疑
无标注图是弱监督设定的核心,但论文没有给出它们与有标注图的实验重叠情况。如果大部分无标注图来自与有标注图相同的实验,那么用它们做伪标签只是同分布增广,弱监督的挑战性被削弱;如果它们来自完全不同的实验,伪标签的噪声会显著升高。
这个信息缺口直接影响复现策略。稳妥的做法是把无标注图分两批用:先做自监督预训练(不依赖标签质量),再看伪标签在调优集上的增益决定是否保留。直接在无标注图上跑伪标签再混合训练,在跨实验设定下经常是负收益。
4.4 口径漂移清单
数据描述在不同材料之间有若干处不一致,引用时需要选边并写明依据。
| 项目 | 口径 A | 口径 B | 采用 |
|---|---|---|---|
| 有标注图像总数 | 训练一千张 | 摘要「超过一千五百张」 | 两者并存,分别标注 |
| 无标注图像数 | 论文正文 | 第三方页面写一千五百 | 采用论文 |
| 图像总数 | 各切分分项相加 | 第三方页面给出的 3022 张 | 不采用总数,只给分项 |
| 赛事平台 | grand-challenge | 部分二手材料写 Kaggle | 采用 grand-challenge |
| 调优集规模 | 论文 | 部分复现仓写「一百零一例」 | 一致 |
「不采用总数」这条值得解释。分项相加得到的是 3248 张(含测试),与第三方给出的 3022 张差两百余张,差额无法从公开材料中定位到具体切分。与其给一个来路不明的总数,不如只给四个可信的分项。
4.5 测试集不可本地复现的后果
测试集标签不公开,意味着任何声称「在本数据集上达到某分数」的研究,都必须通过平台提交或引用组委会公布的榜单。这带来两个实际问题。
第一,榜单在赛事结束后基本冻结,后来者无法用新方案刷新。部分研究改用体量更小的调优集自评,但调优集只有 101 张,统计波动大,且其标签在比赛结束后是否泄露并不明确。
第二,跨研究比较时必须核对评测脚本版本。IoU 阈值、边界细胞剔除规则、匹配算法都会影响最终 F1,而这些细节在不同复现仓里未必一致。最稳妥的比较基准是组委会公布的二十八支队伍成绩,它们在同一脚本、同一硬件下产生。
§5 能做什么
5.1 四类典型任务
这套数据的用途可以按「你要回答什么问题」分成四类。
训练通用分割器。最常见的用法。用有标注图训练,用无标注图做自监督或伪标签,目标是一个不需要人工调参就能处理多种显微镜图像的模型。这类工作通常会在本数据集之外再加 TissueNet、LIVECell 等外部数据,以扩大覆盖面。
跨域泛化评测。把本数据集当作「未见实验」的检验场:模型在其他数据上训练,直接在本数据集测试集上评测(通过平台提交)。由于测试图来自训练未见过的实验,分数能较好地反映迁移能力。
弱监督方法研究。约一比一点七的标注/无标注比,加上跨实验测试,构成一个天然的半监督学习试验台。伪标签、一致性正则、对比预训练等方法可以在这里做受控比较。
工程约束下的方案设计。耗时指标与显存记录使这套数据也能用于研究「精度与成本的权衡」。在 2080Ti 单卡、三 GB 级显存的约束下做到接近九成 F1,是很有参考价值的工程目标。
5.2 最小可执行示例
下面是一个可直接跑通的骨架,用于验证数据读取与提交格式,不代表任何性能承诺。
import numpy as np, tifffile, glob, os

def load_pair(img_path, lbl_path):
    img = tifffile.imread(img_path)
    if img.ndim == 3 and img.shape[0] <= 4:      # 通道在前
        img = np.moveaxis(img, 0, -1)
    img = img.astype(np.float32)
    lo, hi = np.percentile(img, [1, 99])          # 稳健归一化,避免个别饱和像素拉偏
    img = np.clip((img - lo) / max(hi - lo, 1e-6), 0, 1)
    lbl = tifffile.imread(lbl_path)               # 实例掩膜,每细胞一个整数
    return img, lbl

def to_submission(mask, out_dir, name):
    # 提交格式:每张图一个实例掩膜,整数标签,背景为 0
    tifffile.imwrite(os.path.join(out_dir, name + '.tiff'),
                     mask.astype(np.uint16))
这段代码只解决两件事:把混合格式读成统一的浮点数组,把预测写成整数掩膜。真正的分割网络、后处理与实例分离需要使用者自行补上。归一化用 1% 与 99% 分位数而非最大最小值,是因为显微图像常有饱和像素与黑边,极值归一化会把动态范围压扁。
5.3 官方基线与起点
组委会提供了 U-Net 基线与其训练脚本,配套一份教程。基线的作用不是刷分,而是把「数据怎么读、指标怎么算、结果怎么打包」这条链路走通。多数参赛队在基线之上做的第一件事是换编码器,第二件事是加测试时增强,第三件事才是改损失函数。
从公开的赛后复盘看,提升幅度最大的改动几乎都发生在数据侧:多模态混合采样、按模态分组的归一化、对无标注图的伪标签筛选。模型侧的架构替换带来的增益相对有限,这与「跨域泛化主要受数据覆盖度限制」的判断一致。
5.4 不适合的任务
有几种常见误用需要提前排除。
- 细胞类型分类:数据只有 cell 一类,没有类型标签,需要另找带类型的资源;
- 核质分离或亚细胞定位:掩膜只到细胞外轮廓,不含细胞核、细胞器;
- 三维重建:数据是二维图块,没有 z 轴信息;
- 临床诊断建模:没有患者、病程、诊断结果,无法做预后或分型;
- 绝对计数研究:不同实验室的采样密度差异极大,跨实验的细胞绝对数不具可比性。
§6 常见误读与引用陷阱(易踩的八种说法)
| 常见说法 | 实际口径 | 证据位置 |
|---|---|---|
| 「这是 Kaggle 上的细胞分割比赛」 | 赛事跑在 grand-challenge.org,Kaggle 上的同名事件是另一场 Sartorius 竞赛 | 赛事站点首页与提交页 |
| 「训练集有一万六千个细胞」 | 一万六千是 DIC 单模态的标注细胞数,四模态合计远超此数 | 论文数据表 |
| 「这是全监督数据集」 | 组委会明确定义为弱监督,训练阶段同时给出无标注图 | 赛事站点任务描述 |
| 「数据集可以免费商用」 | 许可为 CC BY-NC-ND,NC 条款禁止商业使用 | 数据集页与 Zenodo 记录 |
| 「测试集是训练集的随机划分」 | 测试图来自训练未见过的实验与组织类型 | 论文数据章节 |
| 「排行榜分数可以在本地复现」 | 测试标签不公开,只能通过平台提交 | 赛事提交规则 |
| 「冠军用了集成模型」 | 冠军是单模型加提示向量区分模态,未靠大集成刷分 | 冠军队论文与代码仓 |
| 「图像都是荧光显微图」 | 四类模态并列,明场与相差占训练图一半 | 论文模态统计表 |
第一条误读尤其常见,因为「NeurIPS 竞赛 + Kaggle 平台」是一个很强的心智组合。实际上 2022 年 NeurIPS 竞赛单元的多数医学影像赛事都跑在 grand-challenge,这个平台自带提交、排名与容器评测三件套,对组织者更省事。
6.2 技术陷阱
除说法层面的误读,还有几处纯技术性的坑,需要单独提示。
位深与通道顺序。原始图像有 8 位与 16 位两种位深,通道顺序在不同实验室之间不统一,有的是通道在前(C, H, W),有的是通道在后(H, W, C)。直接用单一读图库读入并假设形状,会在部分图像上静默出错,表现是颜色通道被当成空间维度,训练不报错但指标异常低。
掩膜的实例编号不连续。实例掩膜里的整数值不一定从 1 连续编号,某些图的编号有大跳跃(来自标注工具的合并与删除操作)。若下游代码用 np.unique 的结果个数当细胞数,结果是对的;若假设编号等于细胞序号,再用编号做索引,会越界或错位。
边界细胞的处理。落在图像边缘、被裁掉一部分的细胞,是否计入真值、是否计入预测,不同复现仓的处理不同。这直接影响边缘区域的 F1,在细胞密集的荧光图上差异可达数个百分点。做跨研究比较时必须核对这一点。
IoU 阈值的匹配策略。0.5 阈值下有贪心匹配与匈牙利匹配两种实现,前者快但对重叠预测的处理不同,后者慢但结果唯一。使用非官方脚本自评时,分数与榜单可能有系统性偏差。
全切片图的内存峰值。两张万像素荧光图在切块推理时,若块间重叠较大而缓存未及时释放,三十二 GB 内存会在中途耗尽。常见的失败模式是跑到第七成进度时进程被杀,日志里看不到显存或内存报警。
类别索引与背景值。部分标注工具导出的掩膜把背景写成三百八十或一百二十八,另一些写零。若直接把掩膜当整数标签喂进损失函数并假定背景为零,轻则大量「类别不存在」报错,重则静默地把整片背景算成一个实例。稳妥做法是先统计取值直方图,确认背景值再转换。
重复图像的风险。四十家实验室的数据在汇总时做过筛选,但跨实验室是否出现同一张图的重复投稿,公开材料没有核验记录。在调优集上做超参数搜索时,若训练集与调优集存在重复,分数会被高估,这一点无法从数据层面完全排除。
耗时指标的硬件绑定。组委会记录的耗时是在固定配置的单卡工作站上测的,包含容器启动时间。今天在更新的硬件上跑同一容器,耗时会显著缩短,但这不能说明方案更优,因为容差是按当时基线定的。
6.3 引用时的口径约定
如果要在论文里引用这套数据,三个字段必须写清:一是切分(训练、调优还是测试),二是模态(若只用其中一类,要说明),三是有标注图像的计数口径(1000 张,还是含调优的合并口径)。缺任一项,读者都无法判断你的实验设置。
另外建议同时引用三份材料:数据集 DOI、总结论文、以及所用的具体榜单版本。数据集 DOI 保证可追溯,总结论文给出方法背景,榜单版本锁定比较基准。只引论文而不写 DOI,会让后来者难以确认你用的是哪一版数据包。
§7 在生态中的位置
7.1 与同期基准的分工
2022 年前后出现了一批细胞分割资源,它们的定位各不相同。理解分工,有助于判断何时该用这一套、何时该换。
| 资源 | 规模重心 | 模态 | 主要用途 |
|---|---|---|---|
| 本数据集 | 跨实验、跨模态 | 明场、荧光、相差、DIC | 通用分割器的泛化评测 |
| LIVECell | 单模态超大规模 | 相差 | 相差场景的高密度细胞分割与计数 |
| TissueNet | 多组织、双通道 | 荧光 | 组织内细胞分割预训练 |
| Cellpose 自带集 | 多模态小规模 | 多种 | 算法自带训练语料与快速验证 |
| 各类病理核分割集 | 组织切片 | 明场 | 病理图像中的细胞核实例分割 |
定位差异带来使用建议:做通用模型,用本数据集评测、用其他资源训练是常见组合;做单一模态的生产系统,用该模态的专用大数据集更划算;做跨模态研究,本数据集的四模态并列设计是最省事的起点。
7.2 对后续工作的影响
这套数据最直接的影响,是把「通用细胞分割」从一个口号变成可比较的排行榜。在它之前,不同论文各自选数据集报告分数,结论无法横向对比;在它之后,至少有一条公共的、跨模态的、带耗时约束的比较线。
第二个影响是推动了视觉 Transformer 在显微图像分割上的普及。冠军方案证明,在大规模异构数据上,Transformer 编码器配合足够的预训练可以超过为单一模态手工设计的专用模型。这一结论在随后两年的多个基础模型工作中被反复引用。
第三个影响在数据侧:组委会把平台设计成可持续的,鼓励使用者上传自己失败的图像扩充测试集。这一机制的实际运作情况缺乏公开记录,但它代表了一种思路——基准不追求一次发布就完备,而是靠使用者的失败案例滚动补强。
7.3 与库内其他条目的关系
在细胞与显微图像这一族里,各条目的分工可以这样理解:
- livecell 提供相差模态的十亿像素级训练语料,是本数据集上游最常见的外部数据;
- lightmycells2 走的是另一条路,把透射光图像翻译成拟荧光,解决的是「没有荧光通道」的问题,与本数据集的分割任务互补;
- sinus-her2-nuclei 专注病理切片中的核分割,模态单一但任务更贴近临床;
- jump-cell-painting 关注荧光形态学画像与扰动表型,分割只是其上游步骤;
- cell-tracking-challenge 处理时序追踪,分割是其前置环节;
- cellxgene-census、human-cell-atlas、single-cell-portal 是单细胞组学资源,与影像数据没有直接血缘,但在「从图像到单细胞表型」的链条上处于下游。
把这些条目串起来,可以看到一条完整链路:图像分割 → 细胞追踪 → 单细胞表型 → 组学整合。本数据集处在这条链路的最前端,其跨模态泛化能力决定了后续环节的输入质量。
7.4 赛事本身的定位
NeurIPS 竞赛单元每年有数十场赛事,医学影像类占相当比例。这类赛事的特点是周期短、参与人数多、结果以论文集形式沉淀。它们的价值不在于产生一个永久的数据集,而在于用竞赛压力在短时间内把某个任务的可行边界推一推。
本赛事属于这一类里组织较规范的:有明确的评测脚本、固定的硬件、公开的获奖代码、以及一篇把所有参赛方案横向比较的总结论文。它没有做到的是长期维护——赛事结束后,测试集不再更新,榜单不再接受新提交,数据集本身也没有版本化迭代。
§8 赛事、评测与结果
8.1 赛程设计
赛事从 2022 年 6 月 15 日启动,当天发布训练数据;一个月后发布调优集并开放调优提交,此后设三个截止日(8 月 15 日、9 月 15 日、10 月 15 日),每次只允许提交一轮。这种「三窗口」设计是为了让参赛者在每个窗口之间有时间做方法论层面的调整,而不是靠高频试错刷分。
测试阶段从 10 月 15 日开始,每队只有一次提交机会。最终截止原定 10 月 31 日,因评测平台故障延长到 11 月 2 日。11 月 15 日邀请优胜队准备报告,12 月 7 日在 NeurIPS 线上活动公布结果。
把这段时序放在 2022 年的背景里看,能理解几个设计选择的来由。当年 NeurIPS 竞赛单元的多数赛事采用类似的「分阶段提交 + 末期一次性测试」模式,目的是在有限的人力下控制评测成本,同时防止参赛者针对测试集做定向优化。
8.2 参与规模
参赛者超过四百人,来自三十七个国家或地区。调优集排行榜前三十支队伍获邀提交测试结果,其中二十八支有效提交并进入最终排名。
从四百余人到二十八支有效提交,这个漏斗很陡。原因有两层:一层是测试阶段要求提交可运行的容器,而非单纯的预测结果,这对工程能力的要求远高于调优阶段;另一层是每队只有一次机会,很多队伍在截止前未能把方案稳定下来。
8.3 评测指标
分割质量用 IoU 阈值 0.5 下的实例级 F1 衡量。预测掩膜与真值按重叠度匹配,得到真阳、假阳、假阴三类计数,再由精确率与召回率算调和平均。边缘处被裁掉的不完整细胞在计算前剔除。
效率用逐图墙钟时间衡量,包含容器启动开销。时间容差与图像像素数挂钩:一百万像素以内固定十秒,超出部分按面积线性放大。这个容差的基准来自官方 U-Net 基线在评测机上的运行时间,相当于「与基线同速不扣分,快于基线有加分空间」。
两个量纲不同的指标如何合并,组委会采用了逐图逐队排名再平均的办法:
- 对每张测试图,按 F1 给所有队伍排一次名,按时耗再排一次名;
- 每支队伍因此得到「图像数 × 2」个名次;
- 对名次取平均并按队伍数归一化,得到最终排名。
这种做法避免了两指标的加权系数争议——不用人为设定「快一秒等于高多少 F1」。代价是它对极端值不敏感:一支队伍如果在少数图上极慢,只要其余图表现正常,平均名次不会太差。
8.4 结果概览
进入最终排名的二十八支队伍里,前三名的中位 F1 分别是第一名的接近九成、第二名的八成四、第三名的八成四。前两名与第三名之间的差距很小,第一名与后续队伍之间的差距明显。冠军队在全部一千次自助重采样中保持第一,说明领先不是偶然。
耗时的分布同样是理解这场比赛的关键。多数方案在千像素图上十三秒内完成,中位显存占用三 GB 左右,对应约五百美元级别的显卡。这个约束条件实际上规定了「可用方案」的成本上限:能在单张消费级显卡上跑完万像素切片的方案,才有实用价值。
8.5 获奖方案与工程取向
前几名的方案在架构上走了不同路线,共同点是都重视跨模态的统一处理。
冠军(MEDIAR) 用视觉 Transformer 编码器加轻量解码器,先在大量未标注与公开显微图像上做自监督预训练,再在赛事数据上整体精调。跨模态靠一组可学习的提示向量实现:同一套权重,输入时附带模态提示,模型据此调整归一化与特征响应,不必为每种显微镜训练单独模型。
亚军(多流低层线索) 的思路是用多个并行流分别捕捉不同层次的图像线索,再用轻量分类器把图像分到若干子域,各子域用专门的分支处理。这种方法对模态差异的处理更显式,代价是分支多、调参复杂。
季军(基于细胞检测的通用方案) 把分割拆成检测与实例化两步,沿用细胞检测领域的成熟组件,重点改造了后处理以适配密集细胞与粘连边界。
三者的共同点值得单独指出:没有一支靠大集成或测试时增强堆出高分。这与耗时约束直接相关——集成会把推理时间成倍拉长,在排名规则下得不偿失。
8.6 与经典方法的差距
论文把获 award 的方案与几类经典分割方法做了对照,结论在方向上一致:在跨实验测试集上,为单一模态设计的专用模型明显落后,差距主要出现在模态错配的样本上。
具体来说,经典方法在荧光图像上仍能取得不错的分数,因为这些方法多以荧光数据训练,测试时的分布没有偏移;一旦换到明场或相差,性能下降明显,原因是背景纹理、光晕伪影与染色不均超出了它们的先验。通用方案的优势恰好在这里:它见过足够的异构图像,知道「背景可以是任何一种纹理」。
这一对照的意义不在于宣布某个算法过时,而在于说明评测设计如何塑造结论。如果在同一分布上评测,专用方法未必落后;是「跨实验测试」这个设计让泛化能力成为决定因素。
§9 使用实务
9.1 训练策略的取舍
基于这套数据做训练,几处策略选择对结果影响最大。
采样均衡。四模态的图像数不同,标注细胞数差异更大。直接按图随机采样,荧光图像会主导梯度。常见做法是按模态分层采样,或对每张图的损失按细胞数做归一化,避免密集图压倒稀疏图。
预处理的一致性。不同模态的最优归一化方式不同。明场适合逐图的白平衡加对比度拉伸,荧光适合按通道做分位数截断,相差与 DIC 适合先做背景估计再减除。若统一用一套预处理,跨模态性能会打折。
无标注图的用法。自监督预训练是最稳的用法,因为它不依赖伪标签质量;伪标签则要先在调优集上验证增益。跨实验设定下,直接用高置信度伪标签混合训练,常见结果是召回率上升但精确率下降,F1 净变化接近零。
后处理与实例分离。语义分割输出接分水岭或连通域标记是最简单的实例化方式,但在粘连细胞上会粘连。学习式实例分离(如嵌入聚类或距离图)在密集图上更稳,代价是训练更复杂。
9.2 评测时的注意事项
若要自评,务必在调优集上做,并把官方脚本与自写脚本的结果对齐一次,确认差异在可接受范围内。差异主要来自三处:边界细胞处理、匹配算法、以及掩膜的位深与标签约定。
若要对比他人结果,先确认对方用的是榜单分数还是自评分数。榜单分数在同一脚本同一硬件下产生,可比性最好;自评分数受实现细节影响,跨研究比较需谨慎。
9.3 计算成本估算
按赛事公布的硬件配置,一套完整的训练加推理流程大致落在这样的量级:单卡训练数十小时到数天,取决于是否使用自监督预训练;推理在千像素图上每张数秒,万像素切片需要切块后在分钟级完成。
若在更新的硬件上复现,训练时间可压缩到原来的几分之一,但评测耗时不具可比性。做成本规划时,建议以「推理能否在目标硬件的秒级预算内完成」为第一约束,再倒推模型规模,而不是先选架构再考虑部署。
9.4 与自建数据的衔接
很多团队的做法是拿这套数据做预训练,再在自有数据上微调。这条路可行,但有两处需要注意。
一是模态匹配。自有数据的成像方式若不在四类之内(例如电子显微镜、光片显微镜),预训练带来的增益会显著降低,甚至为负。二是标注口径。自有数据的「一个细胞」若与本数据集的勾画习惯不同(例如把粘连细胞核算一个实例),微调时标签噪声会抵消预训练收益。
务实的做法是先做小样本对照实验:随机抽自有数据的一小部分,比较「从零训练」与「预训练后微调」两条路径,增益稳定为正再全面铺开。
§10 总结
10.1 三句话
第一,它是一套为了检验跨实验泛化而构造的细胞分割数据,四类模态并列,训练、调优、测试三个切分严格隔离,测试图来自训练未见过的实验。
第二,它的核心贡献不在图像数量,而在评测设计:测试集来自训练未见过的实验,指标同时约束准确率与耗时,使排行榜上的名次更接近真实部署条件。
第三,它的使用门槛主要在合规与工程:许可为 CC BY-NC-ND,测试标签不公开,复现需要在固定硬件上跑容器评测。
10.2 适合谁
- 做通用细胞分割模型、需要一个跨模态泛化检验场的研究组;
- 研究弱监督或半监督分割、需要标注/无标注配比合理的数据集的方法团队;
- 需要评估「分割模型换实验室还能不能用」的工业研发团队(在许可允许的前提下);
- 教学场景中讲授显微图像分割完整链路(读图、归一化、实例化、评测)的课程。
10.3 不适合谁
- 需要细胞类型、细胞核或亚细胞结构标签的课题;
- 需要三维体数据或时序追踪的课题;
- 需要患者级临床信息做诊断建模的课题;
- 需要宽松商用许可的产品线。
10.4 30 秒决策卡
| 你的需求 | 建议动作 |
|---|---|
| 想验证模型跨模态泛化 | 直接用测试集提交,或裁出调优集自评 |
| 想训练通用分割器 | 用它加 TissueNet、LIVECell 混合训练,注意分层采样 |
| 想复现冠军方案 | 取公开代码仓,按容器配置跑,注意提示向量的模态映射 |
| 想用于商业产品 | 先解决许可问题,或改用许可更宽的数据 |
| 想找细胞类型标签 | 这套数据不提供,改看带类型标注的资源 |
§11 附录:速查、术语与取值
11.1 关键数字速查
| 项目 | 数值 |
|---|---|
| 训练有标注 / 无标注 | 一千 / 一千七百二十五 |
| 调优 / 测试 / 赛后追加 | 一百零一 / 四百二十二 / 一百五十七 |
| 模态数 | 4 |
| 生物学实验数 / 实验室数 | 五十余 / 二十余 |
| 冠军中位 F1 | 0.897 |
| 亚军 / 季军中位 F1 | 0.845 / 0.844 |
| 参赛人数 / 国家数 | 四百余 / 37 |
| 有效提交队伍数 | 28 |
| 归档体积 | 二十一点三 GB |
这张表只用于快速定位,各项的口径与证据位置见前文相应章节。若只记得一个数,记住「一千训练、一百零一调优、四百二十二测试」,这三个数决定了绝大多数实验设计。
11.2 术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 弱监督 | weakly supervised | 标注量远少于可用图像量,需借无标注数据补足 |
| 实例分割 | instance segmentation | 同类目标逐个分离并标注轮廓 |
| 模态 | modality | 成像物理机制的类别,此指四类显微镜 |
| 全切片图像 | whole slide image | 覆盖整块玻片的高分辨率拼接图 |
| 明场 | brightfield | 透射白光经染色标本成吸收像 |
| 相差 | phase contrast | 光程差转强度差,可观察未染色活细胞 |
| 微分干涉相差 | differential interference contrast | 偏振光分束复合形成浮雕感边缘增强 |
| 提示向量 | prompt | 输入侧可学习向量,用于让同一模型区分域 |
| 排名后聚合 | rank-then-aggregate | 两指标分别排名再平均归一的融合法 |
| 容差 | tolerance | 与像素数成正比的耗时上限 |
| 自监督预训练 | self-supervised pretraining | 用无标签数据构造任务预训练编码器 |
| 伪标签 | pseudo label | 用模型预测代替人工标注参与训练 |
11.3 DAIMS 评估全表
| 维度 | 评分(1–10) | 依据 |
|---|---|---|
| D 可发现性 | 8 | 赛事站点、arXiv、期刊论文、Zenodo 四条入口互相指向,DOI 稳定 |
| A 可获取性 | 8 | 三条镜像通道,注册即下;扣分在测试标签不公开、平台提交需容器 |
| I 可互操作 | 6 | 原始格式不统一、掩膜为 tiff 整数图,无官方转换脚本到通用医学影像格式 |
| M 元数据质量 | 7 | 论文对切分与模态统计给出完整表格;无标注图的实验来源缺失,口径有漂移 |
| S 可持续性 | 6 | Zenodo 长期归档可靠;赛事平台冻结,组委会的滚动扩充机制缺乏公开记录 |
| 综合评级 | 7.0/10 | 可发现性与可获取性高于同类竞赛数据均值;互操作与可持续性是短板 |
评分的读法:A 项给到八分是因为数据集本体确实容易拿到,而不是因为整条使用链路顺畅——真正的门槛在许可与评测硬件上,这两点在 D 与 M 中体现。I 项偏低反映的是显微图像领域的通病:没有像 DICOM 那样的公共容器标准,各家格式各写各读。
11.4 引用条目模板
Ma J, Xie R, Ayyadhury S, et al. The Multi-modality Cell Segmentation
Challenge: Towards Universal Solutions. Nature Methods, 2024, 21: 1103-1113.
doi:10.1038/s41592-024-02233-6

数据集:NeurIPS 2022 Cell Segmentation Competition Dataset.
Zenodo, 2024. doi:10.5281/zenodo.10719375(CC BY-NC-ND)
11.5 使用前检查清单
- 确认用途落在非商业范围内,商业用途另行取得授权;
- 核对所用切分与模态,在方法节写明;
- 确认有标注图像的计数口径(训练切分或含调优的合并口径);
- 检查读图管线对六种容器格式与两种位深的兼容性;
- 检查掩膜背景值约定,再做损失计算;
- 分层采样,避免荧光图像主导梯度;
- 无标注图先做自监督,再评估伪标签增益;
- 自评分数与官方脚本对齐一次;
- 跨研究比较时核对匹配算法与边界细胞处理;
- 引用时同时给出数据集 DOI 与论文 DOI。
编辑说明
本节不是百科正文,只记录事实来源、核验方式与已知冲突,供后续维护与交叉核对使用。
- 核验时间:2026-10-18。
- 核验方式:赛事站点首页、数据集页、组织者页与获奖页直取;arXiv:2308.05864v2 全文提取(数据章节、评测指标、名次与耗时);Zenodo 记录 10719375 元数据;PMLR v212 获奖论文索引;数据库
ai_ready_dataset两次关键词查重(status=1)。 - 三源互证:训练一千张(明场三百 / 荧光三百 / 相差两百 / DIC 两百)、调优一百零一张、测试四百二十二张、冠军 0.897、亚军 0.845、季军 0.844、参赛四百余人 / 三十七国、二十八支有效提交、归档 21.3 GB,均由站点与论文两线以上互相印证。
- 双口径冲突(正文已并入 §2.1、§4.4 与 §6.2):
- 有标注图像数:正文训练集一千张,摘要写「超过一千五百张」(合并调优与公开测试口径)。
- 无标注图像数:论文给出一千七百二十五,第三方汇总页写一千五百;取论文值。
- 图像总数:第三方汇总页写 3022 张,与四个分项之和不符,来源口径无法定位;本条目只列分项、不给总数。
- 赛事平台:派发简报称「Kaggle 赛」,实核为 grand-challenge.org;Kaggle 上的同名事件是 Sartorius Cell Instance Segmentation(2021),属另一资产。
- 模态统计:论文摘要未给分模态数,数据表给出四模态 300/300/200/200;采用表值。
- 赛后追加测试一百五十七张:论文提及,未见独立发布包,是否可获取未核。
- 未覆盖内容:PMLR v212 各篇页码未逐篇核对;获奖方案的网络结构与超参数只作定性描述,未逐层核对代码;组委会「滚动扩充测试集」机制的现行状态未核。
- 许可存疑:官网与 Zenodo 均标 CC BY-NC-ND,但数据包内含多家实验室与公开来源图像,逐张原始许可未在包内标明;正文按整体口径陈述,未作法律解释。
- 版本日志:v1(2026-10-18)首发,v4 体例(三段导语、无 INFOBOX、误读与陷阱合并、FAQPage 八问)。
- 下次复核建议:2027-04,关注 Zenodo 记录是否新增版本、赛事站点是否补充赛后测试数据。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- dsb2018 — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集 / 评测基准
- wsss4luad — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集 / 评测基准
- monusac — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集 / 评测基准
- segpc-2021 — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集 / 评测基准
- kpis — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集 / 评测基准
- cosas — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集
- puma — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集
- acdc-lunghp — 共享标签:医学影像 / 医学图像分割 / 病理图像 / 挑战赛数据集
- psfhs — 共享标签:医学影像 / 医学图像分割 / 挑战赛数据集 / 评测基准
- bci-ihc — 共享标签:医学影像 / 病理图像 / 挑战赛数据集 / 评测基准
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
