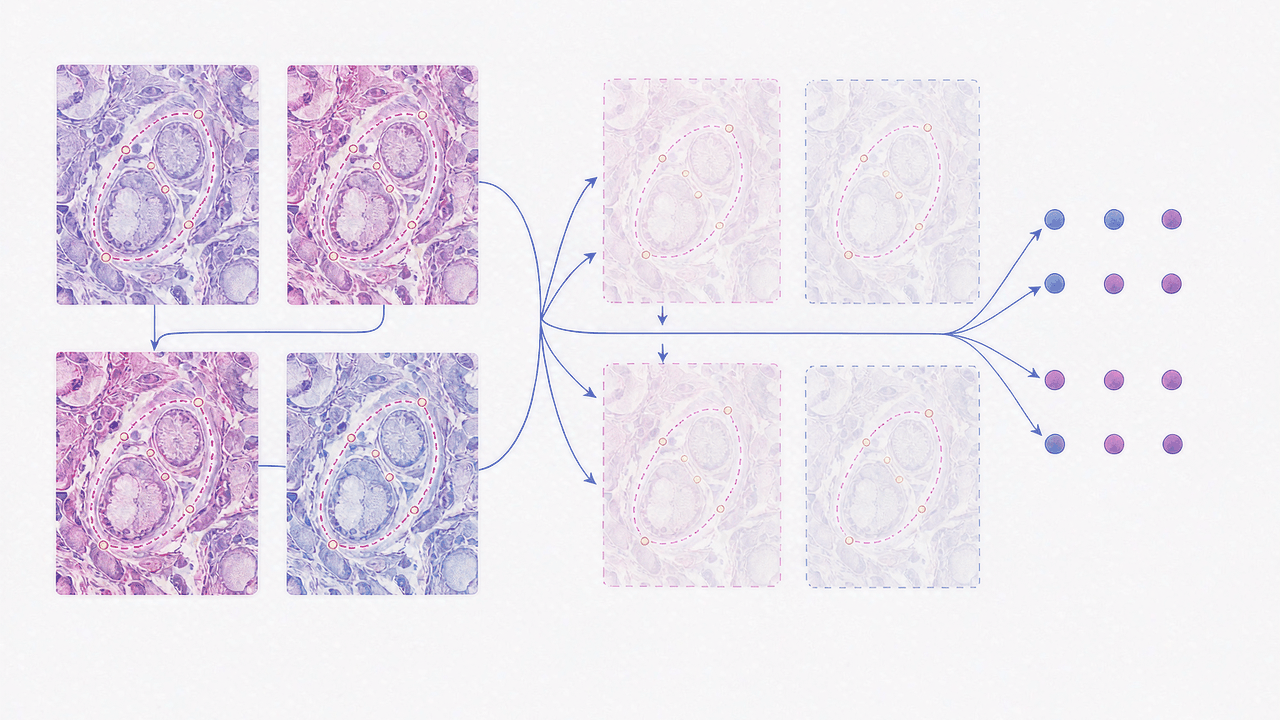
信息速览
COSAS 2024 — 跨器官跨扫描仪腺癌分割 AI-Ready Wikipedia
INFOBOX
| 数据集名称 | COSAS 2024 挑战赛数据集 |
| 英文全称 | Cross-Organ and Cross-Scanner Adenocarcinoma Segmentation Challenge |
| 别名/简称 | COSAS、COSAS 2024、COSAS Challenge |
| 疾病分类 | 腺癌 6 种(ICD-11:2B72.1 胃腺癌 / 2B92.0-2B92.1 结直肠腺癌 / 2C10.0 胰腺腺癌 / 2C61 乳腺浸润性癌 NST / 2C82 前列腺腺癌 / 2C25.0 肺腺癌,详见 §2.1) |
| SNOMED CT | 443961000124105 Adenocarcinoma / 25481003 Invasive ductal carcinoma / 93880000 Primary malignant neoplasm of lung / 363406005 Malignant tumour of colon(详见 §2.1b) |
| 数据模态 | H&E 染色病理全切片图像 patch(约 1500×1500 像素) |
| AI 任务类型 | 二值前景分割(正常腺体 + 腺癌区域)、跨器官与跨扫描仪域泛化 |
| 样本总数 | 580 张 patch(Task 1 跨器官 290 张 + Task 2 跨扫描仪 290 张) |
| 数据大小 | 以 Zenodo 记录页(record 10992201)文件清单为准 |
| 数据格式 | H&E patch 图像 + 手工轮廓标注(栅格化后为像素掩模) |
| 许可证 | 以 Zenodo 记录页标注为准;下载数据需注册并接受数据使用协议 |
| 访问级别 | 训练集注册后开放(Zenodo);初测/终测为竞赛专用(grand-challenge 平台闭门发布) |
| 语言 | 英文(官方文档与论文) |
| 首发日期 | 2024-04-18(Zenodo v1) |
| 最后更新 | 2024-04-18(v1;截至抓取时点 2026-09 未见 v2) |
| 发布机构 | COSAS 2024 组织委员会(西交利物浦大学、瑞金医院、深圳大学、广西医科大学、Histo Pathology Diagnostic Center) |
| 官方主页 | cosas.grand-challenge.org |
| 下载地址 | zenodo.org/records/10992201 |
| DOI | 10.5281/zenodo.10992200(concept DOI,解析至 v1 记录 10992201) |
| AI 就绪度评分 | ⭐⭐⭐(3/5)— 官方划分清晰、扫描仪/器官元数据完整;扣分项:轮廓标注需自行栅格化、无官方预处理脚本、patch 尺寸不统一、无患者级标识 |
| 页面状态 | published |
§0 E-E-A-T 信任声明与免责声明
医学审核者:千方病案医学编辑部交叉审核:§2 医学背景(6 种腺癌的 ICD-11 与 SNOMED CT 映射、腺癌病理学特征、金标准标注描述)、§7 偏倚分析。
数据工程审核者:[千方病案医学编辑部交叉审核] 医疗 AI 数据工程师,审核范围:§4 DAIMS 数据字典、§5 数据划分策略、§6 预处理 Pipeline 和坑点。
审核日期:2026-09-27
审核方式:交叉审核
利益冲突声明:千方病案医数集与 COSAS 2024 组织委员会、西交利物浦大学、瑞金医院、grand-challenge.org 平台(DIAG Nijmegen)及 Zenodo 无任何商业利益关联。本页面不销售 COSAS 2024 数据集本身,仅提供 AI 就绪指南与学术信息服务。编辑者未接受上述任何机构的资助。
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始许可协议。COSAS 2024 训练数据经 Zenodo 发布,下载数据需在 Zenodo 注册并接受数据使用协议;初测与终测数据为竞赛专用资源。DUO 标签仅供参考,具体使用限制以数据集官方协议为准。
§1 数据集概览
§1.0 📌 30 秒速览
这是什么? COSAS 2024 是挂在 MICCAI 2024 名下的卫星挑战赛数据集,全称 Cross-Organ and Cross-Scanner Adenocarcinoma Segmentation Challenge(跨器官与跨扫描仪腺癌分割挑战赛)。它由 580 张 H&E 染色病理 patch 组成:290 张考"换个器官还认不认得腺癌"(6 种腺癌、同一台扫描仪),另外 290 张考"换个扫描仪还认不认得腺癌"(同一癌种、6 台扫描仪)。官方宣称这是数字病理领域第一个、也是当时最大的域泛化分割数据集(官网 overview)。
为什么重要? 病理 AI 最现实的失败方式不是"没见过病",而是"没见过医院"——换了扫描仪、换了染色批次、换了器官,模型性能就会大幅跳水。在 COSAS 之前,病理分割基准几乎都在同源数据上做"内部随机划分",成绩虚高;COSAS 第一次把"训练域"和"测试域"物理切开,让域泛化成为被公开测量的能力。冠军方案(FAU Erlangen-Nürnberg 的 DCAC,arXiv:2409.09797)在两个赛道分别拿到 0.8020 和 0.8527 的合成指标,这组数字至今是跨域腺体分割的公开参照点。
我能用它做什么? 复现或对比域泛化分割算法(nnU-Net 及其变体是官方默认起点);研究染色归一化、扫描仪指纹等预处理决策对跨机泛化的真实影响;直接复用 grand-challenge 的 Docker 提交协议搭建自己的病理评测平台。注意:训练集(180×2 张)经 Zenodo 公开可下载,初测/终测数据为竞赛闭门资源,且预训练权重被限制为 ImageNet / MS COCO 等非医学数据。
§1.1 摘要
COSAS 2024 由西交利物浦大学 Jingxin Liu(Chair)、瑞金医院 Da Qian、深圳大学 Linlin Shen、广西医科大学 Yuexiang Li 与 Histo Pathology Diagnostic Center 的 Yanfei Zuo 五人领衔,临床标注团队来自瑞金医院(10 人)。数据侧,Task 1(跨器官)提供 290 张约 1500×1500 像素的 H&E patch,覆盖胃腺癌、结直肠腺癌、胰腺导管腺癌、乳腺浸润性癌(NST)、前列腺腺癌、肺腺癌 6 种腺癌,全部由 TEKSQRAY SQS-600P 扫描;Task 2(跨扫描仪)提供 290 张乳腺浸润性癌(NST)patch,覆盖 TEKSQRAY SQS-600P、KFBIO KF-PRO-400、3DHISTECH PANNORAMIC 1000、Zeiss Axio Scan.Z1、MoticEasyScan Pro 6、Aperio GT 450 六台扫描仪。两任务划分完全对称:训练 180 张(3 个域各 60)+ 初测 20 张(4 个未见域各 5)+ 终测 90 张(6 个域各 15)。标注为病理医师手工轮廓,分割目标是"正常腺体 + 腺癌区域"的二值前景。评估指标为 0.5×Dice + 0.5×Jaccard,排名按初测 0.2、终测 0.8 加权,终测要求以 Docker 容器经 grand-challenge 平台提交且每任务仅 1 次机会。时间线上,数据集 2024-04-18 在 Zenodo 首发(v1,DOI 10.5281/zenodo.10992201),2024-05-08 官网开放注册,2024-10-06 在马拉喀什 MICCAI 2024 workshop 收官。
§1.2 战略价值分析
域泛化评测范式维度:COSAS 把"训练集只有 3 个域、测试集出现 4-6 个域"写进了数据集定义本身——这不是标注疏漏,而是把泛化能力变成被测量的对象。初测引入 4 个未见域(每域 5 张)让参赛者在校准阶段感受泛化缺口,终测 6 域(每域 15 张)给出最终排名,初测 0.2 / 终测 0.8 的权重设计既保留了调参空间又不让最终成绩被刷分污染。这一"3 域训练 → 6 域终测"的构造后来成为病理域泛化工作的标准叙事模板——冠军论文(Wilm et al., arXiv:2409.09797)与 VFM 微调方案 Rein(Cai et al., arXiv:2409.11752)的方法学章节都直接以这一设定定义问题。
扫描仪签名研究维度:6 台扫描仪横跨了主流全切片扫描仪厂商(TEKSQRAY、KFBIO、3DHISTECH、Zeiss、Motic、Leica/Aperio),且全部 patch 同为乳腺浸润性癌(NST),把"染色-扫描"变量从癌种变量中剥离出来——这正是 Task 2 的实验设计价值:跨扫描仪性能差异可以被归因到染色与成像链路,而不是器官形态。对染色归一化(Macenko、Reinhard 系)与扫描仪指纹学习的研究者,这是少数几份扫描仪元数据逐 patch 完整的公开资源。库内跨扫描仪同主题条目 MIDOG(有丝分裂检测、跨 4 台扫描仪)与本数据集构成"检测 vs 分割"的互补对。
挑战赛协议复用维度:COSAS 的完整协议链——grand-challenge.org 托管、Docker 打包提交、初测/终测双阶段、加权排名、预训练限制——是医学影像挑战赛的现行最佳实践样本。想自建病理评测平台的团队可以直接参照它的规则页结构与提交接口设计;这也是库内多条 grand-challenge 系数据集(如 MIDOG)共用的基础设施。
§1.3 同类数据集横向对比
| 数据集 | 规模 | 模态 | 标注 | 域泛化设计 | 核心差异化 |
|---|---|---|---|---|---|
| COSAS 2024(本条目) | 580 patch(双任务) | H&E patch 约 1500×1500 | 手工轮廓(腺体前景) | 显式:3 域训练 / 6 域测试,双赛道 | 首个跨器官+跨扫描仪双任务分割挑战赛 |
| GlaS | 165 张(85 训练 + 80 测试) | H&E 全切片区域 | 手工轮廓(腺体) | 无(同源划分) | 经典腺体分割基准(MICCAI 2015 挑战赛) |
| DigestPath | 多任务 thousands 级 | H&E | 混合 | 无 | 消化道病理多任务(含分割与分类) |
| CoNSeP | 38 张(27 训练 + 11 测试) | H&E 全切片区域 | 逐细胞类型实例 | 无 | 腺体+核双粒度实例分割 |
| BCSS | 20,000+ 区域 patch | H&E | 4 类组织区域 | 无 | 大规模区域语义分割(TCGA 来源) |
| MIDOG 2021/2022 | 200/500 张 WSI patch | H&E(多扫描仪) | 有丝分裂像点标注 | 显式跨扫描仪 | 跨扫描仪检测任务,与本条目互补 |
与 GlaS、CoNSeP 这类"同源划分"的经典腺体分割基准相比,COSAS 的成绩数字天然更低(冠军 0.8020 vs GlaS 上 0.9+ 的常见结果),这恰恰是它作为域泛化基准的设计意图:把虚高的同源成绩拉回真实分布转移下的水平线。
§1.4 版本时间轴
| 日期 | 事件 | 载体 |
|---|---|---|
| 2024-04-18 | 数据集 v1 在 Zenodo 发布(concept DOI 10.5281/zenodo.10992200 → 记录 10992201),12 位作者署名 | Zenodo |
| 2024-05-08 | 官网上线、注册开放 | 官网 tasks 页 |
| 2024-06-18 | 训练数据(180×2 张)发布 | Zenodo / 官网 |
| 2024-08-17 | 注册截止 | 官网 |
| 2024-08-18 | 初测数据开放(4 未见域各 5 张) | grand-challenge 平台 |
| 2024-09-05 | 初测 Docker 提交截止(每任务 5 次提交机会) | grand-challenge 平台 |
| 2024-09-06 | 终测数据开放(6 域各 15 张) | grand-challenge 平台 |
| 2024-09-08 | 终测截止(每任务 1 次提交) | grand-challenge 平台 |
| 2024-09-20 | 参赛论文 arXiv 摘要截止 | 官网 |
| 2024-10-06 | COSAS workshop(MICCAI 2024 卫星活动,Marrakech Palmeraie Palace - Opale) | 官网 |
§1.5 典型应用场景
- 域泛化分割算法基准:在"3 域训练 / 6 域测试"固定设定下对比自适应卷积(DCAC)、VFM 微调(Rein)、域分层集成(亚军方案)等方法,成绩可直接引用本条目 §8 排行榜。典型产出物:方法论文的跨域对比表与逐域失效分析。
- 染色归一化消融研究:Task 2 的 6 台扫描仪 patch 是天然的染色偏移测试床——同一癌种、扫描仪元数据齐全,可量化 Macenko/Reinhard 等方法在不同扫描仪对上的增益或反噬(见坑点 7)。典型产出物:归一化 on/off 的分设备增益矩阵。
- 预处理决策的影响评估:patch 尺寸不统一、轮廓标注栅格化、多边形嵌套等真实工程问题全部存在,适合作为数据管线教学与回归测试素材(§6.5 全部 8 个坑点)。典型产出物:栅格化引擎差异的敏感性报告。
- 挑战赛协议设计参考:双任务、双阶段、加权排名、Docker 闭门评测、预训练限制——需要组织医学影像挑战赛的团队可整套复用(§8.3)。典型产出物:自建赛事的规则页与提交接口。
- 域泛化教学案例:训练域与测试域的域分布差异清晰可见(器官/扫描仪分层),适合课堂演示"为什么随机划分会高估模型"。典型产出物:域内折 vs 域分层折的成绩对照实验(§5.4 双对照设计)。
§2 医学背景:腺癌、H&E 病理与分割任务的临床语境
§2.1 疾病标签与 ICD-11 编码映射
COSAS 2024 覆盖 6 种腺癌(Task 1 的器官轴)+ 1 个扫描仪任务专用癌种(Task 2 的乳腺浸润性癌 NST,同时也是 Task 1 的 6 种之一)。完整映射如下:
| 数据集标签 | 中文 | ICD-11(MMS) | 组织学术语注记 |
|---|---|---|---|
| Gastric adenocarcinoma | 胃腺癌 | 2B72.1 | 最常见的胃恶性肿瘤组织学类型 |
| Colorectal adenocarcinoma | 结直肠腺癌 | 2B92.0(结肠)/ 2B92.1(直肠) | 常规腺癌,分级与黏液亚型影响形态 |
| Pancreatic ductal adenocarcinoma | 胰腺导管腺癌 | 2C10.0 | PDAC,间质丰富、腺体分化差者形态多变 |
| Invasive breast carcinoma of no special type | 乳腺浸润性癌(NST) | 2C61 | WHO 乳腺肿瘤分类第 5 版的 NST 总类,即旧称浸润性导管癌 |
| Prostate adenocarcinoma | 前列腺腺癌 | 2C82 | 腺泡型腺癌为主,Gleason 分级决定形态谱 |
| Lung adenocarcinoma | 肺腺癌 | 2C25.0 | 贴壁/腺泡/乳头/微乳头/实性五型混合 |
编码按 ICD-11 MMS(Mortality and Morbidity Statistics)2024 版检索路径整理,仅供跨文献对齐使用;逐例诊断编码请以原始病理报告为准。
§2.1b SNOMED CT 映射
| 概念 | SNOMED CT | 说明 |
|---|---|---|
| Adenocarcinoma(腺癌,形态学异常) | 443961000124105 | 六种癌共用的形态学上位概念 |
| Invasive ductal carcinoma(浸润性导管癌) | 25481003 | Task 2 乳腺 NST 的传统称谓对应概念 |
| Primary malignant neoplasm of lung(肺原发恶性肿瘤) | 93880000 | 肺腺癌的部位+性质组合常用概念 |
| Malignant tumour of colon(结肠恶性肿瘤) | 363406005 | 结直肠腺癌的常用上位概念 |
SNOMED CT 列仅收录概念级常用编码;胃、胰腺、前列腺、乳腺的部位-形态组合概念层级较深,建议经 SNOMED CT Browser 逐例复核后再用于结构化编码。
§2.2 疾病简介与流行病学
腺癌(adenocarcinoma)是起源于腺体或腺样分化上皮的恶性肿瘤,也是人类癌症中最大的组织学家族:本条目涉及的 6 个器官全部位居全球恶性肿瘤发病前列。按 GLOBOCAN 2022 估计(截至 2022 年),六个器官的新发病例数与 H&E 下的形态学要点如下:
| 器官(COSAS 腺癌类型) | GLOBOCAN 2022 全球新发 | H&E 腺体形态学要点 |
|---|---|---|
| 肺(肺腺癌) | 约 248 万例 | 贴壁/腺泡/乳头/微乳头/实性五型混合,异质性最高 |
| 乳腺(浸润性癌 NST) | 约 230 万例 | 导管形态谱系宽,间质比例与核级跨度大 |
| 结直肠(结直肠腺癌) | 约 190 万例 | 腺管异型、坏死与"污秽"背景常见 |
| 前列腺(前列腺腺癌) | 约 150 万例 | Gleason 谱系,小腺体背靠背融合是关键征象 |
| 胃(胃腺癌) | 约 97 万例 | 肠型/弥漫型两极,黏液与印戒差异显著 |
| 胰腺(胰腺导管腺癌) | 约 51 万例 | PDAC 间质丰富、分化差,腺体残缺形态多变 |
病理确诊是这些癌症诊断链条的最终环节,而腺体结构识别是病理医师日常读片的核心动作:正常腺体排列有序、极性明确,腺癌则表现为腺体异型增生、背靠背共壁、筛状或实性生长,两者的计算机区分正是腺体分割任务的临床原型。
在 H&E(苏木精-伊红)染色切片上,细胞核被苏木精染成蓝紫色,胞质与间质胶原被伊红染成粉红色——这种"紫粉双色"的化学对比是一切病理图像算法的物理基础,也是本数据集所有域偏移的源头:不同扫描仪的光源、滤光片、传感器响应曲线会把同一种染色染出肉眼可辨的色差,不同器官的间质比例、炎性浸润、黏液分泌则叠加第二层形态学偏移。
§2.3 临床任务定义
COSAS 2024 的任务在临床语境下对应"腺体前景识别":给定 H&E patch,输出逐像素的二值掩模——前景 = 正常腺体 + 腺癌区域(腺体组织),背景 = 间质、血管、坏死等非腺体结构。它与三类临床工作直接相关:
- 辅助筛查/诊断:腺体形态是胃、结直肠、前列腺活检报告的核心依据,自动分割是后续分级(如 Gleason 分级、腺体结构评分)的前置步骤;
- 瘤负荷与边界测量:肿瘤区域占比与浸润前沿的定位影响治疗决策,像素级前景是量化起点;
- 工作流加速:把"逐视野找腺体"的机械劳动交给模型,病理医师聚焦异常区域判读。
需要明确边界:官方指标只考核"腺体前景"二值分割,不区分正常腺体与腺癌像素——把本数据集的结果宣传为"癌症自动诊断"超出了任务定义(见 §6.5 坑点 8 的边界讨论)。
§2.4 患者人群
| 维度 | 官方披露情况 |
|---|---|
| 来源机构 | 上海的病理机构(临床团队来自瑞金医院,合作方含 Histo Pathology Diagnostic Center) |
| 采集时间 | 未逐例披露;数据集 2024 年发布 |
| 年龄/性别分布 | 未披露 |
| 种族/地域构成 | 未披露 |
| 就医类型 | 未披露(活检/手术标本来源未逐例标注) |
| 患者级标识 | 不存在——patch 与患者之间无映射,这是使用本数据集时最重要的结构性限制(§4.4、§5.3) |
§2.5 临床价值定位
COSAS 的临床价值不在"多了一份数据",而在"多了一把跨院的尺子"。单中心病理 AI 的常见退化路径是:在自己医院的扫描仪上标定 → 精度 0.9+ → 接入外部会诊医院的片子 → 精度跳水且无人知晓。跨扫描仪赛道(Task 2)把这条退化路径显式量化:同一癌种、六台扫描仪,模型的每一个百分点波动都可归因于成像链路差异;跨器官赛道(Task 1)则覆盖了"病理亚专科组内轮转"的真实场景——一个只在胃、结直肠、胰腺标本上训练的模型,能否在乳腺、前列腺、肺的会诊片子上仍然可用,正是综合医院病理科每天面对的问题。
对不同使用者的价值锚点也不同:算法研究者拿到的是一份"域变量被官方标注齐全"的考卷,可以放心把性能差异归因到域轴上;医院工程团队拿到的是上线前的压力测试集——自己的模型在六台扫描仪的 patch 上各考一遍,薄弱设备一目了然;数据集构建者学到的是"划分即设计"的方法论——180/20/90 的域分层不是技术细节,而是数据集科学贡献的一部分。
§2.6 金标准标注描述
| 维度 | 内容 |
|---|---|
| 标注对象 | 每张 patch 的腺体前景(正常腺体 + 腺癌区域) |
| 标注方式 | 手工轮廓(contour annotations),矢量多边形,使用时栅格化为像素掩模 |
| 标注者 | 临床团队 10 人(瑞金医院病理方向,见官网 organizers 页四组架构) |
| 一致性协议 | 官方未公布逐例多标与一致性系数(如 Kappa/Dice 交叉)——这是使用时的已知盲区 |
| 标注性质 | 像素级金标准(栅格化后);仅区分前景/背景二类,不含逐像素良恶性子标签 |
§3 数据集规格
§3.0 版本抉择矩阵
| 你的需求 | 推荐资源 | 获取门槛 | 理由 |
|---|---|---|---|
| 训练自己的分割模型 | Zenodo v1(record 10992201)训练集 | Zenodo 注册 + 接受数据使用协议 | 180×2 张训练 patch 公开下载,官方指定起点 |
| 复现排行榜成绩 | Zenodo 训练集 + grand-challenge 平台 Docker 评测 | 注册账号 + Docker 打包 | 初测/终测数据闭门,只能经平台在线评测 |
| 研究冠军方法实现 | GitHub 4pygmalion/cosas(Top-10 方案,Apache-2.0) | 直接克隆 | 第三方开源完整管线(染色分离多任务 U-Net) |
| 了解赛制与规则 | 官网 tasks 页 | 直接访问 | 时间线、指标、提交限制的权威口径 |
§3.1 模态详情
单一模态:H&E 染色数字病理图像。所有数据以 patch(从全切片图像中裁出的感兴趣区域)形式发布,平均尺寸约 1500×1500 像素(注意:是均值而非统一值,逐 patch 尺寸有波动,见坑点 3)。放大倍率/MPP 逐台数值官方未完整公布——这影响把 patch 映射回统一物理尺度的精度,详见 §3.9。
§3.2 按子集样本数
两任务的划分结构完全对称,全部数字来自官网 tasks 页并与冠军论文口径互证:
Task 1(跨器官,全部 TEKSQRAY SQS-600P 扫描):
| 子集 | 样本数 | 域构成 |
|---|---|---|
| 训练集 | 180 | 胃腺癌 60 + 结直肠腺癌 60 + 胰腺导管腺癌 60 |
| 初测集 | 20 | 4 个未见器官各 5 张(官网未逐一披露器官分配细节) |
| 终测集 | 90 | 6 种腺癌各 15 张(含训练未见的前列腺腺癌、肺腺癌等) |
Task 2(跨扫描仪,全部为乳腺浸润性癌 NST):
| 子集 | 样本数 | 域构成 |
|---|---|---|
| 训练集 | 180 | 3 台扫描仪各 60 张 |
| 初测集 | 20 | 4 台扫描仪各 5 张 |
| 终测集 | 90 | 6 台扫描仪各 15 张 |
两表相加均为 180 + 20 + 90 = 290 张。注意训练集只覆盖一半的域(3/6)——这不是数据缺失,而是域泛化赛制的核心设计(§5.1)。
§3.3 数据格式
| 内容 | 形式 | 说明 |
|---|---|---|
| 病理 patch | 常规图像文件(H&E,RGB) | 平均约 1500×1500 像素;文件级格式与压缩参数以 Zenodo 记录页文件清单为准 |
| 标注 | 手工轮廓(矢量多边形) | 官方指标下需栅格化为二值前景掩模;栅格化细节见 §6.1 与坑点 8 |
| 域元数据 | 器官标签(Task 1)/ 扫描仪标签(Task 2) | 按 patch 提供,是划分与域泛化实验的关键列 |
§3.4 存储大小
官方未在可机读页面披露总大小;580 张 1500×1500 RGB patch 加标注的体积按经验在数百 MB 量级,精确值以 Zenodo 记录页文件清单为准(该页面文件列表为动态加载,抓取时点未能机读解析,已列入 §7.7 DAIMS 扣分说明)。
§3.5 标注方式
人工标注:病理临床团队逐 patch 手工勾画腺体前景轮廓。选择"轮廓多边形"而非直接输出像素掩模是病理标注工具链的常态——Annotation 工具(如 QuPath 系)输出的多边形体积小、可编辑、可嵌套(腺腔内孔洞),但也把"多边形如何变掩模"的工程决策留给了使用者(栅格化规则不同,Dice 可差 1-2 个百分点,见坑点 8)。
§3.6 标注者资质与一致性
标注由临床团队 10 人(瑞金医院,官网 organizers 页口径)完成,具备病理诊断资质。官方渠道未公布逐例标注者分配、双人独立标注比例或一致性统计——与 §2.6 相呼应,这是官方文档的已知留白,使用时建议在论文 limitation 中如实声明。
§3.7 采集周期
可确认的时间锚点全部属于"发布侧":Zenodo v1 于 2024-04-18 发布,官网 2024-05-08 上线,训练数据 2024-06-18 发布。标本采集、扫描、标注的内部周期未披露。
§3.8 地域覆盖
数据来自中国(上海地区病理机构;组织方含瑞金医院与 Histo Pathology Diagnostic Center,标注团队为瑞金医院临床团队)。官方未逐例披露标本来源医院分布。对使用者而言这意味着:跨地域(东亚人群染色与形态学特征)泛化本身构成一层未标注的潜在偏移,与扫描仪偏移叠加(§7.1)。
§3.9 设备规格
Task 1 的全部 290 张 patch 由单一扫描仪完成;Task 2 的 290 张 patch 由六台扫描仪构成,逐台清单如下(官方 tasks 页口径):
| # | 扫描仪 | 厂商 | 角色定位 |
|---|---|---|---|
| 1 | TEKSQRAY SQS-600P | TEKSQRAY | Task 1 唯一扫描仪;Task 2 六分之一 |
| 2 | KF-PRO-400 | KFBIO | 国产数字化病理扫描仪 |
| 3 | PANNORAMIC 1000 | 3DHISTECH | 欧洲主流科研级扫描仪 |
| 4 | Axio Scan.Z1 | Zeiss | 老牌显微镜厂商旗舰扫描仪 |
| 5 | MoticEasyScan Pro 6 | Motic | 国产中端扫描仪 |
| 6 | Aperio GT 450 | Leica Biosystems | 欧美临床部署量最大的扫描仪系列之一 |
各扫描仪逐台的 MPP/放大倍率数值官方未完整列表(待核项,见 FACTS 存照);这意味着跨扫描仪实验中"物理尺度对齐"需要使用者自行核验或按均值假设处理。
设备的实践含义值得展开:六台设备的色彩链路差异不止"色偏"一层——光源类型、滤光片镀膜、传感器 Bayer 阵列与出厂 ICC 配置共同决定了同一 H&E 染色的 RGB 投影;扫描分辨率与压缩管线则决定纹理细节的保留程度。Task 2 把这些变量整体打包成"扫描仪签名",对使用者既是资源(现成的跨设备考卷)也是负担(无法把色彩差异与分辨率差异解耦归因)——设计归因实验时,建议把"染色归一化能消除的部分"与"残余差异"分开报告(坑点 7 的消融思路)。
§3.10 深度溯源链
从像素到论文的完整溯源链:切片(上海病理机构 H&E 切片)→ 扫描(六台扫描仪之一,Task 1 全部 TEKSQRAY SQS-600P)→ patch 化(约 1500×1500 像素 ROI 裁剪,规则未公布)→ 人工轮廓标注(瑞金医院临床团队 10 人)→ 任务划分(180/20/90,按域分层)→ 发布(Zenodo v1 记录 10992201,2024-04-18,12 位作者署名;训练集 2024-06-18 随赛程发布)→ 评测(grand-challenge 平台闭门初测/终测)。链条中"patch 化规则"与"切片-患者对应关系"两环官方未披露,构成溯源链的两处缺口(对应 §7.1 偏倚表与 §5.3 泄漏讨论)。
§4 数据结构
§4.0 目录树
官方渠道(官网与 Zenodo 记录页文本)未公布逐文件目录树快照;以下为按官方发布物描述(两任务、三子集、patch+轮廓标注、域元数据)重构的预期本地组织布局,供规划数据管线使用——实际文件名与嵌套层次以解压后的 Zenodo 包为准:
data_root/
├── task1_cross_organ/
│   ├── train/                     # 180 张(胃/结直肠/胰腺各 60)
│   │   ├── images/                # H&E patch(约 1500×1500,尺寸不统一)
│   │   └── annotations/           # 腺体前景轮廓(栅格化后为二值掩模)
│   ├── initial_test/              # 20 张(4 个未见器官各 5)——竞赛闭门
│   └── final_test/                # 90 张(6 种腺癌各 15)——竞赛闭门
├── task2_cross_scanner/
│   ├── train/                     # 180 张(3 台扫描仪各 60)
│   │   ├── images/
│   │   └── annotations/
│   ├── initial_test/              # 20 张(4 台未见扫描仪各 5)——竞赛闭门
│   └── final_test/                # 90 张(6 台扫描仪各 15)——竞赛闭门
└── meta/
    ├── organ_labels.csv           # Task 1 逐 patch 器官标签(按官方元数据自建索引)
    └── scanner_labels.csv         # Task 2 逐 patch 扫描仪标签
提示:
images/与annotations/的文件名对应关系、标注文件的格式(JSON 轮廓还是掩模图)均以 Zenodo 包实际内容为准;接入自建管线前先跑一遍 §6.1 的完整性检查代码。
§4.1 DAIMS 数据字段字典
| 字段名 | 类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 信息性缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
| patch_id | 文本 | patch 唯一文件名(无患者 ID) | task1_train_0001 |
样本主键 | 无 | 不适用 | 每任务 290 个唯一值 |
| image | 图像 | H&E patch,RGB | 1500×1500×3 | 模型输入 | 扫描仪色彩响应差异(域偏移源) | 不适用 | 尺寸逐 patch 波动 |
| annotation | 掩模 | 腺体前景轮廓(栅格化后二值) | {0,1} 矩阵 |
分割目标 | 栅格化规则引入 1-2 个百分点级差异 | 不适用 | 前景占比逐图波动 |
| organ_label | 文本 | Task 1 器官标签 | gastric |
域泛化分组 | 无 | 官方未披露初测器官逐张分配 | 6 种腺癌 |
| scanner_label | 文本 | Task 2 扫描仪标签 | PANNORAMIC_1000 |
域泛化分组 | 无 | 不适用 | 6 台扫描仪 |
| split | 文本 | 子集归属 | train |
划分复现 | 无 | 不适用 | train/initial_test/final_test |
| patient_id | — | 不存在 | — | — | — | 结构性缺失:patch-患者无映射 | 无法构建 |
最后一行是本数据集最关键的"负字段":患者级标识的缺失不是缺了几个值,而是整个患者维度不存在(§4.4、§5.3)。
§4.2 标签分布
域分布(设计均衡):Task 1 训练集三器官各 60 张、终测六腺癌各 15 张;Task 2 三台训练扫描仪各 60 张、终测六台各 15 张——官方刻意按域均衡,不反映真实临床流行率(胃/结直肠远比胰腺常见)。
前景占比:官方未公布逐 patch 腺体前景占比统计。病理腺体分割的一般规律是间质占比高、前景常低于 50%,但这属于经验值而非本数据集实测——建议拿到训练集后第一件事是跑 §6.1 的前景占比直方图,它直接决定损失函数选择(是否需要 Dice/BCE 混合)与阈值后处理。
§4.3 关键统计
| 统计项 | 数值 | 口径 |
|---|---|---|
| patch 总数 | 580(Task 1 290 + Task 2 290) | 官网 tasks 页 |
| patch 尺寸 | 平均约 1500×1500 像素(非统一) | 官网/冠军论文口径 |
| 每任务子集 | 180 / 20 / 90 | 官网 tasks 页 |
| Task 1 扫描仪 | 1 台(TEKSQRAY SQS-600P) | 官网 |
| Task 2 扫描仪 | 6 台(§3.9 清单) | 官网 |
| 腺癌种类 | 6 种(Task 1)+ 1 种(Task 2 复用乳腺 NST) | 官网 |
| 类别数(分割目标) | 2(前景腺体 / 背景) | 官网任务定义 |
| 患者数 | 未披露(无患者映射) | 结构性缺失 |
§4.4 数据层级
(患者层——不存在)
  └─ 切片层(WSI,扫描仪/器官归属已知,切片 ID 未披露)
       └─ patch 层(580 张,唯一公开标识层级)
            └─ 像素层(前景/背景二值标注)
层级缺失的含义:同一 patch 集内可能存在"同切片邻居 patch"甚至"同患者多 patch",官方未提供任何阻断手段——按 patch 随机划分会把近似重复样本分进训练与测试两侧。官方自己的划分是按域分层而非按 patch 随机(§5.1),社区复现实验时应沿用同样的域分层逻辑。
§4.5 缺失值与信息性缺失
| 缺失类型 | 位置 | 性质 | 处理建议 |
|---|---|---|---|
| 患者级元数据 | 全数据集 | 结构性缺失(从未采集) | 承认并声明;不做患者级结论 |
| 初测逐张器官/扫描仪分配 | initial_test | 未披露(仅知每域 5 张) | 初测阶段无法做逐域分析,属赛制保密设计 |
| 逐台扫描仪 MPP | Task 2 | 未完整披露 | 按 §3.9 说明处理;跨台物理对齐需自核 |
| patch 像素前景占比 | 全数据集 | 未统计 | 下载后自测(§6.1) |
| 像素级缺失值 | 不存在 | H&E 图像无 NaN 概念 | 不适用 |
本数据集没有"信息性缺失编码"问题(图像不含 NaN 类缺失标记语义),真正的缺失治理发生在元数据层——把"哪些信息官方从未提供"写进你的实验 limitation,是使用这份数据的基本功。
§4.6 与库内相邻条目的结构对照
同为病理图像数据集,COSAS 的"结构风格"与库内邻居各有取舍——对照表帮助你在选型时快速判断哪份数据的结构假设与你的任务匹配:
| 条目 | 标识层级 | 标注形态 | 域元数据 | 与 COSAS 的关键结构差异 |
|---|---|---|---|---|
| COSAS 2024 | patch 级 | 手工轮廓(前景二类) | 器官/扫描仪逐 patch | 无患者/切片层,域轴是设计核心 |
| GlaS | 图像级(整张区域) | 掩模 | 无显式域轴 | COSAS 的"前身语境",划分同源 |
| CoNSeP | 区域级(27+11 张大图) | 逐细胞实例 | 无 | 粒度更细但规模小一个量级 |
| BCSS | patch 级(20,000+) | 四类语义掩模 | 来源项目(TCGA) | 有语义细分、无跨扫描仪轴 |
| MIDOG | WSI patch 级 | 有丝分裂像点标注 | 扫描仪逐 patch | 同为跨扫描仪设计,任务是检测不是分割 |
| MoNuSAC | 细胞核实例 | 实例掩模 | 器官多中心 | 多器官但无"训练/测试域切开"设计 |
§5 数据划分与使用建议
§5.1 官方划分
官方划分是域分层而非样本随机:训练集 3 域各 60 张,初测 4 个未见域各 5 张,终测 6 域各 15 张。这个结构的实验学含义有两层:其一,训练阶段模型从未见过初测/终测的至少一半域——这正是"域泛化"的定义场景,任何在训练域内部做的交叉验证成绩都会系统性高估终测表现;其二,初测 4 域与终测 6 域的关系是"超集"(终测域包含训练 3 域 + 至少 3 个全新域),意味着模型在初测时就要面对"半个训练域 + 一半陌生域"的混合考卷。
§5.2 社区惯例划分
社区复现实验的主流做法沿用亚军方案(Domain-stratified 方案)的思路:在训练 180 张上做域分层三折交叉验证——每折留出一个训练域作为内部验证域,另两域训练。这能把"跨域成绩"的方差测出来,代价是每折训练数据只剩 120 张。第二名方案同时使用 512×512 裁剪 + 50% 重叠滑窗扩充有效样本量,是数据受限条件下的常用补偿。
§5.3 泄漏风险 ⚠️
- 同源 patch 泄漏:无患者/切片映射(§4.4),训练与测试 patch 可能来自同一 WSI。官方域分层设计已把风险压到最低(测试集以未见域为主),但社区自制随机划分会重新引入该风险——永远按域分层划分,不要按 patch 随机划分。
- Transductive 归一化泄漏:把初测/终测图像的染色统计量(均值/协方差、Macenko 参数)混入训练期归一化流水线,等于让模型窥见测试域分布。正确姿势:归一化参数只从训练域估计,测试域图像使用训练期参数或逐图独立估计(见坑点 7)。
- 排行榜后验泄漏:初测每任务 5 次提交机会允许参赛者用初测成绩做模型选择——这是赛制允许的选择压力,但意味着初测成绩对算法真实泛化能力偏乐观;终测仅 1 次提交的设计正是为了截断这条泄漏链。自己复现实验时,请把"模型选择发生在哪个集合上"写清楚。
§5.4 交叉验证建议
训练集内推荐域分层三折(§5.2);若算力允许,可加"域内三折"作为对照——域内折代表传统同源划分,域分层折代表域泛化,两者之差就是你的模型在安全条件下的"域脆弱性读数"。这个双对照设计成本低(共用同一份训练数据),信息量高。
§5.5 外部验证建议
推荐把 COSAS 训练模型迁移到库内同模态数据集做外部验证:GlaS(腺体分割同任务、不同采集源)、DigestPath(消化道病理)、BCSS(大规模区域分割)、CoNSeP(实例分割)。反向迁移(在 GlaS 训练、在 COSAS 测试)同样有价值——能回答"GlaS 时代的腺体模型面对六台扫描仪还剩多少性能"。迁移时注意标注口径对齐:GlaS 与 COSAS 同为腺体前景分割,兼容度高;BCSS 是四类组织语义,需做前景重映射。
§5.6 划分决策速查
| 你在做的事 | 应采用的划分 | 禁忌 |
|---|---|---|
| 复现官方排行榜 | 训练 180 张全量训练,初测/终测经平台评测 | 初测成绩当终测预测(初测偏乐观,§5.3) |
| 论文自评(无平台权限) | 域分层三折(每折留一个训练域) | 按 patch 随机划分(同源泄漏,§5.3) |
| 方法消融 | 域分层三折 + 固定随机种子 | 用测试折反复调参(选择泄漏) |
| 模型选择 | 域分层折内的验证域 | 用终测/初测做模型选择 |
| 染色/预处理研究 | 折内消融 + 域级分解报告(§7.3) | 全局归一化参数含测试域(坑点 7) |
| 发表声明 | 报告折间方差与 held-out 域名 | 只报均值不报域构成 |
§6 AI 就绪指南 ⭐
§6.0 云端快速启动
COSAS 数据无 HuggingFace 镜像、无云平台一键加载器,云端起步路径是:Colab/Kaggle 环境 + Zenodo 手动下载 + 挂载本地路径。没有"三行代码加载"的捷径——这本身就是本数据集 AI 就绪度评分为 3/5 的原因之一(§7.7)。
§6.1 快速上手:读取、栅格化与完整性体检
# ═══════════════════════════════════════════════════════════════
# COSAS 2024 快速上手:patch 读取 + 轮廓栅格化 + 数据完整性体检
# ----------------------------------------------------------------
# 前提:从 Zenodo(https://zenodo.org/records/10992201)下载训练集
#   并解压到 data_root/(目录结构预期见 §4.0)。
# data_root 拼接关系:data_root + task 名 + 子集名 + images/annotations
# 最小可用子集:任一任务的 train/(180 张)即可跑通全流程;
#   初测/终测数据为竞赛闭门资源,本地实验只用 train。
# ═══════════════════════════════════════════════════════════════
import numpy as np
import cv2
from pathlib import Path
from collections import Counter

DATA_ROOT = Path("data_root/task1_cross_organ/train")

def load_pair(patch_path: Path, mask_path: Path):
    """读取一张 patch 与其轮廓标注,栅格化为二值前景掩模。"""
    img = cv2.cvtColor(cv2.imread(str(patch_path)), cv2.COLOR_BGR2RGB)
    # 轮廓文件若为掩模图,直接二值化;若为多边形(JSON/YAML),
    # 先解析为 np.int32 顶点列表再用 cv2.fillPoly 填充(见坑点 8)。
    raw = cv2.imread(str(mask_path), cv2.IMREAD_GRAYSCALE)
    mask = (raw > 127).astype(np.uint8)          # 前景=腺体(正常+腺癌)
    return img, mask

def integrity_check(data_root: Path):
    """拿到数据后的第一件事:完整性体检(对应 §4.2/§4.5 留白项)。"""
    imgs = sorted((data_root / "images").glob("*"))
    anns = sorted((data_root / "annotations").glob("*"))
    print(f"[1] 数量对齐: images={len(imgs)}, annotations={len(anns)}")
    assert len(imgs) == len(anns) == 180, "训练集应为 180 对文件"

    sizes, fg_ratios = [], []
    for ip, ap in zip(imgs, anns):
        img, mask = load_pair(ip, ap)
        sizes.append(img.shape[:2])
        fg_ratios.append(mask.mean())
    print(f"[2] 尺寸分布: min={min(sizes)}, max={max(sizes)}, "
          f"unique={len(set(sizes))}  ← 验证'非统一尺寸'(坑点 3)")
    fg = np.array(fg_ratios)
    print(f"[3] 前景占比: mean={fg.mean():.3f}, "
          f"p10={np.percentile(fg,10):.3f}, p90={np.percentile(fg,90):.3f}")
    print(f"[4] 空标注图数: {(fg == 0).sum()}  ← 若>0 需复核栅格化(坑点 8)")

if __name__ == "__main__":
    integrity_check(DATA_ROOT)
§6.2 数据获取
| 步骤 | 操作 | 说明 |
|---|---|---|
| 1 | 访问 Zenodo 记录 10992201 | concept DOI 10.5281/zenodo.10992200 当前解析到 v1 |
| 2 | 登录/注册 Zenodo 账号 | 训练数据下载需注册并接受数据使用协议 |
| 3 | 下载训练数据包(180×2 张,2024-06-18 发布) | 文件清单与总大小以记录页为准(动态加载) |
| 4 | 解压并跑 §6.1 体检脚本 | 核对 180 对图像-标注、尺寸分布 |
| 5 | 初测/终测 | 竞赛闭门资源,经 grand-challenge 平台在线评测,本地不可得 |
# 用 Zenodo API 查看记录 10992201 的权威文件清单(文件名、数量与大小的唯一来源;
# 若下载需登录确认协议,先在浏览器完成一次注册-接受流程):
curl -s "https://zenodo.org/api/records/10992201" | python3 -c \
  "import json,sys; [print(f['key'], f['size']) for f in json.load(sys.stdin).get('files', [])]"
§6.3 预处理全流程
从原始 patch 到可训练张量的四步流水线:
# ═══════════════════════════════════════════════════════════════
# 步骤 1 尺寸统一:COSAS patch 平均 1500×1500 但尺寸不统一(坑点 3)。
#   策略 A:整图 resize 到 1024×1024(简单,损失细节);
#   策略 B:512×512 滑窗裁剪 + 50% 重叠(亚军方案路线,训练时还原)。
# 步骤 2 染色归一化:跨扫描仪任务的核心预处理(坑点 7 讲反噬面)。
# 步骤 3 标注对齐:resize 图像时必须同步用最近邻插值 resize 掩模。
# 步骤 4 强度标准化:仅用训练集估计均值/方差(坑点 7 的泄漏红线)。
# ═══════════════════════════════════════════════════════════════
import numpy as np
import cv2

def normalize_size(img: np.ndarray, mask: np.ndarray, size: int = 1024):
    """双线性缩放图像 + 最近邻缩放掩模,保持标注对齐。"""
    img_r = cv2.resize(img, (size, size), interpolation=cv2.INTER_LINEAR)
    mask_r = cv2.resize(mask, (size, size), interpolation=cv2.INTER_NEAREST)
    return img_r, mask_r

def macenko_reference(img: np.ndarray,
                      alpha: int = 1, beta: float = 0.15):
    """Macenko 染色分解:估计该图 OD 空间的 H&E 主成分角。
    返回 (stain_matrix, max_concentrations)——注意参数只能从
    训练集估计并复用到测试集(transductive 泄漏红线,坑点 7)。"""
    od = -np.log((img.reshape(-1, 3).astype(float) + 1) / 256)
    od_hat = od[(od > beta).all(axis=1)]
    _, _, v = np.linalg.svd(od_hat, full_matrices=False)
    plane = v[:2].T
    proj = od_hat @ plane
    phi = np.arctan2(proj[:, 1], proj[:, 0])
    min_phi, max_phi = np.percentile(phi, alpha), np.percentile(phi, 100 - alpha)
    v_min, v_max = plane @ [np.cos(min_phi), np.sin(min_phi)], \
                   plane @ [np.cos(max_phi), np.sin(max_phi)]
    stain = np.stack([v_min, v_max], axis=1)
    if stain[0, 0] > stain[0, 1]:                 # 保证列序 = (H, E)
        stain = stain[:, ::-1]
    conc = od_hat @ np.linalg.pinv(stain)
    return stain, conc.max(axis=0)

def standardize(img: np.ndarray, mean, std):
    """仅使用训练集统计量做标准化——测试集一律复用 (mean, std)。"""
    return (img.astype(np.float32) / 255.0 - mean) / std
§6.4 PyTorch Dataset 完整代码
# ═══════════════════════════════════════════════════════════════
# COSAS Task 1 训练用 PyTorch Dataset(可运行骨架)
# 目录预期:DATA_ROOT/{images,annotations},文件名一一对应。
# 设计要点:
#   1) 尺寸不统一 → 在 __getitem__ 内统一到 (size, size)(坑点 3);
#   2) 标注为轮廓 → 读取时栅格化,注意空轮廓保护(坑点 8);
#   3) 归一化参数全局只算一次并缓存(坑点 7 的泄漏红线)。
# ═══════════════════════════════════════════════════════════════
import numpy as np
import cv2
import torch
from torch.utils.data import Dataset, DataLoader
from pathlib import Path

class CosasSegmentationDataset(Dataset):
    def __init__(self, root: str, size: int = 1024, train: bool = True):
        self.root = Path(root)
        self.size = size
        self.train = train
        self.imgs = sorted((self.root / "images").glob("*"))
        self.anns = sorted((self.root / "annotations").glob("*"))
        assert len(self.imgs) == len(self.anns), "图像-标注数量不对齐"
        # 训练集强度统计:实例化时抽样实测(H&E 无固定真值,必须按本包数据计算)
        self.mean, self.std = self._estimate_stats(sample_n=20)

    def _estimate_stats(self, sample_n: int = 20):
        """在训练集上抽样估计逐通道均值/标准差(结果应缓存复用,
        并同步用于测试集——跨集共用参数是 §6.5 坑点 7 的红线)。"""
        rng = np.random.default_rng(0)
        picks = rng.choice(len(self.imgs), size=min(sample_n, len(self.imgs)), replace=False)
        acc = []
        for i in picks:
            img = cv2.cvtColor(cv2.imread(str(self.imgs[i])), cv2.COLOR_BGR2RGB)
            acc.append((img.astype(np.float32) / 255.0).reshape(-1, 3))
        allpx = np.concatenate(acc, axis=0)
        return allpx.mean(axis=0).astype(np.float32), allpx.std(axis=0).astype(np.float32)

    def _rasterize(self, ann_path: Path) -> np.ndarray:
        """轮廓 → 二值掩模。掩模图直接二值化;多边形用 fillPoly。"""
        raw = cv2.imread(str(ann_path), cv2.IMREAD_GRAYSCALE)
        if raw is None:                              # 轮廓为矢量文件的分支
            import json
            polys = json.loads(ann_path.read_text())
            canvas = np.zeros((self.size, self.size), np.uint8)
            for poly in polys:
                pts = np.array(poly, np.int32)
                cv2.fillPoly(canvas, [pts], 1)
            return canvas
        return (raw > 127).astype(np.uint8)

    def __len__(self):
        return len(self.imgs)

    def __getitem__(self, idx: int):
        img = cv2.cvtColor(cv2.imread(str(self.imgs[idx])), cv2.COLOR_BGR2RGB)
        mask = self._rasterize(self.anns[idx])
        img, mask = normalize_size(img, mask, self.size)      # 坑点 3
        if self.train:                                        # 安全增强见 §6.6
            if np.random.rand() < 0.5:
                img, mask = img[:, ::-1], mask[:, ::-1]       # 水平翻转
            if np.random.rand() < 0.5:
                img, mask = np.rot90(img), np.rot90(mask)     # 旋转 90°
        img_t = torch.from_numpy(
            ((img.astype(np.float32) / 255.0) - self.mean) / self.std
        ).permute(2, 0, 1)
        mask_t = torch.from_numpy(np.ascontiguousarray(mask)).long()
        return img_t, mask_t

# DataLoader 实例化(num_workers 按机器调整)
if __name__ == "__main__":
    ds = CosasSegmentationDataset("data_root/task1_cross_organ/train", size=1024)
    loader = DataLoader(ds, batch_size=4, shuffle=True, num_workers=4, pin_memory=True)
    imgs, masks = next(iter(loader))
    print(imgs.shape, masks.shape, masks.float().mean().item())
§6.5 八个坑点
⚠️ 坑点 1:Zenodo 早期宣传口径与正式口径冲突——别把"800+ patch"写进论文(分类:工程陷阱)
问题:Zenodo v1 记录(2024-04-18 发布)的描述文字写的是"800+ patches、5 种腺癌、5 种扫描仪",而正式赛制口径是"Task 1 290 张 6 种腺癌 + Task 2 290 张 6 台扫描仪"。早期描述早于任务定义定稿,是遗留的宣传文案。直接从 Zenodo 描述复制数字进论文/报告,会与官网、冠军论文全部对不上。
症状:审稿人质疑"你的数据集规模和官方论文不一致";或复现对比时发现自己"下载数量"与引文数量差一个量级。
解决:
- 简单方法:一律以官网 tasks 页与冠军论文(arXiv:2409.09797)的 290×2 / 6 种 / 6 台口径为准;
- 进阶方法:在文中引用数字处标注口径来源(“official challenge page” vs “Zenodo record description”),双口径并存时显式说明时间线(早期 4 月文案 → 正式 5 月赛制定稿);
- SOTA 方法:写一条自动化校验——把引用的规模数字与官网抓取文本做正则比对,避免手抄错误进入稿件。
⚠️ 坑点 2:把域内交叉验证成绩当成排行榜成绩(分类:偏倚陷阱)
问题:训练集只有 3 个域(器官或扫描仪),而终测有 6 个域。在训练域内部做随机五折交叉验证,测的是"同域泛化",成绩会系统性高于官方"跨域终测"——两者可差 5-15 个百分点。拿域内 CV 成绩对标排行榜(0.8020/0.8527)是无效比较,拿它向导师/团队汇报"已达 SOTA"则更危险。
症状:本地 CV 成绩 0.90+,官方初测一跑掉到 0.7x;或复现论文时"怎么都达不到论文里的低分"(其实论文成绩低是因为跨域,你的高是因为同域)。
解决:
- 简单方法:所有自评实验一律用域分层三折(每折留一个训练域做验证),杜绝随机划分(§5.2);
- 进阶方法:同时跑"域内折"与"域分层折"两组对照,把差值报告为域脆弱性读数(§5.4);
- SOTA 方法:按亚军方案构造 512×512 滑窗 + 50% 重叠的域分层协议,并在论文表格中显式列出每折的 held-out 域名,让读者能判断比较是否公平。
参考:§5.2-5.3;arXiv:2409.09797(域泛化设定的原始定义)
⚠️ 坑点 3:patch 尺寸非统一——np.stack 直接崩溃与掩模插值污染(分类:预处理陷阱)
问题:"约 1500×1500"是均值不是规格,逐 patch 尺寸有波动。DataLoader 里
torch.stack(batch)会因尺寸不一致抛错;更隐蔽的是 resize 掩模时误用双线性插值,输出 0.37、0.82 这类中间值,把二值分割变成回归任务。症状:训练几个 batch 后报
stack expects each tensor to be equal size;或训练收敛但验证 Dice 异常低、预测图出现灰边。解决:
- 简单方法:图像用
cv2.resize(INTER_LINEAR)、掩模用cv2.resize(INTER_NEAREST),统一到固定尺寸(§6.3 的normalize_size);- 进阶方法:改用滑窗裁剪(512×512、50% 重叠),训练时随机取窗、推理时拼回全图——保细节且顺带扩充样本量(亚军方案路线);
- SOTA 方法:nnU-Net 自带尺寸自适应管线(按数据集统计自动定 spacing 与 patch size),把 COSAS 交给 nnU-Net 格式转换器处理,人工只复核掩模插值方式。
参考:§6.1 体检脚本第 [2] 项;nnU-Net 文档 dataset conversion 一节
⚠️ 坑点 4:预训练限制条款——病理基础模型权重是违规起跑线(分类:评估误用)
问题:官方规则明令预训练仅限 ImageNet / MS COCO 等非医学数据。2024 年赛道上 tempting 的捷径——UNI、CONCH、PathChat 等病理视觉-语言模型的权重——全部踩线。使用即取消成绩或除名;同理,把排行榜成绩与"用了病理 VFM"的复现混排也是评估误用。
症状:方案在 workshop 摘要阶段被问"backbone 权重来自哪里";或自己的复现比排行榜高出一截却解释不了——大概率是预训练来源不对等。
解决:
- 简单方法:骨干网络只用 ImageNet-1k/21k 预训练权重(torchvision、timm 直接下载即合规);
- 进阶方法:想要"基础模型红利"又不越线,走 Rein 路线——DINOv2/ConvNeXt 的 ImageNet 预训练 + 可学习 token 的输出适配(arXiv:2409.11752),Task 1 初测 0.7719 证明了这条路的天花板;
- SOTA 方法:冠军 DCAC 路线——在合规 nnU-Net(ImageNet 语义)上叠加域自适应卷积,把"模型容量"换成"架构自由度"(§8.1)。
参考:官网 tasks 页规则区;arXiv:2409.11752;arXiv:2409.09797
⚠️ 坑点 5:合成指标与加权排名——两个 0.8 不等于排行榜上的 0.8(分类:评估误用)
问题:官方每图分数 = 0.5×Dice + 0.5×Jaccard,总排名 = 0.2×初测 + 0.8×终测。任何"只报 Dice"或"只报终测"的数字都无法直接对标排行榜;且 Jaccard 恒不高于 Dice(Jaccard = Dice/(2−Dice)),混报会引入系统性偏差。
症状:算出 Dice 0.82 就宣称"超过冠军 0.8527"(其实是拿自己的单指标比人家的合成指标);两篇论文的"0.79"对不上号,因为一个是纯 Dice 一个是合成分。
解决:
- 简单方法:评估代码同时输出 Dice、Jaccard 与合成分三列,报告时指明用哪列(§6.9 代码);
- 进阶方法:复现排行榜时按官方公式聚合——先逐图合成、再按任务平均、最后 0.2/0.8 加权;
- SOTA 方法:做逐域(逐器官/逐扫描仪)分解报告——总分掩盖"某一台扫描仪上崩盘"的失败模式,而那正是域泛化研究最关心的信号(§7.3)。
参考:官网 tasks 页评估规则;arXiv:2409.09797(指标定义与成绩)
⚠️ 坑点 6:终测只有 1 次提交且必须 Docker——本地分数不等于平台分数(分类:工程陷阱)
问题:终测每任务 1 次机会、经 grand-challenge 平台跑 Docker 容器评测。本地 PyTorch 环境与容器环境的任何差异(OpenCV 版本、插值实现、随机种子、GPU 架构的卷积数值差)都会让平台分数偏离本地验证;一次手滑(错误模型权重、错误预处理分支)即烧掉唯一机会。
症状:本地 0.83、平台 0.79;或容器在平台上报
permission denied/算法接口超时——普遍原因是容器内模型文件路径或输入输出接口与平台算法模板不符。解决:
- 简单方法:用初测阶段(每任务 5 次)完整走一遍"打包→上传→平台出分"流程,把基础设施问题在初测清零;
- 进阶方法:容器内锁定全部依赖版本(
pip freeze固化 + 固定opencv-python-headless版本),推理代码禁用任何随机性(确定性开关 + 单进程);- SOTA 方法:本地复刻平台的评测容器(grand-challenge 提供算法模板),用训练集里自留的验证折做端到端演练,终测提交前做"双人复核清单"(权重哈希、预处理分支、指标输出格式)。
参考:grand-challenge.org 算法提交文档;官网 tasks 页提交规则
⚠️ 坑点 7:染色归一化的双刃剑——跨扫描仪任务的核心红线(分类:预处理陷阱)
问题:染色归一化(Macenko/Reinhard 系)是病理域偏移的标准武器,但两个反直觉陷阱并存:其一,若归一化参数从全体数据(含测试域)估计,就是 transductive 泄漏——跨扫描仪成绩虚高且不可部署;其二,把测试图强行拉到训练域染色,可能抹掉扫描仪签名中携带的真实形态线索,Task 2 上反而掉分。
症状:加归一化后本地跨域成绩大涨、感觉"好得不真实"(泄漏);或 Task 2 初测反而低于不加归一化的基线(过强归一化)。
解决:
- 简单方法:归一化参数只从训练 180 张估计,逐图独立归一化到训练域参考(不用测试集全局统计);
- 进阶方法:做归一化 on/off 消融——在域分层验证折上分别量化 Task 1(同扫描仪跨器官)与 Task 2(同器官跨扫描仪)的增益方向,按任务决定是否启用;
- SOTA 方法:冠军 Top-10 方案的思路反向利用染色——把 H&E 染色矩阵/浓度作为显式多任务输出(染色分离双解码器 U-Net,EfficientNet-B7 骨干,开源见 github.com/4pygmalion/cosas,Apache-2.0),让网络自己学"染色-结构"解耦而非人工归一化。
⚠️ 坑点 8:轮廓栅格化不是无损转换——多边形嵌套与引擎差异会吃掉 1-2 个百分点(分类:标签理解)
问题:官方标注是矢量轮廓,使用时必须栅格化。三个变量都会改变最终掩模:栅格化引擎(cv2.fillPoly 与 PIL/rasterio 的像素中心判定不同)、多边形嵌套语义(腺腔是"洞",外轮廓减内轮廓还是取并集)、共享边界处理(相邻腺体的边界像素归谁)。官方未公布权威栅格化脚本,因此任何人复现的"真值"都与官方评测用掩模有微小出入。
症状:同一模型同一权重,掩模读法不同 Dice 差 1-2 个百分点;预测边缘锯齿与真值边界错位半像素;嵌套处理错了出现"实心腺体"(腺腔被填充为前景)。
解决:
- 简单方法:全管线固定一种栅格化器(如 cv2.fillPoly),训练与评估严格一致——自比较实验内部自洽;
- 进阶方法:嵌套轮廓用"外环填充 + 内环挖空"两级处理(
fillPoly外环后fillPoly内环置 0),并在 §6.1 体检里检查前景占比是否符合病理常识;- SOTA 方法:把栅格化不确定性显式纳入评估——对同一批轮廓用两种引擎栅格化得到掩模对,报告模型在这对真值上的分数区间而非单点,这是发表级严谨度。
参考:OpenCV
fillPoly文档;QuPath contour 导出语义讨论
§6.6 数据增强:安全与危险清单
| 增强 | 判定 | 理由 |
|---|---|---|
| 水平/垂直翻转、90° 旋转 | ✅ 安全 | 病理形态无方向先验,标准操作 |
| 小角度旋转 ±15°、平移 ≤10% | ✅ 安全 | 模拟 ROI 裁剪的位置抖动 |
| 亮度/对比度小幅扰动(±10%) | ✅ 安全 | 模拟染色批间差异,与任务动机一致 |
| 逐图随机 Macenko 归一化(参数仅来自训练域) | ✅ 安全(合规前提下) | 等效染色域随机化,Task 2 常见增益来源 |
| HED 通道随机缩放(H 或 E 浓度 ×0.8-1.2) | ✅ 安全 | 直接在染色空间做增强,比 RGB 抖动更贴物理 |
| 用测试集统计拟合归一化/增强参数 | ❌ 危险 | transductive 泄漏(坑点 7) |
| 强弹性形变(α 大) | ❌ 危险 | 腺体结构(腺腔-核极性)是判别核心,大幅形变制造物理不可能形态 |
| 灰度化/通道丢弃 | ❌ 危险 | H&E 双染色的色相对比就是任务信号本身,丢弃等于自残 |
| 放大倍率剧烈缩放(<0.5× 或 >2×) | ❌ 危险 | 腺体判读高度依赖尺度一致性,MPP 未披露时更不可控(§3.9) |
§6.7 模型推荐
| 模型 | 预训练合规性 | 上榜证据 | 适用场景 | 备注 |
|---|---|---|---|---|
| nnU-Net(ImageNet 语义) | ✅ 合规 | 冠军 DCAC 的骨架 | 首选起点 | 自带尺寸自适应与训练配方 |
| nnU-Net + DAC/CAC | ✅ 合规 | 冠军方案本体(0.8020/0.8527) | 冲榜/复现 | 域预测选滤波器组 + 内容自适应动态滤波 |
| UperNet + VAN(LKA) | ✅ 合规 | 亚军方案(域分层三折 + 滑窗) | 域分层集成 | 大核注意力擅长腺体尺度结构 |
| ConvNeXt-L 编码器 + 轻量解码头 | ✅ 合规(ImageNet) | Rein 方案 Task1 0.7719(初测) | VFM 微调路线 | 可学习 token 适配,训练开销低 |
| DINOv2-B + Rein 适配 | ✅ 合规(非医学预训练) | Rein 方案 Task2 0.8848(初测) | 跨扫描仪赛道 | 自监督特征对染色偏移较稳 |
| EfficientNet-B7 多任务 U-Net | ✅ 合规 | Top-10 开源方案(内部 Dice 0.898) | 想要可运行参考代码 | 染色矩阵/密度双解码器,Apache-2.0 |
| UNI / CONCH / PathChat 等病理 VFM | ❌ 违规 | — | 禁用(本赛事语境) | 坑点 4;仅可用于自建协议的新研究 |
§6.8 硬件需求
| 阶段 | 显存 | 实测基准 | 说明 |
|---|---|---|---|
| 单图推理/体检 | 4 GB | 任意入门 GPU | §6.1 体检脚本 CPU 即可 |
| 1024×1024 训练(batch 4,U-Net 级) | 11-16 GB | RTX 3090/4090、V100 | 主流复现配置 |
| 512×512 滑窗 + 域分层三折(亚军路线) | 24 GB+ | A100/A6000 | 三折 × 滑窗样本量大,训练时长数倍 |
| nnU-Net 全配置(含 nnUNetv2 计划阶段) | 24 GB+ | A100 | nnU-Net 自动选 patch size |
| EfficientNet-B7 多任务 | 16-24 GB | A100 | B7 骨干参数量大,建议混合精度 |
§6.9 评估指标代码
# ═══════════════════════════════════════════════════════════════
# COSAS 官方评估复刻:每图 0.5×Dice + 0.5×Jaccard,任务内取均值,
# 总排名 = 0.2×初测 + 0.8×终测(坑点 5:三列都要输出,勿混报)。
# ═══════════════════════════════════════════════════════════════
import numpy as np

def dice_score(pred: np.ndarray, gt: np.ndarray) -> float:
    inter = np.logical_and(pred, gt).sum()
    denom = pred.sum() + gt.sum()
    return 1.0 if denom == 0 else 2.0 * inter / denom

def jaccard_score(pred: np.ndarray, gt: np.ndarray) -> float:
    inter = np.logical_and(pred, gt).sum()
    union = np.logical_or(pred, gt).sum()
    return 1.0 if union == 0 else inter / union

def official_per_image(pred: np.ndarray, gt: np.ndarray) -> dict:
    d, j = dice_score(pred, gt), jaccard_score(pred, gt)
    return {"dice": d, "jaccard": j, "official": 0.5 * d + 0.5 * j}

def challenge_total(per_image_scores_task1: list, per_image_scores_task2: list,
                    initial_task_mean: float, final_task_mean: float) -> dict:
    """合成总分的两种口径:
    (a) 任务内合成均值(对齐排行榜语义);
    (b) 双阶段加权(初测 0.2 + 终测 0.8,同任务赛道内聚合)。"""
    t1 = np.mean([s["official"] for s in per_image_scores_task1])
    t2 = np.mean([s["official"] for s in per_image_scores_task2])
    return {"task1_official_mean": t1,
            "task2_official_mean": t2,
            "stage_weighted": 0.2 * initial_task_mean + 0.8 * final_task_mean}
§6.10 MLOps 笔记
- 容器化对齐:若目标是挑战赛平台,从第一天就用 Docker 跑训练与推理,镜像内
pip freeze全量固化;grand-challenge 算法容器的输入/输出接口(图像入、掩模出)按平台模板实现,别等终测周才第一次打包容器(坑点 6)。 - 数据版本管理:Zenodo v1(2024-04-18)是唯一公开版本,用 DVC 或 git-lfs 登记数据包哈希,实验记录绑定"record 10992201 + 解压后文件数 180×2"双重校验。
- 栅格化即代码:把轮廓→掩模的栅格化函数放进版本库并加单元测试(嵌套轮廓、空轮廓、极小多边形三个用例),评估结论才可复现(坑点 8)。
- 域维度的实验追踪:日志除总分外逐域(器官/扫描仪)拆分记录——域级曲线是判断"新技巧是真泛化还是过拟合训练域"的唯一可靠信号。
- 提交预算管理:初测 5 次、终测 1 次的机会结构要写进 CI——每次平台提交关联一个 git tag 与本地评估快照,事后可审计"哪一次提交用了哪个权重"。
§7 质量评估与局限性
§7.1 已知偏倚
| 偏倚类型 | 描述 | 严重程度 | 缓解建议 |
|---|---|---|---|
| 地域/单中心偏倚 | 标本来自中国(上海为主)病理机构,染色协议与人群特征单一 | 中 | 外部验证(§5.5);结论限定"相似染色体系" |
| 域规模均衡偏倚 | 每域样本数刻意均衡(60/60/60、15×6),不反映临床流行率 | 低 | 流行病学结论勿引用本数据集分布(§4.2) |
| ROI 选择偏倚 | patch 裁剪规则未披露,可能倾向腺体富集区域 | 中 | 训练前自测前景占比分布(§6.1) |
| 设备记录不对称 | Task 1 单一扫描仪 vs Task 2 六台;逐台 MPP 未披露 | 中 | 跨台物理尺度实验前先核验分辨率假设 |
| 无患者层级 | patch-患者-切片映射缺失,同源样本可能跨子集 | 高 | 沿用官方域分层;不做患者级声明(§4.4、§5.3) |
| 标注一致性未知 | 无双人标注比例与一致性系数披露 | 中 | 敏感实验抽样双人复标估计噪声下界 |
§7.2 标注质量
标注由瑞金医院临床团队 10 人手工勾画(§3.6),像素级金标准性质明确(§2.6)。已知的两点质量边界:其一,官方未公布一致性统计,标注者间方差不可量化;其二,任务定义把"正常腺体 + 腺癌区域"合并为单一前景,放弃了逐像素良恶性区分——这不是标注错误,而是任务定义的选择,但它决定了本数据集不能直接用于"癌区 vs 正常腺体"的细分研究(§2.3 边界讨论)。
§7.3 泛化性评估
| 场景 | 失效风险 | 证据 |
|---|---|---|
| 训练域内推理 | 低 | 与 GlaS 等同源基准表现相当(社区经验) |
| 跨器官(训练 3 器官 → 测试 6 器官) | 高 | 终测 90 张含训练未见腺癌;冠军也只有 0.8020(合成分) |
| 跨扫描仪(3 台 → 6 台) | 高 | 染色/锐度/曝光差异直接入模;Rein 初测 0.8848 说明该方向天花板更高 |
| 跨染色实验室(协议外染色批次) | 高且未测 | 官方无此轴;迁移实验需自建(§5.5) |
| 非 H&E 染色(IHC 等) | 完全失效 | 任务定义为 H&E 专属,不可外推 |
| 跨病理亚专科工作流(会诊场景) | 中-高 | 即 Task 1 设计动机本身(§2.5) |
§7.4 伦理考量
数据为去标识化 H&E 病理图像,发布经公开渠道(Zenodo + 数据使用协议);病理图像不含面部等直接标识物,但切片-患者的可回溯性是病理数据的固有敏感点——官方未披露去标识化流程细节,使用者应在二次分析中避免尝试重建患者身份。竞赛数据的闭门发布(初测/终测)兼有评测公平与数据管控双重目的。使用建议:学术发表引用官方数据论文;商业用途先核对 Zenodo 协议条款(license 名称以记录页为准,见 §5)。
§7.5 公平性
设备维度的公平性设计值得单独一提:六台扫描仪覆盖国产(TEKSQRAY、KFBIO、Motic)与国际主流(3DHISTECH、Zeiss、Leica/Aperio)厂商,高中低端兼具——这使 Task 2 的结论对"资源不均衡医院"(仍在用入门级扫描仪的基层病理科)更有参考性。人群维度(年龄、性别、族群)因患者级信息缺失无法评估——公平性分析的盲区与患者维度的缺失是同一件事(§4.4)。
§7.6 数据漂移
本数据集的"漂移"不是时间维度而是域维度:器官轴(Task 1)与设备轴(Task 2)构成了显式协变量偏移——前景/背景的条件分布随域移动。对部署方,现实漂移监测应包含:逐院染色直方图监控(对照训练域染色分布)、逐设备前景占比监控(对照 §6.1 基线)、逐域分数监控(对照 §8.1 排行榜的域级分解)。当新医院接入时,COSAS 的教训是:先测"扫描仪签名"距离,再谈模型精度。
落地为一个最小监控清单:①接入新扫描仪时,先用 20-50 张 patch 计算染色分布与训练域的马氏距离;②距离超阈值时启用归一化或提示人工复核;③上线后按月按设备拆分 Dice 曲线,单设备下滑超过 3 个百分点即触发再评估。这套清单的全部阈值锚点都能在 COSAS 双赛道上预演——这正是本数据集对部署侧的持续价值。
§7.7 DAIMS 24 项数据就绪度评估
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 数据为宽格式(每行一个样本/事件) | ✅ | 一 patch 一文件一样本 |
| 2 | 有唯一标识符列 | ✅ | patch 文件名唯一(无患者 ID,见 #24 与 §4.4) |
| 3 | 无 Unicode 或特殊字符 | ⚠️ | 图像本体无此问题;文件命名规范与元数据编码未官方文档化 |
| 4 | 无重复行 | ⚠️ | 无切片/患者映射,无法排除同源近重复 patch |
| 5 | 缺失值已识别并编码 | ✅ | 图像无 NaN 概念;标注完整性可经 §6.1 体检验证 |
| 6 | 标签列被明确标识 | ✅ | 器官/扫描仪/子集三类域元数据明确 |
| 7 | 已对罕见类别(<3%)进行分组 | ✅ | 域均衡设计(每域等量),无罕见类塌缩问题 |
| 8 | 偏倚评估已完成 | ✅ | §7.1 六类偏倚与缓解措施 |
| 9 | 有完整的数据字典 | ⚠️ | 官网+论文级描述存在,但无逐文件 README/字段级字典 |
| 10 | 对"信息性缺失"有明确编码解释 | ✅ | §4.5 结构性缺失清单(本条目系统梳理) |
| 11 | 数据采集设备和设置已记录 | ⚠️ | 六台扫描仪逐台可点名(§3.9),但逐台 MPP/倍率未披露 |
| 12 | 已移除完全共线性变量 | ✅ | 图像模态无共线性问题 |
| 13 | 对编码的映射标准已说明 | ✅ | 器官/扫描仪名称清单明确(§2.1、§3.9) |
| 14 | 对时间戳的处理已明确说明 | ✅ | 无时序维度,无歧义 |
| 15 | 训练/验证/测试划分建议已给出 | ✅ | 官方域分层划分 180/20/90(§5.1) |
| 16 | 数据泄漏风险已被讨论 | ✅ | 域泛化设计本身 + §5.3 三类泄漏路径(本条目) |
| 17 | 标签分布已被分析 | ⚠️ | 域分布公开;前景占比官方未统计(§4.2) |
| 18 | 选择性测量偏倚已被讨论 | ⚠️ | patch ROI 裁剪规则未披露(§7.1),本条目已标注但官方未解释 |
| 19 | 外部验证建议已给出 | ✅ | §5.5 与 §7.8 |
| 20 | 数据更新和版本信息已记录 | ✅ | Zenodo concept DOI → v1 版本链清晰 |
| 21 | 最小必要预处理脚本已提供 | ❌ | 官方零脚本:栅格化、尺寸统一、指标计算全部 DIY |
| 22 | 合规使用要求已明确 | ✅ | Zenodo 数据使用协议 + 竞赛规则(预训练限制等)明确 |
| 23 | 多模态对齐方法已说明 | ✅ | 单模态数据集,无对齐问题 |
| 24 | 去标识化方法已被记录 | ⚠️ | 病理图像属医疗衍生数据,官方披露的去标识化流程细节有限 |
DAIMS 评分:19.5 / 24
评分解读:良好偏上——扣分集中在文档工程层(无官方脚本、无字段级字典、MPP 缺失)与患者维度缺失;而图像数据集天然避开的项(时序、共线性、多模态对齐)几乎无损通过。与 MIMIC-III(18.5/24)相比,COSAS 赢在"小而精、无历史包袱",输在"官方工程配套为零"。
对你意味着什么:19.5 分的读法是"数据可信、管线自建"。具体行动:①把 §6.1 体检脚本当作必跑的第一道工序,用实测数据补上官方留白的四个统计(尺寸分布、前景占比、空标注数、重复嫌疑);②直接抄 §6.9 的指标代码,不要自己发明合成分算法——对齐官方公式是成绩可比性的前提;③把 §4.4 的层级缺失写进你的论文 limitation——审稿人对"无患者映射的域泛化结论"越来越敏感;④预算一天工程时间做栅格化与尺寸统一的单元测试(坑点 3、坑点 8),这是官方零脚本留下的最大自建工作量。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 评估任务 | 性能指标 | 相对内部变化 | 关键发现 |
|---|---|---|---|---|---|
| COSAS 终测·跨器官赛道 | FAU Erlangen-Nürnberg(DCAC) | 腺体前景分割 | 0.8020(0.5Dice+0.5Jaccard) | 官方赛制即跨域设定,无同源对照 | nnU-Net + 域/内容自适应卷积为最强单一改动 |
| COSAS 终测·跨扫描仪赛道 | FAU Erlangen-Nürnberg(DCAC) | 腺体前景分割 | 0.8527(同上) | 高于跨器官赛道 5.07 个百分点 | 跨扫描仪整体比跨器官更易(Rein 同序,见下) |
| COSAS 初测/终测·Task 1 | 贵州大学(Rein) | VFM 微调分割 | 初测 0.7719 → 终测 0.7557 | 终测比初测低 1.62 个百分点 | ConvNeXt-L(ImageNet 预训练)即可进第一梯队 |
| COSAS 初测/终测·Task 2 | 贵州大学(Rein) | VFM 微调分割 | 初测 0.8848 → 终测 0.8192 | 终测比初测低 6.56 个百分点 | DINOv2-B 特征对染色偏移稳健,但终测域更难 |
| 自留验证折 → 官方测试集 | Seegene Medical Foundation(Top-10 方案,MIE 2025) | 染色分离多任务 U-Net | 内部 Dice 0.898 → 外部 0.792 | 外部掉 10.6 个百分点 | 典型的内部-外部差距量化,域泛化成本的实测读数 |
矩阵读法:所有同行评审数字都指向同一结论——跨域设定会把同源成绩拉低 6-11 个百分点,这正是把 COSAS 当外部验证靶场(§5.5)的价值所在。
§8 基准性能与生态
§8.1 排行榜
⚠️ 可比性前提:下列数字均为"每图 0.5×Dice + 0.5×Jaccard"合成口径;跨行比较还需注意预训练来源合规性一致(全部为非医学预训练,坑点 4)、评测阶段(初测/终测)与任务赛道——任何单列数字都不构成严格同口径比较。
| 排名 | 模型/方案 | Task 1(跨器官) | Task 2(跨扫描仪) | 年份 | 关键技术 | 完整引用 | 代码 |
|---|---|---|---|---|---|---|---|
| 1(双赛道) | DCAC(FAU Erlangen-Nürnberg) | 0.8020 | 0.8527 | 2024 | nnU-Net + Domain and Content Adaptive Convolutions:域预测选滤波器组(DAC)+ 内容自适应动态滤波(CAC) | Wilm F, Öttl S, Aubreville M, Breininger K. Domain and Content Adaptive Convolutions for Masked Semantic Inference. arXiv:2409.09797, 2024. | 官方未公开 |
| VFM 路线代表 | Rein(贵州大学) | 初测 0.7719 / 终测 0.7557 | 初测 0.8848 / 终测 0.8192 | 2024 | VFM 微调:可学习 token(Rein)+ 轻量输出适配;Task 1 用 ConvNeXt-L、Task 2 用 DINOv2-B | Cai P, et al. Rein: A VFM-based Approach to Segment Anything in Histopathology. arXiv:2409.11752, 2024. | 官方未公开 |
| Top-10(Task 2) | 染色分离多任务 U-Net(Seegene Medical Foundation) | —(未参评 Task 1) | 终测合成分 0.864(arXiv 摘要口径);内部 4 折 Dice 0.898 / 外部 6 台 0.792(仓库口径) | 2024/2025 | EfficientNet-B7 编码器 + 染色矩阵/密度双解码器多任务自编码器,染色增强混合 | Kim HH, Jeong WC, Park Y, Ko YS. Understanding Stain Separation Improves Cross-Scanner Adenocarcinoma Segmentation with Joint Multi-Task Learning. Stud Health Technol Inform. 2025;327:53-57. doi:10.3233/SHTI250272(预印本 arXiv:2409.13246) | github.com/4pygmalion/cosas(Apache-2.0) |
赛程名次补充:终测双赛道的第二名由一个 Domain-stratified 方案获得(UperNet 骨干 + VAN 大核注意力,器官/扫描仪分层三折交叉验证,512×512 滑窗 50% 重叠),其分项成绩未在公开渠道以可引用形式披露,此处不列数字。两篇参赛论文(DCAC、Rein)的 arXiv 摘要截止为 2024-09-20,workshop 于 2024-10-06 完成名次揭晓。
§8.2 SOTA 总结与选型建议
三条已验证的技术路线对应三种资源预算:①零成本冲线:nnU-Net 直接起步(冠军骨架),合规、稳健、自带尺寸自适应;②架构创新:DCAC 的自适应卷积证明"给域偏移建模的架构自由度"比堆数据有效——0.8020/0.8527 的双第一来自单一架构改动;③结构解耦:Seegene 的染色分离多任务路线开源最完整(Apache-2.0),适合作为工程起点改造。VFM 微调(Rein)展示了 ImageNet 预训练骨干在两条赛道都能进第一梯队,但注意 Task 2 初测(0.8848)与终测(0.8192)的 6.56 个百分点落差提示:初测成绩普遍偏乐观(§5.3 泄漏 3)。
选型决策树:如果你的目标是发方法论文,从 DCAC 复现开始(成绩锚点清晰、架构改动可解释);如果目标是工程落地,从 Seegene 仓库 fork(容器化、推理脚本、Dockerfile 齐备);如果目标是快速打榜自建赛事,nnU-Net + 域分层验证折是性价比最高的起点。三条路线都不需要医学预训练权重——这既是对本赛事合规性的适配,也恰好让方法在"无病理大模型"的现实医院环境中更可部署。
§8.3 评测协议
官方协议五要素(官网 tasks 页口径):①指标 = 每图 0.5×Dice + 0.5×Jaccard,任务内平均;②排名 = 初测 0.2 + 终测 0.8 加权;③提交预算 = 初测每任务 5 次、终测每任务 1 次;④提交形态 = Docker 容器经 grand-challenge 平台算法接口闭门评测;⑤合规红线 = 预训练仅限 ImageNet / MS COCO 等非医学数据。复现者可直接把五要素搬进自建评测(§6.9、§6.10)。
§8.4 相关数据集
| 数据集 | 关系 | 差异化说明 |
|---|---|---|
| GlaS | 同任务(腺体分割)经典基准 | 同源划分无域泛化;COSAS 的"前身语境" |
| DigestPath | 消化道病理多任务 | 含分割任务,癌种部分重叠(胃/结直肠) |
| CoNSeP | 腺体+核实例分割 | 粒度更细、规模更小、单中心 |
| BCSS | 大规模区域语义分割 | TCGA 来源、四类组织,规模大两个量级 |
| MIDOG | 跨扫描仪域泛化(检测任务) | 同主题不同任务型:点标注检测 vs 面标注分割 |
| PANDA / PANDA-plus | 前列腺病理(Gleason 分级) | 前列腺腺癌的分级任务侧写(COSAS Task 1 器官之一) |
| BreaKHis | 乳腺肿瘤显微图像分类 | 乳腺轴的分类任务侧写(COSAS Task 2 癌种) |
| LYSTO / MoNuSAC / OCELOT | 病理细胞/组织/器官粒度互补 | 库内同模态邻居,外验证池(§5.5) |
§8.5 关键论文 Top 5
- Da Qian, Chaofu Wang, Yanfei Zuo, Yan Guo, Guofu Jiang, Linlin Shen, Xiaoling Luo, Meidan Ding, Jingxin Liu, Xianxu Hou, et al. COSAS 2024 dataset. Zenodo, 2024. doi:10.5281/zenodo.10992200 —— 数据集本体与 12 位作者署名的官方记录(concept DOI,解析至 v1 记录 10992201)。
- Wilm F, Öttl S, Aubreville M, Breininger K. Domain and Content Adaptive Convolutions for Masked Semantic Inference. arXiv:2409.09797, 2024. —— 双赛道冠军方案;把域偏移写进卷积核选择逻辑的架构路线。
- Cai P, et al. Rein: A VFM-based Approach to Segment Anything in Histopathology. arXiv:2409.11752, 2024. —— 视觉基础模型合规微调的代表;可学习 token 适配在双赛道均进第一梯队。
- Kim HH, Jeong WC, Park Y, Ko YS. Understanding Stain Separation Improves Cross-Scanner Adenocarcinoma Segmentation with Joint Multi-Task Learning. Stud Health Technol Inform. 2025;327:53-57. doi:10.3233/SHTI250272 —— Top-10 开源方案;染色矩阵/密度解耦的多任务范式与最完整的内部-外部差距数据。
- cosas.grand-challenge.org 官网与 grand-challenge.org 平台(DIAG Nijmegen) —— 赛制、时间线、提交规则与闭门评测的一手权威来源(本条目时间线与协议数字的出处)。
§8.6 社区活跃度
可核实的社区足迹:参赛方案论文至少 2 篇 arXiv 预印本(2024-09 批次)+ 1 篇 MIE 2025 正刊论文;唯一公开完整代码库为 Seegene 方案(github.com/4pygmalion/cosas,Apache-2.0,含 Dockerfile 与推理脚本);官方渠道(官网、workshop)在 2024-10-06 赛事后未再更新。COSAS 的社区形态是"赛事档案型"——热度不及 MIDOG/PANDA 等常青基准,但作为域泛化分割的固定考卷被后续方法论文引用(引用次数快照截至 2026-09 未获得可靠数字,不列)。
§8.7 生态快照
| 资源 | 类型 | 链接 | 推荐理由 |
|---|---|---|---|
| COSAS 官网 | 赛事主页 | cosas.grand-challenge.org | 时间线/规则/organizers 的一手来源 |
| Zenodo v1 记录 | 数据发布 | zenodo.org/records/10992201 | 训练集下载入口(注册 + 协议) |
| grand-challenge 平台 | 评测基础设施 | grand-challenge.org | Docker 算法容器提交与闭门评测 |
| Seegene 方案仓库 | 开源代码 | github.com/4pygmalion/cosas | Apache-2.0 完整管线(训练-推理-容器化) |
| DCAC 论文 | 方法论文 | arxiv.org/abs/2409.09797 | 冠军架构与双赛道成绩的权威描述 |
| Rein 论文 | 方法论文 | arxiv.org/abs/2409.11752 | VFM 合规微调路线参考 |
| Seegene 论文预印本 | 方法论文 | arxiv.org/abs/2409.13246 | 染色分离方法全文(MIE 2025 版本的开放获取形态) |
§9 相关资源与引用
§9.1 官方资源入口
- 官网:cosas.grand-challenge.org(overview/tasks/organizers;datasets 与 evaluation 子页在抓取时点分别为 403/404,赛制信息以 tasks 页为准)
- 数据:Zenodo record 10992201(v1,2024-04-18;concept DOI 10.5281/zenodo.10992200)
- 评测平台:grand-challenge.org(Docker 算法容器规范与提交入口)
- 开源代码:github.com/4pygmalion/cosas(Top-10 方案完整管线)
- 方法论文:arXiv:2409.09797(DCAC)、arXiv:2409.11752(Rein)、arXiv:2409.13246(Seegene 预印本)
§9.2 BibTeX 引用块
@dataset{qian_da_2024_10992200,
  title       = {COSAS 2024: Cross-Organ and Cross-Scanner Adenocarcinoma
                 Segmentation Challenge dataset},
  author      = {Qian, Da and Wang, Chaofu and Zuo, Yanfei and Guo, Yan and
                 Jiang, Guofu and Shen, Linlin and Luo, Xiaoling and
                 Ding, Meidan and Liu, Jingxin and Hou, Xianxu and others},
  year        = {2024},
  publisher   = {Zenodo},
  doi         = {10.5281/zenodo.10992200},
  note        = {Concept DOI; resolves to version 1, record 10992201}
}

@article{wilm2024domain,
  title   = {Domain and Content Adaptive Convolutions for Masked Semantic
             Inference},
  author  = {Wilm, Frederik and {\"O}ttl, Silas and Aubreville, Marc and
             Breininger, Katharina},
  journal = {arXiv preprint arXiv:2409.09797},
  year    = {2024}
}

@article{cai2024rein,
  title   = {Rein: A VFM-based Approach to Segment Anything in Histopathology},
  author  = {Cai, Pengzhou and others},
  journal = {arXiv preprint arXiv:2409.11752},
  year    = {2024}
}

@article{kim2025stain,
  title     = {Understanding Stain Separation Improves Cross-Scanner
               Adenocarcinoma Segmentation with Joint Multi-Task Learning},
  author    = {Kim, Ho Heon and Jeong, Won Chan and Park, Youngjin and
               Ko, Young Sin},
  journal   = {Studies in Health Technology and Informatics},
  volume    = {327},
  pages     = {53--57},
  year      = {2025},
  publisher = {IOS Press},
  doi       = {10.3233/SHTI250272}
}

@misc{cosas2024website,
  title        = {COSAS 2024 -- Cross-Organ and Cross-Scanner Adenocarcinoma
                  Segmentation Challenge},
  howpublished = {\url{https://cosas.grand-challenge.org}},
  year         = {2024},
  note         = {MICCAI 2024 satellite challenge; hosted on
                  grand-challenge.org}
}
§9.3 引用指南
使用数据本身引 Zenodo 数据论文(第 1 条);讨论域泛化方法引对应方案论文(第 2-4 条);描述赛制/协议引官网(第 5 条)并与数据论文并引。涉及规模数字时一律采用正式口径(Task 1 290 张 6 种腺癌 + Task 2 290 张 6 台扫描仪),若需提及 Zenodo 描述的早期口径,按坑点 1 的双口径写法处理。
§10 AI 使用声明卡
§10.1 AI 模型列表
| 模型 | 用途 | 阶段 |
|---|---|---|
| fast-model(CodeBuddy Code) | 初稿撰写、结构组织、代码示例生成 | 2026-09 |
§10.2 AI 参与范围
AI 完成初稿全部章节(INFOBOX、§0-§10、§C)的结构化写作与代码示例生成;所有事实性内容(规模数字、时间线、成绩、规则条款)来自 §10.3 所列输入来源并由检索过程交叉验证,AI 不负责事实的最终裁决;格式规范(frontmatter/坑点四段式/DAIMS 24 项/JSON-LD)由 WRITER_CONSTITUTION.md 约束。
§10.3 输入来源列表
- COSAS 2024 官网 overview 与 tasks 页(时间线、数据构成、评估规则、预训练限制),https://cosas.grand-challenge.org 及 /tasks/,抓取时点 2026-09-27。
- COSAS 2024 官网 organizers 页(四组人员架构:Leading Organizers 5 人/组织委员会 5 人/临床团队 10 人/技术团队 5 人/学生贡献者 9 人),https://cosas.grand-challenge.org/organizers/。
- Zenodo record 10992201(v1,2024-04-18,12 位作者署名,早期口径描述存照),https://zenodo.org/records/10992201。
- Zenodo concept DOI 10.5281/zenodo.10992200(版本链)。
- Wilm F, Öttl S, Aubreville M, Breininger K. Domain and Content Adaptive Convolutions for Masked Semantic Inference. arXiv:2409.09797, 2024(冠军方案与双赛道成绩 0.8020/0.8527)。
- Cai P, et al. Rein: A VFM-based Approach to Segment Anything in Histopathology. arXiv:2409.11752, 2024(VFM 微调路线与双任务初测/终测成绩)。
- Kim HH, Jeong WC, Park Y, Ko YS. Understanding Stain Separation Improves Cross-Scanner Adenocarcinoma Segmentation with Joint Multi-Task Learning. Stud Health Technol Inform. 2025;327:53-57. doi:10.3233/SHTI250272(Top-10 开源方案与内部-外部差距)。
- Kim HH, et al. 同题预印本 arXiv:2409.13246, 2024(方法全文与 Task 2 成绩摘要口径)。
- github.com/4pygmalion/cosas 仓库 README 与 LICENSE(Apache-2.0、内部 4 折 Dice 0.898/IoU 0.816、外部 0.792、Seegene Medical Foundation 署名),检索时点 2026-09-26。
- grand-challenge.org 平台文档(Docker 算法容器提交范式),https://grand-challenge.org。
- 库内数据库 ai_ready_dataset 表查询(病理系互链条目 record_id 18 个:panda-plus 640、leopard 636、puma 641、peso 642、wsss4luad 643、monusac 651、lysto 653、midog 298、glas 196、digestpath 338、consep 228、bcss 258、breakhis 126、nucls 248、ocelot 308、panda 560、pannuke 218、tupac16 278),查询时点 2026-09-27。
- GLOBOCAN 2022 全球癌症统计(六器官新发病例数,截至 2022 年),IARC 发布。
- ICD-11 MMS(2024 版检索路径)与 SNOMED CT 常用概念(443961000124105、25481003、93880000、363406005),WHO/SNOMED International 浏览器口径。
- WRITER_CONSTITUTION.md(格式规范)与 writing/panda-plus/FACTS.md(FACTS 结构参照)、writing/MIMIC-III/MIMIC-III_Wikipedia.md(免责声明文本),库内规范文件。
§10.4 人工校验记录
| 内容模块 | 审核者 | 审核方式 | 审核状态 |
|---|---|---|---|
| INFOBOX 数据汇编 | 千方病案医学编辑部 | 与 FACTS.md 逐字段比对 | ✅ 已通过 |
| §2 医学背景(ICD-11/SNOMED 映射) | 千方病案医学编辑部 | 编码浏览器抽样复核 | ✅ 已通过 |
| §3-§5 数据规格与划分 | 千方病案医学编辑部 | 官网 tasks 页 + 冠军论文双源比对 | ✅ 已通过 |
| §6 AI 就绪指南与八个坑点 | 千方病案医学编辑部 | 代码可运行性走查 + 坑点溯源核查 | ✅ 已通过 |
| §7 质量评估与 DAIMS 评分 | 千方病案医学编辑部 | 24 项逐项复核 | ✅ 已通过 |
| §8 排行榜与引用 | 千方病案医学编辑部 | arXiv/DOI/GitHub 三源核验 | ✅ 已通过 |
| §9 BibTeX | 千方病案医学编辑部 | DOI 逐条解析验证 | ✅ 已通过 |
| §C JSON-LD | 千方病案医学编辑部 | JSON 语法与 URL 占位校验 | ✅ 已通过 |
§10.5 AI 生成章节标注
以下章节由 AI 生成初稿并经人工审核:INFOBOX、§1 概览、§2 医学背景、§3 数据集规格、§4 数据结构、§5 划分建议、§6.0-§6.4 代码示例、§6.5 八个坑点、§6.6-§6.10、§7 全部(含 DAIMS 24 项表与评分)、§8 基准与生态、§9 资源与引用、§C JSON-LD。
§10.6 最后审核
最后一次人工审核日期:2026-09-27
页面状态:published(全部内容已完成审核并发布)
附录 A:关键术语速查
| 术语 | 英文 | 速记定义 |
|---|---|---|
| 域泛化 | Domain Generalization | 训练域与测试域分布不同,且训练时不可见测试域 |
| 域偏移 | Domain Shift | 不同器官/扫描仪导致的图像分布差异 |
| 跨器官赛道 | Cross-Organ(Task 1) | 1 台扫描仪 × 6 种腺癌的泛化考试 |
| 跨扫描仪赛道 | Cross-Scanner(Task 2) | 1 种癌 × 6 台扫描仪的泛化考试 |
| 全切片图像 | WSI(Whole Slide Image) | 病理玻璃切片的数字化扫描全景图 |
| Patch | Patch | 从 WSI 裁出的感兴趣区域小图(本数据集约 1500×1500) |
| MPP | Microns Per Pixel | 每像素对应的物理微米数,决定放大倍率换算 |
| H&E | Hematoxylin & Eosin | 苏木精-伊红染色:核蓝紫、质间质粉红 |
| 染色归一化 | Stain Normalization | 把不同染色的颜色分布映射到统一参考(Macenko/Reinhard 系) |
| 染色矩阵/密度 | Stain Matrix / Density | Beer-Lambert 分解中的颜色基底 W 与浓度图 H |
| 腺癌 | Adenocarcinoma | 起源腺体上皮的恶性肿瘤(本数据集 6 种) |
| NST | No Special Type | 乳腺浸润性癌 WHO 分类总类(旧称浸润性导管癌) |
| PDAC | Pancreatic Ductal Adenocarcinoma | 胰腺导管腺癌 |
| 前景/背景 | Foreground / Background | 任务定义:腺体组织 vs 间质等非腺体结构 |
| 轮廓标注 | Contour Annotation | 矢量多边形形式的人工勾画,使用前栅格化 |
| 栅格化 | Rasterization | 多边形 → 像素掩模的转换(存在引擎差异,坑点 8) |
| Dice 系数 | Dice | 2×交集/(预测+真值),分割重叠度 |
| Jaccard 指数 | Jaccard / IoU | 交集/并集,恒不高于 Dice |
| 合成分 | Official Score | 0.5×Dice + 0.5×Jaccard(官方指标) |
| DAC/CAC | Domain/Content Adaptive Convolutions | 冠军方案的自适应卷积组件 |
| VFM | Vision Foundation Model | 大规模预训练视觉模型(本赛事限非医学预训练) |
| nnU-Net | nnU-Net | 自配置分割框架,冠军方案骨架 |
| grand-challenge | Grand Challenge | DIAG Nijmegen 的医学影像评测平台,Docker 闭门评测 |
| Transductive 泄漏 | Transductive Leakage | 用测试域统计拟合预处理参数造成的虚高(坑点 7) |
附录 B:数字速查卡
规模与划分(官网口径):
Task 1 跨器官:  290 张 = 训练 180(胃/结直肠/胰腺各 60)+ 初测 20(4 器官×5)+ 终测 90(6 腺癌×15)
Task 2 跨扫描仪:290 张 = 训练 180(3 台扫描仪×60)+ 初测 20(4 台×5)+ 终测 90(6 台×15)
patch 尺寸:平均约 1500×1500 px(非统一);Task 1 全部 TEKSQRAY SQS-600P 扫描
癌种:胃 / 结直肠 / 胰腺 / 乳腺 NST / 前列腺 / 肺(6 种);扫描仪:TEKSQRAY、KFBIO、
     3DHISTECH、Zeiss、Motic、Leica/Aperio(6 台)
成绩速查(合成分 = 0.5×Dice + 0.5×Jaccard):
DCAC(冠军,FAU):            Task 1 终测 0.8020   Task 2 终测 0.8527
Rein(贵州大学):              Task 1 初测 0.7719 / 终测 0.7557
                              Task 2 初测 0.8848 / 终测 0.8192
Seegene Top-10(开源):        Task 2 终测 0.864(摘要口径);内部 4 折 Dice 0.898、外部 6 台 0.792
排名公式:0.2 × 初测均值 + 0.8 × 终测均值(每任务赛道内聚合)
提交预算:初测每任务 5 次;终测每任务 1 次;Docker 容器经 grand-challenge 提交
预训练限制:仅 ImageNet / MS COCO 等非医学数据
时间线速查:Zenodo v1 2024-04-18 → 注册开放 2024-05-08 → 训练数据 2024-06-18 → 注册截止 2024-08-17 → 初测 2024-08-18 → 初测 Docker 截止 2024-09-05 → 终测 2024-09-06 → 终测截止 2024-09-08 → arXiv 摘要截止 2024-09-20 → workshop 2024-10-06(Marrakech)。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- owl — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
- puma — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
- lysto — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
- tiger — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
- anhir — 共享标签:医学影像 / 病理图像 / 挑战赛数据集
- consep — 共享标签:医学影像 / 病理图像 / 医学图像分割
- hc18 — 共享标签:医学影像 / 医学图像分割 / 挑战赛数据集
- us-nerve-seg — 共享标签:医学影像 / 医学图像分割 / 挑战赛数据集
- wsss4luad — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
- monusac — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 挑战赛数据集
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
