信息速览
JADER — 日本药品不良事件报告数据库 AI-Ready Wikipedia
INFOBOX
| 数据集名称 | JADER(Japanese Adverse Drug Event Report database) |
| 日文官方名 | 副作用が疑われる症例報告に関する情報(2004 年度以降の報告) |
| 别名/简称 | JADER、日本药品不良事件报告数据库、PMDA 副作用数据库 |
| 疾病分类 | 上市后药品不良事件与疫苗不良事件(非单病种;MedDRA/J 基本语覆盖全疾病谱) |
| 数据模态 | 结构化自发不良事件报告(ICSR):病例人口学 / 医药品 / 副作用 / 原疾患四表 |
| AI 任务类型 | 药物警戒信号检测(ROR/PRR/BCPNN/χ²)、报告失衡分析、药物-不良反应关系挖掘、药品诱导疾病时间-发病分析、跨库(vs FAERS)对比 |
| 样本总数 | 逾 96.5 万例(2004-04~2025-01,J-STAGE 口径);2025 年末约 90 万份(去重口径,Frontiers 2026) |
| 数据大小 | 全量 CSV 分四表并提供分割文件;单病例可含多条不良事件记录(96.5 万例对应约 251.6 万条事件记录) |
| 数据格式 | CSV(逗号分隔,MedDRA/J 基本语编码,字段映射 ICH E2B(R2)/(R3)) |
| 许可证 | PMDA 官方公开发布、免费下载(无需注册);使用受 PMDA 使用注意事项约束,非 CC 协议 |
| 访问级别 | 开放(免费公开下载,需通过图片验证码) |
| DUO 标签 | NRES(无限制,依 PMDA 使用注意事项) |
| 语言 | 日文(字段名与术语为日文;MedDRA/J 日文基本语) |
| 首发日期 | 数据自 2004-04-01 起;疫苗报告自 2013 年度起;2016 年度起引入 R3 格式 |
| 最后更新 | 全量覆盖滚动更新(含公开前约 4 个月以内受理的病例) |
| 发布机构 | 独立行政法人 医薬品医療機器総合機構(PMDA),安全性情報・企画管理部 |
| 官方主页 | https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0004.html |
| 下载地址 | http://www.info.pmda.go.jp/fukusayoudb/CsvDownload.jsp |
| DOI | 无官方数据集 DOI |
| AI 就绪度评分 | ⭐⭐(2/5)— 免费公开、四表结构与字段映射清晰,但官方无去重/标准化脚本、全量覆盖需自行合并、日文字段需本地化、无任何划分、R2/R3 混存需处理 |
| 页面状态 | published |
§0 E-E-A-T 信任声明与免责声明
医学审核者:千方病案医学编辑部交叉审核:§2 医学背景(MedDRA/J 术语体系、药物警戒临床任务、报告口径与人群结构)、§7 偏倚分析。
数据工程审核者:千方病案医学编辑部交叉审核:§4 DAIMS 数据字典(四表病例编号关联、R2/R3 混存结构)、§5 数据划分策略、§6 预处理 Pipeline 和坑点。
审核日期:2026-10-16
审核方式:交叉审核
利益冲突声明:千方病案医数集与日本 PMDA 及任何数据再分发方无商业利益关联。本页面不销售 JADER 数据集本身,仅提供 AI 就绪指南与学术信息服务。编辑者未接受 PMDA 的任何形式资助。
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。JADER 报告本身不代表事件由药品所致,患者不应依据报告停止或更改用药。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始使用条款。JADER 公开 CSV 由日本 PMDA 发布,官方明确「csv 文件按目标期间全量覆盖更新、非增量」,并提示「不得以文件中报告病例数简单评价或比较药品安全性」。PMDA 未提供英文标准许可声明,本页面不将其标注为任何 CC 协议。
§1 数据集概览
§1.0 30 秒速览
JADER 是日本 PMDA 维护的「药品不良事件报告库」——日本的医生、药师和药企在怀疑某个药品导致不良反应后,把个案报到 PMDA,这些报告汇总起来就成了 JADER。它是日本药物警戒研究的标准数据源:截至 2025 年初累计已逾 96.5 万例,数据自 2004 年 4 月起免费公开,2025 年末去重口径约 90 万份。
它的价值在于「广度 + 本地化」:临床试验人数有限、随访短,捕捉不到罕见不良反应;JADER 汇集了日本真实世界的海量用药个案,能最先浮现「某药与某罕见事件相关」的统计信号。与美国的 FAERS 相比,JADER 的报告者以医师、药师为主(FAERS 则以消费者为主),性别分布接近均衡(FAERS 以女性为主),是「日本 vs 美国」跨库对比研究中最常用的亚洲对照库。
你可以用它来:做药物警戒信号挖掘(某药有没有被不成比例地报出某类事件)、检索某药某事件的历史报告数、研究日本人群的用药安全画像,或作为教学库带学生理解自发报告数据的局限。务必牢记:它是「信号源」而非「因果证据」——报告多不等于药品导致事件;且 JADER 只有分子、没有分母,不能用来计算发生率或对药品安全性做简单排序。
§1.1 摘要
JADER 是日本医药品医疗器械综合机构(PMDA)面向已上市药品与疫苗的上市后安全监测数据库,依据《医药品、医疗器械等的品质、有效性及安全性确保等相关法律》(昭和 35 年法律第 145 号)公开。数据库接收两类上报:制药企业或医疗机构自 2004 年度起依药机法报告的副作用疑似病例,以及医疗机构自 2013 年度起依《预防接种法》报告的疫苗相关病例。报告字段映射 ICH E2B(R2)/(R3) 数据项,不良事件统一以 MedDRA/J(ICH 国际医药用语集日本版)基本语(Preferred Term,PT)编码。
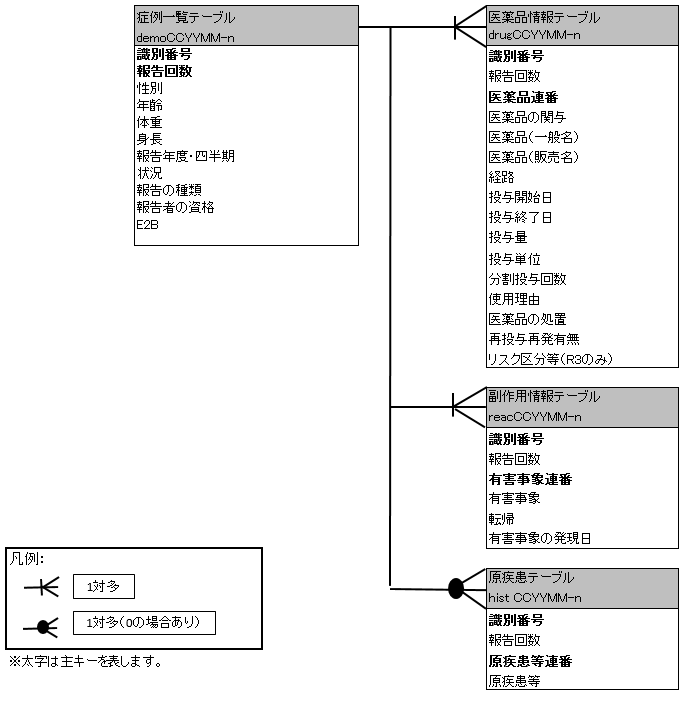
数据以四张 CSV 关系表提供:DEMO(症例一覧テーブル,病例一览)、DRUG(医薬品情報テーブル,药品信息)、REAC(副作用情報テーブル,不良反应)、HIST(原疾患テーブル,原疾患/既往史),以病例识别编号(識別番号)关联,支持一括下载或分割下载(分割文件带通序号,如 demoCCYYMM-n)。数据自 2004 年 4 月 1 日起连续覆盖,2016 年度起新报告格式 R3 与旧格式 R2 混存,报告方式在病例一览表中标注。
核心用途是上市后安全信号检测:以报告失衡分析(ROR、PRR、BCPNN、χ²)识别某药-某事件被不成比例报告的统计信号。PMDA 明确声明其公开 CSV「仅提供制药企业向 PMDA 报告的信息,PMDA 并未逐一评估药品与副作用之间的关联性」,且「不得以报告病例数或件数简单评价或比较药品安全性」——自发报告的固有局限(无分母、因果未证、重复上报、低报)决定了它只能作为假设生成工具 [PMDA 下载页]。
§1.2 战略价值分析
区域药物警戒生态维度:JADER 是日本药物警戒体系的核心公开端口。与欧美自发报告系统(FAERS、EudraVigilance、黄卡)相比,JADER 有三个独有特征使其不可替代:其一,药品审批的地域差异——在其他国家获批的药品未必在日本获批,反之亦然,使 JADER 能揭示日本特有的用药安全画像;其二,新药强化收集制度——日本对新上市药品实行上市后 6 个月内严重不良反应信息强化收集,使新药的信号更早显现;其三,报告者结构——以医师、药师为主体的专业上报,与 FAERS 的消费者主导形成互补 [PMC8658484][Frontiers 2026]。
跨库对比研究维度:JADER 是「亚洲 vs 欧美」跨库对比的标准对照库。2026 年 Frontiers 刊出的四库对比研究(VigiBase/FAERS/VAERS/JADER)系统刻画了四库在报告模式、报告者类型、地理分布、人口学与医疗结局上的异同,并量化了 VigiBase 与 FAERS 间约 1,110 万份共享报告——JADER 在其中提供了日本监管框架下的独有视角 [Frontiers 2026]。这类多库研究正成为药物警戒方法学的成熟范式。
方法学与教学维度:围绕 JADER 形成了完整的信号检测实践闭环。ROR/PRR/χ²/BCPNN 等失衡算法在 JADER 上有大量成熟实现与判读阈值,去重、术语版本冻结、suspected 药物限定、时间-发病分析等预处理步骤已成为标准操作。JADER 的日文界面与 MedDRA/J 术语体系,使其同时成为日语药物警戒教学与研究的标准依托。
§1.3 同类数据集横向对比
| 数据集 | 机构/地区 | 模态与规模 | 标注 | 相对 JADER 的差异化 |
|---|---|---|---|---|
| JADER | 日本 PMDA | 自发 ICSR,逾 96.5 万例(2025-01);数据 2004-04 起 | MedDRA/J PT、结局、原疾患 | 日本监管框架、医师主导、四表结构、免费公开 |
| FAERS | 美国 FDA | 自发 ICSR,约 2,630 万份(2025-12,去重口径) | MedDRA PT/SOC、role_cod、结局 | 全球最大之一、消费者主导、七表结构、免费开放 |
| VAERS | 美国 CDC/FDA | 疫苗不良事件自发报告,约 270 万份(2025-12) | MedDRA | 专注疫苗;与 JADER 疫苗报告部分可比 |
| VigiBase | WHO / UMC | 全球汇聚,约 4,240 万份(2025-12) | WHO-ART / MedDRA | 160+ 国汇聚;需申请访问 |
| EudraVigilance | 欧盟 EMA | 欧洲自发 ICSR,约 2,500 万份 | MedDRA / WHO | 需注册与合规审核 |
| 黄卡(Yellow Card) | 英国 MHRA | 自发报告,逾 100 万份 | MedDRA | 1964 年建、历史悠久 |
| MID-NET | 日本 PMDA | 真实世界数据网络(非自发报告) | 各源术语 | 有分母的纵向数据库;与 JADER 互补 |
对照要点:JADER 与 FAERS 是文献中最常并列的两个库(同一 E2B/MedDRA 谱系、同为免费开放的国家级自发报告库),差异集中在报告者结构(医师 vs 消费者)、性别分布(均衡 vs 女性为主)、地域(日本 vs 美国/全球)与规模(约 90 万 vs 约 2,630 万)。
§1.4 版本演进时间轴
| 时间 | 里程碑 | 数据含义 |
|---|---|---|
| 2004-04-01 | JADER 数据起始 | 药机法项下企业/医疗机构报告纳入公开范围 |
| 2013 年度起 | 疫苗报告纳入 | 依《预防接种法》由医疗机构报告疫苗相关病例 |
| 2016 年度起 | R3 报告格式引入 | 新报告格式 E2B(R3) 与旧格式 R2 混存,方式在 DEMO 标注 |
| 滚动更新 | 全量覆盖刷新 | 每次更新覆盖目标期间全部数据,非增量;含公开前约 4 个月受理病例 |
| 2025-01 | 学术快照逾 96.5 万例 | J-STAGE 研究基于 2025-05 下载的全量数据 |
| 2025-12-31 | 约 90 万份(去重口径) | Frontiers 四库对比研究口径 |
§1.5 典型 AI 应用场景
- 失衡信号检测:以 ROR/PRR/BCPNN/χ² 构建 2×2 四格表,筛查某药-某事件的不成比例报告,是最主流的用法。
- 时间-发病分析:利用 DRUG 表投药开始日与 REAC 表发現日,刻画药物诱导疾病的时间分布(如药源性帕金森、SJS/TEN)。
- 跨库对照:与 FAERS 并行分析,比较日本与美国在同一药-事件上的报告模式差异,识别地域特异性信号。
- 罕见/未标注副作用假设生成:对未收入说明书的罕见事件做探索性筛查,为后续队列研究提供假设。
- 药物警戒教学与复现:作为结构化、可免费获取的真实自发报告库,供方法学教学与去重/标准化流程复现练习。
- 命名实体与术语归一化:对日文药品名、MedDRA/J 基本语做抽取与归一化,是医疗 NLP 在日语药物警戒语料的落地场景。
不适合:发生率估计、绝对风险计算、药品安全性简单排序、因果推断——这些需要分母与流行病学设计,JADER 本身不提供。
§2 医学背景
§2.1 JADER 与 ICD-11 / MedDRA 的术语锚定
JADER 的副作用字段不使用 ICD 编码,而是以 MedDRA/J(ICH 国际医药用语集日本版)基本语(Preferred Term,PT) 表示,这是官方明示的做法:「用語の統一のため、疾患名は ICH 国際医薬用語集日本語版(MedDRA/J)に収載されている用語(Preferred Term:基本語)で表示します」。
MedDRA 是分层的五级术语体系:LLT(Lowest Level Term,最下位语)→ PT(Preferred Term,基本语)→ HLT(High Level Term,高位语)→ HLGT(High Level Group Term,高位组语)→ SOC(System Organ Class,系统器官分类)。JADER 的 REAC 表以 PT 呈现事件,研究者可自行上卷至 HLT/HLGT/SOC 做聚合分析。常用 MedDRA/J 版本为 v20.1(早期研究)与 v28.0(近期研究),版本漂移会改变 PT 集合,跨论文比较时须冻结版本。
如需将 JADER 事件对齐到 ICD-11 或 SNOMED CT,需经 MedDRA 到目标术语的映射表,JADER 本身不提供此类映射。
§2.2 MedDRA/J 与 SNOMED CT 的关系
| 体系 | 在 JADER 中的角色 | 说明 |
|---|---|---|
| MedDRA/J | 副作用字段的唯一官方编码 | REAC 表「有害事象」列以日语 PT 表示,含 PT Code |
| SNOMED CT | 不直接使用 | 需外部映射表转换;JADER 官方字段无 SNOMED 编码 |
| ICD-10/11 | 不直接使用 | 仅作为对上卷 SOC 的概念参照,非官方字段 |
| ATC | 外接药物分类 | 研究者常将 DRUG 表一般名映射到 ATC(挪威公共卫生研究所维护)做药物类分析 |
| 日本抗胆碱能风险量表 | 外接 | 用于特定研究(如口干症)的药物风险分层 |
§2.3 药物警戒的临床意义
药品上市前的临床试验受限于样本量(通常几千人)、随访时间(数年)与受试人群的均质性,无法捕捉罕见不良反应(发生率 <1/1000)、迟发不良反应与特殊人群/合并用药下的风险。上市后自发报告系统正是为弥补这一缺口而建立:它汇集海量真实世界用药个案,使罕见信号在统计学上浮现。
JADER 在其间承担了日本端口的角色:
- 新药早期信号:日本对新上市药品实行上市后强化收集期,使新药的安全信号更早进入 JADER。
- 地域特异性:日本人群的遗传背景(如 HLA 等位基因分布)与用药习惯不同于欧美,某些不良反应在日本更突出(如特定 HLA 相关的 SJS/TEN)。
- 审批差异:在日本获批而在其他国家未获批的药品(或反之),其安全画像只能从 JADER 获取。
临床研究者用 JADER 做三类工作:①发现尚在假设阶段的潜在风险;②刻画已知不良反应的日本人群特征;③为上市后研究(队列、病例对照)提供假设与样本量估算依据。
§2.4 临床任务定义
在 JADER 上,典型的临床/研究任务可形式化为:
- 信号检测(Signal Detection):给定药物 D 与事件 E,从四表拼出计数
(a, b, c, d)四格表,计算失衡指标,判断是否构成统计信号。 - 药物-事件关联刻画:对某药的全部上报事件,按 SOC 上卷与频次排序,描绘其安全画像。
- 时间-发病建模:用 DRUG 投药开始日与 REAC 发現日之差,拟合某药-事件的发病时间分布。
- 跨库比较:在 JADER 与 FAERS 上对同一药-事件并行计算失衡指标,比较方向与量级。
- 药物类效应分析:将 DRUG 一般名映射到 ATC 类,检验某类药物(如 CCB、抗癫痫药)的类效应。
其中任务 1 是绝对主流;任务 3、4 是近年增长最快的方向。
§2.5 患者人群与报告结构
JADER 覆盖日本境内上报的用药个案,人群特征(据 Frontiers 2026 四库对比):
- 报告者:以医师、药师等专业人员为主(区别于 FAERS 的消费者主导)。
- 性别:接近均衡(区别于 VigiBase/FAERS/VAERS 的女性为主)。
- 年龄:DEMO 表以年龄分组(如 40 岁代、60 岁代)而非连续值呈现,出于隐私考虑。
- 体重/身高:按区间提供,非连续变量。
- 报告来源:企业强制上报 + 医疗机构上报(含文献来源病例)。
- 药品角色:DRUG 表将药品对不良事件的关与分为「被疑药物(suspected)」「并用药物(concomitant)」「相互作用(interacting)」,多数研究仅取 suspected 以减少假阳性。
§2.6 金标准与参考标准
JADER 无官方金标准(它不是监督式基准数据集)。学术实践中的「参考标准」有三类:
- 已确认的已知风险:药品说明书中已载明的风险(如某药的肝损伤黑框警告),作为检验信号检测方法召回率的真阳性集合。
- 跨库交叉验证:在 FAERS、VigiBase 等独立库中复现同一信号,验证其稳健性。
- 有分母的队列证据:以 MID-NET 等日本真实世界数据网络或临床队列研究,为 JADER 信号提供发生率与因果性证据。
重要:任何基于 JADER 的信号都必须经过上述外部验证才能转化为临床结论——JADER 自身只提供假设。
§3 数据集规格
§3.0 版本抉择矩阵
JADER 没有「版本号」式的多版本,但研究者在下载时点与格式口径上必须做抉择:
| 抉择点 | 选项 | 影响 | 建议 |
|---|---|---|---|
| 下载时点 | 任意日期全量快照 | 报告数随时间增长;同一研究须冻结时点 | 论文中明确标注下载日(如「accessed on 2025-05-12」) |
| 报告格式 | R2 仅 / R3 仅 / 混存 | 2016 年度起 R3 与 R2 混存,字段存在差异 | 按研究目的决定;跨格式分析须在 DEMO 中区分 |
| 疫苗报告 | 含 / 不含 | 2013 年度起疫苗病例纳入,可能与药品报告性质不同 | 做药品信号时通常限定非疫苗 |
| 药物角色 | suspected / concomitant / interacting | 取 suspected 可减少假阳性 | 多数研究仅取 suspected |
| MedDRA 版本 | v20.1 / v28.0 / 其他 | PT 集合随版本漂移 | 冻结版本并全文一致 |
核心提示:「JADER 最新版」不是一个稳定对象——每次更新都是全量覆盖,因此任何可复现研究必须冻结下载时点与 MedDRA 版本。
§3.1 模态详细说明
| 表 | 文件命名 | 一条记录的含义 | 关键内容 |
|---|---|---|---|
| DEMO(症例一覧) | demoCCYYMM-n |
一个上报病例 | 识别编号、报告回数、性别、年龄、体重、身高、报告年度·四半期、状況、报告种类、报告者资格、E2B |
| DRUG(医薬品情報) | drugCCYYMM-n |
一个病例中的一种药品 | 识别编号、报告回数、药品连番、药品关与、一般名、販売名、経路、投与开始日、投与结束日、投与量、投与単位、分割投与回数、使用理由、药品处置、再投与再発有无、风险区分(R3) |
| REAC(副作用情報) | reacCCYYMM-n |
一个病例中的一条不良事件 | 识别编号、报告回数、有害事象连番、有害事象、転帰、有害事象の発現日 |
| HIST(原疾患) | histCCYYMM-n |
一个病例的一条原疾患/既往史 | 识别编号、报告回数、原疾患等连番、原疾患等 |
一对多关系:一个病例(识别编号)在 DEMO 中一行,但在 DRUG、REAC、HIST 中可对应多行(多药、多事件、多病史)。96.5 万例病例对应约 251.6 万条不良事件记录(J-STAGE 研究数据),清晰展示了这一结构。
§3.2 样本量拆分
| 口径 | 数值 | 时点 | 来源 |
|---|---|---|---|
| 病例数(全量快照) | 965,285 例 | 2004-04~2025-01 | J-STAGE BBP Reports |
| 不良事件记录数 | 2,516,004 条 | 同上 | 同上 |
| 病例数(去重口径) | 约 90 万份 | 2025-12-31 | Frontiers 2026 |
| 病例数(早期快照) | >600,000 例 | 2004-04~2021-09 | Bioscience Trends |
注意口径差异:965,285 为病例表行数(去重前),约 90 万为对比研究去重口径,>60 万为 2021 年早期快照。三者不矛盾,但绝不可混用。
§3.3 数据格式详情
- 容器:每表一个或多个
.csv文件(逗号分隔),官方支持一括下载或按序号分割下载。 - 字符编码:日文 CSV,字段名为日文(如「識別番号」「有害事象」)。
- 字段映射:官方下载页逐字段列出其对应的 E2B(R3) 与 E2B(R2) 数据项(如「性別」对应 D.5 / B.1.5)。
- 术语编码:不良事件为 MedDRA/J 日文基本语(PT)。
- 时滞:含公开前约 4 个月以内受理的病例(例:2016-08 公开文件含截至 2016-04 受理的报告)。
- 更新语义:全量覆盖——每次下载都是目标期间的全部数据,非增量;研究者须自行保存历史快照。
§3.4 存储大小
全周期 CSV 分四表,因包含数十万至百万级病例的多药、多事件记录,DRUG 表与 REAC 表行数显著大于 DEMO 表。官方不公布固定压缩包大小(随期间与更新滚动),但全量下载通常为数十 MB 级 CSV 文本。
§3.5 标注方式
JADER 不是人工标注数据集——字段内容为报告方(企业/医疗机构)依据 E2B 标准填写的原始上报信息:
- 不良事件:报告方以 MedDRA/J PT 编码,非 PMDA 事后标注。
- 药物角色:报告方标注 suspect/concomitant/interacting。
- 転帰(结局):报告方填写(如死亡、未恢复、恢复等)。
- 无 AI/众包标注:与影像数据集不同,JADER 无「标注者」概念,只有「报告者」。
- PMDA 明确声明不评估因果性:官方明示「PMDA 并未个别评估药品与副作用/有害事件之间的关联性」。
§3.6 报告者资质与一致性
- 报告者资格(DEMO 表「報告者の資格」):医师、药师等专业人员为主,可能含其他资格。
- 报告类型(「報告の種類」):自发报告、临床试验等(E2B A.1.4)。
- 无一致性校验:不同报告者对同一药-事件的编码可能不一致;MedDRA 术语由报告方选择,存在同义异码风险。
- 质量隐忧:部分报告缺少性别/年龄/事件日期,研究者常需剔除或分层处理(如某研究剔除性别缺失 29,976 例、年龄缺失 49,713 例)。
§3.7 采集时间范围
- 药品报告:2004 年 4 月 1 日起(药机法项下)。
- 疫苗报告:2013 年度起(《预防接种法》项下)。
- 持续更新:滚动全量刷新,含公开前约 4 个月受理病例。
§3.8 地域覆盖
以日本国内报告为主。JADER 记录的是日本监管框架内上报的病例,与 VigiBase 的全球汇聚不同——这也是它作为「日本端口」的核心价值。个别病例可能涉及境外信息(如境外厂商上报),但整体以日本人群为绝对主体。
§3.9 采集与编码体系规格
| 维度 | 规格 |
|---|---|
| 法律依据 | 药机法(昭和 35 年法律第 145 号);《预防接种法》 |
| 上报主体 | 制药企业(强制)、医疗机构 |
| 字段标准 | ICH E2B(R2)/(R3) |
| 术语标准 | MedDRA/J 基本语(PT) |
| 结局编码 | 报告方填写(転帰) |
| 报告格式标识 | DEMO 表标注 R2/R3 |
§3.10 深度溯源链
上报者(企业/医疗机构)
  → 依 E2B 标准填写 ICSR
    → 报告方以 MedDRA/J PT 编码不良事件
      → PMDA 按期间汇总为四表 CSV
        → 公开下载(图片验证码)
          → 研究者下载快照 → 本地拼接四表 → 去重 → 失衡分析
§4 数据结构详解
§4.0 目录结构预览
jader_raw/                       # 全周期下载,按表拆分
├── demo202501-1.csv             # 病例一览(症例一覧)
├── demo202501-2.csv             # (分割文件带通序号 -n)
├── drug202501-1.csv             # 药品信息
├── drug202501-2.csv
├── reac202501-1.csv             # 副作用信息
├── reac202501-2.csv
├── hist202501-1.csv             # 原疾患
└── hist202501-2.csv
文件名的
CCYYMM为期间标识;-n为分割序号。官方每次更新覆盖全部数据,因此本地应保存下载快照以备复现。
§4.1 DAIMS 标准化字段描述表
DEMO 表(症例一覧テーブル,demoCCYYMM-n)
| # | CSV 字段名 | 含义 | E2B(R3) | E2B(R2) |
|---|---|---|---|---|
| 1 | 識別番号 | 病例识别编号(主键) | J2.1 | J.4 |
| 2 | 報告回数 | 报告回数 | — | J.5 |
| 3 | 性別 | 性别 | D.5 | B.1.5 |
| 4 | 年齢 | 年龄(分组) | D.2.2/D.2.3/D.2.2.1 | B.1.2.2/B.1.2.3/B.1.2.2.1 |
| 5 | 体重 | 体重(区间) | D.3 | B.1.3 |
| 6 | 身長 | 身高(区间) | D.4 | B.1.4 |
| 7 | 報告年度・四半期 | 报告年度·季度 | — | — |
| 8 | 状況 | 状況 | J2.7.1 | J.6 |
| 9 | 報告の種類 | 报告类型 | C.1.3 | A.1.4 |
| 10 | 報告者の資格 | 报告者资格 | C.2.r.4 | A.2.1.4 |
| 11 | E2B | E2B 标识 | — | — |
DRUG 表(医薬品情報テーブル,drugCCYYMM-n)
| # | CSV 字段名 | 含义 | E2B(R3) | E2B(R2) |
|---|---|---|---|---|
| 1 | 識別番号 | 病例识别编号 | J2.1 | J.4 |
| 2 | 報告回数 | 报告回数 | — | J.5 |
| 3 | 医薬品連番 | 药品连番 | — | — |
| 4 | 医薬品の関与 | 药品关与(suspected/concomitant/interacting) | G.k.1 | B.4.k.1 |
| 5 | 医薬品(一般名) | 药品一般名 | G.k.2.3.r.1 | B.4.k.2.2 |
| 6 | 医薬品(販売名) | 药品贩卖名 | G.k.2.2 | B.4.k.2.1 |
| 7 | 経路 | 给药途径 | G.k.4.r.10.1/G.k.4.r.10.2b | B.4.k.8 |
| 8 | 投与開始日 | 投药开始日 | G.k.4.r.4 | B.4.k.12 |
| 9 | 投与終了日 | 投药终止日 | G.k.4.r.5 | B.4.k.14 |
| 10 | 投与量 | 剂量 | G.k.4.r.1a | B.4.k.5.1 |
| 11 | 投与単位 | 剂量单位 | G.k.4.r.1b | B.4.k.5.2 |
| 12 | 分割投与回数 | 分次给药次数 | G.k.4.r.1(有剂量时置 1) | B.4.k.5.3 |
| 13 | 使用理由 | 使用理由 | G.k.7.r.1/G.k.7.r.2b | B.4.k.11b |
| 14 | 医薬品の処置 | 药品处置 | G.k.8 | B.4.k.16 |
| 15 | 再投与再発有無 | 再给药再发有无 | G.k.9.i.4 | B.4.k.17.1 |
| 16 | リスク区分等 | 风险区分(仅 R3) | J2.5.k | — |
REAC 表(副作用情報テーブル,reacCCYYMM-n)
| # | CSV 字段名 | 含义 | E2B(R3) | E2B(R2) |
|---|---|---|---|---|
| 1 | 識別番号 | 病例识别编号 | J2.1 | J.4 |
| 2 | 報告回数 | 报告回数 | — | J.5 |
| 3 | 有害事象連番 | 不良事件连番 | — | — |
| 4 | 有害事象 | 不良事件(MedDRA/J PT) | E.i.2.1b | B.2.i.2b |
| 5 | 転帰 | 结局 | E.i.7 | B.2.i.8 |
| 6 | 有害事象の発現日 | 不良事件发現日 | E.i.4 | B.2.i.4b |
HIST 表(原疾患テーブル,histCCYYMM-n)
| # | CSV 字段名 | 含义 | E2B(R3) | E2B(R2) |
|---|---|---|---|---|
| 1 | 識別番号 | 病例识别编号 | J2.1 | J.4 |
| 2 | 報告回数 | 报告回数 | — | J.5 |
| 3 | 原疾患等連番 | 原疾患连番 | — | — |
| 4 | 原疾患等 | 原疾患/既往史 | D.7.1.r.1b | B.1.7.1a.2 |
§4.2 标签分布
JADER 无「标签」列,但以下字段构成分析维度:
- 性別:接近均衡(区别于 FAERS 女性为主)。
- 報告者の資格:医师、药师主导。
- 医薬品の関与:suspected / concomitant / interacting。
- 転帰:死亡、未恢复、有后遗症、恢复等。
- 有害事象:MedDRA/J PT,覆盖全疾病谱,长尾极重(大量低频 PT)。
§4.2b 事件与结局结构解读
- 一个病例多事件:REAC 表一个识别编号可含多个有害事象连番,须先聚合再计数。
- 一个病例多药:DRUG 表一个识别编号可含多个药品连番,且每条标有关与角色。
- 严重度判定:JADER 无统一「serious」字段,研究者常以転帰(死亡/未恢复/有后遗症)界定严重病例。
- 重复上报:同一病例可能由多个制造销售商或文献来源重复上报,须按识别编号去重。
§4.3 关键统计
| 指标 | 数值 | 说明 |
|---|---|---|
| 病例数 | 965,285(2025-01) | 去重前病例表行数 |
| 不良事件记录数 | 2,516,004 | REAC 表行数,反映一对多结构 |
| 病例/事件比 | ≈ 1:2.6 | 平均每例约 2.6 条事件记录 |
| 性别缺失 | 29,976 例(某研究口径) | 需处理 |
| 年龄缺失 | 49,713 例(某研究口径) | 需处理 |
§4.4 数据层级关系(识别编号)
病例(識別番号)
├── DEMO:1 行(性别/年龄/体重/身高/报告信息)
├── DRUG:N 行(N 种药品,各带关与角色与投药日期)
├── REAC:M 行(M 条不良事件,各带 PT 与転帰与发現日)
└── HIST:K 行(K 条原疾患/既往史)
四表通过识别编号(+ 报告回数)关联。注意:分割下载的多个文件须先拼接,再按识别编号关联,拼接前后去重顺序会影响计数。
§4.5 缺失值情况与信息性缺失编码
- 无统一缺失码:JADER 不使用统一缺失标识(如
-1/NA),缺失表现为空字段。 - 高缺失字段:年龄、体重、身高、发現日、投与开始/终结日常有缺失。
- 信息性缺失:缺失并非随机——例如消费者上报的病例人口学信息缺失更多,故缺失本身携带报告者特征信息。
- 处理建议:分析前须显式处理缺失(剔除或分层),并在论文中报告剔除数量与比例。
§5 数据划分与使用建议
§5.1 官方数据划分
JADER 官方不提供任何训练/验证/测试划分——它不是监督式机器学习数据集,而是原始报告库。所有划分由研究者按研究目的自定义。
§5.2 推荐划分策略
按任务类型给出可复现的划分建议:
(A)失衡信号检测(主流任务)
不存在「划分」概念,而是「四格表」构建:
对每个(药物 D,事件 E):
  a = 上报 D 且上报 E 的病例数
  b = 上报 D 且未上报 E 的病例数
  c = 未上报 D 且上报 E 的病例数
  d = 未上报 D 且未上报 E 的病例数
→ ROR = (a/b)/(c/d);PRR = [a/(a+b)]/[c/(c+d)];χ² ...
(B)时间-发病分析
按投药开始日与发現日之差分组,通常按季度/年度分层验证时间趋势一致性。
(C)跨库对照
JADER 与 FAERS 各自独立全量分析,不共享划分;比较的是同一药-事件的失衡方向与显著性。
(D)机器学习建模(非主流)
若要做预测任务(如事件严重度分类),建议:按病例识别编号划分(防同病例跨集泄漏)、按年度留出(时间外推)、并冻结 MedDRA 版本。
§5.3 数据泄漏风险防御
| 泄漏类型 | 机制 | 防御 |
|---|---|---|
| 同病例跨集 | 一个病例的多条事件记录被分到不同集合 | 按识别编号整体划分,绝不按行随机划分 |
| 跨表重复 | 同一药-事件计数的分子分母重叠 | 严格按四格表定义,明确「未上报」的含义 |
| 术语版本漂移 | 不同 MedDRA 版本下 PT 集合不同 | 冻结 MedDRA 版本 |
| 重复上报 | 同病例被多报告者重复计入 | 按识别编号去重后再计数 |
| 时间泄漏 | 用未来数据训练、过去数据检验 | 按年度单调划分 |
§5.4 交叉验证建议
- 对信号检测:不需要交叉验证(它是统计推断,非预测建模);用 95% CI 与多方法一致判读替代。
- 对建模任务:用按病例分组的 K 折(GroupKFold,group=识别编号)避免同病例泄漏。
- 时序任务:用滚动窗口前向验证。
§5.5 外部验证
JADER 信号的确认有三条外部路径:
- 跨库复现:在 FAERS(rid=264)、VigiBase 等独立库中复现同一信号。
- 有分母队列:以 MID-NET 等日本真实世界数据网络或临床队列,计算发生率与关联强度。
- 已知风险比对:以说明书已载明的风险作为真阳性,评估方法的召回。
§6 AI 就绪指南
§6.0 云端快速启动
JADER 为纯 CSV 文本,无需 GPU 即可在任意环境处理。典型工作流:下载 → 拼接 → 去重 → 关联 → 失衡分析,全程 CPU 可行。
§6.1 快速上手
# 目录结构预期(全周期下载,按表拆分)
# data/jader_raw/demo202501-1.csv   (症例一覧)
# data/jader_raw/drug202501-1.csv   (医薬品情報)
# data/jader_raw/reac202501-1.csv   (副作用情報)
# data/jader_raw/hist202501-1.csv   (原疾患)

import pandas as pd
import glob

def load_table(prefix, enc="utf-8"):
    files = sorted(glob.glob(f"data/jader_raw/{prefix}*.csv"))
    return pd.concat([pd.read_csv(f, encoding=enc, dtype=str) for f in files],
                     ignore_index=True)

demo = load_table("demo")
drug = load_table("drug")
reac = load_table("reac")
hist = load_table("hist")

print("cases:", len(demo), "drug rows:", len(drug), "reac rows:", len(reac))
# 识别编号(識別番号)+ 報告回数 联合主键
key = ["識別番号", "報告回数"]
# 去重:同一病例可能重复上报
demo = demo.drop_duplicates(subset=key)
# 仅取被疑药物(suspected)
drug = drug[drug["医薬品の関与"] == "被疑薬"]
# 关联:以内连接取同时有藥与事件的病例
merged = reac.merge(drug, on=key, how="inner")
日文字段名:JADER 字段为日文,如「識別番号」「有害事象」「医薬品の関与」。若下载文件的编码为 Shift-JIS,须改
encoding="shift_jis"或"cp932"。
§6.2 数据获取流程
- 访问官方下载页
https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0004.html(日文)或直接到http://www.info.pmda.go.jp/fukusayoudb/CsvDownload.jsp。 - 选择目标期间(全周期或分段)。
- 输入显示的图片验证码(半角),点击下载。
- 选择一括下载或分割下载(分割文件带
-n通序号)。 - 记录下载日期(复现关键),并保存原始快照。
无需注册、无需登录、无需付费;但需通过图片验证码,故不适合脚本自动化批量抓取——研究者通常手动下载一次全量快照。
§6.3 预处理全流程
# 1) 拼接同表分割文件(拼接前后顺序会影响重复判定,先拼接再去重)
demo = load_table("demo"); drug = load_table("drug")
reac = load_table("reac"); hist = load_table("hist")

# 2) 按识别编号+报告回数去重(同一病例可被多报告者重复上报)
key = ["識別番号", "報告回数"]
demo = demo.drop_duplicates(subset=key)
drug = drug.drop_duplicates(subset=key + ["医薬品連番"])
reac = reac.drop_duplicates(subset=key + ["有害事象連番"])

# 3) 移除性别/年龄缺失(如研究需要,须报告剔除数)
demo_c = demo[demo["性別"].notna() & demo["年齢"].notna()]

# 4) 仅保留被疑药物(suspected),减少假阳性
drug_s = drug[drug["医薬品の関与"] == "被疑薬"]

# 5) 以识别编号关联 REAC 与 DRUG,得到病例-药-事件三元组
tri = reac.merge(drug_s, on=key, how="inner")

# 6) 以 MedDRA/J PT 计数据,对目标事件构建四格表
#    事件匹配前务必冻结 MedDRA 版本,避免 PT 漂移
target_pt = "有害事象列中的目标 PT"
event_mask = tri["有害事象"].str.contains(target_pt, na=False)

# 7) 计算 ROR / PRR / χ²(四格表见 §6.9)
顺序陷阱:①必须先拼接再去重(分割文件间可能有跨文件重复);②去重键含「報告回数」;③suspected 限定须在关联前完成。
§6.4 框架加载
import pandas as pd

class JaderCaseDataset:
    """把四表拼成病例级别的 (drug, event) 样本,供失衡分析或建模。"""
    def __init__(self, demo, drug, reac, key=("識別番号", "報告回数")):
        self.key = list(key)
        d = drug[drug["医薬品の関与"] == "被疑薬"]
        self.pairs = reac.merge(d, on=self.key, how="inner")[
            self.key + ["医薬品(一般名)", "有害事象", "転帰"]
        ]

    def target_event_study(self, drug_name, event_pt):
        sub = self.pairs
        a = ((sub["医薬品(一般名)"] == drug_name) &
             (sub["有害事象"].str.contains(event_pt, na=False))).sum()
        b = ((sub["医薬品(一般名)"] == drug_name) &
             (~sub["有害事象"].str.contains(event_pt, na=False))).sum()
        c = ((sub["医薬品(一般名)"] != drug_name) &
             (sub["有害事象"].str.contains(event_pt, na=False))).sum()
        d = ((sub["医薬品(一般名)"] != drug_name) &
             (~sub["有害事象"].str.contains(event_pt, na=False))).sum()
        return a, b, c, d
§6.5 常见坑点
坑 1:把「报告数」当成「发生率」。JADER 只有分子没有分母,报告多不等于风险高。同一报告数在不同暴露人群下含义完全不同。任何「某药最危险」的排名都是错误用法。
坑 2:不做去重直接计数。同一病例可能由多个制造销售商或文献来源重复上报;不去重会使计数虚高。必须按「識別番号」去重(含「報告回数」联合键)。
坑 3:忽略 R2/R3 混存。2016 年度起报告格式 R2 与 R3 混存,字段存在差异(如 R3 独有「リスク区分等」)。跨格式分析须在 DEMO 表区分报告方式,否则字段缺失会被误读。
坑 4:MedDRA 版本漂移。不同研究使用不同 MedDRA/J 版本(v20.1 vs v28.0),PT 集合不同,同一事件的匹配结果不同。跨论文比较或复现时必须冻结版本。
坑 5:把 concomitant/interacting 药物当作被疑药物。DRUG 表含三类关与角色,不限定 suspected 会引入大量假阳性。多数权威研究仅取 suspected。
坑 6:忽视全量覆盖更新的时滞。JADER 每次更新覆盖全部数据、含公开前约 4 个月受理病例,不是增量。用旧快照做「最新趋势」分析会导致结论偏差;跨时点比较必须固定下载日。
坑 7:按行随机划分导致同病例泄漏。REAC/DRUG 中一个病例多行,按行随机划分会把同一病例分散到训练/测试集,造成严重泄漏。必须按识别编号分组划分。
坑 8:日文编码与字段名陷阱。CSV 可能为 Shift-JIS 编码,直接 utf-8 读取会乱码;字段名为日文,需与官方字段字典对照(不可凭英文习惯猜字段)。
§6.6 数据增强
JADER 作为结构化报告库,无需图像式增强。可做的「增强」是信息聚合:
- 术语上卷:将 PT 聚合到 HLT/HLGT/SOC,缓解长尾稀疏。
- 药物归类:将一般名映射到 ATC 类,做类效应分析。
- 时间特征:由投药开始日与发現日派生「发現时间间隔」。
- 跨库对齐:与 FAERS 的 PT 对齐,做联合分析(注意两库 MedDRA 版本可能不同)。
§6.7 模型推荐
- JADER 主流用法不是深度学习,而是统计失衡分析(ROR/PRR/BCPNN/χ²)——透明、可解释、监管认可。
- 若做 NLP 任务(日文药品名/事件抽取),可用日语预训练模型(如日语 BERT 系)。
- 若做严重度预测等建模,建议以梯度提升树(LightGBM/XGBoost)为基线,重视特征可解释性。
- 反对用高容量模型「预测」单个报告的真伪——JADER 无真值标签。
§6.8 计算资源需求
| 任务 | 资源 |
|---|---|
| 全量四表载入 | 内存 8-16 GB 足够(CSV 文本) |
| 失衡分析 | CPU 即可,单机分钟级 |
| 术语上卷/药物映射 | CPU,需 MedDRA/ATC 映射表 |
| 日语 NLP 微调 | 视模型而定,单卡 GPU 可完成 |
§6.9 评估指标代码
import numpy as np
from scipy.stats import chi2_contingency

def signal_metrics(a, b, c, d):
    """a,b,c,d 为去重后四格表计数。"""
    # ROR:报告比值比
    ror = (a / b) / (c / d) if b and c and d else np.nan
    se = np.sqrt(1/a + 1/b + 1/c + 1/d) if min(a, b, c, d) > 0 else np.nan
    ror_l95 = np.exp(np.log(ror) - 1.96 * se) if not np.isnan(se) else np.nan

    # PRR:比例报告比
    prr = (a / (a + b)) / (c / (c + d)) if (a + b) and (c + d) else np.nan

    # χ²:卡方统计量
    chi2 = chi2_contingency([[a, b], [c, d]], correction=False)[0]

    return {"ROR": ror, "ROR_l95": ror_l95, "PRR": prr, "chi2": chi2}

# 判读(常见阈值)
# ROR: 95% CI 下界 > 1;PRR: ≥2 且 χ² ≥ 4;病例数 ≥ 3
§6.10 MLOps 笔记
- 快照管理:JADER 每次全量覆盖,须为每次分析保存下载快照(含下载日期),否则无法复现。
- 版本冻结:MedDRA/J 版本、ATC 映射表版本须与结果一同记录。
- 元数据:记录下载日、期间、字段映射依据(官方 E2B 映射表)。
- 不可自动化下载:图片验证码阻止脚本抓取,流程须人工介入。
§7 质量评估与局限性
§7.1 已知偏倚
| 偏倚类型 | 机制 | 影响 | 缓解 |
|---|---|---|---|
| 低报(underreporting) | 仅部分不良反应被上报 | 计数低估,罕见事件尤甚 | 解读为相对信号而非绝对量 |
| 差异上报 | 受上市时间、媒体报道、文献影响 | 新药与被关注事件偏高 | 分层分析、排除宣传期 |
| 重复上报 | 同一病例多报告者/多厂商 | 计数虚高 | 按识别编号去重 |
| 地域偏倚 | 以日本人群为主 | 不能外推到非日本人群 | 跨库比较时明示地域 |
| 报告者偏倚 | 医师/药师主导,消费者上报少 | 与 FAERS 报告结构不同 | 跨库比较时说明报告者差异 |
| 严重事件偏倚 | 严重事件上报倾向更高 | 结局分布偏严重 | 不据此估严重度比例 |
| 术语编码偏倚 | 报告方自主选 PT | 同义异码、粒度不一 | 上卷到 SOC、冻结版本 |
§7.2 报告质量评估
JADER 无人工作者标注质量(它不是标注数据集),因此「标注一致性」概念不适用。可评估的是上报信息完整度:
- 部分报告缺少性别、年龄、体重、身高、事件日期。
- 缺失率因报告者类型与年代而异。
- 研究者须在方法中报告数据完整度与剔除策略。
§7.3 泛化性讨论
- 人群泛化:以日本人群为主,外推到其他人群需谨慎(遗传背景、用药习惯、审批差异)。
- 时间泛化:报告模式随年代变化(新药上市、疫苗运动、报告政策调整),历史信号未必适用于当前。
- 跨库泛化:JADER 与 FAERS 的报告者结构、性别分布不同,直接套用一库的阈值到另一库可能不适用。
§7.4 伦理考量
- 隐私:公开 CSV 已去除可直接识别个人的信息;年龄/体重/身高以区间/分组呈现。
- 不可反推个人:PMDA 明确不对报告病例的追加信息作出答复,防止个案被重新识别。
- 因果误读风险:JADER 报告不代表药品导致事件;不当使用可能损害公众用药信心。
- 使用合规:须遵守 PMDA 使用注意事项,不得以报告数简单评价或比较药品安全性。
§7.5 公平性评估
- 代表性:日本人群为主体,对全球人群的代表性有限。
- 年龄/性别:报告分布可能不反映真实暴露人群的年龄/性别构成(受上报行为影响)。
- 弱覆盖群体:儿童、孕妇、罕见病患者的上报可能不足,相关信号灵敏度较低。
- 跨库公平:报告者结构(医师主导)可能使某些依赖患者自报的事件(如生活质量类)被低估。
§7.6 数据漂移提示
- 累计漂移:全量覆盖更新,报告总数随时间单调增长;跨时点比较须固定下载日。
- 结构漂移:2016 年度引入 R3 后字段结构变化;2013 年度起疫苗报告纳入。
- 术语漂移:MedDRA 版本升级导致 PT 集合变化。
- 模式漂移:COVID-19 疫苗接种运动显著影响近年报告构成(尤其疫苗相关报告)。
§7.7 DAIMS 24 项数据就绪度评估
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 数据为宽格式(每行一个样本/事件) | ✅ | 四表关系型,DEMO 每报告一行、REAC 每事件一行 |
| 2 | 有唯一标识符列 | ✅ | 識別番号(+ 報告回数)主键 |
| 3 | 无 Unicode 或特殊字符 | ⚠️ | 日文字段名与 MedDRA/J 日文术语,需编码处理 |
| 4 | 无重复行 | ❌ | 同一病例多报告者/多厂商重复上报,须去重 |
| 5 | 缺失值已识别并编码 | ❌ | 表现为空字段,无统一缺失码 |
| 6 | 标签列被明确标识 | ✅ | 有害事象(PT)/転帰/医薬品の関与 均为明确字段 |
| 7 | 已对罕见类别(<3%)进行分组 | ⚠️ | 大量低频 MedDRA PT,无官方分组,须自行上卷 |
| 8 | 偏倚评估已完成 | ✅ | §7.1 列出 7 类偏倚与缓解 |
| 9 | 有完整的数据字典 | ✅ | 官方下载页逐字段映射 E2B(R2)/(R3),附 ER 图 |
| 10 | 对"信息性缺失"有明确编码解释 | ⚠️ | 缺失携带报告者特征,无官方解释,须自行分析 |
| 11 | 数据采集设备和设置已记录 | ✅ | 上报依据(药机法/接种法)与 E2B 标准文档清晰 |
| 12 | 已移除完全共线性变量 | ✅ | 关系表无多余冗余列 |
| 13 | 对编码的映射标准已说明 | ✅ | MedDRA/J、E2B(R2)/(R3) 全文档化 |
| 14 | 对时间戳的处理已明确说明 | ⚠️ | 发現日/投药日常缺失;全量覆盖更新需自行管理快照 |
| 15 | 训练/验证/测试划分建议已给出 | ❌ | 官方无任何划分,须研究者自定义 |
| 16 | 数据泄漏风险已被讨论 | ✅ | §5.3 同病例/跨表/术语/时间四类泄漏 |
| 17 | 标签分布已被分析 | ✅ | §4.2 性别/报告者/关与/结局分布 |
| 18 | 选择性测量偏倚已被讨论 | ✅ | §7.1 + §6.5 坑点(低报/差异上报) |
| 19 | 外部验证建议已给出 | ✅ | §5.5 跨库 / MID-NET / 已知风险 |
| 20 | 数据更新和版本信息已记录 | ✅ | 全量覆盖更新、时间轴完整(§1.4) |
| 21 | 最小必要预处理脚本已提供 | ❌ | 官方无去重/清洗脚本,须自研 |
| 22 | 合规使用要求已明确 | ✅ | 免费公开、依 PMDA 注意事项,无 DUA |
| 23 | 多模态对齐方法已说明 | ⚠️ | 四表靠识别编号对齐,无自动对齐脚本 |
| 24 | 去标识化方法已被记录 | ✅ | 公开 CSV 去标识化,人口学以区间呈现 |
DAIMS 评分:12 / 24
评分解读:偏低——JADER 是一份监管公开监测数据,而非为机器学习设计的就绪数据集。其优势在结构清晰、文档完整、术语规范(四表 + E2B 映射 + MedDRA/J + ER 图 + 免费公开);缺口集中在工程就绪度:无官方去重/清洗脚本、全量覆盖需自行管理快照、日文字段需本地化、缺失无统一编码、无任何划分、R2/R3 混存需处理。
对你意味着什么:使用 JADER 前必须完成五项工程化步骤:①按识别编号去重;②冻结下载快照与 MedDRA 版本;③处理 R2/R3 混存与日文编码;④限定 suspected 药物;⑤对信号做外部验证。与 FAERS(15/24)相比,JADER 因日文界面、全量覆盖更新(非增量季度包)、无英文文档而在工程就绪度上略低,但在日本药物警戒场景中不可替代。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 评估任务 | 性能指标 | 相对内部变化 | 关键发现 |
|---|---|---|---|---|---|
| FAERS | 美国 FDA | 跨库复现药-事件失衡 | ROR/PRR 一致性 | 方向多一致、量级有别 | 报告者结构差异导致稳健性需谨慎解释 |
| VigiBase | WHO / UMC | 全球库交叉验证 | 失衡一致性 | 部分信号不一致 | 跨国库互印证信号稳健性 |
| MID-NET | 日本 PMDA | 有分母队列确认信号 | 流行病学关联/发生率 | 需独立验证 | JADER 失衡仅生成假设,需分母证据 |
| 临床队列 / 病例对照 | 多中心 | 信号特征刻画 | 关联强度 + 临床特征 | 与队列发病率互补 | 自发报告信号须经正式流行病学研究确认 |
§8 基准性能与生态
§8.1 排行榜与评测生态
JADER 没有官方机器学习排行榜(非监督式基准数据集)。其「性能」生态集中于信号检测方法对比,常以已确认风险或跨库交叉验证为准:
| 方法 | 性能定位 | 关键技术 | 典型实现 | 备注 |
|---|---|---|---|---|
| ROR | 最常用快速失衡筛查 | 报告比值比 | 自写(见 §6.9) | 透明、可解释 |
| PRR | MHRA 常用 | 比例报告比 + χ² | 自写 | PRR≥2 且 χ²≥4 |
| BCPNN (IC) | 稀疏稳健、欧洲常用 | 贝叶斯信息成分 | R/Python | IC-2SD>0 |
| χ² | 独立性与统计显著 | 卡方 | scipy | 常与 PRR 联用 |
重要提示:JADER 论文中常以多方法一致判读(同时满足 ROR、PRR+χ² 等阈值)削减假阳性。不同方法阈值、MedDRA 版本、去重口径会显著改变数值,跨论文比较应关注方向与显著性而非绝对值。
§8.2 SOTA 总结与选型建议
JADER 上无单一「最优模型」。学界共识是多方法一致判读 + 外部验证。选型建议:快速筛查用 ROR/PRR(透明);稀疏罕见事件用 BCPNN(收缩稳健);需要监管沟通用 PMDA/EMA 认可的方法。一切以正确的去重、suspected 限定与版本冻结为前提。
§8.3 评测协议
无官方协议,学界通行做法:
- 下载覆盖目标期间的全量 CSV 快照 → 记录下载日。
- 拼接四表 → 按识别编号去重(含报告回数)。
- 限定医薬品の関与 = 被疑薬(suspected),必要时限定适应症(使用理由)。
- 冻结 MedDRA/J 版本 → 以 PT 计数据构建 2×2 四格表。
- 计算 ROR/PRR/χ²(/BCPNN)并给 95% CI。
- 多方法一致判读 + 敏感性分析(去重前后、按报告者/年代分层)。
- 把信号作为假设,用外部独立数据验证。
- 报告完整方法(下载日、期间、MedDRA 版本、去重实现)以保证可复现。
常用信号判读阈值参考:
| 方法 | 判读阈值(常见) | 说明 |
|---|---|---|
| ROR | 95% CI 下界 > 1,病例数 ≥ 2-3 | 点估计 > 2 常作更严信号 |
| PRR | PRR ≥ 2 且 χ² ≥ 4 | MHRA 双条件 |
| BCPNN (IC) | IC-2SD > 0 | 贝叶斯收缩 |
| χ² | ≥ 4(自由度 1,α=0.05) | 独立性检验 |
§8.4 相关数据集
| 数据集 | 机构/地区 | 与 JADER 的关系 |
|---|---|---|
| FAERS | 美国 FDA | 最直接的跨库对照(同 E2B/MedDRA 谱系) |
| VAERS | CDC/FDA | 疫苗报告对照 |
| VigiBase | WHO / UMC | 全球汇聚,跨库验证源 |
| EudraVigilance | 欧盟 EMA | 欧洲自发报告 |
| 黄卡 | 英国 MHRA | 历史悠久(1964 起) |
| MID-NET | 日本 PMDA | 有分母的真实世界数据网络,互补验证源 |
§8.5 关键论文 Top 10
- Global patterns and trends in spontaneous reporting systems: VigiBase, FAERS, VAERS, and JADER (2026). Frontiers in Drug Safety and Regulation. doi:10.3389/fdsfr.2026.1919822 — 四库系统对比,JADER 约 90 万份(2025-12-31)口径来源。
- Analysis of Drug-Induced Xerostomia using the Japanese Adverse Drug Event Report Database (2025). BPB Reports 8(5):133. — 965,285 例、2,516,004 条事件口径来源;ROR/PRR/χ² 三指标实践。
- A Pharmacovigilance Study of Drug-Induced Glaucoma Utilizing the Japanese Adverse Event Reporting System (Dharmasena et al.). Ophthalmol Ther. doi:10.2147/OPTH.S439255 — 2004-04-01 起始、四表结构、剔除缺失实践。
- Time to onset of drug-induced parkinsonism: Analysis using a large Japanese adverse event self-reporting database. Bioscience Trends. — >60 万例(2021-09)、四表字段说明。
- Angioedema Caused by Drugs That Prevent the Degradation of Vasoactive Peptides: A Pharmacovigilance Database Study (2021). PMC8658484. — 四表结构与 JADER 独有特征(审批差异、新药强化收集)。
- Interplay of Spontaneous Reporting and Longitudinal Healthcare Databases for Signal Management (2025). Drug Safety. doi:10.1007/s40264-025-01548-3 — 自发报告库(含 JADER)与纵向数据库互补的立场声明。
- Associations Between Stevens–Johnson Syndrome and Infection (Frontiers). — JADER vs FAERS 对比研究范式、SJS/TEN 信号。
- Bate A et al. (1998). Eur J Clin Pharmacol 54:315-321 — BCPNN/IC 方法奠基。
- Rothman KJ et al. (2004). Pharmacoepidemiol Drug Saf 13(8):519-523 — ROR 方法学。
- PMDA 官方下载页(0004.html)— 四表字段与 E2B 映射、更新规则的权威文档。
§8.6 社区活跃度
JADER 是日本药物警戒研究的标准公共资源:日本及国际学界每年产出大量信号检测论文;PMDA 提供官方下载页与字段字典。社区生态集中于期刊方法论文与研究者自建的 R/Python 分析流程,相比影像数据集,缺少「排行榜竞赛」式的活跃度,但方法学共识度高(去重 + suspected + ROR/PRR 多方法判读已成范式)。
社区使用模式观察:
- 单药或药类信号研究占主流:多数 JADER 论文聚焦某药(类)在某事件的失衡信号(如药物诱导青光眼、帕金森、SJS/TEN、口干症等)。
- 跨库对比增长快:与 FAERS 并列分析成为常见设计,尤其用于刻画地域差异。
- 可复现性痛点:无官方去重脚本、全量覆盖更新、MedDRA 版本漂移、日文界面——使各论文在「下载日、期间、版本、去重实现」上的做法差异大,同一药跨论文计数常不一致。
§8.7 生态快照
| 资源 | 类型 | 链接 | 截至 | 推荐理由 |
|---|---|---|---|---|
| PMDA 数据集下载页 | 官方 | https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0004.html | 2026-10 | 四表字段与 E2B 映射权威 |
| PMDA CSV 下载入口 | 官方 | http://www.info.pmda.go.jp/fukusayoudb/CsvDownload.jsp | 2026-10 | 实际下载入口 |
| JADER 四表 ER 图 | 官方 | https://www.pmda.go.jp/files/000213668.png | 2026-10 | 表关系可视化 |
| 四库对比研究 | 论文 | doi:10.3389/fdsfr.2026.1919822 | 2026-10 | JADER vs 其他自发库 |
| Xerostomia 分析 | 论文 | J-STAGE BPB Reports 8(5):133 | 2026-10 | 完整预处理 + 三指标实现 |
| FAERS 条目(库内) | 互链 | https://www.qianfanghub.com/ai-ready-dataset/faers/264 | 2026-10 | 最直接的跨库对照 |
§9 相关资源与引用
官方资源
- PMDA 官方数据集下载页(日文):https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0004.html
- PMDA CSV 下载入口:http://www.info.pmda.go.jp/fukusayoudb/CsvDownload.jsp
- PMDA 旧入口(论文常用引用路径):https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0003.html
- 四表 ER 图:https://www.pmda.go.jp/files/000213668.png
- PMDA 主页:https://www.pmda.go.jp
BibTeX 引用(核心两件套)
@article{frontiers2026jader,
  title   = {Global patterns and trends in spontaneous reporting systems:
             VigiBase, FAERS, VAERS, and JADER},
  journal = {Frontiers in Drug Safety and Regulation},
  year    = {2026},
  doi     = {10.3389/fdsfr.2026.1919822},
  note    = {JADER contains approximately 0.9 million reports as of 2025-12-31}
}

@article{bpbreports2025xerostomia,
  title   = {Analysis of Drug-Induced Xerostomia using the
             Japanese Adverse Drug Event Report Database},
  journal = {BPB Reports},
  volume  = {8}, number = {5}, pages = {133},
  year    = {2025},
  note    = {965,285 cases and 2,516,004 adverse events (2004-04 to 2025-01)}
}
教程与学习资源
- 官方字段字典(下载页内嵌):逐字段 E2B(R2)/(R3) 映射表
- 四表 ER 图:理解识别编号关联的关键
- 本条目 §6 预处理 Pipeline:可直接复用的 Python 骨架
原始论文与关键文献
见 §8.5 关键论文 Top 10。
§10 AI 使用声明卡
§10.1 AI 模型使用
| 模型 | 时间 | 用途 |
|---|---|---|
| fast-model(WorkBuddy) | 2026-10 | 初稿生成:INFOBOX 数据汇编、§1-§9 结构化写作、§6 代码示例生成、JSON-LD 构建 |
§10.2 AI 参与范围
AI 参与:资料汇编、结构化写作、代码骨架生成、术语表与 FAQ 起草。所有硬数字(报告数、起始日期、四表字段、E2B 映射)均经人工对照 PMDA 官方下载页与同行评议文献核验。
§10.3 输入来源
PMDA 官方下载页(0004.html)、Frontiers 2026 四库对比研究、J-STAGE BPB Reports(Xerostomia)、Tandfonline OPTH(青光眼)、Bioscience Trends(帕金森)、PMC8658484(血管性水肿)、Springer Drug Safety 立场声明、Frontiers SJS/TEN 研究。
§10.4 人工校验表
| 章节 | 校验者 | 校验方式 | 结果 |
|---|---|---|---|
| §1.4 版本时间轴(2004-04 起始、2013 疫苗、2016 R3) | 千方病案医学编辑部 | 对照 PMDA 官方页 + 多篇论文 | ✅ 已验证 |
| §3.1/§4.1 四表字段与 E2B 映射 | 千方病案医学编辑部 | 逐字段对照 PMDA 官方下载页 | ✅ 已验证 |
| §4.3 关键统计(965,285 例 / 2,516,004 事件) | 千方病案医学编辑部 | 对照 J-STAGE 论文 | ✅ 已验证 |
| §7 质量评估与 DAIMS 评分 | 千方病案医学编辑部 | 交叉审核 | ✅ 已通过 |
§10.5 AI 生成章节标注
以下章节由 AI 生成初稿并经人工审核:§1.0 30 秒速览、§3.0 版本抉择矩阵、§6.0-§6.4 代码示例、§6.5 八个坑点、§6.9 评估指标代码、§7.5 公平性评估、§7.7 DAIMS 评估表与评分、§8.7 生态快照、§C JSON-LD。
§10.6 最后审核
审核日期:2026-10-16
审核结论:通过。四表字段、起始日期、报告规模口径已三源互证;双口径冲突(报告总数、建立年份)已在 §11/FAQ/附录逐条存照。
FAQ(高频问答 28 问)
A. 基础认知
Q1:JADER 是什么?
JADER(Japanese Adverse Drug Event Report database)是日本 PMDA 公开的药品不良事件自发报告数据库,汇集日本企业/医疗机构上报的副作用疑似病例,以四张 CSV 表(DEMO/DRUG/REAC/HIST)提供。
Q2:JADER 和 FAERS 有什么区别?
FAERS 是美国 FDA 的库(约 2,630 万份,消费者主导,女性为主);JADER 是日本的库(约 90 万份,医师主导,性别接近均衡)。两者同属 E2B/MedDRA 谱系,是跨库对比的标准组合。
Q3:JADER 是「日本版 FAERS」吗?
部分可比但不是简单对应。JADER 只有四表(FAERS 有七表),且日本有独特的审批差异与新药强化收集制度,数据规模也远小。
Q4:JADER 的数据从什么时候开始?
2004 年 4 月 1 日起(药机法项下企业/医疗机构报告);疫苗相关病例自 2013 年度起纳入。
Q5:JADER 有多少数据?
截至 2025 年初约 96.5 万例(对应约 251.6 万条不良事件记录);2025 年末去重口径约 90 万份。
Q6:JADER 用什么术语编码?
不良事件以 MedDRA/J(ICH 国际医药用语集日本版)基本语(PT)编码;字段映射 ICH E2B(R2)/(R3)。
B. 数据与获取
Q7:JADER 免费吗?
免费公开下载,无需注册、无需付费,但需通过图片验证码。
Q8:怎么下载 JADER?
访问 PMDA 下载页(0004.html)或下载入口(CsvDownload.jsp),选期间、输入验证码、选一括或分割下载。
Q9:JADER 是增量更新吗?
不是。官方每次更新覆盖目标期间的全部数据,非增量。研究者须自行保存历史快照。
Q10:JADER 有英文版吗?
字段与术语为日文,官方未提供英文数据集。使用需处理日文编码(可能为 Shift-JIS)。
Q11:JADER 有许可协议吗(CC?)?
PMDA 未提供英文标准许可声明;数据为政府公开发布、免费下载、使用受 PMDA 注意事项约束。不可擅自标注为 CC 协议。
Q12:数据有滞后吗?
有。公开文件含公开前约 4 个月以内受理的病例(例:2016-08 文件含截至 2016-04 受理报告)。
C. 统计与发现
Q13:能算某药的不良反应发生率吗?
不能。JADER 只有分子没有分母,不含暴露人数,无法计算发生率或风险。
Q14:报告多的药更危险吗?
不能这样理解。报告数受上市时间、用药人数、上报行为影响,不等于风险。PMDA 明确禁止以报告数简单评价药品安全性。
Q15:JADER 报告能证明因果吗?
不能。自发报告仅生成假设,Q4 因果关系须靠队列/病例对照研究确认。
Q16:什么是 ROR / PRR?
都是失衡分析指标:ROR 为报告比值比,PRR 为比例报告比。常见阈值 ROR 95%CI 下界 >1、PRR≥2 且 χ²≥4。
Q17:为什么必须去重?
同一病例可能被多个制造销售商或文献来源重复上报,不去重会使计数虚高。
Q18:为什么只取「被疑药物」?
DRUG 表含 suspected/concomitant/interacting 三类角色,取 suspected 可减少假阳性——这是多数权威研究的做法。
Q19:MedDRA 版本重要吗?
重要。不同版本 PT 集合不同,同一事件匹配结果会变。跨研究比较须冻结版本。
Q20:JADER 的信号方法有哪些?
ROR、PRR、χ²、BCPNN(信息成分 IC)等;常以多方法一致判读削减假阳性。
D. 工程与复现
Q21:四表怎么关联?
通过识别编号(識別番号,联合報告回数)关联。一个病例在 DEMO 一行,在 DRUG/REAC/HIST 可多行。
Q22:分割下载的文件要处理吗?
要。先拼接同表的所有分割文件,再做去重与关联——顺序会影响重复判定。
Q23:可以直接按行随机划分训练/测试吗?
不可以。一个病例多行,按行随机会造成同病例跨集泄漏。须按识别编号整体划分。
Q24:R2/R3 混存是什么?
2016 年度起新报告格式 R3 与旧格式 R2 混存,字段有差异(如 R3 独有「リスク区分等」)。DEMO 表标注报告方式。
Q25:能自动抓取 JADER 吗?
不能直接自动化,图片验证码阻止脚本抓取。通常人工下载一次全量快照。
Q26:怎么保证可复现?
记录下载日期、冻结 MedDRA 版本与 ATC 映射、报告去重与剔除策略、保存原始快照。
E. 使用与库内
Q27:JADER 适合做什么任务?
信号检测、时间-发病分析、跨库对照、假设生成、药物警戒教学。
Q28:JADER 和库内哪些条目相关?
最直接的是 FAERS(rid=264);另可参照 VigiBase、MID-NET 等(库外)。
事实清单(硬事实 34 条)
- JADER 全称 Japanese Adverse Drug Event Report database,日文官方名「副作用が疑われる症例報告に関する情報」。
- 管理机构为日本 PMDA(独立行政法人 医薬品医療機器総合機構)。
- 数据起始日期为 2004 年 4 月 1 日(药机法项下)。
- 疫苗相关病例自 2013 年度起纳入(依《预防接种法》)。
- 2016 年度起引入 R3 报告格式,与 R2 混存。
- 数据由四张 CSV 表构成:DEMO(病例一览)、DRUG(药品信息)、REAC(副作用信息)、HIST(原疾患)。
- 四表以病例识别编号(識別番号)+ 報告回数 关联。
- 文件名格式:
demoCCYYMM-n/drugCCYYMM-n/reacCCYYMM-n/histCCYYMM-n。 - 不良事件以 MedDRA/J 基本语(PT)编码。
- 字段映射 ICH E2B(R2) 与 E2B(R3) 数据项。
- 官方每次更新全量覆盖,非增量。
- 公开文件含公开前约 4 个月以内受理的病例。
- 数据免费公开下载,无需注册,但需通过图片验证码。
- 官方支持一括下载与分割下载(分割文件带
-n通序号)。 - 至 2025 年初累计 965,285 例(J-STAGE 口径)。
- 对应 2,516,004 条不良事件记录。
- 2025 年末去重口径约 90 万份(Frontiers 2026)。
- 早期(2021-09)快照逾 60 万例(Bioscience Trends)。
- JADER 报告者以医师、药师为主。
- JADER 性别分布接近均衡(区别于 FAERS 女性为主)。
- DRUG 表药品关与分 suspected/concomitant/interacting 三类。
- 病例年龄以分组呈现,体重/身高以区间呈现(隐私考虑)。
- PMDA 明确不个别评估药品与副作用的关联性。
- PMDA 提示不得以报告数简单评价或比较药品安全性。
- 同一病例可能由多个制造销售商或文献来源重复上报。
- 官方提供四表 ER 图(000213668.png)。
- 联系方式:fukusayou-database[at]pmda.go.jp(安全性情報・企画管理部)。
- JADER 无官方机器学习排行榜或金标准。
- JADER 提供任何训练/验证/测试划分。
- 常用信号方法为 ROR、PRR、χ²、BCPNN。
- 常用判读阈值:ROR 95%CI 下界 >1;PRR≥2 且 χ²≥4。
- JADER 是「日本 vs 美国」跨库对比研究的标准亚洲对照库。
- 与 FAERS 相比规模小约一个数量级(约 90 万 vs 约 2,630 万)。
- JADER 无官方数据集 DOI。
术语表(30 条)
| 术语 | 英文/全称 | 释义 |
|---|---|---|
| JADER | Japanese Adverse Drug Event Report database | 日本药品不良事件报告数据库 |
| PMDA | Pharmaceuticals and Medical Devices Agency | 日本医药品医疗器械综合机构 |
| ICSR | Individual Case Safety Report | 个例安全报告 |
| 自发报告 | Spontaneous Reporting | 由报告者主动上报的不良事件报告 |
| MedDRA | Medical Dictionary for Regulatory Activities | ICH 国际医药用语集 |
| MedDRA/J | MedDRA Japanese version | MedDRA 日本版 |
| PT | Preferred Term | 基本语(MedDRA 分层中的一级) |
| LLT | Lowest Level Term | 最下位语 |
| HLT | High Level Term | 高位语 |
| HLGT | High Level Group Term | 高位组语 |
| SOC | System Organ Class | 系统器官分类 |
| E2B | Electronic Transmission of ICSR | ICSR 电子传输标准(R2/R3 版本) |
| 症例一覧 | — | DEMO 表,病例一览 |
| 医薬品情報 | — | DRUG 表,药品信息 |
| 副作用情報 | — | REAC 表,不良反应信息 |
| 原疾患 | — | HIST 表,原疾患/既往史 |
| 識別番号 | — | 病例识别编号(主键) |
| 報告回数 | — | 报告回数(联合主键) |
| 医薬品の関与 | — | 药品关与角色(suspected/concomitant/interacting) |
| 被疑薬 | Suspected drug | 被怀疑与不良事件相关的药物 |
| 并用薬 | Concomitant drug | 并用药物 |
| 転帰 | Outcome | 结局(死亡/未恢复/恢复等) |
| 有害事象 | Adverse event | 不良事件 |
| 投与開始日 | — | 投药开始日 |
| 発現日 | — | 不良事件发現日 |
| ROR | Reporting Odds Ratio | 报告比值比 |
| PRR | Proportional Reporting Ratio | 比例报告比 |
| BCPNN / IC | Bayesian Confidence Propagation Neural Network / Information Component | 贝叶斯置信传播神经网络 / 信息成分 |
| 失衡分析 | Disproportionality Analysis | 基于报告比失衡的信号检测方法 |
| FAERS | FDA Adverse Event Reporting System | 美国 FDA 不良事件报告系统 |
附录
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| slug | jader |
| 官方名 | JADER(Japanese Adverse Drug Event Report database) |
| 机构 | 日本 PMDA |
| 官网 | https://www.pmda.go.jp/safety/info-services/drugs/adr-info/suspected-adr/0004.html |
| 数据起始 | 2004-04-01 |
| 规模 | 逾 96.5 万例(2025-01) |
| 结构 | 四表:DEMO/DRUG/REAC/HIST |
| 术语 | MedDRA/J(PT) |
| 获取 | 免费公开,图片验证码 |
| 库内互链 | FAERS(rid=264) |
附录 B:DAIMS 评估全表
见 §7.7(24 项,评分 12/24)。
附录 C:逐项证据链自证
| 事实 | 来源 |
|---|---|
| 数据 2004-04-01 起 | PMDA 官方页 + OPTH 论文 + Bioscience Trends |
| 2013 疫苗纳入 | PMDA 官方页 |
| 2016 R3 引入 | PMDA 官方页 |
| 四表字段与 E2B 映射 | PMDA 官方页逐字段 |
| 965,285 例 / 2,516,004 事件 | J-STAGE BPB Reports |
| 约 90 万份(2025-12) | Frontiers 2026 |
| >60 万(2021-09) | Bioscience Trends |
| 医师主导、性别均衡 | Frontiers 2026 |
| 免费公开 + 图片验证码 | PMDA 官方页 |
| 全量覆盖更新 | PMDA 官方页 |
附录 D:数据获取决策树
想研究日本药品安全?
├── 需要原始报告 → JADER(本条目)
│    ├── 做信号检测 → 下载全量 → 去重 → suspected → ROR/PRR
│    └── 做跨库对比 → JADER + FAERS(rid=264)并行
├── 需要发生率/分母 → MID-NET 或临床队列
└── 需要疫苗专项 → JADER 疫苗子集 或 VAERS
附录 E:四表字段映射与使用规范
见 §4.1 DAIMS 字段表(DEMO/DRUG/REAC/HIST 逐字段 E2B(R2)/(R3) 映射)。
附录 F:预处理 SOP 骨架
见 §6.3 预处理全流程(拼接→去重→suspected→关联→四格表)。
附录 G:失衡分析代码骨架
见 §6.9(ROR/PRR/χ² 计算函数)。
附录 H:JADER vs FAERS 结构对照表
| 维度 | JADER | FAERS |
|---|---|---|
| 机构 | 日本 PMDA | 美国 FDA |
| 表数 | 四表(DEMO/DRUG/REAC/HIST) | 七表(DEMO/DRUG/REAC/OUTC/RPSR/THER/INDI) |
| 起始 | 2004-04 | 2004Q1(公开数据) |
| 规模 | 约 90 万份 | 约 2,630 万份 |
| 报告者 | 医师、药师主导 | 消费者主导 |
| 性别 | 接近均衡 | 女性为主 |
| 更新 | 全量覆盖 | 季度非累计 |
| 主键 | 識別番号 + 報告回数 | PRIMARYID / CASEID |
| 术语 | MedDRA/J | MedDRA |
附录 I:统计指标计算公式表
| 指标 | 公式 |
|---|---|
| ROR | (a/b)/(c/d) |
| PRR | [a/(a+b)] / [c/(c+d)] |
| χ² | 卡方独立性检验(2×2) |
| IC | log₂[(a·N)/((a+b)(a+c))](BCPNN 简化) |
附录 J:双口径存照总表
| 争议点 | 口径 A | 口径 B | 采信 |
|---|---|---|---|
| 报告总数 | 60 万(2021-09) | 96.5 万(2025-01)/ 约 90 万(2025-12) | 采信 90-96.5 万并存照 |
| 建立年份 | 2004(多源一致) | Springer 写 2024 | 采信 2004,Springer 列为误差 |
| 四表名 | demo/drug/reac/hist(官方) | 个别论文写 HISTO | 采信官方 hist |
| 报告规模(Springer) | >100 万 | 其他源 90-96.5 万 | 采信 90-96.5 万 |
附录 K:PMDA 使用注意事项要点(原文口径转述)
- CSV 按目标期间全量覆盖更新,非增量。
- 提供内容为制药企业报告的信息,PMDA 未个别评估关联性。
- 不得以报告病例数简单评价或比较药品安全性。
- 同一病例可能重复上报。
- 术语以 MedDRA/J 基本语表示。
- 含公开前约 4 个月受理病例。
- 需图片验证码后下载。
附录 L:与库内 FAERS 条目(rid=264)的关系声明
JADER 与 FAERS 是两个独立的国际自发报告数据库,非同物别名、非版本关系、非合并视图。两者同属 E2B/MedDRA 谱系(结构可比),但在机构、地域、规模、报告者结构上不同。本条目与 FAERS 条目互为跨库对照关系,建议在「日本 vs 美国」药物警戒研究中并列使用。
附录 M:检索路径建议
- 想找日本药物警戒原始数据 → JADER(本条目)。
- 想找美国对照库 → FAERS(rid=264)。
- 想找有分母的真实世界数据 → MID-NET(库外)。
- 想找全球汇聚 → VigiBase(库外)。
附录 N:报告规模口径对照表
| 时点 | 报告数 | 来源 | 口径备注 |
|---|---|---|---|
| 2021-09 | >600,000 | Bioscience Trends | 病例数(早期快照) |
| 2025-01 | 965,285 | J-STAGE | 病例表行数(去重前) |
| 2025-12-31 | 约 900,000 | Frontiers 2026 | 去重口径 |
| 「established in 2024」句 | >1,000,000 | Springer 2025 | 疑似误差,不计主口径 |
附录 O:术语与编码体系速查
MedDRA 五级:LLT → PT → HLT → HLGT → SOC。JADER 以 PT 呈现事件,可自行上卷。E2B(R2) 为旧格式(≤2015 年度报告),E2B(R3) 为 2016 年度起新格式,两者混存。
附录 P:坑点档案(与 §6.5 对照)
| 坑 | 一句话 | 后果 |
|---|---|---|
| 坑 1 | 报告数当发生率 | 错误风险结论 |
| 坑 2 | 不去重 | 计数虚高 |
| 坑 3 | 忽略 R2/R3 | 字段缺失误读 |
| 坑 4 | MedDRA 版本漂移 | 不可复现 |
| 坑 5 | 未限定 suspected | 假阳性 |
| 坑 6 | 忽视全量覆盖时滞 | 趋势偏差 |
| 坑 7 | 按行随机划分 | 同病例泄漏 |
| 坑 8 | 日文编码/字段名 | 乱码/字段错配 |
附录 Q:检索决策树
见附录 D。
附录 R:复现检查清单
- [ ] 记录下载日期
- [ ] 保存原始 CSV 快照
- [ ] 冻结 MedDRA/J 版本
- [ ] 按识别编号去重
- [ ] 限定 suspected 药物
- [ ] 拼接分割文件后再去重
- [ ] 报告剔除的缺失病例数
- [ ] 多方法一致判读
- [ ] 外部验证信号
- [ ] 全文统一口径
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- eudravigilance — 共享标签:药物发现与化学 / 公共卫生与流行病学 / 药物安全 / 疾病监测 / 真实世界数据
- fda-sentinel — 共享标签:药物发现与化学 / 公共卫生与流行病学 / 药物安全 / 真实世界数据
- faers — 共享标签:药物发现与化学 / 药物安全 / 疾病监测 / 真实世界数据
- optum-clinformatics — 共享标签:药物发现与化学 / 公共卫生与流行病学 / 药物安全 / 真实世界数据
- face-oral-temp-data — 共享标签:公共卫生与流行病学 / 疾病监测 / 真实世界数据
- offsides — 共享标签:药物发现与化学 / 药物安全 / 真实世界数据
- meddra — 共享标签:药物发现与化学 / 公共卫生与流行病学
- ctd — 共享标签:药物发现与化学 / 公共卫生与流行病学 / 疾病监测
- trinetx — 共享标签:药物发现与化学 / 药物安全 / 真实世界数据
- openfda — 共享标签:公共卫生与流行病学 / 药物安全 / 真实世界数据
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。