信息速览
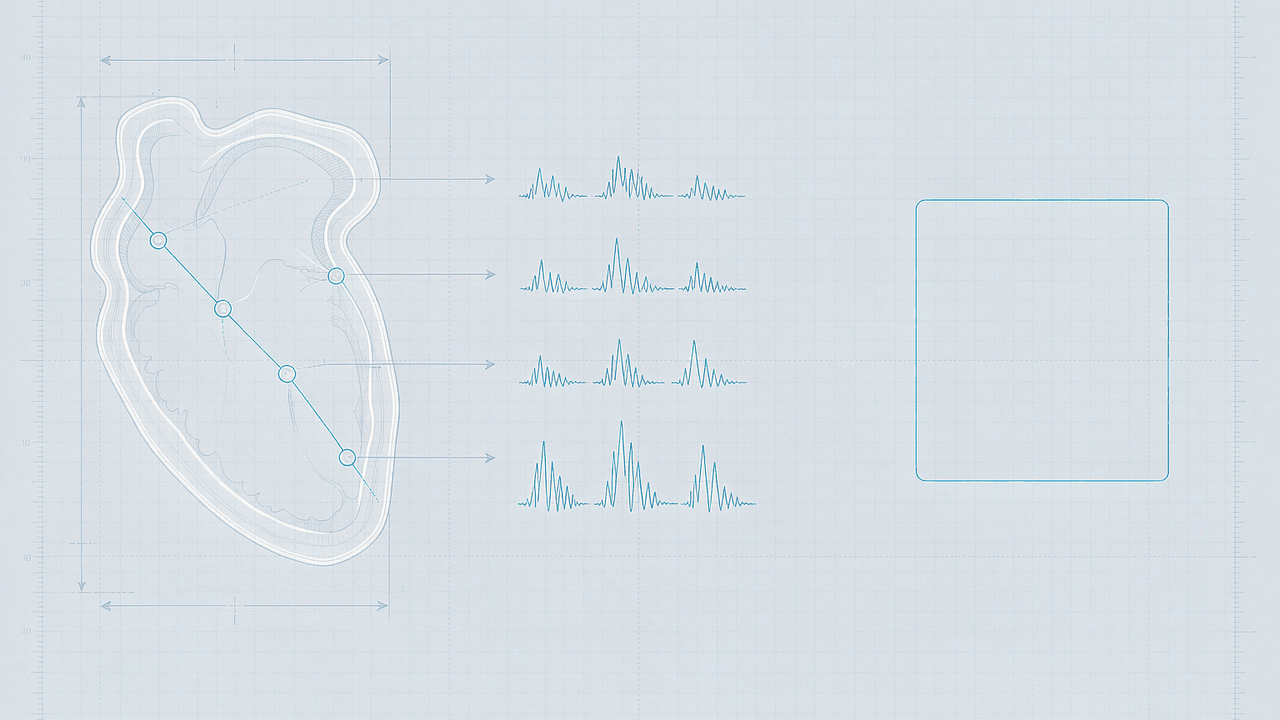
心内房颤数据库(Intracardiac Atrial Fibrillation Database,iafdb)是 PhysioNet 上一个体量很小、取材位置很偏的数据集:八位房颤或房扑患者,在一次电生理检查中把一根十极导管依次放到右心房的四个位置,同时录下五路心内双极信号与三路体表心电,全部按 1 kHz、14 位量化,共三十二条记录。
它偏在两点。一是通道取自心腔内部,测的是电极贴壁处的局部心房电活动,而不是体表投影;二是它没有节律标注,也没有校准过的毫伏刻度,附带的一套 QRS 注释由自动检测器一次生成、从未人工校对。这两点决定了它更像一小份可用于验证机制假设的原始素材,而不是一块能直接喂给模型的训练集。
全库未压缩 102.8 MB,按 ODC-BY 1.0 授权,下载不需要注册。下文先说清它能回答什么、不能回答什么,再逐层拆开文件结构、采集场景与取数路径。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 全名 | Intracardiac Atrial Fibrillation Database |
| 常用缩写 | iafdb |
| 托管平台 | PhysioNet(MIT 主导的生理信号数据平台) |
| 版本与日期 | 1.0.0,2003 年 3 月 4 日发布,此后未再修订 |
| 贡献方 | Creare, Inc.;致谢列出 Jon Peterson 与 Dave Kynor |
| 受试者 | 8 位,心房颤动或心房扑动,年龄 58–81 岁,五男三女 |
| 记录数 | 32 条,每位患者四个导管位置各一条 |
| 通道 | 每条 8 路:5 路心内双极 + 3 路体表心电 |
| 采样与量化 | 1000 Hz,14 位,幅度未校准 |
| 单条时长 | 48.0 秒至 1369.3 秒,全库合计约 1.86 小时 |
| 标注 | 仅 QRS 位置,sqrs 自动生成,未校正 |
| 体积 | 未压缩 102.8 MB |
| 许可 | ODC-BY 1.0,署名即可商用 |
| DOI | 10.13026/C23S33 |
| 官方入口 | https://physionet.org/content/iafdb/1.0.0/ |
§1 它要解决的具体麻烦
1.1 体表心电看不见心房正在做什么
心房颤动在体表心电图上的样子,是一串细而不规则的 f 波,幅度常在 0.1 毫伏量级,还要和 QRS 波群、T 波抢同一段时间轴。想把 f 波单独拿出来,得先做模板减除,减除的残差里又混着残余 QRS 与基线漂移。也就是说,体表信号里关于心房的信息一直都在,只是被压在别的东西下面。
心内电图绕开了这个问题。电极贴在心房壁上,测的是几个毫米范围内的心肌除极,幅度比体表大一到两个数量级,不受心室远场主导,也不需要减除。代价是必须做有创检查:导管要进心腔,患者要在导管室里躺上一段时间,记录只能在这段时间里完成。这就是为什么公开的心内电图库远比体表库稀少——它天然是临床操作的副产品,不是可以随手收集的数据。
iafdb 就是这样一个副产品。它记录的不是「一个患者的一次房颤」,而是「一根导管在四个位置各停一会儿时,附近心肌在做什么」。前者是诊断问题,后者是机制问题。
1.2 三条常见的错误期待
期待一:把它当成房颤检测的训练集。 库里有三十二条记录,八位患者,没有一条写明「第几秒到第几秒是房颤」。房颤与房扑的分界、发作与终止的时刻,全靠使用者自己从波形上判断。拿它训练分类器,标签是二次构造的,构造规则一旦不写清楚,结果就无法复现。
期待二:把它当成 afdb 或 ltafdb 的补充训练数据。 那两者是体表长时程记录,采样率 250 Hz 与 128 Hz,通道数是 2;这里是心内八通道、1 kHz。通道语义、幅度量纲、噪声结构全部不同,混在一起训练不会增加样本量,只会增加一个需要解释的域差异。
期待三:以为 1 kHz 加 14 位就等于高保真。 采样率确实够高,1 毫秒的时间分辨率足以看清局部激动的时间差;但幅度没有校准,增益字段写的 3277 只是个名义值。频率成分可信,绝对幅度不可信,这个区分决定了能做频谱分析而不能做幅度比较。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 看清心房局部激动的时序 | 5 个极对沿导管排列,同一时刻的局部电图 | 够,但只沿一条线 |
| 计算心房激动的主导频率 | 1 kHz 采样,频率分辨率足够 | 够,需自己选窗与去趋势 |
| 观察药物对房颤的影响 | 游离壁记录含给药与洗脱全过程 | 够,但只有两种药、八个案例 |
| 训练房颤检测或分类模型 | 无节律标签,无独立测试集 | 不够 |
| 做多导联体表心电算法 | 只有 3 路体表,且导联组合不统一 | 不够 |
| 做心房解剖或影像配准 | 只有四张示意照片,无坐标 | 不够 |
| 比较不同患者的信号幅度 | 幅度未校准 | 不够 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 在验证一个从心内电图估计主导频率的算法 | 提供 1 kHz、多极对、真实房颤与房扑波形 | 固定窗长与去趋势方法,逐记录报告,不要跨患者汇总 |
| 在做一个导管标测系统的回放或可视化 | 八通道同步、时间对齐、体表与心内可对照 | 用 §2.3 的读取流程按记录拼出多轨视图 |
| 想研究腺苷或异丙肾上腺素对房颤频率的作用 | 游离壁记录含给药前后与洗脱段 | 以头文件给出的近似秒数为锚点,前后各取固定窗 |
| 在教心内电图与体表心电的关系 | 同一时刻两路都在,可逐拍对照 | 取一条短记录,先看体表再看心内 |
| 需要一份体量极小、能反复重跑的压力测试素材 | 全库百兆,一次下载可完整放进内存 | 把它当作管线冒烟测试,不当评测集 |
| 在给一篇机制论文找公开可引用的原始数据 | 有 DOI 与固定版本号 | 引用时写清版本与记录名,见 §9.3 |
1.5 一句话判断
它不是用来教会模型认出房颤的,而是用来让一条从心腔内取数的管线跑通、并且让「局部激动到底长什么样」这个问题有一个可复现的答案。
1.6 不适合谁:四条边界
不适合拿它做任何患者级统计。 八个人,五男三女,年龄集中在五十八到八十一岁,全部是接受电生理检查的房颤或房扑患者。这既不是人群样本,也不是连续入组,任何「房颤患者的平均某指标」都不会成立。
不适合拿它做节律检测的评测。 没有节律段标注,就没有可对齐的真值区间。哪怕自己标一遍,也只有一个人标过,没有一致性检验,评出来的数字无法与别人的结果比较。
不适合拿它做左心房相关的工作。 导管只进右心房,四个位置全在右心系统。肺静脉口、左房后壁、左心耳这些消融靶点区域,一条记录都没有。
不适合拿它做绝对幅度的比较。 心内双极的幅度取决于电极与心肌的接触压力、极间距、组织阻抗,同一患者不同时刻都能差出几倍。官方在每个头文件里都写了未校准,这不是可以绕过的技术细节。
§2 数据构成与规格
2.1 一条记录由三个文件组成
数据库沿用 WFDB 格式。这是 PhysioNet 从 1980 年代沿用至今的生理信号存储规范,一条记录由同名三个文件构成:.hea 是纯文本头文件,第一行写记录名、信号路数、采样率与每条信号的采样点数,随后每路信号一行,声明存储格式、增益、位宽、基线、初始值与校验和;.dat 是二进制信号本体,八路信号按采样点交错存放;.qrs 是二进制注释文件,只存 QRS 波的位置。
三者缺一不可。只拿 .dat 无法还原物理量,因为增益与位宽写在头文件里;只拿 .qrs 不知道这些时刻对应什么波形;只拿 .hea 更是什么都拿不到。目录里另有两份清单:RECORDS 是三十二行纯文本,逐行列出记录名;ANNOTATORS 只有一行,原文是「qrs unaudited beat annotations」,一句话交代了注释的性质——心搏注释,且未经审核。figures 子目录放六张示意图:五张是导管在心脏模型中的摆位,一张是整体位置图。
附属文件各司其职:RECORDS 是三十二行纯文本,逐行一个记录名,批量循环时直接读;ANNOTATORS 只有一行,声明注释的性质;SHA256SUMS.txt 是逐文件校验和,2019 年补入;figures 目录放六张示意图,五张是导管在各位置的摆位,一张是右心房与右心室的剖面总图。没有任何一个文件是可删的冗余——RECORDS 省掉了手工拼记录名,ANNOTATORS 提前说清了标注的成色,校验和则让「下载是否完整」有了客观判断。
2.2 字段与记录的完整字典
| 位置 | 字段 | 含义 | 取值示例 |
|---|---|---|---|
.hea 第 1 行 |
记录名 | 患者编号加导管位置 | iaf1_afw |
.hea 第 1 行 |
信号路数 | 固定为 8 | 8 |
.hea 第 1 行 |
采样率 | 每秒采样点数,全库一致 | 1000 |
.hea 第 1 行 |
采样点数 | 每路信号的样本数 | 154500 |
.hea 信号行 |
存储格式 | 16 表示每样本两字节整数 | 16 |
.hea 信号行 |
增益 | 名义增益,单位为每毫伏的整数单位数 | 3277 |
.hea 信号行 |
位宽 | 量化位数 | 14 |
.hea 信号行 |
基线 | 零电平对应的整数值 | 0 |
.hea 信号行 |
初始值 | 第一个样本的整数值 | -578 |
.hea 信号行 |
校验和 | 全段样本累加和 | -3020 |
.hea 信号行 |
信号名 | 体表导联名或心内极对名 | V1 / CS34 |
.hea 注释行 |
年龄 | 整数,岁 | 81 |
.hea 注释行 |
性别 | M 或 F | F |
.hea 注释行 |
诊断 | 自由文本,三种写法并存 | Atrial Flutter |
.hea 注释行 |
用药 | 药名清单,逗号分隔 | Atenolol, Monopril |
.hea 注释行 |
注射时刻 | 药名加秒数,可多次 | Adenosine injected at 120, 261 sec |
.qrs |
注释位置 | 采样点序号,除以 1000 得秒 | 1104 |
.qrs |
注释类型 | 全库只有一种 | N |
2.3 一条记录的完整解剖
以 iaf1_afw 为例,头文件只有十三行,信息密度很高:
 iaf1_afw 8 1000 154500
 iaf1_afw.dat 16 3277 14 0 -578 -3020 0 II
 iaf1_afw.dat 16 3277 14 0 150 28612 0 V1
 iaf1_afw.dat 16 3277 14 0 -355 -27642 0 aVF
 iaf1_afw.dat 16 3277 14 0 -101 -12342 0 CS12
 iaf1_afw.dat 16 3277 14 0 213 -15468 0 CS34
 iaf1_afw.dat 16 3277 14 0 189 -27328 0 CS56
 iaf1_afw.dat 16 3277 14 0 -207 29875 0 CS78
 iaf1_afw.dat 16 3277 14 0 -274 3520 0 CS90
 # <age>: 81 <sex>: F <diagnosis>: Atrial Fibrillation
 # <medications>: Atenolol, Monopril
 # Adenosine injected at 70 sec
 # Note: signals are uncalibrated
第一行四个数依次是记录名、八路信号、1000 Hz、每路 154500 个采样点。用采样点数除以采样率,得到 154.5 秒。后八行是逐路声明,格式码 16 表示每样本两个字节,增益 3277、位宽 14、基线 0,随后是初始值、校验和、块大小与信号名。
注意最后四行。年龄性别诊断写在一行,用药写在一行,注射时刻单独一行,最后一行是「信号未校准」。这四行是目前全部临床上下文——没有体重、没有左房内径、没有房颤病程、没有既往消融史,也没有随访。
把这条记录读进内存只要三行:
import wfdb

rec = wfdb.rdrecord('iaf1_afw', pn_dir='iafdb')
print(rec.fs, rec.sig_len, rec.n_sig, rec.sig_name, rec.units)
#-- 1000 154500 8 ['II','V1','aVF','CS12','CS34','CS56','CS78','CS90']
print(rec.comments)
units 会显示 mV,但这个 mV 只是名义单位:增益字段 3277 换算出的数值没有经过校准验证。凡是需要幅度的分析,都应当先把每路信号按记录内部分位数做归一化,再比较。
2.4 三十二条记录的逐项参数
| 记录 | 时长(秒) | 采样点 | 首路体表导联 | QRS 注释数 | 信号体积(MB) |
|---|---|---|---|---|---|
iaf1_afw |
154.5 | 154500 | II | 189 | 2.5 |
iaf1_ivc |
51.5 | 51500 | II | 64 | 0.8 |
iaf1_svc |
57.5 | 57499 | II | 74 | 0.9 |
iaf1_tva |
59.5 | 59500 | II | 75 | 1.0 |
iaf2_afw |
230.5 | 230500 | I | 343 | 3.7 |
iaf2_ivc |
67.5 | 67500 | I | 104 | 1.1 |
iaf2_svc |
54.5 | 54500 | I | 81 | 0.9 |
iaf2_tva |
64.0 | 64000 | I | 93 | 1.0 |
iaf3_afw |
814.0 | 814000 | I | 998 | 13.0 |
iaf3_ivc |
66.5 | 66500 | I | 78 | 1.1 |
iaf3_svc |
99.5 | 99500 | I | 117 | 1.6 |
iaf3_tva |
48.0 | 48000 | I | 56 | 0.8 |
iaf4_afw |
1369.3 | 1369253 | I | 1169 | 21.9 |
iaf4_ivc |
60.7 | 60688 | I | 32 | 1.0 |
iaf4_svc |
58.0 | 57978 | I | 29 | 0.9 |
iaf4_tva |
67.5 | 67513 | I | 31 | 1.1 |
iaf5_afw |
811.5 | 811500 | I | 810 | 13.0 |
iaf5_ivc |
63.0 | 63000 | I | 52 | 1.0 |
iaf5_svc |
183.0 | 183000 | I | 160 | 2.9 |
iaf5_tva |
52.5 | 52500 | I | 38 | 0.8 |
iaf6_afw |
361.5 | 361500 | I | 355 | 5.8 |
iaf6_ivc |
58.0 | 58000 | I | 55 | 0.9 |
iaf6_svc |
49.0 | 49000 | I | 47 | 0.8 |
iaf6_tva |
54.5 | 54500 | I | 51 | 0.9 |
iaf7_afw |
661.5 | 661500 | II | 1460 | 10.6 |
iaf7_ivc |
111.5 | 111500 | II | 272 | 1.8 |
iaf7_svc |
146.5 | 146500 | II | 356 | 2.3 |
iaf7_tva |
117.5 | 117500 | II | 323 | 1.9 |
iaf8_afw |
537.0 | 537000 | I | 790 | 8.6 |
iaf8_ivc |
59.0 | 59000 | I | 96 | 0.9 |
iaf8_svc |
51.5 | 51500 | I | 88 | 0.8 |
iaf8_tva |
56.0 | 56000 | I | 85 | 0.9 |
表里的时长与信号体积是由头文件的采样点数换算的,QRS 注释数是逐个读取 .qrs 文件得到的,官方页面没有给出这两个口径。三十二条相加,全库合计六千六百九十六点四秒,约一点八六小时;其中游离壁八条合计四千九百三十九点八秒,占去四分之三以上的时长,其余二十四条多数在一分钟上下。
这个不均衡不是设计失误,而是采集流程的副产品:四个位置各停一次是标准动作,只有游离壁多做了一段药物观察。使用时如果按记录平均,等于给了游离壁记录八倍以上的权重;按秒加权才接近真实的时间分布。
2.5 信号命名:CS 是极对编号,不是解剖坐标
心内五路的名称是 CS12、CS34、CS56、CS78、CS90,从导管远端到近端排列。CS 是冠状窦导管的惯用前缀,但在这个库里,导管并没有停在冠状窦,而是在右心房的四个位置之间移动。也就是说,名字沿用的是导管型号的默认编号,与当时导管尖端在心脏里的实际位置无关。
| 信号名 | 官方解释 | 实际解剖含义 | 使用时要注意 |
|---|---|---|---|
CS12 |
远端双极 | 取决于本记录的位置后缀 | 记为「位置 + 远端」才安全 |
CS34 |
第二双极 | 同上 | 与 CS12 相距 7 毫米 |
CS56 |
第三双极 | 同上 | 中间位置,方向感最弱 |
CS78 |
第四双极 | 同上 | 靠近近端 |
CS90 |
近端双极 | 同上 | 名称里的 90 是缩写,不是 9-10 的误写 |
十个电极按 2-5-2 毫米的间距排布:一对电极内相距 2 毫米,相邻两对之间隔 5 毫米,于是双极中心距为 7 毫米。这个几何关系是理解「五个通道其实是沿一条直线的时间采样」的关键——同一波前依次经过五个极对,通道之间的时间差乘以 7 毫米,就是这一小段上的传导速度估计。
官方页面给出的极对写法是「CS12, CS34, … , CS90」,中间用省略号跳过。头文件里能确认的实际名称是五个:CS12、CS34、CS56、CS78、CS90。最后一个不是 CS910,也不是 CS9-10,就是 CS90 三个字符。写脚本时按头文件里的字符串匹配,不要按「数字递增」的规则去拼名字。
2.6 与同类资源的字段差异
| 维度 | iafdb | afdb | ltafdb | incartdb |
|---|---|---|---|---|
| 信号来源 | 右心房心内 + 体表 | 体表 | 体表 | 体表 |
| 记录数 | 32 | 25 | 84 | 75 |
| 每记录通道 | 8 | 2 | 2 | 12 |
| 单条时长 | 48 秒至 22.8 分钟 | 10 小时 | 24 小时 | 30 分钟 |
| 采样率 | 1000 Hz | 250 Hz | 128 Hz | 257 Hz |
| 幅度校准 | 无 | 有 | 有 | 有 |
| 节律标注 | 无 | 有 | 有 | 无 |
| 心搏标注 | 自动,未校正 | 自动 + 人工修订版 | 自动 + 人工 | 有 |
| 整库体积 | 102.8 MB | 数百 MB | 数 GB | 数百 MB |
这张表回答的是「同一类任务该挑哪一个」。要做房颤检测,iafdb 在第一行就出局:没有节律标注。要做心内电图的信号处理,另外三个库在「信号来源」一栏就出局:它们根本没有心内通道。两个方向的淘汰都很干脆,中间地带很窄。
§3 它是谁的八个心房:一间工程公司的副产品
3.1 贡献者与机构
官方页面的致谢只有一句话:感谢 Creare, Inc. 的 Jon Peterson 与 Dave Kynor 慷慨提供这批记录,以及上文的位置说明与示意图。页面上没有医院署名,没有通讯作者(需要登录才能查看),也没有列出任何一篇配套论文。
这一点与多数 PhysioNet 心电库不同。afdb 的源头是 1983 年波士顿贝斯以色列医院的动态心电磁带,ltafdb 的源头是西北大学的长期监护记录,两者都能追到具体的临床科室与采集协议。iafdb 追到的是一家工程公司,记录随附的是导管摆位示意与心脏模型照片,形态上更像一次技术演示的留存,而不是一次临床研究的归档。
这不影响数据本身的价值,但影响引用方式。没有方法学论文,就没有一段文字可以引用来说明「采样怎么做的、患者怎么选的、标注谁做的」。所有背景只能回到 PhysioNet 的项目页,而项目页只有六百余字。做研究时这意味着一件事:方法段落里关于数据来源的描述,必须自己写,不能靠引一篇论文带过。
3.2 时间线
| 时间 | 事件 | 依据 |
|---|---|---|
| 官方未标注 | 记录采集于某次电生理检查 | 页面无采集年份 |
| 2003-03-04 | 1.0.0 版上线 PhysioNet | 项目页版本信息 |
| 2003-03-01 | 目录内文件时间戳 | 逐文件修改时间 |
| 2019-02-20 | 补入 SHA256SUMS.txt |
校验和文件时间戳 |
| 此后 | 无新版本,仍为 1.0.0 | 项目页版本列表仅一项 |
二十多年只有一个版本,这在 PhysioNet 上并不罕见,但也说明它没有被持续维护。没有勘误、没有追加记录、没有注释修订。使用者拿到的就是 2003 年那一份,未来大概率也不会变——对可复现性是好消息,对数据质量不是。
3.3 采集场景:一次电生理检查里的四个停靠点
十极导管从静脉进入右心,在四个位置各停一次。官方给出的位置定义很具体:
| 位置后缀 | 全称 | 官方定义 | 记录时长范围 |
|---|---|---|---|
svc |
上腔静脉口 | 导管远端(CS12)靠近上腔静脉环 | 49.0–183.0 秒 |
ivc |
下腔静脉口 | 导管近端(CS90)靠近下腔静脉环 | 51.5–111.5 秒 |
tva |
三尖瓣环 | 导管远端(CS12)靠近三尖瓣环 | 48.0–117.5 秒 |
afw |
心房游离壁 | 整根导管贴在心房游离壁上 | 154.5–1369.3 秒 |
四个位置覆盖了右心房的一圈:上口、下口、三尖瓣环一侧与游离壁一侧。这不是标测,而是「沿着腔壁取几个样本」。导管在腔内的朝向随位置而变,所以五个极对指向的空间方向也随记录而变——svc 记录里的 CS12 与 afw 记录里的 CS12,可能看向几乎相反的方向。
figures 子目录里的五张图说明了这一点:上腔静脉口位置,导管贴在后壁;三尖瓣环位置,电极贴着间隔;下腔静脉口位置,近端在上、电极贴后壁;游离壁位置,心房被「掀开」以显示贴壁。另有 1 张总图给出右心房与右心室的剖面。这些图是唯一的位置证据,没有坐标,也没有与影像的配准。
3.4 八位患者与他们的用药
头文件把临床信息压成了四行。下表按记录前缀汇总,年龄、性别、诊断、用药均照抄头文件原文:
| 前缀 | 年龄 | 性别 | 诊断 | 用药(原文) | 激发药与时刻 |
|---|---|---|---|---|---|
iaf1 |
81 | F | Atrial Fibrillation | Atenolol, Monopril | 腺苷 70 秒 |
iaf2 |
79 | M | Atrial Fibrillation | Coreg, Digitalis, Diovan | 腺苷 123 秒 |
iaf3 |
67 | F | Atrial Fibrillation | Norvasc, Metroprolol, Altace | 异丙肾上腺素 69 秒 |
iaf4 |
58 | M | Atrial Fibrillation | Diltiazem, Metoprolol, Digitalis | 异丙肾上腺素 343、547 秒 |
iaf5 |
76 | M | Atrial Flutter | Lopressor | 异丙肾上腺素 94、214 秒 |
iaf6 |
78 | M | Atrial Fibrillation | Metoprolol, Digitalis, Prinivil | 腺苷 146 秒 |
iaf7 |
79 | F | Atrial Fib/Flutter | Propafenone | 异丙肾上腺素 341 秒 |
iaf8 |
68 | M | Atrial Flutter | Atenolol | 腺苷 120、261 秒 |
几点值得记下。诊断有三种写法:五条写心房颤动,两条写心房扑动,一条写「房颤/房扑」,官方页面则统称「atrial fibrillation or flutter」,两种口径并存。用药一栏混着通用名与商品名——Metoprolol 与 Lopressor 是同一种药,Norvasc 是氨氯地平,Prinivil 与 Monopril 都是 ACE 抑制剂。年龄五十八到八十一岁,没有一位年轻患者。
药物激发按患者分组,不是随机分配:腺苷给了 iaf1、iaf2、iaf6、iaf8,异丙肾上腺素给了 iaf3、iaf4、iaf5、iaf7。两种药的作用机制相反——腺苷短暂抑制房室结传导并缩短心房动作电位时程,异丙肾上腺素提高交感张力、加快心房率。把它们放在一起看,等于有了两个方向的扰动样本,每组各四人。
3.5 为什么这批记录只能出自导管室
心内电图无法在门诊、病房或家中获得。它要求导管已经在心腔里,而导管进心腔意味着一次有创操作:穿刺、肝素化、X 线透视、可能的并发症风险。因此这类数据的三个特征全都由场景决定。
第一是短。患者不会在导管室里躺十几个小时,每次停靠能录几十秒到几分钟已经够用。全库合计不到两小时,与 afdb 的二百五十小时不在一个量级。
第二是贵。三十二条记录背后是八次电生理检查,每次都有团队、耗材与设备成本。这解释了为什么公开的心内电图库极少:不是因为没人想要,而是因为产不出来。
第三是附带信息天然贫乏。导管室的注意力在操作本身,临床背景、既往史、影像测量都不在记录流程里。头文件只有四行,不是贡献方偷懒,而是能顺手记下的就这些。
3.6 与「体表长时程」的根本差别
把 iafdb 和 afdb 并列,最容易犯的错是只看到「都是房颤数据」。真正的差别在于测量对象:一个测的是心腔壁上一个点的跨膜电活动,一个测的是整个心脏电活动在体表的远场投影。前者给出时间与位置,后者给出时间与形态。
这个差别会传导到每一个下游环节。心内信号不需要 QRS 减除,因为心室远场本来就弱;体表信号必须减除,否则 f 波看不见。心内信号的幅度与电极接触有关,体表信号的幅度与体型、电极位置有关。心内信号能做传导速度估计,体表信号只能做整体节律判断。
所以两者不是大小样本的关系,也不是新旧版本的关系,而是两种不同的观测。选错观测,后面的算法再精细也补不回来。
§4 它最独特的东西:一根导管上的五个听诊点
4.1 心内与体表:六个维度的对照
| 维度 | 心内电图(本库) | 体表心电图(afdb、ltafdb) |
|---|---|---|
| 测量对象 | 电极附近数毫米心肌的局部除极 | 全心电活动在体表的投影 |
| 幅度量级 | 毫伏到十几毫伏 | 0.05–2 毫伏 |
| 心室干扰 | 弱,多数记录中 QRS 只是小尖峰 | 强,常需模板减除 |
| 空间信息 | 5 个已知间距的采样点 | 2 至 12 个固定导联 |
| 时间分辨率 | 1 毫秒 | 4 至 8 毫秒 |
| 可做的分析 | 传导速度、激动顺序、碎裂、主导频率 | 节律分类、心率变异性、形态学 |
这张表解释了一个常见困惑:为什么用体表数据做房颤机制研究总是差一口气。不是方法不够好,是观测本身丢掉了空间维度——体表十二导联再多,也是远场投影的线性组合,无法反解出心房壁上某一点的激动时刻。
4.2 五个极对等于一条线上的五个时间戳
导管上五个双极沿直线排开,间距 7 毫米。同一个波前扫过这五个极对时,会在五个通道上依次留下一个陡峭的局部偏转。把五个偏转的时刻按通道顺序排好,就得到一条「激动沿导管传播」的时间序列。
这条序列能支撑三类分析。第一类是传导速度:相邻通道的时间差除以 7 毫米,得到这一小段上的表观速度;房颤时这个值常在每秒几十厘米量级波动。第二类是激动顺序:时间差的正负号告诉你波前是从远端走向近端,还是反过来,这在研究功能性阻滞时是关键证据。第三类是方向一致性:五个通道的时间差如果接近线性,说明是单一波前通过;如果次序颠倒、出现双峰,说明有多个波前或局部折返。
三类分析都有同一个前提:极对真的贴在一条直线上,且间距如官方所述。导管是柔性的,贴壁时会弯曲,7 毫米只是名义值。凡是报告绝对速度的论文,都应当把这个不确定性写进限制。
4.3 案例:iaf4_afw 的二十二分钟
iaf4_afw 是全库最长的一条记录,1369.3 秒,二十二分四十九秒,也是唯一一条长到能看清「给药—起效—洗脱」完整过程的记录之一。它来自一位五十八岁男性,诊断心房颤动,平时服用硫氮卓酮、美托洛尔与地高辛,术中在 343 秒与 547 秒两次注射异丙肾上腺素。
这条记录的结构可以分成四段:注射前的基线段,第一次给药后的起效段,第二次给药前后的叠加段,以及最后约八百秒的洗脱段。头文件只给了两个时刻,没有给剂量,也没有给「起效」的定义,所以分段边界要靠波形自己判断。
iaf4_afw 的另一处特殊在于它的 QRS 注释密度。整条记录 1169 个 QRS 注释,平均每分钟五十一次,是八位患者里最慢的;而同一位患者另外三条记录(iaf4_svc、iaf4_ivc、iaf4_tva)分别只有 29、32、31 个注释,折算每分钟三十次上下。这个差异提示心室率在长时间记录中并不恒定,也提示自动检测器在长记录上的行为与其他记录不同。
§2.4 的表里可以看到,iaf4_afw 的信号体积 21.9 MB,占全库五分之一。单条记录就能把整库的体量感拉高一个档,这也是为什么下载时按记录挑选比整包下载更实用。
4.4 标注只有一层:QRS,且未经校正
ANNOTATORS 文件把这个库的标注状况说得很清楚:qrs unaudited beat annotations。翻译过来是「心搏注释,未审核」。
生产方式是 sqrs,WFDB 软件包里附带的一个经典单导联 QRS 检测器。官方原话是这些注释「可能对开始研究这些记录有用」,措辞相当保守。全库注释只有一种符号 N,不区分正常搏、室早或差异传导;也没有节律段标注,房颤、房扑、窦性心律的区间一概没有。
| 标注层级 | 本库 | afdb | ltafdb |
|---|---|---|---|
| 心搏位置 | 有,自动未校正 | 有,另有校正版 | 有 |
| 心搏类型 | 全部标 N | 全部标 N | 按类型标注 |
| 节律段 | 无 | 有,四类 | 有,含终止标记 |
| 信号质量 | 无 | 部分 | 部分 |
| 起搏或伪差标记 | 无 | 部分 | 有伪差标记 |
这张表最右一列不是用来比较优劣,而是说明一个事实:在本库上做任何需要「真值区间」的评测,真值都得自己造,而自造的真值无法与别人的结果对齐。
4.5 边界条件:什么情况下它不再适用
当你要判断「这段是不是房颤」时。 没有任何一段被标为房颤或非房颤。哪怕整条记录都是房颤,也没有一个字节告诉你从第几秒开始。
当你要做频率分析并且需要绝对幅度时。 频谱形状可用,峰值频率可用,但功率的绝对值不可跨记录比较。
当你要做电极位置相关的建模时。 只有四张示意图,没有坐标,没有与 CT 或透视的配准。任何「CS34 位于某解剖坐标」的假设都没有依据。
当你的样本量需求超过八个人时。 这不是边界条件,这是硬墙。
§5 怎么拿到:一百兆之内的完整闭环
5.1 目录结构与下载面
整库未压缩 102.8 MB,三十二组文件加两个清单与一个图片目录。PhysioNet 提供三种取法:网页逐个下载、wget 递归抓取、AWS 开放数据桶同步。三种取法的内容完全一致,区别只在速度与是否需要断点续传。
三种取法各有适用面。网页 ZIP 最省事,点一下拿到 102.8 MB 的压缩包,适合一次拿全;逐文件下载适合只要某几条记录的场景,比如只想看某位患者的四个位置;wget 递归与 aws s3 sync 适合脚本化,前者保留原目录结构、支持断点续传,后者在云端环境里更快,且同样不需要任何凭证。
按记录挑选很实用:全库三十二条记录里,八条游离壁记录占了约 79 MB,其余二十四条合计约 28 MB。只想看基线段的话,跳过 afw 能省下七成流量。
5.2 批量下载
#-- 全库递归下载,保留目录结构,支持断点续传
wget -r -N -c -np https://physionet.org/files/iafdb/1.0.0/

#-- 或者走 AWS 开放数据桶,无需任何凭证
aws s3 sync --no-sign-request s3://physionet-open/iafdb/1.0.0/ ./iafdb

#-- 只取非游离壁记录:先拿清单,再按后缀过滤
curl -s https://physionet.org/files/iafdb/1.0.0/RECORDS \
  | grep -v afw > short.txt
while read r; do
  for ext in hea dat qrs; do
    curl -sO "https://physionet.org/files/iafdb/1.0.0/${r}.${ext}"
  done
done < short.txt
wget -r 会把 figures 目录一起抓下来,五张摆位图对理解导管朝向有用,值得保留。-c 是断点续传,-np 禁止上溯到父目录,两个参数一起用才不会把整个 PhysioNet 拖下来。
5.3 用 wfdb 直接流式读取
不下载也能读。wfdb 的 pn_dir 参数支持直接从 PhysioNet 拉取,按需读取片段:
import wfdb
import numpy as np

#-- 读头文件,不拉信号本体
hdr = wfdb.rdheader('iaf4_afw', pn_dir='iafdb')
print(hdr.fs, hdr.n_sig, hdr.sig_len, hdr.sig_name)

#-- 只取第 300 到 320 秒,避免整条载入
rec = wfdb.rdrecord('iaf4_afw', pn_dir='iafdb',
                    sampfrom=300 * 1000, sampto=320 * 1000)
x = rec.p_signal
print(x.shape)          #-- (20000, 8)
print([float(np.ptp(x[:, i])) for i in range(8)])
p_signal 已经按增益换算过,d_signal 才是原始整数。两者相差 3277 倍,混用不会报错,只会让所有幅度结论失效。
5.4 转成通用的表结构
八通道、1 kHz、几十秒到二十几分钟,最省事的落地格式是宽表:一行一个采样点,一列一个通道,另存记录名与时间戳。
import wfdb
import pandas as pd

def to_frame(record, pn_dir='iafdb'):
    rec = wfdb.rdrecord(record, pn_dir=pn_dir)
    df = pd.DataFrame(rec.p_signal, columns=rec.sig_name)
    df.insert(0, 't_sec', df.index / rec.fs)
    df.insert(0, 'record', record)
    return df

df = to_frame('iaf1_afw')
df.to_parquet('iaf1_afw.parquet', index=False)
print(df.shape, df.columns.tolist())
Parquet 比 CSV 小一个量级,且保留列类型。全库三十二条记录转完约二百多万行、八列,单机内存完全吃得下。
5.5 注释读取与心率换算
import wfdb
import numpy as np

ann = wfdb.rdann('iaf4_afw', 'qrs', pn_dir='iafdb')
t = ann.sample / 1000.0
rr = np.diff(t)
print(len(t), 'beats, median RR %.3f s' % np.median(rr))
print('rate %.1f bpm' % (60.0 / np.median(rr)))
ann.symbol 全库只有一个值 N,ann.aux_note 全是空串。这两行输出就是判定「有没有节律标注」的最快方式,动手前先跑一次,能省掉后面所有基于错误假设的分析。
QRS 注释在长记录上的可靠性要单独看。§4.3 的案例里,同一位患者的长记录折算心率五十一次每分钟,短记录只有三十次上下,差值接近七成。这既可能是真实的心率变化,也可能是检测器在长记录上的漏检或重复触发。由于注释未经校正,两种解释都无法排除,凡是把心率当作协变量的分析,都应当先自己复核一遍注释。
5.6 五个最容易出错的地方
| 坑 | 表现 | 处理 |
|---|---|---|
把 CS 当成冠状窦位置 |
跨记录对齐电极坐标 | 只用记录内的相对次序,不做绝对定位 |
| 把 mV 当校准值 | 跨记录比较幅度,得到几倍差异 | 每路按记录内分位数归一化 |
| 以为 8 路里有 4 路体表 | 索引 x[:, 3] 得到 CS12 而非 aVF |
按 sig_name 取列,不按位置 |
| 把 QRS 注释当金标准 | 用未校正注释算准确率 | 先人工抽检若干段,报告漏检率 |
| 用 1 kHz 直接做高频分析 | 把肌电噪声当成碎裂电位 | 先看 100 Hz 以上的功率占比 |
第一条最隐蔽。CS 前缀在心脏病学里几乎总指冠状窦,而本库的导管在右心房四个位置移动。名字与解剖的错位不会在数据里报错,只会在论文的图注里出错。
5.7 体积与缓存:小到可以整库放进内存
全库 102.8 MB,解码成双精度浮点后约 6.7 百万采样点乘 8 通道乘 8 字节,四百余兆。这个量级意味着两件事:一是任何实验都可以在笔记本上跑完,不需要分布式;二是反复重跑的成本极低,适合当作管线冒烟测试的标准件。
但「小」也带来一个反直觉的风险:太容易过拟合。八位患者、三十二条记录,随机划分训练测试后,同一位患者的其他记录几乎必然出现在训练集里。正确做法是按患者划分,而按患者划分只有八个折,每折留一人的话测试集只有四条记录——统计效力低到无法支撑任何比较。这是体量决定的,不是方法能补救的。
§6 与库内条目的关系
6.1 关系图谱
库里与房颤相关的词条不少,但绝大多数是体表心电。iafdb 的位置可以由一张表定住:
| 词条 | 观测面 | 规模 | 是否有节律标注 | 与 iafdb 的关系 |
|---|---|---|---|---|
iafdb |
右心房心内 | 8 人 / 32 条 | 无 | 本篇 |
mit-bih-afdb |
体表双导联 | 25 条 / 10 小时 | 有,四类 | 同病种、异观测面 |
ltafdb |
体表双导联 | 84 条 / 24 小时 | 有,含终止 | 同病种、异观测面 |
afpdb |
体表双导联 | 50 组 / 30 分钟 | 以「临近发作」定义 | 预测任务,非机制 |
aftdb |
体表 | 80 段 / 1 分钟 | 终止时刻 | 终止预测任务 |
physionet-cinc-2017 |
体表单导联 | 八千余条 / 9–60 秒 | 四分类 | 分类挑战赛 |
kingston-icu-af |
体表四导联 | ICU 床旁 10 秒 | 有 | 场景差异极大 |
lascarqs |
心脏 MRI | 百例级 | 分割标注 | 解剖侧,非电生理 |
表中「同病种、异观测面」这五个字是理解本库的关键。afdb 与 ltafdb 记录的是同一类疾病在体表的样子,iafdb 记录的是它在心房壁上的样子。两者不能互为替代,也不构成训练集与测试集的关系。
6.2 检索路径
在站内找同类资源,可以按观测面与标注类型两个维度筛:
-- 按病种找房颤相关词条,并区分观测面
SELECT record_id, url_name, title
FROM ai_ready_dataset
WHERE del_sign = 0
  AND (title ILIKE '%房颤%' OR title ILIKE '%心房%' OR url_name ILIKE '%af%')
ORDER BY record_id;

-- 找所有生理信号类、且带节律标注的库
SELECT url_name, title
FROM ai_ready_dataset
WHERE del_sign = 0
  AND category_tags::text ILIKE '%生理信号%'
  AND title ILIKE '%心电%';
| 你想找的东西 | 检索词 | 预期命中 |
|---|---|---|
| 心内电图 | 心内、intracardiac、电生理 | 本篇,可能另有标测类数据 |
| 房颤检测基准 | 房颤、AFDB、CinC 2017 | afdb、ltafdb、cinc-2017 |
| 房颤终止或预测 | 终止、预测、PAF | aftdb、afpdb |
| 心房结构 | 左心房、分割、MRI | lascarqs |
6.3 与 afdb、ltafdb 的本质区隔
这一节最需要说清。三个库都叫「房颤数据库」,都挂在 PhysioNet,都以 WFDB 存储,都用同一套注释符号体系,因此极易被当成同一族资源的不同规模版本。实际不是。
| 对照项 | iafdb | afdb | ltafdb |
|---|---|---|---|
| 电极位置 | 右心房腔内,四个停靠点 | 体表,双导联 | 体表,双导联 |
| 观测对象 | 局部心肌除极 | 全心电活动的远场投影 | 同上 |
| 记录时长 | 秒到分钟 | 10 小时 | 24 小时 |
| 采样率 | 1000 Hz | 250 Hz | 128 Hz |
| 通道数 | 8(5 心内 + 3 体表) | 2 | 2 |
| 幅度校准 | 未校准 | 已校准,±10 毫伏 | 已校准 |
| 节律标注 | 无 | 有,AFIB/AFL/J/N | 有,含 T 标记 |
| 典型用途 | 机制、传导、频谱 | 检测、节律分类 | 长时程监测、终止研究 |
第一行就决定了其余所有行。电极在腔内,所以时长只能是分钟级——没人会在导管室里躺十小时;所以采样率必须高——局部电图的陡峭偏转在 128 Hz 下只剩两三个点;所以幅度无法校准——贴壁压力每次不同;所以没有节律标注——整条记录本来就是房颤,标注「这一段是房颤」没有信息量。
反过来看 afdb,它的价值恰恰在于「这一段是不是房颤」这个问题有答案,因为十小时里房颤会来会走。iafdb 里房颤一直在,问题变成了「它此刻在心房壁上怎么走」。两个问题都重要,但需要的数据完全不同。
还有一层容易忽略的差别:afdb 与 ltafdb 的记录可以按患者分组做交叉验证,iafdb 只有八位患者,做不了。前者能支撑「方法在人群上有效」的结论,后者只能支撑「方法在这条记录上跑得通」。
6.4 任务与选型
| 你的任务 | 首选 | 理由 |
|---|---|---|
| 房颤片段检测 | afdb | 有逐段节律真值,时长足够 |
| 长时程房颤负荷统计 | ltafdb | 24 小时连续,含终止标记 |
| 单导联可穿戴房颤筛查 | physionet-cinc-2017 | 单导联、短片段、四分类标签 |
| 心房激动频率与传导 | iafdb | 唯一提供心内多极对公开数据的库 |
| 药物对心房率的影响 | iafdb | 含给药与洗脱段 |
| 导管标测算法验证 | iafdb | 八通道同步、几何已知 |
| 左房结构分割 | lascarqs | MRI 与分割标注 |
6.5 什么时候该放弃它
如果任务需要「房颤与非房颤的二分类」,放弃。如果任务需要「患者级统计」,放弃。如果任务需要「左心房或肺静脉」,放弃。如果任务需要「校准过的幅度」,放弃。
留下来的场景其实很集中:凡是问题里出现「局部」「传导」「频率」「激动顺序」这几个词,且不需要人群结论的,它几乎就是公开数据里唯一的选择。这个唯一性来自心内数据的稀缺,而不是来自它做得有多好。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
讨论质量之前要先摆正一件事:本库的很多「缺陷」其实是观测方式自带的属性,不是制作方的疏忽。幅度未校准、没有节律标注、只有八个人、时长只有几分钟——这四条如果当成质量问题去追责,结论必然是「这个库不合格」;如果当成心内记录的定义性特征去理解,结论就变成「它能做的事很窄,但在那个窄范围里没有替代品」。
第二个容易发生的误判是把「心内」等同于「更接近真相」。心内电极测的是一个点附近的电位差,它离源更近,但也更受接触状态、电极极化、导管位置的影响。把它当作体表算法的金标准,等于用一个有系统偏差的尺子去校准另一把尺子,误差不会消失,只会转移。
第三个误判是把「公开」当成「可用」。挂在 PhysioNet 上、有 DOI、有许可,说明拿得到;不说明拿到的这批数据足以支撑你想做的推断。这两件事之间隔着一整节的方法学。
7.1 五维评分
按 DAIMS 的常用维度打分,每项 1 至 5 分,针对「作为心内电图机制研究素材」这个用途,而不是针对「作为机器学习数据集」:
| 维度 | 分数 | 判断依据 |
|---|---|---|
| 完整性 | 3 | 通道齐全、文件成组、清单与校验和都有;缺节律标注与校准信息 |
| 准确性 | 3 | 时间轴可靠,位置靠示意图,幅度只有名义值 |
| 一致性 | 4 | 八通道、1 kHz、文件命名规则在全库内完全一致 |
| 可追溯性 | 3 | 有 DOI、固定版本、贡献方署名;无配套论文、无采集年份 |
| 可获得性 | 5 | 无需注册、无需申请、百兆级、三种下载方式 |
五项里可获得性满分,这是它作为教学与冒烟测试素材的最大优势;完整性只有三分,扣分全在标注与校准;一致性四分,是三个体表大库都不一定具备的整齐度——afdb 里有两条记录只剩注释文件,信号缺失,本库没有这种情况。
如果换成「作为房颤分类训练集」这个用途打分,五项会变成二、二、四、三、五,总分明显下滑。同一批数据,用途一变,分数就变,这也是为什么评分必须绑定用途。
7.2 信号的三层可信度
同一条记录里,不同属性的可信度差别很大,应该分层看待:
| 层次 | 可信度 | 依据 | 使用建议 |
|---|---|---|---|
| 时间轴 | 高 | 采样率固定 1 kHz,样本数与时长自洽 | 可直接用于毫秒级时序分析 |
| 通道身份 | 高 | 头文件逐路声明,全库一致 | 按 sig_name 取列即可 |
| 通道位置 | 中 | 四个位置有官方定义与示意图 | 只做相对次序,不做绝对坐标 |
| 波形形态 | 中 | 真实采集,但含药物与接触状态影响 | 形态学结论需限定在该条记录内 |
| 绝对幅度 | 低 | 官方明示未校准 | 只做记录内归一化后比较 |
分层的好处是能把「可用」与「不可用」拆开。时间轴与通道身份可以直接信,位置与形态要加限定,幅度基本不能用。很多误用不是因为数据错,而是因为把低可信层当成了高可信层。
想快速估一下某条记录的信噪状态,可以看高频段能量占比,这是判断电极接触好坏的廉价代理:
import wfdb
import numpy as np

rec = wfdb.rdrecord('iaf1_afw', pn_dir='iafdb')
x = rec.p_signal[:, 3]                  #-- CS12,第一个心内通道
x = (x - x.mean()) / (x.std() + 1e-9)
f, p = np.fft.rfftfreq(len(x), 1 / rec.fs), np.abs(np.fft.rfft(x)) ** 2
hi = p[f > 100].sum() / p.sum()
print('high-band share %.3f' % hi)
占比高说明肌电或接触噪声重,占比低说明信号干净。这个指标只能横向提示,不能当作质量门槛,因为房颤本身的碎裂电位也会抬高高频能量。
7.3 已知的、可枚举的偏差
| 偏差 | 具体表现 | 会污染什么结论 |
|---|---|---|
| 样本量 | 8 位患者,32 条记录 | 任何患者级推广 |
| 人群构成 | 58–81 岁,全部接受电生理检查 | 年轻患者、非转诊人群 |
| 病种混合 | 房颤 5 人、房扑 2 人、房扑房颤兼有 1 人 | 把三者当同一类处理 |
| 观测范围 | 只有右心房,无左房与肺静脉 | 左房机制、消融靶点 |
| 药物 | 全部患者在用抗心律失常或控制心率药物 | 「自然状态下的房颤」 |
| 药物激发 | 腺苷与异丙肾上腺素各四人,非随机 | 药物效应的因果推断 |
| 幅度 | 未校准 | 跨记录幅度比较 |
| 记录时长 | 24 条不足两分钟 | 需要长窗的频谱估计 |
第六条值得单说。药物是按患者分组的,不是随机分配的,所以「腺苷组与异丙肾上腺素组的差异」里混着患者本身的差异。八个人的分组,任何组间比较都不可能排除个体效应。§4.3 的案例里同一位患者四条记录的心率就差了三成,可见个体内部的波动已经很大。
第七条影响最广。心内双极的幅度与电极贴壁压力直接相关,压力大时幅度可翻倍。官方在每个头文件都写了未校准,这不是可以忽略的脚注,而是禁止跨记录比较幅度的明确声明。
7.4 外部验证矩阵
| 验证维度 | 本库能否支撑 | 说明 |
|---|---|---|
| 内部复现(同记录不同时段) | 能 | 长记录可切前后段互测 |
| 跨记录复现(同患者不同位置) | 能 | 每人四条,位置不同 |
| 跨患者复现 | 勉强 | 只有八人,留一法测试集仅四条 |
| 跨库复现(对体表库) | 不能 | 观测面不同,无共同任务 |
| 与影像或解剖对照 | 不能 | 无配准、无坐标 |
| 与临床结局对照 | 不能 | 无随访、无消融结果 |
这张表说明它的验证能力集中在「同一批记录内部的稳定性」,出了这个圈就没有支点。写论文时如果把跨患者结果说成「泛化能力」,审稿人只要数一下患者数就会打回。
7.5 它为何能持续:唯一性比质量更耐用
一个二十多年没更新、只有八位患者、没有标注的小库,按常规标准早该被淘汰。它没有,原因很朴素:公开的右心房心内电图几乎没有第二个来源。
体表心电库可以有很多,因为采集便宜、可以回顾性整理、可以众包。心内电图不行,它只能来自导管室,只能来自愿意公开的团队。于是这个库处在一个奇怪的位置:质量不高,需求不小,替代品为零。只要还有人做导管标测、还有人要验证心内信号处理,它就会被下载。这是稀缺性带来的生存逻辑,与制作水准无关。
§8 生态位与历史
8.1 历史沿革
| 阶段 | 时间 | 状态 |
|---|---|---|
| 采集 | 官方未标注 | 某次电生理检查,八位患者,四个位置 |
| 整理 | 2003 年前 | Creare 整理为 WFDB,附位置图与说明 |
| 上线 | 2003-03-04 | PhysioNet 1.0.0,ODC-BY 授权 |
| 静置 | 2003–2019 | 无修订,仅补校验和 |
| 现状 | 2019 至今 | 仍为 1.0.0,页面浏览量两百余次 |
这条时间线与 afdb(1983 年磁带、2000 年补齐信号、2014 年修注释)形成对照。afdb 有明确的维护史,每一次修订都有记录、有致谢、有勘误说明;iafdb 上线即封存。封存本身不是问题,问题在于使用者无法从版本差异里获得任何关于数据质量的线索。
8.2 与 MIT-BIH 体系的关系
PhysioNet 的心电库大体分成两条脉络。一条是 MIT 与波士顿贝斯以色列医院合作产出的 MIT-BIH 系列:心律失常库、afdb、ltdb、ltstdb,注释体系同源,符号表统一,文档风格一致。另一条是外部贡献:各家医院、公司、挑战赛组织方把数据交上来,格式统一到 WFDB,文档各写各的。
iafdb 属于第二条。它的注释符号借用了 MIT-BIH 的 N,但没有沿用那套节律符号;它的文件结构是标准 WFDB,但头文件注释行的写法(<age>:、<medications>)与 MIT-BIH 的 # 69 M 1085 1629 x1 完全不同。这种「格式统一、约定不统一」的状态,是外部贡献数据的典型样貌。
实际影响是:写通用加载器时不能假设所有 PhysioNet 心电库的注释行格式一致。iafdb 的年龄要按 <age>: 前缀解析,afdb 的要按位置解析。这类差异不会报错,只会静默地给出空值。
8.3 生态位:心内数据的一座孤岛
| 生态位 | 代表库 | 与本库的关系 |
|---|---|---|
| 体表长时程节律 | afdb、ltafdb | 同病种,不同观测面,不可互换 |
| 体表短片段分类 | cinc-2017、kingston-icu-af | 任务不同,无交集 |
| 心内电生理 | 本库 | 孤岛,无同量级替代 |
| 心房影像与分割 | lascarqs | 解剖侧,可作背景知识 |
| 心内其他模态 | 官方未见 | 缺口明显 |
「孤岛」这个判断有实际后果。做心内算法的人往往没有第二份数据可以做外部验证,只能在同一批记录上做留一法;做体表算法的人则不太需要它,因为体表库足够多。于是它的使用者群体很小、很稳定,论文里出现它的次数不多,但每次出现都是因为它不可替代。
8.4 谁在用它,用来做什么
从数据类型倒推,使用者大致分四类。做心房颤动机制研究的,关心主导频率、碎裂电位、激动顺序,需要 1 kHz 与多极对;做导管标测系统或消融导航的,需要一个可回放的多通道真值来做算法回归;做生物医学信号处理教学的,需要一个体量小、结构清晰、能一次讲完的例子;做数据工程的,需要一个能反复重跑而不心疼的冒烟测试件。
四类使用者的共同点是:都不需要人群结论。这个共同点划定了它的使用边界,也解释了为什么它长期停留在「小众但被引用」的位置。
教学场景对这条边界最不敏感,也因此最舍得用。§4.3 的案例——一条二十二分钟、含两次给药与完整洗脱的记录——放进一节课刚好讲完,从体表波形讲到心内局部电图,再讲到药物前后频率的变化,全程只用一条记录、一个时间轴。换成任何体表长时程库,这个叙事都拼不起来:十小时里房颤会来会走,讲「给药前后」反而得先解释为什么没有给药。
§9 使用指引
9.1 三种角色的路径
| 角色 | 第一步 | 关键动作 | 常见失败 |
|---|---|---|---|
| 机制研究者 | 读 iaf4_afw 的给药段 |
以头文件秒数为锚,取前后等长窗 | 把未校准幅度当功率绝对量 |
| 算法工程师 | 用 iaf1_afw 跑通读取 |
固定通道顺序与归一化方式 | 按列号取通道,取到 CS12 |
| 教学者 | 取一条短记录做体表与心内对照 | 同一时间轴叠画两类信号 | 直接讲「这是房颤」,无法证明 |
9.2 一条最短的可用流程
从零到能画出第一条图,四步足够:
#-- 1) 只取一条记录,约 2.5 MB
mkdir -p iafdb && cd iafdb
for ext in hea dat qrs; do
  curl -sO "https://physionet.org/files/iafdb/1.0.0/iaf1_afw.${ext}"
done
import wfdb
import matplotlib.pyplot as plt

rec = wfdb.rdrecord('iaf1_afw')          #-- 本地目录内读取
t = rec.p_signal[:, 0]
seg = slice(30 * 1000, 36 * 1000)        #-- 第 30 到 36 秒

fig, ax = plt.subplots(2, 1, figsize=(10, 6), sharex=True)
ax[0].plot(rec.p_signal[seg, 0], lw=0.8)  #-- 体表 II
ax[1].plot(rec.p_signal[seg, 3], lw=0.8)  #-- 心内 CS12
ax[0].set_ylabel('surface'); ax[1].set_ylabel('intracardiac')
plt.tight_layout(); plt.savefig('iaf1_afw_30_36s.png', dpi=150)
上下两栏共用时间轴,这一张图就能讲清本库的价值:上面是熟悉的体表波形,下面是同一次心搏在心房壁上的局部样子。§4.3 的案例用的是更长的 iaf4_afw,如果想看药物段,把记录名与时间窗换掉即可。
9.3 引用方式
官方页面没有给出专属引用格式,只提供 PhysioNet 平台的标准引用。实操中推荐同时写清数据集与平台两层:
Creare, Inc. Intracardiac Atrial Fibrillation Database (version 1.0.0).
PhysioNet, 2003. DOI: 10.13026/C23S33.
https://physionet.org/content/iafdb/1.0.0/
五个要素不能省。作者写 Creare, Inc.,致谢里的两位个人可以并列;版本写到 1.0.0 与 2003 年 3 月 4 日,只写年份会让使用者以为后续有修订;标识写 DOI,网址只是补充;记录写到具体名称,用了四条就写四条,笼统写「全库」会让别人无法核对;平台写 PhysioNet 加访问日期,因为这个页面本身没有「最后更新」字段。
§10 AI 使用声明
| 项目 | 说明 |
|---|---|
| 本页性质 | 数据集说明文档,不是原始数据的再分发 |
| 数据来源 | 全部事实取自 PhysioNet 官方项目页与库内文件 |
| 数字口径 | 规模、结构、边界三类;分布类统计不在范围内 |
| 推导数字 | 时长、体积、注释条数由头文件与注释文件换算,已标注 |
| 未核实项 | 采集年份、采集地点、剂量、患者临床背景 |
| 医学建议 | 本页不含诊断或治疗建议,不构成临床指导 |
| 许可提示 | 转载或再分发数据须遵守 ODC-BY 1.0 的署名要求 |
| 更新策略 | 官方版本不变则本页事实部分不变,勘误另记 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 这是 AHA 发布的心内房颤库 | 贡献方是工程公司 Creare, Inc. | 官方致谢段只提该公司两人 |
| 库里有 4 路体表心电 | 每条固定 3 路,I 与 II 二选一 | 32 个头文件逐行只有 3 个 ECG 名 |
| 有节律标注,可直接训练 | 只有 QRS 位置,且未校正 | ANNOTATORS 原文 unaudited |
| 信号可换算成毫伏做幅度比较 | 名义增益 3277,幅度未校准 | 每个头文件末行 signals are uncalibrated |
| CS12 至 CS90 对应冠状窦十极 | 导管在右心房四个位置移动 | 官方四段位置定义与摆位图 |
| 记录长达十几小时 | 最长 22.8 分钟,全库合计 1.86 小时 | 头文件采样点数除以 1 kHz |
| 覆盖全部房颤患者类型 | 8 人,58–81 岁,全部接受电生理检查 | 头文件年龄性别诊断行 |
| 有配套方法学论文可引 | 页面无参考文献,仅平台标准引用 | 项目页无 References 段 |
| 采样率 250 Hz,与 afdb 相同 | 本库为 1 kHz | 头文件第一行第三个数 |
| 信号通道数随位置变化 | 每条都是 8 路 | 32 个头文件第一行均为 8 |
FAQ
Q1:iafdb 和 afdb 是同一个库的不同版本吗?
不是。afdb 是体表双导联的 10 小时长时程记录,有逐段节律标注;iafdb 是右心房心内的分钟级记录,没有节律标注。两者唯一的共同点是都以房颤为主题、都存放在 PhysioNet。
Q2:八个患者够做什么?
够做方法可行性的验证,不够做任何人群层面的结论。合理用法是把结论限定在「在这八位患者的记录上」,或者把本库当作更大研究里的一个补充实验,而不是主证据。
Q3:为什么游离壁记录特别长?
因为药物激发实验只在这一个位置做。给药后需要观察起效与洗脱,所以记录从两分半延伸到近二十三分钟。其余三个位置是标准停靠,几十秒到三分钟即可。
Q4:能不能自己标节律,然后当检测数据集用?
技术上可以,学术上要谨慎。自标只有一个人、没有一致性检验、样本只有八人,得到的评测数字无法与公开结果比较。如果一定要做,必须公开标注规则与标注文件,并说明无法做患者级划分。
Q5:心内信号需要做 QRS 减除吗?
多数情况下不需要。电极在心房壁上,心室远场本来就弱,QRS 往往只表现为一个小尖峰。但在三尖瓣环位置(tva)记录里,导管离心室近,QRS 残留会明显一些,做频谱分析前应当先看一眼。
Q6:为什么增益写 3277 这么奇怪的数?
3277 接近 32768 除以 10,在 14 位量化下相当于把满量程折成约十毫伏。这个数字只出现在头文件里,官方没有说明它的来历,也没有给出任何标定流程。可以确定的是:每条记录都注明幅度未校准,所以它只能用于把整数还原成「名义毫伏」,不能当成真实刻度。
Q7:记录名的后缀 afw、svc、ivc、tva 分别指什么?
afw 是心房游离壁,svc 是上腔静脉口,ivc 是下腔静脉口,tva 是三尖瓣环。四个位置覆盖右心房的一圈,具体摆位见 figures 目录的五张示意图。
Q8:可以用它验证导管标测算法的定位精度吗?
只能验证时序与通道一致性,不能验证空间定位。库里有位置定义与示意图,但没有电极坐标,也没有与影像的配准。要做定位精度,需要自带标测系统的坐标真值。
Q9:数据里为什么没有左心房?
因为导管只进了右心房。左心房需要房间隔穿刺,操作风险与流程复杂度都更高,这批记录没有做。左房相关的公开数据多是影像与分割标注,例如 lascarqs。
Q10:全库 102.8 MB,需要多大内存?
解码成双精度浮点约四百余兆,单机完全够。若只做逐条分析,一条记录最多二十余兆,普通笔记本即可。
Q11:许可允许商用吗?
允许。ODC-BY 1.0 只要求署名,不限制商业使用,也不要求衍生作品以相同许可发布。署名时建议同时给出数据集名称、版本与 DOI。
Q12:没有配套论文,方法段落怎么写?
按官方页面描述写,并引用数据集本身。采样方式、导管规格、四个位置的定义、药物与时刻、注释生成工具,这些在页面上都有;采集年份、地点、患者临床背景页面上没有,只能写「官方未提供」。
术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 心内电图 | intracardiac electrogram | 电极位于心腔内部记录到的局部心肌电活动 |
| 双极导联 | bipolar | 两个相邻电极之间的电位差,抗远场干扰 |
| 十极导管 | decapolar catheter | 一根导管上排列十个电极,可组成五个双极 |
| 极间距 | electrode spacing | 电极中心之间的距离,本库为 2-5-2 毫米 |
| 上腔静脉口 | SVC | 上腔静脉与右心房交界处 |
| 下腔静脉口 | IVC | 下腔静脉与右心房交界处 |
| 三尖瓣环 | TVA | 右心房与右心室之间的瓣环 |
| 心房游离壁 | AFW | 右心房外侧壁,远离间隔 |
| 房颤 | atrial fibrillation | 心房快速无序的电活动,无有效收缩 |
| 房扑 | atrial flutter | 心房内大折返,激动频率规则且快 |
| 主导频率 | dominant frequency | 频谱中能量最高的频率,反映激动周期 |
| 碎裂电位 | fractionated potential | 局部电图出现多个低幅偏转,提示传导缓慢 |
| 激动顺序 | activation sequence | 波前依次经过各电极的先后关系 |
| 表观传导速度 | apparent conduction velocity | 极间距除以激动时间差得到的近似速度 |
| 腺苷 | adenosine | 短暂抑制房室结传导的药物,用于激发试验 |
| 异丙肾上腺素 | isoproterenol(Isuprel) | 提高交感张力、加快心房率的药物 |
| 洗脱 | washout | 药物作用逐渐消退的过程 |
| WFDB | Waveform Database | PhysioNet 的生理信号存储规范 |
| 头文件 | header file | 记录参数的纯文本声明,扩展名 .hea |
| 注释文件 | annotation file | 事件位置与类型的二进制文件 |
| 采样率 | sampling rate | 每秒采样点数,本库为 1000 Hz |
| 量化位宽 | resolution | 每个样本的二进制位数,本库为 14 |
| 校准 | calibration | 把整数样本映射到物理单位的过程 |
| 远场 | far field | 距离电极较远的心电活动在本地造成的投影 |
| 导管室 | electrophysiology lab | 进行电生理检查与消融的操作场所 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 受试者数 | 8 | 官方页面正文 | 官方 |
| 导管位置数 | 4 | 官方页面正文 | 官方 |
| 记录数 | 32 | RECORDS 清单 |
官方文件 |
| 每记录通道数 | 8 | 头文件第一行 | 官方文件 |
| 心内通道数 | 5 | 官方页面与头文件 | 官方 |
| 体表通道数 | 3 | 官方页面与头文件 | 官方 |
| 采样率 | 1000 Hz | 头文件第一行 | 官方文件 |
| 量化位宽 | 14 | 头文件信号行 | 官方文件 |
| 全库体积 | 102.8 MB | 官方页面 | 官方 |
| 单条时长范围 | 48.0–1369.3 秒 | 采样点数换算 | 推导 |
| 全库总时长 | 约 1.86 小时 | 采样点数换算 | 推导 |
| QRS 注释总数 | 8571 | 逐文件读取 | 推导 |
| 许可 | ODC-BY 1.0 | 官方页面 | 官方 |
| DOI | 10.13026/C23S33 | 官方页面 | 官方 |
附录 B:数字的来源分层
| 层级 | 含义 | 本篇中的例子 | 可信度 |
|---|---|---|---|
| 官方直述 | 项目页正文直接写出 | 8 位患者、4 个位置、1 kHz、102.8 MB、ODC-BY | 高 |
| 官方文件 | 头文件与清单里可读出 | 通道名、采样点数、年龄性别诊断、给药时刻 | 高 |
| 推导 | 由官方文件换算 | 单条时长、信号体积、注释条数 | 中,方法已写明 |
三层的差别在于是否需要中间计算。官方直述没有计算,官方文件是一次读取,推导要经过换算或统计。凡是推导值,本页都注明了换算方式,方便核对。未列入这三层的数字一律不写,包括剂量、采集年份、患者体重与左房内径。
附录 C:完整参考文献
| 编号 | 文献 | 用途 |
|---|---|---|
| 1 | Creare, Inc. Intracardiac Atrial Fibrillation Database, v1.0.0. PhysioNet, 2003. DOI 10.13026/C23S33 | 数据本体与全部事实 |
| 2 | PhysioNet 项目页 https://physionet.org/content/iafdb/1.0.0/ | 描述、许可、版本 |
| 3 | WFDB 软件包文档(PhysioNet) | 文件格式与读取接口 |
| 4 | sqrs 检测器说明(WFDB 附录) | 注释生成方式 |
| 5 | afdb 与 ltafdb 项目页 | §6 对照数据 |
附录 D:任务代码
批量把三十二条记录转成统一的宽表,并汇总每条记录的基本指标:
#-- 先取清单,再逐条转换;已有本地副本时跳过下载
mkdir -p iafdb_parquet
python3 - <<'PY'
import wfdb, pandas as pd
recs = [l.strip() for l in open('RECORDS') if l.strip()]
rows = []
for r in recs:
    rec = wfdb.rdrecord(r, pn_dir='iafdb')
    df = pd.DataFrame(rec.p_signal, columns=rec.sig_name)
    df.insert(0, 't_sec', df.index / rec.fs)
    df.to_parquet(f'iafdb_parquet/{r}.parquet', index=False)
    ann = wfdb.rdann(r, 'qrs', pn_dir='iafdb')
    rows.append({'record': r, 'sec': rec.sig_len / rec.fs, 'beats': len(ann.sample)})
pd.DataFrame(rows).to_csv('iafdb_index.csv', index=False)
print(len(rows), 'records done')
PY
跑完之后 iafdb_index.csv 就是一张三列索引:记录名、时长、注释数。后续任何分析都可以先在这张表上筛,再回读对应的 parquet,不必反复访问网络。
附录 E:如果只记五件事
| 序 | 记住这一条 |
|---|---|
| 1 | 八位患者、三十二条记录、四个右心房位置,全库不到两小时 |
| 2 | 五路心内双极加三路体表,1 kHz、14 位,幅度未校准 |
| 3 | 唯一的标注是自动生成的 QRS,没有节律段 |
| 4 | 它与 afdb、ltafdb 是不同观测面,不是同族的小样本版 |
| 5 | 值钱的地方是「唯一」:公开的右心房心内电图几乎没有第二份 |
编辑说明
本页事实部分依据 PhysioNet 项目页与库内 32 个头文件、32 个注释文件核对,核对于 2026 年 10 月。时长、体积、注释条数为换算值,换算方式已在正文与附录中标明。官方未提供的项目(采集年份、地点、剂量、患者临床背景、配套论文)在本页一律标为未提供,不作推测。原始数据版权归 Creare, Inc.,按 ODC-BY 1.0 使用;本页为说明文档,不包含数据本体。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- wctecgdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- ahadb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- chfdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- crisdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- cudb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- ltdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- ltstdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- mvtdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- nsrdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
- stdb — 共享标签:生理信号 / 心电信号 / 心血管疾病
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
