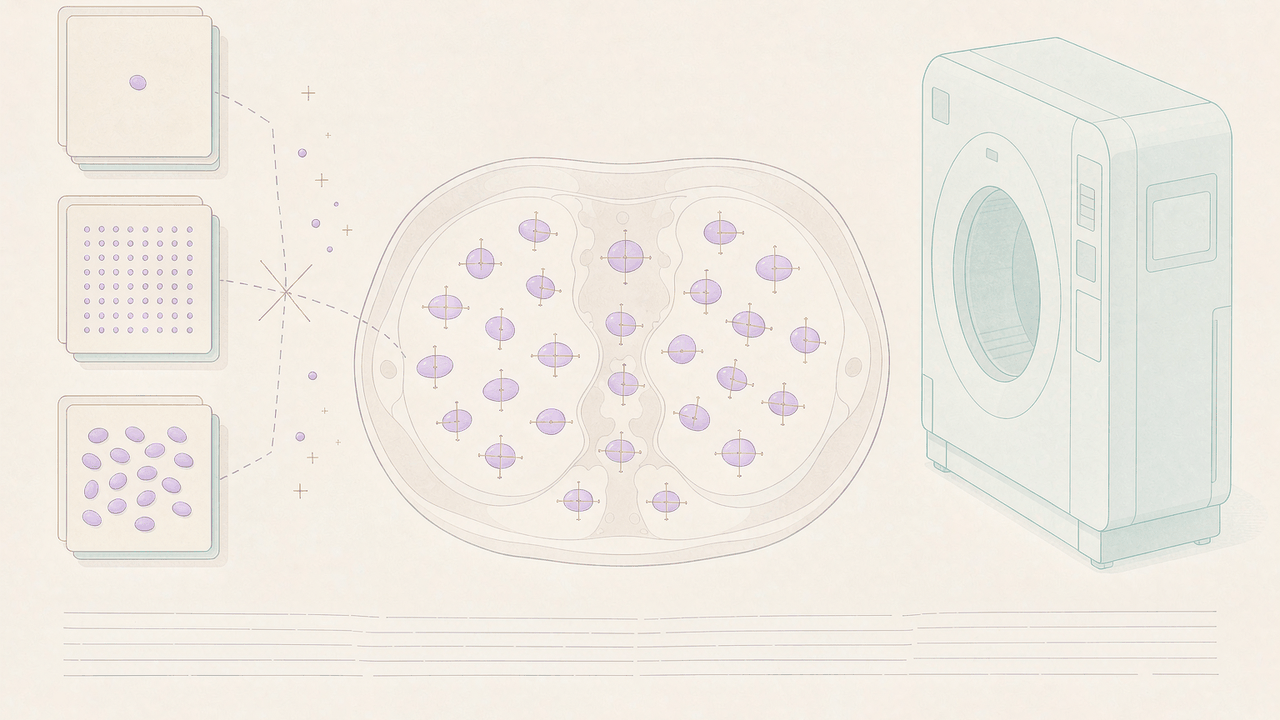
信息速览
CT 上的淋巴结是肿瘤影像里最容易被跳过的目标:它没有原发灶那样清晰的边界,没有转移灶那样可以凭代谢活性圈定的范围,多数时候只是血管旁一个略大的椭球。CT Lymph Nodes 把这一任务单独拎了出来——176 例纵隔与腹腔 CT,983 个由放射科医生逐个点出并量过轴径的淋巴结,外加一套与之独立生成的分割掩膜。
它的标题里写着一个不太好懂的词组:2.5D。这不是说影像被压扁了,而是指检出方法把三维体数据拆成一组带方向的二维切片来观察——后文 §3 会展开。真正让这份数据在中文语境里值得单独成篇的,是它同时给出了三种形态不同的标注:质心、候选点、掩膜。三者常被误当成同一批标注的三种存法,实际上它们回答的是三个不同的问题。
官方页面还明说了一件事:质心注释与掩膜索引不对应。这一句是整份数据最大的工程陷阱,§4 会逐层拆开。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 正式名称 | CT Lymph Nodes — A new 2.5D representation for lymph node detection in CT |
| 发布方 | NIH 临床中心 Imaging Biomarkers and Computer-Aided Diagnosis Laboratory |
| 分发方 | The Cancer Imaging Archive(TCIA),DOI 10.7937/K9/TCIA.2015.AQIIDCNM |
| 规模 | 176 例 / 352 序列 / 110,179 幅 / 58.42 GB |
| 图像模态 | CT(纵隔与腹部),另含随影像衍生的 SEG 对象 |
| 质心标注 | 388 个纵隔 + 595 个腹腔,合计 983 个,含体素索引、物理坐标、轴径 |
| 候选点集 | 704 个(集合页数据表「Access Points」列) |
| 分割掩膜 | 1,056 个对象,覆盖 176 例;NIfTI 与 DICOM-SEG 双格式 |
| 轴径口径 | 腹腔含长轴与短轴;纵隔仅短轴;短轴为 RECIST 判据 |
| 许可 | CC BY 3.0 |
| 版本 | v5,2023-03-31(新增 DICOM-SEG) |
| 状态 | Complete(官方状态栏) |
| 标注单位 | 单个淋巴结(不是病例、不是图像) |
§1 数据集速览:它到底是什么
1.1 一句话定义
CT Lymph Nodes 是一份按淋巴结为标注单位的 CT 检出参考集。它要回答的不是「这个病人有没有淋巴结肿大」,而是:
在盆腔到纵隔这一整段体数据里,哪几个位置是淋巴结,每个的短径是多少像素/毫米?
标注单位是「一个淋巴结」,不是「一例病人」,也不是「一幅图像」。这一点决定了它只能用于检出与定位类任务,而不能直接充当病例级的分类标签来源。一个病例可能贡献零个到十余个标注不等,模型必须在整卷数据上给出不定数量的框或点,这属于目标检测的题型,而不是图像分类。
1.2 为什么它不是一份普通的分割集
库内的器官分割集(如 TotalSegmentator、CT-ORG)的核心难点是「同类结构在不同人身上的形状变化」;CT Lymph Nodes 的核心难点恰好相反——淋巴结在不同人身上的位置几乎没有规律。官方对难点的描述集中在四点上:
| 官方描述的问题 | 工程含义 |
|---|---|
| 与周围结构对比度低(low contrast of surrounding structures) | 灰度阈值法在血管旁几乎必然失效 |
| 尺寸变化大(varying sizes) | 单一尺度的检测框或感受野无法覆盖 |
| 姿态变化大(varying poses) | 方向性过强的特征(如固定轴的切片堆)会漏检 |
| 分布稀疏(sparsely distributed locations) | 候选生成阶段的假阳性数量极多,评价必须看 FROC 而非准确率 |
第四点决定了这份数据天然带一条「候选点集」通道——稀疏目标的检测管线一定是「先大量生成候选,再逐级过滤」两段式,而这份数据把两段都给了。这一点在 §3 展开。
1.3 三十秒决策卡
| 你的处境 | 这份数据能帮你什么 |
|---|---|
| 要做「CT 上淋巴结检出」的第一版基线 | 983 个带轴径的质心是唯一可直接当参考标准的公开标注 |
| 已经有一个检测器,想知道它的假阳性有多离谱 | 704 个候选点可以做两级对照:候选召回率上限与后级分类器的筛选效果 |
| 要训练像素级的分割头而不是框 | 1,056 个掩膜可以独立成一支,但从一开始就按「与质心不同源」设计 |
| 写论文需要引用一份 NIH 出品的淋巴结数据集 | DOI 与三篇方法论文都落在官方引用栏,引用链完整 |
| 做 RECIST 自动测量的方法学研究 | 短轴是 RECIST 判据,腹腔子集还额外给了长轴 |
| 想拿它当转移性淋巴结的病理标签 | 给不了,见下节 |
1.4 不适合谁
如果你的需求是「判断某个淋巴结是不是转移」,这份数据给不了你病理性质。 集合页把它归在 Lymphadenopathy 与 Non-Cancer 两类下,标注只说明「这里有一个淋巴结」,不说明它是转移、反应性增生还是正常大小。要转移标签,得去 PSMA-PET-CT-Lesions 那类带显像剂摄取信息的病灶集,或者去做病理对照的临床队列。
如果你的需求是「病例级的纵隔分期」,同样不合适。983 个点分布在 176 例里,官方没有给出每例的阴阳性标签,也没有给出 TNM 分期。把点集聚合成病例级标签需要自行定阈值,而阈值怎么定,官方没有给依据。
如果你的需求是「足够大、足够杂的训练集」,也要慎用。176 例、单中心、纵隔与腹腔两个子集分开计数——它更像一个评测基准而不是大规模训练语料。
§2 数据构成与规格
2.1 官方给出的全部规模数字
集合页的数据表按四类资产分行列出,下面的表把每行的规模与许可并排放在一起,方便核对「哪个文件对应哪个计数」:
| 资产 | 格式 | 规模 | 计数口径 | 许可 |
|---|---|---|---|---|
| 影像 | DICOM | 176 例 / 176 研究 / 352 序列 / 110,179 幅 / 58.42 GB | 病例、研究、序列、图像四级 | CC BY 3.0 |
| 质心与轴径注释 | TXT、MPS、ZIP | 704 | 集合页计数列 | CC BY 3.0 |
| 候选点集 | ZIP | 1,056 | 集合页计数列 | CC BY 3.0 |
| 分割掩膜 | NIfTI、ZIP、SEG | 176 / 176 | 按病例计 | CC BY 3.0 |
这里必须点出一个口径冲突,而且是真实的:集合页数据表的计数列,与它上方说明文字的语义,指向的对象并非一一对应。说明文字写的是「388 个纵隔淋巴结、595 个腹腔淋巴结」,两数相加 983;而数据表里注释行与候选行的计数分别是 704 与 1,056。三个数字都出自同一页面,但它们是三套不同的东西:
- 983 是放射科医生手工标注的淋巴结总数(说明文字);
- 704 与 1,056 是数据表按行给出的交付对象计数(可能是文件数、对象数或别的单位,页面未逐项注明)。
常见做法是把 704 当成质心思数、把 1,056 当成掩膜对象数,这在多数二手资料里都这么写。但从页面本身只能确认两件事:质心标注在文字里是 983 个淋巴结,掩膜在文字里是「每例一个压缩 NIfTI」。1,056 落在掩膜行上,说明掩膜里被勾画的对象总数大致在这个量级;704 落在候选行上,说明候选点集的对象数在这一量级。二者是否恰好等于「淋巴结个数」,页面没有明说。
写论文时安全的写法是:质心数引 983(并按纵隔 388 / 腹腔 595 拆分),候选与掩膜的数量引数据表原值,并注明口径为集合页交付计数。把 983 与 1,056 当成「同一批淋巴结的两种表示」是错的,这是 §4 的主题。
2.2 两级分区:纵隔与腹腔
官方把标注拆成两个集合,来自两批扫描与两批标注流程:
| 子集 | 病例数(官方) | 淋巴结数(官方) | 轴径字段 | 对应的参考标准形态 |
|---|---|---|---|---|
| 纵隔 | 90 | 388 | 仅短轴 | 短轴单值 |
| 腹腔 | 86 | 595 | 长轴 + 短轴 | 双轴 |
两点要留意。
第一,90 + 86 恰好等于 176,但官方没有说这两批是按病例号互斥划分的,还是各自独立成集。从「合计 176 例」这一表述看,最可能的读法是两批互不重叠;但如果按 176 例来设计交叉验证划分,最好先用病例号自己去重确认一遍——如果存在重叠病例,同一病人在训练集与验证集两侧出现会直接高估指标。
第二,纵隔子集没有长轴。这意味着拿这份数据做「轴比」(长轴/短轴)形态特征的研究时,纵隔那 388 个点是不可用的,只能用腹腔那 595 个。官方只写了「纵隔集只含短轴」,没有解释原因,但从 RECIST 只认短径这一临床惯例看,短轴是必需项、长轴是附加项,纵隔侧省掉了附加项。
2.3 影像层的四个层级
影像是标准 DICOM 四级结构:病例(Patient)→ 研究(Study)→ 序列(Series)→ 图像(Image)。176 例对应 176 个研究、352 个序列,平均每例 2 个序列。110,179 幅除以 352 个序列,平均每序列约 313 幅。
平均每例两序列这个数字值得推一下。一份纵隔或腹部 CT 通常是单个序列装完的,平均 2 个序列说明相当一部分病例带了不止一个重建(不同层厚、不同重建核,或平扫加增强)。集合页没有逐例列出协议,所以「两个序列具体是什么关系」无法从页面本身确定,只能靠逐例读 DICOM 头去判断。
官方对影像来源有一句交代:DICOM 文件是用 ITK 的 ImageReadDicomSeriesWrite 示例从 Analyze 与 NIfTI 体数据转出来的。这句话的信息量比看上去大——原始体数据的格式是 Analyze 与 NIfTI,DICOM 是后转的。转换过程本身可能引入方向、原点、层间距上的偏差。读这份数据时,DICOM 头里的几何信息值得与标注文件里的物理坐标做一次交叉验证,而不是默认两者天然对齐。
2.4 一条质心注释记录长什么样
质心注释包解压后是「每例一个文件夹」的结构。下面是一个注释文件应有的最小形态(字段名以官方描述为准,各行用注释标出含义):
#-- 每行一个淋巴结;列序以实际文件为准,此处按官方描述的四类信息排布
#-- 1) 体素索引 2) 物理坐标 3) 尺寸测量 4) 所属病例
0    -31.5   128.0   64.0    9.8    0    0    0
     ^体素索引(列/行/层)  ^物理坐标(mm)  ^短轴(mm)  ^长轴(mm,仅腹腔有)
三个要点:
- 体素索引与物理坐标同时给出,这省掉了从 DICOM 头反推 transform 的一步,但两者若不一致(例如转换时的原点位移没有同步),以哪一套为准需要自己决定。多数再实现会选择物理坐标,因为它与图像方向无关。
.mps是 MITK 的点集文件,官方建议用 MITK workbench 打开,且明说只有 2014.10.0 及以后版本的点集交互插件支持可视化。想用脚本读的话,.mps是 XML,结构不复杂,但不如 TXT 稳。- 轴径单位:官方只写「shortest axis is used for the RECIST criteria」,没有逐字说明是毫米还是像素。按 CT 惯例与「最长轴、最短轴」的测量语义,通常理解为物理长度;但从注释本身无法百分百确认,落库前建议抽几个与体素间距反算核对。
2.5 与同类集合的定位差异
在肿瘤影像的病灶标注谱系里,CT Lymph Nodes 占的是一个偏窄但不可替代的格子:
| 数据集 | 标注对象 | 标注单位 | 与本期条目的差别 |
|---|---|---|---|
| CT Lymph Nodes | CT 上的淋巴结 | 单点 + 掩膜 | 唯一把淋巴结单列为任务的公开集 |
| PSMA-PET-CT-Lesions | PET/CT 上的肿瘤病灶 | 三维体积 | 病灶级,带摄取信息,但不是淋巴结专属 |
| LUNA16 | 肺结节 | 三维坐标 + 直径 | 结节与淋巴结形态相近,任务的评价体系(FROC/CPM)可迁移 |
| LIDC-IDRI | 肺结节(四阅片者) | 轮廓 + 分级 | 有阅片者间的多标注,可直接研究标注者差异 |
| TotalSegmentator / CT-ORG | 器官 | 体素 | 器官边界清晰,与淋巴结的低对比度难题互补 |
| NSCLC-Radiomics | 原发肿瘤 | 三维体积 | 带生存与分期,但对象是原发灶 |
| HECKTOR | 头颈原发灶与淋巴结 | 三维体积 | 少数同时含淋巴结的集,但限头颈区且与 PET 联合 |
决定性的一条:上面每一行都能给你病灶,只有这一行把淋巴结本身当成第一公民。做淋巴结检出这个独立任务时,其余数据只能作为迁移来源或负样本来源。
§3 任务层:三种标注形态回答三个问题
3.1 三套标注不是三种格式
这是三套标注里最需要先说清的一件事。三套标注看起来都是「CT 上淋巴结的位置信息」,很容易被当成同一次标注的三种导出格式——就像同一份数据既有 CSV 又有 JSON。实际上它们来自三个不同的产出流程,服务于三个不同的任务环节:
| 标注 | 形态 | 谁做的 | 回答的问题 | 对应任务环节 |
|---|---|---|---|---|
| 质心注释 | 点 + 轴径 | 放射科医生手工 | 淋巴结在哪,多大 | 检出评测的参考标准 |
| 候选点集 | 大量点 | 计算机方法生成 | 哪些位置值得可疑 | 假阳性削减的输入 |
| 分割掩膜 | 体素 | 手工勾画 | 淋巴结的边界在哪 | 像素级分割的监督 |
把这个区分想清楚,后面所有工程决策才站得住。反过来说,正是因为三者不同源,§4 那个「索引不对应」的坑才必然存在。
3.2 质心注释:一份人工参考标准
质心注释是这份数据里唯一由放射科医生逐点核过的部分。它的分量在于不可替代性——库内的淋巴结检出任务没有第二份公开金标准,而短轴又是 RECIST 的判据,所以这份注释同时扮演了「检出参考标准」和「疗效评估方法学素材」两个角色。
它的局限也很清楚:
- 点不等于范围。质心只告诉你位置,不告诉你边界,所以从质心做检出评测时,判定「预测框是否命中」要靠距离阈值,而阈值官方没给。
- 轴径只有标量。两个或一个数字,没有方向。想知道长轴的方向,得从掩膜里反推,而掩膜与质心不同源——这就是 §4 那个坑在实际使用中的第一处落脚。
- 纵隔侧只有短轴,见 §2.2。
3.3 候选点集:不是标注,是「别人方法的中途产出」
候选点集是最容易被误用的一个。它由两篇 SPIE Medical Imaging 2014 论文所述的方法生成——集合页同时引了 Cherry 等人的一篇与 Liu 等人的一篇,说明候选由两套方法产出后合在一个包里。它的用途是让后来者不必重跑候选生成,直接在同一批候选上比较后级分类器。
用它的正确姿势是:把它当作一个固定输入,而不是参考标准。
| 用法 | 是否成立 | 理由 |
|---|---|---|
| 在同一候选集上比较后级分类器 | 成立 | 这正是它被放出来的目的 |
| 当作检出任务的完整参考标准 | 不成立 | 它只含可疑点,不含人工判定哪个是真淋巴结 |
| 当作「难例挖掘」的现成素材 | 成立 | 候选里天然混有大量假阳性 |
| 拿来评估自己的候选生成器 | 部分成立 | 两者候选分布不同,比较时要同时报候选阶段的召回率 |
第二行是它最容易被踩的地方:候选点集里没有真伪标签,或者即使有,也不是放射科医生的判定。把它当成标签直接训练,等于把别人方法的错误学进自己的模型。
3.4 分割掩膜:另一支独立的手工标注
掩膜是每例一张压缩 NIfTI,体素值标记淋巴结区域,官方另给了由 dcmqi 转出的 DICOM-SEG 版本。官方明确要求使用掩膜时必须引用 Seff 等人 2015 年的 MICCAI 论文(关于中层语义边界线索的那篇)。
掩膜与质心的关系,官方原话是:掩膜由一套与注释包独立的流程产生,两者有重叠的淋巴结集合,但索引不对应。这句话在下一节展开,因为它是整份数据最大的使用风险。
3.5 三种标注怎么组合使用
实际项目里最常见的三种组合方式,对应三种工作量:
| 目标 | 所需标注 | 主要工作量 |
|---|---|---|
| 纯检出(框或点) | 只用质心 | 低:一套标注,坐标换算即可 |
| 纯分割 | 只用掩膜 | 中:NIfTI/DICOM-SEG 读入 + 与 DICOM 影像对齐 |
| 检出 + 分割联合训练 | 质心 + 掩膜 | 高:必须先解决索引错位,见 §4 |
| 候选生成 + 后级分类 | 候选 + 质心 | 中:候选本身无标签,要用质心做伪标签 |
第四行的做法要小心:用质心给候选打伪标签时,命中半径的取法会显著改变正负样本比例,而这个半径官方没有规定。
§4 标注对应层:为什么质心索引不了掩膜
4.1 官方原话
把这句话单独抄出来,是因为它决定了后面所有工程细节:
these segmentation masks were produced independently to the centroid annotations in MED_ABD_LYMPH_ANNOTATIONS.zip. There is an overlapping set of lymph nodes marked in both files but the indexing does not align.
翻译成可操作的判断是三句话:
- 掩膜与质心是两条独立流程的产物;
- 两者的集合有交集,不是互斥的两批淋巴结;
- 交集里的同一个淋巴结,在两份文件里的编号不同,按编号取会取错。
第三句是最贵的。它意味着 case_001/annotation_row_3 与 case_001_mask_object_3 不是同一个淋巴结,甚至可能一个指向纵隔、一个指向腹腔。
4.2 为什么会产生这种错位
从官方的版本历史可以还原时间线,错位的根因就在时间线里:
| 版本 | 日期 | 加入的内容 | 与错位的关系 |
|---|---|---|---|
| v1 | 2015-03-16 | 影像 | 无标注 |
| v2 | 2015-06-24 | 质心与轴径注释包 | 第一套标注落地 |
| v3 | 2015-09-14 | 候选点集 | 与质心无编号关系 |
| v4 | 2015-12-14 | 分割掩膜 | 第三套标注落地,独立流程 |
| v5 | 2023-03-31 | 掩膜的 DICOM-SEG 版本 | 不改变错位状态 |
两套标注相隔半年,由不同的人、为不同的论文(质心对应的 2.5D 检出方法 vs 掩膜对应的边界线索方法)产出,产出时没有做交叉编号,也没有在事后补一份对应表。这就是「独立生成」的具体含义。
值得注意的是,v5 之所以只加 DICOM-SEG 而没有顺手补一份对应表,最可能的原因是这个对应关系本来就不存在——掩膜流程未必是照着质心列表逐条勾画的,很可能是独立阅片后自行勾了看到的淋巴结。若真是如此,两边的交集只是「都看到了同一个淋巴结」,而不是「同一条标注的两种导出」。
4.3 错位的三种后果
按使用者的动作分三类:
第一类,按行号配对训练联合模型。 最典型的写法是读第 i 行质心,去掩膜里找第 i 个连通域,然后把「质心标签 = 掩膜中心」当成真值。这样构造出来的标签里,一部分是随机配对的,模型学到的是噪声。症状是训练损失看起来正常但验证集指标远低于预期,初学者往往去调超参,方向完全错了。
第二类,做「质心命中掩膜」的正确性抽检。 有一种看起来更谨慎的做法:把每个质心投影到掩膜上,看落点是否在某个连通域内,以此验证配对。这一步是必要的,但它只能告诉你「这个质心附近有没有掩膜」,不能告诉你「这个掩膜是不是这个质心对应的那个」。一个质心旁边恰好有另一个淋巴结的掩膜时,抽检会通过,配对仍然是错的。
第三类,统计两套标注的一致性。 想用两套标注做「标注者间一致性」研究时,错位会让任何自动配对的一致性系数都偏低,而这个偏低是假象——它测的是配对错误率,不是标注分歧。
4.4 正确做法:用物理坐标重新配准
唯一站得住的做法是绕过索引,用物理坐标做几何匹配。步骤如下:
- 从质心注释读出每个点的物理坐标(mm);
- 从掩膜 NIfTI 读出仿射矩阵,把每个连通域的质心算出来,同样换算到物理坐标;
- 在物理坐标空间里做最近邻匹配,并设一个距离阈值;
- 对阈值内的匹配人工抽检,对阈值外的两边各自保留为「单边标注」。
这套流程的关键在第三步:阈值不是一个可以随便取的数。取小了会漏配(同一个淋巴结因掩膜质心偏移而被判为不匹配),取大了会误配(相邻的两个淋巴结互相配错)。合理的起点是半个短轴,因为短轴是淋巴结半径的量级;但由于纵隔侧只有短轴、腹腔侧有两轴,阈值不能统一取。
下面是一段可运行的最小实现,用来完成前两步——把两套标注都换算到物理坐标:
#-- 依赖:nibabel(latest)、numpy。pip install nibabel numpy
import glob
import numpy as np
import nibabel as nib

def mask_centroids(nii_path):
    """读一张掩膜,返回每个连通域的物理坐标质心与体积(体素数)。"""
    img = nib.load(nii_path)
    data = np.asanyarray(img.dataobj)
    affine = img.affine
    labels = np.unique(data)
    labels = labels[labels != 0]               #-- 0 是背景
    out = []
    for lb in labels:
        ijk = np.argwhere(data == lb)           #-- 该标签的全部体素索引
        c_ijk = ijk.mean(axis=0)                #-- 体素空间的质心
        c_xyz = nib.affines.apply_affine(affine, c_ijk)   #-- 换到物理坐标 mm
        out.append({"label": int(lb), "xyz": c_xyz, "voxels": len(ijk)})
    return out

for p in sorted(glob.glob("MED_ABD_LYMPH_MASKS/*/*.nii.gz"))[:2]:
    print(p)
    for c in mask_centroids(p):
        print("  label", c["label"], "xyz(mm)", np.round(c["xyz"], 2), "vox", c["voxels"])
这段代码不假设任何索引关系,只依赖两个东西:掩膜的仿射矩阵,以及「每个淋巴结在掩膜里占一个标签值」这一常见约定。最后一条是假设,不是官方承诺——如果实际文件的标签是连通域编号而非离散标签,用 scipy.ndimage.label 先做一次连通域标号即可,代码结构不变。
4.5 配准之后的检查清单
配准做完不代表就对了。下面四项是判断配准质量的最低门槛:
| 检查项 | 做法 | 不通过说明什么 |
|---|---|---|
| 匹配率 | 统计质心侧有多少比例在阈值内找到掩膜 | 远低于预期说明阈值太小或仿射读错 |
| 一对多 | 统计一个质心匹配到多个掩膜的情形 | 阈值太大,或掩膜把相邻淋巴结连成一片 |
| 一对零 | 列出没有任何掩膜对应的质心 | 掩膜覆盖不全,这些质心只能用于检出任务 |
| 轴向一致性 | 检查匹配对的物理坐标在三个轴上的偏移分布 | 某一轴系统性偏移说明原点或方向没对齐 |
第三项尤其重要。掩膜与质心的集合只是部分重叠,必然存在只有质心没有掩膜的淋巴结,也必然存在只有掩膜没有质心的对象。做联合训练时必须把这两类分开处理,不能默认为零。
§5 使用层:把 DICOM、标注与掩膜接起来
5.1 取数路径
影像不走浏览器下载,而是走 TCIA 的 Data Retriever 客户端——集合页给出的 .tcia 档是客户端的载入清单。三个标注包则可以直接 HTTP 下载。推荐把两者分开处理:标注包小(合计不到 2 MB),可以放进取数脚本里;影像大,走客户端更稳。
#-- 三个标注包极轻,直接取;影像走客户端,见下文
curl -sO https://www.cancerimagingarchive.net/wp-content/uploads/MED_ABD_LYMPH_ANNOTATIONS.zip
curl -sO https://www.cancerimagingarchive.net/wp-content/uploads/MED_ABD_LYMPH_CANDIDATES.zip
curl -sO https://www.cancerimagingarchive.net/wp-content/uploads/MED_ABD_LYMPH_MASKS.zip
for f in MED_ABD_LYMPH_*.zip; do unzip -q -o "$f" -d "ext_${f%.zip}"; done
ls -d ext_*
镜像检索走 NCI Imaging Data Commons 的集合标识 ct_lymph_nodes,集合页给出的 Search 链接指向该过滤器。这条路适合已经有 IDC 元数据表的团队——可以在不下载影像的前提下先统计序列层面信息。
5.2 DICOM 读入与几何确认
#-- 依赖:pydicom(latest)、numpy
import glob
import numpy as np
import pydicom
from pydicom.pixel_data_handlers.util import apply_modality_lut

files = sorted(glob.glob("CT_Lymph_Nodes/*/*.dcm"))
dss = [pydicom.dcmread(f) for f in files]
dss.sort(key=lambda d: float(getattr(d, "InstanceNumber", 0)))
vol = np.stack([apply_modality_lut(d.pixel_array, d) for d in dss], axis=0)  #-- 轴序 z,y,x
ps = dss[0].PixelSpacing                  #-- [行间距, 列间距] mm
st = float(dss[0].SliceThickness)
print("shape", vol.shape, "pixel spacing", ps, "slice thickness", st)
print("IPP", dss[0].ImagePositionPatient, "IOP", dss[0].ImageOrientationPatient)
输出里的 ImagePositionPatient 与 ImageOrientationPatient 是后面配准的锚点。如果一次拿到的序列里这两项在层间不一致,说明序列混进了不同重建,需要先按 SeriesInstanceUID 分组。
5.3 候选点怎么接上影像
候选点集只给位置,要先看它落在影像的哪个层上。最小验证是做一次「候选点在影像里的灰度分布」统计,若分布与背景无差异,说明坐标或轴序搞错了。
#-- 依赖:nibabel、numpy;候选坐标同为物理坐标时可直接用 apply_affine 反算
import numpy as np
import nibabel as nib

def xyz_to_ijk(affine, xyz):
    inv = np.linalg.inv(affine)
    ijkh = inv @ np.append(np.asarray(xyz, float), 1.0)
    return tuple(int(round(v)) for v in ijkh[:3])

img = nib.load("CASE_001.nii.gz")
for xyz in [(0.0, 0.0, 0.0)]:        #-- 换成实际候选坐标
    ijk = xyz_to_ijk(img.affine, xyz)
    print("ijk", ijk, "value", float(img.dataobj[ijk]))
这里的 (0.0, 0.0, 0.0) 只是一个占位说明—实际使用时把候选文件里的每一行坐标传进来即可。重点是 xyz_to_ijk 这个反向变换:物理坐标进、体素索引出,任何一套标注接影像都绕不开它。
5.4 检出评测怎么写
检出任务的评测不能用准确率。稀疏目标下,一张切片上几十万个负位置与几个正位置,准确率能到 99.99% 而模型什么都没学到。标准做法是 FROC:按假阳性数分档,看每一档下的召回率。
#-- 依赖:numpy;输入为预测点 (x,y,z)、参考点 (x,y,z)、命中半径 r(mm)
import numpy as np

def hit_rate(pred, ref, r):
    """每个参考点是否被至少一个预测点命中,返回召回率与未命中的参考点下标。"""
    pred = np.asarray(pred, float)
    ref = np.asarray(ref, float)
    missed = []
    for i, p in enumerate(ref):
        d = np.linalg.norm(pred - p, axis=1) if len(pred) else np.array([np.inf])
        if d.min() > r:
            missed.append(i)
    return 1.0 - len(missed) / max(len(ref), 1), missed

ref = [(1.0, 2.0, 3.0), (10.0, 10.0, 10.0)]
pred = [(1.2, 2.1, 2.9), (50.0, 50.0, 50.0)]
print(hit_rate(pred, ref, r=5.0))
r 的取值是这份数据上最需要交代清楚的一件事。有文献用「命中质心即算对」,有文献用固定毫米阈值,两种口径的召回率不可直接比较。写报告时把 r 明确写出来,比自己定一个值更有意义。
5.5 掩膜侧的 DICOM-SEG 读取
v5 新增的 DICOM-SEG 让不装 NIfTI 工具链的团队也能直接读掩膜。两条路各有取舍:
| 路线 | 优点 | 代价 |
|---|---|---|
| NIfTI + nibabel | 代码最短,与影像索引转换简单 | 需自己处理仿射与 DICOM 方向的对应 |
| DICOM-SEG + pydicom/highdicom | 与影像同一坐标体系,省一次配准 | 需理解 Segment 序列与帧引用结构 |
对「质心与掩膜配准」这件事来说,路线二更有吸引力:DICOM-SEG 里的帧引用直接指向影像的 SOP Instance UID 与帧号,比 NIfTI 的仿射矩阵更难搞错。这也是 v5 值得单独提一句的原因——它没有改变错位问题,但降低了另一类错误(方向与原点)的发生概率。
#-- 依赖:pydicom(latest);读取 DICOM-SEG 的段定义,不做像素解码
import glob
import pydicom

segs = glob.glob("CT_Lymph_Nodes/*/SEG/*.dcm")
ds = pydicom.dcmread(segs[0])
print("SOPClass", ds.SOPClassUID)
print("NumberOfFrames", ds.NumberOfFrames)
for s in ds.SegmentSequence:
    print("segment", s.SegmentNumber, "label", s.SegmentLabel)
输出的 SegmentLabel 是判断「掩膜按什么单位切段」的关键:如果每例段数等于该例的淋巴结数,说明标注者按淋巴结逐段编号;如果只有一段,说明整卷是一个二值掩膜。两种情形的后续处理完全不同,而这一点在集合页上没有写。
§6 与库内条目的关系
这份数据在库内的位置很有意思:它是淋巴结这个任务位上唯一的条目,所以与它相邻的不是同类,而是上游的任务范例与下游的互补数据。
| 库内条目 | 关系类型 | 具体怎么互补 |
|---|---|---|
| PSMA-PET-CT-Lesions | 任务互补 | 那边是病灶(含转移淋巴结)的三维分割,这边是淋巴结的检出点;一个走「找到全部」路线,一个走「描出边界」路线 |
| LUNA16 | 方法迁移 | 同为稀疏小目标检出,FROC 评价体系与候选点两段式管线可以直接搬过来 |
| LIDC-IDRI | 标注范式参照 | 那边有多阅片者四重标注,可用来讨论「如果有多个标注者,这份数据的一致性会是多少」 |
| TotalSegmentator、CT-ORG | 前处理依赖 | 淋巴结检出前的器官定位、腹腔与纵隔分区,可以直接复用器官分割结果做感兴趣区裁剪 |
| NSCLC-Radiomics | 临床语义衔接 | 那边带分期与生存,这边的淋巴结点可以在同一批影像类型上做区域级筛查的探索 |
| HECKTOR 2026 | 分区互补 | 那边覆盖头颈区原发灶与淋巴结,这边覆盖纵隔与腹腔,两者拼起来接近全身淋巴结图谱的两段 |
| HNSC | 邻近解剖区间 | 头颈鳞癌的病例影像与这边的纵隔上界有重叠,做全身化时需要注意衔接处的定义 |
从检索路径看,找「检出类任务」可以从 LUNA16 与本期条目出发,找「病灶分割类」从 PSMA-PET-CT-Lesions 与 HECKTOR 出发,找「器官级先验」从 TotalSegmentator 出发。三条路径互不覆盖,合起来才构成一份影像任务的完整地图。
§7 质量评估与局限性
7.0 阅读本节前需要知道的一件事
这份数据不适合用「训练集」的标准来评价。它的病症不在规模,而在标注形态的分裂:三套标注各成一体,官方明说其中两套索引不对应,却没有给出对账表。任何「标注质量好不好」的判断,都必须先落到「你说的是哪一套标注」上。
两个最常见的评价框架错位:
错位一,把它当训练语料评分。 176 例的体量,放在动辄数万例的现代影像数据集里并不起眼,但这个评价没有意义——它的定位是评测基准与参考标准,不是预训练语料。按「够不够训」来评,会得出「太小了」的结论,而这个结论本身对它不构成批评。
错位二,把三套标注当一套评分。 看到「983 个淋巴结」和「1,056 个掩膜」,先问一句「这两个数字说的是同一批东西吗」。答案是否定的。把两套标注当作一次标注的两种表示来评覆盖率,会得出一个既非 100% 也无法解释的数字。
7.1 局限一:标注不同源,且没有对账
这是所有局限里唯一达到「会直接导致模型出错」级别的。§4 已详述,这里只补充两句。
它的影响面比想象中大:不只是联合训练受影响,任何「用掩膜去验证质心」或「用质心去验证掩膜」的抽检都受影响。换句话说,这份数据没有提供任何一条标注正确性的交叉证据。在使用时,两套标注各自的可信度只能靠引用来源(两篇不同的 MICCAI 论文)间接担保。
7.2 局限二:轴径字段的不对称
纵隔只有短轴、腹腔有长短两轴。这个不对称带来三处具体麻烦:
| 场景 | 麻烦 | 处理建议 |
|---|---|---|
| 用轴比做形态特征 | 纵隔侧算不出 | 只用腹腔 595 个,或从掩膜反推长轴 |
| 统一训练一个轴径回归头 | 目标维度不同 | 分两个头,或只回归短轴 |
| 按短径分档做亚组分析 | 可行 | 短径两边都有,这是唯一可直接合并的字段 |
第三行是好消息:如果研究目的只需要短径,两批可以直接合并,不需要任何额外处理。这也解释了为什么官方在纵隔侧省掉了长轴——对 RECIST 而言,短径是充分信息。
7.3 局限三:病例层面的口径不完整
官方给了病例数、淋巴结数、轴径,但没有给这些:
- 每例的淋巴结个数分布(只有总数);
- 两批病例是否互斥;
- 扫描协议(层厚、重建核、是否增强);
- 淋巴结的病理性质。
前两项影响队列设计,第三项影响模型的可迁移性判断,第四项影响任务的语义边界。它们都不在页面上,只能靠逐例读 DICOM 头与影像自己补。
7.4 局限四:候选点集的时效性
候选点集来自 2014 年前后的方法。以今天的目标检测水平看,这个候选集的召回率上限大概率低于现代检测器的独立召回,直接在同一候选集上比较新旧方法,会系统性压低新方法的成绩。合理做法是同时报告「固定候选集上的结果」与「自生成候选上的结果」,把两者分开。
7.5 局限五:单中心
全部影像来自 NIH 临床中心。单中心意味着扫描设备、重建参数、患者人群都相对同质化,跨机构泛化能力无法从这份数据本身评估。这在检测任务上尤其要小心,因为不同机构的层厚与重建核会显著改变淋巴结的外观与边界清晰度。
7.6 DAIMS 评分
按 DAIMS(Data and AI Model Stewardship)的框架逐层打分。八行分属三层:描述层看「说得清不清」,结构层看「组织得好不好」,访问层看「拿得到、拿得稳、用得合法」。
| 层 | 检查项 | 判定 | 依据 |
|---|---|---|---|
| 描述层 | 身份与边界 | 良好 | 名称、DOI、发布机构、分发机构齐全;但「癌症类型」标为 Lymphadenopathy 与 Non-Cancer,与淋巴结任务的语义有张力 |
| 描述层 | 文档完备度 | 中 | 版本历史五版齐全、三个标注包各有说明与引用论文;但缺逐例协议表与两套标注的对账说明 |
| 结构层 | 标识体系 | 良好 | 影像走 DICOM 四级标识,注释走病例号 + 序号,掩膜走标签值;三套标识互不相通 |
| 结构层 | 层级一致性 | 中 | 病例→序列→图像三级一致;但标注层与影像层之间没有官方外键,质心与掩膜之间也没有 |
| 结构层 | 模态配对 | 良好 | CT 与 SEG 同集合配对,v5 起 DICOM-SEG 与影像共享 SOP Instance 引用 |
| 访问层 | 开放程度 | 良好 | 无需申请,标注包直接 HTTP 下载,影像走公开客户端与 IDC 检索 |
| 访问层 | 可复现性 | 中 | 版本号与日期齐全、镜像可检索;但缺标注规程文档,两套标注的产出流程只能靠论文反推 |
| 访问层 | 许可清晰度 | 良好 | 四类资产分别标 CC BY 3.0,无附加限制;TCIA 另有数据引用要求 |
汇总看,描述层与访问层没有硬伤,扣分集中在结构层的「标识不通」——这恰好是 §4 那个坑的根子在元数据层面的表现。同一个问题在结构层扣分,在使用层变成工程陷阱,两处是同一件事。
7.7 外部验证矩阵
| 验证维度 | 能否用本集合独立完成 | 说明 |
|---|---|---|
| 检出召回率 | 可以 | 983 个质心即参考标准,但命中半径须自定 |
| 假阳性削减效果 | 可以 | 需自建负样本,候选集只能作为对照 |
| 像素级分割精度 | 部分可以 | 有掩膜,但掩膜与质心不对应,联合评测困难 |
| 轴径测量误差 | 可以 | 短轴两侧都有,腹腔侧可测长轴 |
| 跨机构泛化 | 不可 | 单中心,无外部验证集 |
| 病理金标准符合度 | 不可 | 无病理性质标签 |
| 标注者间一致性 | 不可 | 单一标注流程,无多阅片者 |
七行里有四行可以独立完成,三行不可。可完成的四行正好覆盖检出与分割两个主任务;不可完成的三行都指向「缺少第二来源的对照」,这与 §7.1 是同一件事的不同侧面。
§8 版本与生态
8.1 五个版本的节奏
| 版本 | 日期 | 变更 | 影像规模 | 变化幅度 |
|---|---|---|---|---|
| v1 | 2015-03-16 | 影像上线 | 176 例 / 176 序列 / 110,003 幅 | — |
| v2 | 2015-06-24 | 加质心与轴径注释 | 同上 | 加一个标注包 |
| v3 | 2015-09-14 | 加候选点集 | 同上 | 加一个标注包 |
| v4 | 2015-12-14 | 加分割掩膜 | 同上 | 加一个标注包 |
| v5 | 2023-03-31 | 加掩膜的 DICOM-SEG 版本 | 176 例 / 352 序列 / 110,179 幅 | 补格式,不加标注 |
前四个版本挤在 2015 年的九个月里,之后停了七年多。这个节奏说明标注工作在 2015 年底就基本收尾,后续只是补交付格式。
v5 的影像计数变化值得单说一句:序列数从 176 变成 352,图像数从 110,003 变成 110,179。序列数翻倍而图像数几乎不变,最合理的解释是原有序列被拆分或重新打包(例如把 SEG 对象作为独立序列计入),而不是新增了影像。176 幅的增量与「每例一张掩膜」的量级一致。
8.2 生态位:TCIA 里的一个特例
TCIA 的集合大多是单病种临床影像队列,配一套分割或分类标注。CT Lymph Nodes 是个特例——它的主角不是病例,而是解剖结构。176 例影像更像是「装淋巴结的容器」,真正的交付物是那三套标注。
这一定位决定了它在生态里的角色:
| 角色 | 表现 |
|---|---|
| 方法基准 | 集合页明说目的是「make direct comparison to other detection methods」 |
| 教学素材 | 淋巴结检出是住院医师培训的典型难题,带金标准的小样本集很稀缺 |
| 方法论文的配套数据 | 三篇引用论文分别是 2014 MICCAI、2014 MICCAI、2015 MICCAI,全部围绕检出方法 |
8.3 它是怎么来的
三篇论文的时间顺序给出了一条清晰的线索:
- 2014 年 MICCAI 的 2.5D 表示论文(Roth 等),提出把三维数据拆成带方向的二维切片组,配合随机深度卷积特征做检出——集合标题里的「2.5D」就是这篇的遗产;
- 2014 年 MICCAI 的二维视图聚合论文(Seff 等),用浅层线性分类器层级做多视图聚合;
- 2015 年 MICCAI 的边界线索论文(Seff 等),处理分割与检出中的边界,官方要求使用掩膜时引用它。
三篇论文对应三套标注的产出节点,顺序与版本历史完全吻合。这说明数据集的发布不是一次性工程,而是跟着论文走——每做完一项方法研究,就把支撑它的标注放出来。这也解释了为什么三套标注之间没有统一编号:它们本来就是三条研究线的副产物。
8.4 它靠什么活着
一份 2015 年停更、2023 年只补格式的数据集,到今天仍然被引用,靠的不是维护投入,而是三件事:
第一,任务位没有替代品。 库内如此,公开数据集里也如此。淋巴结检出这个任务被大量论文引用,但可直接对标的公开金标准极少,CT Lymph Nodes 长期占着这个位置。
第二,托管方是长期机构。 TCIA 由 NCI 资助运维,集合的 DOI 与检索入口有机构级保障,不会因为作者退休或实验室关停而消失。
第三,引用链完整。 从数据 DOI 到三篇方法论文,再到后续引用它的工作,形成了一条可以逐级回溯的链条。引用者需要引用它,被引用者又通过引用把它带回视野,这是一个自维持的循环。
反过来说,它也有一个明确的脆弱点:一旦出现第二个带病理金标准的淋巴结检出集,它的不可替代性会立刻下降。到那时,三套标注不对应的毛病会从「可以忍」变成「为什么不换一个」。
8.5 为什么这种「科研副产物」能活下来
值得多想一层:一个只有 176 例、标注还互不对应的数据集,凭什么被认为有价值?
答案在任务本身。检出任务的评价需要一个共同的分母——如果每个人都用自己的数据、自己的命中阈值,论文之间就无法比较。这份数据提供的就是这个分母:同一批影像、同一批质心、同一个 DOI。它的价值不在于数据多好,而在于大家都用同一份。这也是它明说「用于与其他检测方法做直接比较」的原因。
§9 使用指引
9.1 三种角色的路径
| 角色 | 第一步 | 第二步 | 第三步 |
|---|---|---|---|
| 做检出基线 | 只取质心包,先跑通坐标换算 | 用 FROC 在 983 个点上评 | 再引入候选集做两段式 |
| 做分割 | 只取掩膜包,先核对段定义 | 与 DICOM 影像做几何对齐 | 需要质心时走 §4.4 的重配准 |
| 做方法学综述 | 读集合页版本表与三篇论文 | 按三套标注分别统计引用情况 | 指出索引不对应这一结构性缺陷 |
三种角色的共同前置动作是同一个:先把「我要哪一套标注」定下来。这一步没定,后面的代码都会白写。
9.2 最小可行流程
从拿到数据到跑出第一个指标,最短的路径是六步:
- 用 Data Retriever 载入
.tcia清单,下载影像; - 直接下载三个标注包并解压;
- 抽一例,把 DICOM 卷读成数组,确认轴序与体素间距;
- 把该例的质心坐标换算到体素索引,在影像上打印灰度,确认落在软组织而非空气或骨骼;
- 用 §5.4 的 FROC 函数,对一组随机预测点跑一遍,检查指标是否接近零(若不为零,说明代码有 bug);
- 换真实预测,跑 FROC。
第四步是整条流程里最容易被跳过的一步,也是最省时间的一步——坐标一旦搞错,后面所有指标都是假的,而且假得不容易发现。
9.3 在 AI 流程中的位置
原始 DICOM ──► 器官分割(TotalSegmentator 等)──► 感兴趣区裁剪
                                                      │
                                                      ▼
                                        候选生成(可选:复用候选点集作对照)
                                                      │
                                                      ▼
                                        后级分类 / 检出头
                                                      │
                                                      ▼
                                        FROC 评测(983 个质心)
                                                      │
                                                      ▼
                                        如需要边界 ──► 掩膜分支(独立配准)
这条流水线里,CT Lymph Nodes 出现在两个位置:末端的评测,以及中段候选生成的对照。它不在最前面——它不是预训练语料,不承担表征学习的角色。
9.4 常见工程决策的取舍
| 决策点 | 保守做法 | 激进做法 | 适用于 |
|---|---|---|---|
| 命中半径 | 固定毫米阈值,写进报告 | 按短轴比例 | 论文之间可比 / 内部调优 |
| 是否合并纵隔与腹腔 | 分两套指标 | 合并一套 | 研究子集差异 / 追单一大数 |
| 是否用候选点集 | 只作对照 | 直接当输入 | 新旧方法比较 / 快速出结果 |
| 是否要掩膜 | 检出任务不要 | 联合训练要 | 单一任务 / 多任务 |
四行的共性是:保守做法都更慢但更可比,激进做法更快但更难与别人对齐。这一判断可以直接套用到这份数据上,因为它本身就是一个为了可比性而存在的集合。
§10 AI 使用声明
| 项 | 内容 |
|---|---|
| 数据性质 | 科研用公开影像数据,非临床诊疗用途 |
| 适用任务 | 淋巴结检出、定位、轴径测量、分割;检出方法评测 |
| 不建议用途 | 直接用于临床诊断、以淋巴结计数替代分期、在无病理对照的情况下推断转移 |
| 训练伦理 | 影像为回顾性采集,TCIA 已做去标识处理;引用时须按官方要求附 DOI |
| 引用要求 | 使用影像与质心引用数据 DOI;使用掩膜另引 Seff 2015 |
| 版本基线 | 写作以 v5(2023-03-31)为准,早期版本标注不完全 |
| 已知风险 | 质心与掩膜索引不对应;纵隔无长轴;无病理标签;单中心 |
| 维护状态 | 官方标为 Complete,实质性更新停在 2015 年,2023 年仅补格式 |
常见误读
| 常见说法 | 实际情况 | 证据 |
|---|---|---|
| 「质心文件和掩膜文件按序号一一对应」 | 两套标注独立生成,索引不对应,同号可能指向完全不同的淋巴结 | 集合页原句:the indexing does not align |
| 「983 个质心就是 1,056 个掩膜的另一版本」 | 质心数与掩膜对象数是两套流程的各自产出,官方未给对账 | 说明文字给 388 + 595;数据表分别在注释行与掩膜行列 704 与 1,056 |
| 「候选点集就是弱标注的真值」 | 候选是方法生成的可疑点,不含放射科医生的真伪判定 | 集合页注明候选来自两篇 SPIE 2014 方法论文 |
| 「三套标注是同一次标注的三种格式」 | 三者是三个任务环节的产物:检出、假阳性削减、分割 | 版本 v2/v3/v4 分三次加入,各自对应不同论文 |
| 「纵隔也有长轴,只是没导出来」 | 官方明确纵隔集只含短轴 | 集合页:The mediastinal set only includes the shortest axis |
| 「有淋巴结标注就能判断是不是转移」 | 标注只给位置和尺寸,不给病理性质 | 集合页只把癌症类型标为 Lymphadenopathy 与 Non-Cancer |
| 「176 例就是 90 + 86 两批互斥」 | 两数相加确为 176,但页面未说明是否按病例互斥划分 | 集合页只分别给出两批病例数与标注数 |
| 「DICOM 是原始格式」 | DICOM 由 Analyze 与 NIfTI 体数据经 ITK 示例转出 | 集合页 Detailed Description 段 |
| 「掩膜可以直接当检出评测的参考」 | 掩膜与质心不重叠部分会污染评测,且掩膜可能漏掉无遮蔽的淋巴结 | 官方称两者只是 overlapping set |
| 「这份数据规模太小所以没价值」 | 它的定位是跨方法比较的共同分母,不是预训练语料 | 集合页:make direct comparison to other detection methods |
FAQ
Q1:这份数据到底有几例?
176 例。官方同时给出纵隔 90 例、腹腔 86 例的标注计数,两数相加恰好是 176,但页面没有明说两批是否按病例互斥划分。
Q2:983 与 704、1,056 哪个是淋巴结总数?
983 是放射科医生手工标注的淋巴结数,仅此一个来源有明确语义。704 与 1,056 是集合页数据表针对注释与候选两行列出的交付计数,口径未逐项注明,引用时须标清。
Q3:质心和掩膜能按编号对上吗?
不能。官方明说两套标注独立生成、索引不对应。必须用物理坐标重新匹配。
Q4:命中半径应该取多少?
官方没有规定。常见做法是取固定毫米阈值并在报告中写明,或按短轴比例取。不同取法的召回率不可直接比较。
Q5:为什么标题里有 2.5D?
因为配套方法把三维体数据拆成一组带方向的二维切片来做检出,2.5D 指这种介于二维与三维之间的表示,不是影像被压缩。
Q6:能用来训练分割模型吗?
可以,但只能用掩膜那一支。掩膜共 176 例、1,056 个对象,体量偏小,更适合做微调或评测。
Q7:能当淋巴结转移的检测数据用吗?
不建议。标注不含病理性质,无法区分转移、反应性与正常。
Q8:需要申请才能下载吗?
不需要。标注包可直接下载,影像走 TCIA 公开客户端,也可从 IDC 检索。使用需遵守数据引用要求。
Q9:许可是什么?
CC BY 3.0,四类资产分别标注。署名即可使用、修改与再分发。
Q10:v5 更新了什么?
只新增了掩膜的 DICOM-SEG 版本,没有新增标注,也没有解决索引不对应问题。
Q11:为什么序列数从 176 变成 352?
官方未解释。序列数翻倍而图像数几乎不变,最可能是原有内容被拆成独立序列计入,而非新增影像。
Q12:纵隔那批能算轴比吗?
不能。纵隔只记短轴。要算轴比只能用腹腔那 595 个,或从掩膜反推长轴。
术语表
| 术语 | 含义 |
|---|---|
| 淋巴结检出(lymph node detection) | 在影像中定位淋巴结并给出位置的任务,评价单位是单个淋巴结 |
| 2.5D | 把三维体数据拆成带方向的二维切片组来做处理的表示方式 |
| 质心(centroid) | 淋巴结的标记点,本集合以体素索引与物理坐标两种方式给出 |
| 短轴(shortest axis) | 淋巴结横断面上的短径,RECIST 判据使用的量 |
| 长轴(longest axis) | 横断面上的长径,仅腹腔子集提供 |
| RECIST | 实体瘤疗效评价标准,以淋巴结短径变化作为判定依据 |
| 候选点(candidate) | 检测管线第一阶段生成的可疑位置,数量大、含大量假阳性 |
| 假阳性削减(false positive reduction) | 检测管线第二阶段,对候选逐个分类 |
| 掩膜(mask) | 以体素标记区域的二值或多值数据 |
| DICOM-SEG | 把分割结果编码进 DICOM 的专用对象类型,与影像共享坐标体系 |
| NIfTI | 常见医学影像体数据格式,含仿射矩阵 |
| MPS | MITK 的点集文件格式,用于存放一组标记点 |
| MITK | 开源医学影像交互工具,官方推荐用于查看点集 |
| 仿射矩阵(affine) | 体素索引与物理坐标之间的线性变换加平移 |
| FROC | 自由响应受试者工作特征曲线,稀疏目标检出的标准评价方法 |
| CPM | 竞争概率度量,FROC 的单一数值汇总 |
| SOP Instance UID | DICOM 图像的唯一标识,DICOM-SEG 用它引用帧 |
| dcmqi | 把分割结果与 DICOM 互转的开源工具 |
| IDC | NCI Imaging Data Commons,TCIA 影像的云端检索入口 |
| 研究(Study) | DICOM 四级结构中的一级,通常对应一次检查 |
附录 A:条目信息速查卡
| 项 | 值 |
|---|---|
| 全称 | CT Lymph Nodes — A new 2.5D representation for lymph node detection in CT |
| DOI | 10.7937/K9/TCIA.2015.AQIIDCNM |
| 规模 | 176 例 / 352 序列 / 110,179 幅 / 58.42 GB(仅此一处列全,其余章节按需引用其中单项) |
| 标注 | 983 个质心(纵隔 388 / 腹腔 595)+ 候选点集 + 1,056 个掩膜对象 |
| 许可 | CC BY 3.0 |
| 版本 | v5 / 2023-03-31 |
| 检索标识 | 集合页 ct-lymph-nodes;IDC 过滤器 ct_lymph_nodes |
| 阅读顺序 | 先 §2 看规模口径冲突,再 §4 看索引不对应,最后 §7 看评分 |
附录 B:交付文件怎么用
| 文件 | 内容 | 大小 | 格式 | 先做什么 |
|---|---|---|---|---|
| TCIA_CT_Lymph_Nodes_03-31-2023.tcia | 影像下载清单 | — | TCIA 客户端档 | 交给 Data Retriever 载入,不要手解 |
| MED_ABD_LYMPH_ANNOTATIONS.zip | 质心、轴径、点集 | 306.96 kB | TXT / MPS / ZIP | 先读 TXT,.mps 留作可视化用 |
| MED_ABD_LYMPH_CANDIDATES.zip | 候选点集 | 603.88 kB | ZIP | 先统计候选总数与每例候选数 |
| MED_ABD_LYMPH_MASKS.zip | 分割掩膜与 DICOM-SEG | 1.2 MB | NIfTI / SEG / ZIP | 先读段定义,确认按什么单位切段 |
| 影像本体 | 纵隔与腹部 CT | 58.42 GB | DICOM | 先抽一例核对几何信息再批量 |
五个文件里只有影像本体需要大容量规划,其余四个加起来不到三兆。说明一件事:这份数据的下载瓶颈不在标注,而在影像;但使用瓶颈恰好相反,卡在标注上。
附录 C:外部资源对照
| 资源 | 用途 | 地址类型 |
|---|---|---|
| TCIA 集合页 | 官方说明、版本历史、数据表 | 集合主页 |
| 数据 DOI | 引用与版本定位 | DataCite |
| MICCAI 2014 2.5D 论文 | 方法背景,标题来源 | Springer 章节 |
| MICCAI 2014 视图聚合论文 | 候选生成方法背景 | arXiv 与技术报告 |
| MICCAI 2015 边界线索论文 | 使用掩膜时必引 | Springer 章节 |
| NCI IDC | 云端检索与元数据浏览 | 检索平台 |
| dcmqi | NIfTI 与 DICOM-SEG 互转 | 开源工具 |
| MITK | 点集可视化 | 开源工具 |
七类资源里,只有前两项是「用这份数据必须打开」的,其余都是按需。三篇论文的分工也值得记牢:2.5D 那篇解释标题,视图聚合那篇解释候选从哪来,边界线索那篇解释掩膜从哪来——三套标注对应三篇论文,没有一篇是统管全部的。
附录 D:三套标注对照速查
| 项 | 质心 | 候选 | 掩膜 |
|---|---|---|---|
| 产出者 | 放射科医生 | 计算机方法 | 手工勾画 |
| 单位 | 单个淋巴结 | 可疑位置 | 区域 |
| 数量 | 983 | 704(数据表) | 1,056(数据表) |
| 是否含真伪判定 | 是(都是真淋巴结) | 否 | 是(勾出的区域) |
| 有无轴径 | 有 | 无 | 可反推 |
| 对应任务 | 检出评测 | 假阳性削减 | 分割 |
| 与其他套的关系 | 与掩膜部分重叠但不对应 | 独立 | 与质心部分重叠但不对应 |
| 对应论文 | 2.5D 表示(Roth 2014) | Cherry 2014 / Liu 2014 | 边界线索(Seff 2015) |
| 版本加入时点 | v2(2015-06) | v3(2015-09) | v4(2015-12) |
这张表可以当成全文的一句话总结:九行里有五行都在说「三者彼此独立」,只有一行(轴径)说明它们有共同的信息面。看懂了这张表,§3 与 §4 就不必再读第二遍。
附录 E:版本变更日志
| 版本 | 日期 | 变更点 | 对使用者的影响 |
|---|---|---|---|
| v1 | 2015-03-16 | 影像上传 | 只有影像,无任何标注 |
| v2 | 2015-06-24 | 经 wiki 加入质心与轴径注释包 | 检出任具备参考标准 |
| v3 | 2015-09-14 | 经 wiki 加入候选点集 | 可做两段式管线对照 |
| v4 | 2015-12-14 | 经 wiki 加入分割掩膜 | 分割任务可用,但同时引入索引错位 |
| v5 | 2023-03-31 | 加入掩膜的 DICOM-SEG 版本(dcmqi 转出) | 省一次方向配准,但不解决错位 |
五次变更里,v4 是唯一一次会改变使用方式的加入——它把一个纯检出的集合变成了「检出 + 分割」的双任务集合,也正是在这一步,两套标注的编号脱了钩。如果只做检出,v2 版本的数据就够用;只有需要边界时才必须升到 v4 之后,并接受 §4 描述的那份额外工作量。
编辑说明
核验时间:2026-10-29。核验方式:直接读取 TCIA 集合页正文(cancerimagingarchive.net/collection/ct-lymph-nodes/),逐段比对「Description」「Annotation files」「Data Access」「Previous Versions」四处,未使用第三方转载。该域名在本沙箱的 shell 出网白名单之外,curl 返回空白,取数改走网页正文抓取。
与常见二手描述的三处差异,已在正文相应位置写明:
- 页面的数据表把两个数值分别列在注释行与候选行,与说明文字里的 983 不是同一个口径。正文按「983 是手工标注淋巴结数、其余两个是交付计数」处理,未把三者混为一个数。
- 90 + 86 = 176 的读法在页面中成立,但页面没有明说两批病例互斥。正文把它写成「最可能的读法,用前建议核对病例号」。
- v4 到 v5 的影像计数从 176 序列变为 352 序列,官方未解释。正文给出的是最可能的解释(内容拆分而非新增),并标明这是推断。
未覆盖的内容:逐例扫描协议、每例淋巴结个数分布、淋巴结病理性质,三项在集合页均无披露,正文只在局限一节指出缺失,没有推测数值。候选点集是否带真伪标签,页面未明示,正文按「不含放射科医生的真伪判定」处理。
页脚只记录核验口径,不承担正文信息量。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- lidc-annot-nlst501 — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割 / 肿瘤学
- uls23 — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割 / 肿瘤学
- lidc-idri — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割
- medpelvis3d — 共享标签:医学影像 / CT / 目标检测 / 医学图像分割
- deeplesion — 共享标签:医学影像 / CT / 目标检测
- pddca — 共享标签:医学影像 / CT / 医学图像分割 / 肿瘤学
- fdtooth — 共享标签:医学影像 / CT / 目标检测
- ct-org — 共享标签:医学影像 / CT / 医学图像分割 / 肿瘤学
- headneck-radiomics — 共享标签:医学影像 / CT / 医学图像分割 / 肿瘤学
- bhx-brain-bounding-box — 共享标签:医学影像 / CT / 目标检测
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
