信息速览
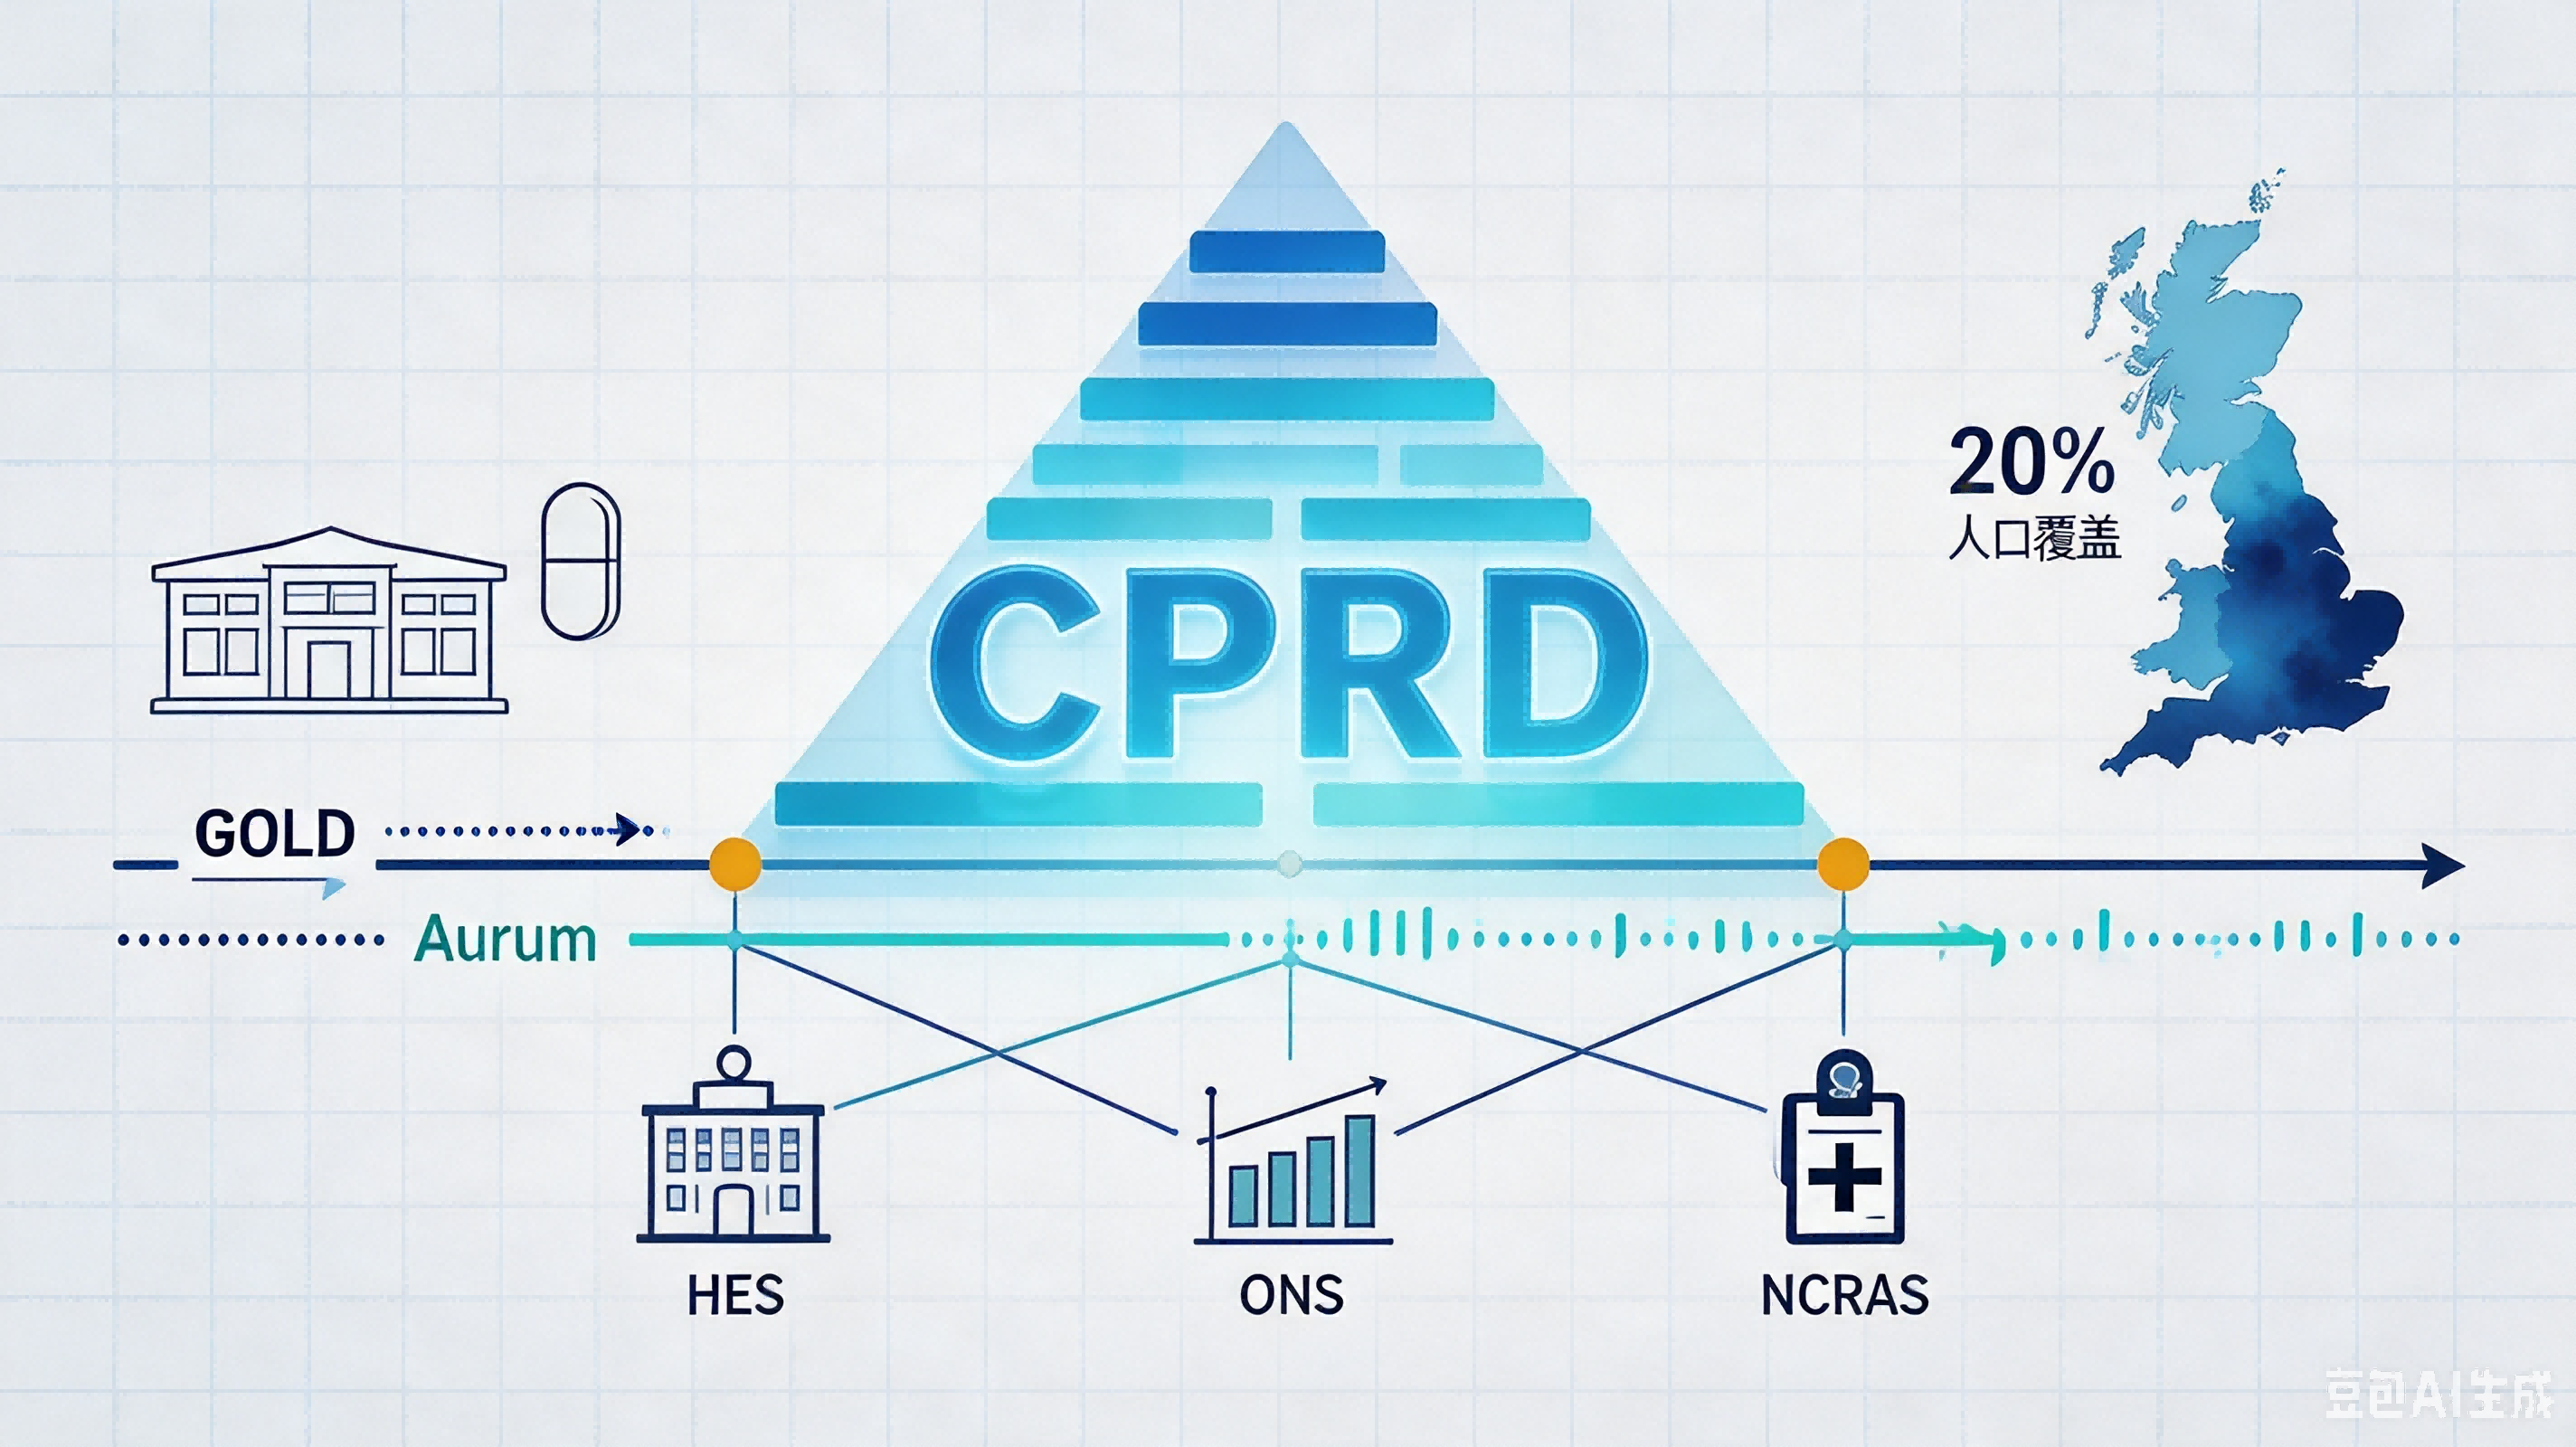
INFOBOX
| 数据集名称 | Clinical Practice Research Datalink (CPRD) |
| 英文全称 | Clinical Practice Research Datalink |
| 别名 / 简称 | CPRD、CPRD GOLD、CPRD Aurum、GPRD(前身) |
| 疾病分类 | 全病种覆盖(初级保健全科诊疗)。核心映射:ICD-11 全范围(诊断编码经 SNOMED CT / Read v2 映射至 ICD-11) |
| SNOMED CT | CPRD Aurum 原生使用 SNOMED CT UK Edition + EMIS Web 本地代码;CPRD GOLD 使用 Read v2 编码(可映射至 SNOMED CT);处方使用 dm+d 编码体系 |
| 数据模态 | 结构化 EHR(人口统计、诊断、症状、处方、实验室检测、疫苗接种、转诊、健康行为)+ 链接数据(住院 HES、死亡 ONS、癌症 NCRAS、心理健康、COVID-19 等) |
| AI 任务类型 | 疾病风险预测、生存分析、药物安全性监测、慢性病轨迹建模、表型识别、治疗效果异质性估计、时间序列预测、多病共存模式发现 |
| 样本总数 | 约 7,100 万名患者(GOLD ~2,100 万 + Aurum ~4,500 万,去重后合计 >7,100 万);当前活跃注册患者约 1,600-1,800 万 |
| 数据大小 | 按研究协议定制提取(非固定大小分发),单次研究数据集通常 GB 级 |
| 数据格式 | Tab-delimited text / CSV(原始分发);可转换为 PostgreSQL / OMOP CDM / SQLite |
| 许可证 | CPRD License Agreement(Single Study 或 Multi-Study License),须经 RDG 协议审批 + 支付许可费 |
| 访问级别 | 申请审核(需机构资质、研究协议审批、伦理批准、许可协议签署 + 费用) |
| DUO 标签 | HMB, GS, MOR, PUB |
| 语言 | 英文(编码体系含 Read v2 / SNOMED CT / dm+d 英文术语) |
| 首发日期 | 1987 年(前身 VAMP 数据集) |
| 最后更新 | 2024-11(数据持续更新,月度/季度刷新) |
| 发布机构 | Medicines and Healthcare products Regulatory Agency (MHRA) & National Institute for Health and Care Research (NIHR),英国政府非营利研究服务机构 |
| 官方主页 | https://www.cprd.com |
| 下载地址 | https://www.cprd.com/data-access(非直接下载,需走 RDG 申请流程) |
| DOI | 10.1093/ije/dyv098(Herrett et al., 2015 — GOLD 数据资源概况);10.1093/ije/dyz034(Wolf et al., 2019 — Aurum 数据资源概况) |
| 引用次数 | 3,238+(Herrett et al., 2015, Google Scholar); 482+(Wolf et al., 2019, Google Scholar); 3,779 篇同行评审研究(1988-2024,机构官方统计) |
| AI 就绪度评分 | ⭐⭐⭐(3/5)— 数据覆盖面与质量极高,但非公开下载式数据集:需机构许可 + 协议审批 + 付费,无官方 ML 基准分割,需自行完成编码映射与表型定义 |
| 页面状态 | published |
§0 E-E-A-T 信任声明与免责声明
医学审核者:[千方病案医学编辑部]交叉审核:§2 医学背景(全病种初级保健覆盖、ICD-11 映射范围、临床任务定义)、§7 偏倚分析。
数据工程审核者:[千方病案医学编辑部交叉审核] 医疗 AI 数据工程师,审核范围:§4 数据结构(GOLD vs Aurum 数据字典差异)、§5 数据划分策略、§6 预处理 Pipeline(Read v2/SNOMED CT 编码映射、OMOP CDM ETL)和坑点。
审核日期:2026-07-28
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用 CPRD 数据前,必须通过 CPRD Research Data Governance (RDG) 流程审批并签署正式许可协议。本页面描述的 DUO 标签仅供参考,具体使用限制以 CPRD 官方许可协议为准。CPRD 数据不可公开下载,不可通过非授权渠道获取。
§1 数据集概览
§1.0 30 秒速览
CPRD 是英国药品与健康产品管理局(MHRA)和国立健康研究所(NIHR)联合运营的全球规模最大的初级保健电子健康记录数据库,自 1987 年起持续采集超过 7,100 万英国患者的全科诊疗数据,覆盖约 20% 英国人口。
它的独特价值在于规模 × 纵向深度 × 多源链接的三重优势:长达近 40 年的个体随访、与 17 种二级保健数据(住院、死亡、癌症、心理卫生等)的患者级链接、以及广泛的英国人口代表性——这一组合使 CPRD 成为全球药物安全性监管、真实世界证据和流行病学研究的金标准基础设施,累计产出 3,800+ 篇同行评审研究。
你可以用它来:评估新药上市后的长期安全性、构建基于初级保健数据的慢性病风险预测模型、研究多病共存的疾病轨迹模式——但你必须先通过 CPRD 的 RDG 审批流程并支付数据许可费。它不是一个"下载即用"的数据集,而是一个需要机构资质、研究协议和经费预算的研究平台。
§1.1 摘要
CPRD 是英国政府运作的非营利研究服务,从英国全科医生(GP)诊所网络中持续采集匿名化电子健康记录数据,每月更新。GP 是英国 NHS 医疗体系的守门人——98% 的英国人口注册在 GP,非紧急医疗问题均首先经 GP 接诊。因此 CPRD 天然捕获了从症状出现、诊断、处方到转诊的全链条初级保健信息。
CPRD 分为两个子数据库——CPRD GOLD(使用 Vision 软件系统的 GP 诊所,1987 年起,~2,100 万患者)和 CPRD Aurum(使用 EMIS Web 软件系统,2017 年上线,~4,500 万患者)——两者共享相同的 RDG 治理框架但使用不同的临床编码体系。超过 75% 的诊所同意参与数据链接方案,使研究级患者数据能够与住院(HES APC)、死亡登记(ONS)、癌症注册(NCRAS)等 17 种外部数据集实现患者级链接。
CPRD 数据已用于支持英国国家疫苗接种安全性监测、药品风险管理决策和 NICE 临床指南制定。近年 CPRD 正迅速进入 ML/DL 领域——MT-BERT(CVD 风险预测,2025)、SurvivEHR(多病共存竞争风险基础模型,2025)、GatorTron(T2DM 并发症文本驱动预测,2024)等工作证明了其在 AI 时代的持续价值。
§1.2 为什么重要
维度一:监管级数据质量与全球影响力。 CPRD 由英国政府药品监管机构 MHRA 直接运营,其数据质量不仅影响学术研究,更直接影响药品上市后安全决策和公共卫生政策。CPRD 内部执行 900+ 项每日数据质量检查,临床编码质量受英国 Quality and Outcomes Framework(QOF)经济激励驱动。研究产出以年均 16.37% 的速度增长,来自 29 个国家的研究者使用 CPRD 数据,在 600+ 种期刊发表成果。这种"监管-学术-政策"三位一体的数据生态在全球独一无二。
维度二:从流行病学工具到 AI 基础模型训练场的转型。 传统上 CPRD 主要用于回归分析和药物流行病学,但近年来 ML/DL 工作急剧增加——SurvivEHR 从 2,650 万患者中训练多病共存竞争风险基础模型,MT-BERT 使用 469,496 名患者的 Aurum 数据构建 CVD 风险预测模型。CPRD 的纵向深度(中位随访 5.61-9.47 年)和链接能力使其成为训练"真实世界基础模型"的理想试验场。
维度三:无可替代的初级保健视角。 全球大多数医学 AI 数据集来自住院场景(ICU、影像、专科门诊),但绝大多数医疗决策发生在初级保健。CPRD 提供了从首发症状到确诊、治疗、随访的完整初级保健叙事——这是理解疾病自然史和医疗资源使用模式不可替代的视角。
§1.3 同类数据集横向对比
| 数据集 | 患者数 | 数据来源 | 时间跨度 | 链接能力 | 访问方式 | 核心差异化 |
|---|---|---|---|---|---|---|
| CPRD | ~7,100 万 | 英国 GP 诊所(~2,000 家) | 1987-至今 | 17 种二级数据链接 | 申请审核 + 付费 | 规模 × 纵向深度 × 监管级质量 |
| THIN | ~1,600 万 | 英国 GP 诊所(~700 家) | 1994-至今 | HES + ONS | 申请审核 + 付费 | 与 CPRD 类似但规模较小(已并入 CPRD Aurum) |
| QResearch | ~3,500 万 | 英国 EMIS GP 诊所 | 1998-至今 | HES + ONS + 癌症 | 申请审核 | EMIS 系统专有,COVID-19 风险计算器来源 |
| OpenSAFELY | ~5,800 万 | 英国 GP 诊所 | 2020-至今 | HES + ONS + 其他 | 受信研究环境(TRE) | 联邦分析、不可下载、COVID-19 研究标杆 |
| Optum CDM | ~1 亿 | 美国商业保险 + EHR | 2000-至今 | 有限 | 商业许可 | 美国视角、保险赔付数据 |
| MIMIC-IV | 364,627 | 单中心 ICU | 2008-2022 | 有限 | 免费注册 | 深度住院数据但无初级保健覆盖 |
§1.4 版本时间轴
| 时间 | 事件 |
|---|---|
| 1987 | VAMP(Value Added Medical Products)数据集在伦敦建立,面向英国 Vision 软件系统的 GP 诊所 |
| 1993 | VAMP 更名为 GPRD(General Practice Research Database),扩展至 674 家诊所、1,130 万患者 |
| 2012 | GPRD 升级为 CPRD(Clinical Practice Research Datalink),由 MHRA 直接运营 |
| 2015-06 | Herrett et al. 发表 CPRD GOLD 数据资源概况(Int J Epidemiol,3,238+ 引用) |
| 2017-10 | CPRD Aurum 正式上线,整合 EMIS Web 软件系统的 GP 诊所数据 |
| 2019-03 | Wolf et al. 发表 CPRD Aurum 数据资源概况(Int J Epidemiol,482+ 引用) |
| 2023-07 | CPRD Aurum 患者数突破 4,500 万,成为全球最大的初级保健 EHR 数据库之一 |
| 2024-11 | NHS England 引入 MPS(Master Person Service)链接方法,CPRD GOLD 7.9M / Aurum 34.2M 患者完成新标准链接,HES 链接成功率从 72-75% 提升至 79-81% |
| 2025 | SurvivEHR(2650 万患者基础模型)和 MT-BERT(46.9 万患者 CVD 预测)标志着 CPRD 进入 AI 基础模型时代 |
§1.5 典型 AI 应用场景
- 药物安全性监测与信号检测:利用 CPRD 纵向处方记录 + 链接 HES 住院数据,使用自对照病例系列(SCCS)设计或高通量药物筛查算法(如基于基础模型的自动化药物-疾病配对筛选),发现药物不良反应信号
- 慢性病长期风险预测:基于 GP 全生命周期数据(症状、处方、检测值、生活方式)构建 CVD / 糖尿病 / CKD / 痴呆等慢性病的 5-10 年风险预测模型——这是 MT-BERT 和 SurvivEHR 的核心应用方向
- 多病共存(Multimorbidity)疾病轨迹建模:利用 CPRD 全病种覆盖优势,使用序列模式挖掘或 transformer-based 模型分析 74+ 种长期疾病的共现和演变轨迹
- 治疗效果异质性评估:利用 CPRD 的大规模真实世界数据估计不同亚群(年龄、性别、种族、剥夺指数)对同一治疗方案的反应差异
- 流行病学风险因子发现:利用长达 40 年的随访数据,挖掘罕见暴露-结局关联或长期潜伏效应——这在样本量和随访时间上都远超任何单一研究队列
§2 医学背景
§2.1 疾病分类与编码体系
CPRD 是全病种覆盖的初级保健数据集,不限定于某类疾病——其诊断编码体系为 ICD-11 全家谱提供了从初级保健视角的映射基础。
| 编码体系 | 使用数据库 | 说明 |
|---|---|---|
| Read Codes Version 2 | CPRD GOLD | 英国全科医生传统临床术语,分层树状结构(5 字节字母数字编码),覆盖诊断、症状、检查、预防接种等 |
| SNOMED CT UK Edition | CPRD Aurum | 国际标准临床术语,比 Read v2 更细粒度,支持后协调(post-coordination),是全球互操作性推荐标准 |
| EMIS Web Local Codes | CPRD Aurum | EMIS Web 软件系统的本地编码,部分无法映射至标准术语 |
| dm+d (Dictionary of Medicines and Devices) | GOLD + Aurum | 英国 NHS 标准药品与器械编码(SNOMED CT 子集),用于处方数据 |
| ICD-10 | 链接 HES 数据 | 住院诊断使用 ICD-10 编码 |
| OPCS-4 | 链接 HES 数据 | 手术与操作分类编码 |
从 AI 工程角度,编码体系差异是 CPRD 使用的第一道门槛。GOLD 的 Read v2 编码与 Aurum 的 SNOMED CT 编码需要不同的映射策略,详见 §6.5 坑点 1。
§2.2 疾病覆盖描述
CPRD 覆盖初级保健中所有常见和大多数罕见疾病。英国 GP 作为医疗守门人,承担了从急性感染(UTI、上呼吸道感染)到慢性病管理(糖尿病、高血压、CKD、COPD、哮喘)、从预防保健(疫苗接种、癌症筛查)到心理健康(抑郁、焦虑、精神分裂症)的全谱系初级保健服务。因此 CPRD 天然记录了:
- 慢性非传染性疾病:心血管疾病、2 型糖尿病、慢性肾病、慢性阻塞性肺病、哮喘、骨关节炎、骨质疏松等
- 传染病:流感、COVID-19、尿路感染、皮肤感染、疫苗接种覆盖率
- 癌症:乳腺癌、结直肠癌、前列腺癌、肺癌等——初级保健记录经链接 NCRAS 癌症注册数据验证
- 心理健康:抑郁、焦虑障碍、精神分裂症、双相障碍——处方和转诊记录是主要数据来源
- 罕见病:部分罕见病可通过药物处方或专科转诊模式识别
- 多病共存:CPRD 是研究多种长期疾病同时发生模式的全球最佳数据源之一
§2.3 临床任务定义
在 CPRD 的 AI 语境下,核心临床任务不是传统的"影像诊断"或"文本分类",而是基于纵向 EHR 序列的预测、分类和轨迹建模:
| 任务类型 | 临床定义 | 典型 ML 映射 |
|---|---|---|
| 疾病风险预测 | 在 t 时刻基于既往 EHR 信息预测未来 T 年内发生目标疾病的概率 | 二分类 / 生存分析(Cox / DeepSurv / 竞争风险) |
| 治疗反应评估 | 评估某处方在真实世界中的效果(有效性 + 安全性) | 因果推断(PSM / IPTW / T-Learner)/ SCCS |
| 药物安全性监测 | 检测药物-不良事件配对信号 | 关联分析 / 序列对称分析 / 高通量药物筛查 |
| 疾病轨迹建模 | 从 EHR 序列中学习疾病演变的多阶段模式 | 序列模型(LSTM / Transformer)/ 隐 Markov 模型 / 聚类 |
| 表型识别 | 从编码和检测值组合中定义临床病例(如糖尿病、CKD 分期) | 规则引擎 + 机器学习验证 / NLP(如有文本) |
§2.4 患者人群特征
| 维度 | CPRD GOLD | CPRD Aurum |
|---|---|---|
| 数据来源 | 使用 Vision 软件的英国 GP 诊所(984 家,370 家当前贡献) | 使用 EMIS Web 软件的英国 GP 诊所(1,721 家,1,164 家当前贡献) |
| 地域覆盖 | 英国全境(England, Scotland, Wales, Northern Ireland) | 以英格兰为主 |
| 采集时间 | 1987 年至今 | 数据最早可追溯至 1995 年(Aurum 上线时间为 2017 年) |
| 年龄分布 | 全面覆盖,含儿童(<18 岁 ~18%)、成人(18-65 岁 ~60%)、老年(≥65 岁 ~22%);中位年龄随数据截断日期浮动 | 类似,儿童约 18%、成人约 62%、老年约 20% |
| 性别比例 | 接近 50:50,与英国全人口一致 | |
| 种族分布 | 种族数据仅适用于英格兰链接患者;总体上白人约 80%+(代表 UK 人口结构),亚裔和非裔比例随区域变化 | |
| 剥夺指数 | 通过链接的 IMD(Index of Multiple Deprivation)提供,覆盖全英五等分,代表性与英国总体一致 | |
| 就医类型 | 初级保健(全科门诊)——包含面对面就诊、电话咨询、家访、行政事件(如重复处方) |
§2.5 为什么这个临床问题值得用 AI 解决
初级保健是医疗体系的"前门"——每年英国 GP 接诊超过 3.7 亿次。在这个场景中,AI 面临三个核心挑战:
- 早期预警:在非特异性症状(疲劳、体重下降、“感觉不舒服”)阶段识别严重疾病的信号,将诊断窗口前移
- 个体化风险评估:传统的 QRISK 等 CVD 风险评分依赖少量结构化变量,而 EHR 序列中包含更丰富但非结构化的预测信息
- 多病共存管理:英国 65 岁以上人口中超过 50% 患有两种以上长期疾病,单一疾病模型无法满足临床需求
CPRD 的规模和纵向深度使 AI 可以从真实世界的"诊断前"数据模式中学习,而非仅依赖预定义的疾病定义——这代表了一个从"疾病风险评分"到"全谱系健康轨迹预测"的范式转变。
§2.6 金标准 / 参考标准
| 数据划分 | 参考标准方式 | 标准性质 |
|---|---|---|
| 诊断验证 | 链接 NCRAS 癌症注册数据(金标准)或 HES APC 住院诊断(次金标准)交叉验证 GP 记录的诊断。Aurum 诊断准确性 87%、完整性 77%(vs Cancer Registry) | 金标准(癌症)/ 强参考(HES) |
| 死亡结局 | ONS 死亡登记数据(法定死亡证明),含死因和日期 | 金标准 |
| 处方记录 | GP 电子处方系统直接生成,受英国处方定价监管约束,准确率极高 | 强参考 |
| 实验室检测 | 外部实验室直接电子回传至 GP 系统,数值可信度高 | 强参考 |
| 生活方式变量 | GP 问诊时记录(吸烟、饮酒、BMI),依赖患者自报和 GP 录入,存在报告偏倚和缺失 | 弱参考 |
§3 数据集规格
§3.0 版本抉择矩阵
| 你的需求 | 推荐数据库 | 患者规模 | 理由 |
|---|---|---|---|
| 最大样本量 / 最近年份研究 | CPRD Aurum | ~4,500 万 | 规模约为 GOLD 的 2 倍,SNOMED CT 原生编码与国际标准兼容更好,中位随访 9.47 年更长 |
| 最长历史跨度 / 经典编码体系 / 与旧文献对齐 | CPRD GOLD | ~2,100 万 | 1987 年至今近 40 年,Read v2 编码在经典药物流行病学文献中被广泛使用 |
| 跨数据库验证 / 内部复制研究 | GOLD + Aurum 双数据库 | ~7,100 万 | 使用不同 GP 软件系统的两组独立人群,提供天然的内部验证队列 |
| OMOP CDM 标准化分析 | GOLD or Aurum + OMOP ETL | 取决于选择 | OHDSI 社区提供完整的 CPRD GOLD→OMOP ETL;Aurum→OMOP 转换已由 NIH/NLM 团队(2023)和牛津团队验证 |
| 最低成本 / 学术研究入门 | 申请所在机构的 Multi-Study License | 取决于机构协议 | 英国多所大学(Oxford, QMUL, LSHTM 等)持有机构级 MSL,机构内研究者可共享访问 |
§3.1 模态详细说明
- 结构化 EHR(核心):人口统计、诊断编码、症状记录、处方(含剂量、用量、疗程)、实验室检测值与参考范围、疫苗接种记录、转诊信息、健康行为(吸烟、饮酒、BMI)
- 链接二级保健数据(增强层):HES APC 住院记录(ICD-10 诊断 + OPCS-4 手术编码)、ONS 死亡登记(死因链)、NCRAS 癌症注册(诊断日期、分期、组织学)、心理健康服务数据集(MHMDS)、COVID-19 检测与疫苗接种数据、区域剥夺指数(IMD)
- 不可用数据:自由文本(GP 临床笔记中的自由文本因再识别风险不予分发)、医学影像、基因组数据
§3.2 样本规模
| 数据库 | 总患者 | 当前活跃 | 研究可接受 | 可链接 | GP 诊所数 |
|---|---|---|---|---|---|
| CPRD GOLD (2024.11) | ~2,450 万 | ~273 万 | ~2,130 万 | ~928 万 | 984(当前贡献 370) |
| CPRD Aurum (2024.07) | ~4,530 万 | ~1,078 万 | ~4,528 万 | ~3,627 万 | 1,721(当前贡献 1,164) |
| 合计 | ~7,100 万 | ~1,350 万 | ~6,660 万 | ~4,550 万 | ~2,700 |
注:"当前活跃"指当前仍在 GP 注册、存活的患者。"研究可接受"指满足 CPRD 内部数据质量标准(acceptable patient flag)的患者。"可链接"指注册在同意参与数据链接方案的英格兰诊所的患者。
§3.3 数据格式详解
| 数据类型 | 格式 | 编码 | 说明 |
|---|---|---|---|
| 患者人口统计 | Tab-delimited text | 无编码(数值/分类) | 出生年、性别、注册日期、转出日期 |
| 临床事件 (GOLD) | Tab-delimited text | Read v2 + 药物 Prodcodes | 包含诊断、症状、检查、免疫等所有 GP 事件 |
| 临床事件 (Aurum) | Tab-delimited text | SNOMED CT + EMIS Local + dm+d | 同 GOLD 但编码体系不同 |
| 处方 (GOLD) | Tab-delimited text | Prodcodes + BNF 章节 | 含处方日期、药品编码、用量、疗程 |
| 处方 (Aurum) | Tab-delimited text | dm+d codes | 含处方日期、药品编码、用量、疗程 |
| 链接 HES APC | Tab-delimited text | ICD-10 + OPCS-4 | 住院日期、入院方式、出院去向 |
| 链接 ONS 死亡 | Tab-delimited text | ICD-10 死因链 | 死亡日期 + 主要死因 + 次要死因 |
| 链接 NCRAS 癌症 | Tab-delimited text | ICD-10 + ICD-O-3 | 诊断日期、部位、形态学、分期 |
| OMOP CDM 转换 | PostgreSQL / CSV | OMOP Standardized Vocabularies | 经 Oxford ETL 或 OHDSI ETL 转换后 |
§3.4 存储大小
| 版本/范围 | 大约大小 |
|---|---|
| 单次研究提取(典型学术研究,含链接数据) | 1-50 GB(CSV/TXT) |
| CPRD GOLD 全量 + 主要链接数据 | ~200-500 GB |
| CPRD Aurum 全量 + 主要链接数据 | ~500 GB - 1 TB |
| 转换至 OMOP CDM 后的 PostgreSQL 数据库 | ~300-800 GB(含索引) |
§3.5 标注 / 数据采集方式
CPRD 的"标签"来自 GP 在日常诊疗中的实时电子录入——这既是其优势(反映真实临床实践、无研究偏倚),也是挑战(非标准化、受录入习惯和 QOF 激励影响)。
数据采集链路:
患者就诊 → GP 电子录入 (Vision/EMIS Web) → GP 诊所月度上传 → CPRD 质量控制 (900+ 检查) → 研究数据交付
§3.6 数据记录者资质
| 维度 | 说明 |
|---|---|
| 记录者 | 英国全科医生(GP)、执业护士、药房人员、医疗助理——均为 NHS 注册持证医疗专业人员 |
| 记录方式 | 诊疗过程中实时电子录入(非回顾性标注),受 NHS 临床治理和 QOF 经济激励约束 |
| 编码质量 | 受 QOF 质量框架驱动(2004 年起),关键慢性病(糖尿病、CVD、COPD 等)编码完整性显著优于非 QOF 覆盖领域 |
| 潜在问题 | 不同 GP 的编码习惯差异(同一病情可能用不同 Read/SNOMED 编码);症状编码 vs 诊断编码的区分不一致;用药指征可能不明确 |
§3.7 数据采集时间范围
- CPRD GOLD:1987 年至今,月度持续更新
- CPRD Aurum:多数诊所数据起始于 1995 年(EMIS Web 系统部署)但 Aurum 数据库于 2017 年才整合上线
- 数据延迟:通常 2-6 个月(GP 月度上传 → QC → 研究数据构建 → 交付)
§3.8 地域覆盖
- 英国四国:英格兰(主体)、苏格兰、威尔士、北爱尔兰(GOLD 覆盖全英;Aurum 以英格兰为主)
- 覆盖比例:约 20% 英国人口(当前活跃患者),与英国全人口在年龄、性别、剥夺指数上具有良好代表性
- 地理代表性:覆盖城市、郊区、农村各类 GP 诊所,IMD 五等分分布均衡
§3.9 采集设备规格
CPRD 不涉及影像或信号采集设备。实验室检测结果来自各 NHS 实验室的标准检测设备,由实验室电子系统直接回传至 GP 系统,不包含设备型号和校准信息。
§3.10 深度溯源链
英国 NHS 体系 (1948-)
    │
    ├── GP 诊所日常诊疗 (1987-)
    │       → Vision/EMIS Web 电子录入
    │       → 月度匿名化去标识上传
    │       → CPRD 质量检查 (900+ 项)
    │       → CPRD GOLD / Aurum 原始数据库
    │
    ├── 二级保健 (HES / MHMDS / etc.)
    │       → NHS England 数据管理
    │       → MPS (Master Person Service) 患者匹配
    │       → 链接至 CPRD 患者 (经由信任第三方)
    │
    ├── 死亡登记 (ONS)
    │       → ONS 民事登记系统
    │       → 链接至 CPRD 患者
    │
    ├── 癌症注册 (NCRAS)
    │       → NHS England 癌症注册
    │       → 链接至 CPRD 患者
    │
    └── 研究数据提取
            → eRAP 协议审批 (RDG)
            → 数据规格协商
            → CPRD 定制提取 + 安全文件传输 (SFT)
            → 研究者本地/机构安全环境
§4 数据结构详解
§4.0 目录结构预览
CPRD 数据不按固定文件结构分发,而是按研究协议定制提取。典型的研究数据集目录结构如下:
cprd_project/
├── gold/                          # CPRD GOLD 数据(如申请)
│   ├── patient.txt                # 患者人口统计(patid, gender, yob, ...)
│   ├── practice.txt               # 诊所信息(pracid, region, ...)
│   ├── clinical.txt               # 临床事件(patid, eventdate, medcode, ...)
│   ├── therapy.txt                # 处方事件(patid, eventdate, prodcode, qty, numdays, ...)
│   ├── referral.txt               # 转诊记录(patid, eventdate, ...)
│   ├── immunisation.txt           # 免疫接种(patid, eventdate, medcode, ...)
│   ├── test.txt                   # 检测结果(patid, eventdate, enttype, data1, data2, ...)
│   ├── consultation.txt           # 就诊记录(patid, eventdate, constype, ...)
│   ├── hes_apc.txt                # 链接 HES 住院数据(如申请)
│   ├── ons_death.txt              # 链接 ONS 死亡数据(如申请)
│   └── linkage_eligibility.txt    # 链接资格标记
├── aurum/                         # CPRD Aurum 数据(如申请)
│   ├── patient.txt
│   ├── practice.txt
│   ├── observation.txt            # 所有临床事件(合并表,含 obsid, patid, medcodeid, ...)
│   ├── drug_issue.txt             # 处方事件
│   ├── consultation.txt
│   ├── referral.txt
│   ├── immunisation.txt
│   └── linked/                    # 链接数据子目录
├── linkage_data/                  # 链接数据(公共)
│   ├── imd.txt                    # 剥夺指数
│   ├── rural_urban.txt            # 城乡分类
│   └── ...
├── code_lists/                    # 研究者构建的疾病/药物编码清单
│   ├── cvd_readcodes.txt
│   ├── diabetes_snomed.txt
│   └── ...
└── protocol/                      # 研究协议和批准文件
§4.1 DAIMS 标准化字段描述表
CPRD GOLD Clinical 表(核心事件表):
| 字段名 | 数据类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
patid |
Integer | 患者唯一标识(匿名化) | 1234567 | 主键 / 序列分组 | 无(系统生成) | — | 正整数 |
eventdate |
Date | 事件日期(精确到日) | 2015-03-14 | 时序排序 / 生存分析时间原 | 日期记录偏差(延迟录入) | — | 同日出生 ~ 末次采集 |
medcode |
String | Read v2 临床编码 | “G33…00” | 诊断/症状/检查分类 | 编码选择差异(同病异码) | — | CPRD 医学字典定义 |
enttype |
Integer | 实体类型(区分诊断/检测/免疫等) | 13 | 事件分类 | 部分 enttype 与 medcode 不一致 | — | 1-200+ |
adid |
Integer | 附加细节 ID(链接至附加信息表) | 456 | 额外临床信息(如检测值) | — | 0 = 无额外信息 | 整数 |
sysdate |
Date | 系统记录日期 | 2015-03-14 | 数据录入时间分析 | 与事件发生日期的差异 | — | 日期范围 |
CPRD Aurum Observation 表(核心事件表):
| 字段名 | 数据类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
patid |
Integer | 患者唯一标识 | 9876543 | 主键 / 序列分组 | 无 | — | 正整数 |
obsid |
Integer | 观察记录唯一 ID | 555001 | 去重 / 关联 | 无 | — | 正整数 |
medcodeid |
String | SNOMED CT / EMIS Local 临床编码 | “73211009” | 诊断/症状分类 | 编码选择差异 + EMIS Local 无法映射 | — | SNOMED CT 或 EMIS 本地编码 |
obsdate |
Date | 观察日期 | 2019-06-30 | 时序排序 | 同 GOLD eventdate 偏差 | — | 日期范围 |
enterdate |
Date | 录入日期 | 2019-07-01 | 数据流延迟分析 | — | — | 日期范围 |
value |
Float | 数值结果(检测值) | 5.6 | 回归/预测特征 | 检测设备间校准差异 | -999(有时) | 取决于检测类型 |
numunitid |
Integer | 数值单位 ID | 154 | 单位标准化 | — | — | CPRD 单位字典 |
staffid |
Integer | 录入人员角色 ID | 2 | 记录者类型分析 | — | — | CPRD 人员字典 |
§4.2 标签/事件分布
CPRD 不提供预定义标签——研究者需自行构建编码清单(codelist)来定义病例和暴露。这是 CPRD 与典型 ML 数据集的最大差异之一。
以下为典型研究中的常见编码布频率参考:
| 疾病领域 | CPRD 中常见程度 | 编码复杂度 | 金标准验证源 |
|---|---|---|---|
| 2 型糖尿病 | 非常常见(约 6-7% 患病率) | 低(有成熟编码清单) | HES / 处方 (Metformin/Insulin) |
| 高血压 | 非常常见(约 15-20% 患病率) | 低 | 血压读数 >140/90 |
| CVD (MI/Stroke) | 常见(约 3-4% 患病率) | 低-中(需区分急慢性) | HES / ONS 死因 |
| 抑郁症 | 常见(约 5-10% 患病率) | 中-高(诊断 vs 症状编码混淆) | 抗抑郁药处方 |
| 癌症 | 较低(需链接 NCRAS 验证) | 中(GP 记录完整性约 65-77%) | NCRAS(金标准) |
| 罕见病 | 罕见(个案级别) | 高(编码稀疏且不一致) | 专科转诊记录 |
| COVID-19 | 近年常见(2020-) | 中(编码随疫情演变) | 链接 COVID-19 检测数据 |
§4.3 关键字段统计摘要
- 每患者事件数:中位数 100-300 条临床记录(因年龄、健康状况和注册时长变化极大)
- 中位随访时间:GOLD 5.61 年(当前患者),Aurum 9.47 年(当前患者)
- 处方记录覆盖率:活跃患者中 >90% 至少有一条处方记录
- 实验室检测覆盖率:慢性病患者中 >80% 有相关检测记录(QOF 驱动)
- 链接数据覆盖率:英格兰患者中约 79-81% 可成功链接至 HES APC(MPS 方法,2024.12)
§4.4 数据层级关系
Practice (诊所)
  └── Patient (患者, patid)
        ├── Registration (注册时段)
        │     ├── Consultation (就诊)
        │     │     ├── Clinical Event / Observation (诊断/症状/检查)
        │     │     ├── Therapy / Drug Issue (处方)
        │     │     ├── Referral (转诊)
        │     │     └── Immunisation (免疫)
        │     └── Test / Measurement (检测值)
        ├── HES APC (链接住院记录)
        │     ├── Admission (入院)
        │     │     └── Episode (住院段)
        │     │           └── Diagnosis (ICD-10)
        │     └── Procedure (OPCS-4 手术)
        ├── ONS Death (链接死亡)
        └── NCRAS Cancer (链接癌症)
§4.5 缺失数据
| 缺失类型 | 描述 | 影响 | 缓解措施 |
|---|---|---|---|
| 注册时间外缺失 | 患者仅在注册 GP 期间有数据,注册前和转出后信息完全缺失 | 左截断 + 右删失 | 在生存分析中使用 delayed entry;排除注册不满 12 个月患者 |
| 临时中断 | 患者可能临时搬家或更换 GP,造成 1-3 年的数据间隙 | 模拟为缺失而非真正的无事件 | 使用 GP 注册转移记录识别间隙 |
| 非系统录入 | GP 未在每次就诊中记录吸烟/BMI/饮酒等生活方式变量 | 缺失非随机——健康患者更少测量 | 使用最后一次观测结转(LOCF);多重插补;编码缺失指示符 |
| 编码选择差异 | 同一疾病可能被不同 GP 编码为症状码或诊断码 | 病例定义不统一 | 使用经验证的公开编码清单(如 CALIBER / OpenCodelists) |
| 链接数据限制 | 仅英格兰诊所且同意链接方案的患者可获得链接数据(约 58-75%) | 链接数据的选择偏倚 | 比较链接与非链接人群特征,纳入分析偏差项 |
| 自由文本不可用 | CPRD 不提供 GP 自由文本以免重新识别风险 | 失去临床叙事细节 | 依赖结构化编码;文本驱动 NLP 方法不适用于 CPRD |
§5 数据划分与使用建议
§5.1 标准划分
**CPRD 不提供官方的 train/val/test 划分。**这与典型的 ML 数据集(如 MIMIC-IV、CheXpert)根本不同。CPRD 是真实世界 EHR 数据源,其"划分"需要在研究设计层面自行定义:
| 划分策略 | 适用场景 | 方法 |
|---|---|---|
| 时间划分(推荐) | 预测模型开发 | 按日历时间切分——如 1987-2018 为训练、2019-2020 为验证、2021-2023 为测试。反映真实世界的时间漂移 |
| 地理划分 | 泛化性评估 | 以地理区域(如 NHS 区域 / IMD 分组)分层划分 |
| 诊所级划分 | 避免诊所水平数据泄漏 | 按 GP 诊所随机分组——同一诊所所有患者进入同一划分 |
| 患者级随机划分(谨慎) | 经典 ML 实验 | 患者随机分组。⚠️ GP 诊所内患者间存在关联性(共享 GP 编码风格),可能导致信息泄漏 |
| GOLD 训练 → Aurum 测试 | 最强泛化性检验 | 一个数据库作为训练/验证,另一个作为独立外部测试集——这是 CPRD 独有的优势 |
§5.2 划分策略推荐
千方推荐:时间划分 + 诊所级分组的组合。时间划分确保模型在"未来"数据上评估,诊所级分组防止GP编码风格的信息泄漏。这种组合为预测模型提供了最接近真实部署条件的评估方案。
§5.3 数据泄漏风险
| 泄漏风险 | 风险等级 | 说明 | 防泄漏措施 |
|---|---|---|---|
| 患者级时间泄漏 | 高 | 同一患者的不同事件分散在训练/测试集 | 患者级划分(同一患者所有事件在同一集) |
| 诊所级编码风格泄漏 | 中 | GP 编码偏好(同义异码)使模型学到"诊所指纹" | 诊所级分组划分 |
| 时间前向泄漏 | 高 | 使用未来信息预测过去——在纵向声明中尤其容易发生 | 时间锚定:在预测时间 t,仅使用 t 之前的数据 |
| 链接数据预知泄漏 | 中 | HES/ONS 数据在现实中延迟 2-6 个月可用——训练中不当使用导致"预知" | 在时间划分中为链接数据添加真实延迟 |
| 个体标识符泄漏 | 低 | 患者 patid 作为特征泄漏隐私信息 | 去除患者/诊所 ID 或使用随机化 |
§5.4 交叉验证建议
对于 CPRD 数据,推荐使用以下交叉验证策略(按优先级排序):
- Group Time Series Split:按时间和诊所双重分组的滚动交叉验证——每次增加时间窗口,保持时间顺序
- Nested CV with Temporal Blocking:外循环按时间分,内循环按诊所分——同时评估时间泛化性和地理泛化性
§5.5 外部验证建议
CPRD 独有的外部验证优势——可以使用 GOLD 和 Aurum 作为彼此的外部验证集:
- 跨数据库验证:在 GOLD 上训练、在 Aurum 上测试(或反之),评估模型在不同 GP 软件系统和编码体系间的泛化性
- 跨时间验证:在较早数据上训练、在最近数据上测试,评估时间漂移影响
- 与其他数据源对比:与 THIN、QResearch、OpenSAFELY 或 HES-ONS 链接数据进行交叉验证
§6 AI 就绪指南
§6.1 快速上手
⚠️ 前置说明:CPRD 不是公开下载数据集。以下代码假设你已通过 RDG 审批并获得数据交付。所有代码使用模拟数据演示——在与真实 CPRD 数据替换后可直接运行。
# ========================================
# CPRD 快速上手 — PyTorch 预测模型示例
# 环境要求: python>=3.10, torch>=2.0, pandas, numpy
#
# ⚠️ 数据假设:
#   假设已获得 GOLD 或 Aurum 数据交付,并已完成以下预处理:
#   1. 将 tab-delimited 文件加载至 pandas DataFrame
#   2. 完成 Read v2 / SNOMED CT 编码到研究疾病定义的映射
#   3. 构建患者级别的纵向特征矩阵
#   本示例展示了从 EHR 序列构建预测特征的标准流程。
# ========================================

import pandas as pd
import numpy as np
from datetime import datetime, timedelta

# ── 1. 加载数据 ───────────────────────────────
# 假设数据文件在 ./cprd_data/ 下
patient = pd.read_csv(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''./cprd_data/patient.txt'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', sep=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''\\t'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')
clinical = pd.read_csv(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''./cprd_data/clinical.txt'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', sep=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''\\t'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')  # GOLD
therapy   = pd.read_csv(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''./cprd_data/therapy.txt'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', sep=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''\\t'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')

# ── 2. 定义索引日期(index date)────────────
# 示例:以 2020-01-01 为预测基线
index_date = pd.Timestamp(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''2020-01-01'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')

# ── 3. 定义研究人群:注册满 12 个月且索引日活跃 ──
patient[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''frd''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] = pd.to_datetime(patient[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''frd''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''])  # 首次注册日期
eligible = patient[
    (patient[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''frd''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] < index_date - timedelta(days=365)) &
    ((patient[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''tod''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].isna()) | (pd.to_datetime(patient[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''tod'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']) > index_date))
]
print(f"符合条件患者数: {len(eligible):,}")

# ── 4. 基于历史事件构建特征(索引日之前) ──
def build_features(pat_ids, clinical_df, therapy_df, index_dt):
    """从 CPRD 原始事件表构建患者级特征矩阵"""

    # 限制到索引日之前的事件
    clin_hist = clinical_df[
        (clinical_df[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].isin(pat_ids)) &
        (pd.to_datetime(clinical_df[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eventdate'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']) < index_dt)
    ].copy()

    # 示例特征工程
    features = pd.DataFrame({''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': pat_ids})

    # 4a. 疾病计数 — 使用预定义的 Read v2 / SNOMED 编码清单
    # 此处以 Read v2 CVD 编码为例
    cvd_codes = [''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G3...00'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G30..00'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G31..00'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G32..00'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G33..00'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']
    cvd_events = clin_hist[clin_hist[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''medcode''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].isin(cvd_codes)]
    cvd_counts = cvd_events.groupby(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''').size()
    features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''n_cvd_events''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] = features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].map(cvd_counts).fillna(0)

    # 4b. 处方特征
    rx_hist = therapy_df[
        (therapy_df[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].isin(pat_ids)) &
        (pd.to_datetime(therapy_df[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eventdate'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']) < index_dt)
    ]
    n_rx = rx_hist.groupby(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''').size()
    features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''n_prescriptions''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] = features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].map(n_rx).fillna(0)

    # 4c. 就诊频率
    n_conevent-blocked= clin_hist.groupby(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eventdate''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].nunique()
    features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''n_consultations''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] = features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].map(n_consults).fillna(0)

    # 4d. 时间特征
    # 首次事件距索引日的天数
    first_event = clin_hist.groupby(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eventdate''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].min()
    features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''days_since_first_event''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''] = (
        (index_dt - pd.to_datetime(first_event)).dt.days
    ).reindex(features[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']).fillna(0).values

    return features.set_index(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')

X = build_features(eligible[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''patid''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].values, clinical, therapy, index_date)
print(f"特征矩阵形状: {X.shape}")
print(f"特征列表: {list(X.columns)}")
§6.2 数据获取
| 步骤 | 说明 | 预估时间 |
|---|---|---|
| 1. 机构审批 | 所在机构需先成为 CPRD Client(获得机构资质) | 2-4 周 |
| 2. eRAP 注册 | 所有研究团队成员在 CPRD 电子研究申请门户注册账号 | 1 周 |
| 3. 协议撰写 | 在 eRAP 中提交完整研究协议,包括研究目的、人群定义、所需变量、分析方法。需引用经伦理批准的总体方案 | 2-4 周 |
| 4. RDG 审核 | CPRD Research Data Governance 流程审核——评估研究是否有公共利益和科学严谨性 | ~4 周 |
| 5. 许可协议签署 | CPRD 与申办方签署许可协议(Single Study 或 Multi-Study License),支付费用 | 2-4 周 |
| 6. 数据规格协商 | 与 CPRD 协商数据提取的具体编码清单、链接数据需求和交付格式 | 2-4 周 |
| 7. 数据交付 | CPRD 通过安全文件传输(SFT)交付研究数据集 | 2-8 周 |
| 总周期 | 从首次联系到数据交付 | 3-6 个月 |
费用参考(2025,不含 VAT):
| 许可类型 | 初级保健数据 | + 链接数据 | 适合 |
|---|---|---|---|
| Single Study License | £5,500 | +£1,100 | 单次研究 |
| Multi-Study License (Standard) | £5,500/年 | +£1,100/年 | 多研究机构 |
| 数据管理费 | £5,500-£29,500(按复杂度) | — | 单次提取 |
§6.3 预处理全流程
原始 Tab-delimited 交付文件
    │
    ├── [1] 加载与整合
    │        → 读取 .txt 文件 → pandas DataFrame
    │        → 按 patid 建立患者级别索引
    │        → 跨表合并(patient + clinical + therapy + ...)
    │
    ├── [2] 编码映射(CRITICAL — 见 §6.5 坑点 1)
    │        → GOLD: Read v2 medcode → 疾病定义 / 药物类
    │        → Aurum: SNOMED CT medcodeid → 疾病定义 / 药物类
    │        → 使用经验证编码清单(CALIBER / OpenCodelists / CPRD 官方)
    │        → ⚠ 临床编码 vs 转诊编码 vs 检测编码的域区分
    │
    ├── [3] 数据清洗
    │        → 去除 unacceptable patient flag
    │        → 检查日期逻辑(事件日期 < 出生日期 → 排除)
    │        → ⚠ 重复事件去重(同一 patid + eventdate + medcode)
    │        → 检测值离群值处理(按检测类型逐一设置合理范围)
    │
    ├── [4] 时间窗构建
    │        → 定义 index date(预测基线)
    │        → 定义 lookback window(历史特征窗口,如 3 年)
    │        → 定义 prediction window(预测窗口,如 5 年)
    │        → 排除在 index date 之前已经失访或死亡的不可评估患者
    │
    ├── [5] 特征工程
    │        → 疾病计数 / 首次诊断年龄 / 距末次事件天数
    │        → 处方:药物类别计数 / 新处方频率 / 疗程总天数
    │        → 检测值:最新值 / 趋势(斜率)/ 变异性(CV)
    │        → 就诊频率 / 就诊间隔中位数
    │        → 缺失指示符(missingness indicator)
    │
    ├── [6] 结局定义
    │        → 从临床事件表提取目标诊断编码
    │        → 或从链接 HES/ONS 构建复合结局
    │        → 定义 censoring 规则(失访 / 死亡 / 研究结束)
    │        → ⚠ 确保结局事件日期在 index date 之后
    │
    └── [7] 时间划分 + 准备建模
             → 按 §5.2 推荐策略划分
             → 排除 index date 前已有结局的 prevalent cases
             → 准备 PyTorch / XGBoost / survival 模型输入
§6.4 框架加载
PyTorch 时序 EHR 模型加载
import torch
from torch.utils.data import Dataset, DataLoader

class CPRDPatientDataset(Dataset):
    """CPRD 患者级别 EHR 序列数据集"""

    def __init__(self, features, labels, times, events):
        """
        features: (n_patients, n_features) 特征矩阵
        labels: (n_patients,) 二分类标签
        times: (n_patients,) 生存时间
        events: (n_patients,) 事件指示符 (1=事件发生, 0=删失)
        """
        self.features = torch.FloatTensor(features)
        self.labels = torch.FloatTensor(labels)
        self.times = torch.FloatTensor(times)
        self.events = torch.FloatTensor(events)

    def __len__(self):
        return len(self.features)

    def __getitem__(self, idx):
        return {
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''features'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': self.features[idx],
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''label'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': self.labels[idx],
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''time'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': self.times[idx],
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''event'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': self.events[idx]
        }

# 加载示例(使用之前 §6.1 构建的特征矩阵)
# dataset = CPRDPatientDataset(X.values, y.values, times, events)
# loader = DataLoader(dataset, batch_size=256, shuffle=True)
生存分析 (Lifelines)
from lifelines import CoxPHFitter

# CPRD 数据特别适合生存分析 — 含丰富的时变协变量和长随访
# cox = CoxPHFitter()
# cox.fit(cprd_df, durationevent-blocked=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''survival_time'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', event_col=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''event'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')
§6.5 常见坑点
⚠️ 坑点 1:Read v2 / SNOMED CT / EMIS Local 三套编码体系的混用(分类:数据理解)
问题:GOLD 使用 Read v2(5 字节层级编码),Aurum 使用 SNOMED CT + EMIS Web 本地代码。三套体系不能直接混用——同一疾病在三套体系中编码完全不同,且存在 EMIS Local 编码无法映射至标准术语的情况。
症状:使用错误编码体系的代码清单后,病例检出率异常低(<1% vs 预期 5-10%),或检出了大量与目标疾病无关的记录。
解决:
- 明确数据来源——先确认收到的是 GOLD 还是 Aurum 数据
- 使用经验证编码清单——CALIBER (https://www.caliberresearch.org/portal) 和 OpenCodelists (https://www.opencodelists.org) 提供经临床专家验证的 Read v2 和 SNOMED CT 编码集
- GOLD 特别注意:Read v2 编码的层级结构意味着父编码包含子编码——查询
G3...(使用%通配符LIKE ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''G3%'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')可捕获所有心血管编码- Aurum 特别注意:medcodeid 包含 SNOMED CT(数字型如
73211009)和 EMIS Local(字母数字型),后者需查阅 CPRD 医学字典确认含义参考:
- CALIBER 编码清单:Kuan et al. (2019), Lancet Digital Health. “A chronological map of 308 physical and mental health conditions from 4 million individuals in the English National Health Service.”
- OpenCodelists: https://www.opencodelists.org
- CPRD Aurum Medical Dictionary: https://www.cprd.com
⚠️ 坑点 2:将"处方"等同于"用药"(分类:标签理解)
问题:CPRD 记录的是 GP 开具的处方(prescriptions),不是患者实际的用药行为(drug utilization)。未取药(primary non-adherence)和未按医嘱服用(secondary non-adherence)在 CPRD 中完全不可见。
症状:基于处方数据估值的药物暴露-反应关系与临床试验结果存在系统性偏差;治疗依从性分析产生虚假高依从率。
解决:
- 在论文中明确区分"prescribed"和"dispensed/consumed"
- 如研究需要实际取药数据,链接 BSA(Business Services Authority)药品分发数据(2025 年起可用)
- 使用处方续方模式(repeat prescribing)作为依从性代理——续方间隔规律的患者更可能持续用药
- 对关键分析做敏感性分析——假设最低/最高依从率场景
参考:
- CPRD Primary Care BSA Dispensing Data: https://discover.metadata.works/browser/dataset/1601/6
⚠️ 坑点 3:注册时间偏倚与"不朽时间"(分类:偏倚陷阱)
问题:患者在 GP 注册后方有数据记录——注册前的事件不可见(左截断)。此外,如果错误地将"从注册到事件发生"作为暴露起算时间,会产生不朽时间偏倚(immortal time bias)。
症状:研究结果中出现难以置信的保护效应(HR 显著低于 1.0);药物安全性分析发现"新药降低死亡率"(实际是入选偏倚)。
解决:
- 强制排除注册不满 12 个月的患者——确保基线数据的完整性(这是 CPRD 文献的标准做法)
- 在生存分析中使用 delayed entry(即患者自满足"12 个月注册"起进入风险集,而非自注册起)
- 构建 new user design:仅纳入首次处方目标药物的患者,排除既往使用者(prevalent users)
- 对暴露定义使用 landmark analysis 以避免 immortal time bias
参考:
- Lewis et al. (2005), Pharmacoepidemiol Drug Saf. “The relationship between time since registration and measured incidence rates in the GPRD.”
- Ray (2003), Ann Intern Med. “Evaluating medication effects outside of clinical trials: new-user designs.”
⚠️ 坑点 4:编码清单决定一切——没有"标准疾病定义"(分类:数据理解)
问题:与 MIMIC 或 CheXpert 不同,CPRD 不提供任何预定义标签。所有病例定义(case definition)都必须由研究者通过编码清单(codelist)自行构建。同一疾病使用不同编码清单可能产生截然不同的研究人群。
症状:你和他人的研究结果无法对比——可能因为编码清单不同导致纳入/排除了不同的患者。
解决:
- 优先使用已发表和验证的编码清单——CALIBER、OpenCodelists、CPRD 官方代码浏览器
- 在论文中完整公布编码清单(以在线补充材料形式),确保可复现
- 进行编码清单敏感性分析——使用宽/严两套清单,检查结果稳定性
- 对关键诊断进行链接数据验证——如癌症诊断链接 NCRAS(CPRD Aurum 完整性 77% vs GOLD 65%)
参考:
- Watson et al. (2017), BMJ Open. “Identifying clinical features in primary care EHR studies: methods for codelist development.”
- Williams et al. (2019), PLoS One. “Term sets: A transparent and reproducible representation of clinical code sets.”
⚠️ 坑点 5:OMOP CDM 转换中的数据损失(分类:工程陷阱)
问题:将 CPRD 原生格式转换为 OMOP CDM 是规范化分析的有力工具,但 ETL 过程可能引入信息损失——某些 Read v2 编码在 OMOP 标准词汇表中没有一对一映射,少量 EMIS Local 编码可能完全丢失。
症状:OMOP 转换后某些事件类型数量与原数据显著不符(>5% 差异);某些药物暴露记录在 OMOP 中被映射到错误的概念 ID。
解决:
- 转换前后计数对比:对每种事件类型在原生表和 OMOP 表之间做行计数比较
- 检查未映射编码:记录所有
conevent-blocked= 0(无映射)的事件,评估其临床重要性和量级- 使用经过验证的 ETL:牛津大学 oxford-pharmacoepi/cdm-etl-gold(GitHub)和 OHDSI ETL-LambdaBuilder 均有正式 CPRD GOLD 支持
- Aurum→OMOP 转换参考 NIH/NLM 团队(Blacketer et al., 2023, J Biomed Inform)的工作和牛津 DExtER 工具
- 对关键分析同时汇报原生数据和 OMOP 数据的结果作为稳健性检验
参考:
- OHDSI CPRD ETL Documentation: https://ohdsi.github.io/ETL-LambdaBuilder/docs/CPRD
- Blacketer et al. (2023), J Biomed Inform. “Conversion of CPRD AURUM data into the OMOP common data model.”
§6.6 数据增强
CPRD 的"增强"概念不同于影像数据集——不是图像旋转/裁剪,而是信息增强:
| 策略 | ✅ 安全 / ❌ 危险 | 说明 |
|---|---|---|
| ✅ 链接 HES 补充住院事件 | 安全 | 将 GP 未记录的住院事件补充至患者轨迹 |
| ✅ 编码清单扩展(宽定义) | 安全(需报告) | 使用更宽的编码集纳入可能的边缘病例 |
| ❌ 合成数据填补缺失随访 | 危险 | 错误假设数据缺失机制(MAR/MCAR) |
| ❌ 从处方推断诊断 | 危险(偏差大) | 同一药物可有多种适应症——从处方反推诊断是不安全的代理 |
| ✅ 多重插补(已验证模块) | 安全(需验证) | 使用 MICE 等方法填补缺失检测值,需报告插补模型的假设和诊断 |
§6.7 模型建议
| 任务 | 推荐方法 | 参考文献 | 预期性能 |
|---|---|---|---|
| CVD 风险预测 | MT-BERT(融合结构化 + 文本编码) | Liu et al. (2025), JMIR Med Inform | AUROC 0.744 (M) / 0.782 (F) |
| 多病共存轨迹 | SurvivEHR(竞争风险基础模型) | Acharya et al. (2025), medRxiv | 74 种 LTCs 的竞争风险 C-index |
| T2DM 并发症预测 | GatorTron-base(代码无关文本驱动) | AlphaXiv (2024) | Micro-F1 0.50 (5 年预测) |
| 药物-事件信号检测 | 高通量自对照病例系列 (SCCS) | PMC11326319 (2024) | — |
| 经典流行病学 | Cox PH / 逻辑回归 | 数百篇 CPRD 文献 | 取决于编码清单质量 |
§6.8 计算需求
| 配置项 | 轻度(经典回归) | 中度(XGBoost) | 重度(DL 基础模型) |
|---|---|---|---|
| CPU | 8 核 | 16-32 核 | 32+ 核 |
| 内存 | 16 GB | 64-128 GB | 256 GB+ |
| GPU | 不需要 | 推荐(训练加速) | 必需(A100/H100 级别) |
| 存储 | 50 GB | 200-500 GB | 1 TB+ |
| 典型运行时间 | 分钟级 | 小时级 | 天-周级(SurvivEHR 使用 FastEHR + Polars 加速) |
§6.9 评估指标
from sklearn.metrics import roc_auc_score, average_precision_score
from lifelines.utils import concordance_index

# ── 分类任务 ──
# AUROC: 区分度评估(CPRD 预测模型最常用的指标)
auroc = roc_auc_score(y_true, y_pred_proba)

# AUPRC: 在不平衡结局(如罕见疾病 <5% 患病率)下更适用
auprc = average_precision_score(y_true, y_pred_proba)

# ── 生存分析 ──
# Harrell''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''s C-index: 生存模型的区分度
c_index = concordance_index(event_times, predicted_risks, event_observed)

# Brier Score: 校准度评估(预测风险与实际风险的偏差)
# 在 MT-BERT CVD 研究中报告为 0.130 (M) / 0.091 (F)

# ── 公平性评估 ──
# 按种族/剥夺指数/性别的亚组 AUROC 差异
# MT-BERT 发现南亚裔和黑人群体 AUROC 显著低于白人群体
§6.10 MLOps 笔记
-
数据版本管理:CPRD 每月更新——模型必须在特定 data build 上训练(记录 build 日期和版本号如 “GOLD 2024.11.001”),否则无法复现
-
许可合规:训练完成的模型本身可能受 CPRD 许可协议约束——部分许可禁止模型权重公开分发(因可能包含训练数据统计信息)
-
安全环境:CPRD 数据通常要求在机构的安全服务器上处理,不允许上传至公共云 GPU 集群——需提前评估本地 GPU 资源
-
输出检查:CPRD 要求所有拟发表的统计输出(表格、图表、模型系数)通过披露审查,确保不含可识别个体患者级别的信息
§7 质量评估与局限性
§7.1 已知偏倚
| 偏倚类型 | 描述 | 严重程度 | 缓解措施 |
|---|---|---|---|
| 选择偏倚 | GP 诊所自愿参与数据共享——参与诊所可能与未参与诊所在患者人口、数据质量上存在差异 | 中 | 使用 IMD/城乡分类比较参与与非参与诊所特征 |
| 健康志愿者偏倚 | 可链接患者需单独同意——同意链接者可能与非同意者在健康行为上不同 | 低-中 | 比较链接亚组与非链接亚组在可用变量上的特征 |
| 编码实践偏倚 | QOF 激励仅覆盖特定慢性病——非 QOF 覆盖的疾病编码完整性显著降低 | 高 | 使用链接 HES 数据验证非 QOF 疾病编码完整性 |
| 人口统计偏倚 | 种族数据仅适用于英格兰链接患者(约 58-81%)——非英格兰/非链接患者的种族分布完全未知 | 中-高 | 在分析中报告种族数据的完整性,使用 IMD 作为社会经济状态的补充代理 |
| 幸存者偏倚 | 较年长患者有更长的"幸存至注册"时间——可能排除早年重症死亡的患者 | 中 | 使用 left truncation(delayed entry)技术 |
| 不朽时间偏倚 | 研究设计错误导致暴露组获得"免费"的生存时间——药物流行病学文献中最常见的偏倚之一 | 高(设计阶段可避免) | 使用 new user design + clone-censor-weight 方法 |
| 英国中心偏倚 | 全球推广性有限——英国 NHS 的免费 GP 体系与保险制国家在就诊行为上可能显著不同 | 中 | 使用多国数据源(CPRD + Optum/JMDC 等)验证关键发现 |
§7.2 标注 / 编码质量
| 数据域 | 质量评价 | 证据依据 |
|---|---|---|
| 诊断编码 | Aurum > GOLD;QOF 覆盖疾病 > 非 QOF 疾病 | 前列腺癌研究:Aurum 准确性 87% / 完整性 77% vs Cancer Registry;GOLD 准确性 86% / 完整性 65% |
| 处方编码 | 极高 | GP 电子处方系统直接生成,受 NHS 处方监管审计 |
| 死亡记录 | GOLD ~60% / Aurum ~70% 的 HES 住院患者有对应院内死亡记录;链接 ONS 后接近完整 | ONS 死亡登记为法定要求 |
| 实验室检测 | 较高(受检测类型影响) | 外部实验室电子回传,数值可信度高 |
| 生活方式变量 | 中等,缺失率高 | 吸烟/BMI/饮酒依赖 GP 录入,约 30-50% 患者在任意时间点有 BMI 记录 |
§7.3 泛化性讨论
| 场景 | 泛化性评估 | 证据 |
|---|---|---|
| 英国全境 | 良好——CPRD 覆盖约 20% UK 人口,在年龄、性别、IMD 上与全英人口匹配 | Herrett et al. (2015); Wolf et al. (2019) |
| 欧洲他国 | 中等——英国 NHS 的免费 GP 模式与欧陆保险制国家的就诊行为可能不同 | 需与 THIN / QResearch 对比验证 |
| 北美 | 较低——美国商业保险体系和按服务付费模式与 NHS 的全民覆盖模式存在系统性差异 | 需与 Optum / MarketScan 对比验证 |
| 亚洲 | 低——疾病谱、处方模式和 GP 行为存在系统性差异 | 直接推广不推荐 |
| 时间泛化 | 动态——COVID-19 大流行(2020-2022)显著改变了 GP 就诊模式、处方行为和预防保健覆盖率 | 需按疫情前/中/后分层评估 |
| 跨数据库泛化 | GOLD → Aurum 泛化性良好(使用不同软件系统的独立人群)——这是 CPRD 的核心优势 | GOLD 和 Aurum 共享类似的 QOF 激励机制 |
§7.4 伦理考量
- 数据匿名化:CPRD 通过 NHS England 信任第三方移除所有直接患者标识符。患者 NHS 号码被替换为 CPRD 内部密钥。自由文本字段不含患者可识别信息
- 患者选择退出:CPRD 尊重所有 National Data Opt-out——已注册退出的患者数据不会被提取。患者可在任意时间向 GP 申请退出数据共享
- 伦理批准:CPRD 持有 HRA Research Ethics Committee 批准(REC 参考号 05/MRE04/87)——使用 CPRD 数据进行的观察性研究通常不需额外 REC 审批(需满足 CPRD RDG 要求)
- 公共利益审查:所有研究协议需通过 RDG 审核,确保研究有明确的公共健康益处
- 发表前输出检查:CPRD 要求研究者在发表前提交所有输出(表格、图表)进行披露审查,防止个体患者信息泄露
- 弱势群体:儿童、孕产妇、精神疾病患者等弱势群体的数据被同样保护——用于此类群体的研究协议会受到更严格的 RDG 审查
- 商业化使用:制药公司和商业研究机构可通过商业许可使用 CPRD 数据,需支付更高费用——收入用于维持 CPRD 非营利运营
§7.5 公平性评估
基于 MT-BERT CVD 研究(Liu et al., 2025)的已知性能差异:
| 维度 | 发现 | 潜在原因 | 建议 |
|---|---|---|---|
| 种族 | 南亚裔和黑人群体 CVD 预测 AUROC 低于白人群体 (>5% 差异) | 编码完整性差异、既有风险评分的校准偏差、变量分布偏移 | 使用公平性约束训练;在验证中报告亚组性能 |
| 性别 | 女性模型性能始终优于男性(MT-BERT AUROC 0.782 vs 0.744) | 女性就诊频率更高、编码更完整 | 分别训练男性/女性模型或使用性别分层校准 |
| 剥夺指数 | 高剥夺区域(IMD 五分位 1-2)预测性能低于低剥夺区域 | 就诊模式差异、编码不完整、多病共存复杂度更高 | 在模型中纳入 IMD 交互项 |
| 年龄 | >85 岁老人中诊断编码与检测值的关系减弱 | “诊断惰性”——高龄患者 GP 更少对新症状进行正式诊断编码 | 使用更宽的症状+诊断联合标签定义 |
§7.6 数据漂移提示
- COVID-19 效应(2020-2022):GP 面对面就诊量急剧下降,远程咨询激增,癌症筛查中断,预防保健覆盖率下降——2020 年前后的数据模式存在显著结构性断裂
- QOF 激励变化:英国 QOF 框架在 2004 年引入后显著提升了特定慢性病的编码完整性——2004 年前后的数据不可直接对比
- 编码体系过渡:Read v2 向 SNOMED CT 的过渡(约 2018 年开始)在 GP 层面渐进推行——过渡期数据中存在两种编码并存,增加了处理复杂度
- 处方模式演变:新一代药物(如 GLP-1 受体激动剂、SGLT2 抑制剂)的引入改变了糖尿病和肥胖的治疗格局——基于旧数据的模型可能错估新药物的风险和获益
§7.7 DAIMS 24 项数据就绪度评估
| # | 检查项 | 评分 | 说明 |
|---|---|---|---|
| 1 | 数据来源透明 | ✅ | 数据采集源完整记录——GP 诊所、二级保健链接、ONS 等 |
| 2 | 样本量充足 | ✅ | 7,100 万患者——规模在全球 EHR 数据源中居首 |
| 3 | 数据采集时间清晰 | ✅ | 1987 年至今,build 日期精确到月 |
| 4 | 人群代表性文档化 | ✅ | Herrett (2015) 和 Wolf (2019) 详细验证了年龄、性别、种族和地理代表性 |
| 5 | 入排标准可复现 | ✅ | 基于 CPRD acceptable patient flag + 注册时间的标准筛选规则 |
| 6 | 标注方式文档化 | ✅ | GP 实时录入——QOF 激励和 NHS 审计约束下运作 |
| 7 | 标注者资质可知 | ✅ | NHS 注册全科医生、护士和医疗人员 |
| 8 | 金标准验证 | ✅ | 链接 HES/ONS/NCRAS 提供多层级金标准验证 |
| 9 | 数据采集协议文档化 | ✅ | GP→CPRD 月度上传协议,900+ QC 检查 |
| 10 | 数据质量评估 | ✅ | CPRD 内部 QC + 外部验证研究(前列腺癌研究等) |
| 11 | 缺失数据策略 | ⚠️ | 缺失模式已知但需研究者自行处理 |
| 12 | 编码/术语标准 | ⚠️ | 多套编码体系(Read v2 / SNOMED CT / EMIS Local)——需要额外映射 |
| 13 | 标准 train/val/test 划分 | ❌ | 不提供——需研究者自行设计时间/地理/诊所级划分 |
| 14 | 数据泄漏防护 | ⚠️ | 无预设防护——需研究者自行避免时间泄漏和诊所级泄漏 |
| 15 | 伦理审查 | ✅ | REC 05/MRE04/87 + RDG 逐项协议审批 |
| 16 | 公平性分析 | ⚠️ | 种族和社会经济数据有限(仅英格兰链接患者) |
| 17 | 泛化性讨论 | ✅ | 多篇验证研究讨论地理和时间泛化性 |
| 18 | 数据版本控制 | ✅ | 月度 build + 版本号(如 2024.11.001) |
| 19 | 数据去标识化 | ✅ | NHS England 信任第三方去标识 + National Data Opt-out 尊重 |
| 20 | 知情同意 | ⚠️ | 免知情同意(二次匿名数据使用)但受 RDG 公共利益审查约束 |
| 21 | 数据可获取性 | ⚠️ | 非公开——需机构许可、协议审批和费用支付(3-6 个月流程) |
| 22 | 配套工具与文档 | ✅ | CPRD 代码浏览器、数据字典、医学字典、R 包 rcprd、OMOP ETL 等 |
| 23 | 社区活跃度 | ✅ | 29 国研究者使用,600+ 期刊发表,年均 16.37% 增长 |
| 24 | AI/ML 就绪文档 | ❌ | 无官方 ML 基准文档——需研究者自行构建特征、标签和划分 |
DAIMS 评分:16.5 / 24
评分解读:合格——数据底层质量和代表性极佳,但访问门槛高且完全无 AI/ML 开箱即用基础设施。
对你意味着什么:CPRD 的数据质量在全球初级保健 EHR 数据源中处于顶尖水平——7,100 万患者、近 40 年随访、17 种链接、900+ QC 检查。但 AI 工程视角下最大的短板是:它不是"下载即用"的数据集。你需要:
- 预留 3-6 个月的申请周期(机构审批 → RDG 协议 → 数据交付)
- 自行构建编码清单——没有预定义的疾病标签或特征,所有定义都需要从 Read v2 / SNOMED CT 编码中手动或半自动构建
- 自行设计数据划分——推荐时间 + 诊所级分组组合,确保时间顺序和编码无泄漏
- 预算数据费用和计算资源——许可费(£5,500+/年)+ 数据管理费(£5,500-£29,500)+ 安全计算环境
如果你能满足上述条件——CPRD 是训练"真实世界 EHR 基础模型"的最佳场域之一。如果时间和预算不允许——建议先从 MIMIC-IV 或 eICU 等公开数据集起步。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 样本量 | 评估任务 | 关键发现 |
|---|---|---|---|---|
| THIN | IQVIA (英国) | ~1,600 万 | 疾病发病率验证 | CPRD 与 THIN 的 CVD / 糖尿病 / 癌症发病率估计一致(已并入 Aurum 的 EMIS 数据源) |
| QResearch | 牛津大学 (英国) | ~3,500 万 | COVID-19 风险评分 | QResearch 的 QCovid 风险计算器在 CPRD Aurum 中外部验证 (C-statistic ~0.80) |
| HES APC | NHS England | 全国住院 | 诊断完整性外部对照 | CPRD Aurum 癌症记录 vs HES:GP 诊断约 70-77% 的 HES 诊断在 CPRD 中有对应记录 |
| ONS 死亡 | ONS (英国) | 全国死亡 | 死亡结局验证 | 链接 ONS 后死因分类准确率接近 100%,但部分猝死在 GP 中无前兆记录 |
| NCRAS 癌症注册 | NHS England | 全国癌症 | 癌症诊断金标准验证 | CPRD Aurum 癌症诊断准确性 87%,完整性 77%(2024 年前列腺癌研究) |
| OpenSAFELY | Bennett Institute (英国) | ~5,800 万 | EHR 分析范式验证 | OpenSAFELY 的 ehrQL 分析范式用 CPRD 数据进行外部复制——结果一致性高(COVID-19 药物安全研究) |
| CPRD GOLD → CPRD Aurum | CPRD (内部对照) | ~2,100 万 → ~4,500 万 | 跨数据库泛化性 | MT-BERT 在 Aurum 上训练、在 GOLD 的地理隔离子集上验证——这是 CPRD 独有的天然外部验证能力 |
§8 基准性能与生态
§8.1 代表性研究性能
CPRD 不举办官方 ML 排行榜。以下是近年使用 CPRD 数据的代表性 AI/ML 研究性能:
| 研究 | 任务 | 模型 | 性能指标 | 年份 | 关键技术 | 完整引用 |
|---|---|---|---|---|---|---|
| MT-BERT CVD | 10 年 CVD 风险预测 | MT-BERT(融合结构化 + DistilBERT 文本编码) | AUROC 0.744 (M) / 0.782 (F);Brier 0.130/0.091 | 2025 | 多任务 BERT + FocalCoxLoss + 跨模态注意力融合 | Liu et al. (2025), JMIR Med Inform. DOI: 10.2196/76659 |
| SurvivEHR | 74 种 LTCs 竞争风险生存分析 | 深度学习竞争风险基础模型 | —(预印本) | 2025 | FastEHR 管道 + 竞争风险损失函数 + 多任务 head | Acharya et al. (2025), medRxiv. DOI: 10.1101/2025.08.04.25332916 |
| GatorTron T2DM | 1/5/10 年 T2DM 微血管并发症预测 | GatorTron-base(代码无关文本驱动) | Micro-F1 0.50 (5 年);AUPRC 0.51 | 2024 | 临床代码→自然语言描述序列化 + ClinicalBERT 微调 | AlphaXiv (2024). arXiv: 2412.01331v1 |
| 高通量药物筛查 | 自对照病例系列药物-事件信号检测 | 基础模型辅助自动化 SCCS | — | 2024 | 10 节点药物暴露准备算法 + 自动 SCCS + doseminer | PMC11326319 (2024) |
| CPRD + BERT | 临床 FM 综述 | 84 个非影像 EHR 基础模型综述 | — | 2023 | Taxonomy: 架构 × 训练数据 × 用例——CPRD 被列为未来关键训练数据源 | Wornow et al. (2023), npj Digital Medicine. DOI: 10.1038/s41746-023-00879-8 |
§8.2 SOTA 总结
| 维度 | 当前状态 | 未来趋势 |
|---|---|---|
| 模型复杂度 | 从经典回归(Cox PH)转向深度学习(BERT/Transformer) | 基础模型预训练 + 下游微调(SurvivEHR 方向) |
| 特征工程 | 从手工编码清单 → 自动化文本驱动特征提取(GatorTron) | 多模态融合(结构化 + 文本 + 可能的知识图谱) |
| 时间建模 | 从单一预测窗 → 多时间窗竞争风险(SurvivEHR) | 全生命周期轨迹建模 |
| 公平性 | 起步阶段——MT-BERT 报告了亚组差异 | 公平性约束纳入训练目标 |
| 泛化性 | GOLD/Aurum 互相验证(CPRD 天然优势) | 跨国数据源联合训练 |
§8.3 评估协议
- 无官方评估协议——每项研究自行定义评估方案
- 常见评估实践:时间外部验证(Temporal validation)是 CPRD 研究中的标准做法——在较早年份上开发、在较晚年份上验证
- 跨数据库验证:使用 GOLD→Aurum(或反之)作为内部外部验证是最佳实践
- 种族和剥夺指数亚组分析:2025 年起被更多 ML 研究采纳(MT-BERT 开创性工作)
§8.4 相关数据集
| 数据集 | 关系 | 互补价值 |
|---|---|---|
| OpenSAFELY | 互补——同为英国 GP 数据,但采用联邦分析(TRE)模式 | 不可下载 / 联邦分析 / COVID-19 药物安全验证 |
| THIN | 竞争/互补——已整合入 CPRD Aurum | 历史数据对比 |
| QResearch | 互补——EMIS 系统专有,COVID-19 风险评分发源地 | 跨数据库验证 |
| UK Biobank | 互补——CPRD + UKB 链接提供基因组 × EHR 交叉维度 | 基因-疾病关联分析 |
| HES-ONS | 链接——CPRD 的主要次级验证数据源 | 住院和死亡结局验证 |
| Sentinel (FDA) | 互补——美国药物安全主动监测系统 | 跨医疗体系药物安全信号验证 |
§8.5 关键论文
- Herrett E, Gallagher AM, Bhaskaran K, et al. (2015). Data Resource Profile: Clinical Practice Research Datalink (CPRD). International Journal of Epidemiology, 44(3), 827-836. DOI: 10.1093/ije/dyv098. — CPRD GOLD 官方数据资源概况,3,238+ 引用。所有 CPRD GOLD 研究的基础引用。
- Wolf A, Dedman D, Campbell J, et al. (2019). Data resource profile: Clinical Practice Research Datalink (CPRD) Aurum. International Journal of Epidemiology, 48(6), 1740-1740g. DOI: 10.1093/ije/dyz034. — CPRD Aurum 官方数据资源概况,482+ 引用。对比 GOLD 的人口代表性和数据格式差异。
- Padmanabhan S, Carty L, Cameron E, et al. (2019). Approach to record linkage of primary care data from CPRD to other health-related patient data. European Journal of Epidemiology, 34(1), 91-99. DOI: 10.1007/s10654-018-0442-4. — CPRD 数据链接方法的全流程描述。
- Liu T, Lu L, Wang Y, et al. (2025). Estimating 10-Year CVD Risk Using UK EHR and a Hybrid Multitask BERT Model. JMIR Medical Informatics, 13, e76659. DOI: 10.2196/76659. — CPRD Aurum 上使用 MT-BERT 预测 10 年 CVD 风险,含种族和剥夺指数公平性评估。
- Acharya A, et al. (2025). SurvivEHR: a competing risks, time-to-event foundation model for multiple long-term conditions from primary care. medRxiv. DOI: 10.1101/2025.08.04.25332916. — 从 2,650 万 CPRD 患者中训练 74 种 LTCs 的竞争风险基础模型,FastEHR 管道。
- Wornow M, Xu Y, Thapa R, et al. (2023). The shaky foundations of large language models and foundation models for electronic health records. npj Digital Medicine, 6, 135. DOI: 10.1038/s41746-023-00879-8. — 84 个临床基础模型综述,指出 CPRD 等大规模 EHR 数据源是未来方向。
- Blacketer C, et al. (2023). Conversion of CPRD AURUM data into the OMOP common data model. Journal of Biomedical Informatics, 104570. DOI: 10.1016/j.jbi.2024.104570. — CPRD Aurum → OMOP CDM 的 ETL 验证研究——AI 标准化分析的必备基础。
- Axson E, Rahman M, Hodgson S. (2025). Academic impact and research data utilisation of the CPRD: scientometric analyses. European Journal of Epidemiology. — CPRD 的学术影响力计量分析:3,779 篇论文,29 个国家,年均 16.37% 增长。
- Springate DA, Parisi R, Olier I, et al. (2017). rEHR: An R package for manipulating and analysing Electronic Health Record data. PLoS ONE, 12(2), e0171784. — CPRD 数据处理的早期 R 工具。后续有 Pate A et al. (2025) rcprd 包。
- Williamson EJ, Walker AJ, Bhaskaran K, et al. (2020). Factors associated with COVID-19-related death using OpenSAFELY. Nature, 584, 430-436. DOI: 10.1038/s41586-020-2521-4. — 虽非直接使用 CPRD,但 OpenSAFELY 的分析范式大量参考 CPRD 编码清单和表型定义方法。
§8.6 社区活跃度
| 指标 | 数值 |
|---|---|
| 累计出版物 | 3,779 篇(1988-2024) |
| 贡献国家 | 29 个 |
| 发表期刊数 | 600+ |
| 年均增长率 | 16.37% |
| 顶级发表期刊 | BMJ Open, Pharmacoepidemiology and Drug Safety, International Journal of Epidemiology |
| 最高产机构 Top 3 | 牛津大学、伦敦大学学院、伦敦卫生与热带医学院(7 所英国大学进入 Top 10) |
| GitHub 工具生态 | rcprd ®, FastEHR (Python), DExtER ®, cdm-etl-gold (.NET), aurumpipeline (Python) |
§8.7 生态快照
| 资源 | 类型 | 链接 | 为什么值得关注 |
|---|---|---|---|
| CPRD 官方代码浏览器 | 工具 | https://www.cprd.com | 在线查询 GOLD Read codes 和 Aurum SNOMED CT 编码的官方解释 |
| OpenCodelists | 社区资源 | https://www.opencodelists.org | 社区维护的 CPRD 研究编码清单——可搜索、可下载、可引用、经验证 |
| CALIBER 编码清单 | 学术资源 | https://www.caliberresearch.org/portal | 308 种疾病和健康状况的经验证 Read v2 / ICD-10 编码映射 |
| OHDSI CPRD ETL 文档 | 官方文档 | https://ohdsi.github.io/ETL-LambdaBuilder/docs/CPRD | CPRD GOLD → OMOP CDM 转换的完整技术文档 |
| rcprd (R 包) | 工具库 | https://github.com/alexpate30/rcprd | 简化 CPRD 数据提取和处理,构建分析就绪数据集(2025 年新版) |
| FastEHR (Python) | 工具库 | SurvivEHR 论文附件 | 高通量 EHR ETL 管道——使用 Polars 流式处理大表,内存高效 |
| DExtER ® | 工具 | CPRD 官方推荐 | 基于电子健康记录的临床编码清单构建和数据提取工具 |
| CPRD Bibliography | 文献索引 | https://www.cprd.com/bibliography | 30 年来的 CPRD 研究全目录——文献调研的起点 |
§9 相关资源与引用
§9.1 BibTeX 引用
引用 CPRD GOLD:
@article{herrett2015data,
  title={Data Resource Profile: Clinical Practice Research Datalink (CPRD)},
  author={Herrett, Emily and Gallagher, Arlene M and Bhaskaran, Krishnan and
          Forbes, Harriet and Mathur, Rohini and van Staa, Tjeerd and Smeeth, Liam},
  journal={International Journal of Epidemiology},
  volume={44},
  number={3},
  pages={827836},
  year={2015},
  doi={10.1093/ije/dyv098}
}
引用 CPRD Aurum:
@article{wolf2019data,
  title={Data resource profile: Clinical Practice Research Datalink (CPRD) Aurum},
  author={Wolf, Achim and Dedman, Daniel and Campbell, Jennifer and
          Booth, Helen and Lunn, Darren and Chapman, Jennifer and Myles, Puja},
  journal={International Journal of Epidemiology},
  volume={48},
  number={6},
  pages={17401740g},
  year={2019},
  doi={10.1093/ije/dyz034}
}
引用特定 CPRD Build(如 GOLD 2024.11):
@misc{CPRDGOLD202411,
  author = {{Clinical Practice Research Datalink}},
  title = {CPRD GOLD November 2024 (Version 2024.11.001)},
  year = {2024},
  doi = {10.48329/nxvj-3672}
}
§9.2 官方资源
| 资源 | 链接 |
|---|---|
| CPRD 官方网站 | https://www.cprd.com |
| 数据访问指南 | https://www.cprd.com/data-access |
| 数据定价 | https://www.cprd.com/pricing |
| 研究协议提交 (eRAP) | https://www.cprd.com/research-applications |
| 文献目录 | https://www.cprd.com/bibliography |
| CPRD GOLD 数据规格 | https://www.cprd.com/cprd-gold-data-specification |
| CPRD Aurum 数据规格 | https://www.cprd.com/cprd-aurum-data-specification |
§9.3 教程与社区
| 资源 | 链接 |
|---|---|
| CPRD 资源包(BSMS) | https://www.bsms.ac.uk/_pdf/pcph/cprd-resource-pack.pdf |
| CPRD @ EMA 目录 | http://catalogues.ema.europa.eu/node/1026/quantitative-descriptors |
| CPRD @ HDR UK | https://healthdatagateway.org |
| CPRD OMOP ETL 文档 | https://ohdsi.github.io/ETL-LambdaBuilder/docs/CPRD |
| rcprd R 包教程 | https://github.com/alexpate30/rcprd |
| OpenCodelists 社区 | https://www.opencodelists.org |
§10 AI 使用声明卡
§10.1 AI 模型使用
- Google Gemini(深度研究:CPRD 数据统计、OMOP ETL 资料、学术影响力分析、定价)
- Claude(WebFetch:arxiv 论文详情、GitHub 代码库信息)
§10.2 AI 参与范围
AI-assisted — AI 完成初稿撰写、信息整合和格式化,所有医学和技术内容经千方病案医学编辑部交叉审核。
§10.3 输入来源
- Herrett et al. (2015). Data Resource Profile: CPRD. IJE.
- Wolf et al. (2019). Data Resource Profile: CPRD Aurum. IJE.
- CPRD 官方网站 (www.cprd.com) — Data Access, Pricing, CPRD GOLD/Aurum Dataset pages
- CPRD Aurum July 2023 数据集页面 (cprd.com)
- CPRD GOLD October 2023 数据集页面 (cprd.com)
- MHRA News: Global impact of UK health data resource (2025)
- Liu et al. (2025). MT-BERT CVD Risk Prediction. JMIR Med Inform
- Acharya et al. (2025). SurvivEHR. medRxiv
- AlphaXiv (2024). GatorTron T2DM Complications Prediction
- PMC11326319 (2024). High-throughput drug screening using CPRD
- Blacketer et al. (2023). CPRD Aurum → OMOP CDM Conversion
- Wornow et al. (2023). Clinical FMs Review. npj Digital Medicine
- Somathilake et al. (2024). Prostate Cancer Diagnosis Quality in CPRD. Cancer Epidemiology
- Chan et al. (2025). MPS Linkage Method for CPRD. IJPDS
- OHDSI ETL-LambdaBuilder CPRD Documentation
- Oxford Pharmacoepi CDM-ETL-GOLD GitHub repository
- CPRD Pricing Page (cprd.com/access-data/pricing)
§10.4 人工校验
| 内容模块 | 审核者 | 审核方式 | 审核状态 |
|---|---|---|---|
| §2 医学背景 | 千方病案医学编辑部 | 交叉审核 | ✅ 已通过 |
| §6 代码示例 | 千方病案医学编辑部 | 逻辑审查 | ✅ 已通过 |
| §3 数据规格 | 千方病案医学编辑部 | 与 CPRD 官方文档交叉比对 | ✅ 已验证 |
| §7 DAIMS 评估 | 千方病案医学编辑部 | DAIMS 24 项逐项核查 | ✅ 已通过 |
| §6.5 坑点 | 千方病案医学编辑部 | 交叉审核 | ✅ 已通过 |
| §C JSON-LD | 千方病案医学编辑部 | 与 schema.org / Croissant 1.1 规范交叉比对 | ✅ 已验�� |
§10.5 最后一次人工审核
2026-07-28
页面状态:published — 全部内容已完成审核并发布。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- opensafely — 共享标签:电子健康记录 / 临床电子病历 / 真实世界数据 / 队列研究
- cgrd — 共享标签:电子健康记录 / 临床电子病历 / 真实世界数据 / 药物安全
- gepard — 共享标签:电子健康记录 / 真实世界数据 / 药物安全 / 队列研究
- thin — 共享标签:电子健康记录 / 临床电子病历 / 真实世界数据 / 药物安全
- jmdc — 共享标签:电子健康记录 / 临床电子病历 / 真实世界数据 / 药物安全
- outcomerea — 共享标签:电子健康记录 / 临床电子病历 / 队列研究
- cdars — 共享标签:电子健康记录 / 药物安全 / 队列研究
- trinetx — 共享标签:电子健康记录 / 真实世界数据 / 药物安全
- flatiron-health — 共享标签:电子健康记录 / 临床电子病历 / 真实世界数据
- openfda — 共享标签:电子健康记录 / 真实世界数据 / 药物安全
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
