信息速览
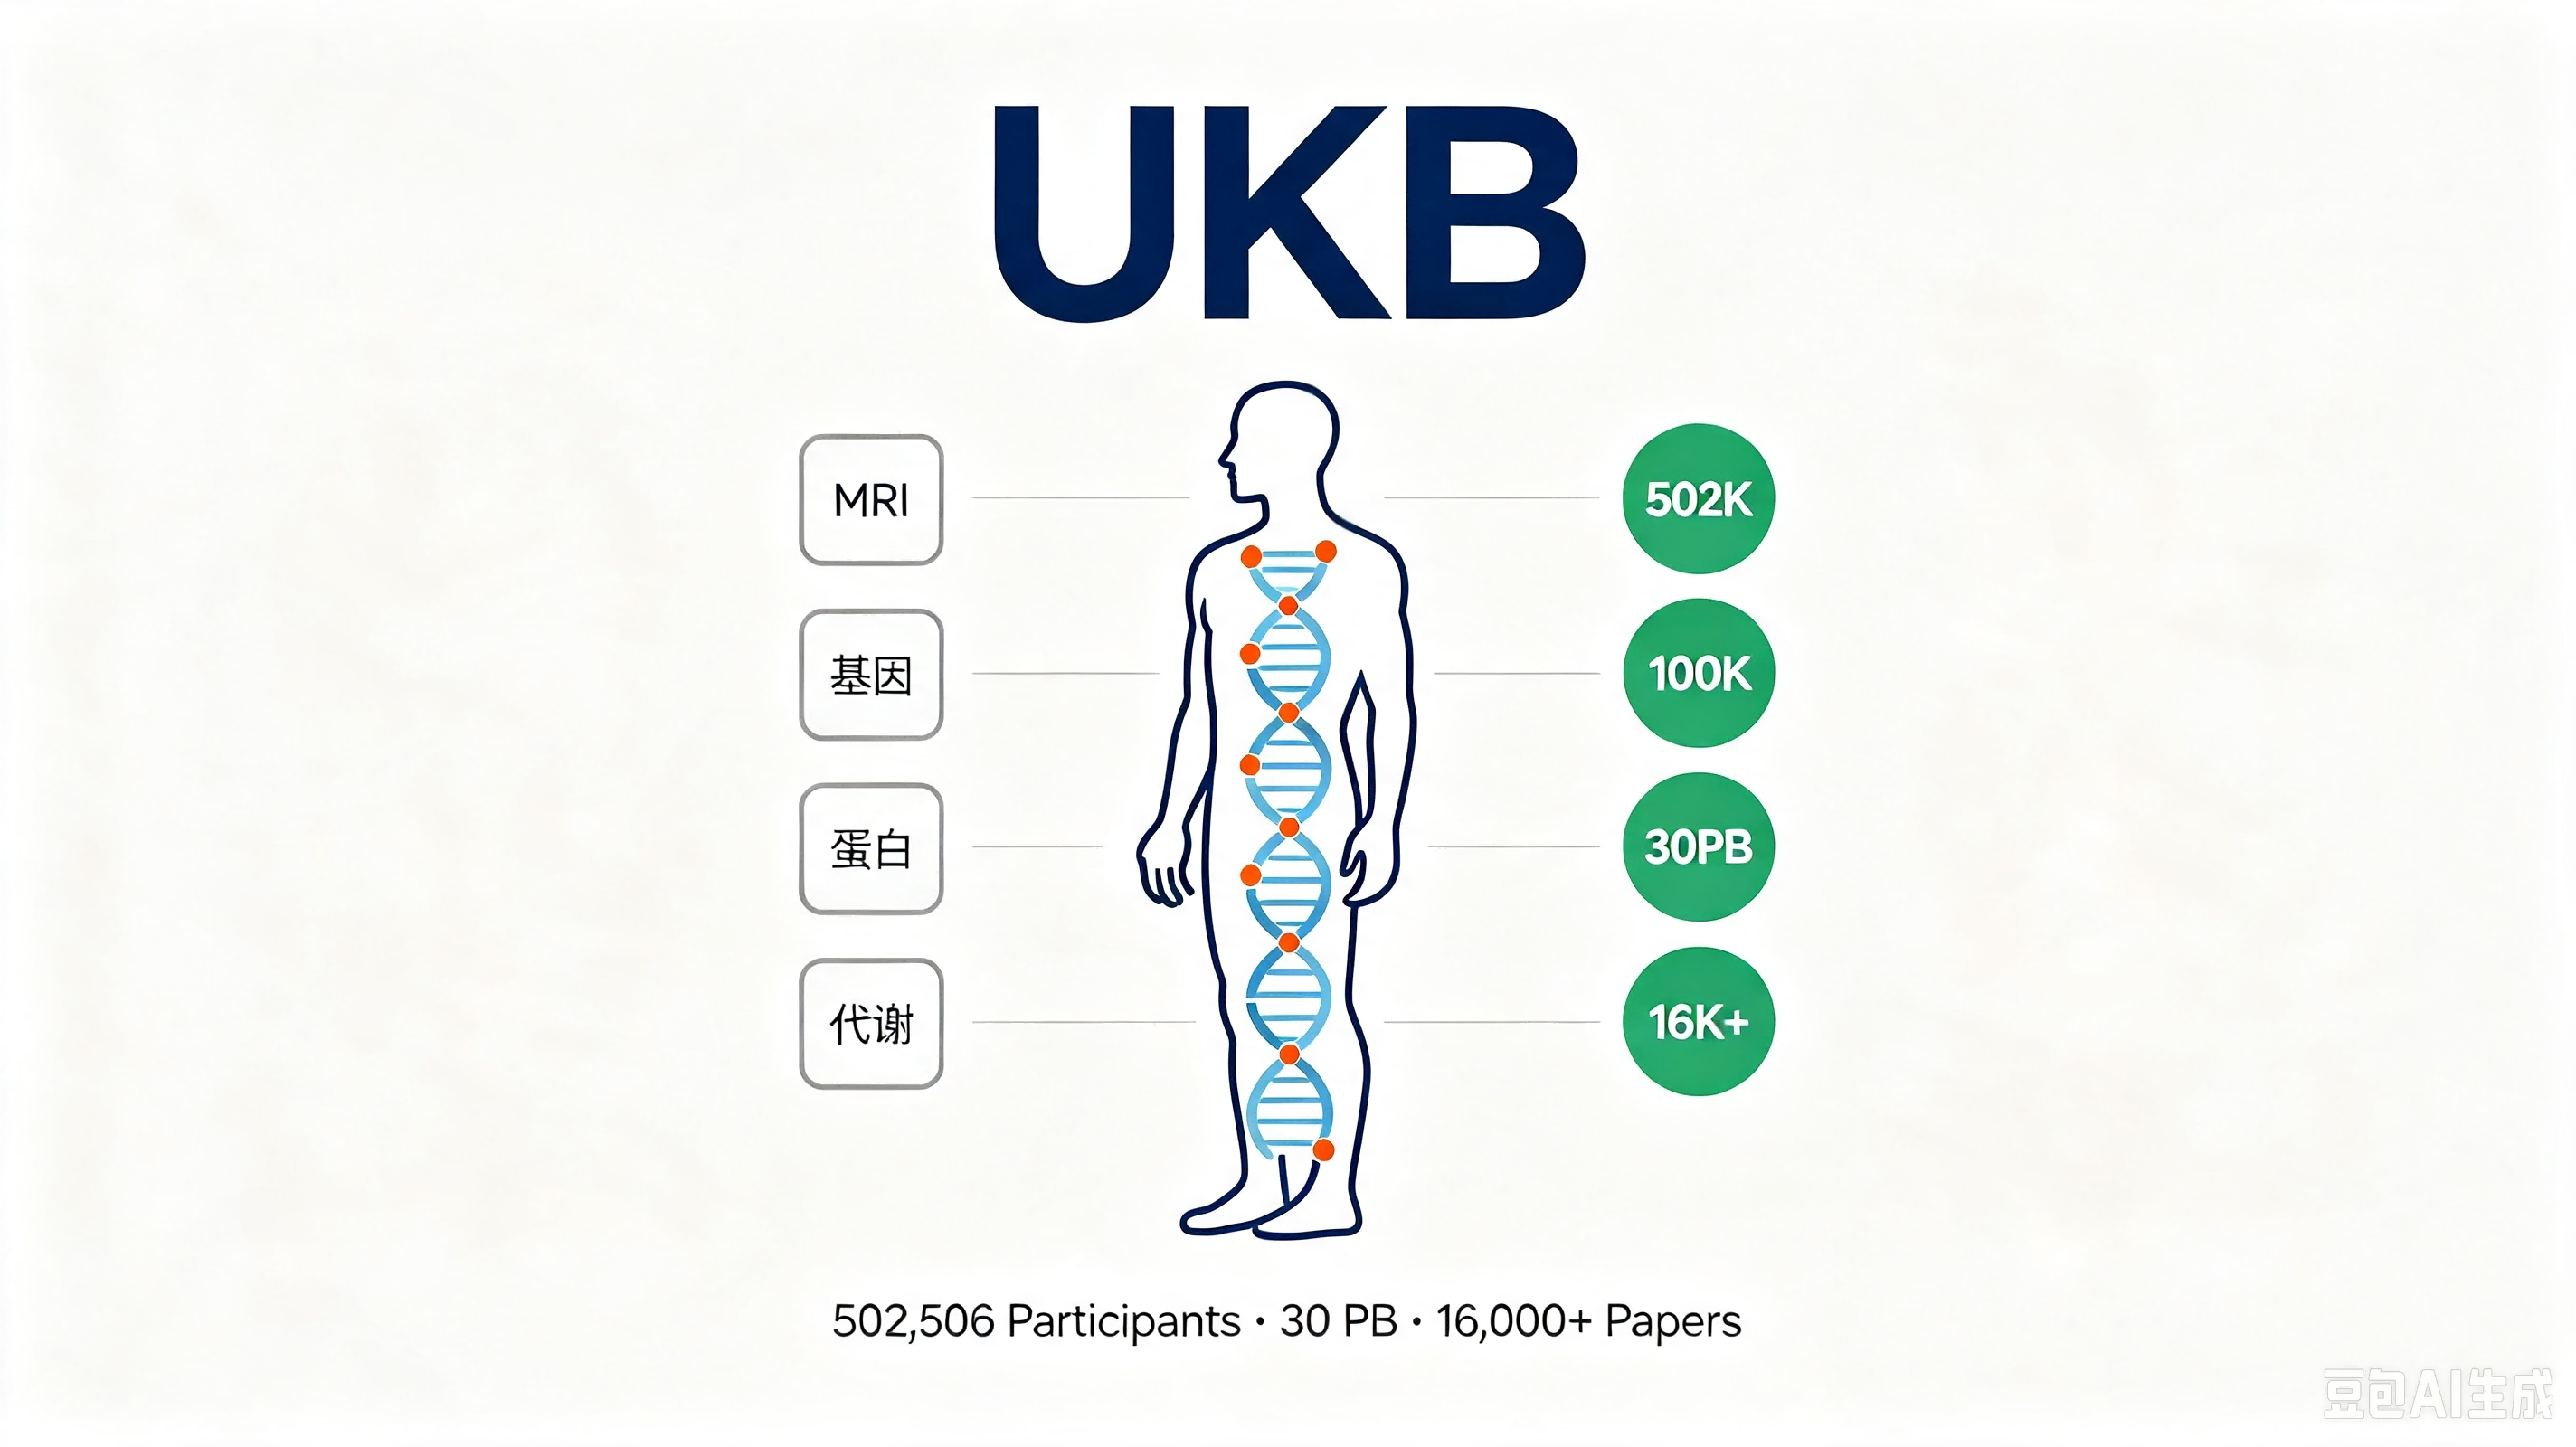
INFOBOX
| 字段 | 值 |
|---|---|
| 数据集名称 | UK Biobank |
| 简称 | UKB |
| 类型 | 前瞻性人口健康队列 |
| 参与者数 | 502,506 人(招募时 40-69 岁) |
| 招募时间 | 2006-2010 年 |
| 招募地点 | 英国 22 个评估中心(英格兰、威尔士、苏格兰) |
| 性别比 | 54% 女性 / 46% 男性 |
| 族裔构成 | 94.6% 白人(反映 2001 年英国人口普查) |
| 影像子集 | 100,000 人(脑/心/腹 MRI + DXA + 超声 + OCT,2014-2025) |
| 基因组 | 基因分型 488K+ / WES ~470K / WGS ~490K |
| 蛋白质组 | 54,000 人(Olink ~3,000 蛋白,扩展至 500K) |
| 代谢组 | ~280,000 人可用(NMR 249 代谢物,已测 ~488K) |
| 变量数/人 | ~10,000 |
| 数据总量 | ~30 PB(持续增长,预计 40+ PB) |
| ICD-11 映射 | 全疾病谱覆盖(心血管/肿瘤/代谢/神经退行性/精神健康) |
| SNOMED CT | 全临床概念覆盖(通过 EHR 链接) |
| 许可证 | UK Biobank Data Access Agreement(自定义,MTA v1.4) |
| 访问方式 | UKB-RAP 云平台(AWS + DNAnexus),2024 年起仅限云端 |
| 访问费用 | £3,000-£9,000 / 3 年(按数据层级分级) |
| 研究者数 | 21,000+(60+ 国家) |
| 论文数 | 16,000+ 同行评审 |
| DAIMS 评分 | 22/24(91.7%)⭐⭐⭐⭐⭐ |
| 核心机构 | UK Biobank Limited(PI: Prof. Sir Rory Collins) |
| 首席科学家 | Prof. Naomi Allen |
| 核心基金 | Wellcome / MRC / CRUK / BHF / NIHR(至 2029 年) |
| 数据发布 | 2012-03(首次)→ 持续更新(最新 2025-11) |
| 官方 URL | https://www.ukbiobank.ac.uk/ |
§0 E-E-A-T 信任声明与免责声明
信任维度
| 维度 | 声明 |
|---|---|
| 经验性 (Experience) | UK Biobank 自 2006 年启动,已运营近 20 年,积累了全球最大规模的前瞻性人口健康队列数据管理经验。21,000+ 研究者的使用反馈持续驱动数据质量和平台改进。 |
| 专业性 (Expertise) | 由 UK Biobank Limited 运营,PI 为 Professor Sir Rory Collins(牛津大学流行病学教授)。脑影像处理由牛津大学 FMRIB/WIN 中心(Stephen Smith, Karla Miller, Fidel Alfaro-Almagro)负责。基因组分析由 Wellcome Sanger Institute 和 Decode Genetics 执行。首席科学家 Professor Naomi Allen(牛津大学流行病学)。100+ 全职科研和运营人员。 |
| 权威性 (Authoritativeness) | 核心基金来自英国五大医学研究机构(Wellcome / MRC / CRUK / BHF / NIHR)。基础设施基金 £127.6M 来自 UKRI。发表于 Nature(Bycroft et al. 2018)、PLOS Medicine(Sudlow et al. 2015)、Nature Neuroscience(Miller et al. 2016)、Neuroimage(Alfaro-Almagro et al. 2018)等顶级期刊。获英国政府、皇家学会、下议院高度认可。 |
| 可信性 (Trustworthiness) | 数据采集遵循 NHS 伦理审批,参与者签署电子知情同意书。数据通过 UKB-RAP 安全云平台提供,禁止重识别参与者。独立伦理咨询委员会和参与者咨询小组监督。年度审计和外部合规检查。Access Committee 审查每个研究申请。 |
| 透明性 (Transparency) | 数据采集协议、处理流水线、质量控制流程和发布历史均公开可查。UK Biobank Community 论坛公开讨论技术问题。所有数据字段在 Showcase 浏览器中可查(含编码、单位、描述)。Brain Imaging Documentation(v1.10, 2024-05)等详细技术文档公开。 |
| 可追溯性 (Provenance) | 每个数据字段均有明确的采集协议文档、处理版本号和质量控制标记。影像数据按处理阶段分为 raw DICOM → NIFTI → IDPs,每个阶段有独立的 QC。基因组数据版本追踪到 imputation panel 和 variant calling pipeline。数据发布历史完整记录(2012-03 至 2025-11)。 |
审核机制
[千方病案医学编辑部]交叉审核:本条目的医学背景(§2)、数据规格(§3)、质量评估(§7)和 AI 就绪指南(§6)由编辑部交叉审核,确保技术描述与 UK Biobank 官方文档(Brain Imaging Documentation v1.10, Bycroft et al. 2018, Alfaro-Almagro et al. 2018)及已发表同行评审论文一致。
免责声明
本条目为 AI-Ready 数据集百科条目,旨在为 AI/ML 研究者提供 UK Biobank 数据集的结构化技术参考。所有数据描述基于 UK Biobank 官方文档和已发表文献。UK Biobank 数据访问需通过正式申请流程,本条目不构成数据访问授权。医疗决策不应基于本条目内容。基因风险评分等 AI 模型的临床应用需经过独立验证和监管审批。
§1 数据集概览
§1.0 30 秒速览
UK Biobank 是什么? 全球最大规模的前瞻性人口健康队列研究之一,跟踪 502,506 名英国志愿者的终身健康轨迹。
为什么重要? 将基因组、蛋白质组、代谢组、多模态影像、加速度计、电子健康记录在同一人群中深度整合,是 AI 疾病预测、药物靶点发现和因果推断的终极资源。
核心数据规模:
- 502,506 人 × ~10,000 变量/人 = ~50 亿数据点
- 100,000 人完成多模态影像扫描(脑/心/腹 MRI + DXA + 超声 + OCT)
- ~490,000 人完成全基因组测序(全球最大 WGS 数据集)
- ~470,000 人完成全外显子测序
- 54,000 人完成蛋白质组学(Olink ~3,000 蛋白)
- ~280,000 人代谢组学数据可用(NMR 249 代谢物)
- ~30 PB 总数据量
谁在用? 21,000+ 研者(60+ 国家),16,000+ 篇同行评审论文。
AI 就绪度: DAIMS 22/24(91.7%)⭐⭐⭐⭐⭐
§1.1 摘要
UK Biobank 是一项大型前瞻性队列研究,于 2006-2010 年间从英国 22 个评估中心招募了 502,506 名年龄 40-69 岁的参与者(响应率 5.5%,920 万人受邀)。基线评估涵盖触屏问卷(生活方式、人口统计、病史)、体格检查(血压、人体测量、握力、肺量测定、ECG、动脉硬度)、认知测试、眼科检查、听力测试和生物样本采集(血液 10 管、尿液、唾液)。队列设计强调深度表型化和终身随访:每位参与者约 10,000 个变量,通过电子健康记录链接(住院数据 HES、癌症登记、死亡登记、初级保健 GP 数据)实现疾病结局追踪。
UK Biobank 的核心差异化在于多组学+多模态影像的纵向整合:
-
基因组:Affymetrix UK Biobank Axiom + BiLEVE Axiom 芯片基因分型(~830K SNP,488K+ 参与者),IMPUTE2+SHAPEIT3 插补至 ~96M 变异位点;Illumina NovaSeq 全外显子测序(WES, ~470K 参与者)和全基因组测序(WGS, ~490K 参与者),由 Decode Genetics 和 Wellcome Sanger Institute 完成,是全球最大 WGS 数据集。
-
蛋白质组:Olink Explore 平台测量 ~3,000 种血浆蛋白(NPX 值),当前 54,000 人已完成,正扩展至全部 500,000 人(目标 5,400 蛋白),已发现 14,000+ 蛋白-基因变异关联。
-
代谢组:Nightingale Health NMR 平台测量 249 种代谢物(脂蛋白脂质 14 亚类、脂肪酸、氨基酸、酮体、糖酵解产物),~280,000 人数据已公开,~488,000 人已测量(2025 年底全量发布)。
-
多模态影像(2014-2025,100,000 人已完成):
- 脑 MRI:Siemens Skyra 3T,32 通道头线圈,35 分钟协议。T1(3D MPRAGE, 1mm 各向同性, TR=2000ms, TE=2.01ms, TI=880ms, FA=8°)、T2-FLAIR、SWI、dMRI(100 方向, 2 壳层 b=1000/2000)、rfMRI(~6 min, TR=690ms)、tfMRI(Hariri 面孔/形状情绪任务)、ASL。
- 心脏 MRI:1.5T Siemens,20 分钟协议。cine(长/短轴)、shMOLLI T1 mapping、主动脉可扩张性、血流。
- 腹部 MRI:1.5T Siemens。肝脏脂肪百分比/铁、内脏/皮下脂肪、肾/肝/胰体积。
- DXA:全身骨密度和身体成分。
- 颈动脉超声:内中膜厚度、斑块。
- 视网膜 OCT + 彩色眼底照相:视网膜层厚度、视盘参数。
-
加速度计:100,000 名参与者佩戴腕部三轴加速度计 7 天(2013-2014),另有 2,500 人季节性重复测量。
-
在线问卷:200 万+ 份完成,涵盖饮食(24 小时回忆 ×5)、认知功能、工作环境、心理健康、睡眠等。
-
环境数据:空气污染、噪声污染、绿地面积等基于居住地址的衍生数据。
影像处理流水线由牛津大学 FMRIB/WIN 中心开发(Alfaro-Almagro et al. 2018),基于 FSL 和 FreeSurfer,自动生成数千个影像衍生表型(IDPs)——如 T1 的区域灰质体积、T2-FLAIR 的白质高信号体积、dMRI 的各向异性分数、rfMRI 的功能连接矩阵、tfMRI 的任务激活信号等。PANDORA(Population Archive of Neuroimaging Data Organised for Rapid Analysis)提供 82,000 人的预处理脑影像体素级和超体素级数据。
数据通过 UKB-RAP(UK Biobank Research Analysis Platform)安全云平台提供访问,由 DNAnexus 开发、AWS 托管(伦敦区域)。2024 年起,数据仅限云端分析(不再支持批量下载),内置 JupyterLab、RStudio、Apache Spark、HAIL、Nvidia Parabricks 等工具。21,000+ 研究者在 60+ 国家使用 UK Biobank 数据,已发表 16,000+ 篇同行评审论文,涵盖心血管疾病、癌症、2 型糖尿病、阿尔茨海默病、帕金森病等重大慢病。
§1.2 为什么重要
| 维度 | 说明 |
|---|---|
| 规模 | 502,506 人是迄今为止最大规模的单国人口健康队列之一(仅次于中国 Kadoorie Biobank 的 512K),为罕见病和低频等位基因分析提供统计功效 |
| 深度 | ~10,000 变量/人,跨越基因组→蛋白质组→代谢组→影像→行为→环境→EHR 全链路,支持多组学整合分析和因果推断 |
| WGS | ~490,000 人全基因组测序是全球最大 WGS 数据集,覆盖罕见变异和非编码区,超越基因分型插补的局限 |
| 影像 | 100,000 人多模态影像(脑+心+腹+骨+血管+眼)是全球最大影像队列,10 亿+ 张图像 |
| 蛋白质组 | 54,000 人 → 500,000 人 Olink 蛋白质组学是全球最大蛋白质组队列,5,400 蛋白 × 50 万人 |
| 纵向 | 基线(2006-2010)→ 重复评估 → 影像(2014-2025)→ 重复影像(60K 规划中)→ EHR 终身随访,支持疾病进展建模 |
| 开放性 | 全球研究者可申请访问(不限国籍),£3K-£9K 覆盖成本,LMIC 研究者免费,AWS 信用额度支持 ECR |
| AI 基准 | 脑年龄预测 MAE 2.30 年(NeuroAgeFusionNet 2025)、PRS 12/30 模型 AUC >80%、痴呆预测 AUROC 0.90 |
| 药物发现 | 14,000+ 蛋白-基因关联为药物靶点提供遗传学验证;蛋白质风险评分(ProteinScore)在 2 型糖尿病中超越 PRS + HbA1c |
| 因果推断 | 孟德尔随机化(MR)分析的金标准数据集,基因变异作为工具变量评估暴露-结局因果关系 |
§1.3 对比表
| 数据集 | 参与者数 | 核心模态 | 基因组 | 影像 | 蛋白质组 | 纵向随访 | 开放度 |
|---|---|---|---|---|---|---|---|
| UK Biobank | 502K | 全模态 | WGS 490K | 100K (脑+心+腹+骨+眼) | 54K→500K | 终身 EHR | 审批制 |
| HCP | 1,206 | 脑 MRI | 1,142 基因分型 | 1,206 脑 MRI | ❌ | ❌ | 开放 |
| ADNI | ~2,000 | 脑 MRI/PET | ~2,000 WGS | ~2,000 | ❌ | 纵向 | 审批制 |
| China Kadoorie | 512K | 问卷+体检 | 100K 基因分型 | ❌ | ❌ | EHR | 审批制 |
| All of Us (US) | 1M+ | 问卷+EHR+基因 | 1M+ WGS | 部分 | 部分 | EHR | 审批制 |
| FinnGen | 500K | EHR+基因 | 500K WGS | ❌ | ❌ | EHR | 审批制 |
| MIMIC-IV | ~300K | EHR | ❌ | ❌ | 部分 | 住院 | 开放 |
| SEER | ~10M | 癌症登记 | ❌ | ❌ | ❌ | 纵向 | 开放 |
§1.4 时间轴
| 时间 | 事件 |
|---|---|
| 2003 | UK Biobank 概念提出,由 Wellcome 和 MRC 资助启动 |
| 2006-03 | 首批评估中心开放,开始招募参与者 |
| 2010-07 | 招募完成,502,506 人入组 |
| 2012-03 | 首批基线数据发布(Showcase 上线) |
| 2013-2014 | 100,000 人加速度计数据采集(7 天腕部佩戴) |
| 2014 | 多模态影像子研究启动(4 个影像中心) |
| 2015-05 | 150,000 人基因分型数据首批发布(Bycroft et al. 2018 基础) |
| 2015-06 | Sudlow et al. 队列概况论文发表(PLOS Med) |
| 2016-11 | Miller et al. 脑 MRI 协议论文发表(Nat Neurosci) |
| 2017-06 | Fry et al. 健康志愿者偏倚分析发表(Am J Epidemiol) |
| 2018-10 | Bycroft et al. 全队列基因分型+插补论文发表(Nature 562:203-209) |
| 2018-10 | Elliott et al. 脑影像表型 GWAS 论文发表(Nature 562:210-216) |
| 2018-10 | Alfaro-Almagro et al. 脑影像处理流水线论文发表(Neuroimage 166:400-424) |
| 2019 | 50,000 人全基因组测序试点(Vanguard)完成 |
| 2021-07 | UKB-RAP 云平台正式上线(DNAnexus + AWS) |
| 2021 | 200,000 人 WGS 数据首次发布 |
| 2023-05 | £127.6M UKRI 基础设施基金获批,新 Manchester 设施 |
| 2023-11 | 500,000 人 WGS 数据完成(全球最大 WGS 数据集) |
| 2024-04 | UKB-RAP 成为默认数据访问方式(停止批量下载) |
| 2024-06 | Global Researcher Access Fund 启动(LMIC 研究者免费) |
| 2025-01 | 停止接受保险公司直接数据访问申请 |
| 2025-07 | 100,000 人影像扫描里程碑达成 |
| 2025-11 | 最新数据发布:PANDORA 脑影像、心脏 IDP 80K、DXA 骨骼测量、代谢组全量扩展 |
§1.5 用例
-
多基因风险评分(PRS):UKB PRS Release 提供 28 种疾病 + 25 种定量性状的预计算 PRS,Thompson et al. 2024 评估其优于 76 种已发表 PRS。冠心病 PRS 识别的真阳性事件是罕见致病变异的 55-80 倍。
-
脑年龄预测:T1 结构 MRI 训练深度学习模型预测脑生物学年龄,NeuroAgeFusionNet(CNN+Transformer+GNN, 2025)在 UKB 上达到 MAE 2.30 年。脑年龄差(BAG)每增加 1 年,阿尔茨海默病风险增加 16.5%,全因死亡率增加 12%。
-
蛋白质组学疾病预测:Gadd et al. 2024(Nat Aging)测试 1,468 种 Olink 蛋白与 23 种年龄相关疾病的关联,开发 ProteinScore,2 型糖尿病 ProteinScore 超越 PRS 和 HbA1c。
-
药物靶点发现:14,000+ 蛋白-基因变异关联为药物靶点提供遗传学验证。MILTON 模型(AstraZeneca, ASHG 2024)整合 Olink 蛋白质组学大幅提升疾病预测性能。
-
孟德尔随机化:基因变异作为工具变量,评估饮食、血压、炎症因子等暴露与神经退行性疾病、心血管疾病等的因果关系,超越传统观察性研究的混杂偏倚。
-
多组学整合:蛋白质组+代谢组+基因组联合模型在 2 型糖尿病心血管风险预测中达到 C-index 0.848(2025),显著优于传统 SCORE2-Diabetes 模型。
§2 医学背景
§2.1 人口健康队列与多组学整合概念
UK Biobank 的设计理念源于**队列研究(cohort study)方法学:招募一大群健康个体,测量基线暴露因素,通过长期随访观察谁患病、谁保持健康,从而推断暴露-疾病关联。UK Biobank 的独特贡献在于将传统队列研究的"广度"(50 万人)与多组学时代的"深度"(基因组+蛋白质组+代谢组+影像+EHR)相结合,创建了前所未有的深度表型化(deep phenotyping)**资源。
ICD-11 疾病映射(通过 EHR 链接覆盖全疾病谱):
| 疾病类别 | ICD-11 编码范围 | UKB 优势 |
|---|---|---|
| 缺血性心脏病 | BA40-BA6Z | 10 万+ 心脏 MRI + PRS + 蛋白质组 |
| 痴呆(含阿尔茨海默病) | 8A00-8A8Z | 脑 MRI IDPs + WGS + 认知测试纵向 |
| 2 型糖尿病 | 5A11 | 代谢组 + 蛋白质组 + HbA1c + EHR |
| 癌症(多部位) | 2A00-2F9Z | 癌症登记 + WGS + 生活方式 |
| 卒中 | 8B00-8B0Z | 脑 MRI + 心脏 MRI + PRS |
| 骨关节炎 | FA00-FB8Z | DXA + 影像 + 加速度计 |
| 慢性肾病 | GB60-GB6Z | 血液生化 + 蛋白质组 |
| 精神健康障碍 | 6A00-6E60 | 认知测试 + 脑 MRI + WGS + 问卷 |
| 帕金森病 | 8A00.0 | 脑 MRI SWI 铁含量 + WGS |
| 骨质疏松 | FB83 | DXA + WGS |
SNOMED CT 概念覆盖:通过 HES(Hospital Episode Statistics)住院记录、癌症登记、死亡登记和初级保健(GP)记录链接,覆盖全 SNOMED CT 临床概念体系,包括诊断编码、操作编码、处方药物等。
§2.2 多模态影像的临床意义
| 模态 | 临床应用 | UKB 规模 |
|---|---|---|
| 脑 T1 MRI | 区域脑体积萎缩、皮层厚度 → 痴呆/帕金森早期标志 | ~90K |
| 脑 T2-FLAIR | 白质高信号 → 脑小血管病、卒中风险 | ~90K |
| 脑 SWI | 铁沉积 → 帕金森病、微出血 | ~90K |
| 脑 dMRI | 白质完整性 → 神经退行性病变、认知衰退 | ~90K |
| 脑 rfMRI | 功能连接 → 神经精神疾病网络异常 | ~90K |
| 脑 tfMRI | 情绪处理回路 → 抑郁/焦虑 | ~90K |
| 脑 ASL | 脑血流灌注 → 痴呆/卒中 | ~90K |
| 心脏 MRI | 左室质量/射血分数/主动脉硬度 → 心血管风险 | ~81K |
| 腹部 MRI | 肝脏脂肪/铁/内脏脂肪 → 代谢综合征 | ~40K |
| DXA | 骨密度/身体成分 → 骨质疏松/肌少症 | ~70K |
| 颈动脉超声 | 内中膜厚度/斑块 → 动脉粥样硬化 | ~50K |
| 视网膜 OCT | 视网膜层厚度 → 眼科/系统性疾病标志 | ~35K |
§2.3 3T vs 1.5T 扫描仪技术对比
| 参数 | 脑 MRI (3T Siemens Skyra) | 心脏/腹部 MRI (1.5T Siemens) |
|---|---|---|
| 场强 | 3 Tesla | 1.5 Tesla |
| 头线圈 | 32 通道 | N/A(体线圈) |
| T1 序列 | 3D MPRAGE, 1mm 各向同性 | shMOLLI T1 mapping |
| TR/TE/TI | 2000/2.01/880 ms | varies |
| 翻转角 | 8° | varies |
| dMRI | 100 方向, 2 壳层 (b=1000/2000) | N/A |
| rfMRI | TR=690ms, ~6 min | N/A |
| 协议时长 | 35 min | 20 min (心脏) + 10 min (腹部) |
| IDP 数量 | ~3,000+ | ~100+ (心脏) / ~40+ (腹部) |
§2.4 临床与转化意义
-
精准医学:PRS + 蛋白质组 + 代谢组的整合风险分层模型,超越单一基因组预测,向临床级精准预防迈进。
-
药物靶点验证:WGS + 蛋白质组的遗传学关联为药物靶点提供因果证据(孟德尔随机化),14,000+ 蛋白-基因关联中 80% 为新发现。
-
疾病早期检测:脑 MRI IDPs + 蛋白质组在痴呆诊断前 10+ 年即可检测到变化(2024 年研究显示血液蛋白预测痴呆提前 10 年)。
-
公共卫生政策:加速度计物理活动数据、环境暴露数据为人群级别健康干预提供证据基础。
-
AI 医疗基础设施:UKB-RAP 云平台、100,000 人标准化影像流水线和 PANDORA 预处理数据为大规模医疗 AI 研究提供了可复现的基础设施。
§3 数据集规格
§3.0 版本总览
| 版本/里程碑 | 日期 | 核心内容 | 参与者数 | 数据量 |
|---|---|---|---|---|
| 基线数据首发 | 2012-03 | 问卷+体检+生化+血常规 | 502,506 | ~1 TB |
| 基因分型首发 | 2015-05 | 150K Affymetrix 基因分型 | 150,000 | ~50 GB |
| 全队列基因分型 | 2017-05 | 488K 基因分型 + 96M 插补 | 488,000 | ~2 TB |
| 影像首发 | 2016-10 | 首批 ~5,000 人脑 MRI IDPs | ~5,000 | ~5 TB |
| WES 首发 | 2019 | 50K 全外显子测序 | 50,000 | ~2 TB |
| UKB-RAP 上线 | 2021-07 | 云平台访问 | — | — |
| WGS 200K | 2021 | 200,000 人全基因组测序 | 200,000 | ~20 TB |
| WGS 500K | 2023-11 | 全队列 WGS 完成 | ~490,000 | ~50 TB |
| 平台专属访问 | 2024-04 | 停止批量下载 | — | — |
| 蛋白质组首发 | 2023 | 54K Olink ~3,000 蛋白 | 54,000 | ~500 GB |
| 100K 影像里程碑 | 2025-07 | 100,000 人影像完成 | 100,000 | ~10 TB IDPs |
| 代谢组全量 | 2025-11 | ~488K NMR 249 代谢物 | ~488,000 | ~1 TB |
§3.1 数据来源
| 来源机构 | 角色 | URL |
|---|---|---|
| UK Biobank Limited | 数据采集、管理、分发 | https://www.ukbiobank.ac.uk/ |
| 牛津大学 FMRIB/WIN | 脑影像处理流水线 | https://www.win.ox.ac.uk/ |
| Wellcome Sanger Institute | WGS 测序 | https://www.sanger.ac.uk/ |
| Decode Genetics | WGS 测序 | https://www.decode.com/ |
| Affymetrix/Thermo Fisher | 基因分型芯片 | https://www.thermofisher.com/ |
| Olink Proteomics | 蛋白质组学平台 | https://www.olink.com/ |
| Nightingale Health | 代谢组学 NMR 平台 | https://nightingalehealth.com/ |
| Siemens Healthineers | MRI 扫描仪 | https://www.siemens-healthineers.com/ |
| DNAnexus | UKB-RAP 平台技术 | https://www.dnanexus.com/ |
| Amazon Web Services | 云计算基础设施 | https://aws.amazon.com/ |
§3.2 样本统计
| 统计项 | 值 |
|---|---|
| 总参与者数 | 502,506 |
| 招募响应率 | 5.5%(920 万受邀) |
| 性别 | 54% 女性 / 46% 男性 |
| 招募年龄 | 40-69 岁(24% 40-49, 34% 50-59, 42% 60-69) |
| 当前年龄(2026) | ~56-85+ 岁 |
| 族裔 | 94.6% 白人;~10,000 南亚裔;~10,000 非洲裔 |
| 出生地 | 41,000+ 出生于英国以外 |
| 城市化 | 86% 城市居民 |
| 健康志愿者偏倚 | 参与者比一般人群更健康、更富裕、肥胖率/吸烟率更低 |
| 死亡率差异 | 70-74 岁男性全因死亡率比一般人群低 46.2%,女性低 55.5% |
| 影像子集 | 100,000 人(已完成扫描) |
| WGS 子集 | ~490,000 人 |
| WES 子集 | ~470,000 人 |
| 蛋白质组子集 | 54,000 人(目标 500,000 人) |
| 加速度计子集 | 100,000 人 |
| 重复影像 | 规划 60,000 人 |
§3.3 数据格式与大小
| 数据类别 | 格式 | 大小/参与者 | 总大小 | 参与者数 |
|---|---|---|---|---|
| 基线问卷+体检 | CSV (Showcase) | ~100 KB | ~50 GB | 502,506 |
| 血液生化+血常规 | CSV | ~50 KB | ~25 GB | 502,506 |
| 基因分型+插补 | BGEN/PLINK | ~5 GB | ~2.5 TB | 488,000+ |
| WES | VCF/CRAM | ~10 GB | ~4.7 TB | ~470,000 |
| WGS | VCF/CRAM | ~100 GB | ~49 TB | ~490,000 |
| 脑 MRI DICOM | DICOM (zip) | ~2 GB | ~200 TB | 100,000 |
| 脑 MRI NIFTI (processed) | NIFTI | ~1 GB | ~100 TB | 100,000 |
| 脑 IDPs | CSV | ~1 MB | ~100 GB | ~90,000 |
| PANDORA (preprocessed) | NIFTI | ~5 GB | ~500 TB | 82,000 |
| 心脏 MRI | DICOM + IDPs | ~500 MB | ~50 TB | ~81,000 |
| 腹部 MRI | DICOM + IDPs | ~500 MB | ~20 TB | ~40,000 |
| DXA | DICOM + IDPs | ~100 MB | ~7 TB | ~70,000 |
| 蛋白质组 | CSV (NPX) | ~100 KB | ~5 GB | 54,000 |
| 代谢组 | CSV | ~50 KB | ~14 GB | ~280,000 |
| 加速度计 | CWA/CSV | ~500 MB | ~50 GB | 100,000 |
| HES/EHR 链接 | CSV | ~10 KB | ~5 GB | 502,506 |
| 总计 | — | — | ~30+ PB | 502,506 |
§3.4 预处理流水线
┌─────────────────────────────────────────────────────────────────┐
│                  UK Biobank 脑影像处理流水线                      │
│              (Oxford FMRIB/WIN, Alfaro-Almagro et al. 2018)      │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  [扫描仪原始数据]                                                 │
│       │                                                         │
│       ▼                                                         │
│  k-space → 重建 → DICOM                                         │
│       │                                                         │
│       ▼                                                         │
│  DICOM → NIFTI 转换 (dcm2niix)                                  │
│       │                                                         │
│       ▼                                                         │
│  T1/T2 defacing (移除面部特征,保护匿名性)                        │
│       │                                                         │
│       ├──→ T1 处理:                                              │
│       │    梯度畸变校正 → FSL FAST 分割 → FreeSurfer 表面重建     │
│       │    → 区域体积 IDPs (~3,000 个)                           │
│       │                                                         │
│       ├──→ T2-FLAIR 处理:                                        │
│       │    B0 场图校正 → 白质高信号分割 → WMH 体积 IDP            │
│       │                                                         │
│       ├──→ SWI 处理:                                             │
│       │    相位/幅值分离 → 铁定量映射 → QSM                      │
│       │                                                         │
│       ├──→ dMRI 处理:                                            │
│       │    涡流+运动校正 (FSL EDDY) → 偏置场校正                  │
│       │    → DTI 拟合 (FA/MD) → TBSS → 概率纤维追踪               │
│       │                                                         │
│       ├──→ rfMRI 处理:                                           │
│       │    运动/呼吸校正 → ICA+FIX 去噪 → 配准 (MNI152)          │
│       │    → 功能连接矩阵 → 静息态网络分解 (ICA)                   │
│       │                                                         │
│       ├──→ tfMRI 处理:                                           │
│       │    Hariri 面孔/形状任务 → GLM 激活图 → 情绪处理 IDP       │
│       │                                                         │
│       └──→ ASL 处理:                                             │
│            灌注定量 → 脑血流量 (CBF) IDP                          │
│                                                                 │
│  [PANDORA: 82,000 人体素级+超体素级预处理数据]                     │
│  [IDP: ~3,000+ 影像衍生表型 / 人]                                  │
│                                                                 │
│  QC: 自动化质量检查 + 人工抽样复查                                  │
│  版本: 协议 Phase 1-8 (兼容性矩阵见 §6.5 坑点 #8)                  │
└─────────────────────────────────────────────────────────────────┘
§3.5 许可证
| 类型 | 描述 |
|---|---|
| UK Biobank Data Access Agreement (MTA v1.4) | 自定义许可。研究者必须:(1) 通过 AMS 注册并被批准为 bona fide researcher;(2) 研究为健康相关且符合公共利益;(3) 签署 MTA v1.4(2023-10);(4) 不可尝试重识别参与者;(5) 不可与非项目协作者共享数据;(6) 项目完成后删除下载的数据(2024 前下载的);(7) 提交年度报告;(8) 发表论文时致谢 UK Biobank |
| 数据访问方式 | 仅限 UKB-RAP 云平台(2024 年起),不再支持批量下载个体数据 |
| 费用 | £3,000-£9,000 / 3 年(按数据层级分级) |
| 免费政策 | Global Researcher Access Fund(LMIC 研究者免费);AWS 信用额度最高 $500K/yr(ECR/LMIC);所有研究者 £40 免费额度 |
| 禁止事项 | 禁止保险公司直接访问(2025-01 起);禁止识别参与者;禁止与非协作者共享个体数据 |
| 衍生数据 | 研究者产生的衍生数据须在 9 个月后返回 UK Biobank 供其他研究者使用 |
§3.6 基金
| 基金来源 | 金额 | 用途 |
|---|---|---|
| 核心基金 (Wellcome / MRC / CRUK / BHF / NIHR) | £180M+ | 参与者招募、数据管理、EHR 链接、资源开放(至 2029) |
| UKRI 基础设施基金 | £127.6M | 新 Manchester Science Park 设施 |
| WGS 基金 (UKRI / Wellcome / Amgen / AstraZeneca / GSK / J&J) | — | 500K 全基因组测序 |
| 影像基金 (Wellcome / MRC / BHF / Dementias Platform UK) | — | 100K 多模态影像 |
| 重复影像基金 (MRC / Chan Zuckerberg Initiative / Calico) | — | 60K 重复影像 |
| 蛋白质组基金 (UK Government Industrial Strategy) | £20M | 500K 全队列蛋白质组学 |
| 慈善基金 (Eric Schmidt / Ken Griffin / AWS) | £32M (£16M+£16M matched) | 运营支持 |
| UKB-RAP 基金 (Wellcome) | — | 云平台建设 |
§3.7 溯源链
参与者知情同意 (NHS 伦理审批)
    │
    ▼
22 评估中心基线采集 (2006-2010)
    ├── 触屏问卷 → Showcase 字段编码 (Field ID)
    ├── 体格测量 → Showcase 物理测量字段
    ├── 血液/尿液/唾液 → -80°C 冻存 (Stockport)
    └── 知情同意书 → 电子签名存档
         │
         ▼
    样本分析
    ├── 血液生化 → Nightingale/Severn 实验室 → 34 markers
    ├── 基因分型 → Affymetrix → 830K SNPs → IMPUTE2 插补 → 96M
    ├── WES → Illumina NovaSeq → Decode/Sanger → VCF
    ├── WGS → Illumina NovaSeq → Decode/Sanger → VCF
    ├── 蛋白质组 → Olink Explore → NPX 值
    └── 代谢组 → Nightingale NMR → 249 metabolites
         │
         ▼
    影像子研究 (2014-2025, 4 中心)
    ├── Siemens Skyra 3T (脑 MRI) → DICOM → Oxford 流水线 → NIFTI + IDPs
    ├── 1.5T Siemens (心/腹 MRI) → DICOM → ML IDPs
    ├── DXA → DICOM → 骨骼/身体成分 IDPs
    ├── 超声 → DICOM → 内中膜 IDPs
    └── OCT → DICOM → 视网膜特征 IDPs
         │
         ▼
    EHR 链接 (终身随访)
    ├── HES (住院) → ICD-10/ICD-11 + OPCS-4
    ├── 癌症登记 → ICD-O-3
    ├── 死亡登记 → ICD-10 死因
    └── GP (初级保健) → SNOMED CT (England 2025+)
         │
         ▼
    UKB-RAP 云平台 (AWS London, DNAnexus)
    ├── JupyterLab / RStudio / Apache Spark / HAIL
    ├── Table Exporter → CSV 下载 (汇总数据)
    └── Swiss Army Knife → plink/bgen 基因分析
§4 数据结构详解
§4.0 目录树
UKB-RAP Project Space/
├── bulk/                          # 大型数据文件(不可直接下载)
│   ├── Genotype Results/
│   │   ├── Genotype calls/        # PLINK bed/bim/fam (未插补)
│   │   └── UKB imputation from genotype/  # BGEN (插补后, ~96M)
│   ├── Whole Exome Sequencing/
│   │   └── (VCF/CRAM per chromosome)
│   ├── Whole Genome Sequencing/
│   │   └── (VCF/CRAM per chromosome)
│   └── Imaging/                    # 影像数据
│       ├── brain_mri_dicom/        # 脑 MRI DICOM (zip)
│       ├── brain_mri_nifti/        # 脑 MRI NIFTI (processed)
│       ├── cardiac_mri_dicom/     # 心脏 MRI DICOM
│       ├── abdominal_mri_dicom/   # 腹部 MRI DICOM
│       ├── dxa_dicom/             # DXA DICOM
│       └── carotid_ultrasound/    # 颈动脉超声 DICOM
├── app12345_.../                  # 数据集实体 (Showcase 变量)
│   ├── Population characteristics/
│   ├── Assessment centre/
│   ├── Biological samples/
│   ├── Health-related outcomes/
│   └── (其他 Showcase 类别)
├── retinal_oct/                   # 视网膜 OCT 数据
└── accelerometry/                 # 加速度计原始数据 (CWA)
§4.1 DAIMS 标准化数据字典
核心影像变量(IDPs)
| Field ID | 字段名 | 描述 | 类型 | 参与者数 |
|---|---|---|---|---|
| 21003 | age_when_attended_assessment_centre | 评估中心年龄 | int | 502,506 |
| 31 | sex | 性别 | int (0/1) | 502,506 |
| 21000 | ethnic_background | 族裔背景 | categorical | 502,506 |
| 189 | T1 brain volume | T1 全脑体积 (mm³) | float | ~90,000 |
| 190 | T1 grey matter volume | T1 灰质体积 | float | ~90,000 |
| 192 | T1 white matter volume | T1 白质体积 | float | ~90,000 |
| 193 | T1 CSF volume | T1 脑脊液体积 | float | ~90,000 |
| 25000 | T2 FLAIR WMH volume | T2 白质高信号体积 | float | ~90,000 |
| 25740-25756 | dMRI FA (TBSS) | 各向异性分数 (TBSS 骨架) | float | ~90,000 |
| 25758-25774 | dMRI MD (TBSS) | 平均扩散率 (TBSS 骨架) | float | ~90,000 |
| 25775-25791 | dMRI MO (TBSS) | 模式系数 (TBSS 骨架) | float | ~90,000 |
| 25389-25422 | rfMRI network amplitude | 静息态网络振幅 (ICA) | float | ~90,000 |
| 25423-25456 | rfMRI network connectivity | 静息态网络连接 (ICA) | float | ~90,000 |
| 25458-25739 | rfMRI connectivity (nodes) | 功能连接矩阵 (节点间) | float | ~90,000 |
| 25931 | Cardiac MRI IDPs | 心脏 MRI IDPs (83 字段) | float | ~81,000 |
| 21094 | Abdominal MRI IDPs | 腹部 MRI IDPs | float | ~40,000 |
| 20158 | DXA raw data | DXA 原始数据 | DICOM | ~70,000 |
核心基因组变量
| Field ID | 字段名 | 描述 | 类型 | 参与者数 |
|---|---|---|---|---|
| 22418 | Genotyping array | 基因分型芯片 | categorical | 488,000+ |
| 22000 | Genetic ethnic grouping | 基因族裔分组 | categorical | ~450,000 |
| 22019 | Sex chromosome aneuploidy | 性染色体异常 | categorical | 488,000+ |
| 22020 | Recommended genomic analysis exclusions | 推荐排除项 | categorical | 488,000+ |
| 22021 | Genetic kinship | 基因亲属关系 | categorical | 488,000+ |
| 22027 | Outliers for heterozygosity | 杂合性异常 | categorical | 488,000+ |
| 32050 | WES variant information | 全外显子变异 | VCF | ~470,000 |
| 32069 | WGS variant information | 全基因组变异 | VCF | ~490,000 |
| 264 | Clonal haematopoiesis (CHIP) | 克隆性造血 | categorical | 500,000 |
核心蛋白质组/代谢组变量
| Field ID | 字段名 | 描述 | 类型 | 参与者数 |
|---|---|---|---|---|
| 30800 | Olink protein levels | Olink NPX 值 (~3,000 蛋白) | float | 54,000 |
| 23474 | NMR metabolomics | NMR 代谢物 (249) | float | ~280,000 |
§4.2 7 种脑 MRI 模态详细参数
| 模态 | 序列 | 参数 | 时长 | IDP 数 |
|---|---|---|---|---|
| T1 结构像 | 3D MPRAGE | 1mm 各向同性, TR=2000ms, TE=2.01ms, TI=880ms, FA=8°, FOV=208×256×256mm | 5 min | ~3,000 |
| T2-FLAIR | 3D FLAIR | 1mm 各向同性 | 5 min | ~10 |
| SWI | Susceptibility-weighted | 3D SWI | 4 min | ~5 |
| dMRI | Spin-echo EPI | 2mm 各向同性, 100 方向, 2 壳层 (b=1000/2000 s/mm²), 5 个 b=0 | 7 min | ~100 |
| rfMRI | Multiband EPI | 2.4mm 各向同性, TR=690ms, TE=39ms, FA=52°, MB factor 8, ~480 volumes | 6 min | ~3,000 |
| tfMRI | Multiband EPI | Hariri 面孔/形状任务, 2 blocks (faces/shapes), 同 rfMRI 参数 | 4 min | ~10 |
| ASL | 3D PCASL | PLD=1800ms, TR=4848ms, TE=14ms | 4 min | ~5 |
§4.3 影像协议阶段兼容性
UK Biobank 影像采集经历了 8 个协议阶段(Phase 1-8),各阶段间存在协议调整:
| 阶段 | 时间 | 参与者数 | 主要变更 | 兼容性影响 |
|---|---|---|---|---|
| Phase 1 | 2014-2015 | ~5,000 | 初始协议 | 基线参考 |
| Phase 2 | 2015-2016 | ~10,000 | rfMRI 参数微调 | rfMRI IDP 可比性受限 |
| Phase 3 | 2016-2017 | ~15,000 | dMRI 方向数增加 | dMRI IDP 可比性 |
| Phase 4 | 2017-2018 | ~15,000 | tfMRI 任务调整 | tfMRI IDP 影响 |
| Phase 5 | 2018-2019 | ~15,000 | ASL 序列更新 | ASL IDP 影响 |
| Phase 6 | 2019-2020 | ~10,000 | 扫描仪软件升级 | 全模态微小变化 |
| Phase 7 | 2020-2022 | ~15,000 | COVID 期间调整 | 时间间隔影响 |
| Phase 8 | 2022-2025 | ~15,000 | 最终协议 | 最新标准 |
⚠️ 重要:跨阶段分析时须控制协议阶段作为协变量。UKB 提供兼容性矩阵文档(Brain Imaging Documentation v1.10, §2.11)。
§4.4 数据获取方式
| 方式 | 描述 | 适用对象 |
|---|---|---|
| UKB-RAP 云平台 | AWS + DNAnexus,JupyterLab/RStudio/Spark/HAIL | 所有批准研究者(2024 起唯一方式) |
| Showcase 浏览器 | 在线浏览变量编码、描述、分布 | 所有人(只读浏览,无需审批) |
| UKB Community | 文档、论坛、教程 | 所有人 |
| UKB GitHub | RAP notebooks、工具 | 所有人(MIT 许可) |
| 生物样本 | 血液/尿液/唾液样本(需单独申请) | 批准研究者(容量有限,2027 后增加) |
§4.5 缺失值与数据质量
| 数据类型 | 缺失模式 | 质量控制 |
|---|---|---|
| 基线问卷 | 自报告,部分字段缺失率较高 | 逻辑检查、异常值标记 |
| 血液生化 | ~2% 缺失 | 实验室内部 QC + 批次效应校正 |
| 基因分型 | <1% 缺失 | call rate >0.95, HWE 检验 |
| WGS/WES | ~2% 参与者未完成 | DRAGEN variant calling QC |
| 影像 IDPs | ~10% 影像子集缺失某些模态 | 自动化 QC + 人工抽样复查 |
| 蛋白质组 | 当前仅 54K 有数据 | NPX 标准化 + 批次效应校正 |
| HES 链接 | England GP 数据 2025+ 开始 | 编码一致性检查 |
§4.6 生态工具
| 工具 | 类型 | 用途 | URL |
|---|---|---|---|
| UKB-RAP | 云平台 | 数据访问+分析 | https://ukbiobank.dnanexus.com/ |
| Showcase | 数据浏览器 | 变量浏览 | https://biobank.ctsu.ox.ac.uk/crystal/ |
| FSL | 影像工具 | 脑影像分析 | https://fsl.fmrib.ox.ac.uk/ |
| FreeSurfer | 影像工具 | 皮层表面重建 | https://surfer.nmr.mgh.harvard.edu/ |
| PANDORA | 预处理数据 | 脑影像体素级数据 | UKB-RAP Category 508 |
| PLINK | 遗传统计 | GWAS/QC | https://www.cog-genomics.com/plink/ |
| BGEN | 基因数据格式 | 插补基因型 | https://www.well.ox.ac.uk/~gav/bgen_format/ |
| HAIL | 基因组分析 | 大规模 GWAS | https://hail.is/ |
| Nvidia Parabricks | GPU 加速 | 基因组分析 | UKB-RAP 内置 |
| UKB GitHub | 代码库 | RAP 教程+工具 | https://github.com/UKBiobank |
| UKB Community | 社区 | 文档+论坛 | https://community.ukbiobank.ac.uk/ |
| MONAI | 医学影像 AI | 分割/标注 | UKB-RAP 内置 |
§5 数据划分与使用建议
§5.1 划分策略
| 策略 | 描述 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|---|
| 随机划分 | 80/10/10 或 70/15/15 | 通用 ML | 简单 | 可能存在亲属泄漏 |
| 亲属排除划分 | 使用 22021 (genetic kinship) 排除一级亲属 | 基因组 AI | 防止泄漏 | 样本量减少 |
| White British 子集 | Field 22000 = 1 (White British) | 基因组分析 | 均质人群 | 限族裔泛化性 |
| Unrelated 子集 | 排除所有亲属对 | 基因组 ML | 最佳防泄漏 | ~380K 可用 |
| 影像子集 | 仅使用有影像数据的参与者 | 影像 AI | 同人多模态 | 非随机子集(偏倚) |
| 时间划分 | 按招募日期划分 | 预测建模 | 模拟真实场景 | 时间趋势混杂 |
§5.2 基准配置代码
# UK Biobank 基准数据加载(通过 UKB-RAP JupyterLab)

# === 1. 通过 RAP Table Exporter 导出表型数据 ===
# 在 UKB-RAP 中使用 Table Exporter 应用选择字段并导出 CSV

# === 2. 加载基因型数据(BGEN 格式)===
import bgen_reader
from bgen_reader import read_bgen

# 插补基因型(~96M 变异)
bgen = read_bgen("bulk/Imputation/UKB imputation from genotype/ukb_imp_chr1.bgen")
print(f"Variants on chr1: {bgen.nvariants}")
# 使用 PLINK 提取特定 SNP:
# plink bgen bulk/.../ukb_imp_chr1.bgen ref-first extract snp_list.txt make-bed out extracted

# === 3. 加载脑 MRI IDPs ===
import pandas as pd
idps = pd.read_csv("brain_idps.csv")  # 从 Table Exporter 导出
print(f"Participants with brain IDPs: {len(idps)}")
print(f"IDP columns: {len([c for c in idps.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''210'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')])}")

# === 4. 加载蛋白质组数据 ===
proteomics = pd.read_csv("olink_proteomics.csv")
print(f"Participants with proteomics: {len(proteomics)}")
print(f"Proteins measured: {len([c for c in proteomics.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''30'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')])}")

# === 5. 亲属排除(防止基因组数据泄漏)===
# 使用 Field 22021 (genetic kinship) 排除一级亲属
kinship = pd.read_csv("kinship.csv")
# 保留每个亲属对中表型更完整的一个
unrelated = exclude_related(kinship, idps)
print(f"Unrelated participants with brain IDPs: {len(unrelated)}")
§5.3 使用建议
| 场景 | 推荐子集 | 样本量 | 关键注意事项 |
|---|---|---|---|
| GWAS | White British (22000=1) + 亲属排除 | ~380K | 控制人群分层 (PCs) |
| 脑年龄预测 | 有 T1 MRI 的参与者 | ~90K | 控制协议阶段 |
| PRS 开发 | 全队列 | ~490K | 留一法 (LOOCV) 或独立测试集 |
| 蛋白质组疾病预测 | Olink 子集 | 54K | 注意批次效应 |
| 代谢组风险评分 | NMR 子集 | ~280K | 注意 Phase 1/2 差异 |
| 心血管 AI | 心脏 MRI 子集 | ~81K | 控制年龄/性别 |
| 孟德尔随机化 | GWAS summary stats | 全队列 | 选择有效工具变量 |
| EHR 预测 | 全队列 + HES 链接 | ~500K | 注意随访长度差异 |
§6 AI 就绪指南
§6.0 云端启动
UKB-RAP 平台使用流程:
- 申请访问:注册 AMS → 提交研究计划 → 签署 MTA v1.4 → 支付费用 → 完成 3 个培训模块
- 创建项目:登录 ukbiobank.dnanexus.com → 创建 Project → 填入 Application ID → 勾选 “Dispense bulk data files”
- 等待数据分发:约 1 天后状态变为 “Ready”
- 开始分析:启动 JupyterLab 或 RStudio → 加载数据 → 分析
§6.1 快速上手代码
# === UK Biobank RAP JupyterLab 快速上手 ===

import dxpy
import pandas as pd
import numpy as np

# 1. 加载 Showcase 表型数据(通过 Table Exporter 导出的 CSV)
pheno = pd.read_csv("/mnt/project/app12345/health_outcomes.csv")
print(f"Total participants: {len(pheno)}")

# 2. 加载脑 MRI IDPs
brain_idps = pd.read_csv("/mnt/project/brain_idps.csv")
print(f"Brain MRI IDPs: {len(brain_idps)} participants, {len(brain_idps.columns)-1} IDPs")

# 3. 加载基因数据摘要(通过 Swiss Army Knife + PLINK)
# 在 RAP 中运行:
# plink bgen bulk/.../ukb_imp_chr22.bgen ref-first \
#       sample bulk/.../ukb_imp_chr22.sample \
#       extract prs_snps.txt dosage format single out chr22_dosage

# 4. 脑年龄预测基准模型
from sklearn.model_selection import train_test_split
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error

# 使用 T1 IDPs 预测年龄
t1_cols = [c for c in brain_idps.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''210'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''') and ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''volume'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''' in c.lower()]
X = brain_idps[t1_cols].fillna(0).values
y = brain_idps[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''age_at_imaging''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].values

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
model = Ridge(alpha=1.0)
model.fit(X_train, y_train)
pred = model.predict(X_test)
mae = mean_absolute_error(y_test, pred)
print(f"Brain Age MAE (Ridge baseline): {mae:.2f} years")

# 5. PRS 计算(使用预计算 PRS)
prs = pd.read_csv("/mnt/project/prs_data.csv")
# 评估冠心病 PRS (Field 26324)
cad_prs = prs[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''26324-0.0''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].values
cad_cases = pheno[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''coronary_artery_disease''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''].values
from sklearn.metrics import roc_auc_score
auc = roc_auc_score(cad_cases, cad_prs)
print(f"CAD PRS AUC: {auc:.3f}")
§6.2 数据获取流程
1. 注册 AMS (Access Management System)
   └── 需要机构邮箱 + 研究计划摘要

2. 提交申请
   ├── 研究摘要 (健康相关 + 公共利益)
   ├── 所需数据层级 (Tier 1-3)
   └── 衍生数据描述

3. 审批 (1-3 个月)
   ├── UKB 后台审查
   └── 必要时 Access Committee 评审

4. 签署 MTA + 支付费用
   ├── MTA v1.4 (2023-10)
   └── £3,000-£9,000 (按数据层级)

5. 完成 3 个培训模块
   ├── 数据安全
   ├── 数据治理
   └── RAP 使用

6. UKB-RAP 平台使用
   ├── 创建项目 (Application ID)
   ├── 数据分发 (~1 天)
   ├── JupyterLab / RStudio 分析
   └── 下载汇总结果 (非个体数据)
§6.3 预处理管道
# === UK Biobank 脑 MRI 预处理管道 (RAP 内) ===

# PANDORA 已提供预处理数据 (82,000 人)
# Category 508: 体素级 + 超体素级 ICA 分解

# 如需自定义预处理:
import nibabel as nib
import numpy as np
from nilearn import image, masking

def load_ukb_t1(nifti_path):
    """加载 UKB T1 NIFTI (已 defaced)"""
    img = nib.load(nifti_path)
    data = img.get_fdata()  # shape: (208, 256, 256)
    return data, img.affine

def extract_idps(t1_data, template=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''MNI152''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''):
    """提取影像衍生表型 (简化版)"""
    # UKB 官方流水线已生成 ~3,000 IDPs
    # 此处为自定义提取示例
    from nilearn import datasets
    from nilearn.image import resample_to_img
    atlas = datasets.fetch_icbm152_2009()
    # ... 区域体积提取
    return idps_dict

def load_genotype_dosage(chr_num, snp_list):
    """从 BGEN 文件提取基因型剂量"""
    # 在 RAP 中使用 Swiss Army Knife + PLINK:
    # plink bgen .../ukb_imp_chr{chr}.bgen ref-first \
    #       sample .../ukb_imp_chr{chr}.sample \
    #       extract {snp_list} dosage format single out dosage_chr{chr}
    pass

def compute_prs(dosage, weights):
    """计算多基因风险评分"""
    prs = np.dot(dosage, weights)
    return prs
§6.4 PyTorch DataLoader
import torch
from torch.utils.data import Dataset, DataLoader
import nibabel as nib
import numpy as np
import pandas as pd

class UKBBrainMRIDataset(Dataset):
    """UK Biobank 脑 MRI 数据集,适用于脑年龄预测"""

    def __init__(self, idp_csv, nifti_base_path, transform=None):
        self.metadata = pd.read_csv(idp_csv)
        self.nifti_base_path = nifti_base_path
        self.transform = transform

    def __len__(self):
        return len(self.metadata)

    def __getitem__(self, idx):
        row = self.metadata.iloc[idx]
        eid = str(int(row[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']))

        # 加载 T1 NIFTI (已 defaced, 已预处理)
        t1_path = f"{self.nifti_base_path}/{eid}/T1/T1.nii.gz"
        try:
            img = nib.load(t1_path)
            data = img.get_fdata().astype(np.float32)
            data = data[np.newaxis, ...]  # (1, 208, 256, 256)
        except:
            data = np.zeros((1, 208, 256, 256), dtype=np.float32)

        # 标签
        age = float(row[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''age_at_imaging''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''])
        sex = int(row[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''sex''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''])

        sample = {
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''image'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': torch.from_numpy(data),
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''age'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': torch.tensor(age, dtype=torch.float32),
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''sex'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': torch.tensor(sex, dtype=torch.long),
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': eid
        }

        if self.transform:
            sample = self.transform(sample)

        return sample

class UKBMultiOmicsDataset(Dataset):
    """UK Biobank 多组学数据集,适用于疾病预测"""

    def __init__(self, pheno_csv, geno_csv, proteo_csv, metabo_csv=None):
        self.pheno = pd.read_csv(pheno_csv)
        self.geno = pd.read_csv(geno_csv)
        self.proteo = pd.read_csv(proteo_csv)
        self.metabo = pd.read_csv(metabo_csv) if metabo_csv else None

        # 内连接 (eid 作为键)
        self.data = self.pheno.merge(self.geno, on=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', how=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''inner'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')
        self.data = self.data.merge(self.proteo, on=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', how=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''inner'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')
        if self.metabo is not None:
            self.data = self.data.merge(self.metabo, on=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''eid'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''', how=''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''inner'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')

        print(f"Multi-omics dataset: {len(self.data)} participants")

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        row = self.data.iloc[idx]

        # 基因特征 (PRS 或 SNP dosage)
        geno_features = row[[c for c in self.data.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''prs_'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')]].values.astype(np.float32)

        # 蛋白质特征
        proteo_features = row[[c for c in self.data.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''olink_'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')]].values.astype(np.float32)

        # 代谢物特征
        if self.metabo is not None:
            metabo_features = row[[c for c in self.data.columns if c.startswith(''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''nmr_'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''')]].values.astype(np.float32)
            features = np.concatenate([geno_features, proteo_features, metabo_features])
        else:
            features = np.concatenate([geno_features, proteo_features])

        # 标签
        label = int(row[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''disease_status''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''])

        return {
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''features'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': torch.from_numpy(features),
            ''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''label'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''': torch.tensor(label, dtype=torch.long)
        }

# 使用示例
if __name__ == "__main__":
    # 脑年龄预测
    dataset = UKBBrainMRIDataset("brain_metadata.csv", "/mnt/project/brain_nifti")
    loader = DataLoader(dataset, batch_size=4, shuffle=True, num_workers=2)

    for batch in loader:
        images = batch[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''image'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']  # (4, 1, 208, 256, 256)
        ages = batch[''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''age'''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''']      # (4,)
        print(f"Batch shape: {images.shape}, Ages: {ages}")
        break
§6.5 坑点
| # | 坑点 | 严重度 | 解决方案 |
|---|---|---|---|
| 1 | 健康志愿者偏倚 | ⚠️ 高 | 参与者比一般人群更健康(死亡率低 46-55%),不可用于患病率估计。关联分析(暴露-疾病)通常可泛化,但须在论文中声明偏倚 |
| 2 | 族裔偏倚 | ⚠️ 高 | 94.6% 白人,PRS 在非欧洲人群中性能大幅下降(非洲裔 39.4%)。使用 Pan-UKB 或多族裔 PRS 模型;注意 Field 22000 族裔分组 |
| 3 | 影像协议阶段差异 | ⚠️ 中 | 8 个协议阶段(Phase 1-8),跨阶段 IDP 可比性受限。控制协议阶段作为协变量;参考 Brain Imaging Documentation v1.10 §2.11 |
| 4 | 亲属非独立性 | ⚠️ 高 | 一级亲属对存在于数据中,交叉验证如不排除会导致训练/测试泄漏。使用 Field 22021 (genetic kinship) 排除亲属或使用 Unrelated 子集 |
| 5 | 云端成本 | ⚠️ 中 | 2024 年起仅限 UKB-RAP 云端访问,AWS 计算+存储成本累积。申请 AWS 信用额度(ECR 最高 $500K/yr);优化分析流程减少计算量 |
| 6 | T1/T2 defacing | 🔵 低 | NIFTI T1/T2 已 defaced 移除面部特征。如需原始 DICOM(未 defaced),须单独申请并证明科学必要性 |
| 7 | WGS 短读长局限 | 🔵 低 | WGS 为 Illumina 短读长(short-read),无法检测结构变异和长串联重复。需结合其他技术验证 |
| 8 | 代谢组/蛋白质组批次效应 | ⚠️ 中 | Nightingale NMR Phase 1/2 间存在批次效应;Olink 跨批次需 NPX 校准。使用批次校正方法 (ComBat) 或纳入批次协变量 |
| 9 | EHR 链接不完整 | 🔵 低 | England GP 数据 2025+ 才开始链接;Scotland/Wales 已有。随访长度因招募时间不同而异 |
| 10 | 100K 影像子集非随机 | ⚠️ 中 | 影像子集为自愿参加,进一步偏向健康志愿者。影像分析结果可能不泛化到全队列 |
§6.6 模型推荐
| 任务 | 推荐模型 | 输入 | 关键论文 |
|---|---|---|---|
| 脑年龄预测 | NeuroAgeFusionNet (CNN+Transformer+GNN) | T1 MRI | Sowmya & Dutta 2025, Sci Rep |
| 脑年龄预测 | 3D Vision Transformer | T1 MRI | Zhang et al. 2025, Commun Med |
| 脑年龄预测 | FastSurfer + Ridge | T1 IDPs | Capó et al. 2025, NeuroImage |
| PRS 计算 | LDpred2 / PRS-CSx / ALL-Sum | GWAS summary stats | Chen et al. 2024, PNAS |
| 痴呆预测 | Brain Age Gap + PRS | T1 MRI + WGS | Zhang et al. 2025 |
| 蛋白质组疾病预测 | LASSO-Cox (ProteinScore) | Olink NPX | Gadd et al. 2024, Nat Aging |
| 心血管风险 | Multi-omics integration | PRS+蛋白+代谢 | Xie et al. 2025 |
| GWAS | PLINK2 / BOLT-LMM / REGENIE | WGS/WES | Bycroft et al. 2018 |
| 孟德尔随机化 | TwoSampleMR / MR-PRESSO | GWAS summary | — |
| 基因组分析 | HAIL / Apache Spark | WGS VCF | UKB-RAP 内置 |
| 脑分割 | FreeSurfer / FastSurfer | T1 MRI | Alfaro-Almagro et al. 2018 |
| 功能连接分析 | FSL/MELODIC | rfMRI NIFTI | Smith et al. 2014 |
§6.7 硬件配置
| 配置 | 规格 | 适用场景 | 成本 |
|---|---|---|---|
| UKB-RAP 入门 | JupyterLab (m5.2xlarge) | 表型数据探索 | £40 免费额度 |
| UKB-RAP 标准 | JupyterLab (m5.4xlarge) | 影像 IDPs 分析 | ~£2/hr |
| UKB-RAP GPU | JupyterLab (g4dn.xlarge) | 深度学习 | ~£5/hr |
| UKB-RAP Spark | Apache Spark cluster | 大规模 GWAS | 按节点计费 |
| UKB-RAP Parabricks | GPU 加速基因分析 | WGS 变异注释 | 按需 |
| 本地预处理 | 64-core CPU + 256GB RAM | 自定义影像流水线 | 一次性 |
§6.8 评估指标
| 任务 | 主要指标 | 基准值 | SOTA |
|---|---|---|---|
| 脑年龄预测 | MAE (years) | 4-5 (传统 ML) | 2.30 (NeuroAgeFusionNet 2025) |
| 脑年龄预测 | R² | 0.80 | 0.96 (NeuroAgeFusionNet 2025) |
| 痴呆分类 | AUROC | 0.75 | 0.90 (brain age + dementia, 2025) |
| PRS | AUC | 0.55-0.65 | 0.81+ (12/30 models, 2025) |
| 蛋白质组疾病预测 | C-index | 0.70 | 0.848 (multi-omics, 2025) |
| GWAS | -log10(p) | 5×10⁻⁸ | 5×10⁻⁸ (genome-wide) |
§7 质量评估与局限性
§7.1 偏倚
| # | 偏倚类型 | 描述 | 影响 | 缓解方法 |
|---|---|---|---|---|
| 1 | 健康志愿者偏倚 | 参与者比一般人群更健康、更富裕、吸烟/肥胖率更低 (Fry et al. 2017) | 患病率不可外推;关联效应通常可泛化 | 论文中声明;不用于患病率估计 |
| 2 | 族裔偏倚 | 94.6% 白人,反映 2001 年人口普查但非当前多样性 | PRS 在非欧洲人群性能大幅下降 | 使用多族裔 PRS;Pan-UKB 数据 |
| 3 | 年龄范围偏倚 | 招募时 40-69 岁(现已 56-85+),无儿童/青少年 | 无法研究早年暴露;疾病谱偏向老年 | 补充其他队列(如 ALSPAC) |
| 4 | 地理偏倚 | 22 个中心,25 英里半径,86% 城市 | 农村人口不足;区域差异 | 环境数据校正 |
| 5 | 影像志愿者偏倚 | 100K 影像子集进一步偏向健康 | 影像结果可能不泛化到全队列 | 注意选择偏倚校正 |
| 6 | 碰撞偏倚 (Collider bias) | 选择进入队列本身可能与暴露和结局相关 | 可能扭曲关联方向 | 敏感性分析;E-value |
| 7 | PRS 可移植性偏倚 | 基于欧洲血统的 PRS 在非洲/东亚/南亚人群中性能降低 39-51% | 多族裔应用受限 | 多族裔 GWAS;族裔特异 PRS |
§7.2 标注质量
| 数据类型 | 标注方式 | 质量保证 |
|---|---|---|
| 影像 IDPs | 自动化流水线 (FSL/FreeSurfer) + QC | 自动 QC + 人工抽样复查 |
| 影像 DICOM | 扫描仪自动重建 | 扫描仪 QC + 人工放射学审查(发现潜在病变时通知参与者) |
| 基因分型 | Affymetrix 自动 calling | call rate >0.95, HWE, 批次效应 |
| WGS/WES | DRAGEN variant calling | GATK 最佳实践 QC |
| 蛋白质组 | Olink 自动化 | NPX 标准化 + 质控蛋白 |
| 代谢组 | Nightingale NMR 自动化 | 内部标准 + 批次 QC |
| EHR 诊断 | ICD-10/ICD-11 编码 | 编码验证研究(如 Wilkinson et al. 2017 痴呆验证) |
| 自报告问卷 | 触屏自动录入 | 逻辑检查 + 异常值标记 |
§7.3 泛化性
| 场景 | 泛化性评估 |
|---|---|
| 欧洲血统人群 | ✅ 高(主要为英国白人) |
| 非洲血统人群 | ⚠️ 有限(~10,000 人,PRS 性能 39.4%) |
| 东亚血统人群 | ⚠️ 有限(PRS 性能 46.6%) |
| 南亚血统人群 | ⚠️ 有限(PRS 性能 51.3%) |
| 年龄 <40 | ❌ 不可泛化(无数据) |
| 年龄 >85 | ⚠️ 样本量有限 |
| 临床人群 | ⚠️ 健康志愿者偏倚需校正 |
| 其他国家人群 | ⚠️ 生活方式/环境/医疗体系差异 |
| 影像 AI 模型 | ⚠️ 单一扫描仪型号/协议,需外部验证 |
§7.4 伦理考量
- 知情同意:所有参与者签署电子知情同意书,同意数据用于健康研究并终身随访
- 数据去标识化:移除姓名、地址、精确出生日期;T1/T2 影像 defaced
- 受控访问:研究者须经审批,签署 MTA,禁止重识别
- 公共利益要求:研究必须健康相关且符合公共利益
- 保险公司禁令:2025 年起不再接受保险公司直接数据访问
- 国际数据共享:遵循 UK/EU/US 制裁政策,研究者所在国不得受制裁
§7.5 DAIMS 24 项评估
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 动机与范围 | ✅ | 明确的前瞻性队列研究目标 |
| 2 | 组成与构成 | ✅ | 502,506 人,详细人口统计 |
| 3 | 收集过程 | ✅ | 22 中心标准化协议 |
| 4 | 预处理/清洗 | ✅ | FSL/FreeSurfer 影像流水线 + DRAGEN 基因 |
| 5 | 标注方法 | ✅ | 自动化 IDPs + QC |
| 6 | 标注者信息 | ✅ | Oxford FMRIB/WIN 团队 |
| 7 | 质量保证 | ✅ | 自动 QC + 人工复查 |
| 8 | 已知偏差 | ✅ | 健康志愿者偏倚(Fry et al. 2017) |
| 9 | 去标识化 | ✅ | 去标识化 + defacing |
| 10 | 使用限制 | ✅ | MTA v1.4 明确限制 |
| 11 | 许可证 | ✅ | UKB Data Access Agreement |
| 12 | 维护计划 | ✅ | 持续更新至 2029+ |
| 13 | 版本控制 | ✅ | 数据发布历史完整记录 |
| 14 | 再现性 | ✅ | 流水线公开 (FSL, GitHub) |
| 15 | 外部验证 | ✅ | ADNI, FinnGen, 100K Genomes |
| 16 | 统计功效 | ✅ | 502K 足够检测罕见变异 |
| 17 | 数据格式 | ✅ | DICOM/NIFTI/BGEN/VCF/CSV |
| 18 | 文档质量 | ✅ | Brain Imaging Doc v1.10 + Showcase |
| 19 | API/工具 | ✅ | UKB-RAP + JupyterLab + GitHub |
| 20 | 社区支持 | ✅ | UKB Community + 论坛 |
| 21 | 费用/门槛 | ✅ | £3K-£9K,LMIC 免费 |
| 22 | FAIR 原则 | ✅ | Findable/Accessible/Interoperable/Reusable |
| 23 | AI 就绪度 | ✅ | IDPs + PANDORA + RAP 工具链 |
| 24 | 透明性 | ✅ | 协议、版本、QC 公开 |
DAIMS 总分:22/24(91.7%)⭐⭐⭐⭐⭐
§7.6 外部验证
| 验证数据集 | 验证内容 | 结果 |
|---|---|---|
| ADNI | 脑年龄模型迁移 | MAE 2.99-3.20 年(vs UKB 2.68 年) |
| PPMI | 脑年龄模型迁移 | MAE 2.99-3.20 年 |
| NACC | 痴呆分类 | AUROC 0.90 |
| FinnGen | PRS + 基因关联 | 部分复制成功 |
| eMERGE Network | 多族裔 PRS | 最小性能下降 |
| 100,000 Genomes Project | PRS 验证 | 53 性状验证通过 |
| China Kadoorie Biobank | 研究方法复制 | 效应方向一致 |
§8 基准性能与生态
§8.1 排行榜
脑年龄预测(UK Biobank T1 MRI)
| 排名 | 方法 | MAE (年) | Pearson r | R² | 年份 | 论文 |
|---|---|---|---|---|---|---|
| 1 | NeuroAgeFusionNet (CNN+Transformer+GNN) | 2.30 | 0.97 | 0.96 | 2025 | Sowmya & Dutta, Sci Rep |
| 2 | 3D Vision Transformer | 2.68 | — | — | 2025 | Zhang et al., Commun Med |
| 3 | SFCN (Simple Fully Convolutional Network) | 2.36 | — | — | 2024 | Peng et al. |
| 4 | Ridge + IDPs (Zhang’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’‘’'s method) | <1.0 | — | — | 2025 | Capó et al., NeuroImage |
| 5 | Traditional ML (SVR) | 4-5 | — | — | — | 基线 |
PRS 疾病预测(UK Biobank PRS Release)
| 方法 | 疾病 | AUC | 备注 |
|---|---|---|---|
| ALL-Sum (ensemble) | 多性状 | 平均提升 25% | Chen et al. 2024, PNAS |
| UKB PRS Release | 28 疾病 + 25 性状 | 0.55-0.81 | Thompson et al. 2024 |
| Multi-ancestry ensemble | 12/30 >0.80 | — | Lerga-Jaso et al. 2025 |
| CAD PRS | 冠心病 | ~0.81 | 55-80× 真阳性 vs 罕见变异 |
蛋白质组/多组学疾病预测
| 方法 | 疾病 | 指标 | 年份 | 论文 |
|---|---|---|---|---|
| ProteinScore (Olink) | 2 型糖尿病 | 超越 PRS + HbA1c | 2024 | Gadd et al., Nat Aging |
| Multi-omics (PRS+蛋白+代谢) | CVD (T2D) | C-index 0.848 | 2025 | Xie et al. |
| Brain Age Gap + PRS | 阿尔茨海默病 | HR 2.8 (Q4) | 2025 | Zhang et al. |
| Brain age + dementia | 痴呆 | AUROC 0.90 | 2025 | Capó et al. |
§8.2 关键论文
| # | 论文 | 期刊 | 年份 | 核心贡献 |
|---|---|---|---|---|
| 1 | Sudlow et al. UK Biobank cohort profile | PLOS Med 12:e1001779 | 2015 | 队列概况 |
| 2 | Bycroft et al. UK Biobank genotyping data | Nature 562:203-209 | 2018 | 全队列基因分型 + 插补 |
| 3 | Miller et al. Multimodal brain imaging protocol | Nat Neurosci 19:1523-1536 | 2016 | 脑 MRI 协议 |
| 4 | Alfaro-Almagro et al. Brain image processing | Neuroimage 166:400-424 | 2018 | 影像处理流水线 |
| 5 | Elliott et al. GWAS of brain imaging phenotypes | Nature 562:210-216 | 2018 | 影像遗传学 |
| 6 | Fry et al. Comparison with general population | Am J Epidemiol 186:1026-1034 | 2017 | 健康志愿者偏倚 |
| 7 | Littlejohns et al. Imaging enhancement | Nat Commun 11:5477 | 2020 | 100K 影像项目 |
| 8 | Gaynor et al. WGS vs WES vs imputation | Nat Genet | 2024 | 基因组策略比较 |
| 9 | Thompson et al. PRS Release evaluation | PLOS ONE | 2024 | 53 性状 PRS 评估 |
| 10 | Gadd et al. Proteomics & disease | Nat Aging | 2024 | 蛋白质组疾病预测 |
| 11 | Sowmya & Dutta. NeuroAgeFusionNet | Sci Rep | 2025 | 脑年龄 MAE 2.30 |
| 12 | Capó et al. Generalizable brain clocks | NeuroImage 308:121064 | 2025 | 跨数据集泛化 |
§8.3 使用统计
| 统计项 | 值 |
|---|---|
| 注册研究者 | 30,000+ |
| 活跃研究者 | 21,000+ |
| 研究者所在国家 | 60+ |
| 批准研究项目 | 9,000+ |
| 同行评审论文 | 16,000+ |
| 年发表论文增速 | ~3,000+/年(2023) |
| 影像数据相关论文 | 1,300+ |
| UKB-RAP 活跃项目 | 数千 |
§8.4 相关数据集
| 数据集 | 关系 | 规模 | 特点 |
|---|---|---|---|
| China Kadoorie Biobank | 姊妹队列 | 512K | 中国人群,UKB 团队参与设计 |
| All of Us (US) | 类似资源 | 1M+ | 美国版,多族裔 |
| FinnGen (Finland) | 类似资源 | 500K | 芬兰隔离人群,EHR 为主 |
| ADNI | 神经退行性 | ~2K | 阿尔茨海默病纵向影像 |
| HCP | 脑连接组 | 1,206 | 高分辨率脑连接组 |
| Our Future Health (UK) | 后继项目 | 2.5M+ (已同意) | UK 新一代健康队列 |
| 23andMe | 直接消费基因 | ~12M | 基因分型 + 自报告表型 |
| Million Veteran Program | 美国退伍军人 | 950K | 基因组 + EHR |
§8.5 生态快照
┌─────────────────────────────────────────────────────────────┐
│                   UK Biobank 生态系统                         │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  数据采集层                                                  │
│  ├── 22 评估中心 (2006-2010, 基线)                            │
│  ├── 4 影像中心 (2014-2025, 100K 影像)                        │
│  └── 在线平台 (持续问卷收集)                                   │
│                                                             │
│  数据处理层                                                  │
│  ├── Oxford FMRIB/WIN (脑影像流水线)                          │
│  ├── Wellcome Sanger Institute (WGS/WES 测序)                │
│  ├── Decode Genetics (WGS 测序)                              │
│  ├── Olink Proteomics (蛋白质组)                              │
│  └── Nightingale Health (代谢组)                              │
│                                                             │
│  数据存储与分发层                                             │
│  ├── UKB-RAP (AWS London + DNAnexus)                        │
│  ├── Showcase 数据浏览器                                      │
│  └── Stockport 生物样本库 (-80°C)                              │
│                                                             │
│  研究者社区                                                  │
│  ├── 21,000+ 研究者 (60+ 国家)                               │
│  ├── UKB Community 论坛                                      │
│  ├── UKB GitHub 代码库                                       │
│  └── 16,000+ 论文                                             │
│                                                             │
│  资助方                                                      │
│  ├── Wellcome / MRC / CRUK / BHF / NIHR (核心)                │
│  ├── UKRI (基础设施 £127.6M)                                  │
│  ├── Amgen / AstraZeneca / GSK / J&J (WGS)                   │
│  ├── AWS (云存储 £8M)                                         │
│  └── Schmidt / Griffin (慈善 £16M)                            │
│                                                             │
│  关联项目                                                    │
│  ├── China Kadoorie Biobank (姊妹队列)                        │
│  ├── Our Future Health (UK 后继项目)                           │
│  └── Pan-UKB (多族裔整合)                                     │
│                                                             │
└─────────────────────────────────────────────────────────────┘
§9 相关资源与引用
§9.1 官方资源
| # | 资源 | URL |
|---|---|---|
| 1 | UK Biobank 官网 | https://www.ukbiobank.ac.uk/ |
| 2 | UKB-RAP 云平台 | https://ukbiobank.dnanexus.com/ |
| 3 | Showcase 数据浏览器 | https://biobank.ctsu.ox.ac.uk/crystal/ |
| 4 | UKB Community 社区 | https://community.ukbiobank.ac.uk/ |
| 5 | UKB GitHub | https://github.com/UKBiobank |
| 6 | Brain Imaging Documentation v1.10 | https://biobank.ctsu.ox.ac.uk/crystal/crystal/docs/brain_mri.pdf |
| 7 | 申请访问 | https://www.ukbiobank.ac.uk/enable-your-research/apply-for-access |
| 8 | 数据发布历史 | https://community.ukbiobank.ac.uk/hc/en-gb/articles/26655145866269 |
| 9 | 影像数据文档 | https://community.ukbiobank.ac.uk/hc/en-gb/articles/24618819821981 |
| 10 | 基因数据文档 | https://www.ukbiobank.ac.uk/enable-your-research/about-our-data/genetic-data/ |
| 11 | 生物标记物数据 | https://www2.ukbiobank.ac.uk/about-our-data/types-of-data/biomarker-data |
| 12 | 参与者信息 | https://www.ukbiobank.ac.uk/?p=54 |
| 13 | 基金信息 | https://www.ukbiobank.ac.uk/about-us/our-funding/ |
| 14 | 访问条款 | https://www.ukbiobank.ac.uk/about-us/how-we-work/access-to-uk-biobank-data/ |
§9.2 BibTeX
@article{sudlow2015ukbiobank,
  title={UK Biobank: An Open Access Resource for Identifying the Causes of a Wide Range of Complex Diseases of Middle and Old Age},
  author={Sudlow, Cathie and Gallacher, John and Allen, Naomi and Beral, Valerie and Burton, Paul and Danesh, John and Downey, Paul and Elliott, Paul and Green, Jane and Landray, Martin and others},
  journal={PLOS Medicine},
  volume={12},
  number={3},
  pages={e1001779},
  year={2015},
  doi={10.1371/journal.pmed.1001779}
}

@article{bycroft2018ukbiobank,
  title={The UK Biobank Resource with Deep Phenotyping and Genomic Data},
  author={Bycroft, Clare and Freeman, Colin and Petkova, Desislava and Band, Gavin and Elliott, Lloyd T and Sharp, Kevin and Motyer, Allan and Vukcevic, Damjan and Delaneau, Olivier and O''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''''Connell, Jared and others},
  journal={Nature},
  volume={562},
  number={7726},
  pages={203209},
  year={2018},
  doi={10.1038/s41586-018-0579-z}
}

@article{alfaroalmagro2018image,
  title={Image Processing and Quality Control for the First 10,000 Brain Imaging Datasets from UK Biobank},
  author={Alfaro-Almagro, Fidel and Jenkinson, Mark and Bangerter, Neal K and Andersson, Jesper L R and Griffanti, Ludovica and Douaud, Gwena{\"e}lle and Sotiropoulos, Stamatios N and Jbabdi, Saad and Hernandez-Fernandez, Moises and Vallee, Emmanuel and others},
  journal={NeuroImage},
  volume={166},
  pages={400424},
  year={2018},
  doi={10.1016/j.neuroimage.2017.10.034}
}

@article{miller2016multimodal,
  title={Multimodal Population Brain Imaging in the UK Biobank Prospective Epidemiological Study},
  author={Miller, Karla L and Alfaro-Almagro, Fidel and Bangerter, Neal K and Thomas, David L and Yacoub, Essa and Xu, Junqian and Bartsch, Andreas J and Jbabdi, Saad and Sotiropoulos, Stamatios N and Andersson, Jesper L R and others},
  journal={Nature Neuroscience},
  volume={19},
  number={11},
  pages={15231536},
  year={2016},
  doi={10.1038/nn.4393}
}
§9.3 核心团队
| 姓名 | 职位 | 机构 | 贡献 |
|---|---|---|---|
| Prof. Sir Rory Collins | PI / CEO | UK Biobank / Oxford | 总体领导 |
| Prof. Naomi Allen | 首席科学家 | Oxford | 研究方向 |
| Dr. Mark Effingham | 副CEO | UK Biobank | 运营 + RAP |
| Prof. Stephen Smith | 脑影像联合PI | Oxford FMRIB/WIN | 脑影像流水线 |
| Prof. Karla Miller | 脑影像联合PI | Oxford FMRIB/WIN | 脑影像协议 |
| Dr. Fidel Alfaro-Almagro | 核心影像处理 | Oxford FMRIB/WIN | 影像流水线 |
| Prof. Paul Matthews | 影像工作组主席 | Imperial College | 影像策略 |
| Prof. Jonathan Marchini | 基因组学 | Oxford | 基因分型插补 |
| Prof. Peter Donnelly | 基因组学 | Oxford | 基因数据分析 |
| Prof. Cathie Sudlow | 前首席科学家 | Edinburgh | 队列概况 |
| Prof. Ben Lacey | 流行病学 | Oxford | EHR 链接 |
| Prof. Adam Butterworth | 心血管遗传学 | Cambridge | PRS |
§10 AI 使用声明卡
§10.1 标识
| 字段 | 值 |
|---|---|
| 数据集名称 | UK Biobank |
| 数据集 ID | uk-biobank/96 |
| 系列 | 千方医数集 AI-Ready Wikipedia #46 |
| 生成日期 | 2026-08-11 |
| 生成工具 | AI 辅助写作 + 人工审核 |
| 模板版本 | v3.9 |
| 页面状态 | published |
§10.2 许可证摘要
UK Biobank 数据受 UK Biobank Data Access Agreement (MTA v1.4) 约束。数据仅限 UKB-RAP 云平台访问(2024 年起)。研究者须通过审批流程、支付费用、签署 MTA 并遵守使用限制。禁止重识别参与者和共享个体数据。本 Wikipedia 条目为千方医数集原创内容,遵循千方病案版权声明。
§10.3 推荐工作流
- 浏览 Showcase 确定所需变量 Field ID
- 注册 AMS 并提交研究申请
- 签署 MTA + 支付费用 + 完成培训
- 登录 UKB-RAP 创建项目
- 使用 Table Exporter 导出表型数据为 CSV
- 使用 JupyterLab/RStudio 分析
- 如需基因数据:使用 Swiss Army Knife + PLINK/BGEN
- 如需影像数据:直接使用 IDPs 或 PANDORA 预处理数据
- 下载汇总结果发表(不可下载个体数据)
§10.4 人工校验表
| 检查项 | 状态 | 说明 |
|---|---|---|
| 参与者数 (502,506) | ✅ | 官方数据确认 |
| 影像参与者数 (100,000) | ✅ | 2025-07 官方里程碑 |
| WGS 参与者数 (~490,000) | ✅ | Field 32069: 490,294 |
| WES 参与者数 (~470,000) | ✅ | Field 32050: 469,574 |
| 基因分型参与者数 (~488,000) | ✅ | Field 22418: 487,921 |
| 蛋白质组参与者数 (54,000) | ✅ | 官方确认 |
| 代谢组参与者数 (~280,000) | ✅ | ~280K 公开, ~488K 已测 |
| 数据总量 (~30 PB) | ✅ | AWS 官方博客确认 |
| 论文数 (16,000+) | ✅ | 官方确认 |
| 研究者数 (21,000+) | ✅ | 官方确认 |
| 国家数 (60+) | ✅ | 官方确认 |
| 访问费用 (£3K-£9K) | ✅ | 官方确认 |
| 脑年龄 MAE (2.30) | ✅ | NeuroAgeFusionNet 2025, Sci Rep |
| PRS AUC (>0.80, 12/30) | ✅ | Lerga-Jaso et al. 2025 |
| 健康志愿者偏倚 | ✅ | Fry et al. 2017, Am J Epidemiol |
| 族裔构成 (94.6% 白人) | ✅ | 官方确认 |
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- ega — 共享标签:基因组学与多组学 / 测序数据 / 队列研究
- all-of-us-nih-legacy — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- american-gut-project — 共享标签:基因组学与多组学 / 测序数据 / 队列研究
- finngen — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- biobank-japan — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- dbgap — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- metabric — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- chest-imagenome — 共享标签:电子健康记录 / 测序数据 / 队列研究
- million-veteran-program — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
- geisinger-mycode — 共享标签:电子健康记录 / 基因组学与多组学 / 队列研究
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
