信息速览
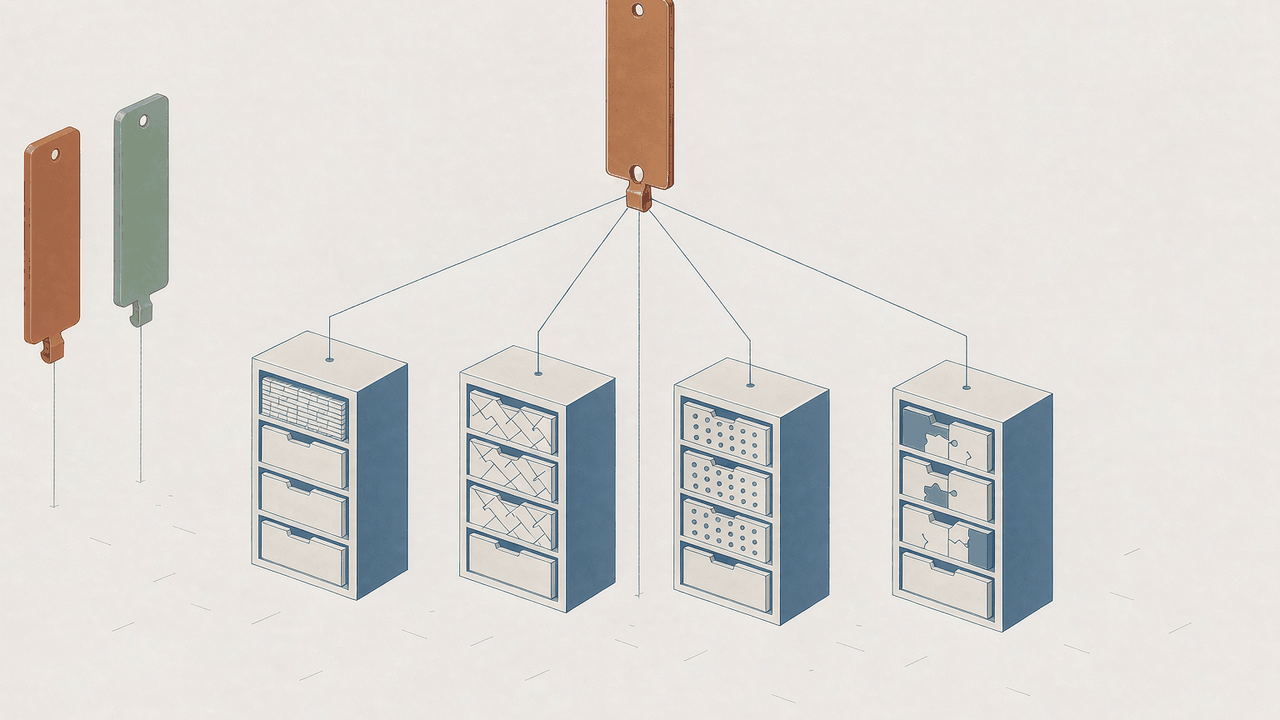
BioProject 是 NCBI 维护的生物学项目著录库,一个编号对应一项研究计划,把这项计划产生的各类数据串到同一处。它最常见的形态是一行十六位的项目编号,例如 PRJNA196804;把它敲进检索框,得到的是一页著录加一张跳转目录:读段去了 SRA,表达数据去了 GEO,样本起了什么名字去了 BioSample,组装好的基因组去了 Assembly。页面本身不含任何一个碱基。
这一点决定了它的位置。它不生产数据,也不重新处理数据,只登记「谁在什么时间、为了什么目的、用什么东西、做了这一批」。可以把它理解为图书馆的总目录卡而不是书架:卡片写清书名、作者、出版者与索书号,书在别处;卡片写错了,书还在,但你按卡片去找会走空。
它有一套自己的边界。三条编号前缀分属三座库,字段只有描述、类型、物种、提交与关联这几块,内容由提交者自负,官方明说不作进一步整理;一部分项目关联数据为零,一部分只剩一句话。下面先给一屏速览,再逐层拆开。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 全称 | BioProject Database(生物项目库) |
| 维护方 | 美国国家生物技术信息中心(NCBI),隶属美国国家医学图书馆 |
| 首发年份 | 2011 年前后上线,2012 年 1 月在《核酸研究》发表方法学论文 |
| 记录粒度 | 一个研究项目一条记录,而非一份样本、一次运行 |
| 主键 | 项目编号(accession),形如 PRJNA 加数字 |
| 编号前缀 | PRJNA 对应 NCBI;PRJEB 对应 EBI 的 ENA;PRJDB 对应日本 DDBJ |
| 当前规模 | 公开记录逾一百一十万条(2026 年 10 月 28 日库快照) |
| 字段分块 | 描述块(标题、概述、类型、范围、物种、资助、登记日期)与链接块(按资源分组的数据跳转) |
| 关联子库 | SRA、GEO、BioSample、Assembly、Nucleotide、WGS、Trace Archive、dbVar、GTR 等 |
| 数据形态 | 网页著录加 XML;无矩阵、无序列文件、无读段文件 |
| 检索入口 | 基础检索、高级检索(二十余个可检索字段)、程序接口 |
| 内容责任 | 提交者自负,NCBI 只做格式、物种与重复性校验 |
| 层级特例 | 伞形项目,只聚类数据级项目,不直接挂数据 |
| 使用限制 | 不存序列与读段;概述详略不一;关联链接数日延迟 |
| 许可 | 著录可自由浏览下载;底层数据依项目访问政策,受控部分另走 dbGap |
§1 它要解决的具体麻烦
1.1 一批数据的零件散在四个库
一个测序项目落地时,产物是分散的。原始读段进 SRA,一次运行一个编号;表达矩阵若走芯片或处理后的表达谱进 GEO,一个系列一个编号;样本若是微生物或模式生物,材料属性进 BioSample;若把读段拼成基因组,组装品进 Assembly。这些文件各自有格式、各自有检索界面、各自的编号规则,彼此之间没有天然联系。
在没有项目层之前,要让这批东西被同一个编号串起来,只有两种办法:一是靠在论文里人工罗列一串编号,二是靠上传者把项目名写成同一串字符串再去全文检索。前者一旦漏写就断链,后者受拼写与命名习惯影响,几乎不可靠。一个项目做了三年,中途换过测序平台、换过合作方、换过样本命名规则,靠字符串对齐是把偶然性当机制。
BioProject 的切入点就是这一层。它不做数据管理,只做登记:先给这项计划发一个编号,此后所有提交动作都在表单里填这个编号,各个档案库的对象就天然带上同一个外键。索引关系由数据库维护,不靠文本猜测。
1.2 它带来的三种改变
| 改变 | 之前 | 之后 |
|---|---|---|
| 编号归属 | 同一批数据的各个片段各有编号,无法判断是否一家 | 同一项目编号作为共同外键,跨库归属一目了然 |
| 检索入口 | 要在四个库里分别试关键词 | 一处检索命中项目,再按分组跳到各库 |
| 背景信息 | 数据对象不携带研究目的 | 项目层给出概述、资助与关联文献 |
第三种改变是最容易被低估的。SRA 的一次运行记录,字段里只有平台、文库、读长与样本号,它不知道这批数据为什么要做。要回答「这批肠道菌群样品取自哪个队列、研究什么问题」,唯一的入口是回到项目层读概述。项目层因此承担的不是数据管理职能,而是语境职能。
1.3 三条常见的错误期待
| 常见期待 | 实际情况 |
|---|---|
| 以为项目编号能直接下载数据 | 页面只有跳转链接,取数要逐个进子库 |
| 以为著录经过人工校订、可信度较高 | 官方明说记录由提交者自负,一般不进入进一步整理 |
| 以为项目数约等于研究数或数据集数 | 一个项目可含多个子项目,也可能只登记不挂数据 |
1.4 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 一个编号找齐同一研究的所有数据 | 按资源分组的完整跳转链接 | 够,这是它的主场 |
| 这批数据为什么做、谁资助 | 概述、资助机构与资助编号、关联文献 | 看提交者写多少 |
| 样本层面的属性(性别、组织、处理) | 只给样本数与去 BioSample 的链接 | 不够,要跳过去 |
| 原始读段或组装好的序列 | 只有链接,不存文件 | 不够 |
| 按数据类型筛出全部转录组项目 | 高级检索可按数据类型字段筛选 | 够,但字段值是提交者自选 |
| 判断一个项目的数据质量 | 无任何质量标记或完整性评级 | 完全不够 |
| 引用时当作数据出处 | 官方建议引用具体数据编号 | 不宜单引项目号 |
1.5 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 论文里写「数据见 PRJNA 某号」,想找原始读段 | 项目页链接块直接列出 SRA Experiments 条数与跳转 | 点进 SRA 取运行号,再按需下载 |
| 想摸清某个实验室近年在做什么 | 按提交机构字段检索,得到该机构全部项目 | 逐条读概述,注意同名机构写法不一 |
| 做数据抓取,需要稳定的项目主键 | 项目编号唯一且不改写 | 用程序接口批量取 XML,按编号建表 |
| 要给一批样本找归属项目 | 从样本号反查项目 | 走样本库查项目链接,或按项目编号批量比对 |
| 需要统计某个物种的公开项目数 | 按物种字段检索计数即可 | 注意同名物种与菌株名的写法差异 |
| 想要项目级的表型汇总 | 无表型字段 | 转向带临床字段的队列资源 |
1.6 一句话判断
如果你要的是一个能把散在各处的数据缝在一起的编号体系,BioProject 是这套体系的中枢;如果你要的是数据本身,它只给你一把钥匙,不开门。
1.7 不适合谁:四条边界
第一,不适合需要数据文件的人。著录页没有任何可下载的科研数据文件,连一份样本清单表都不提供,只有 XML 形式的著录与逐条跳转。把它当作下载站是一个方向性错误。
第二,不适合需要可信度判断的人。著录内容不经过人工事实核查,官方说明只做格式、物种与重复性校验。两个项目写同样的概述不能说明它们是同一件事,一个项目写得很详细也不能说明数据可靠。
第三,不适合需要样本级或个体级信息的人。项目层只到「这批计划用了什么物种、多少样本链接」这一粒度,个体层面的性别、年龄、处理都不在这里,人类个体级数据更是明确不进入开放著录。
第四,不适合把项目编号当唯一引证的人。官方在常见问题里明确建议引用具体数据的编号;只引项目编号,会让核对者多跳一层,且在项目被拆并时失去指向。
§2 数据构成与规格
2.1 一条记录的五块内容
一条项目页的信息排布是固定的,读久了可以按位置找东西,不必逐行看。各块的职责差别明显,混在一起读容易把「提交者写的」当成「系统算的」。
第一块是身份。项目编号、内部数字标识、物种俗名、标题,随后一行是「另有多少个项目与同一物种相关」的横跳入口。这一块是系统生成的,编号不可改,标题在单分离株项目里常由物种名与项目类型自动拼出。
第二块是概述。提交者填写的自由文本,官方只要求足以让使用者理解研究,没有字数下限。有的项目在这里写三五百字,交代研究背景、设计、样本分组与主要发现;有的项目只有一句「某某菌株的基因组测序」。这一段是全页信息密度最不确定的地方。
第三块是属性表。项目编号与外部编号并列(例如同时给出 GEO 系列号),随后是数据类型、样本范围、物种与分类号谱系、资助、登记日期与提交机构。基因组类项目还会多出基因座标签前缀。
第四块是出版。按文献逐条列出标题、期刊、年份与卷期,每条给出 PubMed 标识。这一块由提交者关联,未关联的出版物不会自动出现。
第五块是链接块,标题为 Project Data,是全页最有用也最容易误读的一块。它把关联对象按资源类别分组,每组给出条数与跳转链接。
2.2 链接块的分组结构
链接块的分组大致是三层,层级本身说明了资源类型。
第一层是序列数据。Nucleotide 一行给出去往核酸库的总条数,若含完整基因组还会拆出 WGS master 与 Genomic DNA 两行分别计数。更早的项目会有一行 Capillary Traces,指向毛细管测序时代的 Trace Archive,这一行在新项目里已经不再出现。
第二层是测序实验。SRA Experiments 一行给出关联的测序实验条数,这是绝大多数使用者真正要的东西;点击后进入的是实验列表,不是项目描述。
第三层是出版物与其他数据集。Publications 下分 PubMed 与 PMC 两行;Other datasets 下则按子库罗列具体对象,常见的行包括 BioSample、Assembly、GEO DataSets,某些项目还有 dbVar、GTR 或伞形子项目。
一个典型的多产物项目,链接块会长这样:
| 分组 | 行 | 一条真实记录的计数 |
|---|---|---|
| Sequence data | Nucleotide (Genomic DNA) | 2 |
| Sequence data | Capillary Traces (Trace Archive) | 1 |
| SRA Experiments | SRA Experiments | 3 |
| Publications | PubMed / PMC | 1 / 1 |
| Other datasets | BioSample | 2 |
| Other datasets | Assembly | 1 |
这张表取自一个 2007 年登记的细菌比较基因组项目。计数行由系统扫描生成,提交者不填,所以它反映的是「此刻有多少东西引用了这个编号」,而不是「提交者声称做了什么」。
2.3 记录为零的三种写法
链接块并非总有内容,空缺有三种不同的写法,含义各不相同。
第一种是整块为空并附一句说明:本项目暂无公开数据链接,近期释出的、引用本编号的数据会在数日内补上。这类记录多见于刚登记尚未释出数据的项目,或者由外部库同步过来、尚未建立关联的镜像记录。
第二种是某些行缺席。例如只有 Assembly 没有 SRA Experiments,说明提交者直接提交了组装品而未提交读段,这在早期基因组项目里很常见。
第三种是链接块存在但条数极小,例如只有一条序列。这不算异常,很多单基因或单菌株项目确实只产出一条记录。
三种写法在页面上都是静态文本,没有专门的机器可读标记区分。做批量抓取时不能用「有没有链接块」判断项目是否为空,要按字段解析每一行。
2.4 编号前缀:三条前缀,三座库
编号的五位字母前缀不是随机分配的,它标出这份提交进了哪一座库。
| 前缀 | 受理方 | 所属档案体系 | 对应研究号前缀 |
|---|---|---|---|
| PRJNA | NCBI | GenBank 一侧 | SRP |
| PRJEB | EMBL-EBI | ENA | ERP |
| PRJDB | 日本国立遗传学研究所 | DDBJ | DRP |
后一列值得单独看一眼。同一个项目在项目层与读段层有两套编号:项目层是 PRJ 开头的五字母前缀,研究层是三字母的 SRP、ERP、DRP。两者不是一对一替换关系,而是同一份提交在不同库里的两个视图。SRA 的研究对象本质上是从项目导出的,一个项目可能对应多个研究号,也可能暂时没有。
前缀的区分逻辑可以这样记:第三位字母表示节点,A 表示 NCBI,E 表示 EBI,D 表示 DDBJ;后面的两位是该体系内部的序列段标识。因此看到一个陌生编号,先看第三位就能判断该去哪个站点核对。
2.5 三个前缀在同一界面并存
NCBI 的项目库不只收录自家受理的项目。检索 PRJEB 或 PRJDB 开头的编号,同样能命中记录,页面结构与 PRJNA 记录一致,只是提交机构位置写的是外方机构。
这一点容易被误解成「NCBI 存了全世界的项目」。更准确的说法是:国际核酸序列数据库协作三方约定交换项目著录,任一节点的提交,其余节点都会得到一份著录副本,但编号保持原始样式不变。因此同一个日本项目,在 DDBJ 一侧是母本记录,在 NCBI 一侧是可检索的镜像记录;两边的链接块可能不同步,因为链接是按本地库里的对象扫描生成的。
对使用者的实际影响只有一条:查到一个 PRJEB 或 PRJDB 项目时,若在 NCBI 侧发现链接块偏空,不必判断为项目本身没有数据,应去原始节点再核一次。
2.6 字段清单
高级检索页面把可检索字段全部列出,按字母序排列,数量在二十余个。下表按用途归类,右列说明该字段能不能用来做筛选。
| 字段 | 用途 | 可筛选性 |
|---|---|---|
| Project Accession | 精确取记录 | 强,编号唯一 |
| ProjectID | 内部数字标识 | 强,但对人无意义 |
| Title | 标题文本匹配 | 中,受拼写影响 |
| Description | 概述全文匹配 | 中,长文本召回杂 |
| Organism | 物种名 | 中,菌株名写法不一 |
| Project Data Type | 数据类型标签 | 中,值由提交者选 |
| Project Subtype | 更细的数据子类型 | 中,取值较专 |
| Filter | 若干预置的资源属性筛选 | 视取值而定 |
| Registration Date | 登记日期区间 | 强,可用于时间切片 |
| Submitter Organization | 提交机构 | 中,机构名写法不统一 |
| Grant ID / Funding Agency | 资助编号与资助方 | 中,未填者缺席 |
| Keyword | 关键词 | 弱,覆盖率不稳定 |
| Locus Tag Prefix | 基因座标签前缀 | 强,一对一的短标识 |
| PMID / DOI | 关联文献 | 强,可用于反向找项目 |
| Assembly Accession / Assembly name | 组装号与组装名 | 强,可作反查入口 |
| WGS Accession | 全基因组鸟枪法序列号 | 强 |
| BioProject ID | 与 Project Accession 同义 | 强 |
| Top Bioproject | 上层伞形项目 | 中,仅伞形项目适用 |
| Attribute / Attribute Name | 提交者自定义属性 | 弱,属性名不统一 |
| Organism Properties | 物种侧的属性标记 | 视取值而定 |
| Replicon accession / type / name | 复制子信息 | 弱,仅部分项目有 |
真正在日常检索里靠得住的只有四类:编号类(项目号、组装号、序列号)、日期、文献识别符、物种名。其余字段都受提交者写法影响,做统计前必须先抽样看一遍取值分布,不能假设枚举整齐。
2.7 案例:一个转录组项目的全貌
取一条 2013 年登记的果蝇表达项目,即 PRJNA196804,把它的各块拼起来看,可以看清「描述与链接」是怎样接上的。
#-- 身份块(系统生成)
Accession          PRJNA196804
ID                 196804
Organism           Drosophila melanogaster(分类号 7227)

#-- 描述块(提交者填写)
Title              Gene Expression Analysis of Fat Body of Drosophila
                   melanogaster Subjected to Sir2 Overexpression or
                   Dietary Restriction
Description        (约两百字研究背景 + 六组样本设计与三重复说明)

#-- 属性块
Accession          PRJNA196804; GEO: GSE45974
Data Type          Transcriptome or Gene expression
Scope              Multiisolate
Submission         Registration date: 10-Apr-2013
                   University of Kiel, Germany
Publications       Hoffmann J et al., Aging (Albany NY), 2013

#-- 链接块(系统扫描生成)
Publications       PubMed 1 / PMC 1
Other datasets     GEO DataSets 1
GEO Data Details   Spots 124965;Processed Mbytes 2;Supplementary Mbytes 13
有几处细节值得留意。第一,属性块里的项目编号后面直接跟了 GEO 系列号,说明这一次提交是走 GEO 通道进来的,项目记录由提交 GEO 时自动创建,而非单独登记。第二,没有任何序列数据行,因为表达数据留在 GEO,没有另外提交读段或组装。第三,链接块里出现的「数据量」三行不是项目字段,是 GEO 侧的数据量摘要被拉到项目页展示,它随 GEO 更新而变,不属于著录本体。
这条记录被后面的章节反复用到,用来对照「由数据库自动生成的项目」与「手工登记的项目」在填写深度上的差别。§2.7 的案例在后面的取数路径与使用指引里会再次出现。
2.8 关联子库的分类
关联对象不是随便挂的,按性质可分四类。分清这四类,才知道从一个项目页跳出去会到什么形态的地方。
第一类是数据存放库。SRA 存读段,GEO 存表达与芯片数据,Nucleotide 与 WGS 存序列,Trace Archive 存早期毛细管测序数据,Assembly 存组装产物。这些地方能拿到文件。
第二类是样本描述库。BioSample 存材料属性,一个项目可挂多个样本,样本与项目是多对一。它本身不存数据,只有属性字典。
第三类是文献库。PubMed 与 PMC 是同一批文献的两个视角,前者是文摘,后者可能带全文。项目与文献是多对多。
第四类是受控或专业库。dbVar 存结构变异,GTR 存遗传检测登记,这类库只在特定项目上出现,覆盖面窄。
四类里只有第一类能解决「我要数据」的需求,第二类解决「这批样品是什么」,第三类解决「这个项目发表在哪里」,第四类解决专业检索。一个项目页把这些全放在同一个链接块里,读者要自己按分组判断。
§3 它的身份:谁的库,对谁负责
3.1 名称与实际职能的落差
BioProject 这个名字容易让人以为它管的是「项目」,实际它管的是「项目的登记」。这两件事的差别在于:项目管理意味着对进度、产出与质量负责,登记只意味着对「有一个编号、有一条描述」负责。
官方在常见问题里的原话是,这是一座由提交者驱动的库,提交者对记录的内容与准确性负责,并有责任提供足够的信息让使用者理解研究;提交需通过基本校验与物种审查,此外一般不进入进一步整理。这句话把责任边界划得很清楚:库方保证编号合法、物种名可解析、不与同一提交者的既有记录重复,其余不管。
3.2 三种提交路径与它们留下的痕迹
提交路径不同,著录的样子会有可见差别,这一点对判断记录可信程度有用。
| 路径 | 适用场景 | 典型痕迹 |
|---|---|---|
| 项目提交门户 | 尚未有数据,先占号 | 概述通常是提交者手写,篇幅较完整 |
| 基因组提交门户 | 提交原核或真核基因组 | 数据类型自动置为基因组测序,范围自动置为单分离株,常带基因座标签前缀 |
| 读段提交门户 | 向 SRA 提交测序读段 | 数据类型自动置为原始测序读段,范围自动置为多物种 |
| XML 批量提交 | 机构自有信息系统 | 字段填充最规整,但概述可能沿袭内部命名 |
自动置位的字段是最可靠的字段,因为它们不依赖提交者的判断。反过来说,凡是由提交者手选的字段(数据类型、样本范围、关键词),都要留一层怀疑。
3.3 对谁负责:三层责任
| 责任对象 | 它承担的部分 | 它不承担的部分 |
|---|---|---|
| 提交者 | 发放唯一编号,校验格式与重复,保证编号长期不失效 | 不核对概述是否属实,不追查遗漏的关联文献 |
| 数据库方(SRA、GEO 等) | 按编号自动扫描并挂接对象 | 不为未引用编号的数据补建关联 |
| 下游使用者 | 提供稳定入口与可解析的著录格式 | 不提供质量评级,不担保链接恒久有效 |
这三层叠起来的结论是:项目编号在结构上是可靠的,在语义上不可靠。结构可靠指它唯一、不改写、跨库一致;语义不可靠指它背后写的那些字没有人担责。
3.4 与样本层、运行层的分工
项目层之所以必要,是因为它处在一条三段式链条的顶端,而每一段的职责不同。
| 层级 | 回答的问题 | 基数关系 |
|---|---|---|
| 项目(PRJ 号) | 这批数据属于哪项研究计划 | 一 |
| 样本(样本库编号) | 这份材料取自什么 | 多 |
| 实验与运行(SRA 编号) | 这份材料被怎样测、测了几次 | 更多 |
一个项目可以有几百个样本,每个样本可以有多次实验,每次实验可以有多次运行。这层层展开的结构意味着:仅凭项目编号无法知道数据量级,必须进到链接块看计数,再进到运行层看文件。
链条顶端的另一个后果是命名权。项目名、样本名都由提交者定,两个项目可能用同一个名字(例如都以物种名作标题),所以在做实体合并时,唯一可以依赖的只有编号,不能依赖名字。
§4 它的手艺:编号、校验与自动挂接
4.1 编号是怎样发出来的
编号发放是整套机制里最快的一步。提交通过校验后,编号会在几分钟内以邮件形式返回,不需要人工排队。这意味着编号在数据释出之前就已存在,项目页可以提前被访问,只是内容为空。
编号本身不携带时间或物种信息,只有前缀与流水号。因此不能从编号推断登记先后,只能从登记日期字段读。这一点与某些会带年份编码的标识体系不同,容易误判。
4.2 校验只有三条
官方写明的校验只有三条,量级之小值得单独强调。
第一条是格式。必填字段齐备,编号格式合法,物种名可解析到分类库。
第二条是物种审查。物种名必须对应到分类数据库里的合法节点,这一步防止拼写错误造成的孤儿记录。
第三条是去重。同一提交者的两条记录,只要物种名与菌株、项目类型、资助、机构、外部链接、标题各项全部相同,就判为重复而拒收。任何一项不同即视为新项目。
这三条之外没有内容审核。概述写得对不对、数据类型选得准不准、关联文献有没有漏,都不在检查范围。所以著录的一致性只能靠提交者的自我约束与社群习惯。
4.3 链接的生成逻辑
链接块是自动生成的,机制是反向扫描:不是项目去推数据,而是各档案库在入库时带上项目编号,系统再按编号汇总。这解释了三个现象。
其一,链接有延迟。新释出的数据要等扫描周期跑完才会出现在项目页,页面说明里写的「数日内」就是这个意思。
其二,链接可能只增不减。数据被撤回后链接是否同步清除,取决于各库的撤回流程,页面不承诺即时反映。
其三,镜像记录的链接可能偏少。外方节点的项目在本地只是著录副本,本地库若没有对应的数据对象,链接块自然是空的,这不代表项目没有数据。
4.4 一个例子走完三跳
拿前面 §2.7 的案例走一遍完整路径,能看清三跳各自拿到什么。
第一跳,进项目页,拿到的是背景:这是一项研究 Sir2 过表达与饮食限制对脂肪体转录影响的实验,六组样本,每组三重复,提交机构是德国的一所大学,2013 年 4 月登记。页面上没有任何序列。
第二跳,点链接块里的 GEO DataSets,进入系列页,拿到的是实验设计:平台型号、样本数、处理分组,以及一份可下载的表达矩阵与探针注释。
第三跳,若这项研究另外提交了读段,从 SRA Experiments 进入实验列表,再进运行列表,才能拿到文件清单与下载地址。果蝇这条记录没有这一行,说明它只走了 GEO 通道。
三跳之间,项目层只在第一跳起作用,但它决定了后两跳怎么找。若没有它,第二跳要靠系列号去 GEO 里搜,第三跳要靠样本名去 SRA 里猜。
4.5 接口取数的三种粒度
程序化访问有三个粒度,用途不同。
最粗是全库导出。官方提供批量文件,一次拿到全部著录的 XML,适合建本地镜像或做全量统计,代价是文件大、更新要重新同步。
中等是按检索结果集取。用检索接口先得到编号清单,再用取回接口按清单批量拿 XML,适合按条件切片,例如只取某一年的新登记项目。
最细是单条取回。知道编号就直接按编号取 XML,适合在分析流程里即时补全背景信息。
下面是一段可直接运行的取回示例,展示按编号取回并解析关键字段的做法。
#-- 按项目编号取回著录 XML 并抽取关键字段
import urllib.request
import xml.etree.ElementTree as ET

ACC = "PRJNA196804"
url = ("https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi"
       "?db=bioproject&id=" + ACC + "&retmode=xml")
xml = urllib.request.urlopen(url, timeout=30).read()
root = ET.fromstring(xml)

proj = root.find(".//Project")
acc_id = proj.find("./ProjectID/ArchiveID")
descr = proj.find("./ProjectDescr")
print("编号:", acc_id.get("accession"), "档案:", acc_id.get("archive"))
print("标题:", descr.findtext("Title"))
print("数据类型:", proj.findtext("./ProjectType/ProjectTypeSubmission/"
                                "ProjectDataTypeSet/DataType"))
for pub in descr.findall("Publication"):
    print("关联文献 PMID:", pub.get("id"))
for link in descr.findall("ExternalLink/dbXREF"):
    print("外部库:", link.get("db"), "编号:", link.findtext("ID"))

sub = root.find(".//Submission")
print("登记日期:", sub.get("submitted"), "最近更新:", sub.get("last_update"))
这段代码只用标准库,不依赖第三方包。要注意的是接口会按访问频率做限制,批量取回时应在两次请求之间留出间隔,并在请求头里写明工具名与联系邮箱,这是公共接口的通行约定。
4.6 伞形项目:为了什么而设的第二层
当一个大型计划下面分出若干互不相同的子课题,每个子课题有各自的提交者与数据结构时,会用到伞形项目。
伞形项目不挂数据,只挂子项目。它是唯一需要人工介入的层级:不能自助创建,须写信给支持邮箱说明要把哪些项目聚到一起、理由是什么,由工作人员代为建立。这一限制来自它的性质,聚拢关系一旦被随意自助建立,反而会破坏项目编号作为数据归属依据的确定性。
伞形项目在页面上不显示数据类型与样本范围,只显示类型为伞形项目。链接块里也不出现 SRA、Assembly 这些数据行,因为数据都在子项目上。做统计时要明确是否把伞形计为一个项目,否则同一批数据会被数两次。
4.7 日期与更新
每条记录带两个日期:登记日期与最近更新日期。前者固定,后者随任何字段改动而变。
更新不是自助的。提交者要改字段,须写信给支持邮箱提出请求,而且提交门户里那份最初的提交摘要页不会随之更新,它只是初始提交的记录,不反映后续变更。这造成一个常见困惑:提交者按门户页面判断自己填过什么,与实际库内状态可能已经不一致。
对分析者的含义是:同一编号在不同时间取到的 XML 可能不同,做可复现分析时应在流程里记下取数日期,而不是假设著录不变。
§5 取数:从编号到文件
5.1 四条路径的取舍
| 路径 | 适合的人 | 代价 | 边界 |
|---|---|---|---|
| 网页逐条浏览 | 核对单个项目 | 慢,手工 | 适合抽查,不适合批量 |
| 全库批量文件 | 要建镜像或做全量统计 | 下载量大,需定期重同步 | 只到著录层,不含数据 |
| 检索加批量取回 | 按条件切片 | 需处理接口限流 | 结果集有上限,要分页 |
| 即席单条取回 | 流程内补背景 | 每次都需联网 | 单条延迟低,不适合大批量 |
四条路径背后是同一批著录,区别只在「一次拿多少」。日常分析最常用的是第四条:拿到一个数据编号,反查它的项目,再取项目背景填进分析报告。
5.2 反向查找:从数据编号到项目
实际工作里更常见的起点不是项目编号,而是一个序列号、一个组装号或一篇文献。三条反查路径值得记住。
从序列号反查,用高级检索的序列编号字段直接匹配;从组装号反查,用组装编号字段;从文献反查,用文献标识字段。三条都能落到唯一项目,因为这几类编号在库内是唯一的。
反过来从项目查数据是正向的,靠链接块。正向容易,反向才需要专门设计检索条件,因为项目页不提供「这个项目的数据都在哪些编号下」的完整清单,链接块只给条数与跳转,不给编号枚举。
5.3 一段可用的批量流程
下面这段脚本演示按物种与日期切片,先取编号清单再批量取回,是分析流程里最常用的形态。
#-- 第一步:按物种与登记日期切片,先拿编号清单
curl -s "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi" \
  --data-urlencode "db=bioproject" \
  --data-urlencode 'term=Drosophila melanogaster[Organism] AND 2024:2026[Registration Date]' \
  --data-urlencode "retmax=200" \
  --data-urlencode "retmode=json" \
  | python3 -c "import sys,json; print('\n'.join(json.load(sys.stdin)['esearchresult']['idlist']))" \
  > ids.txt

#-- 第二步:按清单逐条取回 XML,存成一个文件集合
mkdir -p bp_xml
while read -r pid; do
  curl -s "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi?db=bioproject&id=${pid}&retmode=xml" \
    -o "bp_xml/${pid}.xml"
  sleep 0.4
done < ids.txt

#-- 第三步:确认取回数量与清单一致
wc -l ids.txt; ls bp_xml | wc -l
第三步的核对不能省。接口在限流时会返回错误页而非 XML,若不核对,会得到一批看似成功实为空壳的文件。0.4 秒的间隔是为了配合公共接口的频率约定,并非技术要求。
5.4 把 XML 摊平成表
著录是嵌套结构,做分析前要摊平。下面给出一个最小的摊平函数,抽取最常用的六列。
#-- 把一批 XML 摊平成一张表:编号、标题、类型、范围、物种、登记日期
import glob
import xml.etree.ElementTree as ET
import pandas as pd

rows = []
for path in sorted(glob.glob("bp_xml/*.xml")):
    root = ET.parse(path).getroot()
    proj = root.find(".//Project")
    if proj is None:
        continue
    a = proj.find("./ProjectID/ArchiveID")
    d = proj.find("./ProjectDescr")
    t = proj.find("./ProjectType/ProjectTypeSubmission")
    org = t.find("./Target/Organism") if t is not None else None
    sub = root.find(".//Submission")
    rows.append({
        "accession": a.get("accession") if a is not None else None,
        "title": d.findtext("Title") if d is not None else None,
        "data_type": t.findtext("./ProjectDataTypeSet/DataType") if t is not None else None,
        "scope": t.find("./Target").get("sample_scope") if t is not None and t.find("./Target") is not None else None,
        "organism": org.findtext("OrganismName") if org is not None else None,
        "submitted": sub.get("submitted") if sub is not None else None,
    })

df = pd.DataFrame(rows)
df.to_csv("bioproject_index.tsv", sep="\t", index=False)
print(df.shape, df["data_type"].value_counts().head())
摊平之后才能做按类型、按年份、按物种的分组。注意 sample_scope 属性的取值是内部枚举代码而非英文短语,网页上显示的「多分离株」一类文字是渲染结果,与 XML 里的代码不是同一字符串,比对时要先建一张对照。
5.5 别把「取到」当成「有数据」
这是取数环节最容易出错的一步。项目 XML 完整取回,只说明著录存在,不说明背后有任何文件。判断有没有数据,只能看链接块的计数,而链接块在最简的接口返回里可能不包含。
因此一个稳妥的做法是分两步:先用接口取著录,筛出感兴趣的项目,再逐个项目页确认链接块。全自动地把著录批量转成「可用数据集清单」是不可靠的,中间隔着一层只有人才能判断的内容质量。
§6 与库内其他词条的关系
6.1 关系图谱
在库内的一众数据资源之间,BioProject 的位置可以用「索引而不生产」来概括。它不像 SRA 那样存读段,不像 GEO 那样存表达矩阵,不像 Assembly 那样存组装品,但它把这三类以及更多东西串在同一个编号下。
| 库内相关词条 | 与本词条的关系 | 一句话区隔 |
|---|---|---|
| NCBI SRA | 最紧密的下游 | SRA 存读段与运行记录,BioProject 存这批读段属于哪项研究 |
| GEO | 常与项目一对一并存 | GEO 存表达数据与实验设计,自动生成的项目记录只是通道副产物 |
| DDBJ | 三节点之一 | DDBJ 是日本节点,其受理的项目以 PRJDB 前缀出现在项目库 |
| dbGaP | 受控数据的分流口 | 个体级人类数据不进开放项目著录,走受控访问 |
| Assembly | 常见链接目标 | Assembly 存组装产物与统计,项目页只给条数与跳转 |
| 各类策展队列资源 | 下游消费者 | 队列资源自行整理样本与表型,仅引用项目编号作为数据出处 |
这张表里最关键的是第一行。SRA 词条讲的是读段如何组织、如何下载、如何受控;BioProject 讲的是这些读段归谁。两个词条经常被混为一谈,因为一次 SRA 提交的必填项里就包含项目编号,使用者往往以为两者是同一个东西的两层皮。
6.2 与 SRA 的分工要写清
| 维度 | BioProject | SRA |
|---|---|---|
| 存储对象 | 项目著录 | 读段与运行记录 |
| 主键 | PRJ 开头五字母编号 | SRR、SRX、SRP 三类 |
| 记录粒度 | 一个研究计划 | 一次运行 |
| 是否存在文件 | 否 | 是 |
| 访问控制 | 一般公开,少数随数据受控 | 开放与受控并存,人类数据受控 |
| 内容责任 | 提交者自负,不校订 | 提交者自负,有基础质控标记 |
| 典型用途 | 找归属、读背景、建索引 | 下数据、做重分析 |
一句话记住:项目层回答「这是什么研究」,运行层回答「这台机器跑了什么」。做数据下载要从运行层进,做背景理解要从项目层进。
6.3 检索路径
| 你的问题 | 该去哪个词条或入口 | 理由 |
|---|---|---|
| 手里只有一个序列号,想知道出自哪项研究 | 本词条的反查路径 | 序列编号可唯一匹配项目 |
| 想下某项目的原始读段 | SRA 词条 | 项目页只有链接,文件在 SRA |
| 想拿某项目的表达矩阵 | GEO 词条 | 项目页给系列号,矩阵在 GEO |
| 想确认某菌株的样本属性 | 样本库或 SRA 词条 | 属性在样本层 |
| 想找某个实验室的全部项目 | 本词条,按提交机构检索 | 机构字段是项目层独有的 |
| 想限定开放还是受控 | 受控访问库词条 | 项目页不标访问等级 |
| 想拿组装好的基因组序列 | 组装库词条 | 项目页只给组装条数 |
6.4 在数据流转里的位置
把一次典型提交拆开看,项目层处在最前。提交者先登记项目拿到编号,再按编号登记样本,再按编号提交读段与组装。数据释出之后,系统反向把链接补齐。之后下游的策展资源、重处理项目、分析工具开始工作,它们引用的都是项目编号或更细的编号。
这一顺序带来一个使用含义:项目编号在时间上先于数据存在。因此在项目刚登记而数据未释出时,项目页是唯一可查到的信息;等数据释出后,项目页反而成了最简略的一页,详细信息都散到各子库去了。想看全貌,必须把项目页与各子库页拼起来读。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
评估这类库时最容易犯的错,是拿评估数据集的质量尺度来量它:问覆盖率高不高、标注准不准、有没有缺失值处理。这些尺度对 BioProject 不适用,因为它不承载数据,它承载的是「指向数据的那只手」。它对数据质量的任何问题都不负责,也无法负责。
正确的评估框架只有三个:编号体系是否稳定,链接是否完整,著录是否足以让人理解研究的来龙去脉。前两项是机读层面的,第三项完全取决于提交者的自觉。把框架校正过来,后面的每一处扣分才能读懂。
7.1 五维评分
| 维度 | 分数 | 依据 |
|---|---|---|
| 编号稳定性 | 5 / 5 | 编号唯一、不改写、跨节点一致,是整个体系里最硬的一环 |
| 链接完整性 | 4 / 5 | 自动挂接可靠,但有扫描延迟,镜像记录可能偏少 |
| 著录一致性 | 2 / 5 | 概述详略悬殊,类型与关键词由提交者自选,无结构约束 |
| 可机读性 | 4 / 5 | XML 结构规整,字段命名稳定,三十余年不变有利有弊 |
| 内容可信度 | 2 / 5 | 无人工校订,无事实核查,无质量标记 |
五项的分布很不均匀,这不是设计失衡,而是职能所限。编号与结构是它真正在乎的部分,内容不在它的职责里。
7.2 DAIMS 视角下的四条线
| DAIMS 线 | 表现 |
|---|---|
| 数据获取与处理 | 提交由提交者驱动,无策展流程,无内容审核 |
| 数据建模 | 一套固定的描述加链接模型,简单到可以一眼看完,扩展性靠外部链接而非新增字段 |
| 数据溯源 | 编号与登记日期稳定,但著录内容的来源不可追 |
| 数据使用与治理 | 著录公开,底层数据分开放与受控;项目级的治理责任几乎全在提交者 |
四条线里最稳的是建模,最简单也最耐用;最弱的是溯源,因为「谁写的这段概述、依据什么写」这一层不存在。
7.3 已知的、可枚举的局限
第一,概述的详略悬殊。同一年登记的同类项目,有的写清了研究假设与样本分组,有的只有一句名称。这不是个案,而是没有下限规定的必然结果。
第二,数据类型由提交者自选。官方明确说明这个标签只表示初次登记的主目标,不限制后续挂什么数据。所以按类型筛选得到的集合,既可能漏掉「初始标了别的东西、后来补了转录组」的项目,也可能包含「标了转录组但没有转录组数据」的项目。
第三,样本范围字段的取值与直觉不完全对应。官方在说明里给出过专门指引,例如目标是做出单一组装时,即使原始材料来自多个个体,也应选单分离株。这意味着不能把范围字段当作样本数量的指示。
第四,关联文献靠提交者补。未关联的文献不会自动出现,用文献反查项目时,没关联记录的项目就找不到。
第五,镜像记录与母本可能不同步。跨节点查同一项目时,两边的链接块条数可以不同。
第六,伞形项目的计入方式不统一。它在结构上是项目,但不挂数据,做「项目数」统计时必须先声明是否含伞形。
7.4 数字口径的守则
引用这类的规模数字时,有三件事要同时交代:取数时间、统计范围、是否含镜像。
取数时间决定数字,因为库每天在长。统计范围指是否只算开放记录,是否含伞形,是否按物种限定。是否含镜像指是否把 PRJEB 与 PRJDB 记录算进去,这直接影响对「NCBI 收录量」的理解。
三件事不交代,「有多少项目」这句话就没有确定含义。这不是苛求,而是这一层数据本身就在滚动,任何静态数字都会过期。
7.5 它为何能持续:登记成本换来的通用坐标
一个只登记、不校订的库能活下来并成为事实标准,靠的是三件事叠在一起。
其一是必要性。多个档案库把项目登记设为准入前置,想往这些库提交数据,必须先有项目编号。准入即分发,覆盖面自然铺开。
其二是成本。校验只有三条,编号几分钟内自动发出,不需要人工审核队列,因此可以承接每天的大量提交而不积压。
其三是交换。三方节点约定互相交换著录,任一节点受理即可在其余节点见到,避免了三座库各自维护一套互不相通的项目表。
三件事合起来,代价是内容质量不被保证,收益是编号成了整个测序数据生态的通用坐标。这个交易在二十余年里没有改变,说明各方的收益仍然大于成本。§7.5 的这条判断也解释了下文历史沿革里职能为何会从提交入口退成汇总出口。
§8 生态位与历史
8.1 历史沿革
| 时间 | 事件 |
|---|---|
| 2011 年前后 | 项目库上线,作为多项档案提交的前置登记环节 |
| 2012 年 1 月 | 与样本库合并发表方法学论文于《核酸研究》 |
| 2013 年前后 | GEO 与受控人类数据提交改为自动生成项目记录,不再要求单独登记 |
| 2015 年 9 月 | 提交过程支持从资助方系统直接查找资助编号 |
| 2020 年前后 | 公开记录越过八十万条 |
| 2026 年 10 月 | 公开记录逾一百一十万条,库快照每日更新 |
从这条线能读出两件事。其一是增长不靠单点爆发,而是随测序提交量平稳上升,年均增量与测序产出同向。其二是职能的收缩与固化:早年还要单独鼓励提交者登记项目,后来改由其他库的提交流程自动生成,登记本身退化成表单里的一个必填项,项目库因此从「提交入口」变成「汇总出口」。
8.2 与 GOLD 的分工
同样做项目著录的还有美国能源部联合基因组研究所维护的 GOLD。两者的差别在取向:GOLD 面向基因组与微生物组计划的主动编目,带大量策展字段与计划分类;BioProject 面向所有类型数据的被动登记,字段极简。
实际使用中两者常互为补充:查一个微生物基因组计划的研究框架与生态分类,GOLD 更细;查某个编号下面挂了哪些数据、由谁在何时提交,BioProject 更直接。
8.3 在 AI 时代的再定位
近年项目层出现了一类新用途:作为训练语料的元数据骨架。把数据文件按项目编号分组,可以避免同一研究的不同样本被分进训练集与测试集,这是构建评测集时最常见的泄漏来源之一。
这一用法要求项目层提供的东西恰好是它最强的部分:编号稳定、层级关系明确(项目、样本、运行)。同时也会撞上它最弱的部分:项目之间的相似度无法从著录判断,两个概述完全不同的项目可能测的是同一批材料,两个概述高度相似的项目也可能毫无关系。按项目分组只能解决「同一研究的样本不跨集」,不能解决「不同研究的样本是否重复」。
8.4 与策展资源的关系
策展类资源(人工挑选、核对、结构化的数据集合)与项目库不是替代关系。项目库提供的是原始登记的骨架,策展资源提供的是经核对的表层。
正确的组合方式是:用项目库做全覆盖的索引与分组,用策展资源做高置信度的取子集,再让两者通过编号对齐。若只靠项目库,会得到覆盖广但质量参差的集合;若只靠策展资源,覆盖面受人力所限。这条组合逻辑在数据版本管理与泄漏控制上尤其重要。
§9 使用指引
9.1 三种角色的路径
做分析的人路径最短:拿到数据编号,反查项目,读概述确认这批数据说的是自己需要的东西,再回子库取数。重点是第一跳别跳过头,先读概述能省掉后面大量的白下载。§2.7 的案例就是一个提醒:概述里写清了六组样本与三重复,这一句足以让人判断要不要往下走。
做数据工程的人路径最重:需要把项目著录纳入自有目录。要点是三条,一是把项目编号作为唯一外键而不是名字,二是记录每次取数日期,三是把链接块单独存一张表,因为它随时间变动,与著录本体不是一个生命周期。
写综述或审稿的人路径最偏:需要核对论文声明的数据是否真的存在。做法是按项目编号查到页,看链接块里各行的计数,再进子库确认能打开。只看到项目页存在就认为数据可用,是这一环最常见的疏漏。
9.2 一条最短的可用流程
#-- 第一步:确认编号能解析,并看它挂在哪个节点
curl -s "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=bioproject&term=PRJNA196804%5BPRJA%5D&retmode=json"

#-- 第二步:取回著录,确认标题、类型与提交机构与声明一致
curl -s "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi?db=bioproject&id=196804&retmode=xml" \
  | python3 -c "import sys,xml.etree.ElementTree as ET; r=ET.fromstring(sys.stdin.read()); p=r.find('.//Project'); print(p.findtext('./ProjectDescr/Title')); print(p.findtext('./ProjectType/ProjectTypeSubmission/ProjectDataTypeSet/DataType'))"

#-- 第三步:打开网页核对链接块的实际计数(接口简版可能不含该段)
echo "https://www.ncbi.nlm.nih.gov/bioproject/196804"
三步的顺序不能颠倒。先解析再取著录,最后用网页核对链接块,是因为链接块在接口返回里的完整程度不如网页,只有网页能给出准确的分组计数。
9.3 引用方式
引用分两层。
第一层是编号。若要指涉数据,引具体数据的编号(序列号、组装号、运行号),并按官方句式写明「已存入 BioProject 库」与库网址。不要只写一个项目编号了事。
第二层是背景。若分析结论依赖项目的实验设计,应在方法里写明该项目的类型与样本范围,并给出读概述的日期,因为著录可能被更新。
两层合起来,既让人能找到数据,也让人能核对这批数据的研究背景。少了第一层,核对者拿不到文件;少了第二层,核对者不知道这批文件是做什么用的。
§10 AI 使用声明
| 项目 | 说明 |
|---|---|
| 本页 AI 参与程度 | 由 AI 助手依据官方著录页、常见问题页与检索接口返回起草,数字均来自当日库快照 |
| 数字来源层级 | 见附录 B,检索接口返回的计数为一级,著录页文字为一级,论文为二级 |
| 未核实项 | 样本范围与数据类型两者的完整枚举值未取得官方术语表原文,本文只写语义而未穷举代码 |
| 版本信息 | 库快照日期为 2026 年 10 月 28 日,著录页于次日读取 |
| 已知不一致 | 页面说明链接在数日内补上,但未给出具体扫描周期 |
| 访问限制 | 官方帮助书与术语表页在本次核验时可访问性受验证机制影响,相关描述改由著录页与常见问题页交互印证 |
| 适用边界 | 本文只描述著录库本身的结构与边界,不含对任何具体研究结论的评价 |
| 更新机制 | 库每日更新,本文不承诺随库同步刷新 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 「BioProject 里能下到数据」 | 只有跳转链接,无任何科研数据文件 | 著录页仅含描述与链接块;文件在各子库 |
| 「PRJNA 和 PRJEB 是同一个项目的两种写法」 | 前缀标明原始受理节点,编号不改写 | 前缀字母第三位区分 A、E、D 三节点 |
| 「项目数就是数据集数」 | 一个项目可聚多个子项目,也可只登记不挂数据 | 伞形项目不挂数据;部分记录链接块为空 |
| 「项目编号可以放心当数据出处引用」 | 官方建议引用具体数据编号 | 常见问题里有专门的引用句式说明 |
| 「著录是经过校订的」 | 由提交者自负,一般不进入进一步整理 | 常见问题关于校订的问答 |
| 「数据类型字段代表该项目所有数据」 | 只表示初次登记的主目标,不限制后续挂载 | 常见问题关于数据类型的问答 |
| 「样本范围选多分离株就是样本多」 | 范围描述研究对象类别,不是数量 | 常见问题关于范围选择的问答 |
| 「链接块为空说明项目作废」 | 可能只是数据未释出或镜像未同步 | 页面说明数据释出后数日内补上 |
| 「跨节点查到的同一项目内容完全一致」 | 镜像只同步著录,链接按本地库扫描 | 同一项目在不同节点的链接块条数可不同 |
| 「用概述文本判断两个项目是否同一研究」 | 概述详略悬殊,同名不同事常见 | 大量由自动流程生成的记录只有标题级描述 |
| 「伞形项目能自助创建」 | 须向官方申请代为建立 | 常见问题关于伞形项目创建的问答 |
| 「项目编号能看出登记先后」 | 编号只有前缀与流水号,不含日期 | 登记先后只能读登记日期字段 |
FAQ
Q1:BioProject 到底存了什么?
存的是著录:一项研究计划的标题、概述、数据类型、样本范围、物种、资助、提交机构与登记日期,外加一张指向各档案库的链接表。任何碱基、任何读段、任何表达值都不在这里。
Q2:为什么一个项目页上什么都点不出来?
两种可能。一是数据尚未释出,页面会附一句说明,称近期释出的数据会在数日内补上;二是这条记录是从外方节点同步来的镜像,本地库没有对应数据对象,链接自然是空的。
Q3:PRJ 开头的编号有几种?
三种前缀最常见:PRJNA 对应 NCBI,PRJEB 对应 EBI 的 ENA,PRJDB 对应日本 DDBJ。前缀第三位标明受理节点,后面的字母与数字是各体系内部的序列段。
Q4:一个项目能对应几个 SRA 研究号?
没有固定对应。项目层的编号与研究层的编号是两个视图,同一项目可能有多个研究号,也可能暂时没有。SRA 的研究对象本质上是从项目导出,所以不能反过来假设一一对应。
Q5:项目编号会不会被回收或改写?
不会被改写。编号在发放时确定,此后一直指向同一条记录。记录可以被撤回,但编号本身不转给他人,这也是它能当外键用的基础。
Q6:想改自己项目的描述怎么办?
写邮件给支持邮箱提出请求,由工作人员处理。提交门户里那份最初的提交摘要不会随库内更新而变,判断实际状态要看公开的著录页,不看门户页面。
Q7:为什么有的记录有基因座标签前缀?
这一类字段只出现在基因组测序类项目上,由系统在一组项目与样本配对时自动分配,用于注释时的基因编号。它不是所有项目都有,也不是提交者自填。
Q8:能把整个库下载下来吗?
可以,官方提供批量导出文件,格式为逐条记录的 XML。体积不小,更新需定期重同步。若只需要某个切片,走检索接口按条件取反而省事。
Q9:项目页里的数据量数字可靠吗?
那几行来自下游档案库的摘要被拉到这里展示,不由项目层维护。它随下游库更新而变,也只在部分项目上出现,不能当作项目字段使用。
Q10:人类数据也在这套体系里吗?
项目层会有一条记录,但个体级数据不进开放著录。需要个体级基因型与表型的研究走受控访问库,项目记录只作为入口存在,不含可下载内容。
Q11:伞形项目要不要单独统计?
取决于统计目的。若统计的是「研究计划数」,可以把伞形排除,因为它只聚类子项目;若统计的是「记录数」,则包含。任何引用都该说明口径。
Q12:它和 GOLD 该选哪个?
要看需要哪一类信息。要研究框架、生态分类与计划编目,GOLD 更细;要编号归属、数据挂接与提交记录,BioProject 更直接。两者用编号互相印证是很常见的做法。
术语表
| 术语 | 含义 |
|---|---|
| 项目著录 | 一项研究计划的登记记录,含描述与链接两部分 |
| 项目编号 | 以 PRJ 开头的五字母加数字标识,全局唯一且不改写 |
| 镜像记录 | 由其他节点同步来的项目著录,编号保留原始前缀 |
| 伞形项目 | 只聚类数据级项目、不直接挂数据的层级 |
| 分离株 | 从单一材料中分离纯化得到的生物材料,是样本层的基本单位 |
| 样本范围 | 著录字段,描述研究对象是个体、同种多个体、多物种、环境或合成材料 |
| 数据类型 | 著录字段,表示初次登记时的主研究目标,不限制后续挂载 |
| 基因座标签前缀 | 基因组注释时给基因编号用的短前缀,按项目与样本配对分配 |
| 运行 | 一次测序仪上的实际读出,是读段的最小单位 |
| 实验 | 一次建库与测序策略的组合,可含多次运行 |
| 研究号 | 读段层的项目视图,三字母前缀与项目编号并列存在 |
| 全基因组鸟枪法序列号 | 提交基因组测序数据时在序列库一侧产生的序列记录 |
| 毛细管测序 | 早期逐条读序的技术,其数据存放于痕量库 |
| 受控访问 | 需经申请与批准才能取得的数据访问方式,个体级人类数据多属此类 |
| 链接块 | 项目页上按资源类别分组的跳转表,由系统扫描生成 |
| 扫描延迟 | 新释出数据到出现在项目页之间所需的时间,页面称数日内 |
| 分类号 | 物种在分类数据库中的数字标识 |
| 公共接口 | 按请求返回著录的程序化访问方式,有频率限制 |
| 批量导出 | 官方提供的全库著录文件,供镜像与全量统计使用 |
| DAIMS | 数据档案与信息管理系统的评估框架,看采集、建模、溯源与治理四条线 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 公开记录总数 | 1,110,152 | 检索接口库信息 | 一级 |
| 库快照日期 | 2026-10-28 | 同上 | 一级 |
| 可检索字段数 | 二十余个 | 高级检索页字段列表 | 一级 |
| 编号前缀类别 | 三类(PRJNA、PRJEB、PRJDB) | 著录页与外部文档 | 一级 |
| 链接块分组数 | 三类(序列、实验、出版物与其他) | 著录页结构 | 一级 |
| 校验条数 | 三条(格式、物种、重复) | 常见问题 | 一级 |
| 编号发放时长 | 数分钟 | 常见问题 | 一级 |
| 链接补全延迟 | 数日 | 著录页说明 | 一级 |
| 论文发表 | 2012 年,《核酸研究》第 40 卷 D57 至 D63 页 | 文献元数据 | 二级 |
本文只用三类数字:规模(记录总数)、结构(前缀类别、字段数、分组数)、边界(校验条数、延迟)。分布类统计一概不做,原因在附录 B 说明。
附录 B:数字的来源分层
一级:官方页面与接口。 记录总数、库快照日期、字段列表、校验条数、发放时长与延迟说明,均来自当日检索接口返回的库信息与著录页、常见问题页的原文。这类数字随库变动,本文标注了取数日期。
二级:论文。 项目库与样本库的合并方法学论文发表于 2012 年,卷期页码取自文献元数据记录。论文描述的是设计初期的状态,用于说明职能定位,不用于描述当前规模。
三级:未取得。 样本范围与数据类型的完整枚举值本应从官方术语表取得,本次核验时该页受访问机制影响未能读取,本文只按常见问题页的语义描述这两者的含义,未穷举代码值。
另有两类数字刻意不写。一类是分布类,例如各类数据类型的占比、各物种的项目数排行,这类统计受提交者自选字段影响,写出来会造成「看起来精确其实不可靠」的错觉。另一类是跨节点比较类,例如三座库各有多少项目,这需要分别取数并说明口径,本文不承担该工作。
附录 C:完整参考文献
- Barrett T, Clark K, Gevorgyan R, Gorelenkov V, Gribov E, Karsch-Mizrachi I, Kimelman M, Pruitt KD, Resenchuk S, Tatusova T, Yaschenko E, Ostell J. BioProject and BioSample databases at NCBI: facilitating capture and organization of metadata. Nucleic Acids Research, 2012, 40(D1): D57-D63.
- NCBI BioProject 首页,项目定义与入口导航,https://www.ncbi.nlm.nih.gov/bioproject/ ,2026 年 10 月访问。
- NCBI BioProject 常见问题页,提交路径、数据类型、样本范围、校验、编号发放、著录释出与引用句式,https://www.ncbi.nlm.nih.gov/bioproject/docs/faq/ ,2026 年 10 月访问。
- NCBI BioProject 高级检索页,可检索字段清单,https://www.ncbi.nlm.nih.gov/bioproject/advanced ,2026 年 10 月访问。
- NCBI 检索接口库信息与检索返回,用于记录总数、库快照日期与前缀命中检验,https://eutils.ncbi.nlm.nih.gov/entrez/eutils/ ,2026 年 10 月访问。
- NCBI BioProject 著录页样例,PRJNA196804、PRJNA16721、PRJDB1138、PRJEB33487 等,2026 年 10 月访问。
- EMBL-EBI ENA 编号规则文档,项目编号与镜像关系的格式说明,https://ena-docs.readthedocs.io/general-guide/accessions.html ,2026 年 10 月访问。
附录 D:如果只记五件事
第一,它是项目层的登记库,一个编号对应一项研究计划,不存序列也不存读段。
第二,三条前缀分属三座库:PRJNA 是 NCBI,PRJEB 是 EBI,PRJDB 是日本 DDBJ,著录三方交换、编号各自保留。
第三,页面由描述块与链接块组成,前者是提交者写的,后者是系统扫的,两者的可信度不在一个量级。
第四,校验只有格式、物种、重复三条,内容不核,所以概述详略悬殊是常态。
第五,取数据要从链接块跳到 SRA、GEO 或组装库,项目页本身只给钥匙。
编辑说明
本篇的核验时间为 2026 年 10 月 29 日,库快照取自前一日。核验方式为读取项目库首页、常见问题页、高级检索页与多条著录页,并用检索接口核对记录总数、前缀命中的存在性与单条记录的字段结构。编号前缀与镜像关系的表述另以 ENA 官方编号规则文档交叉印证。
未覆盖的内容包括:样本范围与数据类型的完整枚举值(官方术语表页在本次核验中受访问机制影响未能读取),以及链接块的扫描周期具体时长(官方只写数日,未给数值)。文中凡涉及这两处的表述均按语义描述,不写代码值,也不写估算值。
本文只描述著录库本身的结构、规模与边界,不评价任何具体项目的内容,也不构成对使用哪些数据的建议。著录可自由浏览与下载,底层数据的访问政策须按所属子库与具体项目逐项确认。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- gnomad — 共享标签:基因组学与多组学 / 测序数据
- uniprot — 共享标签:基因组学与多组学 / 测序数据
- 1000-genomes — 共享标签:基因组学与多组学 / 测序数据
- encode — 共享标签:基因组学与多组学 / 测序数据
- ega — 共享标签:基因组学与多组学 / 测序数据
- roadmap-epigenomics — 共享标签:基因组学与多组学 / 测序数据
- blueprint — 共享标签:基因组学与多组学 / 测序数据
- pcawg — 共享标签:基因组学与多组学 / 测序数据
- cbioportal — 共享标签:基因组学与多组学 / 测序数据
- kegg — 共享标签:基因组学与多组学 / 测序数据
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
