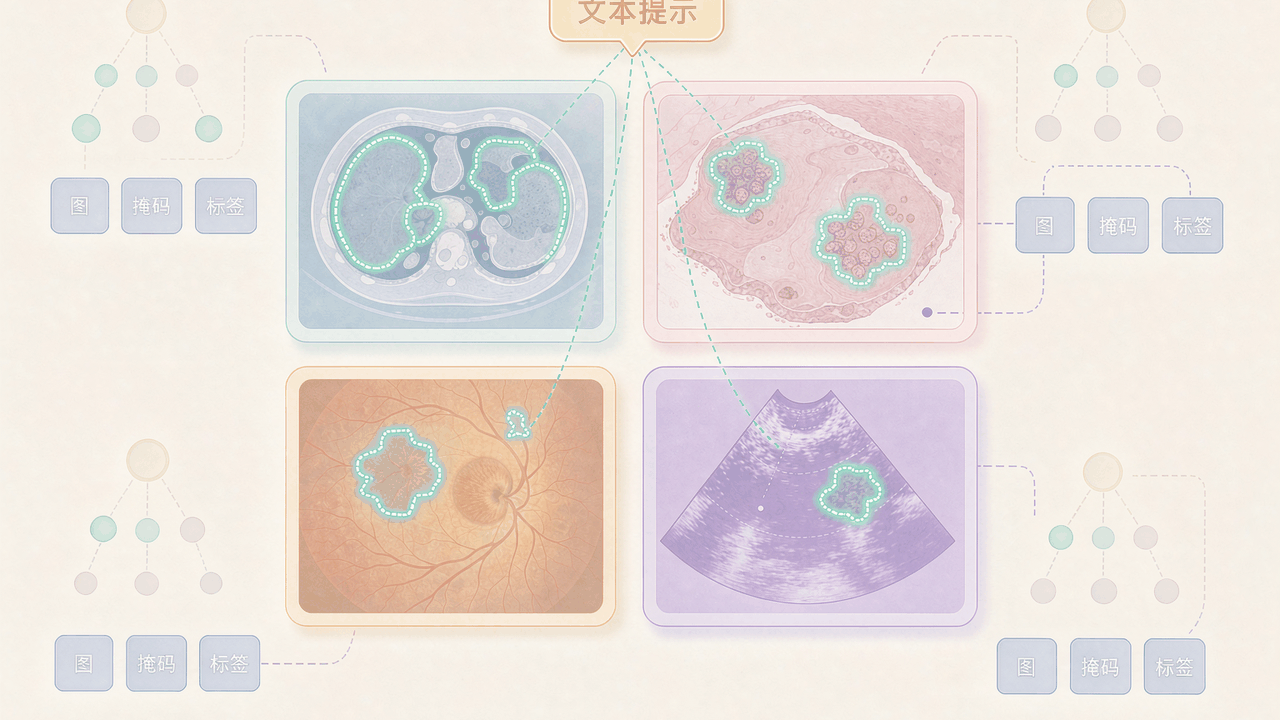
信息速览
INFOBOX — BiomedParseData 一屏速览
维度 内容 本质 微软分割基础模型 BiomedParse 的训练语料集合——45 个公开分割数据集经 GPT-4 本体协调整合成的图像解析(image parsing)数据集;条目主体是数据发布物,模型是背景与产出 团队 Microsoft Research 主导,合作含 University of Washington(Paul G. Allen 学院)与 Providence;16 位作者,一线含 Theodore Zhao、Yu Gu、Jian-Wei Yang、Naoto Usuyama 等,Hoifung Poon 为资深带队人 论文 Nature Methods 22(1):166-176(2025 Jan 刊期,epub 2024-11-18);doi:10.1038/s41592-024-02499-w;PMID 39558098;预印本 arXiv:2405.12971(2024-05-21) 规模 45 源数据集 · 9 模态 · 25 解剖部位 · 110 万图像 · 340 万图像-掩码-标签三元组 · 680 万图像-掩码-描述三元组 · 本体 3 大类 → 15 元类型 → 82 对象类型 获取 HuggingFace microsoft/BiomedParseData——gated 受控访问(登录同意条款后可下载),CC BY-NC-SA 4.0,实测约 204.6 GB、28 个 ZIP 分包(官方注明为处理后全集的子集)标注 源数据集像素级人工/半人工掩码 + GPT-4 生成规范语义标签(canonical label)与同义文本描述(synonymous descriptions);每源随机 80/20 划分,3D volume 不跨划分 评测 102,855 个 held-out 测试三元组上 Dice 全面 SOTA;不规则形状目标 Dice 0.857(较最佳竞争方法 +39.6%);文本嵌入 Silhouette 0.89 版本链 v1(论文版权重)→ CVPR 2025 文本引导 3D 分割挑战赛冠军微调版 → v2(2025-06-30 起分支开发,HF 已上 biomedparse_v2.ckpt) 红线 非商业(NC)+ 相同方式共享(SA);模型仅限研发用途,禁止临床决策使用(README 原文)
§0 导读:这个数据集解决什么问题
医学图像分割(medical image segmentation)领域长期存在一个「三缺一」困境:分割(segmentation)、检测(detection)、识别(recognition)三个任务在传统研究中被拆开处理——分割模型只画轮廓、检测模型只框边界、识别模型只贴标签。想用一个模型同时做三件事,前提是存在一个同时携带三种监督信号的训练数据集,而在这篇论文之前,这样的数据集并不存在。论文原文的表述很直接:「To our best knowledge, no such a dataset exists.」(据我们所知,这样的数据集此前并不存在。)
BiomedParseData 就是为了填补这个空白而构造的数据集:微软研究院团队把 45 个公开的生物医学图像分割数据集整合到一起,用 GPT-4 把各数据集里混乱、非结构化的自然语言标签(有的写「肿瘤」、有的写「tumor」、有的写「enhancing tumor region」)协调到一棵统一的三层本体树上,再为每个规范标签合成一组同义文本描述。最终得到 110 万张图像、340 万个「图像-掩码-标签」三元组、680 万个「图像-掩码-描述」三元组,覆盖 CT、MRI、X-ray、病理、超声、内镜、眼底、皮肤镜与 OCT 九种成像模态、25 个解剖部位。
对 AI-Ready 视角而言,这个数据集有几个值得单独强调的特征:
第一,它是「以模型之名发布的数据发布物」。BiomedParse 模型本身不是数据集——本条目的主体是 BiomedParseData 训练语料,模型是这套语料的直接产出与最佳「质检报告」。这种「模型-语料」双发布结构在基础模型时代越来越常见,检索者需要分清两者各自的许可与获取通道(见 §7)。
第二,它是「gated 受控访问」而非匿名直链。HuggingFace 上必须登录账号、同意使用条款后才能下载。这在 AI-Ready 光谱上处于「注册可取」档位——比申请制(邮件联系作者)自动得多,比公开直链多一道门。检索者做可获取性分级时应记入这一点。
第三,它的「标注」有一半是生成的。像素级掩码来自各源数据集的人工/半人工标注(论文用「stringent inclusion criteria」作为纳入门槛),但规范标签与同义文本描述由 GPT-4 生成。这既是它的高效之处——人工不可能为 340 万三元组逐条写文本描述——也是它需要被审视之处:论文没有披露逐条人工复核的比例。使用文本描述字段训练多模态模型时应意识到这一层来源差异。
第四,它的文本描述不是临床报告。这些描述是围绕分割目标的短语文(如「左心室」「enhancing tumor」「neoplastic cells」),不是放射科报告或病理报告那样的长文本。把它当「影像-报告」数据集用会失望,把它当「影像-短语对齐」语料用才对路。
第五,它已经通过了大规模实战检验。模型在 102,855 个 held-out 测试三元组上建立了九模态分割 SOTA,不规则形状目标 Dice 0.857、较最佳竞争方法提升 39.6%;GitHub 708 星、HF 模型下载过万;2025 年 6 月又在 CVPR 2025 文本引导 3D 生物医学图像分割挑战赛拿了第一。数据集的下游价值有第三方背书。
本条目余下部分按「语料为主体、模型为参照」展开:§2 厘清模型与语料的边界并给出查重定性,§3-§4 交代论文与人物,§5-§6 拆解数据构成与 GPT-4 标注流水线,§7 给出三层资产的获取路径与版本链,§8 汇总评估证据,§9 给出库内互链图谱,§10 是八个已踩过的坑。
0.1 AI-Ready 画像小结(一屏版)
| AI-Ready 维度 | 本语料表现 |
|---|---|
| 机器可读格式 | 优——统一 1024×1024 PNG + 二值掩码 + JSON;命名自描述(模态/部位编码进文件名) |
| 许可明确性 | 优——三层资产各自声明(NC-SA / NC-SA / Apache-2.0),无含糊 |
| 获取自动化 | 良——gated=auto 注册即取,无需人工审批;扣分项:非匿名直链 |
| 文档完备 | 良——论文 + README + DATASET.md 三层文档;扣分项:45 源对账不全、82 类无文本清单 |
| 可复现性 | 中——demo 可跑通;全集复现需逐源获取 + GPT-4 成本自理 |
| 元数据丰度 | 良——本体树、模态、部位、划分纪律均有论文级定义 |
| 标注质量透明度 | 中——掩码层有人工门槛背书;GPT-4 文本层复核比例未披露 |
| 伦理边界 | 优——临床禁用明文、公开数据源、无新增 PHI |
一句话画像:「注册即取的高质量多模态分割语料,文本层带 LLM 生成标签,商用与临床双封锁。」
0.2 前置导览:三类读者的三分钟路径
这部分放在总结前作为「使用说明书」——不同读者进入本条目后的最短路径:
数据工程师(想快速拿数据开训)
§1 七问(获取)→ §5.4 实例格式 → §7.2 gated 实操步骤 → 附录 F 数据组织骨架 → 附录 K 挑包(按模态选 ZIP)。全程约需一次 HF 登录 + 一条 wget 循环。
研究者(要写相关工作/对比实验)
§3.1 双口径存照 → §5.1 硬数字总表 → §8.2 核心结果 → §10 坑点 1/2/5(数字口径)→ 附录 E 来源清单。引用数字全部有原文出处。
策展人/评审(要判断该不该收录、怎么分级)
§2.2 定性声明 → §0.1 AI-Ready 画像 → §7.1 三层许可表 → 附录 O 收录标准对照 → FACTS.md §9 遗留疑点。关注点是「gated 档位」与「子集 vs 全集」的表述精度。
三型读者共同的第一红灯:这不是公开直链数据集——任何把「BiomedParseData」写成「HF 公开直链即取」的二手表述都应被本条目纠正(§10 坑点 6)。
§1 数据集速览:十问十答
一问:BiomedParseData 到底是什么?
微软研究院为训练 BiomedParse 基础模型而构造的训练语料:45 个公开生物医学分割数据集的整合体。每个实例是一张 1024×1024 PNG 图像 + 一个二值掩码 PNG + 该目标的同义文本描述列表 + 三层本体上的规范语义标签。论文称之为「biomedical image parsing dataset」(生物医学图像解析数据集)。
二问:它和 BiomedParse 模型是什么关系?
「原料-成品」关系。BiomedParseData 是训练原料,BiomedParse 是训练产物。两者在 HuggingFace 是两个独立仓库、许可同为 CC BY-NC-SA 4.0 但访问通道独立。本条目以语料为主体——因为语料是可获取的数据发布物,模型不是数据集。
三问:规模有多大?
论文口径:45 个源数据集、9 种成像模态、25 个解剖部位、110 万图像、340 万 image-mask-label 三元组、680 万 image-mask-description 三元组;语义标签覆盖 82 个对象类型(其上还有 15 个元类型与 3 个大类)。HuggingFace 实测仓库体积约 204.6 GB、28 个 ZIP 分包——注意官方说明这是处理后数据的子集,不是全集。
四问:九种模态是哪九种?
CT、MRI、X-ray、病理全切片(pathology)、超声(ultrasound)、内镜(endoscopy)、眼底照相(fundus)、皮肤镜(dermoscopy)、光学相干断层成像(OCT)。官方推理示例按 RGB 七类(病理、X-ray、超声、内镜、皮肤镜、OCT、眼底)加 DICOM/NIFTI 容器(承载 CT/MRI)组织。模态-源数据集的对应映射见 §9.2。
五问:82 个对象类型怎么来的?
GPT-4 构建的三层本体:顶层 3 个大类(organ 器官 / abnormality 异常 / histology 组织学),中层 15 个元类型(如 organ 下的 heart、abnormality 下的 tumor),底层 82 个具体对象类型(如 left heart ventricle 左心室、enhancing tumor 强化肿瘤区)。各源数据集的原始标签被 GPT-4 映射到这棵树上。
六问:许可是什么?能商用吗?
三层资产三种许可:语料与模型权重均为 CC BY-NC-SA 4.0(禁止商业使用、需相同方式共享);代码仓库 Apache-2.0(宽松)。不能商用,模型侧还明确禁止临床使用。见 §7。
七问:怎么拿到手?
HuggingFace microsoft/BiomedParseData,gated 模式:注册/登录 HF 账号 → 打开仓库页同意使用条款 → 即可下载 28 个 ZIP 分包。免登录的快速通道是 GitHub 仓库自带的 BiomedParseData-Demo 小样例。全集复现路径见 §7.3。
八问:文本描述是人工写的吗?
不是。像素掩码来自源数据集的人工/半人工标注;规范标签与同义描述由 GPT-4 生成(「using GPT-4 to generate the canonical semantic label for each segmented object」)。描述是围绕分割目标的短语(名词性目标名),不是临床报告长文本。见 §6。
九问:模型效果有多好?
102,855 个 held-out 测试三元组、九模态全任务:分割 Dice 全面超越 MedSAM(即便后者用 oracle 边界框)与 SAM;不规则形状目标 Dice 0.857、+39.6%;识别任务显著优于 Grounding DINO 系组合(二手口径 F1 +74.5%);无效提示(描述图中不存在的目标)可被统计学检验自动拒绝。见 §8。
十问:现在用什么版本?
三段版本链:v1 为论文版(biomedparse_v1.pt);2025-06-11 有 CVPR 2025 挑战赛冠军微调版(在 junma/CVPR-BiomedSegFM 上微调,docker 镜像发布);2025-06-30 起官方 v2 分支开发中,HF 已上架 biomedparse_v2.ckpt(2025-10-10 更新)。语料侧 2024-12-12 追加过微调用数据集。见 §7.4。
§2 名称与身份:模型、语料与两个容易混淆的边界
2.1 三个名字,三个实体
围绕这条目会出现三个名字,检索者必须先分清:
| 名称 | 实体 | 载体 | 与本条目关系 |
|---|---|---|---|
| BiomedParse | 分割基础模型(权重 + 代码) | HF microsoft/BiomedParse + GitHub microsoft/BiomedParse |
本条目背景与产出,非主体 |
| BiomedParseData | 训练语料集合(图像 + 掩码 + 文本描述 + 规范标签) | HF microsoft/BiomedParseData |
本条目主体 |
| BiomedParseData-Demo | 仓库内小样例(tiny demo subset) | GitHub 仓库 biomedparse_datasets/ 目录 |
免登录快速起步通道 |
论文对语料的自我定性是一句可以整段引用的话:「BiomedParseData was created by synthesizing 45 publicly available biomedical segmentation datasets across 9 imaging modalities, comprising 1.1 million images, 3.4 million image-mask-label triples, and 6.8 million image-mask-description triples.」(BiomedParseData 由 45 个公开生物医学分割数据集跨 9 种成像模态整合而成,含 110 万图像、340 万图像-掩码-标签三元组与 680 万图像-掩码-描述三元组。)
2.2 为什么条目主体是语料而不是模型
本库收录对象是「可获取的数据发布物」。BiomedParse 模型是一组权重文件(biomedparse_v1.pt、biomedparse_v2.ckpt)加推理代码,它不是数据集;而 BiomedParseData 是一个独立的、可下载的、有明确许可条款的数据仓库。因此:
- 条目 slug 用
biomedparse(检索习惯),但 frontmatter 与正文反复锚定主体为 BiomedParseData 训练语料集合; - 模型的架构、训练与评估只作为「语料质量的下游证据」与「获取路径的参照物」出现;
- 引用论文时同时给出两条 DOI 线索:论文 DOI(10.1038/s41592-024-02499-w)与语料仓库 URL(huggingface.co/datasets/microsoft/BiomedParseData)。
这套定性在开工阶段已完成查重核验:数据库内检索 biomed|parse|sam 仅命中 biomedica(rid 734,欧洲生物医学影像平台,不同实体)与 mtsamples(rid 350,医疗转录语料,不同实体);writing/ 目录下虽有多个分割类条目目录,但唯一的 biomedparse 目录是本条目撰写工作区自身。结论:不构成撞库,可成稿。
2.3 与 BIOMEDICA 的区分(高频混淆点)
biomedica(rid 734)与本条目名字前缀相同、都做「生物医学影像 + 文本」,但两者毫无血缘:
| 维度 | BIOMEDICA(rid 734) | BiomedParseData(本条目) |
|---|---|---|
| 主体机构 | 欧洲生物医学影像档案联盟(ECBDC 脉络) | Microsoft Research |
| 语料构成 | 影像-报告配对(放射学报告长文本) | 影像-掩码-短语描述三元组 |
| 主要用途 | 影像-文本多模态预训练 | 分割/检测/识别联合训练 |
| 文本来源 | 临床报告原文 | GPT-4 生成的目标短语描述 |
| 规模口径 | 百万级影像-报告对 | 110 万图像 / 340 万 / 680 万三元组 |
两库检索者在「影像-文本对齐」需求下会同时命中这两个条目——互链时应写明「文本性质不同:报告长文本 vs 目标短语」,避免误用(详见 §9.1)。
2.4 与 MedSAM / SAM 的区分
BiomedParse 常被拿来与 MedSAM、SAM 比较,三者的数据侧差异值得写进检索心智:
- SAM(Meta AI):通用域分割基础模型,1100 万掩码的 SA-1B 语料,无生物医学特化,需要点/框提示;
- MedSAM(自适应版):把 SAM 适配到医学域,仍需边界框提示,且训练语料是各模态分开的分割集;
- BiomedParse(本语料的产出):文本提示驱动、三任务联合、九模态统一——其可能性直接来自 BiomedParseData 的「掩码 + 规范标签 + 描述」三通道监督结构。
一句话:SAM 系的提示是几何的(框/点),BiomedParse 的提示是语义的(文本),而语义提示的训练前提正是这套被本体协调过的语料。
2.5 身份档案卡
- 正式名:BiomedParseData
- 所属模型:BiomedParse
- 发布机构:Microsoft Research(GitHub org: microsoft)
- 论文标题:A foundation model for joint segmentation, detection and recognition of biomedical objects across nine modalities
- 语料仓库创建:2024-10-22(HF API 实测 createdAt)
- 模型仓库创建:2024-11-04(HF API 实测 createdAt)
- 代码仓库创建:2024-05-18(GitHub API 实测)
- 条目 slug:biomedparse
- 本库 URL 占位:https://www.qianfanghub.com/ai-ready-dataset/biomedparse/953
2.6 同名与近名检索景观(防混淆清单)
以「biomed/parse/segment」为词根检索本库与公开网络时,会撞上一批名字相近的实体。逐一列出并划清边界:
| 名称 | 实体 | 与本条目关系 |
|---|---|---|
| BiomedParse | 微软分割基础模型 | 本语料的产出模型(本条目背景) |
| BiomedParseData | 本条目主体语料 | —— |
| BiomedParseData-Demo | 仓库内微型样例 | 免登录起步通道 |
| BIOMEDICA / biomedica(734) | 欧洲生物医学影像-报告平台 | 不同实体(报告文本 vs 目标短语) |
| BiomedGPT | 同期医学基础模型(另一团队) | 不同模型,无语料血缘 |
| MedSAM / SAM | 提示式分割模型 | 竞品对比对象(§2.4) |
| mtsamples(350) | 医疗转录文本语料 | 名字含「med」但纯文本域,无图像 |
| TotalSegmentator(422) | CT 全身分割工具与数据 | 本语料的上游源之一 |
| BiomedParse v2 | 官方在研新版本 | 版本关系(§7.4),非独立实体 |
检索建议:在本库内用 slug biomedparse 直达本条目;在外部检索时用全称 BiomedParseData + HuggingFace 可直接命官方仓库,避开同名模型新闻的噪声。
§3 论文与时间线:从预印本到 Nature Methods 的六个月
3.1 论文双口径存照
| 口径 | 内容 |
|---|---|
| 期刊版 | Nature Methods, 22(1):166-176, 2025 Jan 刊期;epub 2024-11-18;doi:10.1038/s41592-024-02499-w;PMID 39558098 |
| 预印本 | arXiv:2405.12971,v1 于 2024-05-21 上线(本次核证实抓 v3 HTML 全文) |
| PMC | 无开放存档(Semantic Scholar 标注 openAccessPdf status=CLOSED;PubMed 无 PMCID) |
| 官方短链 | aka.ms/biomedparse-paper(重定向到 Nature 页) |
预印本比期刊版早约六个月,两版的核心数字(45 数据集、110 万图像、340 万/680 万三元组、102,855 测试三元组)保持一致。期刊版摘要采用「over 6 million triples of image, segmentation mask and textual description」的约数口径——它对应正文 680 万描述三元组,而非 340 万标签三元组;引用时按需选择口径并注明(详见 §10 坑点 5)。
3.2 发布时间线(官方 README News 逐条实录)
| 日期 | 事件 |
|---|---|
| 2024-05-18 | GitHub 仓库创建(GitHub API createdAt) |
| 2024-05-21 | arXiv 预印本 v1 上线 |
| 2024-10-22 | HuggingFace 数据集仓库(BiomedParseData)创建 |
| 2024-11-04 | HuggingFace 模型仓库(BiomedParse)创建 |
| 2024-11-18 | 论文正式上线 Nature Methods |
| 2024-11-22 | 新增 DICOM 推理 notebook 中的负预测 p 值示例 |
| 2024-12-03 | 新增 RGB 与 NIFTI 推理 notebook 示例 |
| 2024-12-05 | target_dist.json 改为从 HuggingFace 自动下载 |
| 2024-12-12 | 向 HF 数据仓库追加微调(finetune)用数据集;训练加入随机旋转增强 |
| 2025-01-09 | 全对象识别脚本精修并附 notebook |
| 2025-06-11 | CVPR 2025 Text-guided 3D Biomedical Image Segmentation Challenge 第一名:模型在 junma/CVPR-BiomedSegFM 挑战赛数据集上微调,发布 docker 镜像,官方要求致谢原挑战赛 |
| 2025-06-30 | v2 分支启动:代码与模型大版本更新中(「Stay tuned for future completion of the v2 code and model」) |
| 2025-10-10 | HF 模型仓库 lastModified:biomedparse_v2.ckpt 已上架 |
3.3 数据仓库自身的更新线
HF 数据集仓库(BiomedParseData)的时间线与模型侧不同步,独立记录:
- created 2024-10-22(先于论文上线近一个月,配合 arXiv 版即可取数);
- 2024-12-12 追加微调数据(README News 对应条目);
- lastModified 2025-04-20(HF API 实测,为本文撰写时点的最新变更);
- downloads 532 / likes 64(2026-10-09 抓取时点,gated 仓库的下载计数只统计同意条款后的取数,偏低是常态)。
3.4 论文的可用性承诺(原文存照)
Data availability 一节的原文承诺:「We will provide access to BiomedParseData or scripts to reproduce BiomedParseData from the original datasets, upon publication of this manuscript.」(论文刊发后,我们将提供 BiomedParseData 的访问,或从原始数据集复现 BiomedParseData 的脚本。)
Code availability 一节:「BiomedParse will be made fully available upon publication, including the model weights and relevant source code for pre-training, fine-tuning, and inference.」(模型权重与预训练、微调、推理的全部源代码将在刊发后完全公开。)
两条承诺的兑现情况:代码与权重——已兑现(GitHub + HF 双仓库);语料——部分兑现(HF 托管的是处理后子集 28 个 ZIP;「复现脚本」路线对应 GitHub 的数据预处理代码与 DATASET.md 源清单,但官方未提供一条命令跑完 45 个源的自动化流水线)。
§4 机构与人物:微软医疗影像生态的集中出手
4.1 机构构成
- Microsoft Research:主体机构。BiomedParse 属于微软医疗健康 AI 生态(与 LLaVA-Med、GigaPath 同属其生物医学基础模型布局;二手报道称本项目与 University of Washington 及 Providence 医疗系统合作)。
- University of Washington(Paul G. Allen School of Computer Science & Engineering):合作机构(作者 Sheng Wang 教职所在;二手报道口径)。
- Providence(美国大型医疗系统):合作方(二手报道口径,一手论文作者单位以 Nature 页为准——本次核证因 Cloudflare 拦截未能直抓 Nature 页作者单位栏,已按 arXiv 版与二手报道交叉)。
4.2 作者名单(Semantic Scholar 16 人全名单)
- Theodore Zhao(第一作者,微软)
- Yu Gu(微软,LLaVA-Med 系核心成员)
- Jian-Wei Yang(微软,SEEM 一作系)
- Naoto Usuyama(微软)
- Ho-Hin Lee(微软)
- Sid Kiblawi
- Tristan Naumann(微软)
- Jianfeng Gao(微软,多模态大模型负责人级)
- Angela Crabtree
- Jacob Abel
- Christine Moung-Wen
- Brian Piening
- Carlo Bifulco(Providence 脉络的分子肿瘤学专家)
- Mu-Hsin Wei
- Hoifung Poon(微软 healthcare ARC 负责人,团队资深带队人,通常为通信作者)
- Sheng Wang(UW)
GitHub 官方 BibTeX(键 zhao2025foundation)作者列到 “Crabtree, Angela and Abel, Jacob and others” 截止,卷期页码 22(1):166-176, 2025——与 PubMed 口径一致。
4.3 团队的方法论指纹
从作者构成可以看出这个项目的三个血统特征:
- SEEM 系:Jian-Wei Yang 是通用分割基础模型 SEEM 的一作,BiomedParse 直接采用 SEEM 架构做底座(论文 Methods 原文「BiomedParse adopts a modular design under the SEEM architecture」);
- LLaVA-Med 系:Yu Gu、Naoto Usuyama、Hoifung Poon 来自微软生物医学多模态大模型 LLaVA-Med 团队,对「用 GPT-4 清洗医学文本」的套路驾轻就熟;
- 临床背书:Carlo Bifulco、Brian Piening 等带来 Providence 系统的临床与分子肿瘤学视角,保证 82 类对象本体的临床可用性。
4.4 资源热度快照(2026-10-09 抓取)
| 资产 | 指标 | 数值 |
|---|---|---|
| GitHub microsoft/BiomedParse | stars | 708 |
| GitHub microsoft/BiomedParse | forks | 104 |
| HF microsoft/BiomedParse | downloads | 10,785 |
| HF microsoft/BiomedParse | likes | 116 |
| HF microsoft/BiomedParseData | downloads | 532 |
| HF microsoft/BiomedParseData | likes | 64 |
4.5 社区衍生生态
HF 平台上已出现挂接 BiomedParse 权重的 Spaces 应用(API 实测至少三个):tardellirs/model-pulse、kernel-luso-comfort/BiomedParse、Leyogho/Core-AI-IMAGE——覆盖模型状态监测、在线推理与通用医学影像处理三类玩法。社区衍生是「模型-语料」双发布结构的典型 downstream 信号:应用挂的是权重,但权重的能力上限由语料决定。
此外,CVPR 2025 挑战赛微调版走的则是另一条分发路径(docker 镜像 + 致谢要求),说明官方对不同场景采取了「HF 权重(研究)+ 容器镜像(赛事复现)」的双轨供给。检索者引用时注意区分:日常研究引 HF 权重即可;复现挑战赛成绩必须用官方 docker 镜像与 junma/CVPR-BiomedSegFM 数据集,并按官方要求致谢挑战赛。
§5 数据构成与规格:45 个源、9 种模态与三层本体
5.1 硬数字总表(论文口径 vs 平台实测)
| 指标 | 论文口径 | 来源 |
|---|---|---|
| 源数据集数量 | 45 个公开分割数据集 | 论文正文(「synthesizing 45 publicly available biomedical segmentation datasets」) |
| 成像模态 | 9 种 | 论文标题与摘要 |
| 解剖部位 | 25 个(anatomic sites) | 论文正文(「spanning 9 imaging modalities and 25 anatomic sites」) |
| 图像总量 | 1.1 million(110 万) | 论文正文 |
| image-mask-label 三元组 | 3.4 million(340 万) | 论文正文 |
| image-mask-description 三元组 | 6.8 million(680 万) | 论文正文 |
| 对象类型 | 82 specific types(上覆 15 meta + 3 大类) | 论文正文 |
| 训练/测试划分 | 每源 80% / 20% 随机 | 论文 Methods |
| 测试集规模 | 102,855 个 held-out 三元组 | 论文正文(五处出现,交叉一致) |
| HF 仓库实测体积 | 204,621,176,313 字节 ≈ 204.6 GB | HF API usedStorage(2026-10-09) |
| HF 托管分包 | 28 个 ZIP(官方注明为子集) | HF API siblings |
| HF 模型仓库体积 | 6,264,070,200 字节 ≈ 6.26 GB | HF API usedStorage |
5.2 九种模态与官方命名口径
论文摘要只说「nine imaging modalities」,完整模态列表需从两处官方材料拼合:
- 官方 README 推理示例(一手):RGB notebook 覆盖「Pathology, X-ray, Ultrasound, Endoscopy, Dermoscopy, OCT, Fundus」七类,另有 DICOM 与 NIFTI notebook 承载 CT/MRI 等体数据模态;
- 二手汇编(bio.rodeo):CT、MRI、X-ray、pathology、endoscopy、ultrasound、fundus、dermoscopy、OCT——正好九种,与 README 拼合结果一致。
成稿采用的九模态清单:CT、MRI、X-ray、病理全切片、超声、内镜、眼底照相、皮肤镜、OCT。
5.3 三层对象本体:3 → 15 → 82
论文 Methods 对本体的描述原文:「This ontology encompasses three main categories (histology, organ, abnormality), 15 meta-object types, and 82 specific object types.」
| 层级 | 数量 | 示例 |
|---|---|---|
| 第 1 层:大类 | 3 | organ(器官)/ abnormality(异常)/ histology(组织学) |
| 第 2 层:元类型 | 15 | organ 下的 heart;abnormality 下的 tumor;histology 下的 gland 等 |
| 第 3 层:对象类型 | 82 | left heart ventricle(左心室)、enhancing tumor(强化肿瘤区)、neoplastic cells(肿瘤细胞)等 |
本体构建方式:先由 GPT-4 生成候选层级结构与对象命名(「we first used GPT-4 to generate a preliminary hierarchical structure for biomedical image analysis and propose candidate names for individual object types」),再经人工整理定稿。每个对象类型挂一组同义文本描述用于训练。
5.4 实例格式与命名约定(官方 README 一手规格)
每个数据实例包含三件东西:
- 1024×1024 PNG 图像(RGB 或灰度转 RGB);
- 二值掩码 PNG(像素值非零即前景;一图可挂多掩码对应多目标);
- 文本描述列表(该分割目标的同义短语集合)+ 三层本体规范标签。
文件命名约定(官方硬性规格):
- 图像:
[IMAGE-NAME]_[MODALITY]_[SITE].png,如Part_1_516_pathology_breast.png; - 掩码:
[IMAGE-NAME]_[MODALITY]_[SITE]_[TARGET].png,TARGET 中空格替换为+(如chest+tube),TARGET 内禁止下划线; - 训练目录结构:
train/、train_mask/、train.json、test/、test_mask/、test.json。
这套命名把模态与解剖部位编码进文件名,是典型的 AI-Ready 设计——不依赖外部元数据表即可自描述。检索者做子集抽取时可以直接按文件名过滤。
5.5 源数据集清单(官方 DATASET.md 全表实录)
官方 DATASET.md 共列出 34 个唯一来源(CDD-CESM 在表中重复出现一次)。按模态归类转写如下(URL 均为 DATASET.md 原文所附):
CT(8 个)
| 源数据集 | 官方给出 URL |
|---|---|
| amos22 | https://amos22.grand-challenge.org/ |
| MSD (Medical Segmentation Decathlon) | http://medicaldecathlon.com/ |
| KiTS23 | https://github.com/neheller/kits23 |
| BTCV | https://www.synapse.org/#!Synapse:syn3193805/wiki/217790 |
| COVID-19 CT | https://www.kaggle.com/datasets/andrewmvd/covid19-ct-scans |
| LIDC-IDRI | https://wiki.cancerimagingarchive.net/display/Public/LIDC-IDRI |
| AbdomenCT-1K | https://github.com/JunMa11/AbdomenCT-1K |
| BraTS2023 | https://www.synapse.org/#!Synapse:syn51156910/wiki/621282 |
MRI(5 个)
| 源数据集 | 官方给出 URL |
|---|---|
| ACDC | https://www.creatis.insa-lyon.fr/Challenge/acdc/databases.html |
| M&Ms | https://www.ub.edu/mnms/ |
| PROMISE12 | https://doi.org/10.1016/j.media.2013.12.002 |
| LGG | https://www.kaggle.com/datasets/mateuszbuda/lgg-mri-segmentation |
| BraTS2023 | (与 CT 共用,多模态源) |
X-ray(5 个)
| 源数据集 | 官方给出 URL |
|---|---|
| COVID-QU-Ex | https://www.kaggle.com/datasets/anasmohammedtahir/covidqu |
| QaTa-COV19 | https://www.kaggle.com/datasets/aysendegerli/qatacov19-dataset |
| SIIM-ACR Pneumothorax Segmentation | https://www.kaggle.com/datasets/vbookshelf/pneumothorax-chest-xray-images-and-masks |
| Chest Xray Masks and Labels Dataset | https://datasetninja.com/chest-xray |
| COVID-19 Radiography Database | https://www.kaggle.com/datasets/tawsifurrahman/covid19-radiography-database |
超声(3 个)
| 源数据集 | 官方给出 URL |
|---|---|
| CAMUS | https://www.creatis.insa-lyon.fr/Challenge/camus/index.html |
| BUSI | https://scholar.cu.edu.eg/?q=afahmy/pages/dataset |
| US Simulation & Segmentation | https://www.kaggle.com/datasets/ignaciorlando/ussimandsegm |
眼底(3 个)
| 源数据集 | 官方给出 URL |
|---|---|
| REFUGE | https://bitbucket.org/woalsdnd/refuge/src |
| G1020 | https://www.dfki.uni-kl.de/g1020 |
| DRIVE | https://drive.grand-challenge.org/ |
OCT(1 个)
| 源数据集 | 官方给出 URL |
|---|---|
| OCT-CME | https://www.kaggle.com/datasets/zeeshanahmed13/intraretinal-cystoid-fluid |
皮肤镜(2 个)
| 源数据集 | 官方给出 URL |
|---|---|
| ISIC 2018 | https://challenge2018.isic-archive.com/task1/ |
| UWaterlooSkinCancer | https://uwaterloo.ca(Skin Cancer Detection, Vision and Image Processing Lab) |
病理(2 个)
| 源数据集 | 官方给出 URL |
|---|---|
| GlaS | https://warwick.ac.uk/fac/cross_fac/tia/data/glascontest/ |
| PanNuke | https://jgamper.github.io/PanNukeDataset/ |
内镜(2 个)
| 源数据集 | 官方给出 URL |
|---|---|
| PolypGen | https://www.synapse.org/#!Synapse:syn26376615/wiki/613312 |
| NeoPolyp | https://www.kaggle.com/c/bkai-igh-neopolyp/data |
乳腺 X 线(2 个)
| 源数据集 | 官方给出 URL |
|---|---|
| FH-PS-AOP | https://zenodo.org/records/7851339 |
| CDD-CESM | https://www.cancerimagingarchive.net/collection/cdd-cesm/ |
其他(3 个)
| 源数据集 | 官方给出 URL |
|---|---|
| FUMPE | https://figshare.com/collections/FUMPE/4107803/1 |
| TotalSegmentator | https://github.com/wasserth/TotalSegmentator |
| Chest Xray Masks and Labels Dataset | (已列 X-ray 组,此处不重复计数) |
DATASET.md 的口径声明原文:「These datasets are provided pre-formatted for convenience. For additional information about the datasets or their licenses, please reach out to the owners.」(这些数据集为方便起见提供预格式化版本;有关数据集或其许可的更多信息,请联系原所有者。)
5.6 34 与 45 的缺口
论文说 45 个源数据集,DATASET.md 只列 34 个唯一来源。缺口的可能解释:论文计数含 HF 分包中存在但 DATASET.md 未列出的源(HF 的 28 个 ZIP 包名与上表比对,BreastUS.zip、LGG.zip、MMs.zip、MSD.zip、Radiography.zip、CXR_Masks_and_Labels.zip、UWaterlooSkinCancer.zip 等均能对上,但 FH-PS-AOP.zip、FUMPE 等的对应关系需要逐包核验);也可能部分源被合并统计。官方未给出 45 个源的完整对账表——引用「45」时建议同时注明官方清单仅列 34 个唯一来源(见 §10 坑点 3)。
5.7 源数据集的托管平台与许可特征
34 个唯一源分属约 7 类平台,各自的许可特征决定了「复现全集」时的合规工作量:
| 平台 | 语料内代表源 | 许可/获取特征 |
|---|---|---|
| Kaggle | COVID-19 CT、LGG、COVID-QU-Ex、QaTa-COV19、SIIM-ACR、COVID-19 Radiography、NeoPolyp、OCT-CME、US Sim&Seg | 多为开放下载但许可各异(部分 CC BY-NC、部分自定义);需 Kaggle 账号 |
| Synapse | BTCV、PolypGen、BraTS2023 | 需注册并签使用条款;BraTS 系另有挑战赛注册要求 |
| TCIA(癌症影像档案) | LIDC-IDRI、CDD-CESM | 多需签署 Data Usage Agreement(DUA);数据本身公开 |
| grand-challenge | amos22、DRIVE | 挑战赛注册制;部分数据需参赛或申请 |
| 学术机构官网 | ACDC、M&Ms、CAMUS、BUSI、GlaS、G1020 | 通常学术免费、禁商用;下载渠道分散且可能失效 |
| GitHub/项目页 | KiTS23、AbdomenCT-1K、TotalSegmentator、PanNuke | 多为 CC 系或自定义开源许可;脚本式下载依赖外部稳定性 |
| Zenodo/figshare/bitbucket | FH-PS-AOP、FUMPE、REFUGE | DOI 存档型,获取稳定;许可逐条核对 |
检索者视角的结论:34 源没有任何一源要求付费,但「注册+签条款+参赛」三类门槛叠加后,全集复现的行政成本远高于数据成本——这正是官方选择在 HF 只托管子集的现实原因(见 §7.3)。
§6 标注流水线:GPT-4 如何把 45 个杂乱标签变成一棵本体树
6.1 纳入门槛:只收像素级标注
论文对源数据集设了硬性纳入标准(原文「stringent inclusion criteria」):
- 每张图像必须经过人工或半人工的像素级分割(manually or semi-manually segmented at the pixel level);
- 每个分割对象在数据集描述中有名称(a name was available for each segmented object)。
第一条排除了弱监督/框级/点级数据集;第二条保证了「掩码 → 标签 → 文本」链条的起点存在。这是整套语料质量的地基:GPT-4 只做文本层的协调,不做掩码的生成——掩码全部来自源数据集的人工标注。
6.2 3D 转 2D:切片化预处理
CT、MRI 等 3D 体数据被预处理为平面内 2D 切片(in-plane 2D slices),与其他 2D 模态统一。论文 Discussion 诚实记录了代价:「BiomedParse currently treats non-2D modalities such as CT and MRI by reducing them to 2D slices, thus failing to utilize the spatial and temporal information in the original modalities.」(当前把 CT/MRI 等非 2D 模态降为 2D 切片,未能利用原始模态的空间与时间信息。)——v2 的 3D 方向(CVPR 2025 挑战赛即 3D 分割)正是对这一局限的回应。
6.3 划分纪律:80/20 与 volume 级防泄漏
- 每个源数据集随机 80% 训练 / 20% 测试;
- 同一 3D volume 的所有切片强制落入同一划分(「Slices from each 3D volume always appear in the same split to prevent information leakage」)。
这条纪律值得单独强调:切片级随机划分会造成训练集与测试集包含同一患者的相邻切片,指标虚高。BiomedParseData 在论文声明层面明确排除了这种泄漏。检索者复用该语料做自己的实验时,应保持这一划分原则而非重新随机打乱。
6.4 GPT-4 的三件事
GPT-4 在流水线中承担三项文本工作(论文原文逐条):
- 本体构建:「use GPT-4 to create a three-layer biomedical object ontology」——生成 3 大类 → 15 元类型 → 82 对象类型的候选层级;
- 规范标签生成:「using GPT-4 to generate the canonical semantic label for each segmented object」——把各源数据集的原始标签(同义词、拼写变体、粒度不一的描述)映射到统一标签;
- 同义描述合成:为每个规范标签生成一组 synonymous textual descriptions,把 340 万标签三元组扩成 680 万描述三元组。
三件事的共同本质:把 45 个数据集各自为政的文本约定折叠进一个可控词表。这正是大规模异构数据集整合里最费人工的环节。
6.5 主会话 brief 线索「GTEP/TMPT」的核证结论
派单材料提示核证「GTEP/TMPT 等聚合标注」。本次核证对该缩写做了四源全文检索:
| 来源 | 检索结果 |
|---|---|
| arXiv v3 全文(183 KB HTML 实抓) | GTEP 0 命中;TMPT 0 命中 |
| GitHub 官方 README(12.5 KB 全文) | 0 命中 |
| 官方 DATASET.md(5.6 KB 全文) | 0 命中 |
| HF 数据集卡 description(API 抓取) | 0 命中 |
结论:GTEP/TMPT 无法核证,不进入正文术语体系。 论文对「聚合标注」的实际提法即 §6.4 的三件事(GPT-4 本体构建、规范标签生成、同义描述合成)。派单线索中的该缩写按误记处理并存照(见 §10 坑点 2 与 FACTS.md §9)。同样地,派单材料称「44 个原始数据集」,论文原文为 45——以论文为准(坑点 1)。
6.6 描述字料的边界:短语,不是报告
同义描述是围绕分割目标的名词短语(如「neoplastic cells」「inflammatory cells」「left heart ventricle」),不是放射/病理报告的长段文本。这决定了语料的正确用法:
- 适合:文本提示分割(text-prompted segmentation)、影像-短语对齐、目标级 zero-shot 识别、提示词鲁棒性研究;
- 不适合:报告生成(report generation)、临床 NLP、长文档视觉问答。
与库内 BIOMEDICA(rid 734,影像-报告对)形成互补而非竞争——两者在「影像-文本」光谱的不同位置(详见 §9.1)。
6.7 质量声明与未披露项
- 已披露的质量控制:像素级纳入门槛、volume 级防泄漏划分、GPT-4 本体协调;
- 未披露:GPT-4 生成标签/描述的逐条人工复核比例;各源数据集掩码质量的重审结果;82 类对象在 340 万三元组上的分布直方图(论文正文以图示呈现,未见逐类计数表)。
引用本语料时建议保留这一层不确定性声明——尤其当下游任务对标签精度敏感时。
6.9 方法学定位:LLM 协调标签是不是「新范式」
把本语料的构造方法放到数据集工程的方法谱里看,它代表了一个清晰的转折点:
- 前一世代(约 2015-2022):跨数据集整合靠人工映射表——每个源写一个「原始标签 → 统一标签」的对照 CSV,典型如 MSD 十项全能的逐任务独立、TotalSegmentator 的器官清单。人工映射精确但不可扩展,跨 45 个源的标签空间人工成本爆炸;
- 本语料的做法(2024):LLM(GPT-4)承担「理解杂乱标签 → 映射到本体 → 生成同义扩展」的三步,人工只做本体骨架审核。340 万三元组的文本层协调在人工时代是不可想象的工程量;
- 同时期平行案例:微软自家 LLaVA-Med 用 GPT-4 从 PMC 文献生成图文指令数据;本语料是同一方法论在「掩码语料」上的落地——LLM 不碰掩码,只碰文本。
对数据策展人的启示:本案例给出了「LLM 协调标签」的完整可查模板(本体三层结构、纳入门槛、防泄漏划分、同义扩展),但也暴露了模板的软肋——生成内容的复核比例未披露。复用此范式时,「人工抽检率」应作为一等公民写进数据卡,而不是留白。
§7 获取与许可:三层资产、三种门、一条版本链
7.1 三层资产与各自的大门
| 资产层 | 载体 | 许可 | 门槛 |
|---|---|---|---|
| 训练语料 | HF microsoft/BiomedParseData |
CC BY-NC-SA 4.0 | gated=auto:登录 HF 账号 + 同意条款 → 自动放行 |
| 模型权重 | HF microsoft/BiomedParse |
CC BY-NC-SA 4.0 | gated=auto(同上);README 明文限研发用途、禁临床 |
| 代码 | GitHub microsoft/BiomedParse |
Apache-2.0 | 无门槛,直接 clone |
三层许可的分工逻辑:代码宽松(Apache-2.0 利于生态扩散),数据与权重用同一 NC/SA 许可(阻止直接商用与闭源衍生)。引用或集成时注意 SA 条款——衍生数据集需以相同许可共享。
7.2 gated 通道实操步骤
- 注册/登录 HuggingFace 账号;
- 访问
huggingface.co/datasets/microsoft/BiomedParseData; - 页面会出现使用条款确认区(gated=auto,无需人工审批等待);
- 同意后即可下载仓库内 28 个 ZIP 分包(ACDC.zip、amos22.zip、BreastUS.zip、CAMUS.zip、CDD-CESM.zip、COVID-19_CT.zip、COVID-QU-Ex.zip、CXR_Masks_and_Labels.zip、DRIVE.zip、FH-PS-AOP.zip、G1020.zip、GlaS.zip、ISIC.zip、kits23.zip、LGG.zip、LIDC-IDRI.zip、LiverUS.zip、MMs.zip、MSD.zip、NeoPolyp.zip、OCT-CME.zip、PanNuke.zip、PolypGen.zip、QaTa-COV19.zip、REFUGE.zip、Radiography.zip、siim-acr-pneumothorax.zip、UWaterlooSkinCancer.zip);
- 每包解压后为 §5.4 所述的图像/掩码/JSON 描述结构。
HF 包名与 DATASET.md 源清单的对读发现两个额外的包:BreastUS.zip(乳腺超声)与 LiverUS.zip(肝脏超声)在 DATASET.md 34 源表中没有对应行——进一步佐证 34/45 缺口(见 §5.6 与坑点 3)。
7.3 全集复现路线(论文承诺的另一半)
论文 Data availability 承诺二选一:「provide access to BiomedParseData or scripts to reproduce BiomedParseData from the original datasets」。实际落地情况:
- HF 托管 = 处理后子集(28 包,约 204.6 GB);
- GitHub 仓库提供数据预处理代码(
biomedparse_datasets/目录)、源清单(DATASET.md)与 80/20 划分约定; - 无一条命令跑完 45 源的官方自动化流水线——全集复现需按 DATASET.md 逐源下载原始数据(各源许可独立,如 TCIA 系需签 DUA)、跑预处理脚本、再自行执行 GPT-4 协调(GPT-4 调用成本自理)。
对多数检索者,现实的可复现单元是「HF 子集 + demo」;「45 源全集」是研究级工程。AI-Ready 评级时应按「子集可取、全集需复现」双轨表述。
7.4 版本链全景
| 版本 | 时间 | 内容 | 载体 |
|---|---|---|---|
| v1(论文版) | 2024-11 | 论文配套权重 biomedparse_v1.pt |
HF 模型仓库 |
| CVPR 2025 挑战赛版 | 2025-06-11 | 在 junma/CVPR-BiomedSegFM 数据集上微调的 3D 特化版;docker 镜像发布;官方要求致谢原挑战赛 | 挑战赛(codabench 5651)+ Google Drive 镜像 |
| v2(开发中) | 2025-06-30 起 | 代码 + 模型大版本更新;biomedparse_v2.ckpt 已于 HF 上架(2025-10-10 lastModified) |
GitHub v2 分支 + HF |
语料侧版本事件:2024-12-12 向 HF 数据仓库追加微调数据集(v1 语料的增量);2025-04-20 数据仓库最后一次元数据变更(截至抓取时点)。官方建议使用最新版模型(「We recommend using the latest version of the model」)。
7.5 快速起步与在线体验
- 免登录 demo:GitHub 仓库
biomedparse_datasets/BiomedParseData-Demo——微型抽样集,可跑通训练/评估全流程; - 在线 demo 页:microsoft.github.io/BiomedParse;
- Colab:官方
inference_colab_demo.ipynb一键推理; - 推理 notebook 三件套:RGB(七类 2D 模态)、DICOM(含负预测 p 值示例)、NIFTI(体数据切片)。
7.6 使用红线(README 原文存照)
「The model described in this repository is provided for research and development use only. The model is not intended for use in clinical decision-making or for any other clinical use, and the performance of the model for clinical use has not been established.」(本仓库所述模型仅供研究与开发使用。该模型不用于临床决策或任何其他临床用途,其临床使用性能尚未确立。)
使用者在论文致谢、产品边界声明与伦理审查材料中都应复制这条红线。NC 许可叠加临床禁用,构成双层限制。
7.7 检索与核证的环境实录(供复现本条目核验)
本次核证过程遭遇的环境限制与绕行路径,供后续复核者复用:
| 目标 | 直连结果 | 可用路径 |
|---|---|---|
| HuggingFace 主站 | 被封锁 | hf-mirror.com(API 端点 /api/datasets/...、/api/models/... 正常;dataset 卡 raw 文件因 gated 需登录不可取) |
| GitHub raw README | curl 超时(偶发) | cdn.jsdelivr.net/gh(@main 固定分支抓取,稳定) |
| Nature 论文页 | Cloudflare「Client Challenge」 | 改用 arXiv HTML 全文(arxiv.org/html/2405.12971v3 直接可抓)+ PubMed/Semantic Scholar API |
| PubMed/NCBI | 正常 | eutils esearch/esummary 直连可用 |
| HF gated 数据卡全文 | 需登录 | 用 API 的 description 字段(非 gated 部分摘要)+ GitHub DATASET.md 交叉 |
结论:本条目的全部一手核证都在上述约束下完成,核验脚本级路径见附录 E 来源清单。
§8 评估与基准:102,855 个三元组上的三任务成绩单
8.1 评测设计
- 规模:102,855 个 held-out 测试 image-mask-label 三元组(论文正文五处交叉一致);
- 覆盖:9 模态全量(「held-out set comprising 102,855 test instances (image-mask-label triples) across 9 imaging modalities」);
- 对比方法:MedSAM(两种提示模式:oracle 边界框与 Grounding DINO 生成框)、SAM(同两模式)、Grounding DINO(纯检测);
- 统计检验:paired t-test(bio.rodeo 二手口径 p<10^-4)。
8.2 核心结果
- 分割:Dice 全面第一——即使 MedSAM 使用 oracle 边界框(人类级提示上限)也被超越(论文原文「outperforming prior best methods such as MedSAM and SAM, even when they were equipped with oracle bounding box as input」);
- 不规则形状目标:Dice 0.857,较最佳竞争方法 +39.6%(论文原文「attaining a 0.857 Dice score that is 39.6% higher than the best-competing method」)——联合学习对形态复杂的对象(肿瘤、腺体、出血区)收益最大;
- 识别(recognition):无需用户提示即可同时分割并标注图中全部对象;F1 较 Grounding DINO 提升 74.5%(bio.rodeo 二手口径,未经一手核证,引用需注明);
- 检测(detection):从文本提示生成边界框并输出掩码,不规则目标优势同上;
- 无效输入拒绝:对描述图中不存在目标(如在皮肤镜图像中要求「左心室」)的提示,通过 Kolmogorov-Smirnov 检验预测像素概率分布自动拒绝——这是「防幻觉」设计(bio.rodeo 二手口径 precision 0.93 / recall 1.00 / AUROC 0.99);
- 嵌入质量:BiomedParse 文本嵌入区分细粒度细胞类型的 Silhouette 分数 0.89,显著高于原生 PubMedBERT——本体协调确实把语义空间「拉直」了。
8.3 架构存照(评估的载体)
| 组件 | 实现 | 初始化 |
|---|---|---|
| 整体框架 | SEEM 架构模块化设计(image encoder + text encoder + mask decoder + meta-object classifier) | — |
| 图像编码器 | Focal(Focal Transformer 系) | 预训练 checkpoint |
| 文本编码器 | PubMedBERT | 生物医学域预训练 |
| 掩码解码器 | 图文特征交叉注意力 → 像素级概率图 | 随训练 |
| 元对象分类器 | 15 元类型粗粒度语义监督,与掩码解码器联合训练 | 随训练 |
「meta-object classifier 参与 image encoder 联合训练」是 SEEM 移植的关键改动——粗语义与细掩码互相正则,这正是论文主张的 joint learning 机制。
8.4 第三方实战背书
- CVPR 2025 Foundation Models for Text-guided 3D Biomedical Image Segmentation Challenge 第一名(2025-06-11,codabench 编号 5651)——3D 场景下经微调再夺冠,部分回应了 2D 化局限;
- HF 模型 downloads 10,785 / likes 116、GitHub stars 708(2026-10-09);
- 生态衍生应用(HF Spaces 三个:model-pulse、BiomedParse、Core-AI-IMAGE)。
8.5 引用结果时的三条守则
- 分割与不规则形状数字(102,855、0.857、+39.6%)出自论文原文,可直接引用;
- F1 +74.5%、p<10^-4、0.93/1.00/0.99 出自二手汇编(bio.rodeo),引用必须标注二手来源;
- 所有对比结论限定在论文评测的模型清单内,不可外推为「全面 SOTA」。
8.6 三个分割基础模型的数据侧对比
把 SAM、MedSAM、BiomedParse 的训练语料设计并排看,能更清楚地看到本语料的差异化选择:
| 维度 | SAM(Meta) | MedSAM | BiomedParse(本语料产出) |
|---|---|---|---|
| 语料规模 | 1100 万掩码(SA-1B) | 百万级医学图像-掩码 | 110 万图像 / 340 万标签三元组 |
| 模态 | 通用自然图像 | 多种医学模态 | 9 种生物医学模态统一 |
| 监督通道 | 掩码(无语义标签) | 掩码 | 掩码 + 规范标签 + 文本描述(三通道) |
| 提示形态 | 点/框(几何) | 框(几何) | 文本(语义) |
| 标签体系 | 无(类别无关分割) | 无统一标签 | 三层本体 82 类 |
| 整合方式 | 数据引擎自动标注 | 逐集收集 | GPT-4 本体协调 45 源 |
| 文本理解 | 无 | 无 | PubMedBERT + 本体对齐 |
核心洞察:SAM 系的「类别无关」让掩码规模可以堆到千万级,但放弃了语义;BiomedParseData 用「三通道监督」换来了语义提示能力,代价是掩码规模收缩到 340 万三元组、且文本层依赖 LLM 生成质量。两条路线没有绝对优劣,但下游任务形态完全不同——几何提示交互式分割选 SAM 系,语义提示自动化批处理选 BiomedParse 系。
8.7 评测数字的跨论文可比性提示
把本语料相关的评测数字与其他论文对比时,注意三个「口径陷阱」:
- 测试集不同:102,855 是本论文私有的 held-out 划分,与 MedSAM 原论文、TotalSegmentator 原论文的测试集互不重合——跨论文 Dice 不可直接排名,只能参考同论文内的相对比较;
- 提示条件不同:「MedSAM + oracle bbox」与「MedSAM + 自动框」是两条完全不同的成绩线,引用时要写明提示条件;
- Dice 聚合层级不同:按数据集聚合、按模态聚合、按目标类型聚合会得到不同均值——论文图表以模态/数据集分组呈现,二手转述的单一「平均 Dice」需谨慎。
实操建议:跨模型比较一律回到同论文内的对照表(附录 N 的 oracle bbox 与 NMS 基线设计是关键上下文);跨论文引用时标注「不同测试集,仅示意」。
§9 生态与互链:本语料在数据集地图上的位置
9.1 库内互链点(rid 实查)
| 库内条目 | rid | 互链理由 | 强度 |
|---|---|---|---|
| totalsegmentator | 422 | DATASET.md 源清单在列(TotalSegmentator 是 45/34 源之一)——本语料的直接上游 | ★★★ |
| biomedica | 734 | 同为「生物医学影像+文本」,但文本性质相反(报告长文本 vs 目标短语)——光谱互补 | ★★ |
| chexmask-cxr-segmentation-data | 602 | X-ray 胸片分割同域(CXR_Masks_and_Labels.zip 对应 Chest Xray Masks and Labels 源在列) | ★★ |
| chest-x-ray-segmentation | 601 | X-ray 分割任务同域 | ★ |
| heart-lung-segmentations-data | 610 | 胸部器官分割同域 | ★ |
| lung-segment-mimic-cxr | 613 | 胸片肺分割同域 | ★ |
检索路径建议:从 totalsegmentator(422) 进入 → 看「通用 CT 全身分割」与本语料 CT 子集的关系;从 biomedica(734) 进入 → 看「影像-文本」两种文本形态的分野;从 chexmask(602) 进入 → 对比单一模态深度数据集与九模态广度语料的设计取舍。
9.2 模态-源数据集-库内条目三方映射
| 模态 | 语料内主要源 | 库内/写作区相关条目 |
|---|---|---|
| CT | amos22、MSD、KiTS23、BTCV、LIDC-IDRI、AbdomenCT-1K、BraTS2023 | totalsegmentator(422) |
| MRI | ACDC、M&Ms、PROMISE12、LGG、BraTS2023 | —(库内暂无 MRI 专条互链强候选) |
| X-ray | COVID-QU-Ex、QaTa-COV19、SIIM-ACR、Chest Xray Masks、COVID-19 Radiography | chexmask(602)、chest-x-ray-segmentation(601)、heart-lung(610)、lung-segment-mimic-cxr(613) |
| 超声 | CAMUS、BUSI、US Sim&Seg、BreastUS、LiverUS | —(写作区 ultrasound-nerve-segmentation 未入库,不作 rid 互链) |
| 眼底 | REFUGE、G1020、DRIVE | — |
| OCT | OCT-CME | — |
| 皮肤镜 | ISIC 2018、UWaterlooSkinCancer | — |
| 病理 | GlaS、PanNuke | — |
| 内镜 | PolypGen、NeoPolyp | — |
(写作区另有多模态与病理家族条目可作第二层互链,但与本语料为「任务域相邻」而非「数据血缘」,互链文案需写明区别。)
9.3 外部生态坐标
- 上游:45 个公开分割数据集(Kaggle、Synapse、TCIA、grand-challenge、Zenodo、figshare、GitHub 等多源);
- 同级:LLaVA-Med(同为微软生物医学多模态,语料为图文对)、GigaPath(微软病理基础模型,WSI 域);
- 下游:BiomedParse 模型族(v1/CVPR 版/v2)、HF Spaces 衍生应用、CVPR 2025 挑战赛生态;
- 官方入口:aka.ms/biomedparse-paper(论文)、microsoft.github.io/BiomedParse(demo)、HF 双仓库、GitHub 主仓库。
9.4 互链文案建议(供入库与互链模块使用)
- 指向 totalsegmentator(422):「BiomedParseData 的官方源数据集清单在列 TotalSegmentator——本语料的直接上游之一;反向看,TotalSegmentator 条目可作为本语料 CT 子集的细粒度延伸阅读。」
- 指向 biomedica(734):「同为生物医学影像+文本语料,但文本形态互补:BIOMEDICA 携带放射学报告长文本,BiomedParseData 携带 GPT-4 协调的目标短语描述——报告生成选前者,文本提示分割选后者。」
- 指向 chexmask-cxr-segmentation-data(602) 等胸片分割家族:「单一模态(X-ray)深度数据集与九模态广度语料的设计取舍对照;Chest Xray Masks and Labels 源同时出现在两者谱系中。」
- 指向 chest-x-ray-segmentation(601)、heart-lung-segmentations-data(610)、lung-segment-mimic-cxr(613):「任务域相邻(胸部 X 光分割)互链,非数据血缘——这四个条目与 BiomedParseData 无共同源数据集,仅任务重叠。」
§10 避坑清单:八个已踩过的坑
坑点 1:数据集数量「44 vs 45」——以论文 45 为准。
派单线索与部分二手转述写「44 个原始数据集」。arXiv v3 全文两处独立表述均为 45(「combining 45 biomedical image segmentation datasets」「synthesizing 45 publicly available biomedical segmentation datasets」),Semantic Scholar 摘要与 bio.rodeo 汇编同为 45。成稿一律写 45;「44」按误记存照于 FACTS.md。
坑点 2:GTEP/TMPT 缩写查无实据——不要写进正文。
四源全文检索(arXiv v3、README、DATASET.md、HF 卡)均为 0 命中。若引用来源称语料含「GTEP/TMPT 聚合标注」,实为对 GPT-4 本体协调流程的不准确转述。正确表述:「GPT-4 三层本体构建 + 规范语义标签生成 + 同义描述合成」(见 §6.4)。
坑点 3:34、45、28 三个数字各有所指。
论文全集口径 45 个源;官方 DATASET.md 仅列 34 个唯一来源(CDD-CESM 重复一次);HF 实际托管 28 个 ZIP 且官方注明是子集(另有 BreastUS、LiverUS 两包在 DATASET.md 无对应行)。三个数字不可混用——说「语料含 45 源」时必须紧跟「官方公开清单列 34 源、HF 托管 28 包子集」的限定。
坑点 4:模型不是数据集——条目主体必须锚定语料。
BiomedParse 是分割基础模型;若把条目写成模型介绍,就脱离了本库「数据发布物」的收录边界。凡涉及模型的段落,落点都应回到「语料的构造质量与下游证据」。
坑点 5:「600 万三元组」是哪种三元组?
论文摘要口径「over 6 million triples of image, segmentation mask and textual description」对应正文 680 万描述三元组;正文另有 340 万标签三元组。两个口径并存且差一倍——引用时写明「680 万描述口径(摘要)/340 万标签口径(正文)」,避免被审稿人当数字事故。
坑点 6:gated 不等于公开直链。
HF 数据仓库 gated=auto——需要登录并同意条款。做「可获取性分级」时归入「注册可取」档,不要写成「公开直链即取」;同样地,下载计数 532 偏低是 gated 的自然结果,勿据此低估语料影响力(模型侧 downloads 10,785 可作参照)。
坑点 7:CC BY-NC-SA 的 NC 与临床禁用是两层限制。
数据与权重均为 NC(禁商用)+ SA(相同方式共享);模型 README 另有研发专用、禁临床的明文。商用集成或临床部署两个方向都此路不通——挑选下游项目前先过这两道闸。
坑点 8:3D 模态是切片化的——别当体数据处理。
CT/MRI 在语料中是平面内 2D 切片(论文明言),且同一 volume 切片强制同 split。直接把切片当独立 3D 样本重建体数据、或重新做切片级随机划分,都会破坏官方设计(前者引入伪 3D,后者制造泄漏虚高)。
§11 总结
11.1 三句话总结
- BiomedParseData 是微软把 45 个公开分割数据集用 GPT-4 本体协调成的九模态训练语料——110 万图像、340 万标签三元组、680 万描述三元组、82 类对象、25 个解剖部位;
- 它以 HF gated 发布(CC BY-NC-SA 4.0,约 204.6 GB 子集),配套论文载 Nature Methods(2024-11 上线),其产出模型 BiomedParse 在 102,855 个测试三元组上建立九模态分割 SOTA 并在 CVPR 2025 挑战赛夺冠;
- 它的 AI-Ready 特质是「命名自描述 + 三通道监督 + 注册可取」,代价是 NC/SA 许可、临床禁用红线与「子集可取、全集需复现」的获取落差。
11.2 适合谁
- 训练/微调文本提示医学分割模型(text-prompted segmentation)的团队;
- 研究「本体协调/标签归一」方法学的数据工程团队——这是 45 源整合的最完整公开案例之一;
- 需要多模态广度(9 模态 25 部位)做泛化基准的研究者;
- 做影像-短语对齐、提示词鲁棒性、零样本目标识别的实验者。
11.3 不适合谁
- 需要商业部署的团队(NC 许可 + 临床禁用双层封死);
- 需要影像-报告长文本的任务(报告生成、临床 NLP)——请转库内 biomedica(734);
- 需要 3D 体数据训练的团队(语料是 2D 切片化的;3D 需求参考官方 v2 方向或挑战赛数据集);
- 无法注册 HF 账号或无法接受 gated 条款的匿名批量抓取场景。
11.4 30 秒决策卡
| 你的需求 | 走向 |
|---|---|
| 快速跑通文本提示分割 | GitHub BiomedParseData-Demo(免登录)+ Colab demo |
| 拿全量子集训练 | HF gated 下载 28 个 ZIP(登录 + 同意条款) |
| 复现 45 源全集 | DATASET.md 逐源获取 + 官方预处理脚本(工程量大,各源许可另查) |
| 报告长文本多模态 | 不适用 → biomedica(734) |
| 商用产品 | 不适用(NC + SA + 临床禁用) |
| 只需要权重做推理 | HF microsoft/BiomedParse(gated,CC BY-NC-SA 4.0,v2 ckpt 已上架) |
FAQ(高频问答 37 问)
A. 基础认知
Q1:BiomedParseData 是数据集还是模型?
是数据集——训练语料集合。BiomedParse 是用它训练出的模型。本条目主体是语料。
Q2:为什么叫 parsing(解析)而不是 segmentation(分割)?
论文把「分割+检测+识别」的联合任务统一命名为 image parsing(图像解析)——一次前向同时输出掩码、框与标签。BiomedParseData 为这三个任务同时提供监督。
Q3:45 个源数据集里有哪些著名成员?
MSD(Medical Segmentation Decathlon)、LIDC-IDRI、BraTS2023、KiTS23、amos22、ISIC 2018、PanNuke、GlaS、REFUGE、DRIVE、TotalSegmentator 等——多数是各自模态的标杆公开集。
Q4:有多少图像来自 CT?
论文未按模态披露图像分布,仅给出总量 110 万与九模态覆盖。CT 源有 7-8 个(含 MSD、amos22 等大体量源),但逐模态计数表未公开。
B. 数据与获取
Q5:直接能下载多少数据?
HF 上 28 个 ZIP、约 204.6 GB(官方注明为处理后子集)。全集需自行复现。
Q6:gated 流程要等多久?
gated=auto 模式,同意条款后即时放行,无人工审批。
Q7:可以只下单个模态吗?
可以——ZIP 按源数据集分包,按 §5.5 模态映射挑对应包即可;包内再按文件名 [MODALITY]_[SITE] 过滤。
Q8:掩码是什么格式?
二值 PNG(像素非零即前景),1024×1024,与图像同名加 _[TARGET] 后缀。
C. 标注与方法
Q9:GPT-4 生成的标签可靠吗?
掩码层不经过 GPT-4(全是源数据集人工标注);GPT-4 只做文本层协调(标签归一 + 同义描述)。论文未披露逐条人工复核比例——对标签文本敏感的任务建议抽样自检。
Q10:文本描述有多少种说法?
680 万 image-mask-description 三元组对应 340 万 image-mask-label 三元组——平均每标签约 2 条同义描述。
Q11:可以重新划分训练/测试集吗?
技术可行,但必须保持「同一 3D volume 切片不跨划分」原则,否则指标虚高(论文原文明确此纪律)。
Q12:82 个对象类型的完整列表在哪?
论文图 1a 与补充材料以图示呈现;官方未提供 82 类的逐类文本清单——实际可用类别以模型 BIOMED_CLASSES 常量与 target_dist.json 为准。
D. 许可与使用
Q13:能用在公司的产品里吗?
不能。数据与权重均 CC BY-NC-SA 4.0(NC 禁商用、SA 需相同方式共享);模型另明文禁止临床使用。Apache-2.0 只覆盖代码仓库。
Q14:发表论文需要引用什么?
引用论文(doi:10.1038/s41592-024-02499-w);若用 CVPR 2025 挑战赛版模型需额外致谢挑战赛(官方要求)。
Q15:衍生数据集必须开源吗?
SA(ShareAlike)条款要求衍生数据集以相同许可共享——构建闭源衍生集不符合许可。
E. 版本与维护
Q16:v2 什么时候正式发布?
2025-06-30 官方启动 v2 分支(「Stay tuned for future completion」),biomedparse_v2.ckpt 已上架 HF(2025-10-10 更新),但 v2 代码与文档截至抓取时点未宣告完结。跟踪 GitHub v2 分支即可。
F. 方法与对比(续)
Q17:这个语料和 SA-1B(SAM 的语料)哪个更大?
掩码数量上 SA-1B(1100 万)更大;但监督通道维度上 BiomedParseData 更丰富(掩码+标签+描述三通道 vs 纯掩码)。规模比较必须限定维度,见 §8.6 对照表。
Q18:为什么用 GPT-4 而不是人工写标签映射?
45 个源、340 万三元组的标签空间人工映射成本爆炸;GPT-4 一次完成「理解→映射→同义扩展」三步。代价是复核比例未披露(§6.7)。
Q19:GPT-4 版本升级后标签会变吗?
论文未披露所用 GPT-4 快照版本。本体已定稿为 82 类,复现时用新一代模型生成描述可能与官方语料存在措辞漂移——严格复现应使用官方发布的描述文件而非重新生成。
Q20:语料里有儿科技据吗?
论文与数据卡均未按年龄分组披露。源数据集以成人为主(如 LIDC-IDRI、ACDC 成人队列),儿科专用源未见——本条目 patient_tags 从保守标注「成人」。需要儿科分割数据者应另行检索。
Q21:掩码是实例级还是语义级?
二值掩码按「图像×目标」成对发布:一图可挂多掩码(每目标一个二值图),文件名以 TARGET 后缀区分。语义级合并掩码需使用者自行叠加。
Q22:能用于视频分割吗?
不能。语料全部为静态 2D 图像(含 3D 体数据的切片化),无时序标注。
Q23:语料覆盖的 25 个解剖部位有清单吗?
论文以图示(Supplementary Figure 2)呈现,未提供逐部位文本清单。可从源数据集推断:心(ACDC/CAMUS/M&Ms)、脑(BraTS/LGG)、肺(LIDC/Covid 系)、腹(BTCV/amos22/KiTS)、前列腺(PROMISE12)、乳腺(BUSI/BreastUS)、皮肤(ISIC)、眼底与视网膜(REFUGE/G1020/DRIVE/OCT-CME)等。
Q24:训练这个语料用了多少 GPU?
论文正文(HTML 版)未披露训练算力细节。这是基础模型论文里常见的留白,复现训练(而非推理)的成本评估需另行估算。
Q25:官方有训练好的 ONNX/TensorRT 部署版吗?
未见于官方渠道;官方提供的是 PyTorch 权重(.pt/.ckpt)与 docker 镜像(挑战赛版)。部署侧转换需自行处理。
Q26:语料的 JSON 描述文件长什么样?
train.json/test.json 记录图像-掩码-描述的对应关系;确切 schema 未在 README 中逐字段文档化,建议下载 demo 样例(BiomedParseData-Demo)后以实际文件为准。
Q27:可以只借「本体树」不用图像吗?
82 类本体在论文图 1a 有可视化,模型侧 BIOMED_CLASSES 常量与 target_dist.json 是可执行的类别清单——做本体研究可以只引用这两个代码资产。
Q28:这个语料能用来训练报告生成模型吗?
不适合。描述是目标短语而非报告(§6.6)。报告生成需求见 biomedica(734)。
Q29:为什么 HF 下载数(532)这么低?
gated 仓库的计数只含同意条款后的取数,且许多下游走 GitHub demo 或镜像——下载计数在此场景下不反映真实使用面(模型侧 10,785 可作参照)。
Q30:和 TotalSegmentator 的关系?
TotalSegmentator(全身 CT 分割)是 45 源之一(DATASET.md 在列,库内 rid 422)——本语料吸收了其 CT 分割数据;两者是「上游源 → 整合语料」关系。
Q31:论文的补充材料哪里取?
Nature Methods 页(付费/机构订阅);arXiv 版 HTML 未完整渲染补充材料。核证补充材料细节(如 25 部位分布图)需订阅权限——本条目已把可从正文核证的数字全部落地,补充材料项列遗留疑点。
Q32:如何引用本条目与官方资源的分工?
学术引用引论文(doi:10.1038/s41592-024-02499-w)+ 语料仓库 URL;本条目作为中文检索与导航层,注明「千方病案医数集 AI-Ready Wikipedia 条目 biomedparse」即可。
G. 数据完整性与工程细节(续)
Q33:下载中断后如何校验 ZIP 完整性?
HF 仓库元数据带每个文件的 git sha(LFS Oid);断点续传后建议比对文件字节数与解压试读(unzip -t)双保险。官方未提供逐包 checksum 清单页。
Q34:ZIP 内的目录结构是什么?
按 §5.4 的 train/train_mask/test/test_mask 约定组织;demo 样例(BiomedParseData-Demo)与全量包结构一致,可先看 demo 建立心智模型。
Q35:能否用 hf_transfer/huggingface-cli 加速?
可以——HF 仓库是标准 LFS 布局,huggingface-cli download microsoft/BiomedParseData --repo-type dataset 在登录并同意条款后即可用;国内网络可配 HF_ENDPOINT=https://hf-mirror.com。
Q36:target_dist.json 是什么?
模型推理侧的「目标先验分布」文件(配合 KS 检验做无效输入拒绝);克隆仓库缺失时会自动从 HF 拉取(官方 README 提示)。它属于模型仓库资产,不属于语料本体。
Q37:训练配置里能换回自己的类别表吗?
可以——configs/biomed_seg_lang_v1.yaml 是注册制配置,微调自己的数据集(附录 F 结构)后即可替换/扩展类别注册,官方流程见 README「Finetune on Your Own Data」节。
事实清单(硬事实 28 条)
- 语料名 BiomedParseData;模型名 BiomedParse;发布方 Microsoft Research。
- 论文:Nature Methods 22(1):166-176, 2025;epub 2024-11-18;doi:10.1038/s41592-024-02499-w;PMID 39558098。
- 预印本 arXiv:2405.12971(v1 2024-05-21);无 PMC 开放版。
- 作者 16 人;第一作者 Theodore Zhao;Hoifung Poon 为资深带队人。
- 源数据集 45 个(论文口径);官方 DATASET.md 列 34 个唯一来源;HF 托管 28 个 ZIP 子集。
- 九模态:CT、MRI、X-ray、病理、超声、内镜、眼底、皮肤镜、OCT。
- 解剖部位 25 个。
- 图像 110 万(1.1 million)。
- image-mask-label 三元组 340 万。
- image-mask-description 三元组 680 万(摘要口径「over 6 million」)。
- 本体三层:3 大类(organ/abnormality/histology)→ 15 元类型 → 82 对象类型。
- 纳入标准:像素级人工/半人工分割 + 对象有名称。
- 3D 模态预处理为平面内 2D 切片。
- 划分:每源 80/20;同一 volume 切片同 split。
- GPT-4 三用:本体构建、规范标签生成、同义描述合成。
- 实例格式:1024×1024 PNG 图像 + 二值掩码 PNG + 描述列表;命名
[IMAGE-NAME]_[MODALITY]_[SITE](_[TARGET]).png。 - HF 数据仓库 created 2024-10-22、lastModified 2025-04-20、usedStorage 204,621,176,313 B、gated=auto、license cc-by-nc-sa-4.0、downloads 532、likes 64。
- HF 模型仓库 created 2024-11-04、lastModified 2025-10-10、usedStorage 6,264,070,200 B、downloads 10,785、likes 116;文件含 biomedparse_v1.pt 与 biomedparse_v2.ckpt。
- GitHub 仓库 created 2024-05-18、stars 708、forks 104、license Apache-2.0。
- 测试规模 102,855 个 held-out 三元组。
- 不规则形状 Dice 0.857(+39.6%)。
- 分割胜过 MedSAM(含 oracle 边界框模式)与 SAM。
- 文本嵌入 Silhouette 0.89(vs 原生 PubMedBERT)。
- 架构:SEEM 模块化(Focal 图像编码器 + PubMedBERT 文本编码器 + 掩码解码器 + 元对象分类器)。
- CVPR 2025 Text-guided 3D Biomedical Image Segmentation Challenge 第一名(2025-06-11)。
- v2 分支 2025-06-30 启动。
- 模型使用限制:仅研发用途,禁止临床(README 原文)。
- 数据/模型许可 CC BY-NC-SA 4.0;代码 Apache-2.0。
术语表(22 条)
| 术语 | 释义 |
|---|---|
| image parsing(图像解析) | 分割、检测、识别三任务统一的框架命名 |
| image-mask-label triple | 图像-掩码-规范标签三元组(340 万) |
| image-mask-description triple | 图像-掩码-文本描述三元组(680 万) |
| canonical label(规范标签) | GPT-4 生成的统一种类名,折叠各源原始标签变体 |
| synonymous descriptions(同义描述) | 每个规范标签的一组等义短语 |
| ontology(本体) | 三层类别树:3 大类 → 15 元类型 → 82 对象类型 |
| meta-object classifier(元对象分类器) | 用 15 元类型做粗粒度监督的辅助分类头 |
| SEEM | 通用分割基础模型架构,BiomedParse 的底座 |
| Focal | 图像编码器的初始化预训练模型(Focal Transformer 系) |
| PubMedBERT | 文本编码器的初始化预训练模型(生物医学 BERT) |
| oracle bounding box(预言框) | 由金掩码导出的理想边界框,提示质量上限 |
| Grounding DINO | 文本生成框的开放词汇检测器,对比方法之一 |
| MedSAM | SAM 的医学域适配版,对比方法之一 |
| Dice | 分割重叠度指标,2×交集/(预测+真值) |
| KS test(Kolmogorov-Smirnov 检验) | 用于拒绝「图中不存在的目标」提示的统计检验 |
| gated dataset(受控访问数据集) | 需登录同意条款后下载的 HF 仓库模式 |
| CC BY-NC-SA 4.0 | 署名-非商业-相同方式共享许可 |
| Apache-2.0 | 宽松开源代码许可 |
| anatomic site(解剖部位) | 图像拍摄的身体部位,共 25 处 |
| in-plane 2D slice(平面内切片) | 3D 体数据沿轴切出的 2D 图像 |
| information leakage(信息泄漏) | 同一 volume 切片分跨训练/测试造成的指标虚高 |
| held-out(留出) | 训练不可见的评测子集 |
附录
附录 A:条目信息速查卡
| 字段 | 值 |
|---|---|
| 条目 slug | biomedparse |
| 主体 | BiomedParseData 训练语料集合 |
| 官方数据入口 | https://huggingface.co/datasets/microsoft/BiomedParseData |
| 官方模型入口 | https://huggingface.co/microsoft/BiomedParse |
| 官方代码入口 | https://github.com/microsoft/BiomedParse |
| 论文 DOI | 10.1038/s41592-024-02499-w |
| 预印本 | https://arxiv.org/abs/2405.12971 |
| demo | https://microsoft.github.io/BiomedParse/ |
| 本库占位 URL | https://www.qianfanghub.com/ai-ready-dataset/biomedparse/953 |
| 撰写代理 | agent-e-biomedpars |
| 事实档案 | writing/biomedparse/FACTS.md(2026-10-09) |
附录 B:DAIMS 评估全表
DAIMS(Data AI-Readiness Maturity Score,数据 AI 就绪度成熟度评分)八维评估(10 分制,评分依据见括注):
| 维度 | 得分 | 依据 |
|---|---|---|
| D1 可获取性 | 7 | gated=auto 注册即取(-1 门槛)、但仅子集 204.6 GB,全集需复现(-2) |
| D2 许可清晰度 | 8 | 三层许可各自明确(数据/模型 NC-SA、代码 Apache-2.0);NC+临床禁用双重限制需使用者自行注意(-2) |
| D3 文档完备性 | 8 | 论文 Methods 详尽 + README 完整(安装/训练/评估/数据格式)+ DATASET.md 源清单;但 45 源对账不全(34 列)、82 类无文本清单(-2) |
| D4 标注质量 | 8 | 掩码全部来自源集人工/半人工像素级标注 + 纳入门槛;GPT-4 文本层无逐条复核披露(-2) |
| D5 元数据标准 | 9 | 命名约定把模态/部位/目标编码进文件名,自描述性强;模态枚举规整(-1 JSON 描述 schema 未单独文档化) |
| D6 格式规范性 | 9 | 统一 1024×1024 PNG + 二值掩码 + JSON;统一 train/test 目录结构;ZIP 分包按源组织 |
| D7 可复现性 | 6 | 划分原则明确、demo 可跑通;但全集复现需逐源下载+GPT-4 调用成本,无端到端流水线(-4) |
| D8 伦理与合规 | 8 | 源数据集均为公开发布物、临床使用明文禁止、无 PHI 新增暴露;各源原始许可需使用者逐一对齐(-2) |
| 总分 | 63/80 | AI-Ready 光谱定位:中高就绪(注册可取 + 自描述格式 + 文档充实),扣分集中在全集复现与许可限制 |
附录 C:逐项证据链自证
| 主张 | 证据源 | 核证方式 |
|---|---|---|
| 论文书目(期刊/卷期/DOI/PMID) | PubMed esummary API 实抓 | ✅ 一手(官方数据库) |
| 45 源/9 模态/110 万/340 万/680 万/82 类/25 部位/102,855/0.857/+39.6% | arXiv v3 全文 HTML 实抓 183 KB | ✅ 一手(预印本原文,与期刊版摘要交叉) |
| 架构(SEEM/Focal/PubMedBERT/元对象分类器) | arXiv v3 Methods 节原文 | ✅ 一手 |
| 纳入标准/80-20 划分/volume 防泄漏/GPT-4 三用 | arXiv v3 Methods 节原文 | ✅ 一手 |
| Data/Code availability 承诺原文 | arXiv v3 声明节 | ✅ 一手 |
| HF 数据仓库(license/gated/体积/28 ZIP/时间戳) | hf-mirror.com API 实抓 JSON | ✅ 一手(平台元数据) |
| HF 模型仓库(同上 + v1/v2 文件名) | hf-mirror.com API 实抓 JSON | ✅ 一手 |
| GitHub(stars/license/时间线/News 全表/命名约定/BibTeX) | jsdelivr CDN 实抓 README 全文 12.5 KB + GitHub API | ✅ 一手 |
| 源数据集清单 34 个唯一来源 | DATASET.md 实抓 5.6 KB 全文 | ✅ 一手 |
| 作者 16 人全名单 | Semantic Scholar API 实抓 | ✅ 一手(权威聚合库) |
| F1 +74.5%、p<10^-4、0.93/1.00/0.99 | bio.rodeo 汇编页(WebSearch 摘录) | ⚠️ 二手(引用需标注) |
| UW/Providence 合作 | winbuzzer 报道 | ⚠️ 二手 |
| GTEP/TMPT(brief 线索) | 四源全文检索 0 命中 | ❌ 无法核证,按误记存照 |
| 44 个数据集(brief 线索) | 论文原文两处 45 | ❌ 误记,以 45 为准 |
附录 D:获取决策树
需要 BiomedParseData?
├─ 只想跑通流程 → GitHub BiomedParseData-Demo(免登录)
├─ 需要训练数据
│   ├─ 可接受子集 → HF gated 下载 28 ZIP(登录+同意条款)
│   └─ 必须 45 源全集 → DATASET.md 逐源获取
│       ├─ 各源许可自查(TCIA 系需 DUA)
│       ├─ 跑官方预处理脚本
│       └─ GPT-4 协调成本自理
├─ 只要模型权重 → HF microsoft/BiomedParse(gated)
│   ├─ 论文复现 → biomedparse_v1.pt
│   ├─ 3D 任务 → CVPR 2025 挑战赛版(致谢挑战赛)
│   └─ 最新版 → biomedparse_v2.ckpt
└─ 需要影像-报告长文本 → 不适用 → 库内 biomedica(rid 734)
附录 E:来源清单(全部实抓 URL)
- 论文(Nature Methods):https://www.nature.com/articles/s41592-024-02499-w (doi:10.1038/s41592-024-02499-w)
- 预印本(arXiv):https://arxiv.org/abs/2405.12971 ;全文 HTML 实抓:https://arxiv.org/html/2405.12971v3
- PubMed:PMID 39558098(eutils.ncbi.nlm.nih.gov esummary 实抓)
- Semantic Scholar:https://api.semanticscholar.org/graph/v1/paper/DOI:10.1038/s41592-024-02499-w
- GitHub 主仓库:https://github.com/microsoft/BiomedParse
- README 实抓(jsdelivr CDN):https://cdn.jsdelivr.net/gh/microsoft/BiomedParse@main/README.md
- 源数据集清单实抓:https://raw.githubusercontent.com/microsoft/BiomedParse/main/assets/readmes/DATASET.md
- HF 数据仓库:https://huggingface.co/datasets/microsoft/BiomedParseData (API 实抓经 https://hf-mirror.com/api/datasets/microsoft/BiomedParseData)
- HF 模型仓库:https://huggingface.co/microsoft/BiomedParse (API 实抓经 hf-mirror.com)
- 在线 demo:https://microsoft.github.io/BiomedParse/
- CVPR 2025 挑战赛:https://www.codabench.org/competitions/5651/
- 挑战赛微调数据集:https://huggingface.co/datasets/junma/CVPR-BiomedSegFM
- 二手汇编(引用需标注):https://bio.rodeo/models/biomedparse ;https://winbuzzer.com/2024/11/18/microsoft-unveils-biomedparse-ai-model-for-medical-image-analysis-xcxwbn/
附录 F:推理与数据组织代码骨架(据官方 README 整理)
模型加载与推理(官方示例精简):
from PIL import Image
import torch
from modeling.BaseModel import BaseModel
from modeling import build_model
from utilities.distributed import init_distributed
from utilities.arguments import load_opt_from_config_files
from utilities.constants import BIOMED_CLASSES
from inference_utils.inference import interactive_infer_image
import numpy as np

opt = load_opt_from_config_files(["configs/biomedparse_inference.yaml"])
opt = init_distributed()
pretrained_pth = 'hf_hub:microsoft/BiomedParse'
model = BaseModel(opt, build_model(opt)).from_pretrained(pretrained_pth).eval().cuda()
with torch.no_grad():
    model.model.sem_seg_head.predictor.lang_encoder.get_text_embeddings(
        BIOMED_CLASSES + ["background"], is_eval=True)

image = Image.open('examples/Part_1_516_pathology_breast.png', formats=['png']).convert('RGB')
prompts = ['neoplastic cells', 'inflammatory cells']
pred_mask = interactive_infer_image(model, image, prompts)
自备数据的组织结构(官方硬性约定):
biomedparse_datasets/
└── YOUR_DATASET_NAME/
    ├── train/        # [IMAGE-NAME]_[MODALITY]_[SITE].png(1024x1024)
    ├── train_mask/   # [IMAGE-NAME]_[MODALITY]_[SITE]_[TARGET].png(二值,空格→'+')
    ├── test/
    └── test_mask/
# 生成描述文件后追加:train.json / test.json
注意事项(官方原文要点):
- 掩码为二值 PNG,像素非零即前景;
- TARGET 内禁用下划线,空格替换为
+; - 一图可挂多掩码(多目标);
- 注册数据集后加入
configs/biomed_seg_lang_v1.yaml即可进入训练/评估流水线; inference_utils/target_dist.json缺失时会自动从 HuggingFace 拉取。
附录 G:检索关键词与别名表
供库内检索与外部检索使用的同义词族:
| 词族 | 关键词 |
|---|---|
| 主名 | BiomedParseData、BiomedParse Data |
| 模型名 | BiomedParse、Biomed Parse |
| 任务名 | image parsing、biomedical image parsing、joint segmentation detection recognition、文本提示分割、text-prompted segmentation |
| 方法标签 | GPT-4 harmonization、ontology-based label harmonization、canonical label、synonymous descriptions |
| 模态词 | nine modalities、CT、MRI、X-ray、pathology、ultrasound、endoscopy、fundus、dermoscopy、OCT |
| 平台词 | HuggingFace gated dataset、microsoft huggingface、Nature Methods 2025 |
| 易混淆词 | BiomedGPT(不同模型)、BIOMEDICA(不同语料)、MedSAM(不同模型)——检索时建议排除 |
附录 H:gated 仓库的引用与再分发合规清单
使用 BiomedParseData 前,按此清单逐项自查:
- 账号与同意:HF 账号 + 仓库条款同意(gated=auto,即时放行);
- 非商业:NC 条款——商业产品、商业服务、付费 API 后端均不可用;
- 相同方式共享:SA 条款——基于本语料的衍生数据集必须继续以 CC BY-NC-SA 4.0 发布;
- 署名:BY 条款——引用论文(doi:10.1038/s41592-024-02499-w)并注明语料仓库;
- 临床隔离:模型 README 明文禁止临床决策使用——任何面向患者的应用均越界;
- 上游许可穿透:45/34 个源数据集各自的许可并不因「被整合」而消失——商用审查需逐源穿透(好在 NC 红线已先挡掉多数商用场景);
- 再分发边界:HF 仓库条款与 SA 决定再分发形态——推荐「链接 + 教程」而非「转售数据包」;
- CVPR 挑战赛版:使用挑战赛微调版模型必须额外致谢挑战赛(官方明文)。
附录 I:坑点档案对照表(与 §10 对照)
| 坑点 | 一句话版本 | 高危场景 |
|---|---|---|
| 坑点 1 | 44 是误记,论文为 45 | 引用数据集数量时 |
| 坑点 2 | GTEP/TMPT 查无实据 | 转述「聚合标注」流程时 |
| 坑点 3 | 45/34/28 三口径不可混用 | 写综述或数据卡时 |
| 坑点 4 | 模型不是数据集 | 条目定性、库内收录边界 |
| 坑点 5 | 600 万是描述口径,另有 340 万标签口径 | 引用三元组数量时 |
| 坑点 6 | gated 不等于公开直链 | 可获取性分级、下载数解读 |
| 坑点 7 | NC+SA+临床禁用三层红线 | 商用/临床/衍生集规划 |
| 坑点 8 | CT/MRI 是 2D 切片化,volume 不跨 split | 数据重组与再划分 |
附录 J:模态 × 下游任务适用性矩阵
| 模态 | 文本提示分割 | 目标检测 | 全图识别 | 跨模态对齐研究 | 备注 |
|---|---|---|---|---|---|
| CT | ✅ | ✅ | ✅ | ⚠️ 短语级 | 2D 切片化 |
| MRI | ✅ | ✅ | ✅ | ⚠️ 短语级 | 2D 切片化 |
| X-ray | ✅ | ✅ | ✅ | ✅ | 库内胸片家族条目互链 |
| 病理 | ✅ | ✅ 细胞/腺体 | ✅ | ✅ | 全切片 patch 化 |
| 超声 | ✅ | ✅ | ✅ | ⚠️ | 含模拟数据源 |
| 内镜 | ✅ | ✅ 息肉 | ✅ | ⚠️ | PolypGen/NeoPolyp |
| 眼底 | ✅ | ✅ 视杯视盘 | ✅ | ✅ | REFUGE/G1020/DRIVE |
| 皮肤镜 | ✅ | ✅ 病灶 | ✅ | ✅ | ISIC 2018 |
| OCT | ✅ | ✅ 囊液 | ✅ | ⚠️ | 单一源(OCT-CME) |
图例:✅ 论文直接支持;⚠️ 可行但描述为短语级/源较薄,需自行评估。
附录 K:HF 分包(28 ZIP)与源数据集对读表
HF API 实抓的 28 个 ZIP 包名与 DATASET.md 源清单的对读结果(用于核对「28/34/45」三口径):
| HF ZIP 包 | 对应源(DATASET.md) | 模态 |
|---|---|---|
| ACDC.zip | ACDC | MRI |
| amos22.zip | amos22 | CT/MRI |
| BreastUS.zip | DATASET.md 无对应行 | 超声 |
| CAMUS.zip | CAMUS | 超声 |
| CDD-CESM.zip | CDD-CESM(表中出现两次) | 乳腺 X 线 |
| COVID-19_CT.zip | COVID-19 CT | CT |
| COVID-QU-Ex.zip | COVID-QU-Ex | X-ray |
| CXR_Masks_and_Labels.zip | Chest Xray Masks and Labels | X-ray |
| DRIVE.zip | DRIVE | 眼底 |
| FH-PS-AOP.zip | FH-PS-AOP | 乳腺 X 线 |
| G1020.zip | G1020 | 眼底 |
| GlaS.zip | GlaS | 病理 |
| ISIC.zip | ISIC 2018 | 皮肤镜 |
| kits23.zip | KiTS23 | CT |
| LGG.zip | LGG | MRI |
| LIDC-IDRI.zip | LIDC-IDRI | CT |
| LiverUS.zip | DATASET.md 无对应行 | 超声 |
| MMs.zip | M&Ms | MRI |
| MSD.zip | MSD | 多模态 |
| NeoPolyp.zip | NeoPolyp | 内镜 |
| OCT-CME.zip | OCT-CME | OCT |
| PanNuke.zip | PanNuke | 病理 |
| PolypGen.zip | PolypGen | 内镜 |
| QaTa-COV19.zip | QaTa-COV19 | X-ray |
| REFUGE.zip | REFUGE | 眼底 |
| Radiography.zip | COVID-19 Radiography Database | X-ray |
| siim-acr-pneumothorax.zip | SIIM-ACR | X-ray |
| UWaterlooSkinCancer.zip | UWaterlooSkinCancer | 皮肤镜 |
对读结论:24 包可直接对上 DATASET.md 源;BreastUS 与 LiverUS 两包在 DATASET.md 无对应行(缺口实证);DATASET.md 在列的 BTCV、PROMISE12、BUSI、US Sim&Seg、FUMPE、TotalSegmentator、BraTS2023、AbdomenCT-1K 等 10 余源未见对应 ZIP——HF 子集确实只是子集,且两个平台各有自己的「在列清单」,两者交集不等于论文全集。
附录 L:官方环境配置实录(README 原文要点)
复现推理/训练的环境要求(官方 README 全文整理):
- 克隆:
git clone https://github.com/microsoft/BiomedParse.git; - conda 两条路:①
conda env create -f environment.yml(直接建环境);②手工建python=3.9.19环境; - PyTorch:
conda install pytorch torchvision torchaudio pytorch-cuda=12.4 -c pytorch -c nvidia(CUDA 12.4 通道); - detectron2 兼容:官方提醒 detectron2 安装问题多半来自 PyTorch 与 CUDA 版本不匹配;
- 其余依赖:
pip install -r assets/requirements/requirements.txt; - 权重落位:下载 HF 权重后放
pretrained/并改名biomed_parse.pt(或直接用hf_hub:microsoft/BiomedParse在线加载); - Docker 路线:README 保留有 docker 构建脚本(正文已注释掉,挑战赛版另有官方镜像)。
环境坑提示:python 锁定 3.9.19 是官方实测版本,偏离该版本可能触发 detectron2 兼容问题;target_dist.json 若克隆不完整会自动从 HF 补拉。
附录 M:推理 notebook 三件套与在线 demo
| 入口 | 文件 | 适用 |
|---|---|---|
| RGB 推理 | inference_examples_RGB.ipynb |
病理、X-ray、超声、内镜、皮肤镜、OCT、眼底七类常规 2D |
| DICOM 推理 | inference_examples_DICOM.ipynb |
影像科原始格式;含负预测 p 值示例(无效输入拒绝演示) |
| NIFTI 推理 | inference_examples_NIFTI.ipynb |
体数据切片(CT/MRI 研究常用) |
| Colab 一键 | inference_colab_demo.ipynb |
零安装快速体验 |
| 在线 demo | microsoft.github.io/BiomedParse | 浏览器直接试 |
三个 notebook 合起来覆盖了九模态的完整推理路径;负预测 p 值示例(2024-11-22 加入)是「防幻觉」能力的官方演示入口——对描述图中不存在目标的提示,模型输出统计检验 p 值供使用者判断拒绝。
附录 N:评估方法细节(论文原文要点)
读 §8 成绩单时需要知道的评测细节:
- oracle bounding box:由金标准掩码导出的「最小覆盖框」——代表交互式提示的质量上限;BiomedParse 无框仍胜出,说明语义提示在九模态平均意义上不输几何提示上限;
- Grounding DINO 组合基线:先用 Grounding DINO 从文本提示生成框(带置信分),再经非极大值抑制(NMS)去重选框,最后把框喂给 SAM/MedSAM 出掩码——这是「文本提示 + 几何模型」的最佳组合仿真;
- 统计检验:paired t-test 配对设计(同图同目标的逐对比较),bio.rodeo 二手口径 p<10^-4;
- 嵌入质量评估:以 Silhouette 分数量化文本嵌入对细粒度细胞类型的区分度(0.89 vs 原生 PubMedBERT)——这是「本体协调有效」的直接量化证据;
- 三任务同评测集:102,855 三元组同时用于分割/检测/识别三任务的评估——这正是「联合监督数据集」定义的兑现。
附录 O:本库收录标准对照(AI-Ready 光谱定位)
| 收录考察点 | 本语料状态 |
|---|---|
| 是数据发布物(非模型/非论文) | ✅ HF 独立数据仓库(模型仅作背景) |
| 可获取(任一通道) | ✅ gated=auto 注册即取 + demo 免登录 + 全集复现路线 |
| 许可明示 | ✅ CC BY-NC-SA 4.0(HF cardData 字段实测) |
| 规模可查证 | ✅ 论文原文多口径齐备(110 万/340 万/680 万/45 源/9 模态) |
| 结构化格式 | ✅ PNG+JSON+命名约定自描述 |
| 主体定性清晰 | ✅ 训练语料集合(非模型本身)——开工查重已核验 |
| 库内查重 | ✅ 无同实体条目(biomedica/mtsamples 均不同实体) |
| 来源可存照 | ✅ 论文/官方仓库/平台 API 三源互证完成 |
结论:符合本库收录标准,AI-Ready 光谱定位为「注册可取 · 结构自描述 · 文档充实 · 全集复现需工程」的中高档位。
附录 P:核证命令清单(复现本条目核验)
本条目全部一手核证可用以下命令复现(2026-10-09 时点有效):
# 1. 论文书目(PubMed 官方数据库)
curl -s "https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=pubmed&id=39558098&retmode=json"

# 2. 论文全文(arXiv HTML,约 183KB)
curl -sL --range 0-900000 "https://arxiv.org/html/2405.12971v3" -o biomedparse_arxiv.html
# 关键词核对:45 / 1.1 million / 3.4 million / 6.8 million / 82 / 25 anatomic / 102,855 / 0.857 / 39.6
# 反向核对:GTEP=0、TMPT=0(brief 线索证伪)

# 3. 作者全名单与 arXiv 关联(Semantic Scholar API)
curl -s "https://api.semanticscholar.org/graph/v1/paper/DOI:10.1038/s41592-024-02499-w?fields=title,abstract,externalIds,authors"

# 4. HF 数据仓库元数据(经镜像;license/gated/体积/28 ZIP)
curl -s "https://hf-mirror.com/api/datasets/microsoft/BiomedParseData"

# 5. HF 模型仓库元数据(v1/v2 权重文件名可见)
curl -s "https://hf-mirror.com/api/models/microsoft/BiomedParse"

# 6. GitHub 仓库元数据(license/stars/时间线)
curl -s "https://api.github.com/repos/microsoft/BiomedParse"

# 7. 官方 README 全文(jsdelivr CDN,绕 GitHub raw 不稳)
curl -sL "https://cdn.jsdelivr.net/gh/microsoft/BiomedParse@main/README.md"

# 8. 源数据集清单 DATASET.md(34 个唯一源)
curl -sL "https://raw.githubusercontent.com/microsoft/BiomedParse/main/assets/readmes/DATASET.md"
# (raw 超时时的备选:https://cdn.jsdelivr.net/gh/microsoft/BiomedParse@main/assets/readmes/DATASET.md)
附录 Q:九模态官方命名对照速查
| 中文条目名 | 论文/README 英文写法 | DICOM 模态缩写参考 | 语料内代表性源 |
|---|---|---|---|
| CT(计算机断层) | CT | CT | amos22、MSD、BTCV、LIDC-IDRI |
| MRI(磁共振) | MRI | MR | ACDC、M&Ms、PROMISE12 |
| X-ray(X 光) | X-ray(README);CXR(文献惯用) | DX/CR | COVID-QU-Ex、QaTa-COV19 |
| 病理(全切片/组织学) | Pathology | —(WSI 无标准 DICOM 模态) | GlaS、PanNuke |
| 超声 | Ultrasound | US | CAMUS、BUSI |
| 内镜 | Endoscopy | — | PolypGen、NeoPolyp |
| 眼底(照相) | Fundus | — | REFUGE、G1020、DRIVE |
| 皮肤镜 | Dermoscopy | — | ISIC 2018 |
| OCT(光学相干断层) | OCT | — | OCT-CME |
使用提示:文件名中的 [MODALITY] 段官方示例用「X-Ray」这类连字写法;跨语料过滤时建议大小写不敏感并兼容连字/无连字变体。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- synthrad — 共享标签:医学影像 / CT / MRI / 多模态影像 / 肿瘤学
- spinal-multiple-myeloma-seg — 共享标签:医学影像 / 医学图像分割 / CT / 多模态影像 / 肿瘤学
- cptac-imaging — 共享标签:医学影像 / CT / MRI / 肿瘤学
- medical-decathlon — 共享标签:医学影像 / 医学图像分割 / CT / MRI
- pddca — 共享标签:医学影像 / 医学图像分割 / CT / 肿瘤学
- ct-org — 共享标签:医学影像 / 医学图像分割 / CT / 肿瘤学
- headneck-radiomics — 共享标签:医学影像 / 医学图像分割 / CT / 肿瘤学
- amos — 共享标签:医学影像 / 医学图像分割 / CT / MRI
- lctsc — 共享标签:医学影像 / 医学图像分割 / CT / 肿瘤学
- chaos — 共享标签:医学影像 / 医学图像分割 / CT / MRI
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
