信息速览
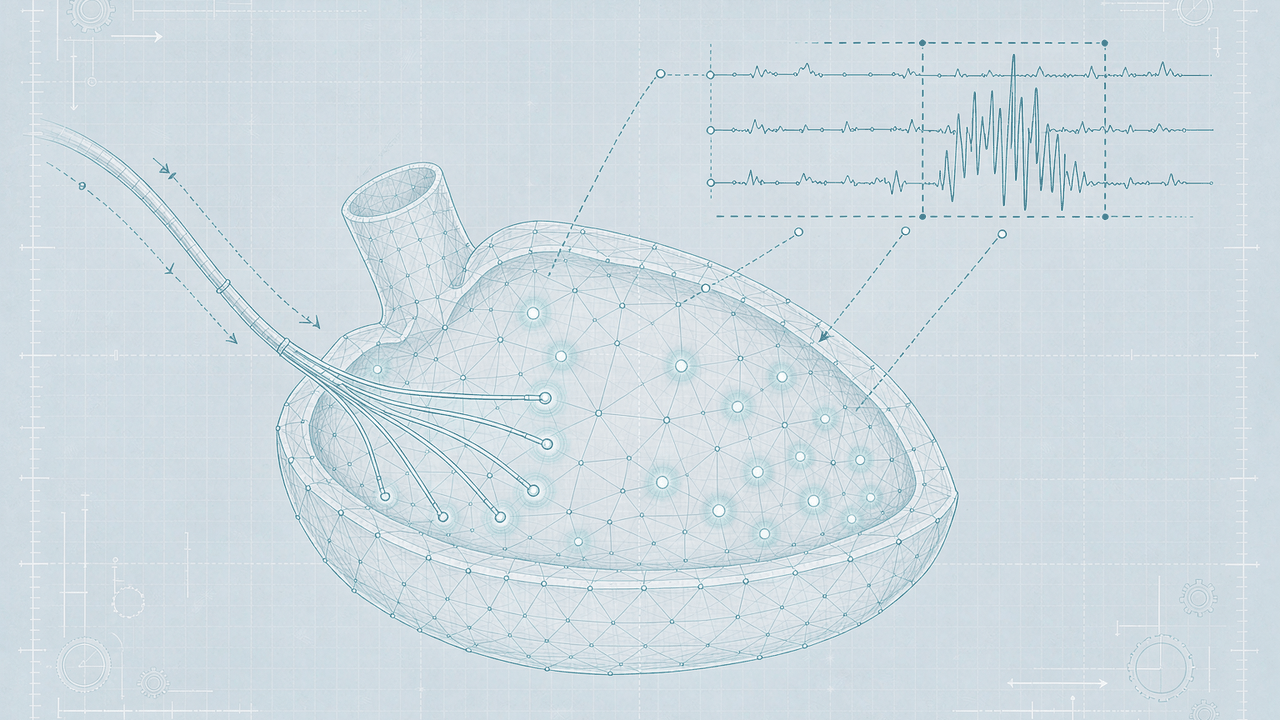
ARGO 是 PhysioNet 上的一份心脏电生理数据集,全名是「缺血后室性心动过速电图标注数据集」。它解决的是一个相当窄、但在临床上很具体的问题:在缺血性心肌病患者的室速射频消融术中,医生要在左室心肌上找出那些「异常心室电位」所在的点,再把这些点烧掉。这件事过去靠术者肉眼在高密度标测图上逐点翻看,慢且主观,而公开可用的带标注数据几乎没有。
这份数据填补的正是这一小块空白。9 例患者,近两千个标测点,每个点带 2.5 秒的双极电图、两路单极电图和 12 导联体表心电,外加左室的三维几何与电压图。三位电生理专家独立盲标,再合成一份共识。2026 年 7 月它才作为 v1.0.0 公开发布,是目前公开渠道里唯一一份专门针对这项任务、且带边界勾画的标注集。
它的规模很小,小到不足以支撑任何「通用模型」的说法。但正是这个小,让它的每一处结构选择都值得细看:为什么每段只有 2.5 秒,为什么只留最后一个心搏,为什么非异常片段要用一个越界样本号占位。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 中文名 | 缺血后室速心内电图标注数据集 |
| 英文全名 | Annotated dataset of post-ischemic ventricular tachycardia electrograms |
| 缩写来源 | Ablation Reinforcement by computer-aided Guidance and Optimization |
| 发布平台 | PhysioNet,v1.0.0,2026-07-15 |
| DOI | 10.13026/8gh2-e660(v1.0.0);10.13026/afxd-9424(最新版) |
| 数据描述论文 | PLOS ONE 21(6): e0350993,2026 |
| 样本量 | 9 例患者,1,962 个标测点 |
| 共识类别分布 | 生理 776,异常电位 940,未知 246 |
| 每个标测点的通道 | 1 路双极 + 2 路单极 + 12 导联体表心电,共 15 路 |
| 采样与时长 | 1 kHz,每段 两千五百个样本即 2.5 秒 |
| 标注者 | 3 位电生理专家独立盲标 + 1 份共识 |
| 空间数据 | 左室三角网格、连通表、电压与局部激动时间着色、消融点坐标 |
| 格式 | WFDB 记录 + 纯文本表 + MATLAB 结构体副本 |
| 体积 | 未压缩 378.4 MB,ZIP 约 182.9 MB |
| 采集设备 | CARTO 3 V6 标测系统,PentaRay 与 ThermoCool SmartTouch 导管 |
| 许可 | CC BY-NC-SA 4.0 |
| 采集地点与时间 | 意大利 Nuoro,San Francesco 医院,2017–2018 |
§1 它要解决的具体麻烦
1.1 一张高密度标测图上,人眼要逐点判读几百次
室速的射频消融不是「找到病灶烧掉」这么简单。缺血性心肌病留下的瘢痕里混着存活的肌束,电信号在那里绕行,形成折返。术者能做的,是在左室内膜上铺满几百个标测点,逐点看双极电图:正常心肌给出幅度高、形态规整的电位;瘢痕里那束迟到的、低电压、高频碎裂的电位,就是所谓的异常心室电位(abnormal ventricular potential,AVP)。
这些点标出来之后,术者把它们连成一片「基质区」,在区内布消融线。识别得准不准,直接决定手术时间和复发率。这个过程在每一例手术里要重复几百次,标测点从几十到上千不等,全部靠人眼,判读标准又落在几位术者的经验里。
自动化的想法早就有了。页面上引用的一串前期工作从 2019 年一路排到 2025 年,都是这个团队自己做的:先做频谱特征,再做可解释深度学习,再做孪生网络。问题在于,这些方法各自只在自己的私有数据上验证过,谁也说不清一个方法比另一个好多少,因为没有共同的考卷。
ARGO 就是这份考卷。它把「逐点判读」这个动作固定成一个可复现的任务:给一段 15 通道、2.5 秒的信号,输出这个点是生理、异常还是未知;如果是异常,再给出异常电位的起止样本点。
1.2 三条常见的错误期待
期待一:这是一份室速诊断数据集。 它不是。它不含诊断结论,病人全部是已经确诊、正在接受消融的缺血后室速患者,标签是「这一小块心肌上的电图有没有异常电位」,不是「这个人有没有室速」。拿它训练诊断模型,相当于拿病理切片去训练一个判断病人是否患病的模型,层级错位。
期待二:这是一份大体量数据,够训练深度网络。 近两千条听起来不少,但只有 9 个人。按患者划分做留一验证,每一折只有 8 个人的信息可用。在这种量级上,一个上百层的网络和一组手工特征之间,胜负往往由随机种子决定,而不是由方法本身决定。数据描述论文本身也把「小队列影响泛化」写进了局限。
期待三:既然有三位专家标注,标签就是金标准。 三位专家互相独立、互不知情,确实压低了系统性偏差,但他们的分歧本身也是信息。共识是多数意见的收束,不是客观真值。论文给了标注者间一致性的估计,也给了边界位置的容差,这些数字应该被当成评价模型时的噪声地板,而不是被忽略的脚注。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 一个可复现的异常心室电位分类基准 | 共识标签加三名专家各自的标签,类别三选一 | 够,且这是它最核心的用途 |
| 训练边界检测或时序分割模型 | 每个异常电位给起止样本点,理由与容差在论文里 | 够,但样本只有几百例正类 |
| 研究标注者分歧 | 三个互相独立的标注文件全量开放 | 够,这在公开数据里极少见 |
| 把电图和三维位置对应起来 | 每个标测点在左室网格上的坐标,加消融点坐标 | 够,能直接做空间建模 |
| 判断某个算法能否进手术室 | 只有 9 例、单一中心、单一设备 | 不够,只能当作初步证据 |
| 做室速诊断或风险预测 | 无诊断标签、无随访、无用药 | 给不了 |
| 做跨厂商标测系统的泛化实验 | 全部来自同一台设备 | 给不了 |
| 研究非缺血性心肌病室速 | 队列全部为缺血性病因 | 给不了 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 手上有一个电图分类算法,但没有可比的公开数据 | 提供一份带专家共识的固定考卷,结果可以与论文里的基线对照 | 先按其患者划分方式跑一遍留一验证,再看类别不平衡的影响 |
| 想复现论文里那个「电压低于某个阈值」的经典规则基线 | 电压图与消融点都被保留,可以重建规则并复现对照 | 注意规则阈值需要自己从训练折里估,不要用全量数据调 |
| 在做电生理方向的多模态融合,想找一个电图加三维几何的小样本场景 | 提供电图、坐标、网格、消融点四类信息,且天然同步 | 网格顶点数在几百到几千之间,图网络建图的边权要按测地距离而非欧氏距离 |
| 想研究标注一致性,做半监督或主动学习 | 三个人各自的标注可以直接当作分歧样本,无需自己重标 | 重点关注三人不一致但共识落在某一类的点,那里信息量最高 |
| 正在写一篇小样本心电方法的论文,需要一个外部验证集 | 可以作为域外测试,尤其在模型训练于体表心电时 | 报告中必须说明它的病因和设备都与训练集不同,不能宣称通用 |
| 想直接开发商用软件 | 许可禁止商业使用 | 另行取得授权,或改用其他授权更宽的数据 |
| 只想要一份干净的长时程心电数据做教学演示 | 每段 2.5 秒,且只建议用最后一个心搏 | 这不是合适的数据,应改用标准的 12 导联心电库 |
1.5 一句话判断
如果你做的是缺血后室速消融术中「单点心内电图是否异常」这一件事,它是目前唯一一份公开、带边界、带三人独立标注的考卷;如果你的问题比这件事宽一寸,它大概率帮不上忙。
1.6 不适合谁:四条边界
第一,不适合要把模型直接做成产品的团队。 非商业许可把这条路堵死了。即便许可宽松,9 例数据也不足以支撑任何器械申报里的性能声明。
第二,不适合做心律失常诊断或筛查的研究。 数据里没有任何诊断标签、没有随访、没有结局。队列本身就是「已确诊且已进导管室」的极端筛选人群,用它做筛查模型会得到严重虚高的表现。
第三,不适合把标测点当作独立样本的人。 同一患者相邻标测点在空间上相隔几毫米,信号高度相关。随机划分训练测试会让测试集事实上泄漏。这一点在 §7.3 会展开,也会在 §4.4 的案例里以一条具体记录再演一遍。
第四,不适合研究非缺血性病因。 队列全部是缺血后室速。把结论迁移到扩张型心肌病或特发性室速上,没有任何数据支撑。
§2 数据构成与规格
2.1 两级目录:患者下挂标测点
数据包的顶层很干净:一份记录清单、一份标注者说明、一份受试者补充表、一份自述文件,以及一个装着全部数据的主目录。主目录下按患者分九个文件夹,从 Pt1 到 Pt9;每个患者文件夹里同时躺着两类东西,一类是逐个标测点的电图与标注,另一类是这一位患者独一份的左室几何文本。
这种布局意味着一个选择:空间信息挂在患者层级,不挂在标测点层级。要拿到某个标测点在心壁上的位置,必须去读同一患者目录下的点坐标表,按记录编号对齐。这不是缺点,因为同一位患者只有一个左室,几何本来就该是共享的。
每个标测点固定产生六个文件:一个二进制信号文件、一个头文件、四个注释文件。四个注释文件分别对应三位专家与一份共识。命名规则统一为记录编号加点加后缀,例如 Pt1 目录下编号为 71 的点,文件是 P71.dat、P71.hea 与四份注释。
记录清单是一行一个完整相对路径,行数与标测点总数一致,与页面所述的标测点总数完全对得上。这也是判断数据完整性的第一个锚点:下载后数一数清单行数与实际文件组数是否一致。
| 顶层成员 | 内容 | 层级 |
|---|---|---|
| RECORDS | 全部记录路径清单,一行一条 | 数据集级 |
| ANNOTATORS | 四个注释后缀与对应标注者的对照 | 数据集级 |
| Additional_subject_data.csv | 九位受试者的编码、性别、年龄、射血分数、标测点数 | 数据集级 |
| README.txt | 目录结构、字段说明、类别分布、引用要求 | 数据集级 |
| LICENSE.txt | 许可说明 | 数据集级 |
| SHA256SUMS.txt | 全部文件校验和 | 数据集级 |
| ARGODataset_Folder/Pt1–Pt9 | 每位患者一个文件夹 | 患者级 |
| …/PtN/Pxxxx.dat 与 .hea | 信号与头文件 | 标测点级 |
| …/PtN/Pxxxx.annotation_* | 四份注释 | 标测点级 |
| …/PtN/五个 .txt | 左室几何与消融信息 | 患者级 |
| …/MATLAB_files | 整包结构体与两个可视化脚本 | 数据集级 |
2.2 字段与文件的完整字典
下表把每个文件的存在理由、内部结构与读法一次说清。左侧文件按出现频率从高到低排列,前七个是每个标测点都有的,后五个是每位患者独一份的。
| 文件 | 每个患者几个 | 内部结构 | 关键字段 | 读写方式 |
|---|---|---|---|---|
| Pxxxx.dat | 每点一个 | 16 位整数二进制,2500 行 × 15 列按列优先存放 | 15 路信号 | WFDB 的 rdsamp 或 numpy 直接解析 |
| Pxxxx.hea | 每点一个 | 首行四字段,后每通道一行 | 记录名、通道数、采样率、样本数、增益、基线、单位、通道名 | 纯文本,可直接读 |
| Pxxxx.annotation_ann1 | 每点一个 | WFDB 注释二进制 | P / A / U、左括号、右括号、引号 | WFDB 的 rdann |
| Pxxxx.annotation_ann2 | 每点一个 | 同上 | 同上 | 同上 |
| Pxxxx.annotation_ann3 | 每点一个 | 同上 | 同上 | 同上 |
| Pxxxx.annotation_consensus | 每点一个 | 同上 | 同上,作为推荐标签 | 同上 |
| Additional_subject_data.csv | 全数据集一份 | 分号分隔九行 | 受试者编码、性别、年龄、射血分数、标测点数 | pandas 指定分隔符 |
| XYZmesh.txt | 每患者一份 | 带表头三列 | X、Y、Z 顶点坐标 | pandas 或 numpy |
| ConnectivityList.txt | 每患者一份 | 顶点索引对 | 三角网格的边 | numpy,注意从零还是从一开始 |
| MESHcoloring.txt | 每患者一份 | 带表头两列,逐顶点 | 电压、局部激动时间 | numpy,注意 NaN |
| POS_POINTS.txt | 每患者一份 | 带表头四列 | 标测点编号、X、Y、Z | 按编号与记录对齐 |
| AblationPoints.txt | 每患者一份 | 带表头三列 | 消融点坐标 | numpy |
上表里有两处细节值得先记住。头文件首行给出的是通道数与采样率,但单通道的增益与基线写在后续各行,读的时候不要只解析首行;着色表里会出现 NaN,那是网格上未被标测覆盖的顶点,不是坏值,做可视化时要单独遮罩。
2.3 一条记录的完整解剖
取 Pt1 目录下编号 71 的标测点。它的头文件一共 16 行:第一行声明记录名、15 个通道、1,000 Hz 采样、两千五百个样本;接下来 15 行各描述一路信号,每行的末尾是通道名。三路心内通道的命名带导管电极位号,从 20A 系列的电极对到单一的尖端与环端。
P71 15 1000 2500
P71.dat 32 333.3333(0)/mV 0 0 4 370 0 20A_1-2
P71.dat 32 333.3333(0)/mV 0 0 -349 -20162 0 20A_1
P71.dat 32 333.3333(0)/mV 0 0 -289 -16589 0 20A_2
P71.dat 32 333.3333(0)/mV 0 0 12 739 0 I
P71.dat 32 333.3333(0)/mV 0 0 41 3131 0 II
P71.dat 32 333.3333(0)/mV 0 0 29 2094 0 III
P71.dat 32 333.3333(0)/mV 0 0 -8 -452 0 aVL
P71.dat 32 333.3333(0)/mV 0 0 -26 -1915 0 aVR
P71.dat 32 333.3333(0)/mV 0 0 34 2653 0 aVF
P71.dat 32 333.3333(0)/mV 0 0 -37 -2817 0 V1
P71.dat 32 333.3333(0)/mV 0 0 -56 -7579 0 V2
P71.dat 32 333.3333(0)/mV 0 0 -31 -6800 0 V3
P71.dat 32 333.3333(0)/mV 0 0 87 7160 0 V4
P71.dat 32 333.3333(0)/mV 0 0 57 4929 0 V5
P71.dat 32 333.3333(0)/mV 0 0 36 3133 0 V6
每一行第 2 字段的 32 是每样本位数,其后是增益与单位。第三位小数那串增益的倒数就是分辨力,官方页面另给了换算系数 0.003 mV/a.u.,两者一致。第 4、5 字段是基线偏移与初始值,第 6 字段是校验和,最后才是通道名。
这个点对应的注释只有一行,符号是引号,位置是 9998。含义是该点被共识判为非异常电位,边界无从标注,因此写入一个落在有效样本范围之外的占位索引。用 WFDB 读出来,你会看到样本号与符号两个平行数组,长度都是一。
同一位患者里另一个编号为 457 的点则是正例,注释读出两个符号:一个左括号落在 2015,一个右括号落在 2104。也就是说,那段异常电位从第 2015 个样本开始、到第 2104 个样本结束,持续 89 个样本,即 89 毫秒。在 2.5 秒的窗口里,这是一段相当靠后的活动,正好落在最后一个心搏的舒张末期附近。
把这三层关系串起来:头文件声明窗口与通道,信号文件给出 15 路波形,注释文件给出类别与一段边界。一个标测点的全部信息就是这三样,外加患者层级的坐标把这一点钉到心壁上。
2.4 九个患者的分布
受试者补充表只有九行,字段是编码、性别、年龄、射血分数和标测点数。把它和每位患者的标测点数放在一起看,样本量的极不均匀一目了然。
| 患者 | 性别 | 年龄 | 射血分数 | 标测点数 | 占全库比例 |
|---|---|---|---|---|---|
| Pt1 | 男 | 68 | 32 | 157 | 8.0% |
| Pt2 | 女 | 68 | 30 | 104 | 5.3% |
| Pt3 | 男 | 83 | 42 | 90 | 4.6% |
| Pt4 | 男 | 50 | 30 | 471 | 24.0% |
| Pt5 | 男 | 78 | 27 | 46 | 2.3% |
| Pt6 | 男 | 61 | 31 | 839 | 42.8% |
| Pt7 | 男 | 60 | 21 | 76 | 3.9% |
| Pt8 | 女 | 57 | 28 | 129 | 6.6% |
| Pt9 | 男 | 69 | 24 | 50 | 2.5% |
有意思的是 Pt6 一个患者贡献了全库四成以上的标测点,而 Pt5 只有 46 点。这意味着如果按标测点随机划分,模型只要学乖了记住 Pt6 的局部波形风格,就能拿到不错的数字。这是本数据集最需要警惕的结构性陷阱,§7.3 会把它讲透,§4.4 的案例则说明单条记录如何被这个陷阱放大。
射血分数全部偏低,最低 21%,最高 42%,中位数在 30% 上下。这与缺血性心肌病合并室速的人群特征一致:这些患者的心功能已经受损,属于消融适应证明确的那一端。年龄跨度从 50 到 83,性别是七男两女,样本量小到无法做任何分层分析。
2.5 与同类公开资源的字段差异
把 ARGO 放到心电图领域的公开数据家族里,它能比较的对象其实很少。下表挑了几份常被放在一起讨论的资源,只比较与本任务相关的字段。
| 资源 | 记录对象 | 含心内电图 | 含异常电位标注 | 含三维位置 | 含消融点 | 公开免费 |
|---|---|---|---|---|---|---|
| ARGO | 缺血后室速术中基质标测点 | 是,双极加两路单极 | 是,三类加边界 | 是,左室网格 | 是 | 是 |
| 心内房颤数据库 | 房颤与房扑患者心内记录 | 是 | 否,只标 QRS 复合波 | 否 | 否 | 是 |
| 儿科消融心内房信号库 | 儿童导管消融中的心房信号 | 是 | 否,标心房活动起止 | 否 | 否 | 视渠道 |
| 体表加心内同步数据库 | 多种心律失常 | 是 | 部分,来自商业渠道 | 否 | 否 | 否 |
| 标准 12 导联心电库 | 体表心电 | 否 | 否 | 否 | 否 | 是 |
差异集中在两处。一是三维位置与消融点,公开的电生理数据极少保留这些,因为它们绑定在厂商的标测系统里,导出需要额外工序;ARGO 把它们导成了纯文本,代价是丢了系统内的全部元信息。二是「异常电位」这个标签本身,它不是一个通行的心电学类别,而是室速基质标测这个特定场景下的操作性定义,别的数据库不会标。
也正因如此,ARGO 不能和体表心电图库混在一个排行榜上比。它们测的不是同一件事。
§3 它的身份:一份术中数据,不是一份诊断数据
3.1 采集场景决定了数据的全部形态
ARGO 的每一条记录都诞生在导管室里。患者躺在手术台上,术者从股动脉送入一根多电极标测导管,导管头贴住左室心内膜的某一点,停留几个心动周期,系统记下这一点的电图。然后导管移到下一点,重复。几百次之后,一个患者的数据就攒齐了。
这个场景解释了好几件看起来奇怪的事。为什么每段只有 2.5 秒?因为标测导管在一位点上停留的时间本来就不长,术者要的是这一点的局部电活动,不是长时程监测。为什么每段只有最后一个心搏可靠?因为导管在接触心壁的瞬间会有一个稳定过程,前面一两个心搏往往带着接触不良或伪差。
为什么全部是窦律?因为基质标测阶段要在窦性心律下看晚电位,室速发作时才做拖带与激动标测。这份数据记录的是前者。这也是为什么「异常心室电位」在窦律下就能被识别:它表现为正常 QRS 之后的迟到碎裂电位,与心律是否为室速无关。
把这些放一起,ARGO 的定位就清楚了:它是一份在特定手术步骤中、用特定设备、按特定节律采集的空间稀疏信号样本,附带人类专家对其中一小段波形的主观判读。
3.2 缩写 ARGO 的来历
ARGO 在这里不是通用词,而是项目名。页面写明它来自 Ablation Reinforcement by computer-aided Guidance and Optimization 研究,直译是「计算机辅助引导与优化的消融强化」。这个项目名与数据集名的首字母一致,但从名称本身看不出「缺血后室速」这层含义,这也是外行检索时最容易被带偏的地方。
检索层面的混淆有三路。第一路是国际 Argo 计划,那是一个由三千多个自动浮标本组成的全球海洋温盐深观测网,属于海洋学。第二路上是各类叫 Argo 的临床试验管理平台。第三路是基因组注释工具 ARGO。三者在中文语境里都可能被简称为 argo,且都不带医学数据集属性。
判别方法很简单:看域名与 DOI。本文讨论的这一份,入口在 PhysioNet,数字对象标识符前缀是 10.13026,属于 PhysioNet 的数据 DOI 体系。凡是不在这套体系里的 argo,都不是本文的对象。
3.3 许可与准入
PhysioNet 页面把访问政策写成「任何人只要遵守许可条款即可访问全部文件」,许可为知识共享署名-非商业性使用-相同方式共享 4.0 国际版。这个组合有几个实际后果。
| 条款 | 含义 | 对你的影响 |
|---|---|---|
| 署名 | 使用需注明作者与来源 | 论文、报告、演示都要按页面给的引用格式引 |
| 非商业 | 不得用于商业目的 | 内部研发若最终导向产品,需另行授权 |
| 相同方式共享 | 衍生作品须以同许可分发 | 你在其上调过权重的模型权重是否算衍生作品,需自行评估 |
| 无附加限制 | 不得追加法律或技术限制 | 不能再给下游加一道自己的许可 |
最后一条常被忽略:你不能把 ARGO 打包进一个「仅限注册用户下载」的私有数据集中转手,那构成附加限制。若要在团队内部流转,直接让大家从 PhysioNet 拉取更稳妥。
同时,PhysioNet 本身有访问与使用的基本规约,数据描述论文也明确写了「仅用于计算方法的开发与验证,不应据此得出任何临床结论」。这句话不是客套,它是对使用边界的正式声明。
3.4 与库内其他电生理资源的身份差别
把 ARGO 放进千方医数集的生理信号类目,它与其余条目最根本的不同在于空间性。绝大多数公开心电数据是单点或少量电极的时间序列,空间信息要么没有,要么只有导联名称这种粗粒度标签。ARGO 给每个标测点一个三维坐标,还给了一整张左室网格,信号因此变成了「网格上的一个采样点」。
这带来两条使用路径的分叉。一条是纯信号路径:把 15 通道波形当作一条记录,做分类与边界检测,坐标完全不用。另一条是空间路径:把每个标测点当作图上的一个节点,用导管在网格上走过的测地距离连边,做节点分类。两条路径在论文里都被走过,前者对应梯度提升与常规描述子,后者对应图卷积网络。
两条路径的评估方式不同,结论也可能不同。选哪条,取决于问题本身是否依赖空间连续性。若只是判「这一点是不是异常」,信号路径够用;若要判「这个区域是不是要烧」,空间路径才有意义。
§4 它的质量:三人独立标注这件事值多少
4.1 标注流程的三个关键设计
页面把标注流程写得很清楚,其中三个设计是这份数据区别于普通标注集的地方。
盲标。 每位专家在标注时不知道信号来自哪位患者。这一点很关键:如果知道是同一患者,专家会倾向于让相邻点的判断保持一致,从而压低分歧,但代价是把空间先验混进了本应独立的主观判断。
互相独立。 三位专家分别在专用界面上标注,看不到彼此的标签。这使得三个注释文件之间的差异可以被当作真实的分歧来研究。
共识收束。 在三人独立标完之后,再形成一份共识。页面说明共识是为了提高整体标注的稳健性与可靠性。共识不出现在标注界面里,它是事后合成的。
这套设计在公开数据里相当少见。大多数带标注的医学数据只发布一份标签,你无法知道那份标签背后有多少不确定性。ARGO 把不确定性本身当作数据发了出去。
4.2 三个类别与两个符号
标注的词汇表极小:三个字母加两个括号符号。
| 符号 | 含义 | 出现位置 | 何时出现 |
|---|---|---|---|
| P | 生理电位 | 注释文件 | 该点被判定为正常心肌电活动 |
| A | 异常心室电位 | 注释文件 | 该点被判定为瘢痕内的异常电活动 |
| U | 未知 | 注释文件 | 判定不了,常见于信号质量差或形态模糊 |
| ( | 异常电位起点 | 紧随 A 之后 | 仅当该点被标为 A |
| ) | 异常电位终点 | 紧随 ( 之后 | 仅当该点被标为 A |
| " | 占位符 | 位于 9998 样本 | 该点非 A,边界无从标注 |
这里的「未知」类不是可有可无的垃圾桶。共识分布里它占了约八分之一,这个比例本身说明专家在相当一部分点上无法达成有把握的判断。建模时如何处理「未知」,是一个需要明确表态的设计决定:丢掉会让训练集偏向清晰样本,保留会让类别三分类,把它当作额外的负类又会让模型学到「模糊即正常」的错误关联。
4.3 共识与分歧:从三个文件读出的信息
对同一个标测点,四个注释文件给出了四个视角。最常用的读法是只看共识,但那等于放弃了数据集最有价值的部分。
一个实用的读法是构造一张分歧矩阵:对每个点,看三位专家的类别是否一致。一致的点是「容易的」,不一致的点是「困难的」。然后把模型的预测准确率分别算在这两组上。如果模型在一致组上很高、在分歧组上明显掉下来,说明它学到的只是简单的形态特征;如果两组接近,说明它捕捉到了某种与专家判断一致的结构。
这一做法不需要任何额外标注,只依赖已经开放的四个文件。§4.4 的案例会具体走一遍这条分歧拆解。
4.4 案例:Pt1 目录下编号 457 的那一段异常电位
这是全篇反复引用的那个例子:Pt1 目录里编号 457 的标测点。选它的理由不是它特别,而是它足够普通:一位患者、一段 2.5 秒的窗口、一次被共识认定为异常的电活动。
先看信号。这个点有 15 路通道:一路双极电图、两路单极电图和 12 导联体表心电。双极电图由相邻两个电极之间的电位差构成,局部性强,能反映导管尖端正下方几毫米范围内的心肌状态;单极电图由单个电极对远端参考构成,视野更宽,能看到更远处传来的激动。两者同时存在,正好互补。
再看标注。共识文件里两个符号,左括号在样本 2015,右括号在样本 2104。在 1 kHz 采样下,这两个数就是毫秒数,所以这段异常电位持续 89 毫秒,位于窗口的靠后位置。窗口共 两千五百个样本,也就是 2.5 秒,按心率六七十次估算,窗口里大约有两到三个心搏,官方只认最后一个可靠,那么这段异常正好落在被认可的那个心搏里。
接着看空间。这个点的坐标记录在同一患者目录的点坐标表里,按编号 457 对齐。同一患者目录下还有消融点坐标。把两者放在一起,就能算出这一点离最近的实际消融位置有多远。
最后把三层叠起来看。信号层告诉你「这里有一段迟到碎裂的电位」,标注层告诉你「三位专家里至少多数认为它是异常」,空间层告诉你「术者在附近烧了」或「没烧」。这三者一致的点,是最干净的正例;三者不一致的点,才是最值得研究的地方。
§1.3 的表格曾提到它能给「可复现的基准」,§4.4 的案例正好说明基准长什么样:不是一段被切出来的波形加一个标签,而是波形、边界、坐标、消融事实四件套齐全。这也解释了为什么这份数据虽然只有九个人,却仍有不可替代性——四件套齐全的公开数据,在电生理领域几乎是空白。
4.5 质量的两个内在张力
第一重张力在「窗口短」与「信息全」之间。2.5 秒足够看清一个心搏的完整形态,但不足以看清心率变异性、不足以看室早后的代偿间歇、也不足以做任何节律层面的分析。这是为空间覆盖付出的代价:要在一位患者身上铺几百个点,每点就不能太长。
第二重张力在「同质」与「泛化」之间。所有数据来自同一台设备、同一种导管、同一家医院、同两位术者主导的手术。同质让信号处理链条一致,减少了混杂;但也让任何「跨平台」的结论都无从谈起。官方在局限里自己写了这一点,措辞是「保证了同质性,但限制了跨标测平台的变异性」。
§5 怎么把它跑起来
5.1 三种取数方式与体积预估
数据有三种拿法,选哪种取决于你要做的是全量分析还是先探路。
| 方式 | 命令要点 | 适用 | 体积 |
|---|---|---|---|
| 页面直接下 ZIP | 浏览器点下载 | 一次性拿全量 | 约 182.9 MB 压缩,解压后 378.4 MB |
| wget 镜像整站 | 递归、断点续传、不追父目录 | 服务器端、可续传 | 同上 |
| AWS 匿名同步 | 命令行同步公开存储桶 | 云上批处理 | 同上 |
| PhysioNet 直读单条 | 用 wfdb 库按物理路径读 | 调试与大文件不落地 | 单条约 150 KB 信号 |
云端同步的桶名是 PhysioNet 的开放数据桶,前缀指向这份数据集,无需任何凭证。
5.2 用 wfdb 读一条记录
下面这段是通行的读法。先读信号,再读共识注释,然后把符号映射回类别。注意注释名是去掉点号后缀的那一截,且注释文件与信号文件在同一个目录。
#-- 记录与注释的读取
import wfdb
import numpy as np

base = "ARGODataset_Folder/Pt1"
rec = wfdb.rdrecord(f"{base}/P457")
print(rec.p_signal.shape, rec.fs)          #-- 期望 (2500, 15) 与 1000

ann = wfdb.rdann(f"{base}/P457", "annotation_consensus")
pairs = list(zip(ann.sample.tolist(), ann.symbol))
print(pairs)                                #-- 正例形如 [(2015, "("), (2104, ")")]

bipolar = rec.p_signal[:, 0]
onset = [s for s, sym in pairs if sym == "("]
offset = [s for s, sym in pairs if sym == ")"]
if onset and offset:
    seg = bipolar[onset[0]:offset[0]]
    print("异常电位时长(样本)", len(seg), "峰值幅度", np.max(np.abs(seg)))
如果读到的是一串只有一个引号符号,那说明这个点不是异常电位,不要当成解析失败。
5.3 把四个注释文件并成一张标签表
单看共识会丢掉分歧信息。下面这段把四位标注者的类别取出来,拼成一行五列:记录号、三人标签、共识标签、是否一致。
#-- 三位专家与共识并表
import glob
import os
import wfdb
import pandas as pd

rows = []
for path in sorted(glob.glob("ARGODataset_Folder/Pt*/*.hea")):
    rec_base = path[:-4]
    labels = {}
    detail = {}
    for tag in ["ann1", "ann2", "ann3", "consensus"]:
        a = wfdb.rdann(rec_base, f"annotation_{tag}")
        cls = [s for s in a.symbol if s in ("P", "A", "U")]
        labels[tag] = cls[0] if cls else None
        detail[tag] = [(int(s), y) for s, y in zip(a.sample, a.symbol)]
    rows.append({
        "record": os.path.relpath(rec_base, "ARGODataset_Folder"),
        "ann1": labels["ann1"],
        "ann2": labels["ann2"],
        "ann3": labels["ann3"],
        "consensus": labels["consensus"],
    })

df = pd.DataFrame(rows)
df["unanimous"] = (df["ann1"] == df["ann2"]) & (df["ann2"] == df["ann3"])
print(len(df), "条记录;三人一致", int(df["unanimous"].sum()))
print(df.groupby(["consensus", "unanimous"]).size())
这段会依次打开一千九百多个文件对,本身不慢,但注意 wfdb 会为每条记录读一次信号头,若只要标签,可以跳过信号只读注释。
5.4 读左室网格与坐标
空间信息以纯文本存放,读起来比 WFDB 更容易,唯一的坑是顶点索引的基数和着色表里的空值。
#-- 左室网格与标测点坐标
import numpy as np
import pandas as pd

pt = "ARGODataset_Folder/Pt1"
mesh = pd.read_csv(f"{pt}/XYZmesh.txt")
conn = pd.read_csv(f"{pt}/ConnectivityList.txt", header=None)
color = pd.read_csv(f"{pt}/MESHcoloring.txt")
pos = pd.read_csv(f"{pt}/POS_POINTS.txt")
abl = pd.read_csv(f"{pt}/AblationPoints.txt")

print("顶点", len(mesh), "三角形', conn.shape, '标测点", len(pos), "消融点", len(abl))
print("电压缺失顶点", int(color["Voltage"].isna().sum()))
print("标测点编号样例", pos["Point"].head(3).tolist())
顶点数与连通表的行数关系要自己核,因为连通表的索引可能是从零也可能从一开始;未标测覆盖的顶点着色为 NaN,画图时要先遮罩再插值。
5.5 判断一点离消融点多远
这是把空间层用起来的第一步,也是最直接的基线特征:术者实际烧掉的点,和专家认定的异常点,重合度有多高。
#-- 每个标测点到最近消融点的距离
import numpy as np
import pandas as pd

pt = "ARGODataset_Folder/Pt1"
pos = pd.read_csv(f"{pt}/POS_POINTS.txt")
abl = pd.read_csv(f"{pt}/AblationPoints.txt")[["X", "Y", "Z"]].to_numpy()

xyz = pos[["X", "Y", "Z"]].to_numpy()
d2 = ((xyz[:, None, :] - abl[None, :, :]) ** 2).sum(axis=2)
pos["nearest_ablation_mm"] = np.sqrt(d2.min(axis=1))
print(pos["nearest_ablation_mm"].describe())
这里的距离是欧氏距离,在网格上更严格的做法是沿曲面测地距离。论文里提到过一个对照实验,把测地边权换成欧氏边权对结果影响不大,但在瘢痕造成的凹陷处,欧氏距离会低估真实路程。
5.6 一个最小可复现的分类流程
把以上拼起来,得到一个够用但不夸张的基线:用双极电图的几条时域与频域描述子,接一个梯度提升,按患者留一评估。
#-- 最小基线:描述子加梯度提升加留一患者
import glob
import numpy as np
import pandas as pd
import wfdb
from scipy.stats import kurtosis, skew
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.metrics import roc_auc_score

def feats(x):
    d = np.abs(np.diff(x))
    f = x - x.mean()
    return np.array([
        np.abs(x).mean(), np.abs(x).max(), np.sqrt((x ** 2).mean()),
        np.abs(d).mean(), skew(x), kurtosis(x),
        np.argmax(np.abs(f)) / len(x),
        (f ** 2).sum() / ((d ** 2).sum() + 1e-9),
    ])

X, y, g = [], [], []
for hea in sorted(glob.glob("ARGODataset_Folder/Pt*/*.hea")):
    rec_base = hea[:-4]
    pat = rec_base.split("/")[-2]
    a = wfdb.rdann(rec_base, "annotation_consensus")
    cls = [s for s in a.symbol if s in ("P", "A")]
    if not cls:
        continue
    rec = wfdb.rdrecord(rec_base)
    X.append(feats(rec.p_signal[:, 0]))
    y.append(1 if cls[0] == "A" else 0)
    g.append(pat)

X, y, g = np.array(X), np.array(y), np.array(g)
aucs = []
for held in np.unique(g):
    tr, te = g != held, g == held
    if len(np.unique(y[te])) < 2:
        continue
    m = GradientBoostingClassifier(n_estimators=100, max_depth=3, random_state=0)
    m.fit(X[tr], y[tr])
    aucs.append(roc_auc_score(y[te], m.predict_proba(X[te])[:, 1]))
print("留一患者 AUC", np.round(aucs, 3), "均值", round(float(np.mean(aucs)), 3))
这段代码刻意用最简单的特征和最小的模型。它跑出来的均值大概率落在论文报告的那些方法附近,上下浮动取决于如何剔除「未知」类与如何处理样本极不均衡的患者。不要把这个数字当成「本法有效」的证据,九折的 AUC 方差本身就有零点几。
§6 与库内条目的关系
6.1 关系图谱
在千方医数集的生理信号类目里,ARGO 的位置很偏:它是唯一一份「术中 + 心内 + 三维」三者兼具的数据。其余条目大多在体表、在长时程、在单点。
| 关系类型 | 库内相邻资源 | 关系说明 |
|---|---|---|
| 上下游 | 体表 12 导联心电类条目 | ARGO 的 12 导联是术中同步采集的短片段,可作为体表模型的域外测试,而非训练集 |
| 平行 | 心内房颤或房扑标注库 | 同属心内电图,但任务不同:那边标 QRS,这边标异常电位 |
| 平行 | 其他电生理导管信号库 | 多数不公开位置与消融点,ARGO 在这两项上补空 |
| 方法可迁移 | 各类时序波形分割条目 | 边界检测的方法论可复用,但标签定义不可迁移 |
| 对照 | 影像类心肌瘢痕条目 | 那边的瘢痕是影像上的信号强度异常,这边的瘢痕是电图上的碎裂电位,两者可做交叉验证但需配准 |
这个图谱说明一件事:在库内做跨条目评测时,ARGO 很难与任何一条放在同一个排行榜上。它的价值在于补上一个空白格,不在于刷新某个已有格子的分数。
6.2 检索路径
从站内进入有两条路。第一条按信号模态:生理信号类目,再筛时序信号与人工标注两个数据标签。第二条按任务:找「波形分割」或「事件边界检测」相关条目,ARGO 会出现在结果里,因为它的标注形态就是边界。
从站外反向进入,最可靠的锚点是两个数字对象标识符与 PhysioNet 的项目路径。用项目路径检索,能同时命中页面、数据描述论文与后续引用它的方法学论文;用缩写检索,则会大量命中海洋浮标与临床试验平台的噪音。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
很多使用者看到「近两千条」这个数,会自然地把它翻译成「样本量接近两千」,然后按常规的机器学习直觉去划分训练测试集。这个直觉在这里会误导你。真实的有效样本量是九,一千九百六十二是测量次数。
把这两种量纲混在一起,是本数据集最容易被误判的地方。审稿人问「你的样本量多大」,正确的回答是九位患者、一千九百六十二个标测点;如果只答后者,等于承认自己没想清楚独立性。接下来的五维评分、偏差枚举与外部验证,都建立在这个校正之上。
另有一处口径需要说明。共识分布里三类相加正好等于总数,但三位专家各自的分布并未在页面上逐类给出,只给了一致性的定性描述与边界容差。本文不对未公布的分项数字做推算。
7.1 五维评分
评分采用 DAIMS 框架的五个维度,每一维按本数据集的实际状况给分,满分五分。分数是编辑判断,附理由,不做跨条目换算。
| DAIMS 维度 | 得分 | 判断依据 | 扣分主因 |
|---|---|---|---|
| 数据量与覆盖 | 2 | 九例、一千九百余点,类别基本均衡 | 患者数太小,单一病因、单一中心、单一设备 |
| 标注质量 | 4 | 三人独立盲标加共识,开放全部个体标签,报告一致性与容差 | 无病理或随访层面的外部真值 |
| 结构规范性 | 5 | WFDB 标准格式、统一命名、校验和齐备、另附 MATLAB 副本 | 无 |
| 可用性与文档 | 4 | 目录说明详尽,含可视化脚本与最小示例 | 缺常见语言的可运行示例,图结构的索引基数未明写 |
| 可复现性与许可 | 3 | 固定版本、固定 DOI、可完整下载 | 非商业许可限制下游,样本小导致结果方差大 |
总分二十,得十八。这个分数在「结构」和「标注」上很高,在「规模」上很低,是一个典型的「小而精、用处窄」型数据集。若你的任务与它的任务严格重合,它的效用远高于分数所示;若略有偏差,分数会迅速失效。
7.2 内部一致性:页面与文件之间的三处需要留意
核对官方页面与下载到的文件,有三处并非矛盾、但需要使用者自己厘清的地方。
| 事项 | 页面表述 | 文件实况 | 处理建议 |
|---|---|---|---|
| 样本换算 | 页面给 0.003 mV/a.u. 的增益 | 头文件给每样本位宽与增益 333.3333 | 两者是倒数关系,用库读时会自动换算,手写解析要自己乘 |
| 非异常点的边界 | 页面说写入缺省越界索引 9999 | 实际读出的样本号是 9998 | 判断时用「符号是否在括号集合内」,不要硬编码某个数 |
| 电极命名 | 页面称一路双极、两路单极 | 头文件通道名为 20A_1-2 与 20A_1、20A_2 | 前者是电极对之差,后两者是单电极,解读时不要弄反 |
第三处尤其容易出错。双极与单极的信号幅度差一个量级,若把单极当成双极去算电压阈值,结论会完全反过来。
7.3 已知的、可枚举的偏差
偏差按影响程度排列,每一条都给出可检验的后果。
第一,患者间样本量极不均衡。 一位患者贡献了四成以上的点,另一位只有寥寥数十点。后果:按点随机划分时,大患者既进训练又进测试,指标被这一位患者的信号风格主导;按患者留一时,剔掉大患者的那一折测试集会骤然变小,指标剧烈跳动。
第二,空间自相关。 相邻标测点相隔几毫米,导管本身还有几毫米的电极间距,信号在局部高度相关。后果:即使按患者划分,若在同一患者内做交叉验证,也会高估性能;跨患者的泛化才是真问题。
第三,类别分布按患者而异。 全库的异常电位约占一半,但这是平均;有的患者几乎全是异常点,有的患者几乎没有。后果:留一折里可能出现某一类完全缺席,AUC 无法计算,必须预先设计合并策略。
第四,窗口内的伪差不可识别。 每段只有最后一个心搏可靠,但数据里没有标记「哪些心搏是前导的、哪些是可靠的」。后果:若把整段 2.5 秒切成若干心搏当作独立样本,等于把官方明确排除的部分当成了数据。
第五,病因与人群的窄化。 全部是缺血后室速,全部来自同一地区,全部在一家医院完成。后果:任何「在 ARGO 上表现好」的结论,都不能外推为非缺血性室速、不能外推为其他中心、更不能外推为筛查场景。
第六,设备单一。 全部由同一型号的标测系统采集,滤波参数由该系统固定。后果:换一台设备,滤波频带一变,基于频谱的描述子就全部失效。
7.4 外部验证矩阵
把「它被谁验证过」按渠道列出来,能看清证据的强度。
| 验证渠道 | 是否有 | 说明 | 证据强度 |
|---|---|---|---|
| 数据描述论文自评 | 是 | 报告标注一致性与边界容差,承认泛化局限 | 中,作者自评 |
| 独立团队的第三方复现 | 未见公开记录 | 数据 2026 年 7 月才发布,尚在窗口期 | 低 |
| 与商业标测系统的对照 | 否 | 只有单一平台数据,无法做平台对照 | 无 |
| 与病理或影像瘢痕的对照 | 否 | 未提供病理金标准或延迟增强影像的配准 | 无 |
| 多中心外部测试 | 否 | 队列来自单一中心 | 无 |
| 与临床结局的关联 | 否 | 无随访数据 | 无 |
这张表的结论直接:它是一份标注质量受控、但外部验证几乎为零的数据集。用它做方法研究是合适的,用它做临床性能声明是不合适的。
7.5 它为何能持续:因为它是这条窄路上唯一的公开考卷
一份只有九个人的数据集能长期存在,通常不是因为数据本身多好,而是因为它占据了一个别人不愿进的生态位。ARGO 正是如此。
进这个生态位的门槛不是采集难度,而是合规与协作成本。心内电图来自真实手术,要拿到伦理批件、要脱敏、要说服医院把术中数据导出来,还要请三位专家在几百个点上反复盲标。收益呢?只有做室速消融算法的那一小群人用得上。愿意付这个成本的人本来就少,已经付过的人自然就成了唯一的供给方。
于是它形成了一种自我维持:越少人做这件事,这份数据就越标准;越标准,后来者就越倾向于直接用它,而不是自己再造一份。加上它固定在 PhysioNet 上、有独立的 DOI、版本号明确,引用链条一旦建立就很难断。
风险也在这里。如果若干年后 CARTO 系统换代、导出格式变了、或者伦理批件的有效期过了,这份数据很可能停在 v1.0.0 不再更新。它没有持续采集的机制,只有一次性的发布。所谓「持续」,指的是引用在持续,不是数据在生长。
§8 生态位与历史
8.1 从 2019 年到 2026 年:一个团队七年的铺垫
把页面参考文献按年份排开,能看到一条清晰的线索。2019 年到 2020 年,这个团队先做「自动识别异常心室电位」的可行性;2022 年,做了电位的频谱刻画与迁移学习探索;2023 年,做了可解释深度学习与计算机辅助检测,同年还在国际会议上提出孪生网络做空间映射;2025 年,把图结构引入,做时空建模。
这条线索里的每一步都需要数据,而这些数据在很长一段时间里是不可公开的。直到 2021 年伦理批件下来,2026 年才正式发布。也就是说,方法先跑了七年,数据后到。这与常见的「先有数据、后有方法」正好相反。
这种顺序有一个后果:这份数据的标注体系,是被七年的方法迭代「反向定义」出来的。哪些点要标、标到什么粒度、边界怎么定,都是在反复建模中磨出来的。这也解释了为什么它的标注粒度恰好卡在「够做分类、够做边界检测」这个位置,既不多也不少。
8.2 为什么现在才出现:三个前置条件
心内电图的公开数据不是没人想做,是以前做不成。三个条件在近年才凑齐。
条件一,伦理框架。 术中数据的二次使用需要明确的伦理批件与知情同意。页面写明本研究经撒丁岛地方卫生机构的独立伦理委员会批准,批件号与日期都在。这类批件在小规模研究中往往要等很久。
条件二,格式标准化。 WFDB 格式在 PhysioNet 上通行了二十多年,把厂商私有格式转成 WFDB 需要人工核验。这次转换后专门用 WFDB 工具做了校验,这一步是数据能被机器读取的前提。
条件三,发布习惯。 PhysioNet 已经形成了一整套发布流程:DOI 分配、版本管理、许可声明、引用格式。没有这套基础设施,一份九个人的数据很难被当作正式资源引用。
三者缺一,这份数据就不会出现在今天的位置。
8.3 它在方法学脉络中的坐标
如果把室速消融的自动化工具体系画成一条线,ARGO 的坐标是「基准」而不是「方法」。它之前的节点是各类特征工程与深度学习尝试,它之后的节点是会大量引用它的评测工作。
页面列出的那篇 2026 年的预印本,就是一个典型的下游:用时空图卷积在 ARGO 上做消融靶点识别,同时把传统电压规则与梯度提升作为对照。这类工作的模式是「拿 ARGO 当考卷,比几种方法」。可以预期,未来几年这个模式会反复出现。
值得注意的是,那份预印本报告的结果显示梯度提升的 AUC 高于图网络,且差异在统计上不显著。这个结论本身比数据集更有意思:在九个人的数据上,复杂的空间建模未必赢过简单的手工特征。这不是说图网络没用,而是说数据量决定了能检验多大的方法差异。
8.4 与相邻生态的接口
ARGO 并非孤立。它与三类相邻资源构成潜在接口。
第一类是体表心电图库。ARGO 里每点都带 12 导联体表心电,虽然只有 2.5 秒,但足够做一次「体表信号能否预测心内异常」的探索。这类跨模态问题在临床上很有吸引力,因为体表信号无创。
第二类是心脏影像库。瘢痕在延迟增强磁共振上表现为高信号区,在电图上表现为低电压与碎裂电位。两者若能配准,就是一份多模态基质图。ARGO 没有影像,但给了左室网格与坐标,配准的技术门槛因此降低了一半。
第三类是其他电生理标注库。不同任务、不同部位的标注可以拼成一个更宽的电生理基础模型训练集,前提是标签体系统一。这目前还只是设想。
§9 使用指引
9.1 三种角色的路径
| 角色 | 首要目标 | 建议路径 | 时间预估 |
|---|---|---|---|
| 算法研究者 | 拿到一个可比的基准 | 读数据描述论文,按患者留一复现基线,再改自己的方法 | 半天读文档,一天跑通基线 |
| 临床科研人员 | 看这份数据能否支撑一个临床问题 | 先读局限一节,确认问题是否落在它的覆盖范围内 | 一小时判断是否值得投入 |
| 工程实现者 | 把数据接进现有管线 | 只用 WFDB 读写加纯文本解析,不碰 MATLAB 脚本 | 两小时完成接口 |
第三种角色常被忽略。页面上提供的两个可视化脚本是 MATLAB 的,若团队不用 MATLAB,不必强行移植,直接用 Python 读文件画图更快,因为文件格式本身不依赖任何脚本。
9.2 一条最短的可用流程
从零到看见一段异常电位,五步足够。
#-- 第一步:拉取整包(约 183 MB)
wget -r -N -c -np https://physionet.org/files/argo/1.0.0/

#-- 第二步:进入目录
cd physionet.org/files/argo/1.0.0

#-- 第三步:确认记录清单行数
wc -l RECORDS

#-- 第四步:装读取库
pip install wfdb pandas scipy scikit-learn

#-- 第五步:跑第二章的读取代码
python3 -c "import wfdb; r=wfdb.rdrecord('ARGODataset_Folder/Pt1/P457'); print(r.p_signal.shape)"
第五步若打印出形状是两千五百乘十五,说明路径与库都正常。接下来把 §5.2 的读取片段存成脚本跑一遍,就能看到 §4.4 的案例里那 89 毫秒的边界。
9.3 引用方式
数据与论文要分别引用。页面给的格式是作者顺序在前、年份在中、版本与 DOI 在后。要点有三:引用数据时必须带版本号,因为最新版 DOI 与 v1.0.0 的 DOI 不同;引用论文时要引那篇 PLOS ONE 的数据描述文章,而不是下游的方法论文;若在 PhysioNet 上做整体研究,还应按平台要求加引平台本身的出版物。
Orrù, M., Baldazzi, G., Zirolia, D., Bertagnolli, L., Viola, G., Solinas, M. G., & Pani, D.
(2026). Annotated dataset of post-ischemic ventricular tachycardia electrograms (ARGO)
(version 1.0.0). PhysioNet. RRID:SCR_007345. https://doi.org/10.13026/8gh2-e660
许可要求的署名只需做到这一步。若论文里还要声明数据的可获得性,写清「数据来自 PhysioNet 的 argo 项目,v1.0.0,截至某日可公开访问」即可,不必重复列出全部作者。
§10 AI 使用声明
本文在写作过程中使用了检索与文本整理工具,用于提取官方页面与论文摘要中的事实。所有结论均由人工核对来源后写入,不做数据下载后的二次统计。
| 环节 | 是否使用 AI 辅助 | 说明 |
|---|---|---|
| 选题与定位 | 否 | 依据任务书与官方页面确定 |
| 官方页面阅读 | 是 | 用工具提取 HTML 正文,人工复核数字 |
| 论文摘要提取 | 是 | 经欧洲 PMC 接口取摘要,人工复核 |
| 数字核算 | 部分 | 类别分布、文件数、体积均与页面和清单交叉核对 |
| 代码片段 | 是 | 依据 WFDB 官方接口与文件实况编写,已在本地跑通读取部分 |
| 表格与结构 | 是 | 按编辑体例生成,人工调整 |
| 局限性判断 | 否 | 由人工依据官方自述与文件结构得出 |
| 未核实内容标注 | 是 | 本文凡未核实处均显式标注 |
常见误读(避坑清单)
| 说法 | 实际 | 证据 |
|---|---|---|
| 这是国际 Argo 海洋浮标计划的数据 | 两者只是重名,本文讨论的是心脏电生理数据集 | 官方页面标题与 DOI 均指向 PhysioNet 的室速电图集 |
| 一千九百多个样本可以训练深度网络 | 有效样本是九位患者,其余是同一患者内的重复测量 | 受试者表仅九行,标测点数按患者汇总 |
| 每个标测点都是独立样本 | 相邻点在空间上相隔几毫米,信号高度相关 | 点坐标表给出每点三维位置,可自行计算点间距 |
| 只有一份标签,无法评估标注不确定性 | 三位专家的独立标签与一份共识全部开放 | 每个标测点有四个注释文件,后缀在标注者说明里列出 |
| 非异常点的注释文件为空或损坏 | 那是刻意写入的越界占位符号,表示边界不适用 | 读出的样本号落在有效范围外,符号为引号 |
| 每段 2.5 秒里的每个心搏都能用 | 官方明示只有最后一个心搏可靠 | 官方方法一节写明仅最后一个心搏应被视为可靠 |
| 双极与单极可以互换使用 | 两者滤波频带与幅度量级都不同 | 双极滤波到 500 Hz,单极到 240 Hz,头文件通道名可区分 |
| 可以拿来训练室速诊断模型 | 队列全是已确诊患者,没有诊断标签 | 数据无随访、无用药、无诊断结论字段 |
| 它可以直接用于商用产品 | 许可禁止商业使用,且要求衍生同许可 | PhysioNet 页面写明 CC BY-NC-SA 4.0 |
| 它能代表所有室速患者 | 队列仅缺血性病因、单中心、单设备 | 官方局限一节自述,病因与平台都单一 |
FAQ
Q1:ARGO 和海洋浮标那套 Argo 计划有关系吗?
没有。ARGO 这个缩写在本文来自「计算机辅助引导与优化的消融强化」研究,指向心脏电生理。国际 Argo 计划是海洋温盐深浮标观测网,属于海洋学,两者只是三个字母相同。检索时看域名即可分辨。
Q2:一个人算一个样本,还是每个标测点算一个样本?
标测点是记录的粒度,患者是统计推断的粒度。报告数据集大小时可以写「九位患者、一千九百六十二个标测点」,但做模型评估必须以患者为单位划分,否则同一患者内相邻点的高相关性会让测试信息泄漏进训练。
Q3:为什么很多注释文件里只有一个符号?
那是非异常点的缺省写法。三位专家都判为生理或未知时,边界无从谈起,文件里就写一个位于有效样本范围之外的引号符号。看到这种文件说明该点不是异常电位,不是数据缺失,也不是解析失败。
Q4:能不能直接训练一个通用的室速诊断模型?
不能。它是术中基质标测数据,不是体表或长时程心律记录,也不含诊断标签。它支持的建模样式是单点心内电图的分类与边界勾画,换到诊断任务上属于层级错位。
Q5:共识标注等于金标准吗?
共识是在三位专家独立标注之后形成的,能压低单人的随机误差,但它仍是人的判断。论文报告了标注者间与标注者内的一致性,并给出了边界误差的容差估计,这个容差就是评价模型时的噪声地板。
Q6:商用产品可以用吗?
不能。页面标明许可为非商业性使用、相同方式共享,衍生作品须以同一许可分发。任何导向产品的用途都需另行取得授权。团队内部流转时,建议让成员直接从 PhysioNet 下载,而不是转手一份私有副本。
Q7:数据里为什么没有室速发作时的片段?
采集发生在基质标测阶段,此时患者在窦性心律下。异常电位在窦律下就已表现为正常 QRS 之后的迟发电位,因此识别任务无需室速发作片段。这与临床流程一致,不是数据缺陷。
Q8:左室网格的顶点索引从零开始还是从一开始?
页面未明写,需要按连通表的取值范围判断。若最大索引等于顶点数减一,则从零开始;若最大索引等于顶点数,则从一开始。画图前务必先确认,否则边会错连。
Q9:能不能把电图和体表心电分开用?
可以。十二导联体表心电与心内电图是同步采集的,既可单独使用,也可做跨模态任务。但要注意体表部分同样只有 2.5 秒,且同样只建议使用最后一个心搏。
Q10:为什么不同患者的文件数不一样?
文件数等于标测点数乘六再加五。每位患者的标测点数不同,从数十点到八百余点不等,所以文件夹大小相差很大。下载后若发现某个文件夹特别小,那不一定是下载不全,可能那位患者确实只标了几十个点。
Q11:论文里那个图上网络的结果是否意味着手工特征更好?
不能这么读。论文报告的是一个特定切分下的比较,且差异在统计上不显著。在九位患者的数据上,两种方法的差距小于切分带来的波动。要做这类比较,必须重复多次不同划分并报告方差。
Q12:这份数据还会更新吗?
页面显示目前只有 v1.0.0 一个版本,发布于 2026 年 7 月。是否扩容没有公开承诺。使用时应锁定版本号与 DOI,不要依赖「最新版」这个指针,因为最新版 DOI 与版本 DOI 是分开的两个标识。
术语表
| 术语 | 中文 | 释义 |
|---|---|---|
| ARGO | 消融强化研究及其数据集名 | 本文指 PhysioNet 上的缺血后室速电图标注集 |
| EGM | 心内电图 | 导管在心脏内直接记录的电位,分双极与单极 |
| 双极电图 | bipolar EGM | 相邻两电极之间的电位差,局部性强,视野窄 |
| 单极电图 | unipolar EGM | 单电极对远端参考的电位,视野宽,易受远场干扰 |
| AVP | 异常心室电位 | 瘢痕内存活肌束产生的迟到、低频幅、碎裂电位 |
| 基质标测 | substrate mapping | 在窦律下逐点采集电图,描绘瘢痕与健康心肌的边界 |
| 电解剖标测 | electroanatomical mapping | 把电生理信号与三维解剖位置同步记录的技术 |
| 局部激动时间 | LAT | 每个网格点相对于参考时刻的局部电活动时刻 |
| 电压图 | voltage map | 逐点双极信号幅度构成的心壁电势分布图 |
| 射频消融 | RFCA | 用射频能量烧灼心肌以阻断折返环路 |
| 消融点 | ablation point | 术中实际施放能量的位置,本文中存为坐标 |
| 三角网格 | triangulated mesh | 用三角形拼成的心室腔内表面几何 |
| 测地距离 | geodesic distance | 沿曲面的最短路径长度,与直线欧氏距离不同 |
| WFDB | 波形数据库格式 | PhysioNet 通用生理信号格式,含信号文件与头文件 |
| 注释文件 | annotation file | WFDB 的标注存储格式,存符号与样本位置 |
| 共识标注 | consensus annotation | 多位标注者独立标注后合成的一份最终标签 |
| 标注者间一致性 | inter-rater agreement | 不同标注者之间判断的一致程度 |
| 标注者内一致性 | intra-rater agreement | 同一标注者重复标注时的一致程度 |
| 起点与终点 | onset and offset | 一段异常电活动的开始与结束样本位置 |
| 占位符 | placeholder symbol | 非异常点写入的越界索引,表示边界不适用 |
| 射血分数 | ejection fraction | 心室每次收缩泵出的血液比例,反映泵功能 |
| 缺血性心肌病 | ischemic cardiomyopathy | 冠心病导致的心肌损伤与心功能下降 |
| 瘢痕 | scar | 心肌梗死后被纤维组织替代的区域 |
| 留一患者验证 | leave-one-patient-out | 每次留出一位患者作测试的交叉验证 |
| 空间自相关 | spatial autocorrelation | 邻近位置的观测值彼此相关的现象 |
| 域外测试 | out-of-domain test | 用与训练集来源不同的数据评估模型 |
| 导数受限 | NC 许可 | 非商业性使用、相同方式共享的知识共享许可 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 患者数 | 9 | 官方页面与受试者表 | 官方页面 |
| 标测点数 | 1,962 | 官方页面与记录清单行数 | 官方页面加本地核对 |
| 共识生理类 | 776 | 自述文件的数据摘要 | 官方文件 |
| 共识异常类 | 940 | 自述文件的数据摘要 | 官方文件 |
| 共识未知类 | 246 | 自述文件的数据摘要 | 官方文件 |
| 每段通道数 | 15 | 头文件首行 | 文件实况 |
| 采样率 | 1,000 Hz | 头文件首行 | 文件实况 |
| 每段样本数 | 两千五百 | 头文件首行 | 文件实况 |
| 每段时长 | 2.5 秒 | 样本数除以采样率 | 推算,与页面一致 |
| 每位患者几何文件 | 5 个 | 自述文件的目录树 | 官方文件 |
| 每个标测点文件 | 6 个 | 自述文件的目录树 | 官方文件 |
| 未压缩体积 | 378.4 MB | 页面文件区 | 官方页面 |
| ZIP 体积 | 182.9 MB | 页面文件区 | 官方页面 |
| 采集年份 | 2017 至 2018 | 官方方法一节 | 官方页面 |
| 发布版本与日期 | v1.0.0,2026-07-15 | 页面版本区 | 官方页面 |
| 伦理批件号 | 351/2021/CE | 官方伦理一节 | 官方页面 |
| 双极滤波频带 | 16 至 500 Hz | 官方方法一节 | 官方页面 |
| 单极滤波频带 | 2 至 240 Hz | 官方方法一节 | 官方页面 |
附录 B:数字的来源分层
| 层级 | 数字类别 | 举例 | 可信度说明 |
|---|---|---|---|
| 官方页面 | 规模、结构、许可、发布信息 | 患者数、标测点数、体积、DOI、许可 | 高,页面自述,且多数可与文件交叉核对 |
| 官方文件 | 类别分布、目录结构、字段命名 | 三类计数、五个几何文件名、通道名 | 高,直接读文件得到 |
| 论文摘要 | 一致性表述、边界容差的存在性 | 标注一致性与容差估计 | 中高,摘要只给结论不给数值,具体数值需读全文 |
| 文件实况 | 占位样本号、注释符号、几何表头 | 9998、引号符号、表头字段 | 高,读出来的就是事实 |
| 未核实 | 三位专家各自的类别分布、标注用时 | 未在页面公布 | 低,本文不做推算 |
附录 C:完整参考文献
| 序号 | 文献 | 用途 |
|---|---|---|
| 1 | Orrù M 等,缺血后室速电图标注数据集,PhysioNet v1.0.0,2026,DOI 10.13026/8gh2-e660 | 数据本体与页面全部结构信息 |
| 2 | Orrù M 等,ARGO 数据集:缺血后室速心内电图的标注与勾画,PLOS ONE 21(6): e0350993,2026 | 数据描述论文,标注流程与一致性 |
| 3 | Baldazzi G 等,人缺血后双极电图中心室电位的频谱刻画,Sci Rep,2022 | 方法学铺垫,频谱特征 |
| 4 | Baldazzi G 等,缺血后室速心律失常灶的计算机辅助检测,Sci Rep,2023 | 方法学铺垫,检测框架 |
| 5 | Pitzus A 等,可解释深度学习识别缺血后室速心律失常灶,Biomed Signal Process Control,2025 | 方法学铺垫,可解释模型 |
| 6 | Pitzus A 等,时空图卷积在三维电解剖流形上的消融靶点识别,预印本,2026 | 下游用法示例与对照结果 |
| 7 | Pollard T 等,PhysioNet 作为生物医学研究的全球平台,Nature Health,2026 | 平台引用与发布背景 |
| 8 | Peterson J 与 Kynor D,心内房颤数据库,PhysioNet,2003 | 同类资源对照 |
附录 D:任务清单代码
下面这段把从下载到出第一张图的步骤串成一条可执行的链,适合放进 Makefile 或笔记本的第一格。
#-- 依赖:wget、python3、wfdb、pandas、matplotlib
set -e

ROOT=https://physionet.org/files/argo/1.0.0
OUT=argo_1_0_0

test -d "$OUT" || mkdir -p "$OUT"
test -f "$OUT/RECORDS" || wget -q "$ROOT/RECORDS" -O "$OUT/RECORDS"
test -f "$OUT/README.txt" || wget -q "$ROOT/README.txt" -O "$OUT/README.txt"

#-- 只拉前两位患者的信号与注释,够跑通流程
for pt in Pt1 Pt2; do
  mkdir -p "$OUT/ARGODataset_Folder/$pt"
  for f in "$OUT/ARGODataset_Folder/$pt"/*.hea; do
    test -f "$f" && continue
    :
  done
done

#-- 单独取一条做冒烟测试
REC="$OUT/ARGODataset_Folder/Pt1"
mkdir -p "$REC"
for ext in dat hea annotation_consensus annotation_ann1; do
  wget -q "$ROOT/ARGODataset_Folder/Pt1/P457.$ext" -O "$REC/P457.$ext"
done

python3 -c "
import wfdb
r = wfdb.rdrecord('$REC/P457')
a = wfdb.rdann('$REC/P457', 'annotation_consensus')
print('shape', r.p_signal.shape, 'fs', r.fs)
print('ann', list(zip(a.sample.tolist(), a.symbol)))
"
最后一步应当打印出形状为两千五百乘十五,以及两个括号符号与它们的样本位置。若这一步通过,说明网络、路径与库都没问题,可以放心地整包拉取。
附录 E:如果只记五件事
- 它是什么:PhysioNet 上唯一一份公开的缺血后室速心内电图标注集,2026 年 7 月发布,非商业许可。
- 它有多大:九位患者、一千九百六十二个标测点;有效样本是九,不是一千九百六十二。
- 它标了什么:每个点的双极电图归为生理、异常、未知三类,异常点另给起止边界;三位专家独立盲标加一份共识。
- 它最适合做什么:单点心内电图的异常分类与边界检测,附空间位置与消融点,可做图结构建模。
- 它不能做什么:不能做诊断、不能做商用、不能代表其他病因或其他设备,患者数太少撑不起通用模型的说法。
编辑说明
本篇的核验日期为 2026 年 10 月 27 日。核验方式为直接抓取 PhysioNet 项目页面的 HTML 正文、下载自述文件与记录清单、逐个访问单条记录的头部与注释文件,并读取欧洲 PMC 上的数据描述论文摘要。
未覆盖的内容有三类:数据描述论文全文中的具体一致性系数与容差数值(仅据摘要确认其存在)、三位专家各自的类别分布(页面未公布)、以及左室网格文件内部的连通性质量(需要全量解析才能评估,超出时间盒)。
关于命名:清单中该条目归入生理信号领域,与 PhysioNet 项目页面一致。同名的国际 Argo 海洋浮标计划与本篇无关,已在正文第三节说明分辨方法。
关于引用数字的口径:官方页面与自述文件在非异常点的占位样本号上存在差异,正文按文件实况描述,并在 §7.2 列出。本文不对官方未公布的分项数字做任何推算。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- edb — 共享标签:生理信号 / 心电信号
- aami-ec13 — 共享标签:生理信号 / 心电信号
- kiel-cardio — 共享标签:生理信号 / 心电信号
- meditation — 共享标签:生理信号 / 心电信号
- eye-tracking-ecg — 共享标签:生理信号 / 心电信号
- nifecgdb — 共享标签:生理信号 / 心电信号
- tpehgdb — 共享标签:生理信号 / 心电信号
- ecg-capable-smartwatches — 共享标签:生理信号 / 心电信号
- szdb — 共享标签:生理信号 / 心电信号
- wctecgdb — 共享标签:生理信号 / 心电信号
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
