药企的算力账,有人替你先付了一个亿:全国首个生物医药制造支持计划的产业信号
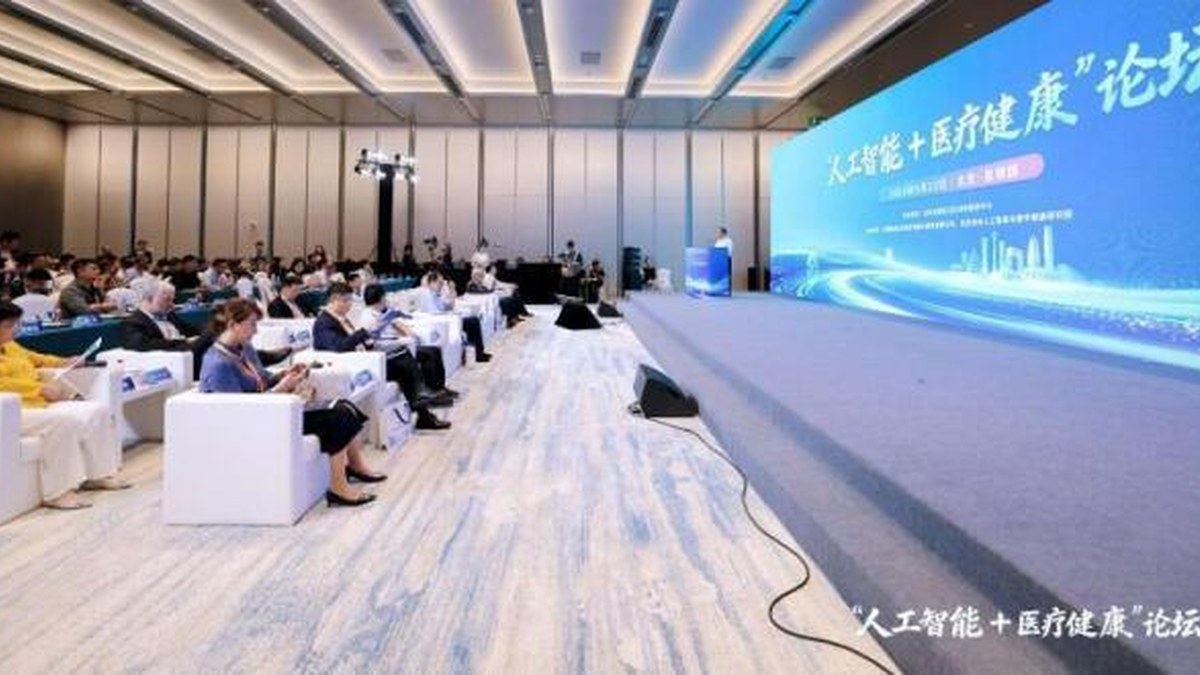
9月12日,由北京市医药卫生科技促进中心主办、中国联通北京医疗健康大模型有限公司(京医公司)和北京未来人工智能与数字健康研究院承办的2026年服贸会"人工智能+医疗健康"论坛举行,国家人工智能应用中试基地(医疗)·北京集中发布多项成果。其中最重磅的是全国首个亿元生物医药制造支持计划:专项投入超1亿元算力资源,全面覆盖药物发现、临床前研发、临床试验全产业链环节。算力分配结构为:上游靶点验证与虚拟化合物高通量筛选占40%,中游药效预测与成药性优化占35%,下游受试者智能匹配与临床数据治理占25%。基地将面向全行业开放优质算力资源,计划一年内赋能不少于100个生物医药制造创新项目。同场发布的还有:北京未来人工智能与数字健康研究院正式揭牌(聚焦前沿技术攻关与产业落地转化,与中试基地形成"前沿研究+工程中试"双向协同);北京医学会医疗人工智能分会第一届委员会正式成立。
一个亿,说多不多——够一家Biotech烧半年。但当这一个亿被明码标价地切给"靶点验证40%、药效预测35%、受试者匹配25%"时,它就不是一笔补贴,而是一份产业政策的设计图纸。9月12日服贸会上发布的全国首个亿元生物医药制造支持计划,值得从研发负责人的视角拆开看。
一、服贸会上一场论坛,三个国家级动作同时落地
先摆事实。9月12日,2026年服贸会"人工智能+医疗健康"论坛举行,主办单位是北京市医药卫生科技促进中心,承办方是中国联通北京医疗健康大模型有限公司(京医公司)和北京未来人工智能与数字健康研究院。国家人工智能应用中试基地(医疗)·北京在这场论坛上集中发布了多项成果:
- 全国首个亿元生物医药制造支持计划:专项投入超1亿元算力资源,覆盖药物发现、临床前研发、临床试验全产业链;
- 北京未来人工智能与数字健康研究院正式揭牌,与中试基地形成"前沿研究+工程中试"双向协同;
- 北京医学会医疗人工智能分会第一届委员会成立,北京医疗AI领域有了规范化的行业组织。
三件事同时出现不是巧合:研究机构出技术判断、中试基地出工程能力、行业组织出标准秩序——这是一个完整创新基础设施的三个部件。而这三个部件里,算力计划是最直接触达企业钱包的那个。
二、1亿元算力怎么分:40/35/25的结构透露了什么
计划的核心细节是算力分配结构:
| 环节 | 用途 | 分配比例 |
|---|---|---|
| 上游 | 靶点验证与虚拟化合物高通量筛选 | 40% |
| 中游 | 药效预测与成药性优化 | 35% |
| 下游 | 受试者智能匹配与临床数据治理 | 25% |
这个结构值得逐层读。
**上游拿走40%,是整个设计里最激进的表态。**虚拟筛选是算力消耗的真正黑洞——一个化合物库的对接筛选动辄需要数万卡时,而AI药物发现最确定的增益恰恰在这里(把进入实验的候选分子从"猜"变成"算")。把最大一块蛋糕给上游,说明设计者清楚:算力补贴的边际价值在药物发现端最大,那里是"有没有算力决定能不能做"的问题;而在临床端,更多是"快慢"问题。
中游35%落在药效预测与成药性优化,对应的是AI在"分子行不行"判断上的加速——失败率每降低一个百分点,后期的研发成本就省一截。
**下游25%最值得注意的是它把"受试者智能匹配"和"临床数据治理"并列。**前者是入组效率问题,后者是数据质量问题。官方文件把数据治理明确写进算力支持范围,这个信号后面还会展开。
计划的目标也给了量化锚点:面向全行业开放优质算力资源,一年内赋能不少于100个生物医药制造创新项目。平均下来,每个项目理论上能分到百万元级算力支持——对早期团队是一次实打实的输血。
三、为什么说这是"研发基建"而不是"补贴"
对这个计划,最准确的定性不是"发钱",而是"建研发基础设施"。
区别在哪?补贴的逻辑是"你缺钱,我补钱",钱花完就完了;基建的逻辑是"你缺的环节能力,我把它建成本地公共服务",后续团队可以反复复用。中试基地(pilot-scale testing base)这个名字本身就说明了定位——它承接的是实验室成果到产业落地之间最难的那段"工程放大",这在制造业是标准配置,在生物医药领域长期缺位。
支撑这个定性的是发布会上的另一个动作:**同场发布的AI移动医疗车,车上所有AI成果都经过了国家中试基地的中试验证才获准"上车"。**也就是说,这个基地不只是给算力,还在事实上行使"AI医疗成果的工程验证关口"职能——先验证、再上车、再下沉。算力计划是这个体系里的资源入口,中试验证是质量闸门,两者配套。
对药企研发负责人来说,实操含义是:这笔算力不是雨露均恩的财政撒钱,而是绑定在"从发现到临床全链路"的工程体系里的,用它的算力,就要进它的验证流程。
四、横向看:北京这套打法和其他地区医疗AI扶持的差异
这两年各地医疗AI扶持政策不少,常见的三种:给创新券、给场地和落户奖励、给场景开放(医院试点)。北京的亿元算力计划走的是第四条路——补"计算+验证"的硬能力缺口。
差异化的点在两个:一是全链路视角,从药物发现一直覆盖到临床数据治理,而不是只押注某个明星环节;二是中试验证作为准入机制,把"用了资源"和"过了质量关"绑定,避免了扶持资源变成低水平重复建设燃料的风险。
当然,这套体系的成色最终要看落地数据:100个项目里有多少跑通了"发现→临床"?中试验证的标准是否公开透明?这些才是明年回看时真正要回答的问题。
五、趋势判断:算力普惠之后,下一个瓶颈是数据
最后给一个判断。
算力这件事,正在从稀缺品变成公共品。国产算力供给上量、各地智算中心密集投产、加上这类专项计划输血,"用不起算力"正在快速退出创新瓶颈清单。
那下一个瓶颈是什么?看这个计划自己的措辞就知道了——下游25%里明确写了"临床数据治理"。行业真正的卡点是:**高质量、可计算、合规流通的医疗数据。**药物发现端的数据(化合物库、靶点数据、文献知识)相对可获取,而临床端的数据散落在各家医院、格式各异、标注缺失、出院即沉睡。谁能把这一段数据盘活,谁就拿到了AI制药下半场的入场券。
换句话说:一个亿的算力解决的是"算得动",接下来行业要解决的是"有东西可算"。前者靠基础设施投资,后者要靠数据工程、数据治理和合规流通机制的长期建设——这部分,靠发一个亿的算力是发不出来的。
**算力普惠是起点,不是终点。生物医药的AI竞争,正在从"谁的卡多"转向"谁的数据底座厚、治理能力强"。**这场论坛上的三个动作,只是一个开始。
千方医数集编辑部 出品
