眼科开源大模型LEME:零样本打穿7个基线,视力抽取F1比Eye-LLaMA高出59%
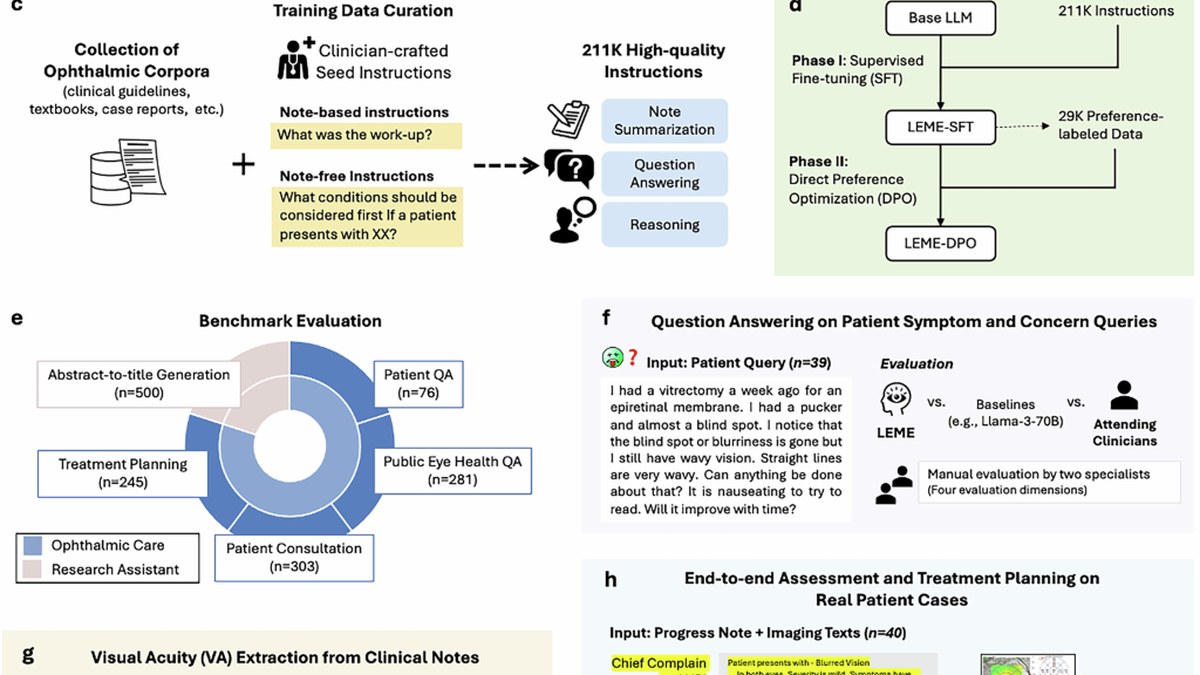
9月25日,《npj Digital Medicine》在线发表眼科开源大语言模型LEME。模型采用两阶段训练:先以211,149条指令数据做监督微调,再以29,747条偏好样本做强化学习。在零样本设定下的5个基准(含问答与医患咨询)上,LEME优于全部7个基线模型(p<0.004),平均ROUGE-L比GPT-4o高3.32%。在真实患者数据的三项任务中,其患者提问完整性评分甚至超过专家撰写的答案(p=0.015);视力(visual acuity)抽取任务F1比LLaMA-3 70B高14.1%、比Eye-LLaMA高59.0%。
数据视角 × AI技术供应商/创业者 | 影响分析 × 医院信息化/临床医生 | 产品发布
通用大模型在医学问答上的表现已经不差,GPT-4o这类模型早在执业医师考试题上就能拿到及格线以上的分数。9月25日发表于npj Digital Medicine的LEME给出的是另一个角度的回答:当一个模型只做眼科、并且把权重全部公开时,它到底能比通用模型多赢多少。论文的结论是赢面确实存在,而且赢在几个非常具体的环节上——不是通用的语言流畅度,而是病历里视力值抽取得准不准、回答患者提问时信息给得全不全。
开场:通用模型已经很强了,专病模型还能赢在哪里
专病模型的胜面通常不来自知识量。通用模型的参数是靠全领域语料堆出来的,医学只是其中一小块,眼科又是医学里的一小块,真正稀缺的不是更多文本,而是与临床工作流对齐的表达方式和评价尺度。
LEME的定位就贴着这条线:不是再造一个什么都会的医疗助手,而是围绕眼科的问答、医患咨询与临床文本处理做深,明确强调推理与问诊能力。这也决定了它的评测方式——不走刷题路线,而是在零样本设定下用五个整理出的基准,任务覆盖问答与医患咨询,再拿真实患者数据做三项下游任务。
眼科本身也是一个适合做专病模型的切口。论文开篇的动机是眼病带来的公共卫生负担在持续加重,而从数据角度看,眼科的诊疗记录天然具有较高的结构化程度:视力、眼压、影像描述、随访结论,这些字段既是临床决策依据,也恰好是可被模型学习的监督信号。相比之下,不少内科领域的价值藏在长时段、非结构化的病程叙述里,标注成本高得多。
两阶段训练:21万条指令打底,3万条偏好对齐
训练分两段。第一段是监督微调,使用211,149条指令数据,论文强调这些数据从权威来源整理而来,不是从通用语料里随手抓取的。这一步解决的是领域表达与任务格式问题,让模型学会用眼科医生习惯的方式组织并输出信息。
第二段是强化学习,使用29,747条偏好标注样本,目标是提升临床推理能力与信息量。偏好对齐这一段是关键:监督微调能让模型说得像医生,偏好学习才能让模型在几个都说得通的答案里,选那个信息更完整、推理链更站得住的。两段数据量形成一个有意思的比例——指令数据是偏好数据的七倍多,说明作者把大部分预算放在打底,把对齐当精修而非主体。而两阶段样本的获取成本恰好相反:指令数据可以规模化整理,偏好数据需要有人反复比较两个答案并给出判断,且判断标准必须与临床偏好一致,单位成本远高于前者。用不到3万条偏好样本完成对齐,说明这一阶段拼的是质量而非数量,也给后来者提供了可参考的量级。
零样本7个基线全胜:赢的幅度有多大
零样本评测的结果,论文的表述是LEME优于全部7个基线模型,所有比较的p值均小于0.004。与通用模型的直接对比是:平均ROUGE-L比GPT-4o高3.32%。
3.32%这个幅度需要放在语境里读。它不是一个让人意外到失语的数字,ROUGE-L衡量的也是生成文本与参考答案的字面重合度,而非临床正确性。真正的价值在于方向的一致性:五个基准、七个基线,全部方向一致地胜出,且统计显著。对做工程的人来说,这比某个榜单上的大幅领先更有说服力,因为它说明优势不是挑任务挑出来的。
零样本这个设定本身也值得强调。它意味着LEME在评测时没有针对这些基准做过微调或示例提示,排除了针对性优化带来的虚高。反面同样要看到:基准是作者整理的,外部研究者此前无法接触,因此不存在数据泄露的担忧,但这些基准本身的代表性取决于构建方式,需要回到论文与公开数据集里逐项核对。
超过专家撰写答案的那一项,值得单独看一眼
真正值得单独拎出来看的是真实患者数据上的结果。在使用去标识化患者数据的三项任务中,回答患者提问这一项上,LEME拿到了主治医师给出的最高总体评分,其完整性评分甚至超过了专家撰写的答案,p值为0.015。
这句话的分量在于参照物。专家撰写的答案通常是这类评测的天花板,超过它意味着模型在信息覆盖这件事上做到了人类专家在有限时间内不容易做到的事——不是更准确,而是更少遗漏。另一项更工程化的任务是从临床记录中抽取视力值,LEME取得最高F1,比LLaMA-3 70B高14.1%,比Eye-LLaMA高59.0%。两者放在一起看,说明通用大模型在结构化抽取上并不天然占优,而此前的眼科专用模型Eye-LLaMA在这一项上仍有明显差距。第三项评估与治疗计划生成上,LEME的评分接近主治医师,论文用的是promising而非equivalent,这个措辞是诚实的。
这里也有必要标出评分方法的边界。总体评分与完整性评分由主治医师给出,属于主观评价,参评者是否设盲、样本量多大、评分者之间的一致性如何,都会影响结论的稳健性。p值为0.015说明差异在统计上成立,但离临床意义上的显著改善还有距离——少遗漏并不等于判断正确。
冷静观察:开源权重的意义,是让别人能复现也能挑错
论文由耶鲁大学医学院生物医学信息学与数据科学系、新加坡国立大学Yong Loo Lin医学院、新加坡眼科研究所、哈佛医学院附属Mass Eye and Ear、斯坦福Byers Eye Institute、伦敦Moorfields眼科医院等机构的研究者共同完成,共同通讯作者为Yih-Chung Tham与Qingyu Chen,资助来自美国国家医学图书馆与美国国家癌症研究所等NIH基金。这份作者名单本身就是一种信号:专病模型的门槛不在算法,而在数据与临床评价资源的组织能力。
开源权重这件事的意义,需要说得比通常更具体一点。模型、数据集与代码全部公开,意味着别人可以拿它在自己的患者数据上复现,也可以在复现失败时指出问题出在哪——这是很多只发论文、不发权重的医学AI研究做不到的。反过来看,LEME的评测仍以自动指标与临床医师评分为主,零样本胜出与真实临床收益之间还有距离;文章采用CC BY-NC-ND许可,商业使用需另行授权,也不允许分发衍生版本。也就是说,它更适合被当作垂直医疗大模型的一个可对标基线,而不是拿来直接上线的产品。对医院信息科来说,现阶段最现实的用法是把它作为内部评测的对照组,先看它在本院病历上的抽取表现,再谈部署。对做垂直模型的团队而言,这篇论文更实际的价值是给出一个成本参照:21万条指令加3万条偏好,就能在一个专科上稳定超过通用模型。真正贵的不是算力,而是数据整理与临床评价的组织成本。
原文链接:npj Digital Medicine(DOI: 10.1038/s41746-026-03104-4)
千方医数集编辑部 出品
