斯坦福发布TranscriptFormer:1.12亿细胞跨12物种训练,细胞生物学迎来通用坐标系
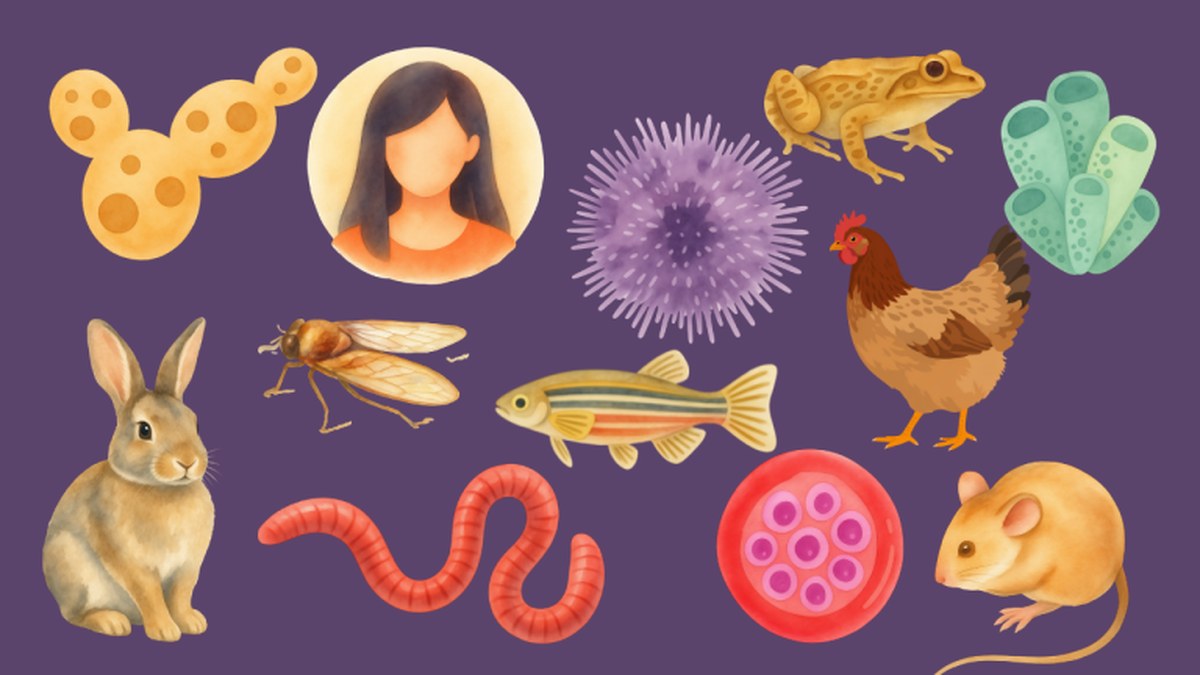
9月14日,斯坦福医学院宣布开发出两个生物细胞AI模型:第一代通用细胞嵌入模型(universal cell embedding)为第二代模型TranscriptFormer奠定基础,后者用来自12个物种(从单细胞酵母到人类,含小鼠、斑马鱼、疟原虫、海绵等)共1.12亿个细胞的数据训练,成果同期发表于Nature与Science。由Stephen Quake、Jure Leskovec与CZI的Theo Karaletsos共同领衔。训练方法类比大语言模型:LLM预测缺失词,TranscriptFormer预测缺失的基因表达值,从而构建一个所有物种细胞都可放入的通用数学空间,量化细胞间相似与差异。模型已能识别训练集之外物种的细胞类型、区分健康与病变细胞,并解答演化问题(如海绵领细胞与线虫、青蛙神经元的相似性)。团队称这可能是全新领域的开端,远期愿景是指导设计目前尚不存在的治疗性细胞。
1.12亿个细胞教出的AI:斯坦福TranscriptFormer把12个物种的细胞放进同一个数学空间
趋势前瞻 × 药企研发负责人 | 深度研报
9月14日,斯坦福医学院官方宣布开发出两个生物细胞AI模型:第一代通用细胞嵌入(universal cell embedding)模型奠基,第二代TranscriptFormer用12个物种共1.12亿个细胞的数据训练,成果同期发表于Nature与Science两刊。模型把从酵母到人类的细胞放进同一个通用数学空间(universal space),已能识别训练集之外物种的细胞类型、区分健康与病变细胞,并为神经元的演化起源提供新线索——对药企而言,这是从细胞图谱走向设计治疗性细胞的一条被验证的开端。
人话翻译:给地球上所有细胞建一个通用坐标系
一句话说清这项成果:斯坦福医学院的研究者训练出了一个能“读懂”细胞的AI模型,地球上的生物细胞——无论来自人、小鼠还是海绵——都可以放进同一个数学空间,量化它们的相似与差异。
这项工作分两代:第一代universal cell embedding(通用细胞嵌入)模型打下基础,第二代TranscriptFormer把规模推到12个物种、1.12亿个细胞——物种从酵母、疟原虫、海绵这样的简单生物,到小鼠、兔、鸡、斑马鱼、果蝇、非洲爪蟾、海胆、秀丽隐杆线虫,直至人类。
团队由生物工程教授Stephen Quake、计算机科学教授Jure Leskovec与Chan Zuckerberg Initiative(CZI)的Theo Karaletsos共同领衔。Quake对这项工作的期许是:“我们希望开启一个全新领域和十年的工作。”
如果给这项工作找一个参照物:细胞图谱是“字典”,记录每个细胞类型的释义;universal cell embedding与TranscriptFormer则更像“语义网络”,把所有细胞放进一张关系网里——没被字典收录的新细胞,也能凭它在网络中的位置被理解。模型已验证的能力之一,正是这种对“没见过”的物种的举一反三。
原理拆解:像ChatGPT一样预测缺失的基因表达值
要理解模型在算什么,先回到生物学的基本盘。基因组是生命的说明书,而现代生物学真正关心的是基因表达——哪个基因正在被使用:胰岛beta细胞表达胰岛素基因,B细胞生产抗体,皮肤细胞表达毛发与色素相关的基因。同一段基因组在不同细胞里被“翻牌”的部分不同,这决定了细胞长成什么样。
近年的科学家为此建了细胞图谱(atlases):按基因表达模式定义细胞与组织的大型数据库。问题在于数据规模——数万个基因乘以数亿个细胞,远超人脑的处理能力。Quake的表述很直接:“我们怎么同时思考所有这些基因?人脑做不到。这些模型帮我们做到。”
TranscriptFormer的训练方法可以直接类比大语言模型(LLM):
- ChatGPT读海量文本,靠预测被遮住的词学会语言规律;
- TranscriptFormer读1.12亿个细胞的基因表达数据,靠预测缺失的基因表达值学会细胞的生命规律。
训练的产出是一个通用数学空间:所有物种的细胞都能在这个空间里找到自己的位置,位置越近的细胞越相似。它像一张覆盖地球生物的“细胞地图”,把跨物种比较从定性描述变成可计算的坐标问题。
这套方法能跨物种成立,前提是基因表达规律本身在演化上共享——细胞在什么情境下表达哪些基因、以什么组合表达,在不同物种之间遵循相似的底层逻辑。这也是下文“识别训练集之外物种”得以成立的原理基础。
已验证的三件事:跨物种识别、病变区分与海绵细胞的演化线索
模型不是只靠规模讲故事,发布信息给出了三项已验证的能力:
- 识别训练集之外的物种——对没有参与训练的物种,模型也能依据基因表达数据识别细胞类型,说明它学到的是跨物种共享的规律,而不是死记训练数据。
- 区分健康与病变细胞——在同一空间里,病变细胞与健康细胞可以被分开,这是通向疾病研究应用的基础能力。
- 回答演化问题——模型发现海绵的领细胞(choanocyte)与线虫、青蛙的神经元高度相似,为神经元的演化与领细胞的功能提供了新线索;而海绵的“神经样细胞”(neuroid cell)的表达谱其实更像青蛙的腺体细胞,提示它可能参与消化而非神经功能。
第三条尤其能说明这类模型的用法:它不只是分类器,还能在跨物种坐标系里提出可被实验检验的生物学假设。论文的共同第一作者是博士生Yanay Rosen与Yusuf Roohani——后者现为Arc Institute机器学习副总监。
三项验证合起来回答了同一个问题:模型学到的是规律还是记忆。跨物种泛化排除了死记硬背,健康与病变的区分提供了研究用途,演化层面的发现则展示了提出新假设的能力。
产业意义:从细胞图谱到设计治疗性细胞
对药企研发负责人来说,这项成果的近期价值在研究端,远期价值在管线端。近期看,通用细胞嵌入空间可以直接用于细胞类型注释、健康与病变状态的区分、以及跨物种数据向人类的外推——临床前研究大量使用小鼠、斑马鱼等模式生物,跨物种坐标系为“动物模型数据能否外推到人”提供了一种量化工具。具体到研发流程,三类场景较为直接:单细胞测序数据的细胞类型注释可以交给模型自动完成;疾病样本与健康样本在空间中的分布差异,可作为靶点与生物标志物线索的来源;跨物种外推的量化程度,则为动物实验结果的解读增加一个参照维度。
远期看,团队的愿景是“设计目前尚不存在的治疗性细胞”:先理解细胞功能的机制,再想象并指导构建具备特定功能的治疗性细胞。对细胞治疗领域,这是一条从筛选走向设计的路径。Quake强调:“我们希望它是强大的发现工具……帮优秀生物学家思考复杂问题。”
该项目由CZI、BioHub、DARPA、NSF及企业伙伴资助,学术与公共资金的组合也表明它目前仍定位为基础研究工具。
局限与验证:模型能力不等于临床可用
需要划清的边界同样清晰。模型能力不等于临床可用——从识别细胞类型到设计治疗性细胞,中间隔着机制验证、制造工艺、安全性与监管审评的完整链条。训练数据的边界也决定能力边界:12个物种、1.12亿个细胞在演化尺度上仍只是抽样,物种、组织类型与疾病状态上的盲区都可能影响输出;跨物种泛化的可靠性需要持续验证,海绵领细胞这类发现也要回到实验生物学中接受检验。此外,以预测缺失表达值为目标的训练方式,决定了模型强在归纳表达模式,而非直接给出干预方案——任何向治疗场景的迁移,都需要额外的实验证据链支撑。
正如Quake所说,这是一个“全新领域和十年的工作”的开端。对产业观察者,合理的期待是把TranscriptFormer当作生物学的发现工具看待——它的价值兑现速度,取决于从“识别细胞”到“设计细胞”这段路能走多快。
千方医数集编辑部 出品
