复旦肿瘤268例随机试验:术前先用本地部署大模型答一轮,患者焦虑与医生负荷同时下降
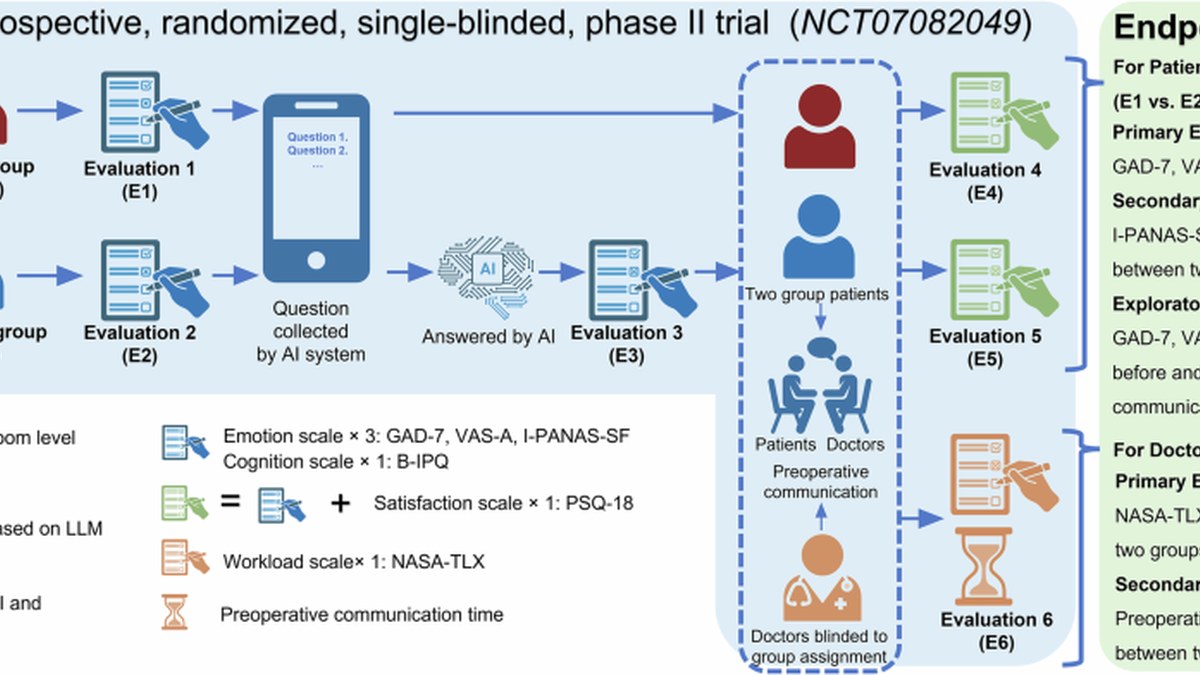
9月26日,《npj Digital Medicine》在线发表复旦大学附属肿瘤医院泌尿外科团队的前瞻随机II期试验:新诊断前列腺癌、拟行根治术的患者,在常规面对面术前沟通前先用扫码方式向院内本地部署的大模型提交问题,一小时后查看经审核的答复。最终分析268例(AI组138例、对照组130例)显示,AI组焦虑评分GAD-7为3.2、对照组为5.7,校正均数差-2.2;医生工作负荷NASA-TLX总分为39.9对56.8,校正均数差-10.6。研究同时报告,3507个患者提问中有81.2%由AI直接答复,18.8%被判为不适合AI直接回答而转由医生处理。
事实报道 × 医院信息化/临床医生 | 趋势前瞻 × AI技术供应商/创业者 | 深度研报
医疗 AI 的论文里,绝大多数是回顾性数据复盘或模拟问诊,真正把大模型塞进真实临床流程、再用前瞻随机对照去量的中国研究并不多。9 月 26 日《npj Digital Medicine》在线发表的复旦大学附属肿瘤医院泌尿外科 II 期试验给出了一个稀缺样本:让患者在常规术前谈话之前,先向院内本地部署的大模型问一轮。随机对照是把「看起来有用」与「确定有用」分开的分水岭,这一步迈过去,结论才谈得上可用于采购与流程改造。
开场:术前谈话这道工序,AI能插得进去吗
术前谈话是一道典型的高压工序:患者刚拿到癌症诊断,信息缺口最大、情绪最不稳;医生则要在有限时间里把手术方式、风险与恢复路径讲完,还要接住一堆重复提问。它恰好具备几个适合插 AI 的特征——问题高度重复、答案有权威资料可依据、结局可用量表量化,而且流程上有一个天然的插入点,就在谈话之前。
研究给出的插法相当克制。患者入院后先做基线评估并提交问题,AI 组扫码提问,由本地部署的 DeepSeek-R1 生成答复,先经内容审核医生在后台实时审核或修改后放行,患者约一小时后查看,随后再接受与对照组相同的常规面对面术前沟通。选择前列腺癌根治术作为切口也很讲究:诊断已明确、术式已确定、患者疑问集中在麻醉、围手术期管理与恢复路径,是外科沟通里标准化程度最高的一类,知识库因此容易建得扎实。研究者没有让 AI 替代谈话,而是让患者带着已经答过一轮的问题走进谈话室。
268例怎么分的:病房整群随机,避免同病房互相串
这不是一份小样本探索报告:筛查 371 例,随机 276 例,8 例因未完成既定术前沟通被排除,最终分析 268 例,AI 组 138 例、对照组 130 例。设计为前瞻、随机、单盲、单中心 II 期,注册号 NCT07082049,入组时间为 2025 年 7 月至 12 月。
随机化方式值得单独说:按病房整群随机,而非按人随机。原因是病室为 3 至 4 人间,若同室患者分属两组,跨床交流会把干预传给对照组,主要终点直接被稀释。同日入院患者按病房 1 比 1 随机,是防污染最省事、也最贴合病房现实的办法。代价是整群随机会引入组内相关,统计上有效样本量要打折,这也解释了作者为何把校正均数差和可信区间一并报出。设盲方面,医生对分组设盲;患者身处干预中心,不可能盲法。两组基线 GAD-7 为 9.8 对 9.5,基本均衡,这也让终评差异更可能归因于干预而非起点不同。需要提醒的是,8 例被排除的理由是未完成既定术前沟通,而非失访或主动退出,性质上属于流程未执行的剔除,与常见的脱落偏倚不是一回事。
两个主要终点都动了:焦虑降了2.5分,医生负荷降了近三成
主要终点只有两个,一个朝患者,一个朝医生。患者端 GAD-7 终评 AI 组 3.2、对照组 5.7,校正均数差 -2.2,95%CI 为 -3.4 至 -1.1,P=0.001;对照基线 9.8 与 9.5 看,两组都在降,AI 组降得更多。置于量表语境里看:GAD-7 满分 21 分,临床上通常以 10 分作为中度焦虑的分界,两组基线 9.8 与 9.5 都压在这条线附近,而终评 3.2 与 5.7 均已落入轻度区间。换句话说,AI 组不是把焦虑清零,而是把一批贴着中度线的患者推到了更远处。医生端 NASA-TLX 总分 39.9 对 56.8,校正均数差 -10.6,95%CI 为 -14.3 至 -6.9,P<0.001,降幅接近三成。
两个方向同时阳性,在医疗 AI 里并不常见:多数干预只能证明一端获益,另一端不变甚至更差,毕竟省下的时间常常只是被转移而非消失。这里的解释更朴素——重复疑问被前置消解后,面对面沟通可以直接进入个体化决策。次要终点方向一致:I-PANAS-SF 正负性情绪、B-IPQ 疾病认知、PSQ-18 满意度,以及沟通时长从 19.9 分钟降到 11.3 分钟,均 P<0.001。但作者明确说明次要终点未做多重性校正,只能视为支持性结果;NASA-TLX 也没有基线数据,两组医生负荷是否原本就不同,无法从论文中判断。
18.8%的问题AI没答:这条比阳性结果更值得看
全组患者共提交 3507 个问题,人均 13.08 个。其中 2847 个、占 81.2% 由 AI 直接答复;660 个、占 18.8% 被判定不适合由 AI 直接回答,改由医生以标准化模板回复。这条阴性数字,比任何一条阳性结果都更能刻画这套系统的真实边界。
系统设计本身就在为这条边界做工程化处理。检索采用混合 RAG:bge-m3 稠密向量配 FAISS 索引,叠加 TF-IDF 稀疏检索,本地知识库为泌尿与肿瘤外科权威资料及患教材料,回答限 500 词以内;本地内容不足时,经仅出站安全网关做二次外部检索,只传脱敏后的查询表征。模型跑在院内 GPU 集群上,走内网 API,只检索不参与训练。更关键的是,所有答复先由内容审核医生在后台审核或修改后放行——18.8% 不是答错被抓出来,而是在放行前就被分流掉。
对医院信息化和供应商来说,18.8% 应当被读成规格而不是瑕疵。它说明这套系统能稳定吃下约八成的标准化疑问,剩下两成仍要医生接;人力成本不是归零,而是从全部回答变成回答最难的五分之一。评估这类系统时更有用的指标是路由率:多少比例的问题能安全交给模型,以及人工兜底的单位成本是多少。需要说明,论文公开的是这 660 个问题的比例与去向,并未给出主题分布,因此不宜推断它们究竟是个体化预后判断、并发症权衡还是情绪性提问。
冷静观察:单中心、普通话人群、次要终点未校正,III期才是真考场
需要摊开的限制不少。研究为单中心,术式仅限前列腺癌根治术,人群全部为普通话使用者,外推到多中心、其他癌种以及非普通话人群都还缺乏证据。患者无法盲法,而 GAD-7 与满意度都是主观量表,期望效应无从排除——知道自己被额外照顾,本身就可能让人更安心。次要终点未校正多重性、NASA-TLX 无基线,这两点已在主要终点之外划出了证据强度的边界。
还要加上工程前提:院内 GPU 集群、常驻的内容审核医生、仅出站安全网关,这三样并非多数医院的现成配置,复制时的边际成本容易被低估。论文目前是 2026 年 9 月 26 日在线的 Article in Press,尚未完成最终排版。接下来的 III 期、多中心、跨术式验证,才是这套模式能否成为常规工序的真考场。
原文链接:npj Digital Medicine(DOI: 10.1038/s41746-026-03309-7)
千方医数集编辑部 出品
