五中心4026例前瞻验证:双模态超声视频AI鉴别浅表淋巴结良恶性,把低年资医生从0.72拉到0.88
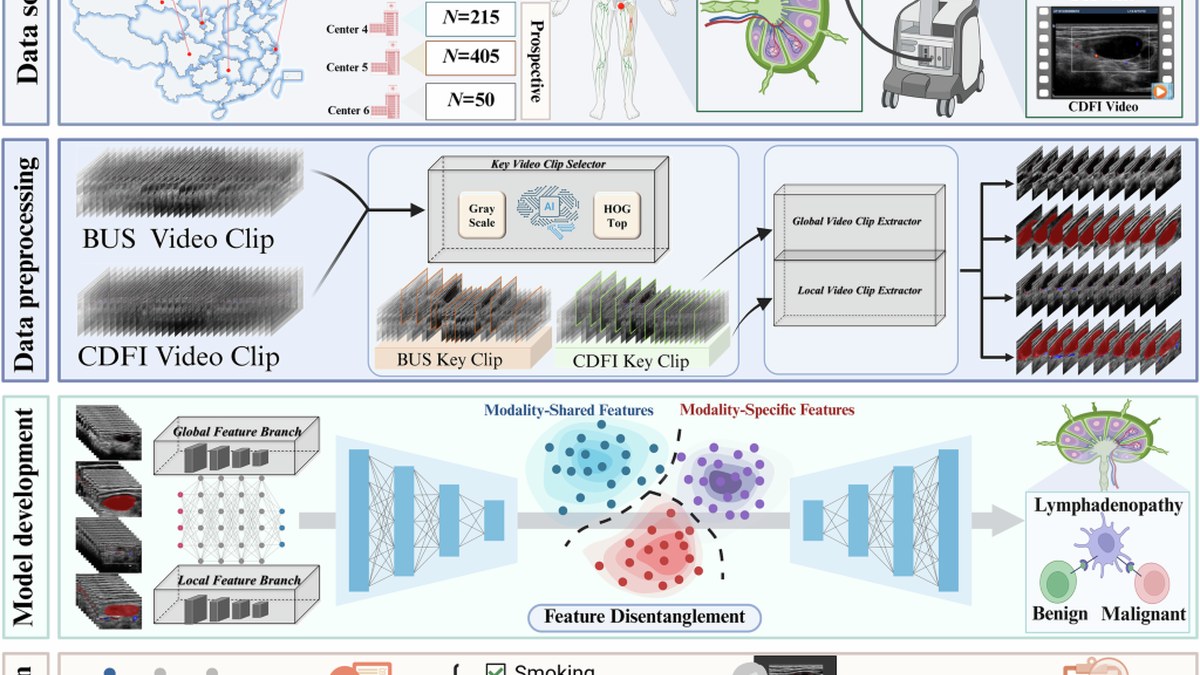
9月30日,《Radiology: Artificial Intelligence》在线发表一项五中心研究:DMUVL-DiagNet融合B型超声与彩色多普勒血流视频双模态,配合基础临床信息鉴别浅表淋巴结病变良恶性。研究纳入病理确诊的4026例患者,回顾性视频集1616例用于训练与内部测试,另有前瞻性双模态视频集454例与静态图像集1956例作为外部验证。模型良恶性鉴别AUC 0.91-0.95,淋巴瘤与转移瘤区分AUC 0.87-0.91;更关键的是AI辅助后低年资放射科医师的AUC从0.72升至0.88、从0.58升至0.77,均具统计学显著性。
4026例五中心前瞻外部验证:双模态超声视频AI把低年资医生的淋巴结判读推到0.88
影响分析 × 医院信息化/临床医生 | 数据视角 × 监管与合规专家 | 深度研报
2026年9月30日,《Radiology: Artificial Intelligence》在线发表一项中国五中心研究:团队用DMUVL-DiagNet融合B型超声视频与彩色多普勒血流视频,配合基础临床信息鉴别浅表淋巴结病变良恶性,共纳入病理确诊患者4026例,良恶性鉴别AUC落在0.91至0.95。真正被推到台前的却是另一组数字——AI辅助之后,低年资放射科医师的AUC从0.72升至0.88,另一组从0.58升至0.77,均具统计学显著性,而支撑这条断言的前瞻性外部验证集只有454例。
开场:一个淋巴结的良恶性,乡镇医院和三甲医院的判断差多少
一个颈部或腋窝的肿大淋巴结,在基层超声报告里常常只有一句话:描述大小、形态、血流信号,再加上建议进一步检查。代价是转诊成本、等待时间与一段不必要的焦虑。这段差距很少来自设备——彩色多普勒超声早已下沉到县乡两级,探头能看到的物理信息差别有限,差别落在探头后面那个人的经验上。
浅表淋巴结的判读属于经验密集型任务。皮髓质分界、纵横比、边界是否规则、淋巴门结构、血流偏向周边还是中央,每一项都由操作者在扫查过程中实时判断,而这些指征如何组合几乎没有标准答案。经验是一条缓慢积累的曲线,年资是这条曲线最粗略也最容易获取的代理变量。
因此这项研究的切口比AI能不能读片更窄,也更有价值:它测的不是模型单独打分的成绩,而是把模型放进医生流程之后,不同年资的成绩各自移动了多少。如果增益集中在年资较低的一侧,那么这不再是一条关于机器能否超越专家的叙事,关于经验差距能否在一年内被技术压缩才是落点。
4026例怎么分的:训练1616、前瞻外部454、静态图像1956
研究纳入病理确诊的浅表淋巴结病变患者4026例,中位年龄52.6岁,四分位间距41至62岁,男性2175例;采集期自2019年6月延续至2025年12月,覆盖五个中心,前瞻性注册于中国临床试验注册中心ChiCTR2400090592。病理确诊这四个字值得单拎出来:标签质量决定监督学习的上限。
4026例被切成三块,切法本身就交代了作者的意图。第一块是回顾性视频集1616例,用于训练与内部测试,这是模型见到并学习过的部分,在这一段上好看都不算意外;任何有足够容量的网络都可能在自己的训练集近邻区域取得高分,真正承担检验职责的是后面两块。
其一是前瞻性双模态视频集454例,采集发生在模型成型之后,受回顾性挑选的影响最小,是三块数据里最干净的一支。其二是静态超声图像集1956例,模拟的正是基层日常:保存与调阅的多是单帧截图,模型在缺少动态信息时能否站住,决定它能不能下沉到第一站。论文目前仍为预排版版本,正式数字以定稿为准。
0.91到0.95:双模态视频到底多了什么信息
论文给出的性能不是一个点,而是一个区间:良恶性鉴别AUC 0.91至0.95。以区间而非单值呈现,通常意味着读数来自不同的测试集合,应理解为跨集合的波动而非同一队列反复抽样的置信区间。更难的第二道题是区分淋巴瘤与转移瘤,AUC 0.87至0.91;亚组泛化落在0.85至0.93,说明模型在人群之间的稳定性并不均匀。
双模态补进了什么,可以沿着数据本身的技术含义去理解:B型超声视频承载形态与结构信息,彩色多普勒血流视频给出血流分布与血管走形,合起来补上单帧图像无法体现的扫查连续性;再并入年龄、部位这类基础临床信息,等于把影像信号放回临床先验中读取。各模态各占多少,仍需看全文的消融结果。
论文还报告模型表现优于所有年资组放射科医师的平均水平。这一条要谨慎持有:被比较的是平均水平,既不等于逐一对位,也不代表模型在每一个病例上都胜过每一位医生。真正有信息量的是这条优势建立在多大的人群变异之上,而这恰恰由上一节那两个外部集的构成决定。
0.72到0.88:AI先作用于谁的年资
论文里最亮的数字不属于模型,属于医生。AI辅助后,低年资放射科医师的AUC从0.72升至0.88,另一组从0.58升至0.77,均P小于0.001;两项跃升幅度分别为0.16与0.19,在以医生读片为主观终点的研究中,跨过零点一的变化并不多见。
增益落在低年资一侧的机制不难解释:模型把大量已确诊病例的形态与血流模式压缩成稳定的先验,低年资医生缺少的正是这种靠样本暴露量堆积出来的模式识别能力;而经验更丰富者的判断里本已包含相当部分的同类先验,可被新增的自然更少。AI在这里填补的不是智力差距,是样本差距。
但要守住一条纪律:0.72到0.88是AI辅助下人类读片的成绩,0.91到0.95是模型单独工作的成绩,两者测量对象不同,不能排在同一条轴上比高低。再往前推一步就到了场景——最该部署这套系统的地方或许不是专家云集的三甲超声科,而是写下建议进一步检查的基层诊室,只是这一跳转已超出论文测量的范围。
冷静观察:前瞻外部集454例,这条结论能在第二年复现吗
先说最硬的一条约束:这套结论目前主要站在454例的前瞻性外部验证集上。它是三块数据里最干净的一支,也是最小的一支。样本量直接决定AUC估计的宽度,0.91到0.95这段区间本身可能就有相当部分来自集合间的规模差异,而非模型能力的真实浮动,需要更多中心的前瞻数据来收敛。
时间与标签是另两层边界。采集期跨越六年多,设备换代、探头型号与扫查规范调整、人群构成变化都会在时间轴上留下痕迹;训练集取自回顾性数据的安排有利于检验这种漂移,但幅度多大仍要看全文是否给出按时间切分的结果。入组的都是有病理确诊的病例,而门诊里多数淋巴结并不会走到活检那一步。
最后一层边界在读片实验自身。AI辅助后是一个特定条件下的读数:医生知道自己在被评估,知道手边有参考意见,病例也经过挑选,真实工作流里没有这些前提。要把0.72到0.88写进基层的日常,还需要在连续病例、无提示的条件下重做一遍。方向是可信的,数值还需要它自己再证明一次。
原文链接:Radiology: Artificial Intelligence(RSNA)论文
千方医数集编辑部 出品
