一句话生成蛋白质:西湖大学Pinal登《自然》,用17亿条合成配对跨越数据鸿沟
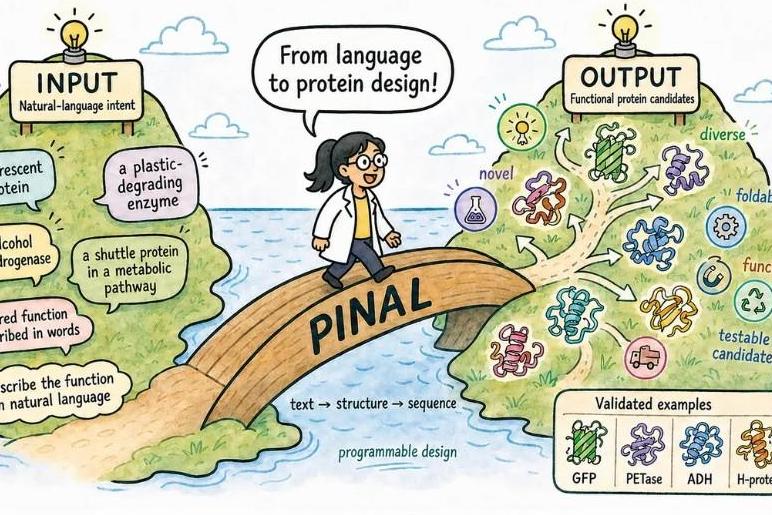
西湖大学与香港科技大学(广州)、中科院深圳先进技术研究院合作构建的AI模型Pinal登上《自然》(论文10月21日23时上线)。只需一句文字描述,Pinal即可生成与已知天然蛋白序列不同、且可能具备实际功能的候选蛋白质。团队整合1.35亿条蛋白序列,并用AI合成约17亿条蛋白质-文本配对训练集跨越数据鸿沟,模型规模160亿参数。四类蛋白质湿实验全部验证功能,其中H蛋白通路产物浓度达天然蛋白的1.7倍。
趋势前瞻 × 药企研发负责人 | 事实报道 × 医疗数据从业者 | 行业观察
10月21日23时,西湖大学原发杰、刘建明团队与香港科技大学(广州)卢泓远团队、中国科学院深圳先进技术研究院司同团队合作完成的论文「Programmable design of functional proteins from natural language」在《自然》在线上线(编号s41586-026-11205-z)。他们搭建的AI模型Pinal只需一句自然语言描述,就能生成与已知天然蛋白序列不同、且可能具备实际功能的候选蛋白质。对药企研发来说,这件事的真正看点不在「一句话」的噱头,而在它用AI合成数据跨越了蛋白质-文本配对的数据鸿沟,并且四类湿实验全部跑通了功能验证。
开场:给AI一句话,它回你一条自然界不存在的蛋白质
在实验检测中,一抹微弱的绿色荧光出现在一个由AI设计的候选蛋白质里,它被命名为pinalGFP。这一次,研究人员没有直接取用天然荧光蛋白序列,也没有围绕某个已知模板反复突变优化,而是给一个名为Pinal的模型一段关于目标功能的自然语言描述,让模型生成候选序列,再通过筛选和实验验证,找出其中真正发挥功能的那一个。
Pinal是「Protein-design Interface using Natural Language」的缩写,即一个由自然语言驱动的通用蛋白质设计模型。它把蛋白质设计的第一步,从画结构、查同源、写修改方案,压缩成了打下一行字。
- 设计案例覆盖荧光蛋白、降解PET塑料的酶、醇脱氢酶、固碳多酶体系中的穿梭H蛋白四类功能迥异的场景
- 模型参数量160亿,运行时大致分三步:先根据文字生成蛋白质的结构蓝图,再依据结构排布氨基酸,最后对众多候选序列打分,挑出最符合目标的候选序列
对药企研发负责人而言,值得注意的不是某一个候选蛋白,而是这条「自然语言提需求-AI出候选-实验验功能」链路的形态:它把设计的入口,从结构专家手里递到了需求描述者手里。
数据鸿沟怎么跨:1.35亿条序列加17亿条AI合成配对
这项研究最对医疗数据从业者胃口的,是它处理数据缺口的方法论。
问题很直白:人类已知的蛋白质序列数据规模庞大,但经实验验证功能的数据相对稀缺。AI模型很难在海量序列与少量功能注释之间,建立「功能文字到蛋白序列」的可靠对应关系——这是一种左右脚不平衡的状态,海量序列说不清结构、也说不清功能,模型自然学不到真本事。
团队的解法分两层:
- 第一层,以蛋白质三维结构作为中间桥梁。序列看起来只是20种氨基酸字母的排列组合,可能性极其庞大,但并非每种排列都能折叠成稳定结构;而结构已经包含了折叠后的空间关系与物理化学约束,更接近蛋白质真正工作的样子。自然语言不直接对接序列,而是先指向结构,再由结构约束序列。
- 第二层,用AI合成数据补齐配对。团队整合多种来源的蛋白质数据,构建了覆盖约1.35亿条不同蛋白质序列的训练数据集;再通过为同一蛋白质配备多种语言表述,最终合成约17亿条「蛋白质-文本」配对训练数据,为模型学习语言描述与蛋白质之间的关联提供了基础。
这里的判断可以被其他领域复用:当真实标注数据稀缺时,与其干等标注补齐,不如引入一个中间模态,并用模型生成的合成配对把训练集撑大一个数量级。
对做医疗数据链路的从业者而言,这个范式与病历文本、影像、临床表型之间的配对缺口高度同构——蛋白质领域先行验证了一次,同样的思路正在被搬到更多模态上。
160亿参数模型与四类蛋白的湿实验验证
概念之外,研究团队选取四类功能迥异的蛋白质开展湿实验,全部以文字描述作为输入,经计算筛选确定候选序列后进入实验,且四类全部验证了功能:
- 荧光蛋白:从优先筛选的29个候选设计中获得具有绿色荧光的pinalGFP;对发色团关键残基进行突变后荧光消失,支持这一设计具有相应的发光机制
- 降解PET塑料的酶:筛选获得的pinalPETase36能在实验条件下水解预处理PET底物,化学分析检测到逐渐积累的降解产物,扫描电子显微镜显示酶处理后的PET表面出现孔洞和凹坑
- 醇脱氢酶:团队没有在文字需求中限定酶的亚家族或链长,最终获得覆盖三个不同亚家族的五种活性设计,展示了模型围绕同一功能生成多种分子方案的能力
- 穿梭H蛋白:需要经过正确的翻译后修饰并与其他酶协同工作,成为检验设计蛋白能否融入复杂多酶反应体系的重要案例
原发杰在报道中强调,Pinal的关键不只是让AI生成一串看起来合理的氨基酸字母,而是继续追问:这些字母组成的蛋白质,离开电脑后能不能在真实实验中发挥功能。四类实验给出的答案都是肯定的。
1.7倍:H蛋白通路产物浓度超过天然蛋白
四类验证中最能打动研发场景的,是穿梭H蛋白这组结果。H蛋白在二氧化碳固定多酶体系中承担物质转运,设计蛋白不仅要自己能正确折叠、被修饰,还要嵌进既有的多酶流水线协同工作。实验显示,搭载设计H蛋白的通路,其产物浓度达到天然蛋白版本的1.7倍。

这个数字的意义在于:AI设计的序列并不只是「能用的替代品」,在特定工程化场景中已经可以超过天然模板。对酶工程、生物催化与合成生物学方向的研发管线来说,这意味着一个可预期的效率增量来源——用语言描述目标功能,直接获取高于天然基线的候选,再进入常规优化流程。
冷静观察:功能验证是起点,成药与工业应用还有长路
需要把边界说清楚。原发杰自己表示,目前基于自然语言描述的蛋白质设计模型仍处于概念验证阶段。四类湿实验验证的是「功能存在」,不是「产品就绪」。
- 距离药物开发与工业应用,还需要成药性、安全性与规模化放大的系统验证
- 更精细的设计需求——例如通过语言指令指定荧光蛋白的发光波段——仍是团队与科技界当下面临的科研挑战
- 合成训练数据的质量上限,取决于底层注释与生成模型的偏差,17亿条配对不等于17亿条独立知识
- 1.7倍的通路产物浓度是特定体系内的单点结果,不能外推为普遍性能
对药企研发的启示是现实的:Pinal目前改变的是「提出候选」这一步的成本结构,而不是整个开发周期。把它放进管线的正确位置,是早期探索阶段的候选生成器,而不是终局方案。真正值得盯的下一步,是这套「结构为桥、合成配对补数据」的范式,能否在抗体、酶药等更贴近制药的品类上,重复出同样的湿实验成功率。
原文链接:科技日报
千方医数集编辑部 出品
