Scientific Data:胰腺癌慢性缺氧多组学数据集开源,20785个基因配52770个磷酸化位点
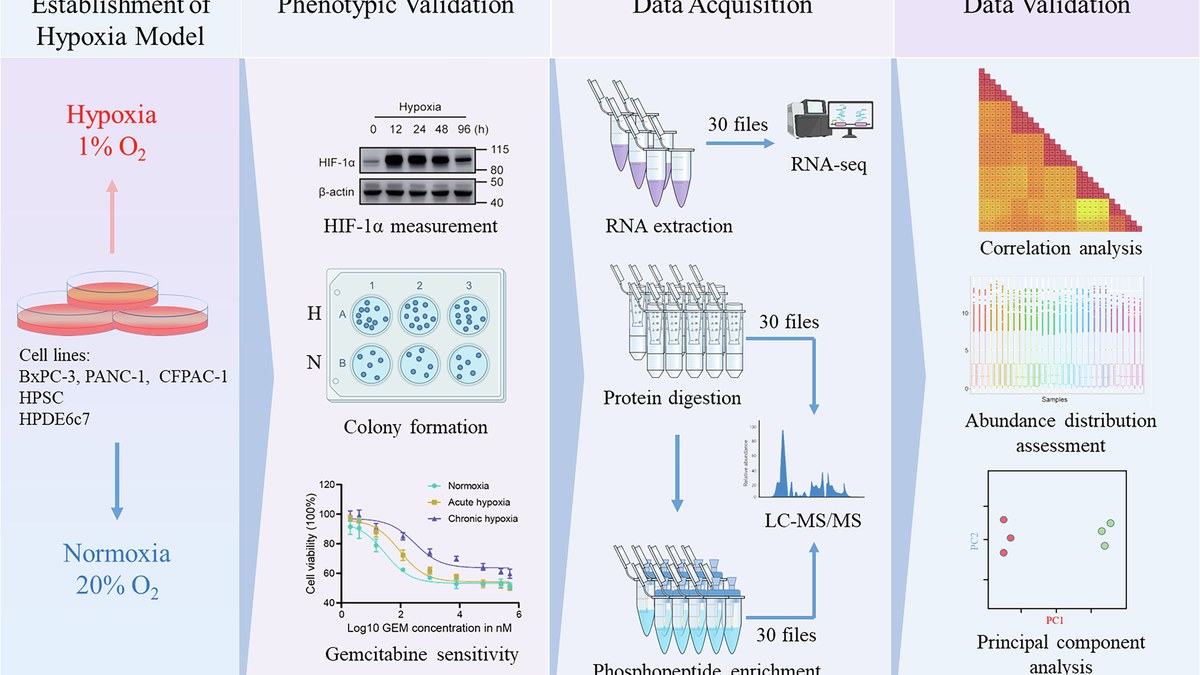
Scientific Data于2026年10月6日在线发表一份胰腺导管腺癌慢性缺氧多组学数据集:覆盖3株PDAC细胞系、1株胰腺星状细胞系与1株非恶性胰腺导管上皮细胞系,分别在常氧与慢性缺氧条件下培养,并提供三次重复的生物学样本。数据集含配对的转录组、蛋白质组与磷酸化蛋白质组谱,定量到20785个基因、10208个蛋白与52770个I类磷酸化位点。
慢性缺氧配对多组学:胰腺癌研究多了底座,但还没有新结论
数据视角 × 医疗数据从业者 | 趋势前瞻 × AI技术供应商/创业者 | 行业观察
2026年10月6日,Scientific Data在线发表一份面向胰腺导管腺癌(PDAC)肿瘤微环境慢性缺氧的配对多组学数据集:5株胰腺来源细胞分别在常氧与慢性缺氧两种条件下培养,提供三次重复的生物学样本,覆盖转录组、蛋白质组与磷酸化蛋白质组三层,定量规模为20,785个基因、10,208个蛋白、52,770个I类磷酸化位点,并以集落形成改变与吉西他滨反应差异做表型验证。
对医疗数据从业者而言,这份数据的价值集中在配对二字:同一批生物学样本上同时测三层,省掉了跨研究拼接的老麻烦;对技术供应方而言,要先判明它覆盖的是细胞系层面的分子反应,不是患者队列,这决定它能进哪一类研发流程。
开场:缺氧这件事,胰腺癌研究里一直缺一份底座数据
缺氧是胰腺导管腺癌微环境的突出特征,肿瘤内部血供与消耗失衡,形成持续低氧区域。既有研究把这种状态与疾病进展、化疗耐药联系起来,这是学界长期持有的假说,也是很多人想往下挖的入口。
但入口处一直缺基础设施。论文描述的缺口很具体:此前缺的是跨多个胰腺细胞模型的、慢性缺氧诱导分子变化的配对多组学资源。这句话有三个限定词值得分别记。跨多个细胞模型,意味着单一细胞系上的结论不能外推;慢性缺氧,意味着不是短时缺氧处理那类实验条件;配对多组学,意味着转录、蛋白与磷酸化要在同一批样本上测,而不是从不同研究里各取一份再拼起来。
数据集类论文不提供新结论,它提供让后续研究可比的底座。这份数据想填的正是这个位置。
五株细胞、两种氧气条件:这个设计在控制什么
模型共5株细胞:3株PDAC细胞系、1株胰腺星状细胞系、1株非恶性胰腺导管上皮细胞系。每株分别在常氧与慢性缺氧条件下培养,另提供三次重复的生物学样本,合起来是5乘2乘3共30份生物学样本,每层组学各测一遍。
这个设计的控制逻辑是配对的:同一株细胞内部比较两种氧条件,遗传背景这一大组混杂因素被自动抵消,剩下的差异主要可归因于氧条件。
五株的构成解决的是另一件事。3株恶性细胞系之间可以互相印证,看缺氧反应是共性还是株系特异;星状细胞系把基质成分纳入,因为胰腺癌微环境里基质占比高;非恶性导管上皮提供对照,用来判断某一变化是恶性细胞特有还是低氧下的普遍反应。需要提醒的是,摘要未给出各株之间的横向比较结论,上述用途是设计能支撑的方向,不是已经产出的结果。
三次重复这一条要单独说。三次生物学重复意味着统计功效有限,差异检出对离群值敏感,效应量偏弱的分子变化很可能检不出。用它生成假设是合适的,用它下确定性结论则不够。
三层次配对:转录、蛋白、磷酸化分别能回答什么
三层组学分别是转录组RNA-seq、蛋白质组与磷酸化蛋白质组,且互相配对。定量规模为20,785个基因、10,208个蛋白、52,770个I类磷酸化位点。
配对的实质是同一批生物学样本被拆开分别测量。这避开了多组学研究里最常见的一个坑:不同组学来自不同实验批次时,观测到的不一致分不清是生物学差异还是批次差异。三层同源之后,转录层面的变化有没有传导到蛋白层面,就可以直接问。
三层的分工也不同。转录组回答哪些基因的表达被缺氧改写,蛋白质组回答这些改写是否落到蛋白丰度上,磷酸化蛋白质组更靠近信号通路活性,因为磷酸化状态的改变往往比丰度改变来得更快、更直接。I类磷酸化位点是磷酸化鉴定中按定位置信度划分的一档,摘要未给出其判定阈值与鉴定流程。
规模也要按口径读。20,785个基因是检出量而非差异量,10,208个蛋白同理,52,770个磷酸化位点也不例外;摘要未给出差异显著的基因、蛋白与位点各有多少,也未给出统一的差异判定标准。因此这三个数描述的是数据厚度,不是发现数量。
吉西他滨反应差异:表型验证走到了哪一步
数据集附带的表型验证分两项:缺氧相关的细胞集落形成改变,以及吉西他滨反应差异。
这两项的作用是把分子层面的变化锚定到可观察的功能上。集落形成反映细胞的长期增殖与存活能力,吉西他滨是胰腺癌化疗的基础药物,看缺氧条件下细胞对它的反应是否改变,等于把前面的分子图谱与一个临床关心的表型连起来。没有这一步,数据就只是一张差异清单。
但验证的边界必须划清。其一,验证范围只有这两项,摘要未涉及侵袭、迁移、代谢重编程等其他表型。其二,没有动物模型验证,也没有任何临床样本或患者队列层面的验证。其三,吉西他滨反应差异的幅度、剂量设置与统计检验摘要未给出,因此不能据此得出慢性缺氧导致耐药的结论。
更关键的一句:缺氧与化疗耐药的关联是既有假说,这份数据集提供的是检验该假说的研究底座,它本身不构成新结论。
冷静观察:细胞系数据是起点,不是结论
先把没有的部分列出来。这是细胞系层面的体外数据,不是患者队列或临床样本;未见动物模型验证,未见临床样本验证,未见临床相关性或预后关联分析;三次生物学重复意味着统计功效有限;表型验证仅限集落形成与吉西他滨反应两项;摘要未给出差异分析的具体阈值与多重检验校正方式,也未给出数据存放格式、许可协议与质控指标明细。这些缺席决定了它的身份是研究平台,不是临床证据。
细胞系这一属性还带来一层常被低估的限制:长期培养的细胞系在染色体状态与代谢特征上与体内肿瘤有差距,且缺少微环境中的免疫成分与三维结构。慢性缺氧在培养箱里是单一变量,在患者体内是与灌注、间质压力、代谢互作耦合的状态。因此从这里读出的分子程序,需要在更接近体内的模型里再验一遍。
因此正确的表述是:这份数据集填补了跨多个胰腺细胞模型的慢性缺氧配对多组学空白,为研究缺氧介导的机制、发现生物标志物与识别治疗脆弱性提供了平台;不能写成临床数据集,不能写成它证实了缺氧导致耐药,也不能把细胞系上的分子差异读成可进入临床的标志物。
接下来该追问的是四件事。其一,差异分析的具体阈值与显著分子数量何时公布,这决定数据厚度能转成多少可用假设。其二,三次重复之外是否存在独立验证批次,重复之间的变异有多大。其三,星状细胞与恶性细胞的互作是否被纳入共培养设计,微环境的细胞间对话现在只到单培养。其四,数据的许可与使用条款如何设定,这决定企业能否把它用于商业研发。这四件事没有答案之前,这份数据最合适的用法是假设生成器,不是结论来源。
原文链接:Scientific Data论文
千方医数集编辑部 出品
