Scientific Data:1579例股骨颈骨折CT多视角数据集开源,双医师标注κ=0.82
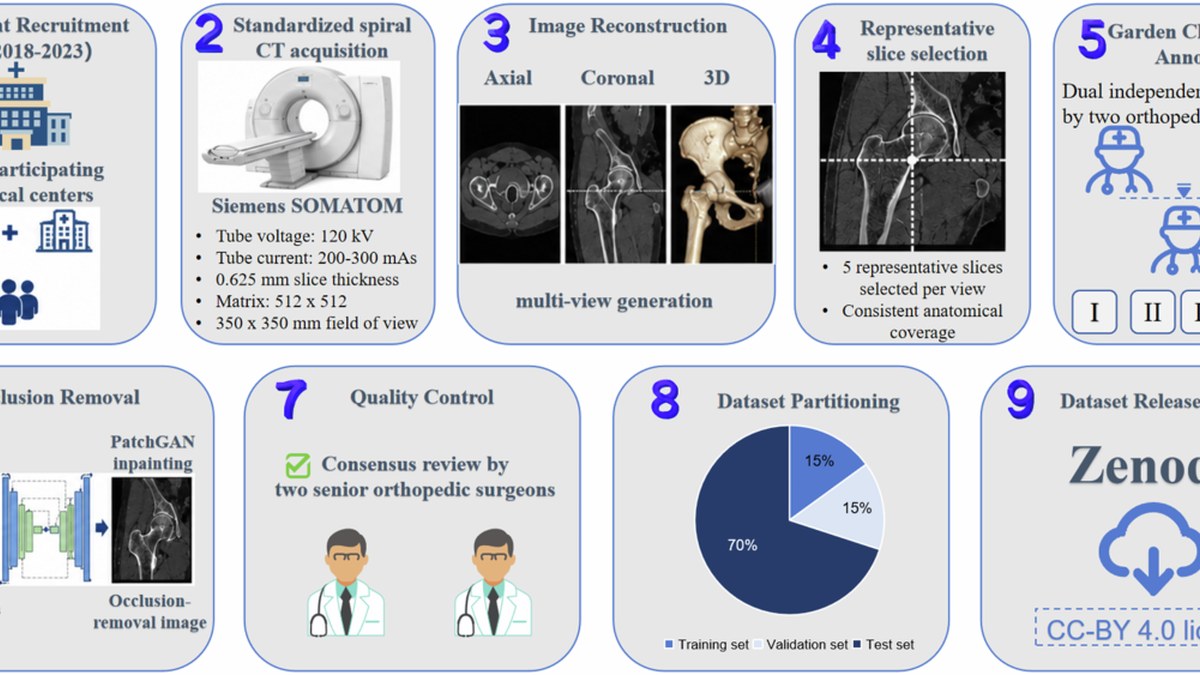
Scientific Data于2026年10月8日在线发表一份股骨颈骨折Garden分型多视角影像数据集:含1,579名患者的19,940张CT衍生图像,分轴位CT、冠状位CT与三维容积再现三类视角,每类均提供原始图与去除内固定物遮挡的配对图。两名高年资骨科医师独立标注,标注一致性Cohen's κ为0.82,遮挡区分割Dice为0.962,基准分类AUC超过0.96。
骨科AI缺的不是模型,是一份能拿来互相比较的数据集
数据视角 × 医疗数据从业者 | 影响分析 × 投资人与产业分析师 | 行业观察
2026年10月8日,Scientific Data在线发表一份股骨颈骨折Garden分型的多视角影像数据集:含1,579名患者的19,940张CT衍生图像,覆盖轴位、冠状位与三维容积再现三类视角,每类都提供原始图与去除内固定物遮挡后的配对图。两名高年资骨科医师独立标注,一致性Cohen κ为0.82,遮挡区分割Dice为0.962,基准分类实验的AUC超过0.96。
对数据从业者而言,这份数据集的价值不在规模,而在它把标注流程、划分方式与质量指标都写清楚了,这是可复用数据集与一次性数据的分界线;对产业端而言,需要判断的是它能否成为骨科影像AI的公共标尺,而不是又一份只能用于自家训练的数据。
开场:Garden分型为什么卡在数据这一层
Garden分型是股骨颈骨折最常用的分类体系,按移位程度分为四型,直接影响治疗决策:无移位与完全移位骨折的处理路径完全不同,前者多考虑内固定,后者常需关节置换。分型判断错了,治疗方向就可能错。
这个任务看似适合交给AI。CT图像上骨折线的位置、走行与股骨头的相对关系是可观察的,判断规则在教材里写得清楚。但领域里一直没有可比的模型,原因不在算法,而在没有共同的评测基础:各家用各家的私有数据,样本构成不同、标注者不同、划分方式也不同,两个团队报出的准确率无法互相印证。
论文把缺口描述得很直接:缺少公开的、经专家标注的、多视角的影像数据集,导致可复现的模型开发与跨机构验证都受限。这句话点出了问题的性质——这是一个基础设施缺口,不是一个算法难度问题。数据集类论文的价值也正在这里,它不提供更好的模型,它提供让模型之间可比的条件。
19,940张与1,579例:这份数据是怎么长出来的
19,940张CT衍生图像来自1,579名患者,分六类图像:轴位CT视图、冠状位CT视图与三维容积再现视图,每一类都同时给出原始图与去除内固定物遮挡后的图像,所以是三类视角乘以两种状态。
配对设计是这份数据最值得记的一笔。骨折术后常带有内固定物,金属植入物在CT上产生伪影并遮挡骨折线,是这一类任务里最烦人的干扰源。同时提供原始与去遮挡两个版本,等于把干扰变量单独剥离出来,让研究者可以分别测试模型在有遮挡与无遮挡条件下的表现差异。去遮挡这一步本身也做了质量验证,分割Dice为0.962,并由专家确认去除后的图像在解剖上合理。
数据来源是回顾性螺旋CT检查,在伦理批准号2024(Research)-024下收集,按标准化纳入与排除标准筛选。论文流程图所示招募区间为2018至2023年。划分方式采用患者级划分以阻断数据泄漏——这一点看似技术细节,实则是许多影像AI研究翻车的地方:若按图像而非按患者划分,同一患者的轴位与冠状位图会同时出现在训练集与测试集,成绩会被系统性抬高。
κ=0.82与Dice 0.962:标注质量怎么被量化
标注由两名高年资骨科医师独立完成,分歧交由一名骨科主任医师裁决。一致性指标为Cohen κ等于0.82,95%置信区间0.78至0.86。
κ这个指标的意义在于它扣除了偶然一致的部分,因此比简单一致率更能反映真实的一致程度。0.82属于高度一致区间,但要注意它衡量的是两名医师之间的一致程度,不是标注与真实情况的一致程度。两人看法相同并不等于看法正确,且Garden分型本身在临床上就存在判读差异,尤其在相邻型别之间。这意味着0.82既是这份数据的质量证明,也提示了该任务天然的不确定性上限。
Dice 0.962衡量的是遮挡区分割的准确程度,属于预处理环节的质量指标,与分类标注质量是两个独立维度。它的作用是让使用者知道,去遮挡这一步不是靠人工逐张擦除,而是有可量化精度的自动分割,且精度足够高,不会引入明显的形态扭曲。
论文同时报告了各数据集划分之间的人群特征均衡,并记录了采集协议、标注流程与预处理步骤。这些是数据集类论文最该有而常被省略的内容:没有采集协议就无法判断外部适用性,没有标注流程就无法复现标注口径。
AUC超过0.96:基准结果能说明什么,不能说明什么
基准分类实验在冠状位去遮挡子集上进行,论文称代表性的卷积架构与Transformer架构都取得了超过0.96的AUC。
这个数字要先看清它的主语。它证明的是数据集具有区分效用,即数据里确实含有足以支持分型的信号,且这份数据能训练出高区分度的模型。它不证明这些模型可以进入临床流程,也不证明它们在别的医院数据上还有同样表现。
还有三点限制了它的可推广性。其一,实验只在冠状位去遮挡子集上做,不是全六类图像上的结果,轴位与三维容积再现视角上的表现未给出。其二,这是单中心回顾性数据,人群构成、设备与重建参数来自同一来源,跨中心的表现需要另测。其三,AUC是排序质量指标,它不给出临床实际使用时的阈值行为,也不反映在型别分布不均衡时的实际收益。
对数据从业者更实际的一点是,有了这份公开数据,不同团队的模型终于可以在同一份数据上报数并互相比较。这才是基准的意义:不是0.96这个数字有多高,而是从此之后的数字可以放在同一把尺子上读。
冷静观察:数据开源了,临床可用性还差一层
先把没有的部分列出来。除单中心回顾性数据与冠状位去遮挡子集上的基准外,论文未见多中心外部验证,未见不同CT设备与重建算法条件下的稳健性测试,未见与骨科医师在日常流程中的一致性对照,未见前瞻性研究,也未见任何器械注册路径。这些缺席决定了它的身份是研究与评测资源,不是临床可用工具。
还需要说明Garden分型这一任务本身的天花板。κ为0.82意味着人类专家之间也存在约两成的分歧空间,模型在这一任务上能达到的上限,受制于标签本身的确定性。任何声称显著超越专家一致性的结果,都需要先解释它超越了什么标准。
因此正确的表述是:这份数据集填补了骨科影像AI在公开评测基础上的空白,配对去遮挡设计与患者级划分是可借鉴的数据工程实践;不能写成它带来了可用的分型工具,也不能把基准AUC读成临床准确率。
接下来该追问的是四件事。其一,其余五类图像视角上的基准结果何时补齐,轴位与三维视角的表现是否一致。其二,数据以何种许可开放、是否允许商业使用,这决定了企业能否把它用于产品评测。其三,跨中心验证何时启动,不同设备条件下的衰减有多大。其四,Garden分型的标签确定性是否会成为这类模型的共同上限,需要用多中心多人标注来测定。这四件事没有答案之前,这份数据最合适的用法是当标尺,不是当训练集。
原文链接:Scientific Data
千方医数集编辑部 出品
