Scientific Data:德国罕见病登记NARSE跨注册库语义互操作评测,32个元素仅2项无法映射,信息保留分0.76
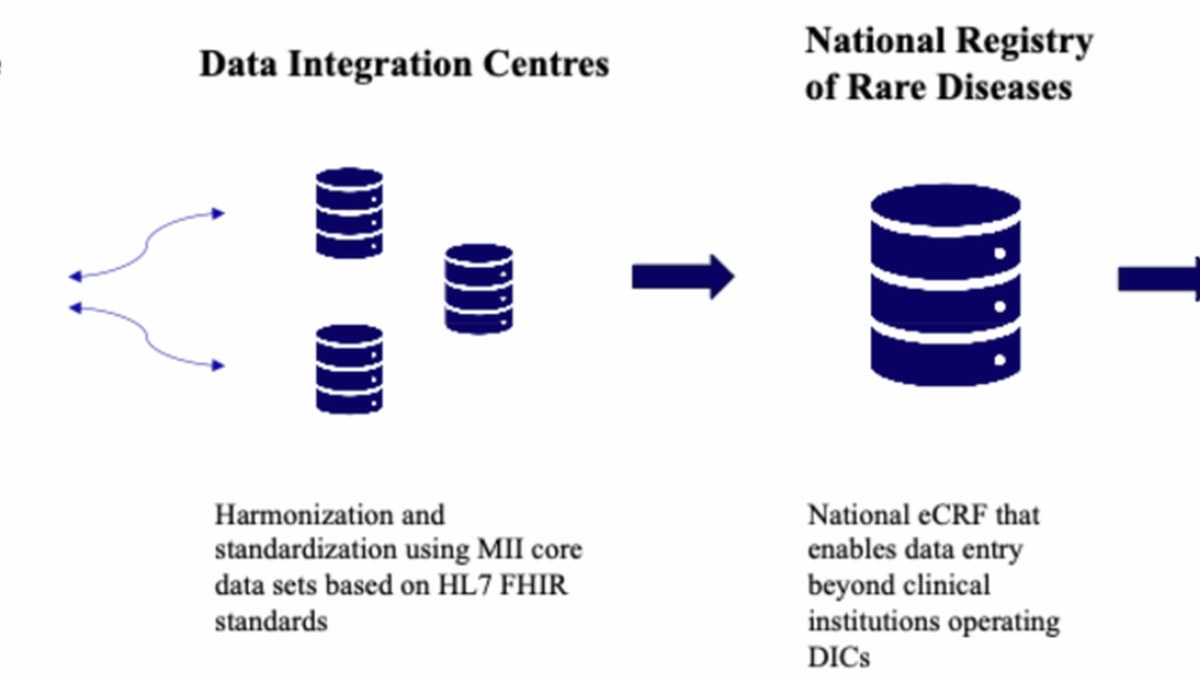
发表于Scientific Data的研究评估德国罕见病登记NARSE与其他核心数据集的语义互操作性。32个NARSE目标元素中有30个在德国医学信息学倡议核心数据集(MII CDS)中找到对应元素,映射构成为exactMatch 31%、closeMatch 53%、relatedMatch 9%,仅出生时生物性别与出生地无法映射。MII至NARSE方向信息保留分为0.76(信息损失24%),NARSE至欧洲罕见病注册基础设施(ERDRI)方向为0.73(损失27%)。
32个元素,两个对不上,还是丢掉了四分之一的信息
数据视角 × 医疗数据从业者 | 影响分析 × 药企研发负责人 | 深度研报
2026年9月30日,Scientific Data在线刊出一项研究,PMID 42816551,DOI 10.1038/s41597-026-08406-6。研究评估德国罕见病登记NARSE与其他核心数据集之间的语义互操作性:32个NARSE目标元素中有30个在德国医学信息学倡议核心数据集(MII CDS)中找到对应元素,仅出生时生物性别与出生地无法映射。信息保留分MII至NARSE方向为0.76,即信息损失24%;NARSE至欧洲罕见病注册基础设施(ERDRI)方向为0.73,损失27%。作者的结论是低损但非无损。
背景数据两条:罕见病全球影响约4.46亿人,欧盟定义为患病率低于万分之五。这个定义直接决定了为什么单点数据不够用,也决定了为什么要把映射本身做成一门学问。
开场:32个字段里只有两个对不上,听起来不错
要先拧的是量纲。32是数据元素的数量,另一方向的14同样如此,两处都不是患者数。摘要未给出NARSE实际登记的患者数,因此这篇稿里所有数字都不能读成队列规模。
结果初看不错:30个元素找到对应,只有出生时生物性别与出生地两个元素对不上。这两个恰好都属于最基础的人口学字段,缺的不是冷门变量。
方法上有两把尺子。映射采用5类SKOS式映射类别,信息损失则用启发式量表评估。把这两件事分开是本研究的贡献所在:一把尺子量「能不能对上」,另一把尺子量「对上之后还剩多少」。
这个结构值得记住。很多互操作评估只报覆盖率,覆盖率高的系统未必能交换出可用的信息。这里把映射类别与保留分并列,等于把「连得上」和「传得动」拆成两个问题,各自给答案。
exactMatch只占31%:能对上不等于完全一样
在已建立映射的元素中,映射构成为exactMatch 31%、closeMatch 53%、relatedMatch 9%;broadMatch与narrowMatch两类均为0。
完全等价的只占31%,其余对上了但有折损:closeMatch是近似,relatedMatch只表示相关。broadMatch与narrowMatch均为0,说明没有出现一方比另一方宽或窄的层级错位,错的是横向分类而不是纵向包含。
还有一个过程数据不该漏:32个元素中有5个因初审评审意见不一致进入共识讨论,最终3个定为closeMatch、2个定为relatedMatch。这说明分类本身带评判成分,即使专家也不是一次性达成协议。做数据治理时这个环节必须留痕,因为映射结论会被下游当成既定事实使用。
另一方向的结构类似但更松:NARSE至ERDRI评估14个元素,13个可语义映射,构成为exactMatch 21%、closeMatch 64%、relatedMatch 7%,1项无法映射。完全等价的比例比MII方向更低。
0.76的保留分:丢掉的那24%是什么
信息保留分MII至NARSE为0.76(信息损失24%),NARSE至ERDRI为0.73(损失27%)。这两个数由启发式量表给出,摘要未给出置信区间与P值,因此应理解为量级提示,不是精确测得的值。
分类别看,能知道损失落在哪里。MII至NARSE方向,诊断0.94、标识数据0.83,其余类别在0.57至0.77之间;NARSE至ERDRI方向,诊断达到1.0,最低类别降至0.56。诊断类最好符合预期,编码体系相对统一;短板在诊断之外的部分。
还有一种类别是算不出来的:家族史类别因缺对应元素无法计算保留分。它不是低分而是缺项,以另一种形式计入损失。
对研发侧的含义可以按用途分。做自然史研究或外部对照,诊断与标识数据的高保留分基本够用;评估治疗获益或做安全性随访,落在0.56至0.77那一批类别上的变量就要重新设计,或在源系统里单独补采。把0.76当成整体可用的一次判定,会忽略这种分布差异。
换权重也稳:0.73到0.81说明什么
作者做了一次敏感性分析。更换权重方案后,MII方向保留分在0.73至0.81之间波动,ERDRI方向在0.71至0.79之间。
这两个区间比单个点更有用。它们说明0.76与0.73不依附于某一套特定的权系数:换权重会带来上下移动,但不会把结论从可用推到不可用,反之也不会把0.76抬到接近无损的程度。
反过来读,同样说明保留分的绝对值不必过度解读。0.76与0.73只在这套启发式量表下有意义,换一套量表、权重不变,数值也可能不同。摘要没有给出量表细节与比对数据,第三方无法重算一遍。
落到实践上,0.7到0.8这个区间的互操作性,适合做计数、分型与可行性评估,不适合当作个体患者的连续随访数据源。跨库查询能回答有多少符合入选条件的人,回答不了这些字段能不能支撑终点指标的判定。
冷静观察:还有一块没算进来,家族史和ICF
第一处空白要先说在数字之前:本次映射未覆盖ICF(国际功能、残疾与健康分类)。罕见病研究里功能状态与生活质量属于核心结局,这部分变量没有被纳入评估,0.76与0.73的口径里不包含它们。这不算研究缺陷,但读数字时必须知道它不在里面。找不到对应元素的还有家族史类别,它连保留分都无法计算。
第二处是规模问题。32与14是元素数量,摘要未给出NARSE实际登记的患者数,也未给出各类别各自包含多少元素;诊断0.94这个分数背后覆盖几个字段、每个字段权重如何,都不清楚。所有保留分同样没有置信区间与P值,类别之间的高低差异是否有统计意义无法判断。
第三处是可迁移性。结论建立在德国MII CDS与欧洲ERDRI这两套特定体系上,两者的元素定义与编码习惯都已成型;换成结构差异更大的数据集,或并无标准术语约束的数据源,缺失情况可能更多。摘要没有给出与其他国家核心数据集的对照,也没有说明元素抽取过程是否依赖人工判断。
所以这条结论停在作者自己的表述上:低损但非无损。它给了「大致能连」的证据,也给了不能说「完全互通」的三条理由——两成以上的信息损失、家族史缺项、ICF未纳入。能否支撑跨库研究,取决于研究要用哪一类变量,而不是取决于0.76这个数本身。
原文链接:Scientific Data(DOI 10.1038/s41597-026-08406-6)
千方医数集编辑部 出品
