RadKev开源放射决策模型:15项任务平均准确率较通用模型高4.9个百分点,单问延迟128毫秒对16.9秒
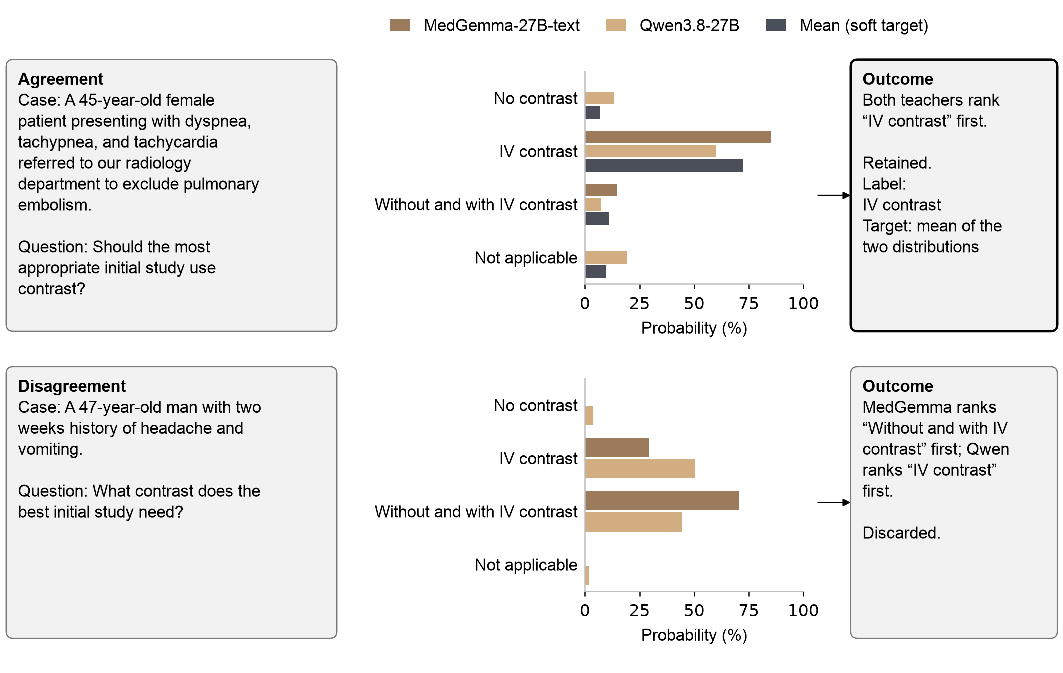
威斯康星大学麦迪逊分校团队在medRxiv发布预印本《RadKev: An Open-Weight Decision Model for Radiology》,用36109条公开放射数据集记录微调通用决策模型Kev-27B与Kev-9B。决策模型对固定选项一次给出各答案概率、不生成文本。在14142道留出题、15项任务评测中,RadKev-27B任务平均准确率较Kev-27B高4.9个百分点,95%置信区间3.8至6.2,最大单项增益在报告错误检测达22.6个百分点。单问延迟128毫秒对16.9秒,低132倍;5%错误率下可回答90.5%的问题。适用于报告阅读、病例诊断分类等类别化放射决策场景,部署前需在本地数据上验证。
事实报道 × 医疗数据从业者 | 数据视角 × 监管与合规专家 | 产品发布
威斯康星大学麦迪逊分校团队在预印本平台medRxiv发布《RadKev》,用36109条公开放射数据集记录在通用决策模型上做微调,得到开放权重的放射科专用决策模型。在14142道留出题、15项任务的评测中,其任务平均准确率比通用模型Kev-27B高4.9个百分点,单问延迟仅128毫秒,对比推理模型的16.9秒低132倍;该成果目前仍属未经同行评审的预印本。
开场:威斯康星大学麦迪逊分校团队在medRxiv发布RadKev,用36109条公开放射数据集记录在通用决策模型Kev-27B与Kev-9B上微调,得到首个专门面向放射科并与大模型对照的开放权重决策模型。
这项工作的作者是威斯康星大学麦迪逊分校医学物理系与放射科的Udbhav Ram与Ran Zhang,预印本于2026年10月13日发布在medRxiv。团队用来自公开放射数据集的36109条记录,对通用决策模型Kev-27B与Kev-9B做微调,得到RadKev-27B与RadKev-9B两个版本。作者指出,此前还没有任何一个决策模型专门针对放射科做过领域化,并与大语言模型做系统对照,RadKev填补的正是这一空白。对照对象包括原有的Kev系列、托管的决策模型Jev与OpenAI Decisions,以及同规模的大语言模型Qwen3.8-27B。作者同时声明不存在竞争性利益,并确认研究遵循了相关伦理规范、取得了必要的机构审查批准。
模型形态:决策模型对固定选项一次给出各答案的概率、不生成文本,RadKev-27B以Qwen3.8-27B为骨干,覆盖报告阅读、病例诊断与分类、放射知识共15项任务。
所谓决策模型,工作方式与大语言模型不同:面对一组固定选项,它一次前向计算就给出每个允许答案的概率,不逐词生成文本。作者的出发点是,放射科大量决策本质上就是在固定答案集合中做选择,例如一份报告是否描述了某个所见、一项检查应以多高的优先级被阅片。这类任务用生成式模型去做,既慢又难以校准置信度,输出的自由度还带来了格式漂移与幻觉风险。RadKev-27B以Qwen3.8-27B为骨干,评测覆盖15项任务,归为报告阅读、病例诊断与分类、放射知识三大类。由于输出被约束在预先定义的答案集合内,模型给出的概率天然带有可作阈值判断的置信度,这为后续的自动放行与人工复核分流提供了基础。
准确率数据:在14142道留出题上,RadKev-27B比Kev-27B高4.9个百分点,95%置信区间3.8至6.2,最大单项增益出现在报告错误检测,达22.6个百分点;RadKev-9B比Kev-9B高6.9个百分点,与体积三倍于它的Kev-27B无显著差异。
评测集是14142道留出题,预设主要终点为相对Kev-27B的任务平均准确率。结果为RadKev-27B高出4.9个百分点,95%置信区间3.8至6.2,最大单项增益落在报告错误检测,达22.6个百分点。小模型版本的表现同样值得注意:RadKev-9B比Kev-9B高6.9个百分点,95%置信区间5.5至8.4,并且与体积三倍于它的Kev-27B之间没有检测到显著差异。在1675道题的子集上,RadKev-27B优于托管的Jev 3.0个百分点(1.7至4.4)、优于OpenAI Decisions 4.8个百分点(3.2至6.4),也优于不开推理的Qwen3.8-27B 4.7个百分点(3.4至6.0)、优于开推理的Qwen3.8-27B 2.8个百分点(1.0至4.6)。
效率与可控拒绝:单问延迟128毫秒对16.9秒,低132倍;在5%错误率下RadKev-27B可以回答90.5%的问题,Kev-27B为76.4%;开放权重可在院内本地运行,使患者数据留在院内。
工程层面的差距更为悬殊。RadKev-27B的单问延迟为128毫秒,对比推理模型的16.9秒,低132倍,这让逐题打分的批量评测与近实时的科室级调用变得可行。更有实用价值的是可控拒绝能力:在容忍5%错误率的前提下,RadKev-27B可以回答90.5%的问题,而Kev-27B只能回答76.4%,意味着模型能在更大范围内给出可信答案,把剩下的题交给人工。权重已发布在Hugging Face,配套的数据构建、教师标注、训练、评测与统计分析脚本在GitHub公开,开放权重意味着可以在院内本地运行,患者数据不必离开医院,这对受数据合规约束、难以把影像与报告外送的机构尤其关键。需要留意的是,RadKev发布的是适配器与指针头,其依赖的Kev代码以Apache-2.0许可分发,两者许可并不相同。
冷静观察:这是未经同行评审的medRxiv预印本,评测题目与训练记录均来自公开数据集,尚未在真实临床工作流中前瞻验证;权重以CC BY-NC-SA 4.0许可发布、仅限非商业研究用途,商用需另行确认,作者明确要求部署前必须在本地数据上验证。
四点限制必须说在前面。第一,这是一篇未经同行评审的medRxiv预印本,结论尚未经过独立同行评议。第二,训练记录与评测题目都来自公开数据集的留出题,与真实科室的病种构成、图像质量、报告风格存在差距,尚未在真实临床工作流中做前瞻验证。第三,RadKev-27B与RadKev-9B的适配器及指针头以CC BY-NC-SA 4.0许可发布,仅限非商业研究用途,因为部分训练来源带有该许可,商用需要另行确认授权。第四,作者本人在结论中也明确,模型应在本地数据上完成验证之后,才能用于院内的类别化放射决策。对数据从业者来说,可复现性是这项工作的加分项:生成论文中每个数字、表格与图表的脚本都随代码公开,外界可以自行核对而非只引用结论。
原文链接:medRxiv(预印本)
千方医数集编辑部 出品
