npj Precision Oncology:MAVEN融合MRI与病理全片预测肝癌VETC,五中心1928例外部AUC 0.879至0.891
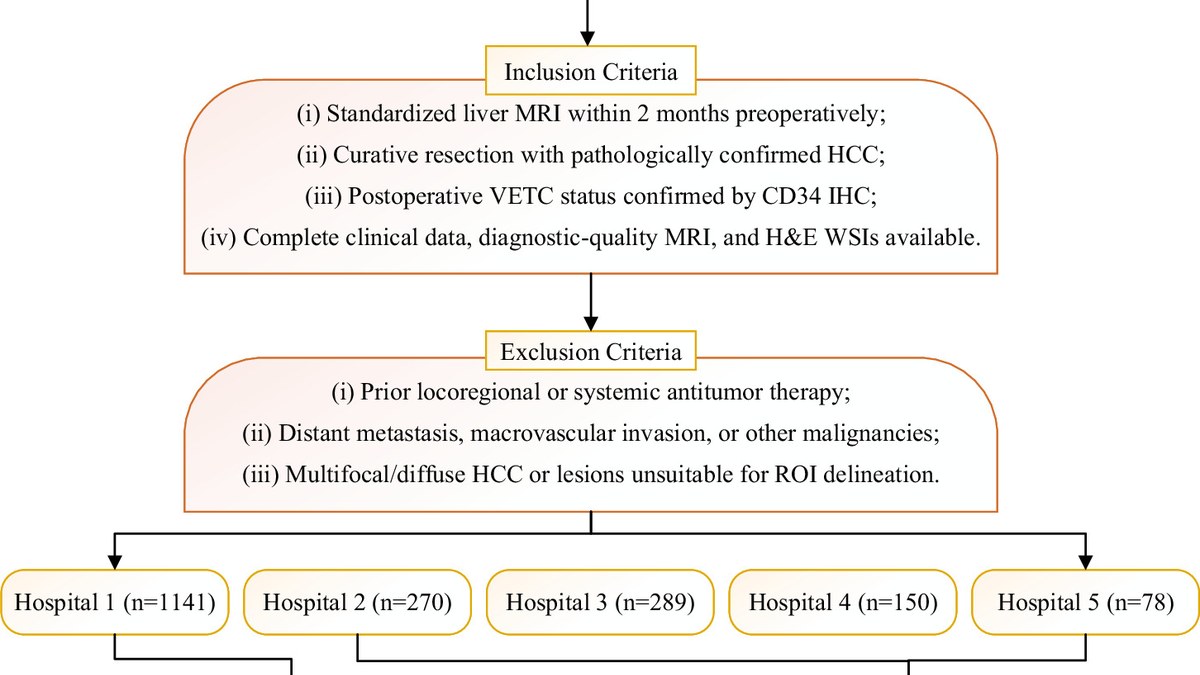
npj Precision Oncology于2026年10月2日在线发表MAVEN:一个全自动多模态深度学习系统,整合磁共振成像、全片病理图像与临床变量,用于预测肝细胞癌的血管包绕肿瘤细胞簇(VETC)并评估早期复发风险。这项多中心研究纳入五个机构1928例患者,内部测试队列AUC为0.932,四个外部队列为0.879至0.891,均优于单模态与双模态模型。
五个中心1928例,MAVEN离全自动预测VETC还有多远
事实报道 × 药企研发负责人 | 趋势前瞻 × 投资人与产业分析师 | 深度研报
2026年10月2日,npj Precision Oncology在线发表MAVEN,即Multimodal Automated VETC Estimation Network,一套同时吃进MRI影像、全片病理图像与临床变量的全自动深度学习系统,用于预测肝细胞癌的血管包绕肿瘤细胞簇VETC,并评估早期复发风险。
研究为多中心设计,五个机构共1928例患者。内部测试队列AUC 0.932,四个独立外部队列AUC 0.879至0.891。对研发端与投资端而言,值得记下的不是0.932本身,而是内外之间落差有多大,以及这条流程的输入条件在什么时点才凑得齐。
开场:VETC是什么,为什么值得单独预测一次
VETC指血管包绕肿瘤细胞簇,是肝细胞癌在镜下呈现的一种组织学模式:肿瘤细胞成簇被内皮细胞包绕,形成可以直接进入血流的通道。它与肿瘤的侵袭行为、转移倾向和术后复发风险相关,因此被当作一层独立的预后信息看待。
问题在于怎么判读。VETC的判定依赖病理医师在术后全片上逐区域观察,工作量大且带主观成分,不同医师之间的一致性难以保证。需要精细目视判读的指标,天然是自动化的候选对象。
自动化的收益有三层:把主观变成可量化,把抽样观察变成全片覆盖,把人工耗时压缩到可批量处理。MAVEN进一步往前推,不只做病理图像判读,而是把影像、病理与临床变量合并进一个网络,输出的也不只是VETC状态,还包括早期复发风险分层。
1928例五个中心:数据是怎么铺开的
1928例是五个机构合计的患者数。需要说清的是,摘要未给出各机构的样本构成,也未给出训练、内部测试与四个外部队列之间如何划分,这意味着0.932对应的内部测试集规模未知,是评估这组数字时最实的信息缺口。
多中心本身是加分项:五个机构意味着扫描设备、序列、制片流程与人群构成都有差异,模型在这种条件下仍稳定,比单中心结果更有说服力。但价值取决于各中心样本量是否均衡,若某一中心占绝大多数,名义上的多中心实际接近单中心,这一点摘要未给出。
三模态同时可得,是数据铺开的真正约束。一名患者要进入建模,必须同时具备可用的MRI、术后全片病理图像与完整临床变量,缺一项即被剔除。这类配对约束会压缩样本,也决定入组人群的偏倚方向:能同时做MRI与完整病理评估的,通常是接受手术、术前检查齐全的那批人。
这里有一处必须点明的时序问题。VETC判读依赖术后病理全片,属术后可得信息,MAVEN的输入包含这一模态,因此完整流程是术后的。术前能否使用,取决于能否拿掉病理这一支,而单双模态模型的表现摘要只给了定性结论,没有给出数值。
0.932与0.879至0.891:内部和外部的落差有多大
两个数字要分开写:0.932是内部测试队列成绩,0.879至0.891是四个独立外部队列的区间。把0.932单独摘出来当作模型性能,是这类论文最常见的转述方式,也最需要纠偏。
内部测试与训练数据共享同一批来源、同一套预处理与同一批操作者,成绩通常高于真实陌生数据。外部队列跨越机构、设备与流程差异,更能代表泛化能力。两者之间约0.04至0.05的落差属于正常范围,不算大,但它存在的本身就说明0.932不应被直接引用为预期性能。
值得注意的是外部队列的区间很窄,0.879至0.891相差0.012,这点是正面的:模型在不同机构之间表现相对稳定,没有某一中心明显塌陷。但摘要未给出四个队列各自的样本量与置信区间,这个稳定性有多少来自样本量支撑,暂时无法判断。
论文还给出两条补充结论。一是性能优于单模态与双模态模型,说明融合确有增益,但摘要未给出对比模型的具体数值与增益幅度,无法判断增益是否值得三倍的数据准备成本。二是风险分层与早期无复发生存显著相关,这属于回顾性队列上的统计关联,说明分层有预后区分度,不代表用它指导治疗能改善结局。
可解释性:模型盯的地方是不是病理学家盯的地方
可解释性分析给出的结论是,影像与病理特征均有贡献,高风险区域的空间定位一致。这句话需要谨慎读。
它说的是两件事:一是模型不是只靠某一支模态在做判断,MRI与病理两侧都提供了有效信息,这支撑了多模态设计的必要性;二是两个模态指向的高风险区域在空间上一致,说明关注的是同一类结构,而不是各自抓住一组无关特征。
但一致这个词有明确边界:它指的是影像侧与病理侧之间的定位一致,不等于模型的注意力与病理学家的判读一致。摘要未给出模型热区与病理医师标注区域的重合度,也未给出一致性的定量指标。把空间定位一致读成模型盯的地方就是病理学家盯的地方,是一次明显的越界。
对研发端来说,这类可解释性证据的用途是排错与沟通,不是验证,它能说明模型没有明显跑偏,但不能替代与人工判读的一致性研究。要推向监管沟通,需要前瞻设计的判读一致性数据与阅片者研究,这一层目前还没有。
冷静观察:全自动流程离临床落地还差哪几步
先把没有的部分列出来。摘要未见前瞻性干预研究,未见模型指导治疗带来生存获益的直接证据,未见各机构样本构成与队列划分明细,未见四个外部队列各自的样本量与置信区间,未见单双模态对比的数值,未见与病理医师判读的一致性指标与阅片者研究,也未见任何器械注册或许可路径。这些缺席决定了它现在的身份是一项多中心建模研究,不是可用的临床决策工具。
因此正确的表述是:MAVEN内部测试AUC 0.932、四个独立外部队列AUC 0.879至0.891,外部验证显示泛化相对稳定,风险分层与早期无复发生存显著相关。不能写成它已能替代病理医师判读VETC,也不能写成依据它调整治疗可以改善结局。前者缺一致性研究,后者缺干预性证据。
对投资端还有一层判断。落地形态受制于输入条件:MRI、术后全片病理与临床变量必须同时具备,这限制了它最自然的场景是术后病理工作流内的自动标注与风险分层,而不是术前决策。想推向术前,就得先回答去掉病理模态后性能掉到哪里,摘要没有给出可核验的数。
接下来该追问的是四件事。其一,五个机构的样本构成与队列划分能否公布,0.932背后的内部测试集有多少例。其二,四个外部队列各自的样本量与置信区间是多少,窄区间有多少来自样本量支撑。其三,去掉病理模态后性能降到什么水平,这决定术前场景是否成立。其四,与病理医师判读的一致性研究何时开展。这四件事没有答案之前,全自动只是流程自动化,不是临床可用性的结论。
千方医数集编辑部 出品
