npj Digital Medicine随机对照试验:眼科预问诊LLM智能体病历采集质量较住院医师高17.7分,交互时长11.2对3.1分钟
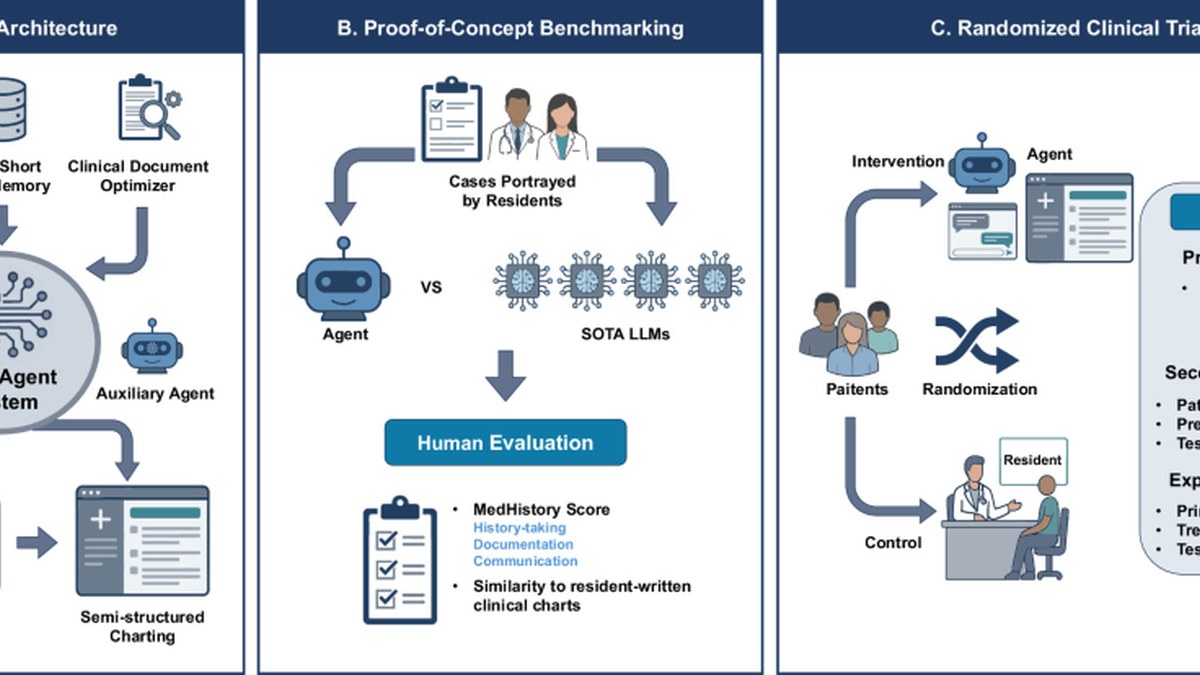
发表于npj Digital Medicine的随机对照试验在中国广州一家三级眼科医院开展,2025年5月10日至6月10日期间172名非急诊预约患者被1:1随机分配至预问诊大语言模型智能体组或眼科住院医师组。智能体采用双智能体架构与技能工程化的症状导向逻辑树。主要结局MedHistory评分(0至100分)校正均差为17.7分(95%CI 14.1至21.3,P<0.001),智能体更优;耐心与共情评分分别为5对4与5对3(均P<0.001);交互时长中位数11.2对3.1分钟(P<0.001)。探索性分析显示仅凭病史的诊断F1为0.85对0.68。
问诊质量高出17.7分的代价,是每次多花八分钟
事实报道 × 医院信息化/临床医生 | 趋势前瞻 × 监管与合规专家 | 深度研报
2026年10月5日,npj Digital Medicine在线发表了一项在中国广州一家三级眼科医院开展的随机对照试验。研究在2025年5月10日至6月10日期间纳入非急诊预约患者,175名受试者中172名被1:1随机分配,一组面对预问诊大语言模型智能体,另一组面对眼科住院医师。主要结局指标MedHistory评分(0至100分)的校正均差为17.7分,95%CI 14.1至21.3,P<0.001,智能体组更优。
这不是又一份 retrospective 的回顾性比对,而是把AI智能体和真人住院医师放在同一时间窗、同一家医院、同一类患者面前做的前瞻性随机对照。它的价值不小,边界也很清楚,两者都写在论文里。
开场:172名患者,被随机分给了AI和住院医师
试验设计为单中心随机对照,1:1随机,对象是非急诊预约患者,时间窗为2025年5月10日至6月10日,地点为中国广州一家三级眼科医院。175名受试患者中有172名完成随机,中位年龄56岁,女性占55%。
智能体一侧的架构被描述为双智能体架构,配合技能工程化的症状导向逻辑树。这个说法值得拆开看:双智能体意味着采集与质控被分成了两个角色,症状导向逻辑树则是把问诊路径从自由对话约束成一棵可枚举的树。对预问诊这种高重复、强流程的场景,工程化约束往往比模型本身更能决定输出稳定性。
研究已在ClinicalTrials.gov注册,摘要给出的注册号前缀为ClinicalT,完整编号未获取。
17.7分从哪来:主要结局怎么测的
主要结局是MedHistory评分,一个0至100分的病史采集质量评分。校正均差17.7分,95%CI为14.1至21.3,P<0.001,方向为智能体组优于住院医师组。
| 结局 | 智能体组 | 住院医师组 | 统计 |
|---|---|---|---|
| MedHistory评分校正均差 | — | — | 17.7分,95%CI 14.1至21.3,P<0.001 |
| 耐心评分 | 5 | 4 | P<0.001 |
| 共情评分 | 5 | 3 | P<0.001 |
| 交互时长中位数 | 11.2分钟 | 3.1分钟 | P<0.001 |
| 仅凭病史的诊断F1(探索性) | 0.85 | 0.68 | P<0.001 |
17.7分是校正后的组间差值,不是两组绝对分的直接对比,评分由谁执行、是否盲法、评分者间一致性如何,公开摘要中未见详细说明,这些都会影响对效应量的解读。次要结局中的患者体验指标同样偏向智能体:耐心评分5对4,共情评分5对3,两项均P<0.001。在一项以病史质量为主结局的试验里,患者主观评分同步朝同一方向移动,这个一致性本身是有信息量的——一个把问题问得更细的流程,通常也容易被感知为更有耐心。
11.2分钟对3.1分钟:质量换来的时间成本
代价写在下一行。交互时长中位数,智能体组11.2分钟,住院医师组3.1分钟,P<0.001。按中位数计算,多出来的时间超过八分钟。
对门诊流程而言,八分钟不是可以忽略的量级。一家三级医院的眼科门诊日接诊量通常不小,把预问诊整体换成智能体,意味着候诊队列、诊室周转与人力排班都要重新计算。需要说明的是,交互时长衡量的是患者与问诊方之间的直接交互,不等于医生的总工时。智能体把病史采集前移之后,医生在诊室内需要补全的信息可能变少,这部分潜在的节省本研究没有统计,公开信息中也未见对医生后续工作量的测量。因此,八分钟是这项试验里最实在的成本项,但未必是全流程的净成本。
时间和质量在这里是明确的一次交换,而不是可以两头兼得。医院信息化部门若想引入同类系统,需要判断的是本单位瓶颈在哪一侧:是病史采集不全,还是诊室周转不过来。
0.85对0.68与那个-0.19:体征进来之后发生了什么
探索性分析显示,仅凭病史做诊断时,智能体组的F1为0.85,住院医师组为0.68,P<0.001,智能体更优。必须强调的是,这是探索性分析,不是预设的主要或次要结局,其结论强度低于前文各项,也不应被单独引用为AI诊断能力优于住院医师的证据。
更有意思的是交互效应:把眼部体征加入之后,住院医师组的改善幅度更大,交互效应为-0.19,P=0.003,两组差距显著缩小。也就是说,AI的优势集中在纯病史阶段;一旦体格检查信息进入,住院医师追上来的速度更快。检查建议方面,各阶段差异无统计学意义。
这组结果勾出的能力边界相当清晰:智能体强在问得全、问得有耐心、不漏项,弱在无法自己获得体征,也不擅长把体征与病史整合进同一个判断。检查建议在各阶段均无统计学差异,说明它也没有开出更合理的检查组合。三项合起来看,智能体在这一试验中是一个更强的采集者,而不是一个更强的诊断者。
冷静观察:单中心单专科,混合工作流才是作者给的落点
作者自己的结论指向混合工作流——由智能体承担病史采集,让临床医生把精力放在体格检查与诊断综合上。这与数据是一致的:AI在病史阶段领先17.7分,体征进来后被追回一大截,两边各有一段相对优势。
局限同样写在明处。单中心、单专科、样本172人、随访期短,泛化性未在研究中验证。172例的样本量足以检出17.7分这样的大效应,但不足以支撑亚组结论,也无法估计罕见情形下的失效风险。眼科是一个病史结构相对规整、体格检查高度依赖设备的专科,把结果外推到主诉模糊、鉴别面更宽的内科或时间压力更大的急诊,需要非常谨慎。11.2分钟的交互时长在真实门诊里能否被患者和排班接受,也不是这项试验能回答的问题。
从监管与合规角度看,这项研究提供的是有效性信号,不是上市依据。探索性分析的F1与主次要结局应当被分开引用,注册信息中完整编号的缺失也需要在正式引用时补齐。编辑部的判断是:预问诊智能体已经越过能不能用的门槛,下一步要回答的是它放在流程的哪一段、以及那八分钟由谁来承担。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
