npj Digital Medicine:机器人手术基础运动学指标区分术者年资,随机森林AUC 0.892±0.075,左手峰值密度为首要判别特征
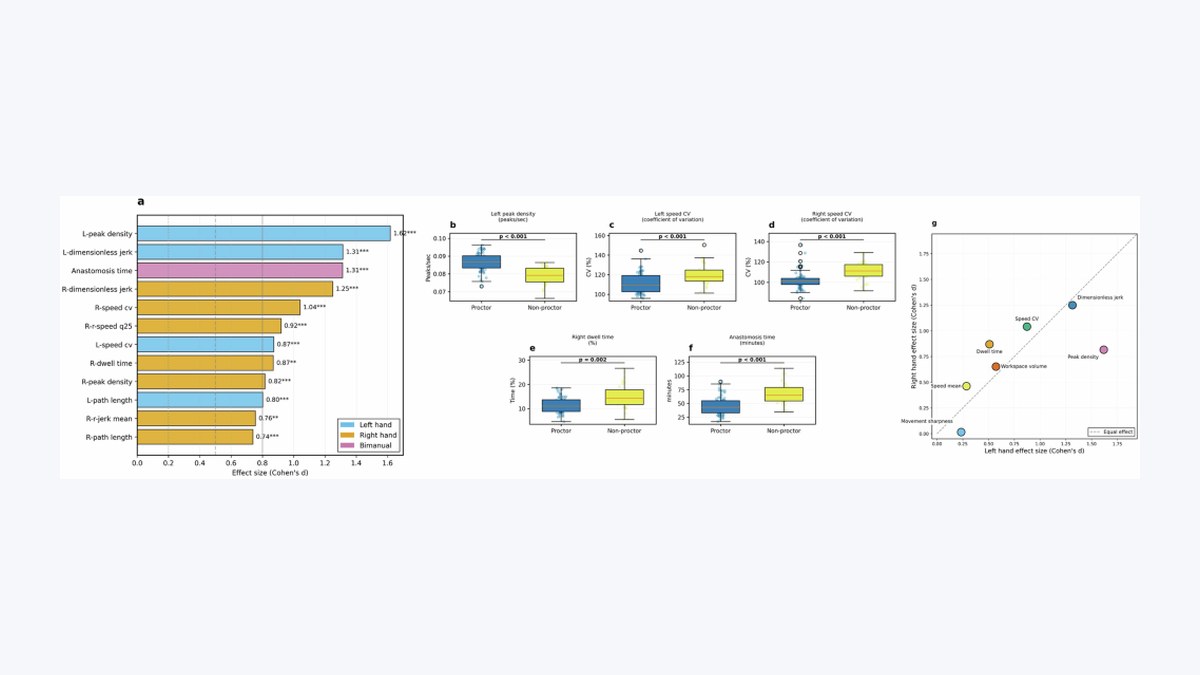
发表于npj Digital Medicine的研究提出只用三维位置坐标即可计算机器人手术的基础运动学指标,并用这些指标客观评估术者专业水平。随机森林分类器在按例层面区分术者年资的曲线下面积为0.892±0.075,特征重要性分析显示左手峰值密度是最主要的判别特征。少量这类基础指标在留一术者交叉验证中可泛化到未见过的术者;运动学模式与临床结局相关,探索性分析提示运动特征与出血量存在关联;个体学习曲线分析发现专家转入新平台时的适应模式差异明显,并识别出若干不同表型。
不打开录像,只看机械臂走过的轨迹
事实报道 × 医疗数据从业者 | 数据视角 × 医院信息化/临床医生 | 深度研报
2026年9月29日在线发表于npj Digital Medicine的一项研究(PMID 42811045),把手术技能评估退回到最基础的输入:三维位置坐标。日本团队提出,只用机器人系统自带的三维位置追踪数据,计算一组基础运动学指标(fundamental kinematic indicators),即可客观区分术者的专业水平(surgical expertise)。
开场:只用坐标,不看画面,也能判断手熟不熟
研究的出发点是一个正在扩大的需求。机器人手术平台在全球普及,随之而来的是对客观技能评估框架的现实需要:谁来评价、凭什么评价、结果能否跨机构比较。作者的答案建立在最朴素的数据之上——任何具备三维位置追踪的机器人系统,理论上都能输出这些基础运动学特征。
可迁移性是全文最值得留意的设计取向。框架若依赖厂商专有字段,最多只能服务一个平台;把输入限定为三维位置,门槛就降到了所有能提供坐标数据的系统。作者的表述是「可能推广」,这个限定要一路带着读。
对临床一侧,好处在于坐标不涉及影像与术野画面,隐私与存储负担明显下降,信息化部门接入时的阻力比接录像流小得多。代价同样清楚:只用坐标,就放弃了器械与组织的交互信息、解剖细节与错误动作的具体形态。
基础运动学指标能回答手怎么动,回答不了为什么这么动。摘要未交代该框架与视频评分法的一致性比较,两者能否互相替代,目前无从判断。
0.892±0.075:这个数是怎么来的,又缺了什么
核心数值是一项分类结果。作者用随机森林(Random Forest)分类器在按例(case-wise)层面区分术者专业水平,报告曲线下面积AUC为0.892±0.075。AUC只描述排序能力,不等于准确率。
「按例」需要专门读一遍:分析单位为一次手术病例,而非切分出的动作片段或时间窗。单位越大样本量越小,同一术者的多例手术之间还存在相关性,这会直接影响泛化误差的估计。摘要未说明是否处理了术者层面的聚类。
至于0.075,摘要只给出这个变异量,未说明统计口径。它既不应读成标准差,也不应读成置信区间——口径不明时,两种解释都属过度推断。稳妥的写法是记为「未说明口径的变异量」。
更实际的缺口在复现层面:特征集合的条目与数量、训练与测试的划分方式、随机森林的超参数,摘要一概未给。摘要也未报告敏感度与特异度,因此无法判断不同判定阈值下的实际表现,更无法据此设定一条可直接用于考核的分数线。
左手峰值密度:为什么是左手
特征重要性分析给出的首要判别特征是左手峰值密度(left-hand peak density)。这是全文信息含量最高、定义也最模糊的一句话。摘要未给出计算公式,也未说明按时间还是按路径长度归一化。编辑部只能从字面推测它衡量手部运动局部峰值的密集程度,此推测有待原文核实。
为什么是左手,摘要未做解释。一种可能的解释是:机器人手术中双手分工不对称,非优势手多承担牵引、暴露、夹持等辅助动作,其节奏与停顿模式可能比主操作手的目标导向动作更稳定地暴露经验差异。这只是机制层面的猜测,研究未验证。
「左手」还有一层方法论含义:判别信号来自特定的手,而非双手的聚合量。若术者惯用手不同、或术式改变导致双手分工重排,这一特征的判别力是否保留,摘要未回答。
价值在于信号的位置。作者指出,与专业水平相关的信号被定位到少数几个可解释的运动学指标上,而不是散落在一大堆难以命名的特征里。对信息化部门而言,能被口头解释清楚的指标,才可能在质控会上被讨论、被写进培训反馈。
留一术者验证:泛化到没见过的人才是硬指标
评估这类模型,划分方式比算法更值得看。留一术者交叉验证(leave-one-surgeon-out validation)每次留出一位术者的全部数据作测试集,其余术者数据用于训练。它检验的问题很直接:模型能不能用在训练阶段从未见过的人身上。
之所以是硬指标,是因为随机划分会制造泄漏。按病例随机拆分时,同一术者的不同手术会同时进入训练集与测试集,模型只需记住个人运动习惯就能拿高分。这种分数反映的是认人,不是评技能。
结果是克制的:摘要的表述是「一小部分」基础指标在该验证中可泛化到未见过的术者。这个限定不能省,它说明并非全部特征都通过了检验,泛化成立的范围是少数指标,而非整套特征集合。泛化后的具体数值,摘要未给。
医院一侧最该关心这一节。若机构打算引入这类指标做院内培训或质控,面对的永远是本院新术者,也就是模型没见过的人。留一术者验证是这套方案能否搬进临床的最小门槛,但它只是必要条件。
冷静观察:探索性结果与学习曲线,离培训工具还有多远
先把信息缺口列清楚。本次可获取的材料仅为论文摘要与元数据,病例数、术者人数、具体机器人平台型号、手术术式均未获取;敏感度、特异度与出血量的具体数值同样未获取。这些空白不靠推算填补。
临床结局那一侧需要降温。摘要称运动学模式与临床结局相关,并报告探索性分析(exploratory analysis)显示运动特征与出血量存在关联。探索性分析是提示性的:不构成因果结论,也不等于已被确认的预测关系。读成动作指标能预测出血,超出了摘要支持的范围。
学习曲线提供另一条线索。个体学习曲线分析显示,专家过渡到新平台时适应模式呈异质性(heterogeneous adaptation patterns),研究识别出不同的表型(distinct phenotypes),作者认为对个性化培训有意义。这是描述性发现:摘要未给出任何培训干预的对照结果,「有意义」仍停留在主张层面。
推广范围要还原成原话的分量。作者的结论是,只用三维位置数据的基础运动学分析可提供可解释的手术表现指标,可能推广到各类提供坐标数据的机器人系统。「可能」指向理论可行性,不是已在多平台完成的验证。
从培训工具的角度看还差几步:在多中心、多平台上做前瞻性验证;给出可用于考核的阈值与误判代价;把动作指标与真实临床结局的前瞻关联建立起来。在此之前,更合适的定位是研究与反馈工具,而不是考核依据。
原文链接:npj Digital Medicine(DOI 10.1038/s41746-026-03137-9)
千方医数集编辑部 出品
