npj Digital Medicine:五个AI证据检索平台实测,表述级召回中位数仅7.2%至42.2%,12.0%证据从未被任何平台召回
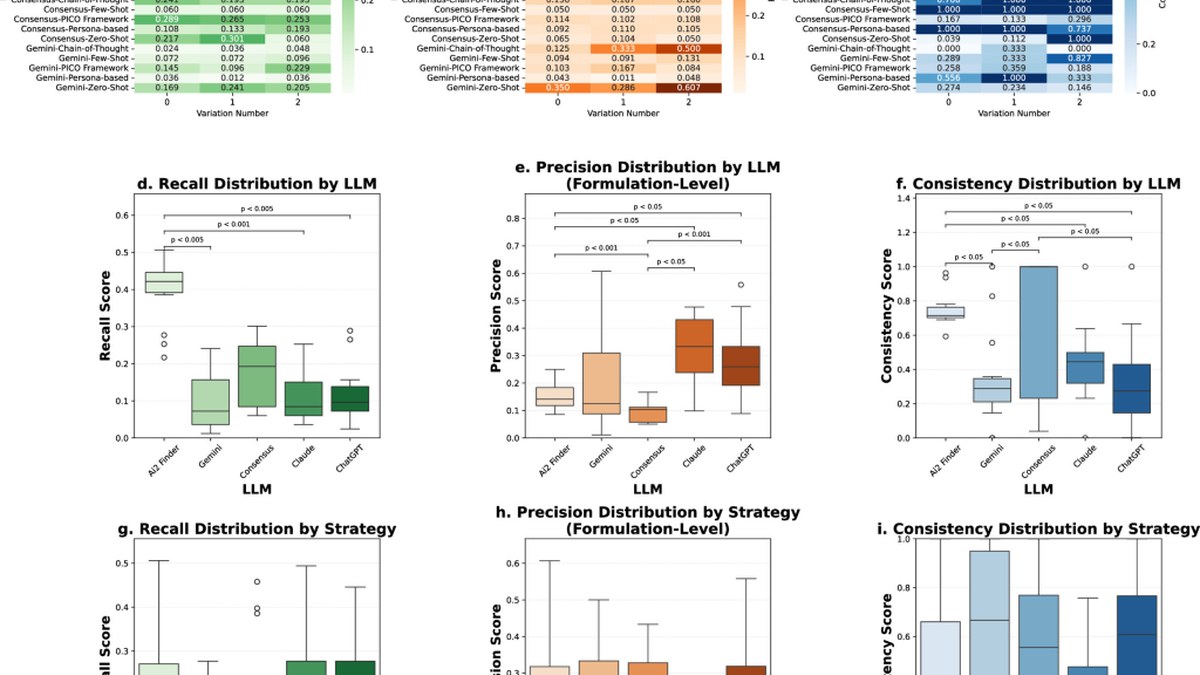
发表于npj Digital Medicine的研究以前瞻构建的非公开金标准语料(避免基准污染)评估五个检索增强与大模型证据检索平台:Consensus、Ai2 Paper Finder、ChatGPT、Gemini与Claude,覆盖15种查询表述。主要结局显示,表述级召回中位数仅7.2%至42.2%;平台汇总召回为45.8%至72.3%;最大证据类别的单次查询零召回概率为47%至80%。12.0%的证据从未被任何平台召回,会议论文零召回率显著高于期刊论文(38.9%对4.6%,P<0.001)。
五个AI证据检索平台实测:表述级召回中位数只有7.2%至42.2%,12.0%证据从未被召回
趋势前瞻 × 药企研发负责人 | 数据视角 × 医疗数据从业者 | 深度研报
2026年9月29日在线发表于npj Digital Medicine的一项研究,评估了五个检索增强与大模型证据检索平台:Consensus、Ai2 Paper Finder、ChatGPT、Gemini与Claude,覆盖15种查询表述,并前瞻构建了一份非公开金标准语料以避免基准污染。
结果中最刺眼的一句是:表述级召回中位数仅7.2%至42.2%。这意味着同一问题换一种说法,检索到的证据就换了一批。对依赖证据检索做立项、综述或医学事务决策的团队来说,这不是模型精度问题,而是证据覆盖面问题。
开场:先造一份谁都没见过的金标准,再去问五个平台
研究方法的核心设计是前瞻构建非公开金标准语料。公开基准很容易进入模型训练数据,导致召回率虚高,这种污染在评测大模型时尤其难排除。用一份没有公开过的语料做对照,等于把尺子先藏起来再造。
受测的五个平台覆盖了三类形态:Consensus与Ai2 Paper Finder是专门的文献检索工具,ChatGPT、Gemini与Claude是通用大模型。研究没有只测专用工具,而是把通用助手一并纳入,这更贴近实际使用情况——多数人查证据时并不会严格区分二者。
每种查询被写成15种表述。这个设计是整篇研究的关键,它使得「换个说法结果是否稳定」可以被量化,而不是停留在经验层面。
15种表述对应的是真实使用中的提问差异:同义词替换、语序调整、问句与短语切换、加上或去掉限定条件。研究没有把这些表述混成一个平均结果,而是分别统计,才使得表述级召回这个指标有意义。
非公开金标准与15种表述这两项设计合在一起,构成了本研究的说服力基础:前者保证尺子没被污染,后者保证结果可重复检验。缺任何一项,召回率的绝对值都会失去参照意义。
7.2%到42.2%:换一种问法,召回就换一批
主要结局之一是表述级召回中位数,区间为7.2%至42.2%。这是单次查询、单一表述下的召回水平,下限7.2%意味着在最差情况下,一次提问只能捞回不到十分之一的已有证据。
另一项指标是平台汇总召回,即在所有表述下至少被召回一次的比例,区间为45.8%至72.3%。这两个数字必须分开读:表述级召回衡量的是单次提问的可靠度,平台汇总召回衡量的是反复提问后的累计覆盖度。
二者之间约四十个百分点的差距,恰恰说明了问题的性质——多问几遍能补回不少证据,但也说明单次检索的结果远不足以支撑结论。用汇总召回的数字去描述单次查询的效果,会严重高估系统表现。
对实际工作流的启示很直接:如果一项决策依赖「证据是否充分」,那么单次查询的结果不能作为充分性依据。研究没有给出需要多少种表述才能逼近汇总召回上限,公开信息中未见相关分析,因此也无法给出一个安全的提问次数。
47%到80%的零召回:搜不到不等于不存在
主要结局之二更为直接:最大证据类别的单次查询零召回概率为47%至80%。也就是说,即便证据确实存在且属于该平台覆盖范围内的最大类别,一次查询仍有接近一半到八成的概率什么都搜不到。
零召回是最容易被误读的结果类型。检索工具返回空结果时,使用者通常会理解为「没有相关证据」,而实际上更可能是「这次没搜到」。两者在决策上的后果完全不同:前者会终止一条研究线索,后者只是需要再试一次。
47%至80%这个区间还说明,零召回概率在不同证据类别之间差异很大。研究指出最大证据类别尚且如此,其余类别的情况论文未逐一列出,公开信息中未见完整的分类结果。
研究还发现,某一平台显示出明显的2016年前证据缺口,且证据缺口随平台、证据类别、发表年份与发表载体类型而变化。缺口不是均匀的,因此无法通过固定某一平台的做法系统性规避。年份维度的缺口尤其值得注意:较早的研究若系统性取不到,时间趋势类结论会被截断。
12.0%从未被召回:会议论文的38.9%对期刊的4.6%
把五个平台、15种表述全部跑完之后,仍有12.0%的证据从未被任何平台召回。这部分证据在现有工具条件下等同于不存在,无论换哪个平台、换哪种说法都取不到。
从未召回率在两类载体之间差异悬殊:会议论文为38.9%,期刊论文为4.6%,P<0.001。接近四成的会议论文从未被召回,这在医学与AI交叉领域尤其值得警惕——大量方法学进展与阴性结果首发于会议,若系统性地取不到,证据基础会向期刊已发表内容偏斜。
对药企研发与医学事务而言,这条结论直接关系到文献综述的完整性声明。在现有工具下做出的「未检索到相关证据」,其含义需要被重新定义。
38.9%对4.6%这组对比,本质上是一种发表载体偏倚。当检索系统对会议论文的覆盖明显弱于期刊论文时,任何基于检索输出构建的证据图谱都会向已正式发表的内容倾斜,而会议载体往往承载更早期、更方法学化、也更可能包含阴性结果的材料。
研究未给出五个平台各自对应的具体数字,只报告了区间与对比结果,因此不宜把某一平台单独指认为缺口来源。可以确认的只有整体结论:12.0%的证据在所有平台、所有表述下均未被召回。
冷静观察:证据检索的盲区会直接写进结论,这是流程问题不是模型问题
研究给出的作者结论是:在临床或研究工作流中使用检索增强输出前,应先做领域专用评估。这句话其实把责任从工具方移到了使用方。
盲区的危害在于它是静默的。检索工具不会告知哪些证据没被找到,返回的列表看起来总是完整的,缺口因此被直接写进综述、立项依据与合规文档。这是流程缺陷,不是模型缺陷——换更大的模型或新版本并不能保证缺口闭合。
可行的应对是流程性的:对关键问题强制多表述检索,把单平台结果升级为跨平台交叉验证,对会议论文单独走人工补充通道,并在文档中明确记录检索策略与覆盖范围。已有证据基础的可复现性,取决于这些步骤是否被写进标准操作流程。
对药企研发负责人来说,成本账也要重算。检索环节节省的时间,有一部分会被复核与补充检索吃掉。研究给出的作者结论——使用检索增强输出前应先做领域专用评估——意味着评估本身是一项必须前置投入的工作,而不是可选项。
更长远看,这类盲区不会随模型迭代自动消失。只要检索环节仍依赖外部索引与排序策略,证据缺口的形状就由平台的覆盖范围决定。把「这次用什么工具、用了几种问法」写进方法学记录,可能是当前最现实的防守动作。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
