npj Digital Medicine:EyeSeek面向基层眼病筛查的可弃权大语言模型,真实世界转诊依从性P=0.037
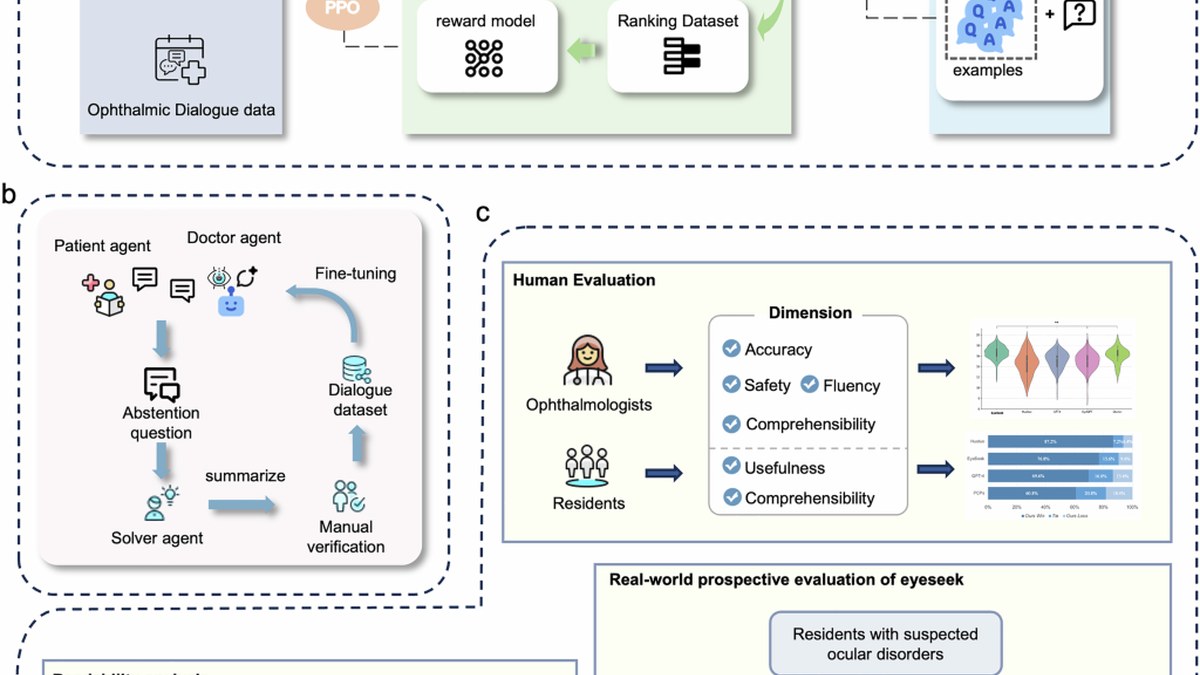
发表于npj Digital Medicine的研究提出面向基层眼保健筛查的专用大语言模型EyeSeek,为居民提供个性化筛查解读与指导。模型引入可弃权驱动的迭代学习框架,通过检测不确定性来判断是否超出知识边界,从而向外部寻求答案以降低幻觉,并配合角色扮演策略实现针对性沟通。专家评估中EyeSeek在多个维度优于若干通用大模型与基层医生;可读性分析显示其回复适配3至8年级阅读水平。单中心前瞻真实世界研究中,辅助组(n=84)转诊依从性高于未辅助组(n=86),P=0.037。
EyeSeek把可弃权写进基层眼病筛查,真实世界转诊依从性P=0.037
影响分析 × 医疗数据从业者 | 数据视角 × 医院信息化/临床医生 | 行业观察
2026年10月5日在线发表于npj Digital Medicine的一项研究,把专用大语言模型放进了基层眼保健筛查这一场景。系统名为EyeSeek,定位是面向基层眼保健筛查的专用大语言模型,为居民提供个性化筛查解读与指导。它与多数同类工作的差别不在答对了多少题,而在工程设计上把一件事放到了最前面:让模型在超出知识边界时选择弃权。
对医疗数据从业者来说,这项工作的价值取向值得注意——幻觉抑制不靠事后过滤,而是把不确定性检测前置到生成之前;对医院信息化与临床一侧,可检验的东西则要朴素得多,目前只有一段真实世界结果:辅助组与未辅助组的转诊依从性差异,P=0.037。
开场:基层筛查缺的不是模型,是敢说不知道的模型
基层眼保健筛查的典型困境,往往不是缺少一个能答题的模型,而是缺少一个在答不上来时肯停下来的模型。EyeSeek的题目描述落在这一处:论文将其定位为面向基层眼保健筛查的专用大语言模型,向居民提供个性化筛查解读与指导,而不是一套泛用问答接口。
研究给出的另一条信息是专家评估结论:EyeSeek在多个维度优于若干通用大语言模型与基层医生。但摘要并未给出这些维度的具体名称与分值,也未给出诊断准确率等量化性能指标,因此专家评估只宜作为方向性结论阅读,不能换算成任何具体数值。
这里有一个容易被忽略的对照关系:被比较的对象里既包括通用大语言模型,也包括基层医生。前者衡量的是领域专用化带来的增益,后者衡量的是相对一线人力的表现。这两类对照放在同一场评估里,说明作者关心的是模型进入真实筛查流程后的位置,而不只是榜单排名。不过摘要没有说明专家人数、评分维度数量与盲法设置,评估的独立性与可重复性都无法据此判断。
可弃权机制:先判断边界,再决定答不答
核心机制是可弃权驱动的迭代学习框架。其逻辑顺序被明确写为:通过检测不确定性来判断是否超出知识边界;一旦判断越界,模型即选择弃权,并向外部寻求答案。作者称该机制可减少幻觉。
这一设计的工程含义在于,把是否回答变成一个可被单独优化的中间决策。模型不必在每一个输入上都强制产出结论,而是先对自身不确定性做出估计,再由估计结果决定是直接作答、弃权,还是转向外部检索。对数据侧而言,这相当于在生成链路中间插入一道闸门;闸门本身的判定质量,决定了后续回答的可信度区间。论文未给出弃权率、弃权判定的准确率或外部求答的命中率,这些数字一概无法从摘要推断。
配合该框架的还有一项角色扮演策略,用于实现针对性沟通。摘要将其列为核心机制之二,但未披露角色设定方式、策略触发条件或与弃权机制的耦合关系。从数据工程的角度看,这两项机制是可以分开度量的:前者决定答不答,后者决定怎么答。论文把它们放在一起报告,却没有给出各自的消融结果,因此无法判断转诊依从性的改善来自哪一侧。
3至8年级的可读性:沟通本身就是干预的一部分
可读性分析给出的结论是:EyeSeek的回复适配3至8年级(Grade 3至8)阅读水平。这个区间是论文中少见的、以量化形式呈现的结果之一。
在基层筛查场景里,可读性不是修辞问题。筛查解读的直接受众是居民,回复若超出受众阅读能力,后续任何指导都难以转化为行动。研究同时报告了两项次要观察:辅助组健康素养改善,用户满意度高。两项均未给出量表名称、评分口径与统计检验结果,因此只能视为方向一致的支持性观察。
把可读性与健康素养放在一起看,这条线索的落点其实在干预链条的上游——模型先要保证自己说的话能被读懂,才谈得上改变行为。
84对86与P=0.037:真实世界那一段怎么做的
真实世界研究为单中心前瞻设计,EyeSeek辅助组84人,未辅助组86人。主要结局是转诊依从性:辅助组高于未辅助组,P=0.037。
需要如实说明的是这段设计的边界。合计170人的样本量很小,P=0.037也只是一个刚刚跨过常规阈值的显著性水平;单中心前瞻设计不足以支撑跨机构泛化。论文未给出两组依从性的绝对百分比、相对提升幅度、置信区间或效应量,因此也无法判断这一差异在临床流程中的实际分量。除此之外,论文未给出诊断准确率等量化性能指标,任何由此反推准确率的做法都没有依据。论文的资助字段自相矛盾,本稿不写资助方。
还有一个判断上的陷阱值得提醒:转诊依从性衡量的是患者是否按建议去做了,不是模型是否判断正确。依从性提高既可能来自解读更清楚,也可能来自沟通更有说服力,二者对临床结局的意义并不相同。研究没有报告两组在最终确诊率或疾病分期上的差异,因此这项结果不能外推为筛查效果的改善。
冷静观察:没有准确率数字,转诊依从性是目前唯一的硬结局
编辑部判断,EyeSeek真正的新意不在又出现了一个医学专用模型,而在把弃权写成了一等公民。幻觉治理的常见路径是事后校验与知识库增强,可弃权框架则把不确定性估计提到了生成之前,这是一条更接近工程可控性的路线,也更便于在部署侧设置兜底策略。
但必须同时看到,这条路线目前的公开证据相当单薄。专家评估只说多个维度更优,无分值;可读性只给3至8年级区间;真实世界只有84对86、P=0.037一项主要结局。样本量小、单中心,且缺少诊断准确率这一类最直观的性能指标,意味着这项研究更适合被读作机制可行性验证,而不是效果确证。
对准备引入这类系统的机构,可操作的落点大致有三处。第一,把弃权率与弃权后的外求命中率作为上线后的必测指标,这两项论文没给,但恰好是部署方最该自己测的。第二,把转诊依从性当作与临床结果并行的一级指标,因为在这个场景里,让人按建议去上级机构复诊,本身就是干预链条上最容易被打断的一环。第三,把可读性检查固化进生成流程,3至8年级这个区间可以作为本地化的参照基线,但它来自英文语境下的年级换算,换成中文场景后需要重新标定。
一句话概括:EyeSeek给出的是一个值得跟踪的机制方向和一项刚刚显著的结局,离可复制的部署结论还有相当距离。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
