npj Digital Medicine:EpiScreen用病历文本早筛癫痫,私有队列AUC 0.980,人机协作优于专家14.3%
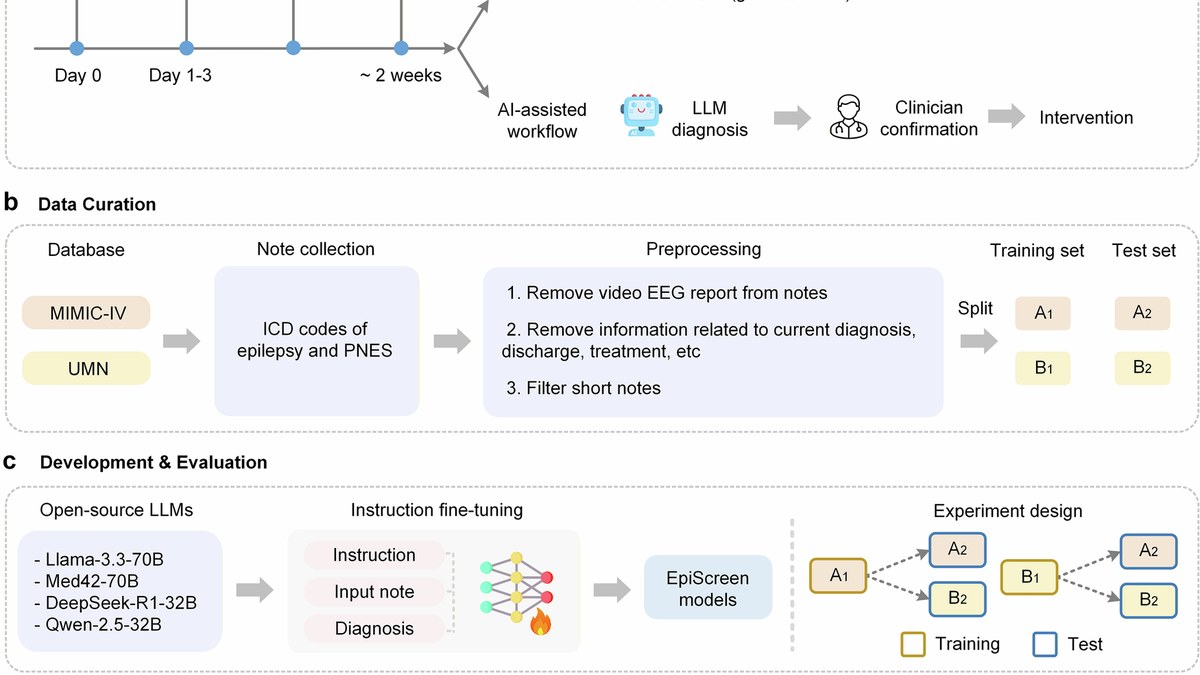
npj Digital Medicine于2026年10月8日在线发表EpiScreen:一个通过微调大语言模型、利用电子病历中常规采集的临床记录做癫痫早期识别的方法。在MIMIC-IV数据集上AUC达0.875,在明尼苏达大学的私有队列上达0.980;在医师与AI协作的场景下,获得辅助的神经科医师表现优于未获辅助的专家至多14.3%。
0.875与0.980之间:常规病历里的癫痫早筛走到哪一步
数据视角 × 医院信息化/临床医生 | 影响分析 × 医疗数据从业者 | 深度研报
2026年10月8日,npj Digital Medicine在线发表EpiScreen:一套利用电子病历中常规采集的临床记录文本做癫痫早期识别的方法,路线为在标注病历上做的大语言模型微调。论文报告,在MIMIC-IV数据集上AUC为0.875,在明尼苏达大学私有队列上AUC为0.980;在医师与AI协作场景中,获得辅助的神经科医师优于未获辅助的专家至多14.3%。
三个数字分属三层证据,排不成一条上升曲线。0.875与0.980之间0.105的落差,在判别类模型上足以改变结论的适用范围,必须当作分布差异讨论,而不是当作性能上限引用;14.3%是论文给出的上限值,且绑定在特定协作设置里;整套方法的定位是低成本早筛,与长程视频脑电不构成等量关系。
开场:两种发作长得像,走下去却是两套路径
癫痫发作与心因性非癫痫发作在外观上高度相似,都可能表现为意识改变、肢体抽动与发作后困倦,此后却是两条完全不同的路径。前者需要抗癫痫发作药物与长期随访,后者需要精神心理方向的评估与干预。误判朝哪一边,代价都由患者承担:一边是不必要的药物暴露,一边是治疗延迟与持续的发作损伤风险。
论文把误诊归为三类后果:诊断延迟、不必要治疗与由此产生的患者损害。难点在于两类发作的鉴别高度依赖发作期电生理证据,而这类证据在首诊现场通常拿不到。
现有金标准是长程视频脑电监测(video-EEG),同步记录脑电与视频,捕捉一次真实发作并判断是否存在癫痫样放电。它的成本高、床位与设备占用大、可及性有限,难以覆盖全部疑似病例,也难以在资源受限地区铺开。缺口正是EpiScreen要填的位置:能不能用已经在病历里的文字,先做一次便宜的风险分层。
常规病历文本里到底有什么信息
吸引力在输入侧。EpiScreen用的不是新做的检查,而是电子病历中常规采集的临床记录文本:首诊与急诊记录里对发作过程的描述、既往史与既往检查结果等叙述性内容。它们已经在系统里,无需追加费用、排期或额外设备配合。
代价是信息的性质。这类文本由不同书写者在不同压力下写就,详略不均、用语不统一,混杂主观描述与模板化措辞;它记的往往是他人转述的发作现场,而非发作期的电生理信号。模型能学到的上限,取决于文本与结论之间的关联强度。
方法上,论文描述为对标注病历做的大语言模型微调。这里有一个必须先排除的变量:标签由谁给出、以什么为判定依据,摘要未给出。若标签来自临床医师的最终诊断而非视频脑电的确证,误诊本身就会被写进监督信号,模型学到的是书写习惯与诊断结论之间的相关性,其中包含了被记录的错误。这一点决定了后面两个队列的结果怎么读。
0.875与0.980:两个队列的落差该怎么解释
两个AUC落在性质不同的队列上:公开数据集MIMIC-IV上为0.875,明尼苏达大学私有队列上为0.980,落差0.105。
这个跨度首先要作为分布差异处理,而不是性能区间的两端。可能的原因至少有三组。其一是数据集性质不同,一个偏公开、多机构、重症监护场景的记录集合,另一个是单一机构的私有队列,记录规范与文本长度分布不一致。其二是病例构成不同,入组口径、目标疾病患病率、纳入者的病情谱若有差别,AUC就会移动,而两者的入组标准摘要均未给出。其三是标注来源不同,两个队列的标签是否出自同一流程、同一批复阅者,摘要未给出。
因此合理的读法是:0.980描述模型在更接近目标部署环境的单一机构数据上的表现,0.875是它在异质公开数据上的表现,两者之差提示模型对数据环境的依赖程度。只引用0.980而略去0.875,会系统性高估它在医院信息科真实数据上的起点。
还要补指标本身的限定。AUC是对全部阈值上判别能力的整体度量,不等于某个工作阈值下的灵敏度与特异度,更不等于阳性预测值;若疑似发作人群中的真实患病比例不高,即便AUC处在这样的水平,筛查阳性者中的真阳性比例仍可能偏低。
优于专家14.3%:协作是怎么设计的
人机协作部分要逐字读:医师与AI协作场景下,获得辅助的神经科医师优于未获辅助的专家至多14.3%。
至少三重约束。第一,14.3%是上限值,不是平均提升幅度,实际增益的分布区间摘要未给出。第二,对照主体是特定的协作设置:AI以何种形态介入、给出的是分值还是可读依据、医师在什么时点看到它,这些细节摘要均未给出,脱离这套设置谈数字没有意义。第三,被比较的专家如何界定、评估指标是准确率还是别的口径,摘要未给出。
可由此得出的结论是有限的:在论文设定的协作方式下,辅助带来的改善可以达到14.3%的量级。它不能被转述为AI优于专家,也不能推广为一般性的效率增益。对医院信息化而言,真正决定落地效果的恰是摘要没写的部分:输出以什么形态出现在哪一环、谁为最终判断签字、误报如何处理。
冷静观察:早筛工具与金标准之间,位置要摆正
先把没有的部分列清楚。未见前瞻部署结果,也未见多中心、跨机构的前瞻验证;未见不同电子病历厂商与记录模板之间的可迁移性测试;未见儿童、老年人及合并症人群的亚组结果;未见两个队列的基线表、患病率与入组标准;未见工作阈值、校准曲线、置信区间与混淆矩阵;未见标注来源与质量控制说明;未见成本效果分析与工作流可用性研究;也未见任何监管许可路径。
因此正确的表述是:EpiScreen是一条低成本的早期筛查候选路径,作用是在资源受限场景中把有限的视频脑电资源优先分配给最需要的人。它不能被表述为可以替代金标准的确证地位,也不是避免误诊的手段;筛查之后的确诊路径仍要回到长程视频脑电。
务实的判断是:这条路线证明了常规病历文本里确实含有可被大语言模型提取的鉴别信号,值得在多队列上继续验证,但它目前支撑的用法是分诊与提示,不是诊断。把0.980当作通用性能,是把验证环境的优势记到了方法头上。
接下来该追问的是四件事。其一,两个队列的基线特征表、入组标准与患病率能否公开,以量化0.105的落差究竟来自数据分布还是标注流程。其二,14.3%对应的评估指标与协作界面细节是什么,换个界面能否保持。其三,前瞻、多中心、跨厂商的外部验证何时落地,换个记录规范是否需要重新微调。其四,若走向监管审批与医院采购,既定阈值下的灵敏度、特异度与成本效果数据以什么形态提交。这四件事没有答案之前,EpiScreen应被理解为一份有价值的早筛信号,而不是一张可以直接接入门诊的方案。
千方医数集编辑部 出品
