npj Digital Medicine:ClinicalGPT审计84.7万份医嘱,漏警率每千份3.2次对纯规则9.4次
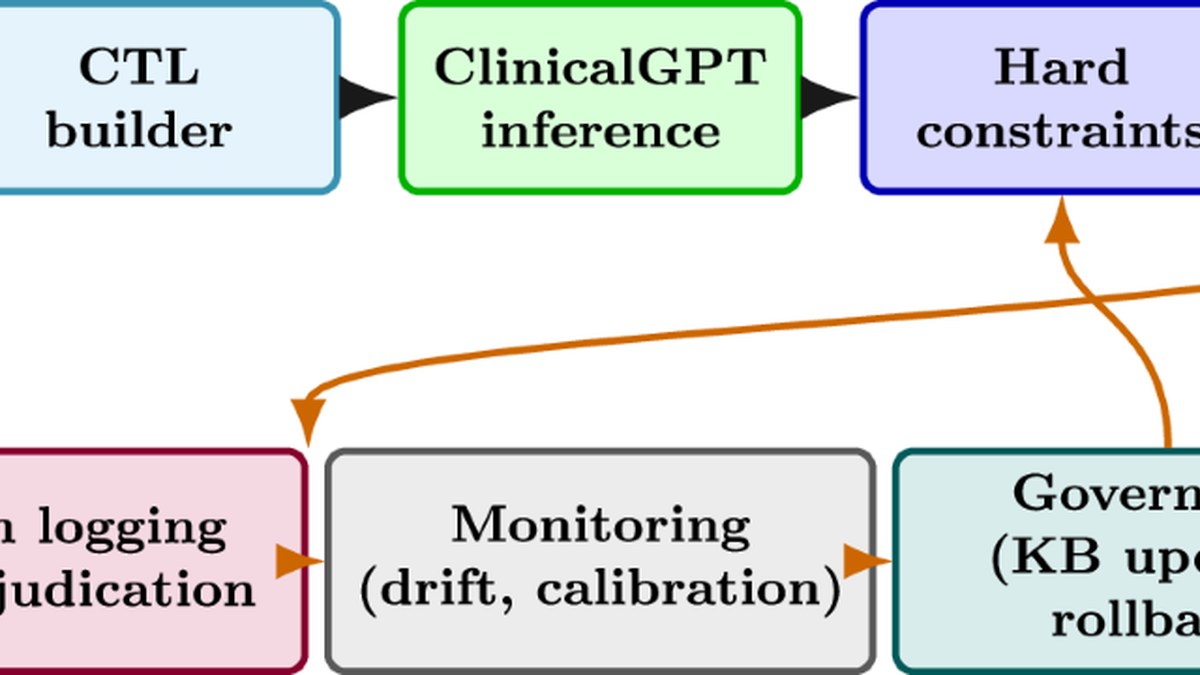
npj Digital Medicine于2026年10月8日在线发表审计就绪的病历基础模型ClinicalGPT。在7家医疗系统、847000条高危医嘱的回顾性评估中,开单时「应告警而未告警」率为每千份3.2次,低于纯规则的9.4次与最强LLM对照的4.8次;假警报率同时由38.7降至33.9。作者明确声明未测量后续临床处置与患者伤害。
每千份医嘱少漏6.2次警报,但这条链路到患者结局就断了
数据视角 × 医院信息化/临床医生 | 影响分析 × 医疗数据从业者 | 深度研报
2026年10月8日,npj Digital Medicine在线发表一项针对病历基础模型ClinicalGPT的审计评估。研究覆盖7家医疗系统、847000条可评估的高危医嘱,测的不是模型答对多少道题,而是开单那一刻该响的警报有没有响:ClinicalGPT加硬约束之后每千份医嘱漏警3.2次,纯规则系统为9.4次。作者同时明确声明,研究未测量后续临床处置、药物不良事件与患者伤害。
对医院信息化部门与临床科室来说,这意味着一份可量化的过程改良,而不是一份用药安全结论。前者能直接写进采购评估表,后者目前没有任何数据支撑。
开场:84.7万条医嘱,看的是该响的警报有没有响
把评测对象定在漏警而不是准确率,是一项有意识的选择。用药决策支持系统的价值不在它输出了多少条建议,而在真正危险的那几条有没有被拦下。847000条高危医嘱构成的分母,让每千份这个口径变得有意义:基数足够大,千分位上的差异才不至于被随机波动吞掉。
这条赛道此前的主角是规则引擎。规则写得出明确的相互作用与剂量上限,却写不出病历里的上下文,于是医院端长期面对两个方向的抱怨:该响的没响,不该响的响个不停。ClinicalGPT的定位是在病历语料上训练的基础模型,再叠加一层硬约束,让不可协商的规则仍然由确定性逻辑兜底。
还有一个容易被忽略的口径是时间点。漏警被定义在开单那一刻,评估的是系统在医师按下确认之前给出的提示。药师复核、护士执行环节拦下来的用药问题,都不在这个指标的视野之内。
设计边界要提前说清:这是回顾性评估加单中心静默前瞻,不是随机对照试验。静默意味着模型输出没有真正进入临床流程,医师看不到它,也就没有任何一次真实的干预发生。
3.2对9.4:比纯规则少漏六成
四组数字应当放在一起读。ClinicalGPT加硬约束为每千份3.2次漏警,纯规则为9.4次,原版通用大语言模型对照为6.1次,最强对照(检索增强加大语言模型加规则)为4.8次。ClinicalGPT优于全部对照,包括那套把三种方法叠起来的组合。
降幅要分两个参照系来看。相对纯规则,每千份少漏6.2次,降幅约六成;相对最强的4.8次,只少1.6次,降幅约三分之一。对照越强,留给改进的空间越薄,这是评估类研究常见的形状,也提示不要把六成这个数单独摘出来用。
6.1与3.2之间的落差也可以单独读:同一个通用模型,经病历语料训练并叠加硬约束之后,漏警从6.1降到3.2。这说明改进来自两部分叠加,论文没有给出分项拆解,因此无法判断领域训练与硬约束各自贡献了多少。
3.2次的绝对值同样不能忽略。换算过来,大约每313份高危医嘱就有1次应当告警而系统没有告警。对单个医师而言这可能是几个月才遇上一次,但按847000条医嘱的规模推回去,它对应的是一个不小的绝对计数。
33.9的假警报:降了,但还是很高
同一个系统的假警报率为33.9,95%置信区间31.6至36.3,纯规则为38.7。改进确实发生了,幅度约4.8个百分点。但33.9意味着大约每三次警报里就有一次是空的,离可接受还有明显距离。
置信区间本身也值得留意。31.6至36.3的跨度接近4.7个百分点,而纯规则的38.7未给出区间,两者之间缺少重叠检验,这次下降在统计上的确定性因此要打一折扣。
更要紧的是漏警率没有给出置信区间。3.2、9.4、6.1、4.8四个数被并列呈现,读者却无从判断它们彼此的差异是否稳定。漏警与假警报必须同框,只讲改进会让结论失真。
放到临床现场,假警报率决定的是医师的覆盖行为。警报可信度不足时,医师会养成顺手关掉的习惯,此时无论漏警降到多低,都难以转化为实际拦截。本研究没有测量覆盖率,这恰恰是两者之间缺失的一环。
参考标准先冻结:这一步防的是什么
论文写明,参考标准向量在最终打分之前冻结。这一步防的是最常见的自评偏差:先看到系统的输出,再回头调整判定标准,最后用调整过的标准给自己打分。标准一旦冻结,评分过程就变成单向,结果才具备可复现性。
这也是审计就绪这个定位的实质。它的目标读者不是模型排行榜,而是需要追责链条的院内质审与外部监管:谁定的标准、什么时候定的、依据哪个版本、能否重跑一遍。
对医疗数据从业者来说,难点在工程而不在算法。标准向量的版本化、冻结时点的留痕、跨机构迁移时的口径对齐,决定了这套方法能否在第二个院区复现。目前缺少跨平台的外部验证,7家医疗系统之外表现如何仍是未知。
冷静观察:这是过程指标,离患者结局还隔着一层
先把没有的部分列出来。后续临床处置未测量,药物不良事件未测量,患者伤害未测量,三项都是作者自己声明的;漏警率的置信区间未披露;跨平台外部验证缺失;单中心静默前瞻部分没有触发任何真实干预,因而也没有干预之后的任何结果数据。
因此正确的表述是:ClinicalGPT在这个离线评测中改善了告警的过程指标。不能写成它减少了医疗差错,更不能写成它挽救了生命。从漏警率下降到处方真的被修改,再到不良事件减少,中间隔着医师是否看见、是否采信、是否改动医嘱、改动是否确实更优四道环节,本研究一道都没有测。
接下来该追问的是四件事。其一,漏警率与假警报率的置信区间以及逐层亚组结果需要补齐,否则3.2与4.8之间的差距无法判定是否稳定。其二,需要一个非静默的真实前瞻,把医师覆盖率与医嘱修改率接进证据链。其三,跨平台外部验证要在不同厂商的电子病历系统上重跑,检验冻结标准向量的口径能否迁移。其四,成本账同样缺席:把33.9的假警报放进真实工作流,医师额外付出的复核时间是否抵消掉漏警下降的收益,这个平衡点在研究中没有任何位置。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
