npj Digital Medicine:B-RAD乳腺超声多模态检索增强模型,7国11队列8311图验证,活检分流AUROC 0.952
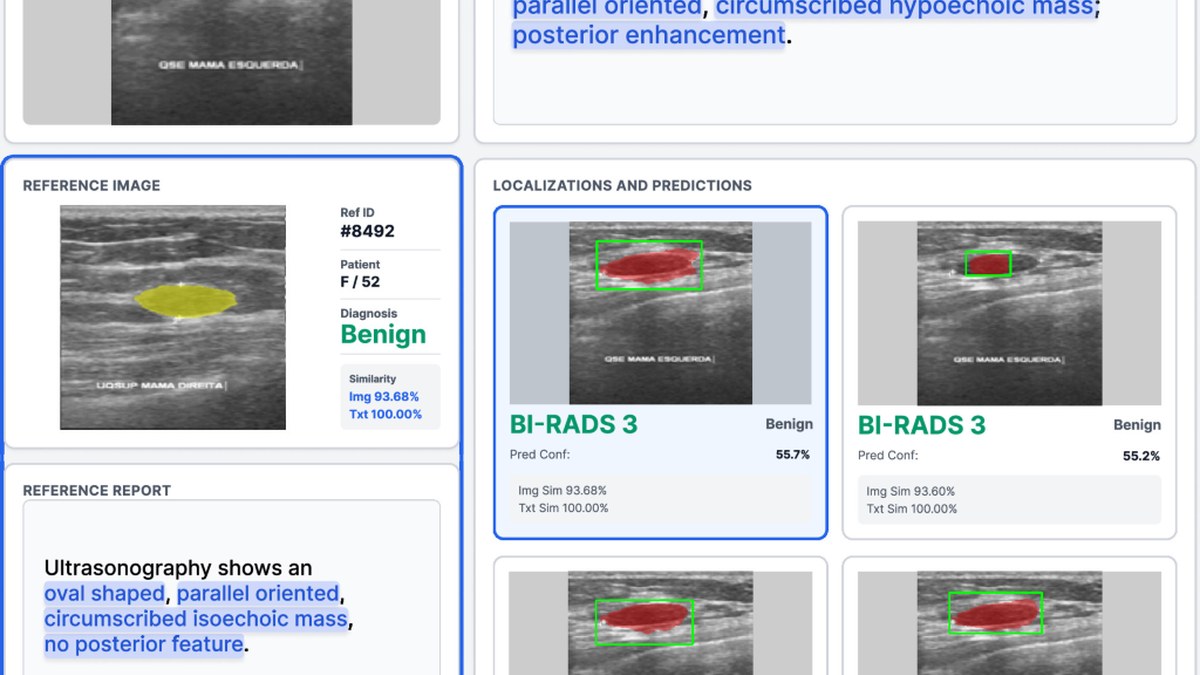
发表于npj Digital Medicine的研究提出面向乳腺超声的可解释多模态检索增强诊断模型B-RAD,汇总7个国家11个队列共8311幅图像进行多国临床验证。模型采用BI-RADS感知的检索增强架构,从未配对数据中学得跨模态对齐,在活检分流任务上AUROC达0.952——该数值来自单一独立机构队列且未经微调,不代表11个队列的平均水平。四名阅片者参与的研究显示,阅片者间一致性(inter-reader agreement)由moderate提升至substantial,所有阅片者的恶性漏诊均下降。共同第一作者为Han Jang与Subin An,通讯作者为韩国国民大学Soochahn Lee与首尔大学医院Kyu Sung Choi。四位作者为待审韩国专利10-2026-0096895的发明人。
不训练更大的模型,B-RAD给乳腺超声配了一套会检索的参考系
事实报道 × 医院信息化/临床医生 | 数据视角 × AI技术供应商/创业者 | 深度研报
2026年10月3日,npj Digital Medicine 在线刊出韩国团队的 B-RAD 研究:面向乳腺超声的可解释多模态检索增强诊断框架。它不给模型扩容,而是配一套先检索相似病例、再定位与分类的机制,并在7国11队列8311幅图像与四名阅片者的研究中完成验证。
开场:8311幅图、7个国家,先问数据从哪里来
乳腺超声是乳腺癌诊断的核心手段,但它有一个结构性难题:乳腺影像报告与数据系统(Breast Imaging Reporting and Data System,BI-RADS)的评估存在显著的阅片者间差异。既有深度学习模型能给出判断,却难以解释;多模态大语言模型被寄望于用报告式推理补上可解释性,然而配对的图像与报告数据稀缺,视觉与语义的对齐始终偏弱。B-RAD 的出发点正是这个断点。
验证数据的构成如下:
| 项目 | 内容 |
|---|---|
| 队列数 | 11个 |
| 覆盖国家 | 7个 |
| 图像总数 | 8311幅 |
| 验证层次 | 内部验证 + 三个外部队列 |
| 独立机构队列 | 包含其一,AUROC 0.952 来自此处 |
把规模与指标分开看很重要:11个队列与7个国家说明的是覆盖广度,不代表每个队列都跑出了同等水平。论文为在线优先的 accepted article preview 版本,正式版措辞可能调整。
检索增强怎么做:先找相似,再下判断
B-RAD 是 BI-RADS 感知的检索增强框架,其流程刻意模仿放射科医生的工作方式:检索范例、定位病灶、判定 BI-RADS 类别。三段动作对应三个模块。
检索模块从未配对数据中学习跨模态对齐,做法是同时最小化跨模态错配与序数预测误差——前者让图像与语义靠近,后者让排序关系贴近 BI-RADS 的等级结构。这一步是整套设计的关键:它不依赖成对的图像与报告,因此不必受限于配对样本的规模。
检索到的范例随后引导病灶的少样本检测,一并检出病灶的边缘特征与后方声学特征。检测出的区域再提示分割模型,其生成的掩码驱动一种无需训练的中央凹注意力(foveal attention)机制完成分类。整条链路的输出是可追溯的:每一个判断背后都有被检索出来的相似病例作为参照,这构成了该研究所谓可解释性的实际载体。
对技术供应方而言,这套架构把竞争要素从模型规模部分转移到了检索库本身。范例库的来源、规模、标注质量与更新机制直接决定检索结果,进而影响最终分类;可复用的核心资产因此是一套经过整理的历史病例库,而这类库的可得性在不同机构之间差异极大。这也解释了为什么从未配对数据学习对齐这一步如此关键——它降低了构建检索库时对成对标注的依赖。
AUROC 0.952的边界:单一队列、未经微调
唯一被明确给出的性能指标是活检分流任务的 AUROC 0.952。它的限定条件必须完整写出:
- 该数值来自单一独立机构队列,不是11个队列的平均或整体表现;
- 模型在该队列上未经微调(without fine-tuning)就已取得该结果;
- 取得该数值的是完整流水线(full pipeline),而非其中某个子模块;
- 对应任务是活检分流,不是 BI-RADS 分级或其他终点;
- 论文称其优于既有视觉语言模型(vision-language models)。
未经微调这一点其实比0.952这个数本身更值得注意:它意味着跨机构迁移时没有针对目标机构的数据做适配,属于更接近真实落地场景的检验方式。但反过来,单一队列也意味着这个数字缺乏跨机构的离散度信息,无法判断它在其余队列中会落在什么区间。
本次未获取到该指标或相关指标的置信区间、灵敏度与特异度,因此不做任何反推与估算。
阅片者研究:一致性上去,漏诊下来
比指标更能说明临床价值的是四名阅片者参与的研究。结果三项:
| 观察项 | 结果 |
|---|---|
| 阅片准确度 | 在 B-RAD 辅助下提升 |
| 阅片者间一致性 | 由 moderate 提升至 substantial |
| 恶性漏诊 | 所有阅片者均下降 |
需要准确表述的是,论文原文写的是阅片者之间的一致性(inter-reader agreement)提升,而非人机一致性。对乳腺超声这种主观性较强的模态,把不同经验水平的阅片者拉向同一判断区间,其临床含义往往高于单点准确率的提升——它直接关系到患者会不会因为换一位医生而得到不同的随访建议。所有阅片者的恶性漏诊均下降,是这项研究里最硬的一条结论,但同样未附带具体数值。
冷静观察:多国数据解决了泛化,但专利与作者结构决定了它离产品还有距离
这项工作在证据组织上是克制的:多国多队列解决的是泛化性质疑,四名阅片者的研究补上了纯指标无法覆盖的临床可用性。但把它读成产品前夜的信号则为时过早。
第一道门槛是知识产权。论文披露,Han Jang、Subin An、Soochahn Lee 与 Kyu Sung Choi 四位作者是待审韩国专利申请(申请号10-2026-0096895)的发明人,该申请由国民大学产学合作基金会与首尔大学医院提交,覆盖的正是本文所述的端到端 B-RAD 流水线——从多模态检索到病灶定位与 BI-RADS 分类。共同第一作者为 Han Jang 与 Subin An,通讯作者为韩国国民大学 Soochahn Lee 与首尔大学医院 Kyu Sung Choi,工程侧与临床侧各占一端。作者结构与专利范围共同说明:这是实验室成果,不是可自由实施的技术。
第二道门槛在许可。该文为开放获取,但采用 CC BY-NC-ND 4.0 许可,即允许非商业性使用与传播,禁止演绎作品的再分发。这意味着任何商业化改造都需要另行取得授权。研究经费来自韩国国家研究基金会、首尔大学医院研究基金、韩国保健产业振兴院等多个渠道。
还有一个方法论层面的遗留问题:论文摘要未报告各外部队列的单独表现,也未提供分层人群的表现差异。多国数据证明了覆盖面,但覆盖面不等于稳定性。考虑到本文仍是 accepted article preview,正式版若补充队列级细节,评估结论可能需要相应调整。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
