npj Digital Medicine:7家医院2040例二次肺切除,5变量MARS模型预测顽固性低氧,验证AUROC 0.750至0.782
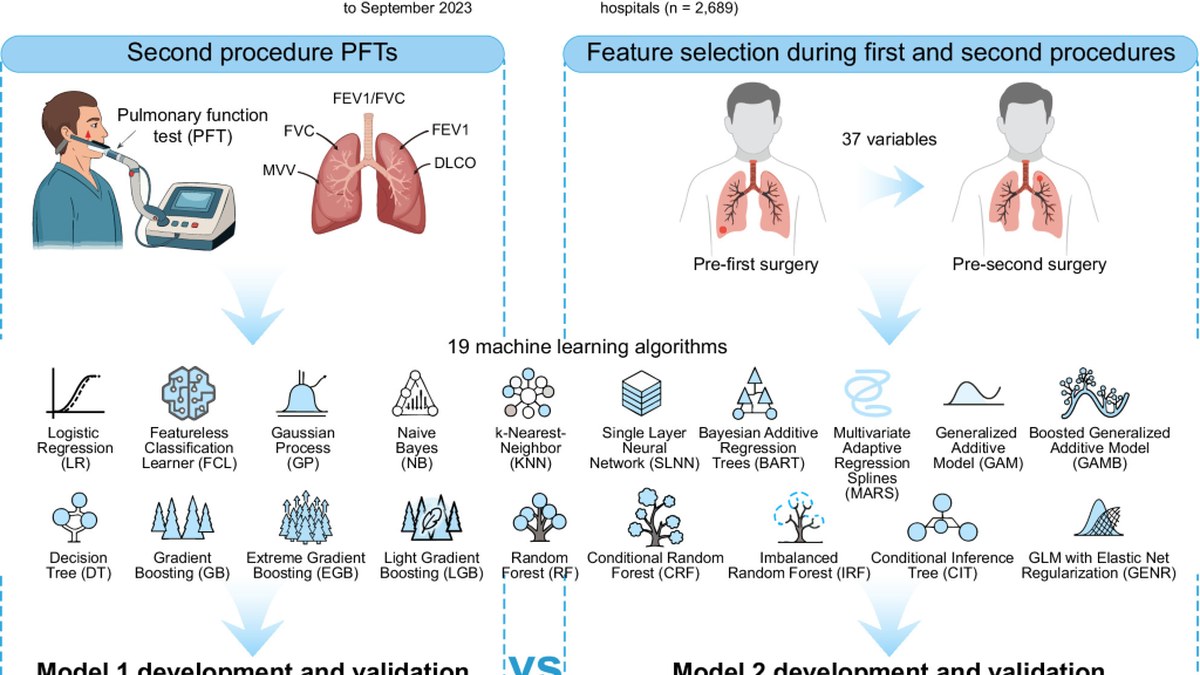
发表于npj Digital Medicine的多中心回顾性研究纳入中国7家医院2013至2023年2040例二次肺切除患者,比较19种机器学习学习器并结合包装式特征选择建模,用术前与第二次术前两个时间点的围术期数据预测单肺通气期间的顽固性低氧。该并发症发生率为15.4%。仅用肺功能检查的模型表现不足(训练队列AUROC<0.6、AUPRC<0.2);最终5变量多元自适应回归样条(MARS)模型在训练队列AUROC达0.790,三个验证队列分别为0.750、0.765与0.782。
2040例二次肺切除:5变量MARS模型预判顽固性低氧,验证AUROC 0.750至0.782
趋势前瞻 × 医院信息化/临床医生 | 数据视角 × 医疗数据从业者 | 深度研报
2026年9月29日在线发表于npj Digital Medicine的一项多中心回顾性研究,把术前预测的对象对准了一个相当具体的术中事件:二次肺切除患者单肺通气期间的顽固性低氧。研究纳入中国7家医院2013至2023年的2040例患者,比较19种机器学习学习器并结合包装式特征选择建模,最终落在了一个5变量的多元自适应回归样条(MARS)模型上。
结论层面有两处值得临床侧注意。一是发生率:这一并发症在队列中为15.4%,不算罕见。二是那条基线对照:仅用肺功能检查(PFT)的模型表现不足,训练队列AUROC低于0.6、AUPRC低于0.2。也就是说,现有最常用的术前评估手段,在这件事上提供的区分能力有限。
开场:15.4%的发生率,和一份测不准的肺功能报告
二次肺切除(RPR)患者是胸外科里的一类特殊人群:已经接受过一次肺切除,面临第二次手术。单肺通气是这类手术的常规通气方式,而顽固性低氧是其间最棘手的并发症之一。
研究给出的发生率是15.4%。这个数字的意义在于它足够高,高到值得在术前专门做一次风险分层;同时又不够高,低到如果给所有人都按高风险准备,会造成明显的资源浪费——这正是预测模型的用武之地。
而对照组的表现说明问题确实存在:仅用肺功能检查建模时,训练队列AUROC小于0.6、AUPRC小于0.2。这是一条重要的否定性结果,它把「肺功能检查不够用」从临床印象变成了可引用的量化事实。
2040例与两个时间点:数据是怎么组织的
数据来自中国7家医院,时间跨度为2013至2023年,共2040例二次肺切除患者。设计是多中心回顾性研究。
建模所用的不是单一时点的数据,而是术前与第二次术前两个时间点的围术期数据。这个设计对应二次肺切除的临床现实:患者在两次手术之间肺功能已经发生过一次改变,只用第一次术前的资料,等于丢掉了最能反映当前状态的那部分信息。
最终模型整合了双时间点CT衍生的体积学特征与临床特征。摘要未列出这5个变量的具体名称,也未说明CT体积学特征的提取方式与软件来源,因此无法复现特征工程,也无法判断其中临床特征与影像特征各占几席。
19个学习器筛到5个变量:MARS为什么胜出
建模流程分两步。第一步是比较19种机器学习学习器;第二步是结合包装式特征选择做变量筛选。最终胜出的是5变量多元自适应回归样条(MARS)模型。
摘要没有逐一列出19种学习器的名称与各自表现,因此无法判断MARS是全面领先,还是在特定指标上占优。但从结果形态上可以作出一个克制的技术解读:MARS属于可解释性较强的模型族,其输出是分段线性基函数的组合,临床医生可以逐项查看每个变量的贡献区间。在一个只有5个变量的最终模型里,这种可解释性是有实际意义的——它让模型有机会进入术前讨论,而不是停留在评分工具层面。
需要说明的是,摘要未给出特征选择的具体搜索策略、交叉验证方案与超参数设置,也不涉及各学习器的调参深度,所以「MARS为什么胜出」这个问题目前只有一个结果,没有机制层面的答案。
0.790到0.750:训练与验证之间的落差
性能数字必须整组呈现,单引任何一个都会失真。
| 队列 | AUROC | AUPRC | 基线发生率 |
|---|---|---|---|
| 训练队列 | 0.790 | 0.445 | 0.133 |
| 验证队列一 | 0.750 | 0.641 | 0.349 |
| 验证队列二 | 0.765 | 0.529 | 0.173 |
| 验证队列三 | 0.782 | 0.473 | 0.180 |
训练队列AUROC为0.790,三个验证队列分别为0.750、0.765、0.782。落差确实存在,但幅度不大,最低的0.750与0.790之间相差4个百分点,说明模型没有出现明显的过拟合塌方。这一点对多中心回顾性数据而言并不常见,值得肯定。
真正跳动得厉害的是AUPRC:0.445、0.641、0.529、0.473。四个数字横跨近20个百分点,而它们的排列顺序与AUROC的顺序并不一致——AUPRC最高的0.641出现在AUROC最低的0.750那一组。
原因在于AUPRC与基线发生率强相关。四个队列的基线发生率分别为0.133、0.349、0.173、0.180,训练队列最低(0.133)而验证队列一最高(0.349)。基线发生率越高,同样区分能力下的AUPRC就会越高。因此只看0.641,会把模型在一个发生率异常高的队列上的表现误读为整体性能;只看0.445,又会低估它在高发队列中的表现。正确的读法是把两者并置,并承认跨队列的AUPRC不可直接比较。
研究还报告校准可接受,决策曲线分析显示正向净获益。摘要未给出校准曲线斜率、Brier分数或决策曲线的阈值区间。
冷静观察:AUPRC跳动得厉害,因为它跟着基线发生率走
编辑部认为,这项研究最值得被同行记住的,恰恰是那组不整齐的AUPRC数字,以及它与基线发生率的对应关系。多中心验证报告里常见的做法是挑最好的那个数字写进结论,而这里的四个AUPRC之所以从0.445跳到0.641,几乎完全可以由基线发生率解释。把它如实列出来,比挑一个漂亮数字更有价值。
对临床侧,务实的位置大概是这样:AUROC稳定在0.750至0.782,配合可接受的校准与正向净获益,说明这个5变量模型具备进入术前评估流程讨论的资格;但作者自己也明确指出结论待前瞻性验证,回顾性设计与单一国家来源决定了外部泛化性尚未在研究中验证。七年跨度、七家中心带来的异质性,既是这项研究的优势,也是它无法自证的部分。
对数据侧,还有一条提醒:训练队列基线发生率0.133,与三个验证队列中的两个(0.173、0.180)接近,却与另一个(0.349)相差悬殊。这组差异提示各中心在病例构成或结局判定上并不一致,而在回顾性数据里,这类不一致往往无法追溯。任何后续复现工作,都应先把发生率对齐这件事做清楚。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
