npj Digital Medicine:21.9万例CKM综合征住院患者建模,8变量XGBoost预测三年死亡,高危组HR达9.62
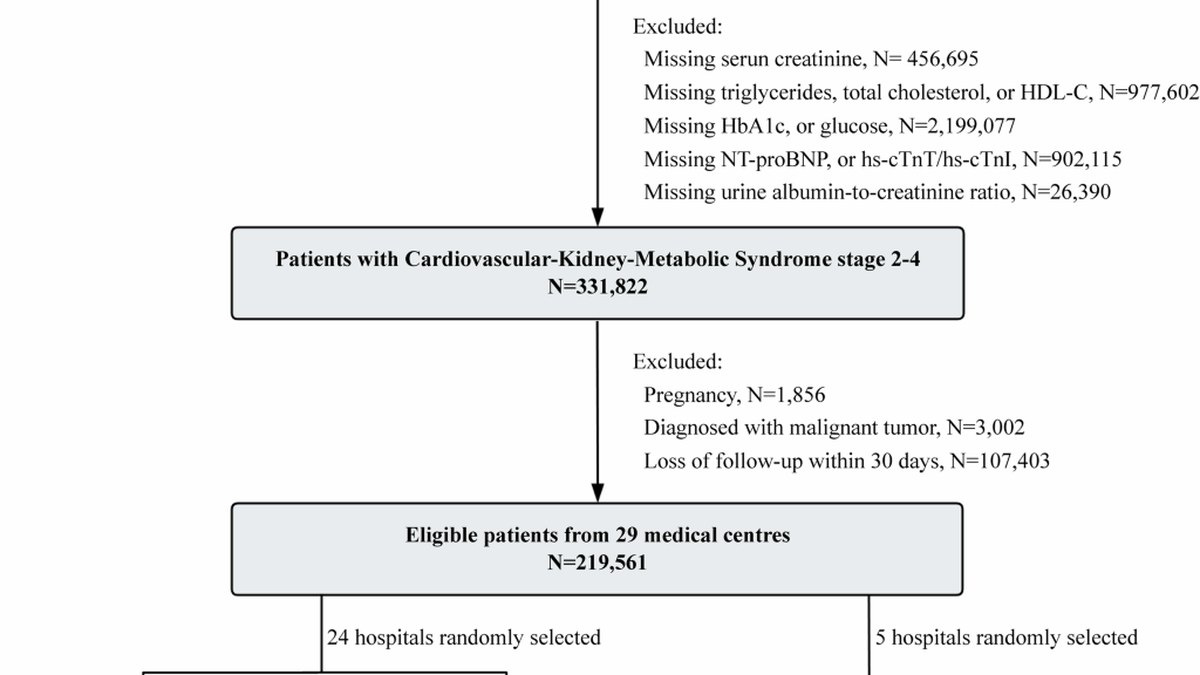
发表于npj Digital Medicine的研究基于心血管-肾脏-代谢(CKM)综合征2至4期住院患者219,561例、来自29家医疗中心的数据,构建三年死亡风险机器学习模型。数据集拆分为推导队列132,404例、内部验证56,744例、中心层面验证30,413例。研究从101个候选变量建模,最终以8变量XGBoost模型表现最优,优于LASSO。三组的AUC分别为0.831、0.826、0.813。按模型分层后,高危组相对低危组的三年全因死亡HR为9.62(95%CI 8.86-10.45),心血管死亡HR为12.53(95%CI 10.97-14.31)。研究附网页版风险计算器,通讯作者为聂晟、董骏武、魏红兰,机构为武汉市第四医院肾内科与南方医科大学南方医院肾内科。
101个变量筛到8个:一张能贴在病历首页的CKM三年死亡风险表
趋势前瞻 × 医疗数据从业者 | 数据视角 × 医院信息化/临床医生 | 深度研报
2026年10月2日,npj Digital Medicine 在线刊出中国团队研究:为心血管-肾脏-代谢(Cardiovascular-Kidney-Metabolic,CKM)综合征2至4期住院患者构建三年死亡风险模型。研究纳入29家中心219,561例,从101个候选变量收敛到8变量 XGBoost,并附网页版风险计算器。
开场:一个横跨心、肾、代谢的诊断框,缺一个能用的风险尺
CKM 综合征把心血管疾病、慢性肾脏病与代谢紊乱放进同一个框架,其临床价值在于承认这三类病变互为因果、共同推高死亡风险。论文给出的前提是:CKM 综合征与高死亡风险相关,但准确的个体化风险预测手段仍然有限。
这句话点出了真实缺口。住院患者的决策窗口很短,医生需要的是在现有病历字段上就能算出、不需要额外检查的评分,而不是再开一批化验。从这个角度看,变量个数本身就是产品指标:8个变量意味着这张表有可能被嵌进电子病历,在医生打开病历时自动算完。研究也确实配了网页版风险计算器,用于推动临床应用。
数据基础来自中国肾脏数据系统(China Renal Data System,CRDS),参与单位被致谢为各区域中心医院。这是本批十条里唯一一篇中国团队论文,其意义在于用国内多中心的真实住院数据完成了一次大样本建模,而不是在方法上有什么新发明。
21.9万例怎么拆:推导、内部、中心层面三道关
219,561例被切成三份,分别对应三种不同的检验强度:
- 推导队列132,404例:模型在这里被训练与筛选,是性能数字最高的地方,也是最容易乐观的地方;
- 内部验证队列56,744例:用于检验模型在同一数据分布内的稳定性,回答的是换一批同来源患者还行不行;
- 中心层面验证队列30,413例:按医疗中心划分,检验的是换一家医院、换一套检验设备与记录习惯之后还行不行,这是三道关里最接近真实部署场景的一道。
样本量足以支撑细粒度建模,这一点没有疑问。但三份数据的来源结构是同一套系统、同一类住院患者,它们之间的差别主要体现在中心与患者构成,而不是人群性质。因此三组结果的落差,读法应当是跨机构稳定性,而不是跨人群外推性。
101个变量到8个:LASSO输在哪一步
研究在推导队列中用101个变量分别构建 XGBoost 与最小绝对收缩与选择算子(Least Absolute Shrinkage and Selection Operator,LASSO)模型,结论是8变量 XGBoost 模型持续优于 LASSO 模型。
需要克制的是因果表述。论文报告的是性能排序,并未对两种方法为何产生差异展开机制分析,因此可以确定的是XGBoost在这批数据上表现更好,而不是XGBoost为何更好。在公开信息范围内,可以确认的只有三点:一是建模起点为101个候选变量,二是最终选出的模型只保留8个变量,三是该模型的表现优于同研究中的 LASSO 模型。变量筛选的具体路径、8个变量分别是什么,摘要未给出。
对数据从业者来说,从101到8这一段是整个研究里最值得琢磨的工程动作。候选变量越多,缺失值处理、编码一致性与中心间口径差异的负担就越重;压到8个变量,等于把跨中心数据 harmonization 的成本大幅压缩。这也解释了一个隐含的取舍:模型愿意牺牲一部分信息量,换取在29家中心之间可复现。
HR 9.62与AUC 0.831各说的是哪件事
这两组数字常被放在同一句话里,但衡量的完全是两件事。
AUC 衡量区分度。三组的受试者工作特征曲线下面积(ROC-AUC)依次为0.831(推导队列)、0.826(内部验证队列)与0.813(中心层面验证队列)。它回答的是:给定一个患者,模型能否把后来死亡的人排在未死亡的人前面。0.8出头属于中等偏上的区分能力,谈不上决定性。
HR 衡量分层后的相对风险。基于最优模型,患者被分为低危、中危、高危三组。与低危组相比,高危组的三年全因死亡风险比(Hazard Ratio,HR)为9.62(95%CI 8.86-10.45),心血管死亡 HR 为12.53(95%CI 10.97-14.31)。
这里必须说清楚:HR 是高危组相对于低危组的分层相对风险,来自模型分层之后的两组生存比较,不是模型的区分度指标,也不表示模型准确率提升了多少倍。一个区分度一般的模型同样可以划出风险差异极大的两组,这两件事分别由 AUC 与 HR 描述,不能互相替代,也不能叠加解读。
换个说法更容易记:AUC 说的是模型能不能把人排对顺序,HR 说的是排完之后首尾两组差多少。排得准不等于两组拉得开,两组拉得开也不代表每一次排序都对。三年全因死亡与心血管死亡两条 HR 都远超9倍,加上置信区间较窄,说明高危这组一旦被划出来,其风险升高是稳定可见的——但这件事的证据强度,与模型能否精准识别每一个高危个体,是两个独立问题。
冷静观察:中心层面验证掉的那0.018,才是真实世界要付的成本
从0.831到0.813,中间差的0.018看上去很小,但它是这三组数字里最有信息量的一处。推导队列与内部验证队列之间只掉了0.005,而一旦换成按中心划分的验证,落差扩大到0.018——恰好出现在跨机构这一道关上。这提示模型性能对数据来源结构的敏感度高于对样本量的敏感度,换言之,把同样的字段搬到另一家医院,掉的那部分性能大概率要由工程侧补回来,比如检验值单位统一、缺失模式对齐、编码口径映射。
从趋势上看,这类研究的价值正在从提出新算法转向把已知算法压进临床工作流。8个变量、29家中心、附网页计算器,三个特征指向同一个方向:可被嵌进现有系统,而不是等待新的数据基础设施建成。国内多中心数据的积累为此提供了条件,但这不是方法层面的突破,也不宜这样表述。
还有两点需要留在视野内。其一,研究对象为CKM综合征2至4期的住院患者,结论外推到门诊人群或更早期分期缺少依据。其二,论文声明未获得专项资助、作者无利益冲突,当前可见的是 accepted article preview 版本,正式发表时措辞可能调整。三年死亡风险的预测时长本身也构成限制:模型输出的是一个长期概率,而临床上最直接的问题往往是这一次住院该怎么办。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
