npj Digital Medicine:14个本地开源LLM做芬兰语电子病历检索,最佳准确率95.3%,但2.9%输出含临床显著错误
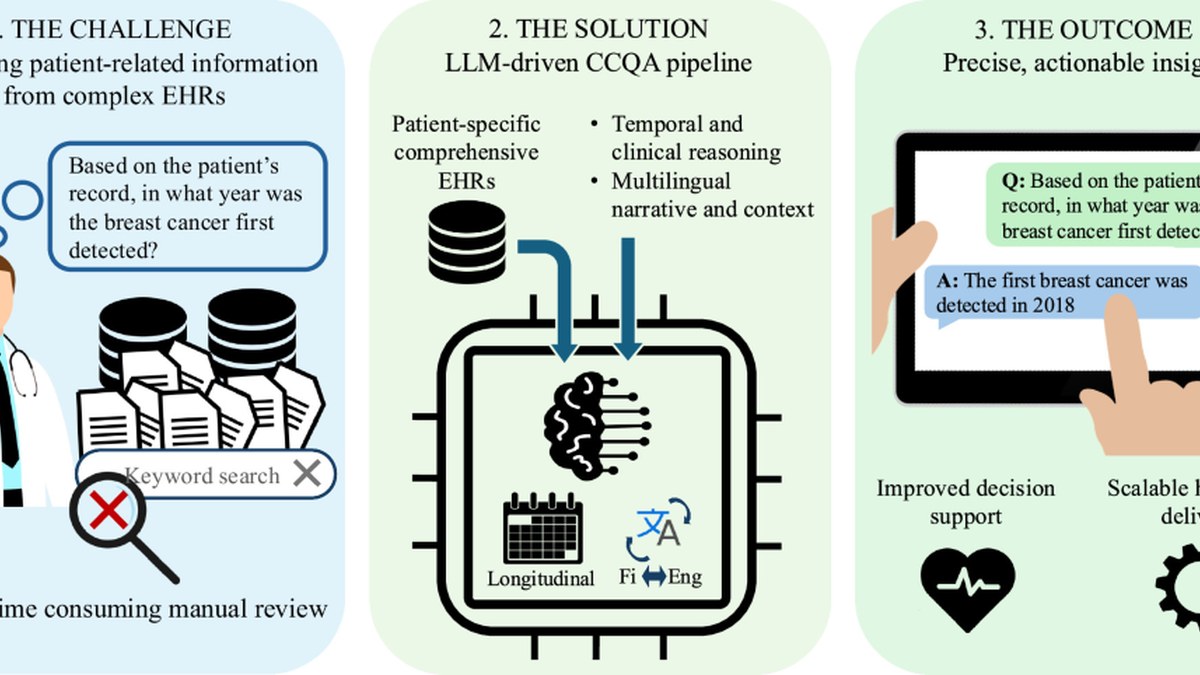
发表于npj Digital Medicine的研究在完全离线条件下评估14个可本地部署的开源大语言模型,用于从电子病历中检索结构化、患者特异的临床信息。数据集含1664条专家标注问答对,来自183名接受乳腺癌筛查、诊断或治疗的芬兰患者的病历文本,以芬兰语临床文本为主、夹杂英语与拉丁术语。最佳模型Llama-3.1-70B准确率95.3%、语义等价问法下一致性97.3%;Qwen3-30B-A3B-2507表现相当而内存占用与延迟更低。临床审查发现2.9%的输出含临床显著错误,语义等价的不同问法偶尔导致不同的临床安全结局。
开源大模型跑在院内已能做到95.3%准确率,但2.9%的输出含临床显著错误
影响分析 × 医疗数据从业者 | 趋势前瞻 × 监管与合规专家 | 深度研报
2026年9月28日在线发表于npj Digital Medicine的一项研究,在完全离线条件下评估了14个可本地部署的开源大语言模型,任务是从电子病历中检索结构化、患者特异的临床信息。最佳模型Llama-3.1-70B的准确率为95.3%。
但这项研究真正需要被记住的数字不是95.3%,而是2.9%——临床审查发现,2.9%的输出含临床显著错误;语义上等价的不同问法,偶尔会导致不同的临床安全结局。前者说明本地开源模型已跨过可用门槛,后者说明它还没有跨过可托付门槛。
开场:把模型留在院内,先解决能不能用
研究设定的前提是完全离线。这一点对医疗数据从业者意义直接:病历文本不出院,模型权重与推理过程都在本地,数据合规压力因此大幅下降。
离线部署过去常被视为性能妥协,需要接受明显更弱的模型。这项研究把14个可本地部署的开源模型放在同一任务上比较,实际上是在回答一个更实际的问题:在不出网的前提下,还能不能做到足够好。
任务也选得很克制:不是生成诊断建议,而是从电子病历中检索结构化、患者特异的临床信息。检索比生成更容易验证对错,也更容易被纳入既有工作流,这是把大模型放进临床系统时最现实的入口。
选择检索而非生成,还有一层现实考虑。生成式输出的评估成本高、责任边界模糊,而检索任务有明确的标准答案,错误可以被逐条定位。本研究后续能给出2.9%这样一个可核查的数字,前提正是任务形态本身可判定。
对数据从业者而言,离线还有一层含义:模型权重、推理框架与硬件都要在院内自行维护,升级与回滚不再由厂商托管。14个模型同台比较的设置,恰好对应了这种自主选型的需求——机构必须自己决定部署哪一个。
1664条问答对与183名患者:评测集是怎么做的
评测集包含1664条专家标注问答对,来自183名芬兰患者的病历文本。患者人群为接受乳腺癌筛查、诊断或治疗的人群,也就是说这是一个单病种、单中心的纵向文本集合,而非跨科室的混合语料。
语言条件是这项研究的另一个特点:文本以芬兰语临床记录为主,夹杂英语与拉丁术语。这种混合形态在真实电子病历中相当常见,专业术语常被直接写成英语或拉丁语原词,对分词与语义理解都是额外考验。
1664条由专家标注,意味着每条都有可核对的标准答案,准确率因此可以被精确计算,而不是靠人工打分。这是本研究结论可信度的基础。
同时也应看到边界:183名患者、单一病种、单一语种、单一机构的病历文本,决定了这套评测集衡量的是特定条件下的能力,而非通用临床检索能力。换一家医院、换一个语种或换一个科室,准确率是否仍然维持在95.3%的水平,论文未给出跨中心或跨病种的验证。
95.3%之外,2.9%的临床显著错误才是重点
性能结果分两层。最佳模型Llama-3.1-70B的准确率为95.3%,在语义等价问法下的一致性为97.3%。也就是说,同一问题换几种说法,模型给出的答案在97.3%的情况下保持一致。
Qwen3-30B-A3B-2507表现相当,但内存占用与延迟更低(在标准化Transformers配置下)。对硬件预算有限的机构来说,这条比0.1个百分点的准确率差更值得关注。
反向证据必须放在同等位置:临床审查发现2.9%的输出含临床显著错误,且语义等价的不同问法偶尔产生不同的临床安全结局。2.9%看似不大,但落在临床检索这个场景里,意味着每一百次查询中约有三次拿到可能误导判断的信息。论文未给出这些错误在病种、字段或问法类型上的分布,公开信息中未见更细的拆解。
这一条反向证据之所以重要,是因为它与95.3%并非同一维度的补充,而是对后者解释力的限制。准确率高说明大多数时候对,一致性97.3%说明换说法多数时候结论不变,但两者都没能排除剩余那一小部分里存在临床显著错误的可能。三项数字必须一起读。
从任务性质看,临床信息检索的输出往往直接进入医生的判断链条,错误的代价不按错误率线性计。因此2.9%这个数字在部署评审中的权重,应当高于它在数值上给人的直觉印象。
专用模型没有优势:这条结论对选型意味着什么
研究中一个反直觉的发现是:医学领域或芬兰语专用模型相对通用模型并无系统性优势。这条结论对选型路径的影响很直接——与其追求垂直领域微调版本,不如把精力放在通用模型的规模、量化与部署配置上。
工程侧还有两条可用结论。一是对最强模型而言,提示中是否给出预定义答案选项对准确率影响不大;二是4-bit量化降低了内存需求且大体保持准确率。前者意味着提示工程不必围绕选项设计过度优化,后者意味着单机显卡预算可以被进一步压缩。
需要说明的是,这两条结论的适用边界是本研究设定的任务与模型集合,不能直接外推到生成类任务。
「专用模型无系统性优势」这条尤其容易被过度解读。它否定的只是本研究条件下垂直微调带来的整体性能增益,并不意味着专用模型在术语理解、格式遵循或本地化表达上毫无价值。选型时把它当作一条成本信号来用,比当作一条禁令来用更稳妥。
冷静观察:换一种问法就换一个答案,这是部署前必须面对的
对监管与合规视角而言,2.9%与「语义等价问法偶尔产生不同临床安全结局」这两条,比任何准确率数字都更关键。它意味着系统的输出不具备问法无关的稳定性,而临床使用恰恰无法保证所有使用者用同一种方式提问。
这类不稳定无法通过调高阈值或加一道人工复核彻底消除,因为复核者看到的往往只是单次输出。可行的方向是把一致性本身纳入评测:在上线前用语义等价问法批量压测,把不一致率作为准入指标之一,而不是只看单次准确率。
本地部署解决了数据在哪的问题,没有解决答案稳不稳的问题。这两件事在审批与院内评估中应当分开报、分开审。
对监管与合规专家而言,还有一个分类上的现实:检索类功能常被当作效率工具而非诊断功能立项,但2.9%的临床显著错误率说明它已经触碰临床判断。划在哪一类,决定了走哪条评估路径,也决定了出错时由谁承担复核责任,这个判断不宜由工具名称来替使用者做。
原文链接:npj Digital Medicine(Nature)
千方医数集编辑部 出品
