《Nature Medicine》:600万个脑细胞里筛出150万个表型相关细胞,AI把阿尔茨海默的分型拆到单细胞精度
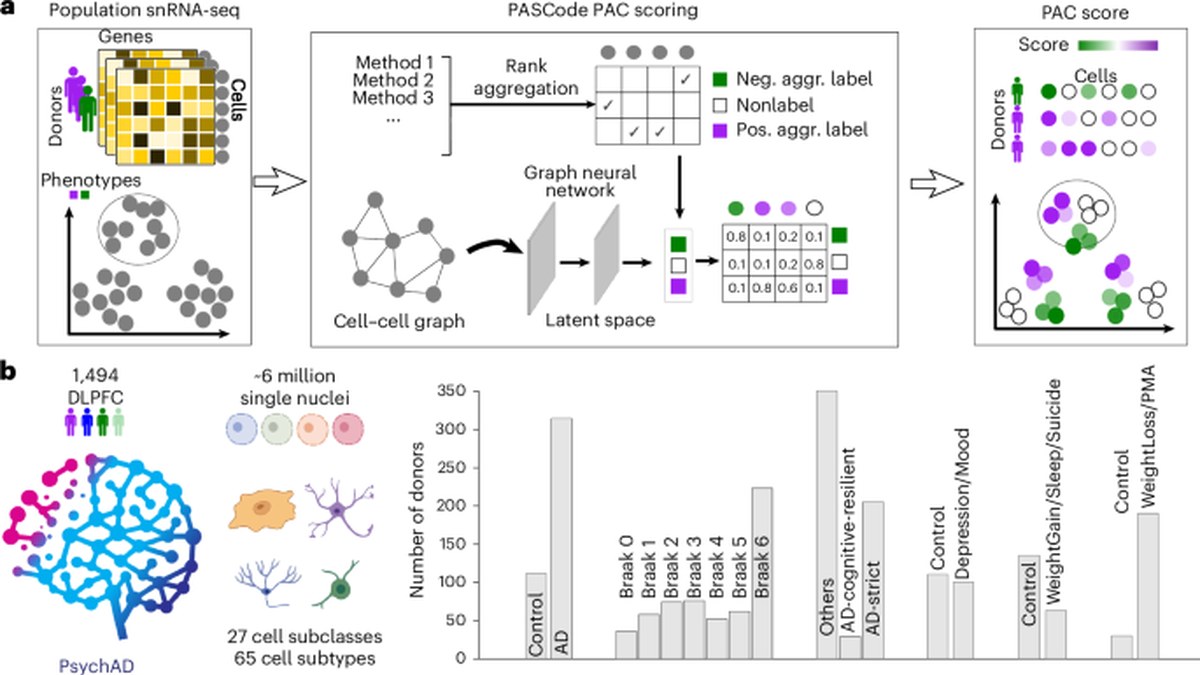
9月23日发表于《Nature Medicine》的研究中,PsychAD项目构建了超过600万个脑细胞核、来自1000多个个体脑的人群级单核RNA测序数据集,并开发图神经计算框架PASCode为单细胞打分表型关联,从584名阿尔茨海默相关表型供体中鉴定约150万个表型相关细胞,在27类脑细胞亚型中优先排序出与各表型相关的细胞亚群与基因。
600万细胞核的新图谱:阿尔茨海默不再是一个病,而是一组细胞状态
数据视角 × 医疗数据从业者 | 趋势前瞻 × AI技术供应商·创业者 | 深度研报
**9月23日,《Nature Medicine》在线发表一项基于人群规模单细胞数据的阿尔茨海默病表型AI表征研究(DOI:10.1038/s41591-025-04128-1)。**依托PsychAD联盟,研究团队构建了覆盖1000多个个体脑、超过600万个细胞核的单核RNA测序数据集,并开发计算框架PASCode,从584名具有阿尔茨海默病相关表型的供体中鉴定出约150万个表型相关细胞,为不同疾病表型找到了各自的“细胞坐标”。
开场:阿尔茨海默最大的难题,是它从来不止一种样子
阿尔茨海默病在临床上从来不是一个整齐划一的疾病。同样拿到这一诊断的患者,病理进展速度不同、认知受损模式不同,还常常与抑郁等其他表型交织出现。对药物研发和精准诊疗而言,这种异质性是最难啃的骨头:如果“一种病”实际上是一组状态,那么用同一套指标、同一类靶点去对付它,失败几乎是注定的。这也意味着,临床试验里的“平均疗效”,很可能掩盖了只对某一类细胞状态真正有效的药物。
**把阿尔茨海默当作单一疾病来对付,或许正是许多治疗尝试折戟的深层原因之一。**这项新研究的出发点,就是把“阿尔茨海默”拆解成一组可以被刻画、被比较的细胞状态——不再问“病人有没有病”,而是问“他的哪些细胞正处在哪一种与表型相关的状态里”。
600万细胞核:一张人群级的单细胞底图
PsychAD项目生成的,是一个真正意义上的“人群级”单细胞数据集:超过600万个细胞核,来自1000多个个体脑的前额叶皮层,覆盖多种疾病表型。前额叶皮层是认知功能的关键脑区,也是阿尔茨海默病理的重灾区;而1000多个个体这一量级,让数据集第一次具备了流行病学意义上的代表性。单核RNA测序的价值在于,它能以单细胞分辨率读出每个细胞核的基因表达谱,让“细胞状态”成为一个可量化、可统计的对象,而不再只是病理切片上的形态学描述。
规模带来的质变在于统计能力。过去的单细胞脑研究多为“几个病人、几万个细胞”的病例对照设计,只能给出定性观察;而当细胞数达到600万、供体数破千,细胞状态与真实临床表型之间就可以做严格的相关性分析,把“表型”这个临床概念落到具体的细胞亚群和基因表达上。这张底图本身,就是后续一切分析的地基。
PASCode怎么工作:把统计方法装进图神经模型
有了底图,还需要一把能在600万个细胞里“捞针”的尺子。团队开发的PASCode(Phenotype Associated Single Cell encoder),干的正是这件事:为每一个单细胞计算它与特定表型之间的关联评分。
方法设计上有一个值得数据从业者注意的思路:团队没有发明全新的统计量,而是将多种统计方法集成进一个图神经模型,以获得稳健的评分。图结构的引入意味着细胞不再是孤立的数据点,细胞与细胞之间的相似性关系也参与建模;中文报道进一步描述,该框架通过图注意力网络计算单细胞的表型关联性评分。换句话说,**模型即方法集成,评分即特征工程——统计先验负责稳健,图注意力负责表达。**这套“集成式建模”的思路,对高噪声的单细胞数据尤其对症。而“评分”这一输出形式,也让结果天然具备可排序、可比较的属性,方便下游直接做优先级决策。
150万个表型相关细胞:小胶质、星形胶质与认知韧性
把PASCode跑在底图上,团队从584名具有AD相关表型的供体中鉴定出约150万个表型相关细胞(PACs),并在27类脑细胞亚型中逐一比较,为不同AD表型优先排序了细胞亚群及其表达基因。四个发现尤其值得关注。
其一,鉴定出与AD病理相关的小胶质细胞亚群,为免疫炎症假说补上了细胞级的坐标。其二,反应性星形胶质细胞亚型的神经保护与神经毒性基因表达发生改变,这种改变或赋予部分患者认知韧性——病理很重、认知却相对完好的现象,由此有了细胞层面的解释。其三,认知受损AD供体中兴奋与抑制的平衡失调增强,并伴随线粒体功能障碍。其四,许多PACs同时关联多个表型,例如同时关联AD与抑郁的星形胶质细胞,呈现出炎症与内质网应激通路的特异性基因表达,这为临床共病找到了细胞层面的重叠证据。四个发现横跨免疫炎症、胶质功能、神经环路平衡与细胞应激多个层面,也呼应了AD机制研究“多线并行”的现实格局。
**这批结果把“哪个细胞、哪个表型、哪条通路”串成了一份可优先排序的清单。**更重要的是,团队在外部人群规模数据集(包括AD与重度抑郁症数据集)中验证了这些发现,说明评分不是对单一队列的过拟合。
冷静观察:关联不是因果,图谱到药物之间还有功能验证
兴奋之余需要泼一点冷水:表型关联评分本质上仍是统计关联。一个细胞亚群与某表型高度相关,不等于它在驱动该表型;从“优先排序的候选清单”到“可成药的靶点”,中间隔着功能实验、扰动验证与动物模型的漫长链条。单细胞图谱能告诉你“哪里值得挖”,但不能替你证明“挖下去一定有矿”。它更像一张标注了坐标的藏宝图,而不是已经提炼好的药物分子。
**对产业界而言,这张图谱最大的现实价值,或许是缩短靶点发现的搜索空间,而不是直接给出答案。**值得一提的是,团队编制了AD表型单细胞图谱,并将框架以开源工具、预训练模型与网络应用的形式交付社区,这意味着优先排序的能力可以被任何团队复用。研究由威斯康星大学王岱峰与西奈山伊坎医学院Panos Roussos领衔,赵新宇为第一作者,依托PsychAD联盟完成。这些优先排序的细胞亚群、基因与通路,有望为阿尔茨海默的精准诊断与治疗开发提供新线索,而从“提供线索”到“兑现疗法”之间的路,才刚刚开始。
原文链接:Nature Medicine
千方医数集编辑部 出品
